
决策树
决策树用一连串”是/否”问题递归地切分数据,直到每个分支内的样本足够”纯净”。它直观、可解释、能自动处理非线性关系与混合类型特征,是随机森林、GBDT、XGBoost 等集成模型的基础构件。前置阅读:监督学习。
把决策树想象成医生问诊的流程图:
- 你来看病,医生不会一上来就开药,而是一个问题接一个问题地排查:“发烧吗?""咳嗽吗?""痰是什么颜色?“每个问题都把可能的疾病范围缩小一半。
- 每个”是/否”问题对应一个内部节点——问题选得好,几个回合就能锁定答案;选得差,绕半天还在原地。
- 最后给出的诊断对应一个叶子节点——同一类病人到达同一片叶子。
- “纯净”就是叶子里的样本几乎全是同一类。决策树学习的过程,就是挑那些能最快让子节点变纯的切分问题。
决策树的魅力在于:训练出来的模型就是一棵人类可直接阅读的规则树——这是黑箱神经网络无法比拟的可解释性,也是它在医疗、金融、司法等高风险领域备受青睐的原因。
从几何视角看,决策树每次沿某个特征的某个阈值”切一刀”,把特征空间划分为一系列轴平行的矩形区域(hyper-rectangle)。每个叶子对应一个区域,区域内的预测值相同(分类取多数类,回归取均值)。这意味着决策树本质上是在用阶梯函数逼近真实的决策边界——虽然单个切分是”硬”的轴平行线,但足够多的叶子就能逼近任意复杂的边界。
一棵决策树由三类节点组成:
- 根节点:包含全部训练样本,是第一个切分点。
- 内部节点:对一个特征做一次判断(数值特征用”小于阈值”,类别特征用”是否属于某集合”),把样本分到子节点。每个内部节点存储的信息非常简单:用哪个特征、什么阈值、分到左还是右。
- 叶子节点:不再切分,给出预测——分类树取多数类,回归树取叶子内样本目标值的平均。
从数据流的角度看,一条输入样本 从根节点出发,每到一个内部节点就根据 x[feature] <= threshold 决定走左子树还是右子树,最终落入某个叶子,叶子里的值就是预测结果。推理过程的时间复杂度是 ——这是决策树比神经网络快得多的原因之一。
切分准则:如何选最好的问题
Section titled “切分准则:如何选最好的问题”每个节点要找一个”最有区分力”的切分。衡量”区分力”的核心是纯度(purity)——切分后子节点越纯越好。这背后的直觉是:如果切分后左子树全是 A 类、右子树全是 B 类,那这个切分就完美地把两类分开了;反之如果左右两边各类各占一半,那切了等于没切。
为了量化纯度,我们需要一个不纯度函数(impurity function),它满足:
- ,且当节点完全纯净(所有样本同类)时 。
- 类别分布越均匀, 越大。
- 关于类别概率 对称(交换类别顺序不影响结果)。
常见的三种不纯度函数如下,它们都满足这些性质。
熵与信息增益(ID3 / C4.5)
Section titled “熵与信息增益(ID3 / C4.5)”熵(entropy)是信息论中衡量不确定性的基本度量。在决策树语境下,它衡量”节点内样本类别的混乱程度”。设节点 内有 个类别,第 类的占比为 ,则熵定义为:
数学直觉: 是”得知一个第 类样本所属类别后获得的’信息量’“(也叫 surprisal)。概率越低( 越小)的事件发生了,越令人”惊讶”,信息量越大。熵就是所有可能的类别的信息量的期望值(加权平均)。
- 当节点完全纯净(只有一类,):,不确定性为零。
- 当节点类别均匀分布( 类各占 ):,熵达到最大值。
以二分类为例,设正类占比为 ,则 ,在 时取最大值 1 bit。
信息增益(Information Gain)就是切分前后熵的下降量。设节点 经切分 后分为左子节点 (占比 )和右子节点 (占比 ):
其中 ,。
这个公式的含义: 是切分前的不确定性, 是切分后子节点的加权平均不确定性。两者之差就是切分”消除了多少不确定性”——消除得越多,切分越好。
ID3 算法在每个节点遍历所有特征的所有可能切分,选取信息增益最大的那个。
基尼不纯度(CART 分类树)
Section titled “基尼不纯度(CART 分类树)”基尼不纯度(Gini impurity)的定义更简洁:
数学直觉:它衡量的是”从节点中随机抽一个样本,用节点内的类别分布随机猜它的类别,猜错的概率是多少”。具体来说,如果你按概率 随机猜样本属于第 类,猜对的概率是 ,那么猜错的概率就是 。
- 完全纯净(只有一类):。
- 二分类均匀分布:。
CART 使用基尼下降量()作为切分准则,逻辑与信息增益完全对称:
信息增益率(C4.5)
Section titled “信息增益率(C4.5)”ID3 用信息增益有一个已知缺陷:信息增益偏好取值多的特征。极端情况下,如果把每个样本的 ID(唯一标识)当作一个特征,按 ID 切分能让每个叶子只剩一个样本,信息增益达到最大——但这显然没有泛化能力。
C4.5 用信息增益率(Gain Ratio)修正这一问题。定义切分 的固有值(intrinsic value):
其中 是切分后的第 个子节点。固有值衡量的是”切分本身把数据分成了多少份、每份多大”——切分越多份、越不均匀,固有值越大。
信息增益率 = 信息增益 / 固有值:
直觉:把信息增益”按切分的复杂度打折扣”。一个把数据切成 100 份的切分,固有值很大,信息增益率被压低;一个简洁的二分切分,固有值小,更容易胜出。
CART 回归树的分裂准则
Section titled “CART 回归树的分裂准则”回归问题中目标是连续值 ,不能再用分类的不纯度。CART 回归树用加权方差下降量作为切分准则。
定义节点 内目标值的均方误差(MSE)为不纯度:
其中 是节点 内目标值的均值。
切分 的方差下降量为:
直觉:切分前所有样本用一个全局均值预测,误差为 ;切分后左子树用左均值预测、右子树用右均值预测,加权误差更小。下降量越大,说明切分越有效地把”差异大的样本”分开了。
切分的搜索空间
Section titled “切分的搜索空间”对于数值特征,候选阈值通常取该特征在当前节点内所有不同取值的中点。如果特征有 个不同取值,就有 个候选阈值。对于类别特征,CART 只做二分(“属于子集 ” vs “不属于”),有 种可能的子集划分( 是类别数),当类别数多时计算量很大——这是 CART 对高基数类别特征效率不高的原因之一。
三大经典算法
Section titled “三大经典算法”| 特性 | ID3 | C4.5 | CART |
|---|---|---|---|
| 年份 | 1986 | 1993 | 1984 |
| 作者 | Quinlan | Quinlan | Breiman |
| 切分准则 | 信息增益 | 信息增益率 | Gini(分类)/ 方差(回归) |
| 树结构 | 多叉树 | 多叉树 | 二叉树 |
| 特征类型 | 仅类别 | 类别 + 连续 | 类别 + 连续 |
| 缺失值 | 不支持 | 支持 | 支持 |
| 剪枝 | 无 | 悲观剪枝 | 代价复杂度剪枝 |
| 回归 | 不支持 | 不支持 | 支持 |
- ID3(1986, Quinlan):用信息增益选切分,只能处理类别特征,倾向于选取值多的特征(信息增益偏好)。它是决策树学习的开山之作,奠定了”自顶向下递归切分”(top-down induction of decision trees, TDIDT)的基本框架。
- C4.5(1993, Quinlan):用信息增益率(增益除以切分本身的熵)修正 ID3 的偏好,能处理连续特征与缺失值,支持悲观剪枝(pessimistic pruning)。C4.5 的继任者 C5.0(商业版本,也称 See5)进一步提升了速度和内存效率。
- CART(1984, Breiman):二叉树(每次只切两份),分类用 Gini,回归用方差,既做分类又做回归。CART 的二叉结构保证了每次切分都是对特征空间的最简分割,避免了多叉树中”一个特征只切一次”的局限。sklearn 的
DecisionTreeClassifier/DecisionTreeRegressor用的就是 CART。
其他经典决策树算法
Section titled “其他经典决策树算法”除了”三巨头”,还有几个值得了解的算法:
- CHAID(Chi-square Automatic Interaction Detection, 1980):用卡方检验(分类)或 F 检验(回归)判断切分是否统计显著,能做多叉分裂。在市场研究和社会学中常用,但计算量较大。
- Conditional Inference Trees(条件推断树, 2006):由 Hothorn 等人提出,用非参数统计检验选切分特征,并对多重比较做校正。它避免了传统决策树对取值多的特征的偏好,且不需要剪枝——因为只在统计显著时才继续分裂,自然防止过拟合。R 语言的
party/ctree包实现了这一方法。 - MARS(Multivariate Adaptive Regression Splines):扩展决策树以更好地处理连续数值特征,使用分段线性 hinge 函数代替硬切分。
剪枝:防止过拟合
Section titled “剪枝:防止过拟合”决策树最大的毛病是容易长成一棵过拟合的巨树——如果一路切到每个叶子只剩一个样本,训练集准确率 100%,但泛化极差。这是因为树的复杂度(叶节点数)随数据量增长而增长,模型记住了训练数据中的噪声。
控制方法有两大类:
预剪枝(pre-pruning / early stopping):在生长时就限制,常用超参数:
| 超参数 | 含义 | 典型值 |
|---|---|---|
max_depth | 树的最大深度 | 3-15 |
min_samples_split | 节点至少有多少样本才允许继续切 | 2-20 |
min_samples_leaf | 每个叶子至少有多少样本 | 1-50 |
max_leaf_nodes | 叶子总数上限 | 10-100 |
min_impurity_decrease | 切分必须带来的最小不纯度下降 | 0-0.01 |
max_features | 每次切分最多考虑多少特征 | 或 |
预剪枝简单高效,但风险是”目光短浅”——某个切分可能在当前看起来增益不大,但它之后的子切分可能带来大幅提升。预剪枝会在第一步就停住,错过了后续的好切分。
后剪枝(post-pruning):先让树充分生长,再自底向上把”提升不显著”的子树合并成叶子。C4.5 与 CART 都支持,sklearn 目前通过 ccp_alpha 参数提供简化版后剪枝。
决策树是非参数模型,没有假设数据服从什么分布,这是优点也是隐患:自由度太高导致方差大——训练数据稍微变一点,长出来的树可能完全不同(具体来说,只是换了训练集中的一个样本,最优切分点就可能改变,而切分点一变,后续整棵子树都不同)。这正是集成学习(bagging、boosting)要解决的核心问题:把多棵不稳定树组合成一个稳定强大的模型。
另一个深层问题是决策树学习是 NP 完全的——构建全局最优的决策树已被证明是 NP-hard 问题(Hyfil & Rivest, 1976)。因此所有实际算法(ID3、C4.5、CART)都采用贪心策略:在每个节点做局部最优选择,但无法保证全局最优。这也解释了为什么同一个数据集用不同的随机种子,sklearn 可能长出不同的树。
决策空间的几何视角
Section titled “决策空间的几何视角”从决策边界的角度看,决策树用轴平行的超平面逐步切分特征空间。以二维为例:
每次切分都是沿某个坐标轴画一条线。这意味着:
- 优势:能自然地捕捉特征间的交互作用(interaction),不需要人工构造交叉特征。一个深度为 的路径就编码了 个特征的组合条件。
- 局限:对于斜对角的决策边界(如 ),需要很多次轴平行切分来逼近,树会很深。这正是斜决策树(oblique decision tree,如 OC1 算法)试图解决的问题——它用线性组合 做切分,但训练难度大幅增加。
训练时每个内部节点都遍历所有特征与所有可能阈值,计算切分后的纯度提升(信息增益 / Gini 下降),选最大的那个。这个过程是递归的:对每个子节点重复同样的切分搜索,直到满足停止条件(节点纯了 / 达到最大深度 / 样本太少)。
以 Iris 数据集的经典切分为例,根节点第一个问题通常是”花瓣长度(petal length)≤ 2.45 cm 吗?“——这一刀就能完美地把 Setosa 类分出来(Gini 从 0.667 降到 0),因为 Setosa 的花瓣长度显著短于其他两类。
sklearn 训练决策树并可视化深度影响
Section titled “sklearn 训练决策树并可视化深度影响”from sklearn.tree import DecisionTreeClassifier, export_textfrom sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_split
X, y = load_iris(return_X_y=True)X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42)
# 对比:不限制深度 vs 限制深度deep = DecisionTreeClassifier(random_state=42).fit(X_tr, y_tr)shallow = DecisionTreeClassifier(max_depth=3, random_state=42).fit(X_tr, y_tr)print(f"无限制: 训练={deep.score(X_tr, y_tr):.3f} 测试={deep.score(X_te, y_te):.3f}")print(f"max_depth=3: 训练={shallow.score(X_tr, y_tr):.3f} 测试={shallow.score(X_te, y_te):.3f}")# 打印浅树的规则print(export_text(shallow, feature_names=load_iris().feature_names))典型输出:无限制的树训练准确率 1.0、测试准确率约 1.0(Iris 太简单),但在更复杂的数据集上无限制树的测试准确率会显著低于训练——这就是过拟合的信号。
numpy 手写 Gini 不纯度与最佳切分
Section titled “numpy 手写 Gini 不纯度与最佳切分”import numpy as np
def gini(y): """y 是节点内的标签数组,返回 Gini 不纯度。""" _, counts = np.unique(y, return_counts=True) p = counts / len(y) return 1 - np.sum(p ** 2)
def best_split(X, y, feat): """在单个特征上找使加权 Gini 最小的阈值。""" xs = np.sort(np.unique(X[:, feat])) best_gini, best_t = 1.0, None for t in (xs[:-1] + xs[1:]) / 2: # 候选阈值取相邻值中点 left = y[X[:, feat] <= t]; right = y[X[:, feat] > t] g = len(left)/len(y)*gini(left) + len(right)/len(y)*gini(right) if g < best_gini: best_gini, best_t = g, t return best_t, best_gini
# toy 数据演示X = np.array([[1],[2],[3],[4],[5],[6]]); y = np.array([0,0,0,1,1,1])print("最佳切分:阈值 =", best_split(X, y, 0)) # → 阈值 3.5用 graphviz 可视化决策树
Section titled “用 graphviz 可视化决策树”from sklearn.tree import DecisionTreeClassifier, export_graphvizfrom sklearn.datasets import load_irisimport graphviz
X, y = load_iris(return_X_y=True)clf = DecisionTreeClassifier(max_depth=3, random_state=42).fit(X, y)
# 导出为 graphviz DOT 格式,渲染为 PDFdot_data = export_graphviz( clf, out_file=None, feature_names=load_iris().feature_names, class_names=load_iris().target_names, filled=True, # 用颜色填充节点(颜色深浅表示纯度) rounded=True, special_characters=True,)graph = graphviz.Source(dot_data)graph.render("iris_tree", format="pdf", cleanup=True) # 输出 iris_tree.pdfprint("已生成 iris_tree.pdf")不同剪枝策略的对比实验
Section titled “不同剪枝策略的对比实验”import numpy as npimport matplotlib.pyplot as pltfrom sklearn.tree import DecisionTreeClassifierfrom sklearn.datasets import make_classificationfrom sklearn.model_selection import train_test_split, cross_val_score
# 生成一个有噪声、非线性可分的数据集X, y = make_classification( n_samples=1000, n_features=20, n_informative=5, n_redundant=5, n_clusters_per_class=3, flip_y=0.1, random_state=42,)X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42)
# 策略 1:无限制(过拟合基准)clf_none = DecisionTreeClassifier(random_state=42).fit(X_tr, y_tr)
# 策略 2:预剪枝——限制深度和叶子最小样本数clf_pre = DecisionTreeClassifier( max_depth=5, min_samples_leaf=20, random_state=42).fit(X_tr, y_tr)
# 策略 3:后剪枝——用 ccp_alpha 控制复杂度path = clf_none.cost_complexity_pruning_path(X_tr, y_tr)ccp_alphas = path.ccp_alphas# 交叉验证选最优 alphacv_scores = []for alpha in ccp_alphas: clf = DecisionTreeClassifier(ccp_alpha=alpha, random_state=42) cv_scores.append(cross_val_score(clf, X_tr, y_tr, cv=5).mean())best_alpha = ccp_alphas[np.argmax(cv_scores)]clf_post = DecisionTreeClassifier( ccp_alpha=best_alpha, random_state=42).fit(X_tr, y_tr)
print(f"无限制: 训练={clf_none.score(X_tr, y_tr):.3f} 测试={clf_none.score(X_te, y_te):.3f}")print(f"预剪枝: 训练={clf_pre.score(X_tr, y_tr):.3f} 测试={clf_pre.score(X_te, y_te):.3f}")print(f"后剪枝(α={best_alpha:.4f}): 训练={clf_post.score(X_tr, y_tr):.3f} 测试={clf_post.score(X_te, y_te):.3f}")
# 可视化 ccp_alpha vs 交叉验证准确率plt.figure(figsize=(8, 4))plt.plot(ccp_alphas, cv_scores, marker='.')plt.xlabel('ccp_alpha')plt.ylabel('5-fold CV accuracy')plt.title('后剪枝:代价复杂度参数 vs 交叉验证准确率')plt.axvline(best_alpha, color='r', linestyle='--', label=f'最优 α={best_alpha:.4f}')plt.legend()plt.tight_layout()plt.savefig('pruning_comparison.png', dpi=150)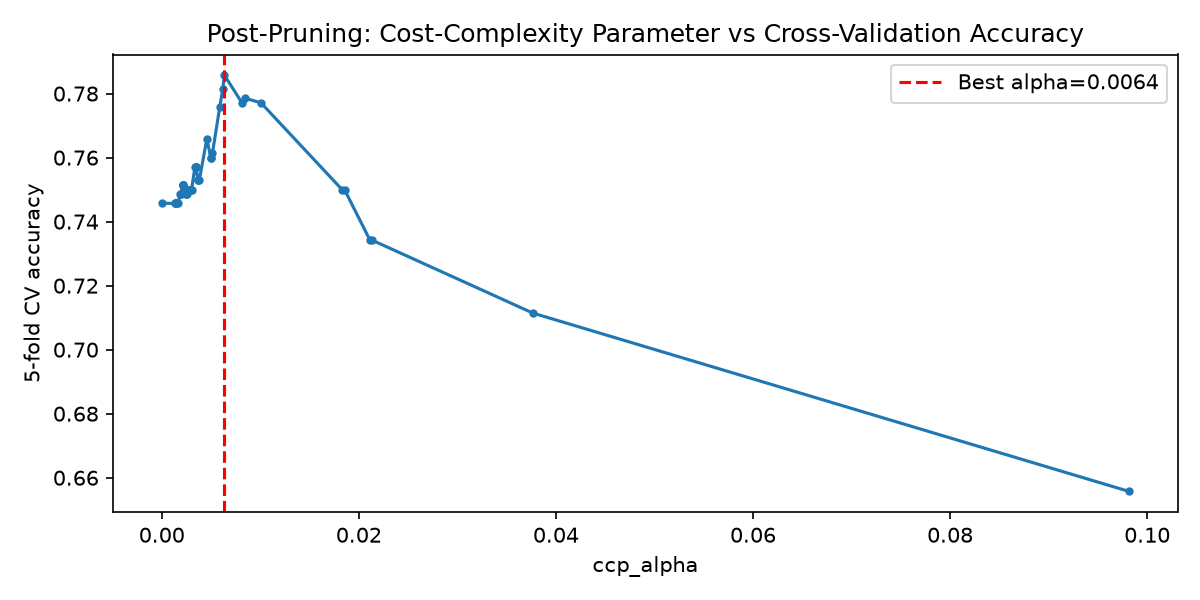
CART 回归树示例
Section titled “CART 回归树示例”import numpy as npimport matplotlib.pyplot as pltfrom sklearn.tree import DecisionTreeRegressor
# 生成一个非线性回归数据集(y = sin(x) + noise)rng = np.random.RandomState(42)X = np.sort(5 * rng.rand(200, 1), axis=0)y = np.sin(X).ravel() + rng.normal(0, 0.1, X.shape[0])
# 对比不同深度的回归树fig, axes = plt.subplots(1, 3, figsize=(15, 4))X_test = np.linspace(0, 5, 500).reshape(-1, 1)
for ax, depth in zip(axes, [2, 4, None]): reg = DecisionTreeRegressor(max_depth=depth).fit(X, y) y_pred = reg.predict(X_test) ax.scatter(X, y, s=10, alpha=0.5, label='数据') ax.plot(X_test, y_pred, color='red', linewidth=2, label=f'回归树 (depth={depth})') ax.set_title(f'max_depth={depth}') ax.legend(fontsize=8)
plt.tight_layout()plt.savefig('regression_tree.png', dpi=150)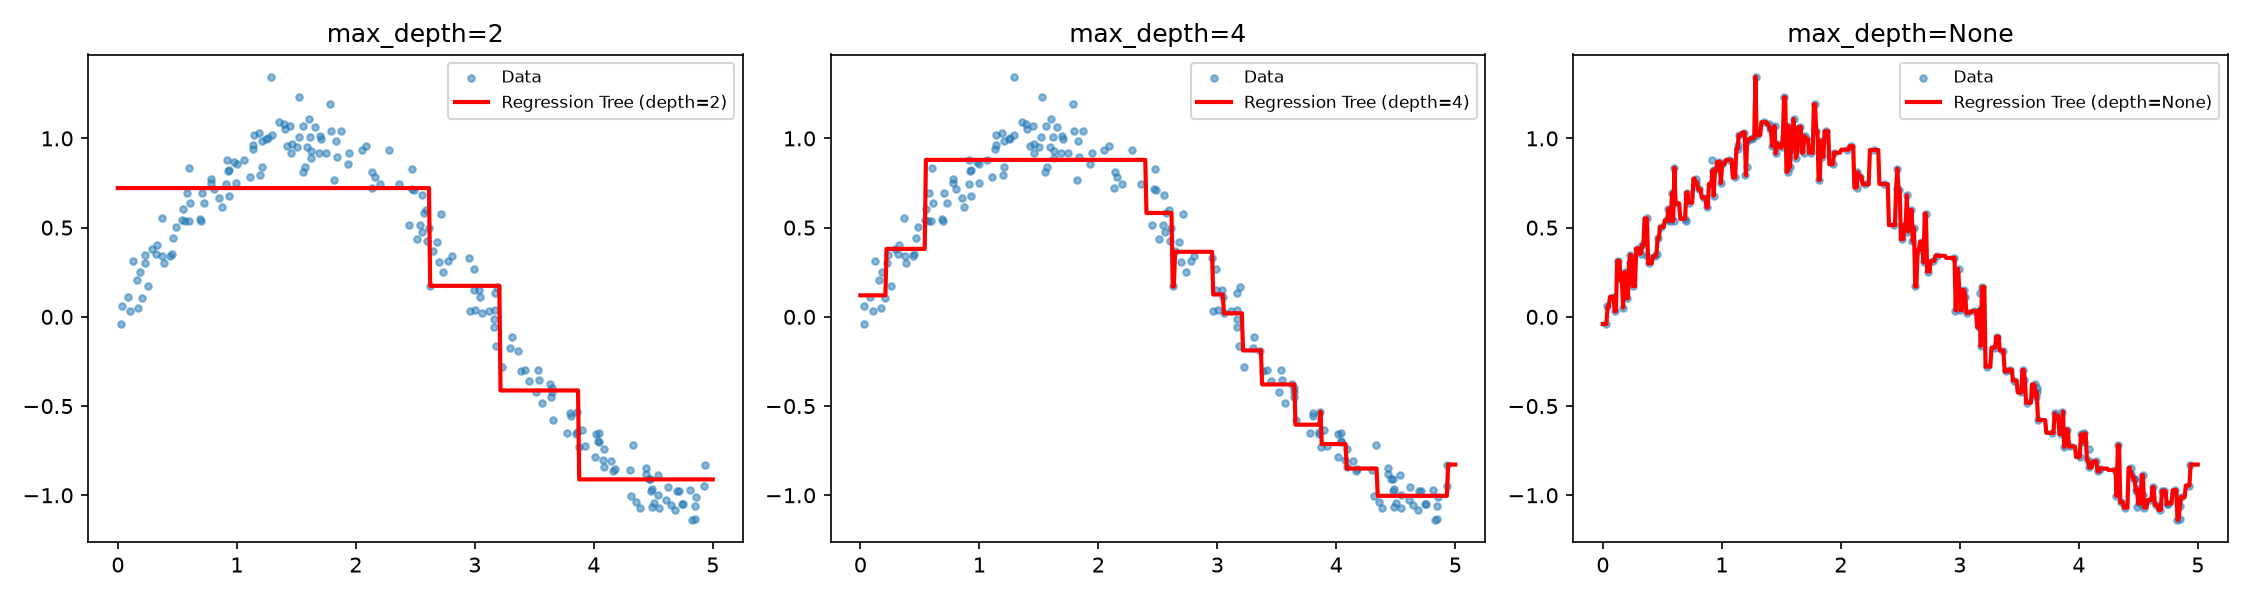
注意回归树的预测曲线是阶梯形的——每一段水平线对应一个叶子,高度就是该叶子内训练样本 值的均值。这是决策树”轴平行切分”的直接结果:每个叶子输出常数,不连续。
特征重要性分析
Section titled “特征重要性分析”from sklearn.tree import DecisionTreeClassifierfrom sklearn.datasets import load_irisimport numpy as np
X, y = load_iris(return_X_y=True)clf = DecisionTreeClassifier(max_depth=3, random_state=42).fit(X, y)
# 决策树自带 feature_importances_:每个特征的不纯度下降总量(归一化后)feature_names = load_iris().feature_namesimportances = clf.feature_importances_indices = np.argsort(importances)[::-1]
print("特征重要性排名:")for i in indices: print(f" {feature_names[i]:25s} {importances[i]:.4f}")- 先调 max_depth:控制深度是最有效的抗过拟合手段,通常 3 到 10 层就够了。配合
min_samples_leaf(如 20)效果更好。 - 类别不平衡要设 class_weight:否则树会被多数类主导,少数类的切分被忽略。设
class_weight='balanced'可让算法自动按类别频率的倒数加权。 - 数值特征要谨慎外推:回归树在训练范围外的预测是常数(最后一片叶子的值),不会线性外推——预测超出训练范围的外推要小心。
- 单树不稳定,优先用集成:实际项目里几乎不裸用决策树做最终模型,而是用它作为随机森林或 GBDT 的基学习器。
- 类别特征要编码:sklearn 的 CART 不原生支持类别特征,需 one-hot 或序号编码;LightGBM / CatBoost 原生支持,效果更好。
- 可解释性是杀手锏:需要向业务方解释决策的场景(如信贷审批、医疗辅助诊断),单棵浅树 +
export_text或 graphviz 可视化仍然极有价值。 - 数据预处理需求低:决策树对特征的量纲不敏感(因为是按阈值切分而非计算距离),通常不需要标准化或归一化。异常值对决策树的影响也远小于线性模型或 SVM——一个极端值只会改变切分阈值的候选范围,不会像在距离计算中那样”拉偏”整个模型。
- 特征选择是内建的:决策树自动选出”最有区分力的特征”并忽略无关特征——树的上层节点就是最重要的特征,不相关的特征根本不会被选中。这意味着决策树天生具有特征选择能力。
- 验证用交叉验证而非单次划分:单棵决策树方差大,单次 train/test 划分的评估结果波动很大。使用 5 或 10 折交叉验证能得到更可靠的性能估计。
- 信贷风险评级:银行用决策树生成可解释的审批规则——“收入大于 X 且负债比小于 Y 则通过”,监管与客户都要求规则透明。例如美国《平等信用机会法》(ECOA)要求信贷模型必须能给出拒绝原因,决策树天然满足这一要求。
- 医疗辅助诊断:根据症状、检验指标走决策树给出可能的诊断与建议检查,规则可由医生审阅与背书。经典的例子包括基于决策树的急性心肌梗死风险分层模型。
- 客户流失预测:电信、SaaS 公司用决策树识别”哪些特征组合的客户最可能流失”,输出可直接落地的挽留规则。
- 欺诈规则引擎:支付风控的规则引擎本质是一棵(或一组)人工 + 机器学习共同维护的决策树。例如”单笔金额 > 5000 且 IP 归属地 ≠ 注册地 且 凌晨 2-5 点交易 → 触发人工审核”。
- 推荐系统的规则层:在深度学习推荐模型之上叠加一层决策树规则做业务逻辑兜底——“新品冷启动期给予额外曝光权重”等。
- 作为集成模型的基学习器:XGBoost、LightGBM、CatBoost、随机森林等几乎全部以决策树(通常是 CART)为基学习器——理解决策树是理解这些工业级模型的前提。详见集成学习。
- 特征工程参考:决策树自动发现”哪个特征在哪个阈值切分有用”,可作为构造人工特征的灵感来源。一个常见技巧是:训练一棵决策树,把每个样本落入的叶子编号(
apply()方法)作为新特征喂给线性模型。 - 工业设备预测性维护:根据传感器读数(温度、振动频率、运行时长等)的阈值组合判断设备是否需要维护,规则可由工程师审核。
2025-2026 前沿进展
Section titled “2025-2026 前沿进展”尽管深度学习在图像、文本等领域占据主导,决策树在表格数据(tabular data)上仍然是王者,并且与新技术持续融合。以下是近年来的重要进展:
决策树仍是表格数据的王者
Section titled “决策树仍是表格数据的王者”2022 年 Grinsztajn 等人的大规模基准测试(arXiv:2207.08815,NeurIPS 2022)在 45 个数据集上系统比较了树模型与深度学习,结论是:
树模型(XGBoost、随机森林)在中等规模(~10K 样本)的表格数据上仍然是 state-of-the-art,即使不考虑它们更快的训练速度。
研究指出了神经网络的三个关键弱点:(1) 对不 informative 特征不够鲁棒;(2) 对数据的旋转不够保留;(3) 难以学习不规则函数。而树模型天然没有这些问题。到 2025 年,尽管出现了 FT-Transformer、TabPFN 等面向表格数据的新架构,GBDT(梯度提升决策树)在绝大多数实际 Kaggle 竞赛和工业表格任务中仍然是最强基线。
决策树与 LLM 的交叉融合
Section titled “决策树与 LLM 的交叉融合”大语言模型(LLM)的兴起给决策树带来了新的角色:
- 用决策树解释 LLM:LLM 的黑箱决策过程难以审计。一系列研究将 LLM 的决策行为蒸馏为决策树——用 LLM 对大量样本打标签,然后在该数据上训练决策树来近似 LLM 的决策边界。得到的规则树可以直接审查,发现 LLM 到底在”看”哪些特征(例如在文本分类中发现 LLM 过度依赖某些表面词汇)。这种”模型蒸馏为可解释代理”的思路在金融和医疗合规中极有价值。
- Born-again trees:Sagi & Rokach (2021) 提出将 XGBoost 等复杂树集成”蒸馏”为单棵可解释的决策树,在保持较高准确率的同时恢复可解释性。这一思路在 2024-2025 年进一步扩展到”将神经网络蒸馏为决策树”。
- LLM 辅助决策树构建:最新研究探索让 LLM 利用领域知识直接生成决策树规则或建议切分特征,将人类专家知识和数据驱动学习结合——例如在医疗场景中,LLM 可以根据医学文献建议”先按哪个检验指标切分”。
软决策树与神经决策树
Section titled “软决策树与神经决策树”传统决策树的切分是”硬”的(),不可微分,因此无法用梯度反向传播训练。软决策树(soft decision tree)用 sigmoid 函数将硬切分替换为概率路由:
其中 控制软硬程度( 退化为硬切分)。这使得整棵树可微分,可以与神经网络端到端联合训练。Frosst & Hinton (2017) 的”Distilling a Neural Network Into a Soft Decision Tree”开创了这一方向。2024-2025 年的最新工作包括:
- NODE(Neural Oblivious Decision Ensembles):用可微分的遗忘性决策树(oblivious decision tree,每层用同一个特征和阈值)构建集成,在表格数据上与 XGBoost 竞争。
- TabNet:基于稀疏注意力机制的决策树变体,结合了树的结构可解释性和神经网络的表达能力,支持端到端训练和特征选择。
联邦学习中的决策树
Section titled “联邦学习中的决策树”联邦学习(Federated Learning)要求在不共享原始数据的前提下联合训练模型。决策树在联邦学习中面临独特挑战:
- 切分点的计算需要聚合统计量:决策树需要找到最优切分阈值,而这需要所有客户端的数据分布信息。解决方案包括联邦直方图聚合——各客户端本地计算直方图,服务器聚合后找最优切分点。
- 隐私保护:即使只共享直方图,也可能泄露个体信息。2024-2025 年的研究结合差分隐私(differential privacy)和安全聚合协议,在隐私预算内高效训练联邦决策树。
- 联邦 GBDT:FedGBDT、SecureBoost 等框架已经将 GBDT 扩展到联邦场景,在银行跨机构反欺诈等场景中落地。SecureBoost 采用与 XGBoost 类似的直方图加速方法,但通信发生在加密域中。
斜决策树的新生
Section titled “斜决策树的新生”传统决策树只能做轴平行切分,对斜决策边界效率低。斜决策树(oblique decision tree)用特征的线性组合做切分(),能用更少的节点逼近复杂边界。2024 年的研究方向包括:
- 用优化算法(如线性规划、梯度下降)搜索最优斜切分。
- 结合神经网络自动学习切分超平面的方向。
- 在高维基因表达数据、医学影像特征等场景中,斜决策树比传统轴平行树有显著优势。
条件推断树的推广
Section titled “条件推断树的推广”Hothorn 等人的条件推断树框架因其无偏的特征选择(不受特征取值数量的影响)和内建的统计检验防过拟合机制,在 2025 年的因果推断和可解释 AI 领域获得更多关注。它被扩展到生存分析(conditional inference survival trees)、纵向数据(model-based recursive partitioning)等新场景。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| sklearn.tree.DecisionTreeClassifier / Regressor | Python | CART 实现,支持预剪枝与 ccp_alpha 后剪枝 |
| sklearn.tree.export_text / plot_tree | Python | 树规则文本输出与图形可视化 |
| XGBoost / LightGBM / CatBoost | Python / C++ | 基于决策树的梯度提升框架,工业界主力 |
| rpart | R | R 生态经典决策树包,支持代价复杂度剪枝 |
| party / ctree | R | 条件推断树(Conditional Inference Trees),无偏特征选择 |
| C5.0 / See5 | C / R | Quinlan 系列决策树商业实现,C4.5 的继任者 |
| graphviz / dtreeviz | Python | 决策树可视化工具,dtreeviz 能展示叶子内分布 |
| NODE / TabNet | Python | 神经决策树 / 可微决策树,支持端到端训练 |
| SecureBoost | Python | 联邦学习场景下的 GBDT 框架,加密域训练 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 决策树 | Decision Tree | 用递归切分构建的树形预测模型,每个内部节点是一个特征判断,叶子给出预测 |
| 根节点 | Root Node | 包含全部样本的起始节点 |
| 内部节点 | Internal Node | 对某特征做判断并分支的非叶节点 |
| 叶子节点 | Leaf / Terminal Node | 不再切分、给出预测结果的节点 |
| 信息增益 | Information Gain | 切分前后熵的下降量,衡量切分消除了多少不确定性,ID3 / C4.5 的切分准则 |
| 信息增益率 | Gain Ratio | 信息增益除以切分的固有值,修正了信息增益对多取值特征的偏好,C4.5 使用 |
| 基尼不纯度 | Gini Impurity | 节点内随机两样本异类的概率(或随机猜错的概率),CART 分类准则 |
| 熵 | Entropy | 信息论中的不确定度度量,值越大越混乱,ID3 / C4.5 用 |
| 固有值 | Intrinsic Value | 衡量切分把数据分成了多少份、每份多大,用于信息增益率的归一化 |
| 方差下降 | Variance Reduction | 回归树中切分前后目标值方差的下降量,等价于 MSE 下降 |
| 剪枝 | Pruning | 移除子树以控制复杂度,分预剪枝(提前停止生长)与后剪枝(先长后剪) |
| 预剪枝 | Pre-pruning | 在树生长过程中用超参数(如 max_depth)提前停止,简单但可能”目光短浅” |
| 后剪枝 | Post-pruning | 先充分生长再自底向上回剪,效果通常好于预剪枝但计算量更大 |
| 代价复杂度剪枝 | Cost-Complexity Pruning | CART 的后剪枝方法,用参数 平衡误差与叶子数,sklearn 通过 ccp_alpha 实现 |
| 不纯度 | Impurity | 衡量节点内类别混乱程度的指标(熵、Gini 等),值越小越纯 |
| CART | Classification and Regression Trees | Breiman 提出的二叉决策树算法,sklearn 选用,既做分类又做回归 |
| 软决策树 | Soft Decision Tree | 用 sigmoid 替代硬切分的可微分决策树,可与神经网络联合训练 |
| 斜决策树 | Oblique Decision Tree | 用特征线性组合做切分的决策树,能更高效地逼近斜决策边界 |
| 特征重要性 | Feature Importance | 特征在树中对不纯度下降的贡献总量,衡量特征的预测价值 |
| TDIDT | Top-Down Induction of Decision Trees | 自顶向下递归切分构建决策树的通用框架,几乎所有决策树算法的基础 |
| 条件推断树 | Conditional Inference Tree | 用统计检验选切分特征并校正多重比较的决策树,无偏且不需剪枝 |
| Born-again tree | Born-again Decision Tree | 将复杂集成模型蒸馏为单棵可解释决策树的技术 |
- Breiman, Friedman, Olshen & Stone,《Classification and Regression Trees》(1984):CART 的原始著作,决策树领域的奠基性文献,系统阐述切分准则与代价复杂度剪枝。
- Quinlan,“Induction of Decision Trees” (Machine Learning 1986):ID3 算法原始论文,引用量极高,决策树学习的开山之作。
- Quinlan, C4.5: Programs for Machine Learning (1993):C4.5 算法的完整阐述,引入信息增益率与缺失值处理。
- Hastie, Tibshirani & Friedman,《The Elements of Statistical Learning》第 9 章:从统计视角系统讲解决策树,并自然过渡到集成学习中的 bagging 与随机森林。
- Mingers,“An Empirical Comparison of Selection Measures for Decision-Tree Induction” (Machine Learning 1989):实验比较信息增益、Gini 等切分准则的效果差异,对实践调参很有启发。
- Grinsztajn, Oyallon, Varoquaux, “Why do tree-based models still outperform deep learning on tabular data?” (NeurIPS 2022):大规模基准测试,证明树模型在表格数据上仍是 SOTA。论文链接:arXiv:2207.08815。
- Hothorn, Hornik & Zeileis, “Unbiased Recursive Partitioning: A Conditional Inference Framework” (JCGS 2006):条件推断树的理论基础,解决传统决策树特征选择偏好的问题。
- Frosst & Hinton, “Distilling a Neural Network Into a Soft Decision Tree” (2017):软决策树的先驱工作,将神经网络蒸馏为可微决策树以提升可解释性。论文链接:arXiv:1711.09784。
- Sagi & Rokach, “Approximating XGBoost with an interpretable decision tree” (Information Sciences 2021):将 XGBoost 蒸馏为单棵决策树的 Born-again tree 方法。
- Hyafil & Rivest, “Constructing Optimal Binary Decision Trees is NP-complete” (Information Processing Letters 1976):证明了构建最优决策树是 NP 完全问题,解释了为什么实际算法都采用贪心策略。
- Murthy, “Automatic construction of decision trees from data: A multidisciplinary survey” (Data Mining and Knowledge Discovery 1998):决策树构建算法的全面综述,涵盖切分准则、搜索策略和剪枝方法。