
Mamba与状态空间模型
状态空间模型(State Space Model, SSM)是一条不同于 Transformer 的序列建模范式:用线性递推替代自注意力,在长序列上实现线性时间复杂度。Mamba(2023)通过”选择性”机制让 SSM 达到了与 Transformer 相当甚至更好的性能,成为最有竞争力的 Transformer 替代架构之一。前置阅读:RNN 循环神经网络、Transformer 架构、注意力机制。
把序列建模想象成”学生上课记笔记”:
- Transformer(自注意力)= 超级学霸,随时翻阅整学期所有课堂笔记做回答。信息全,但笔记越多翻得越慢(平方复杂度),且书包塞满(KV 缓存巨大)。
- RNN= 上课认真听讲但记性差的学生,把所有知识压缩进一个小本子(隐状态)。推理快(每步常数开销),但小本子装不下长学期的内容,容易遗忘。
- 经典 SSM(S4)= RNN 的升级版,用更大的、连续的”记忆本”(高维隐状态)并精细调节”更新规则”,记忆力强很多,但仍是不加选择地记下所有信息。
- Mamba(选择性 SSM)= 聪明的学生,上课时会判断”这段重要、那段可跳过”——根据输入动态调整记忆更新力度。遇到关键信息大开记忆闸门,遇到无关内容直接忽略。推理和 RNN 一样快(线性复杂度),但效果逼近 Transformer。
再用一个更技术的比喻:SSM 可以理解为一个可学习的递推滤波器。经典 SSM 是一个固定滤波器(参数不随输入变化),而 Mamba 是一个自适应滤波器(参数随当前输入动态调整),这正是它能逼近注意力机制选择性聚焦能力的关键。
连续状态空间模型
Section titled “连续状态空间模型”SSM 源于控制论中的状态空间方程。连续时间的 SSM 用两个方程描述一个一维函数到一维函数的映射,通过一个隐状态 h(t) 作为中间桥梁:
- 状态方程: —— 隐状态如何随时间连续演化
- 输出方程: —— 如何从隐状态读出输出
其中:
- h(t) 是 N 维隐状态向量(N 即 d_state,SSM 的”记忆容量”)
- x(t) 是标量输入,y(t) 是标量输出
- A 是 N×N 的状态转移矩阵,控制记忆的衰减与保持
- B 是 N×1 的输入投影矩阵,决定输入如何写入隐状态
- C 是 1×N 的输出投影矩阵,决定如何从隐状态读出信息
- D 是直连项(skip connection),通常合并到残差路径中,训练时只学习 A/B/C
在实际的多通道模型中,每个通道独立运行一个 SSM(类似深度可分离卷积的思路),所有通道共享 A 矩阵结构但参数独立。
线性投影(Linear Projection):用矩阵乘法将向量从一个维度空间变换到另一个维度空间。比如 B 矩阵把标量输入 x(t) 投影到 N 维隐状态空间。这是神经网络最基本的操作。
深度学习处理的是离散序列(token 序列),需要将连续时间 SSM 转换为离散递推步骤。最常用的是**零阶保持(Zero-Order Hold, ZOH)**方法。
零阶保持(Zero-Order Hold, ZOH):信号处理中将连续信号离散化的一种经典方法,假设输入信号在每个采样间隔 Delta 内保持不变(即 x(t) 在一个步长内是常数),在此基础上求解连续微分方程的解析解。
矩阵指数(Matrix Exponential):定义为 ,是对标量指数的自然推广。当 是对角矩阵时, 就是每个对角元素分别取指数。在 SSM 中,矩阵指数精确描述了线性连续系统离散化后的状态转移。
ZOH 离散化的完整公式如下:
化简后(利用 B 的维度),离散化的输入投影矩阵可以写成:
其中 Delta 是一个可学习的时间步长参数,控制离散化的粒度。Delta 大意味着每步覆盖的连续时间长、记忆更新幅度大;Delta 小则更新缓慢、记忆保持稳定。
当 A 是对角矩阵时(Mamba 实际使用的参数化),上述公式大幅简化:矩阵指数和矩阵求逆都退化为逐元素运算:
离散化后的递推公式变为:
- 状态更新:
- 输出读取:
这和 RNN 的递推形式完全一致——当前状态由上一时刻状态加当前输入决定。区别在于 SSM 的 A/B/C 有明确的连续数学起源(微分方程离散化),而 RNN 的权重是纯数据驱动的。
S4:结构化状态空间模型
Section titled “S4:结构化状态空间模型”S4(Gu et al., 2022)的关键创新有两点:
1. HiPPO 矩阵初始化。 S4 发现矩阵 A 的初始化对长程记忆至关重要。它使用一种称为 HiPPO(High-order Polynomial Projection Operators) 的特殊矩阵,其数学含义是:使有限维的隐状态 h(t) 能够以最小二乘意义近似记忆输入信号 x(t) 在整个历史区间上的积分。直觉上,HiPPO 矩阵相当于一组”遗忘曲线”——不同维度以不同速率衰减,高维负责记住近期信息,低维负责记住远期信息的摘要。
更准确地说,HiPPO 矩阵将输入信号投影到一组正交多项式基(如 Legendre 多项式)上,隐状态的每个分量对应一个多项式系数。这样 N 维隐状态就能精确近似一个连续函数的历史,N 越大近似精度越高。
2. 卷积视角与 FFT 并行。 当 A/B/C 固定(不随输入变化)时,整个 SSM 递推等价于一个(非常长的)一维卷积。具体地,展开递推公式后:
这可以写成 ,其中卷积核 。由于是卷积,可以用 FFT(快速傅里叶变换)在 时间内并行计算训练时所有位置的输出,彻底解决了 RNN 无法并行训练的核心痛点。
S4 在 Long Range Arena(LRA)等长序列基准上大幅超越 Transformer(如在 Path-X 任务上 Transformer 几乎随机,S4 接近完美),但在语言建模等离散序列任务上效果一般——因为 LRA 的模式是全局固定的,而语言需要选择性。
Mamba:选择性状态空间模型
Section titled “Mamba:选择性状态空间模型”Mamba(Gu and Dao, 2023)的核心洞察:经典 SSM(包括 S4)的 A/B/C 是固定的(不随输入变化),这限制了模型的选择性推理能力——它无法根据内容决定”记住什么、忽略什么”。Mamba 让 B、C、Delta 成为输入的函数(即”选择性的”),而 A 保持固定。
选择性参数的生成过程:
对于每个时间步的输入 x(t)(维度为 d_model),Mamba 通过独立的线性投影生成选择性参数:
其中 softplus(z) = log(1 + exp(z)) 保证 Delta 始终为正数(因为 Delta 是时间步长,必须大于零)。
门控机制(Gating):用一个分支的输出控制另一个分支的通过比例,类似”阀门”。选择性机制本质上就是一种门控——Delta 充当”输入阀门”(控制多少新信息写入记忆),C 充当”输出阀门”(控制从记忆中读取哪些部分)。
直觉上:
- 当输入信息重要时,模型可以让 Delta 变大(大开记忆闸门)、B 变大(多写入),从而记住关键信息。
- 当输入是噪声或无关内容时,Delta 变小(关闭闸门),旧记忆不受干扰。
- C 的变化则让模型能从隐状态中选择性读取与当前相关的信息。
这使 Mamba 具有类似注意力的选择性聚焦能力,同时保持线性的时间复杂度。
对角矩阵 A 的参数化。 Mamba(以及 S4D、S5 等后续工作)将 A 限制为对角矩阵——即 A 只有 N 个对角元素有值,其余为零。这带来巨大的计算优势:
- 完整矩阵的 A_bar = exp(Delta · A) 需要 O(N³) 计算(矩阵指数)
- 对角矩阵的 A_bar 退化为逐元素 exp,只需 O(N) 计算
- 隐状态更新从矩阵-向量乘法 O(N²) 降为逐元素乘法 O(N)
代价是表达能力降低(N 维对角矩阵只有 N 个自由参数,而完整矩阵有 N² 个),但实验表明配合选择性 B/C 和足够的 d_state,对角参数化已经足够强。
硬件感知的并行扫描
Section titled “硬件感知的并行扫描”为什么 Mamba 训练时可以并行而 RNN 不行? 这是理解 Mamba 工程价值的关键。
传统 RNN 的参数是固定的(共享于所有时间步),但递推本身是串行的——h(t) 依赖 h(t-1),看起来无法并行。然而关键在于:RNN 每步的计算虽然简单,但梯度反向传播需要”沿时间展开”(BPTT),序列越长、计算图越深,效率越低且梯度不稳定。
Mamba 的选择性 SSM 看似更复杂(B/C/Delta 随位置变化),但它有一个关键性质:一旦所有位置的 B(t)/C(t)/Delta(t) 都已计算好,递推 h(t) = A_bar(t) · h(t-1) + B_bar(t) · x(t) 就是一个线性递推,满足结合律,可以用关联扫描(associative scan)算法并行化。
关联扫描的核心原理:递推 h(t) = a(t) · h(t-1) + b(t) 可以分解为一个可结合的二元运算:
由于这个运算满足结合律(类似加法和乘法),可以用经典的**并行前缀和(parallel prefix sum)**算法并行计算:将序列分成多段,各段独立递推,再合并段间结果。
时间复杂度分析:
- 串行递推:N 步(无法并行)
- 并行扫描(P 个处理器):O(N / P) 步,总工作量 O(N log N)
- 当 P 足够大时(GPU 有数千核心),实际延迟接近 O(log N)
配合 SRAM 分块计算(类似 FlashAttention 的思路)——将序列分成小块在 GPU 的快速 SRAM 中完成扫描,避免对全局显存的反复读写——Mamba 的实现在 A100/H100 GPU 上达到了极高的计算效率,实际吞吐量在长序列上数倍于同规模的 Transformer。
Mamba 架构
Section titled “Mamba 架构”Mamba 将选择性 SSM 块嵌入到一个类似 Transformer block 的结构中。以下是一个 Mamba block 的完整数据流和维度变化(以 d_model=512、expand=2、d_state=16 为例):
第 0 步:残差入口。 输入 x(形状 [batch, seq_len, d_model],即 [B, L, 512])直接跳过整个 block,作为残差备用。
残差连接(Residual Connection):输入直接跳过某些层与输出相加,即 output = F(x) + x。这缓解深层网络中的梯度消失问题,使梯度能直接回流到早期层,是现代深度网络能训深的关键技术。
梯度消失(Vanishing Gradient):深层网络中梯度在反向传播时逐层衰减(每层乘以一个小于 1 的因子),导致靠近输入的底层几乎不更新,网络无法学习。残差连接通过提供梯度”高速公路”来缓解此问题。
第 1 步:线性投影扩展维度。 x 经过一个线性层从 d_model(512)扩展到 d_model * expand(512 * 2 = 1024)。扩展因子 expand 通常为 2。这类似于 Transformer FFN 中的中间维度扩展,给 SSM 更多”工作空间”。
第 2 步:分两路。 扩展后的向量(形状 [B, L, 1024])分成两条分支,各走各的变换:
- SSM 分支(“主路径”):先经过 1D depthwise conv → 选择性 SSM → 输出 [B, L, 1024]
- 门控分支(“阀门路径”):经过 SiLU 激活 → 输出 [B, L, 1024]
第 3 步:SSM 分支的内部流程。
3a. 1D depthwise conv:对扩展后的向量做一维深度可分离因果卷积(核大小 d_conv,通常为 4)。
深度可分离卷积(Depthwise Convolution):每个输入通道独立做卷积,不做通道间的混合。标准卷积的参数量是 kernel_size × in_channels × out_channels,而 depthwise 只需 kernel_size × channels,参数量少得多。这里用 depthwise 是因为通道间混合交给后续的线性投影完成,卷积只负责局部时序模式。
1D conv 的作用是提取局部时序模式,弥补 SSM 对局部信息的不敏感——SSM 的递推天然侧重长程依赖,对相邻 token 的局部 n-gram 关系建模不够直接。d_conv=4 意味着每个位置能看到前 3 个邻居。
3b. 选择性 SSM 计算。 卷积输出([B, L, 1024])进入选择性 SSM:
- 用一个线性层从 d_model*expand(1024)投影生成 B([B, L, d_state=16])和 C([B, L, d_state=16])
- 用一个线性层投影生成 Delta 标量([B, L, 1024]),经 softplus 保证为正
- 用预定义的对角矩阵 A(d_state=16 维),按上述 ZOH 公式计算 A_bar 和 B_bar
- 执行并行扫描,计算每个位置的隐状态 h(t) 和输出 y(t) = C(t) · h(t)
- 输出形状为 [B, L, 1024]
第 4 步:门控分支与 SiLU。 另一条分支经过 SiLU 激活函数:
为什么用 SiLU 而不是 ReLU? SiLU(也叫 Swish)是 x · sigmoid(x),具有平滑、非单调的特性。相比 ReLU 的硬截断(x < 0 时直接为 0),SiLU 允许少量负值通过,梯度处处非零,训练更稳定。Google 的研究表明 SiLU 在深层网络中一致优于 ReLU。Transformer 中的 SwiGLU 激活也基于 SiLU。
门控分支的作用是充当”阀门”——它的输出与 SSM 分支逐元素相乘,动态控制 SSM 输出的每个维度通过多少。这类似于 LSTM 中的输出门。
第 5 步:逐元素相乘。 SSM 分支输出和门控分支输出逐元素相乘(都是 [B, L, 1024])。
第 6 步:线性投影回原维度。 相乘结果经线性层从 d_model * expand(1024)投影回 d_model(512)。
第 7 步:残差相加。 投影输出与第 0 步的残差输入相加:output = MambaBlock(x) + x。最终输出形状 [B, L, 512],与输入完全一致。
多个这样的 block 堆叠(通常 12-64 层)构成完整的 Mamba 语言模型。
Mamba-2 与结构化对偶性
Section titled “Mamba-2 与结构化对偶性”Mamba-2(Dao and Gu, 2024)揭示了一个深刻的数学关系:结构化的 SSM 可以等价表示为一种特殊的(线性)注意力形式,反之亦然。
结构化对偶性(Structured State Space Duality, SSD):Mamba-2 证明的核心定理——当 SSM 的状态矩阵 A 满足某种结构约束时,SSM 的前向计算可以重写为一个注意力矩阵与值向量相乘的形式。这统一了 SSM 和 Transformer 的理论框架,意味着 SSM 不是 Transformer 的”替代品”,而是广义注意力家族的一个特例。
这一发现的实际意义:
- 更高效的计算:Mamba-2 利用对偶性开发了新的计算路径,在保持选择性的同时,训练速度比 Mamba-1 快 2-8 倍
- 更大的状态维度变得可行:Mamba-1 的 d_state 通常限制在 16-64,Mamba-2 可以用 128 或 256 甚至更大
- 理论统一:SSM 和注意力不再是对立范式,而是同一个数学框架的不同实例
Transformer vs RNN vs Mamba
Section titled “Transformer vs RNN vs Mamba”三种架构的特性对比
Section titled “三种架构的特性对比”| 特性 | Transformer | RNN | Mamba (SSM) |
|---|---|---|---|
| 训练复杂度 | O(N²) | O(N)(但串行) | O(N)(可并行) |
| 推理复杂度(每步) | O(N)(需遍历KV缓存) | O(1) | O(1) |
| 推理时显存(KV/状态) | O(N) 随序列增长 | O(1) 固定 | O(1) 固定 |
| 并行训练 | 支持 | 不支持 | 支持(并行扫描) |
| 长程依赖 | 强(但受位置编码限制) | 弱(梯度消失) | 强(结构化记忆) |
| 选择性聚焦 | 强(注意力权重) | 弱 | 强(选择性参数) |
Mamba block 结构
Section titled “Mamba block 结构”选择性 SSM 内部数据流
Section titled “选择性 SSM 内部数据流”SSM 隐状态演化可视化
Section titled “SSM 隐状态演化可视化”下面的可视化展示了 SSM 中隐状态 h(t) 如何随时间步递推演化:上图为 4 个隐状态维度的变化曲线,下图为对应的输入信号 x(t)(橙色为”重要”输入,蓝色为”噪声”输入)。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
np.random.seed(42)
T = 24       # 时间步数d_state = 4  # 可视化的隐状态维度
# 对角状态转移矩阵 A_bar(衰减因子)A_bar = np.array([0.90, 0.85, 0.78, 0.92])
# 输入信号:大部分为噪声,少量重要尖峰x = np.random.randn(T) * 0.3important_steps = [3, 10, 17]for idx in important_steps:    x[idx] = np.random.choice([-1, 1]) * (2.0 + np.random.rand())
# 选择性参数 Delta:重要输入大,噪声小delta = np.full(T, 0.1)for idx in important_steps:    delta[idx] = 1.5
B_bar = np.array([0.5, -0.4, 0.6, -0.3])
# 递推:h(t) = A_bar_eff * h(t-1) + B_bar_eff * x(t)h = np.zeros((T + 1, d_state))for t in range(1, T + 1):    A_eff = np.exp(-delta[t - 1] * (1.0 - A_bar))    B_eff = B_bar * delta[t - 1]    h[t] = A_eff * h[t - 1] + B_eff * x[t - 1]
fig, (ax1, ax2) = plt.subplots(2, 1, figsize=(10, 6),                                gridspec_kw={"height_ratios": [3, 1.2]})colors = ["#2196F3", "#FF5722", "#4CAF50", "#9C27B0"]for i in range(d_state):    ax1.plot(h[:, i], color=colors[i], linewidth=2, marker="o",             markersize=3, label=f"h_{i}(t)")for idx in important_steps:    ax1.axvspan(idx + 0.5, idx + 1.5, alpha=0.12, color="#FF9800")ax1.set_title("SSM Hidden State Evolution Over Time Steps",              fontsize=12, fontweight="bold")ax1.legend(fontsize=9)ax1.grid(True, alpha=0.2)
bar_colors = ["#FF5722" if t in important_steps else "#90CAF9"              for t in range(T)]ax2.bar(np.arange(1, T + 1), x, color=bar_colors, width=0.7)ax2.set_xlabel("Time Step t")ax2.set_ylabel("Input x(t)")plt.tight_layout()plt.savefig("mamba-ssm-state-evolution.png", dpi=180,            bbox_inches="tight", facecolor="white")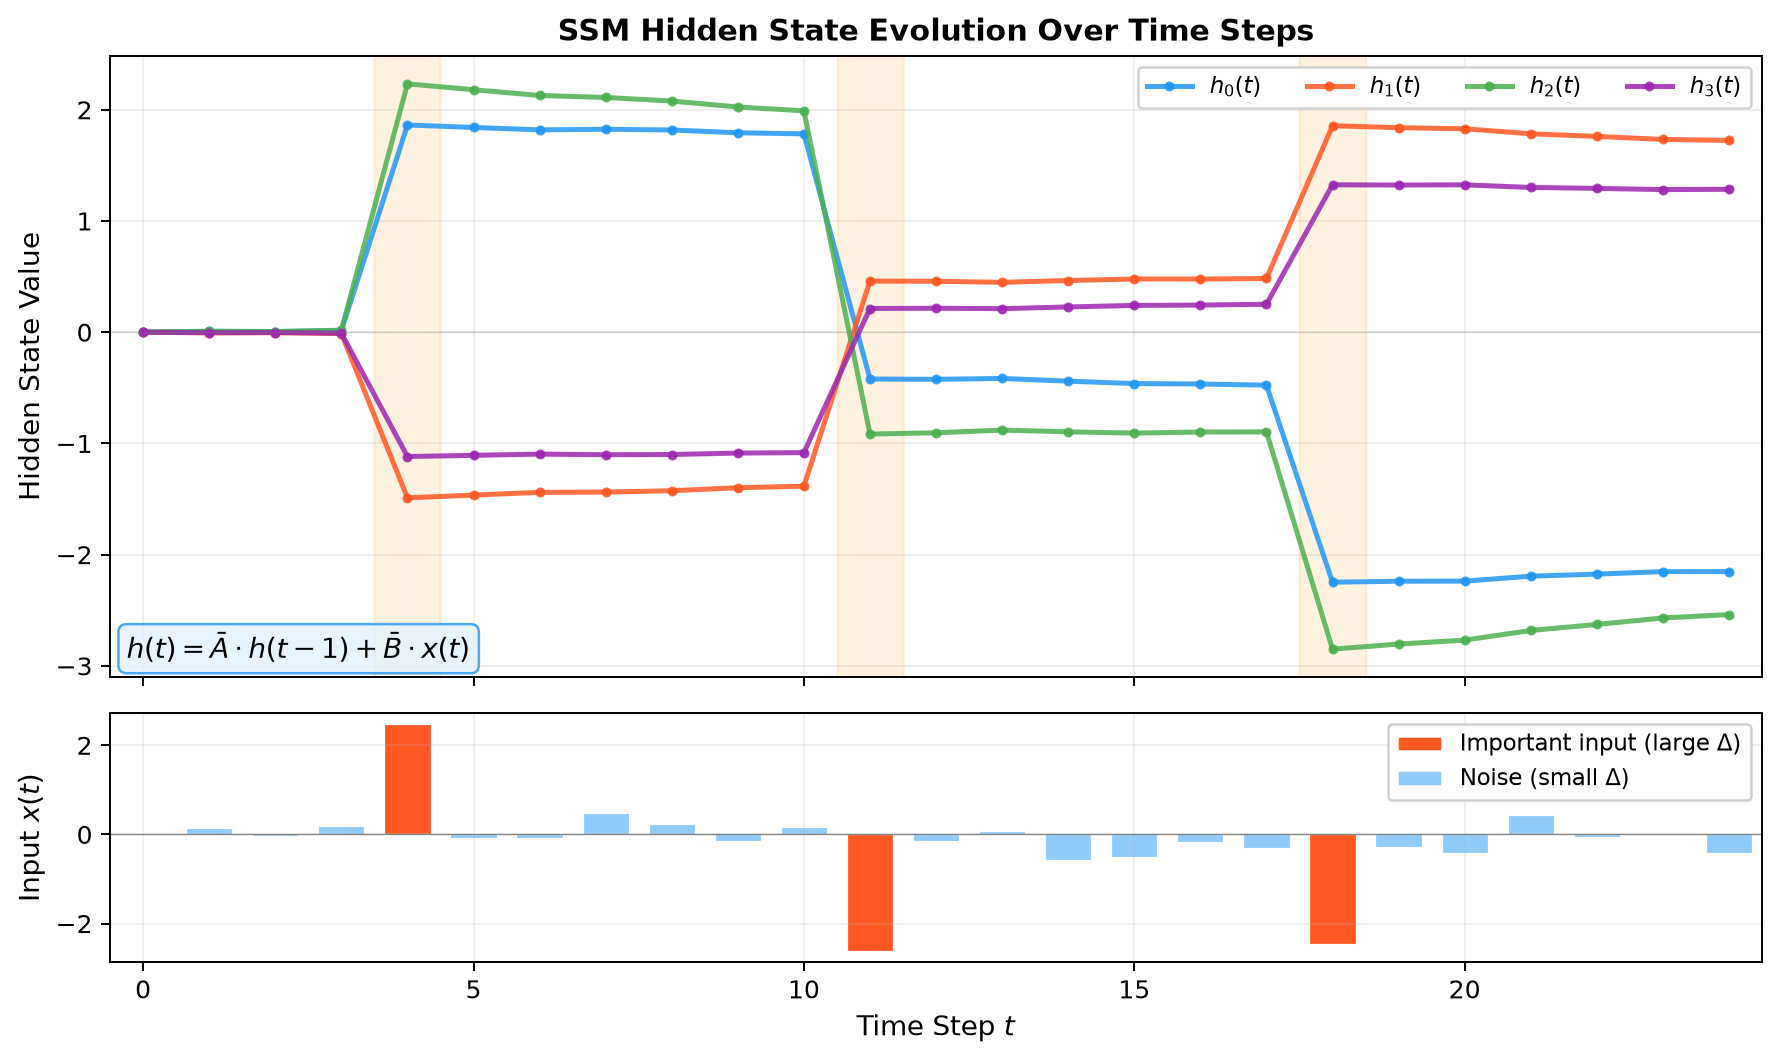
PyTorch:用 mamba-ssm 库创建 Mamba 模型
Section titled “PyTorch:用 mamba-ssm 库创建 Mamba 模型”import torchfrom mamba_ssm import Mamba # pip install mamba-ssm causal-conv1d
# 单个 Mamba blockblock = Mamba( d_model=512, # 模型维度 d_state=16, # SSM 隐状态维度 d_conv=4, # 局部卷积核大小 expand=2, # 内部扩展因子).cuda()
# 模拟输入:batch=2, 序列长度=128, d_model=512x = torch.randn(2, 128, 512).cuda()y = block(x) # 输出形状 2×128×512,与输入相同print(y.shape) # torch.Size([2, 128, 512])
# 多层堆叠构成语言模型layers = [Mamba(d_model=512, d_state=16, d_conv=4, expand=2).cuda() for _ in range(12)]h = xfor layer in layers: h = layer(h) # 逐层处理print(f"输出形状: {h.shape}") # torch.Size([2, 128, 512])numpy 手写简化 SSM 递推
Section titled “numpy 手写简化 SSM 递推”import numpy as np
# 最简单的离散 SSM 递推(非选择性,参数固定)N, d = 100, 8 # 序列长度 100,状态维度 8A = 0.9 * np.eye(d) # 状态转移矩阵(保持稳定)B = np.random.randn(d, 1) # 输入投影C = np.random.randn(1, d) # 输出投影x = np.random.randn(N, 1) # 输入序列
h = np.zeros(d) # 初始隐状态outputs = []for t in range(N): h = A @ h + B.flatten() * x[t] # 状态更新(递推) y = C @ h # 输出 outputs.append(y[0])print(f"最终隐状态范数: {np.linalg.norm(h):.4f}")print(f"前 5 个输出: {outputs[:5]}")numpy 手写选择性 SSM(Mamba 核心逻辑)
Section titled “numpy 手写选择性 SSM(Mamba 核心逻辑)”import numpy as np
# 简化的选择性 SSM:B/C/Delta 随输入变化(Mamba 的核心思想)seq_len, d_model, d_state = 20, 8, 4
# 模拟输入序列x = np.random.randn(seq_len, d_model)
# 可学习的投影权重(简化版,实际 Mamba 先扩展维度再投影)W_B = np.random.randn(d_model, d_state) * 0.1 # 生成 BW_C = np.random.randn(d_model, d_state) * 0.1 # 生成 CW_delta = np.random.randn(d_model, 1) * 0.1 # 生成 Delta
# 固定的对角 A 矩阵(用 HiPPO 或 S4D 初始化,这里随机模拟)A = -np.exp(np.random.randn(d_state)) # 负值保证稳定性
# 选择性递推h = np.zeros(d_state)outputs = []for t in range(seq_len): # —— 选择性参数随输入变化 —— B_t = x[t] @ W_B # [d_state] C_t = x[t] @ W_C # [d_state] delta_t = np.log1p(np.exp(x[t] @ W_delta)) # softplus,保证为正 [1]
# —— ZOH 离散化(对角矩阵简化版,逐元素) —— A_bar = np.exp(delta_t * A) # [d_state] B_bar = B_t * delta_t # [d_state](简化)
# —— 状态更新与输出 —— h = A_bar * h + B_bar * x[t, 0] # 逐元素更新(对角矩阵) y = np.dot(C_t, h) # 标量输出 outputs.append(y)
print(f"前 5 个 Delta 值: {[np.log1p(np.exp(x[t] @ W_delta))[0] for t in range(5)]}")print(f"最终隐状态: {h}")print(f"输出范围: [{min(outputs):.3f}, {max(outputs):.3f}]")这段代码展示了 Mamba 选择性机制的本质:每个时间步的 B、C、Delta 都由当前输入动态生成,这正是 Mamba 区别于 S4 的关键。
训练技巧与优化
Section titled “训练技巧与优化”Mamba 的训练对初始化比较敏感,以下是经过验证的最佳实践:
- A 矩阵初始化:通常用 HiPPO 初始化(S4 论文中的方法)或 S4D 初始化(对角版本,更简单)。S4D 的做法是将 A 初始化为复平面上特定区域的负实数值,确保记忆的多尺度衰减特性。Mamba 官方代码中 A 默认在复数域初始化。
- B/C 投影层初始化:使用标准的截断正态分布初始化(类似 PyTorch 默认)。
- Delta 投影层初始化:这是 Mamba 特有的关键参数。官方实现对 Delta 的线性层用较小的初始化(标准差按 1/sqrt(d_model) 缩放),使初始 Delta 接近一个温和的默认值。
学习率与优化器
Section titled “学习率与优化器”- 学习率调度:Mamba 的学习率通常与 Transformer 类似,采用 warmup + cosine decay。典型设置:warmup 2000-5000 步线性增长到峰值(如 3e-4),然后余弦衰减到峰值的 1/10。
- 优化器:AdamW,beta1=0.9, beta2=0.95(与 GPT 训练一致),权重衰减 0.1。
- 梯度裁剪:通常裁剪到 1.0,防止选择性参数的偶发大梯度。
- 与 Transformer 的差异:Mamba 对学习率稍更敏感(尤其 Delta 参数),但整体优化行为与 Transformer 相似,不需要特别的 trick。
超参数选择建议
Section titled “超参数选择建议”| 超参数 | 典型值 | 说明 |
|---|---|---|
| d_model | 512-4096 | 模型主维度,与同规模 Transformer 一致 |
| d_state | 16-128 | SSM 隐状态维度,控制记忆容量。语言建模 16-64 即可,长序列任务可增大 |
| d_conv | 4 | 局部卷积核大小,4 是经验最优值,一般不需调整 |
| expand | 2 | 内部扩展因子,2 是默认值,部分模型用 4 |
| 层数 | 12-64 | 与 Transformer 类似,按参数量需求调整 |
经验法则:对于语言建模,d_state=16 配合 d_model=1024 已经能匹配同参数量 Transformer 的性能。在 DNA、音频等极长序列任务上,增大 d_state 到 64-128 会带来明显提升。
FLOPs 与显存对比
Section titled “FLOPs 与显存对比”对于序列长度 N、模型维度 d、层数 L:
| 指标 | Transformer | Mamba |
|---|---|---|
| 训练 FLOPs | ~O(N² · d · L) | ~O(N · d · d_state · L) |
| 训练显存(激活) | O(N² · L)(注意力矩阵) | O(N · d · L) |
| 推理 KV/状态显存 | O(N · d · L),随生成长度增长 | O(d · L),固定不增长 |
| 推理每步延迟 | 随序列增长(需扫描KV缓存) | 常数,与已生成长度无关 |
Mamba 在推理时的关键优势:隐状态大小固定,不随上下文长度增长。Transformer 生成第 N 个 token 时需要与所有前 N-1 个 token 做注意力,KV 缓存线性增长;Mamba 只需维护一个固定的 d_state 维隐状态,每个新 token 的处理开销恒定。
由于纯 Mamba 在精确信息检索(needle-in-haystack)任务上仍有不足,实践中常采用混合架构——交替堆叠 SSM 层和注意力层:
- Jamba(AI21 Labs):每 8 层中放 7 层 Mamba + 1 层注意力(部分层还加入 MoE),在保持效率的同时获得精确检索能力
- Zamba:类似的混合策略,注意力层共享同一组 KV 投影以减少参数
- 经验配比:通常 75%-87.5% 的层用 SSM,12.5%-25% 用注意力,注意力层均匀间隔放置。这样总计算量接近纯 SSM,但关键检索能力由注意力层补足
- Mamba 的优势在长序列:在序列长度 8K 以上的场景(DNA 序列、音频、长文本),Mamba 的推理速度和显存效率明显优于 Transformer。短序列(512 以下)优势不大。
- d_state 是关键超参数:SSM 隐状态维度(通常 16-256)控制记忆容量。更大 d_state 记忆更多但计算更贵。Mamba 默认 d_state=16,在语言建模中效果已经不错。
- 混合架构是趋势:Jamba(AI21)、Zamba 等模型将 Mamba 层和注意力层交替堆叠,兼得 SSM 的效率和注意力的精确检索能力。实践证明纯 Mamba 在某些需要精确查找的任务上不如 Transformer。
- 选择性是核心:Mamba 相比 S4 的关键提升就来自选择性(输入相关的参数)。如果去掉选择性退回固定参数 SSM,在语言建模上效果显著下降。
- 部署生态仍在完善:mamba-ssm 库需要较新的 CUDA 版本,推理框架(vLLM、TensorRT-LLM)对 Mamba 的支持正在逐步跟上,但不如 Transformer 成熟。
- 推理吞吐优势显著:由于隐状态固定,Mamba 在高并发推理场景(如 API 服务)中吞吐量可达同规模 Transformer 的 3-5 倍,尤其受益于连续批处理(continuous batching)。
- 长文本语言建模:Mamba 在 Pile、WikiText-103 等长文本基准上以更少参数匹配或超越 Transformer。详见语言模型演进。
- 基因组序列分析:DNA 序列动辄数十万碱基,S4/Mamba 的线性复杂度在此场景优势巨大(Caduceus 模型)。
- 音频生成与处理:音频序列极长(采样率 44.1kHz 下每秒 4 万多个点),SSM 在音频建模上天然有优势。
- 时序预测:金融、气象等长时序预测任务,Mamba 的递推特性天然适合。详见时间序列分析。
- 视觉模型骨干:Vision Mamba(Vim)、VMamba 等将 SSM 用于图像理解,探索非 Transformer 的视觉架构。
- 医学图像分析:医学影像(CT、MRI)通常分辨率极高(512×512 以上),Vision Mamba 的线性复杂度在处理高分辨率医学图像时比 ViN(Vision Transformer)效率更高,已在分割和分类任务中展现竞争力。
最新进展(2024-2026)
Section titled “最新进展(2024-2026)”Mamba 发表后,SSM 范式在多个方向快速扩展,以下是 2024-2026 年的重要进展:
- Mamba-2(Dao and Gu, 2024):通过结构化对偶性(SSD)统一了 SSM 与注意力,训练速度提升 2-8 倍,支持更大的 d_state(128+),是目前 SSM 的主力架构。
- Jamba(AI21 Labs, 2024):52B 参数的混合 Mamba-Transformer-MoE 模型,活跃参数 12B,上下文窗口 256K。是第一个达到 Transformer 级规模的 SSM 混合大模型,证明了 SSM 在超大规模下的可行性。
- Falcon-Mamba(TII, 2024):7B 参数的纯 Mamba 语言模型(不含任何注意力层),展示了纯 SSM 架构在中型规模语言模型上的潜力,在长上下文基准上表现出色。
- Zamba2(Zyphra, 2024):进一步优化的混合架构,在更小参数量下达到 Transformer 同级性能。
- Vision Mamba(Vim):将 Mamba 用于视觉任务,核心思路是将 2D 图像展平为 1D 序列(类似 ViT 的 patch 化),然后输入 Mamba block。双向扫描(正向+反向)弥补单向递推的信息流限制。
- VMamba:引入2D 选择性扫描(SS2D)和交叉扫描机制——从四个方向(上→下、下→上、左→右、右→左)分别扫描图像,聚合后获得全图的感受野。在 ImageNet 分类、COCO 检测等任务上接近 Swin Transformer。
- MambaVision(微软, 2024):Vision Mamba 的改进版,采用分层架构(类似 ResNet/Swin 的多尺度金字塔),在图像分类和下游任务上超越了同规模 Transformer。
- U-Mamba / SegMamba:将 SSM 用于医学图像分割,在 3D 医学影像(如 CT 体数据)的长序列建模上展现出优于 CNN 和 Transformer 的效率。
推理效率与长上下文
Section titled “推理效率与长上下文”- KV 缓存不增长:这是 Mamba 相对 Transformer 在推理时的根本优势。Transformer 的 KV 缓存随上下文长度线性增长(128K 上下文下 KV 缓存可达数十 GB),而 Mamba 的隐状态固定(通常 d_state × 层数,仅几 MB),使其在极长上下文场景下的显存和延迟都远优于 Transformer。
- 吞吐量优势:在批量推理场景下,Mamba 的吞吐量可达同规模 Transformer 的 3-5 倍(因为每步计算不随历史长度增长)。
- 连续批处理友好:由于状态固定,不同长度的请求可以无缝混合批处理,不像 Transformer 需要为不同序列长度管理变长 KV 缓存。
仍待解决的问题
Section titled “仍待解决的问题”- 精确信息检索:在 needle-in-haystack(大海捞针)等需要精确定位单个信息的任务上,纯 Mamba 仍不如 Transformer。这被认为是 SSM 的固有局限——信息被压缩到有限维隐状态后,精确召回困难。混合架构(如 Jamba)是目前的主流解法。
- 复制与精确计数:需要精确复制序列中远距离内容、或精确计数的任务,SSM 表现不佳,理论分析表明这与隐状态的信息瓶颈有关。
- 生态成熟度:推理框架、量化、蒸馏等工具链对 SSM 的支持仍落后于 Transformer 数年。
- 理论理解不充分:选择性 SSM 为什么在语言建模上有效、其表达能力边界在哪里,目前仍缺乏像注意力机制那样深入的理论分析。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| mamba-ssm | Python | Albert Gu 和 Tri Dao 的官方 Mamba 实现,含训练和推理代码 |
| causal-conv1d | Python | Mamba 使用的因果 1D 卷积 CUDA kernel,Tri Dao 维护 |
| s4 | Python | S4 原始实现,Gu 等维护,含 HiPPO 矩阵等核心组件 |
| triton | Python | Mamba 的选择性扫描 kernel 用 Triton 实现,支持自定义硬件优化 |
| jax | Python | S4 的原始 JAX 实现和多数 SSM 研究代码基于 JAX |
| vim | Python | Vision Mamba 官方实现,含图像分类和检测代码 |
| vmamba | Python | VMamba 官方实现,含 SS2D 交叉扫描模块 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 状态空间模型 | State Space Model, SSM | 用状态方程描述序列动力学的模型,源自控制论 |
| 隐状态 | Hidden State | SSM/RNN 内部的记忆向量,编码历史信息 |
| 选择性 | Selectivity | Mamba 的核心机制,让 SSM 参数随输入动态变化 |
| HiPPO 矩阵 | HiPPO Matrix | S4 提出的特殊状态转移矩阵初始化,能高效压缩长程历史 |
| 离散化 | Discretization | 将连续时间 SSM 转换为离散递推步骤的过程 |
| 并行扫描 | Parallel Scan | GPU 上高效并行计算递推的算法,Mamba 的训练加速基础 |
| 线性复杂度 | Linear Complexity | 计算量与序列长度成正比,远优于 Transformer 的平方复杂度 |
| 对偶性 | Duality | Mamba-2 揭示的 SSM 与线性注意力之间的等价关系 |
| 结构化SSM | Structured SSM | 对状态矩阵施加结构约束(如对角化)以降低计算复杂度的 SSM |
| 混合架构 | Hybrid Architecture | 交替使用 SSM 层和注意力层的模型(如 Jamba) |
| 零阶保持 | Zero-Order Hold, ZOH | 信号处理中将连续信号离散化的方法,假设信号在采样间隔内保持不变 |
| 残差连接 | Residual Connection | 输入跳过某些层直接与输出相加,缓解梯度消失 |
| 深度可分离卷积 | Depthwise Convolution | 每个输入通道独立做卷积,不做通道间混合,参数量远少于标准卷积 |
| 门控机制 | Gating | 用一个分支控制另一个分支通过比例的机制,类似”阀门” |
| 结构化对偶性 | Structured State Space Duality, SSD | Mamba-2 揭示的 SSM 与线性注意力在数学上的等价对应关系 |
- Gu et al.,「Efficiently Modeling Long Sequences with Structured State Spaces」(ICLR 2022):S4 论文,引入 HiPPO 初始化和结构化 SSM,在长序列基准上首次大幅超越 Transformer。
- Gu and Dao,「Mamba: Linear-Time Sequence Modeling with Selective State Spaces」(2023):Mamba 原始论文,核心创新是选择性机制,在语言建模、音频、基因组上全面匹配或超越同规模 Transformer。
- Dao and Gu,「Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality」(ICML 2024):Mamba-2 论文,揭示 SSM 与注意力的对偶关系,进一步优化硬件效率。
- AI21 Labs,「Jamba: A Hybrid Transformer-Mamba Language Model」(2024):混合架构大模型,交替使用 Mamba 和注意力层,展示了 SSM 在超大规模模型中的可行性。
- Wang et al.,「Mamba-ND: Selective State Space Models for Multi-Dimensional Data」(2024):将 Mamba 扩展到多维数据(图像、视频),展示了 SSM 超越一维序列的潜力。
- Lieber et al.,「Jamba: A Hybrid Transformer-Mamba Language Model」(2024):AI21 的技术报告,详细描述了 52B 混合架构的设计和训练细节。
- Zhu et al.,「Vision Mamba: Efficient Visual Representation Learning with Bidirectional State Space Model」(2024):Vision Mamba(Vim),将 Mamba 用于视觉,双向扫描处理 2D 图像。
- Liu et al.,「VMamba: Visual State Space Model」(2024):引入 2D 选择性扫描和交叉扫描机制,是 Vision SSM 的代表作。