
模型量化技术
模型量化是一种通过降低模型参数数值精度(例如从 FP16 降到 INT8 甚至 INT4)来压缩模型体积、加速推理的技术,是大语言模型在消费级硬件上高效部署的关键手段。
可以把量化想象成”把高清照片压缩成 JPEG”。原始照片的每个像素可能用 24 位色彩表示,信息极其丰富但体积庞大;JPEG 通过丢弃人眼难以察觉的细节,把文件压缩到十分之一甚至更小,而看起来几乎没有差别。量化做的是类似的事:神经网络里的权重本来用 16 位甚至 32 位浮点数存储,但相邻权重之间的微小差异对最终输出影响极小。量化把这些浮点数”四舍五入”到更少的几个离散档位上(比如 256 档对应 INT8,16 档对应 INT4),从而同时减少存储和计算开销。关键在于:只要选对档位(让重要的数值落得准),模型能力几乎不下降。
另一个有用的类比是”用直尺量身高”。如果直尺的最小刻度是 1 毫米(高精度浮点),你能量出 175.3 毫米;但如果只需要知道这个人有没有到 1.7 米,一把只有厘米刻度的尺子(低精度整数)就完全够用了。量化本质上就是在问:“我们真的需要那么多小数位吗?”
量化的数学本质
Section titled “量化的数学本质”量化的核心是把一段连续的浮点数区间映射到有限个整数档位上。给定一组数值的范围 min 和 max,目标位宽为 bit(例如 8 或 4),档位总数为 (例如 8 位有 256 档)。
量化过程(从浮点到整数):
反量化过程(用整数恢复出近似的浮点数):
其中 scale(缩放因子)决定了每一档代表多大的浮点跨度,zero_point(零点)用来让浮点的零值精确对应到某个整数,避免零点附近的误差累积。
让我们用一个具体例子来走一遍。假设有一组 4 个权重值 [-1.2, 0.0, 0.5, 2.0],要把它们量化到 INT4(4 位整数,范围 0~15,共 16 档):
第 1 步:确定范围  min = -1.2, max = 2.0
第 2 步:计算 scale 和 zero_point  scale = (2.0 - (-1.2)) / (16 - 1) = 3.2 / 15 ≈ 0.2133  zero_point = round(-min / scale) = round(1.2 / 0.2133) ≈ round(5.625) = 6
第 3 步:逐个量化  q(-1.2) = round(-1.2 / 0.2133) + 6 = round(-5.625) + 6 = -6 + 6 = 0  q(0.0)  = round(0.0 / 0.2133) + 6  = round(0) + 6 = 0 + 6 = 6  q(0.5)  = round(0.5 / 0.2133) + 6  = round(2.344) + 6 = 2 + 6 = 8  q(2.0)  = round(2.0 / 0.2133) + 6  = round(9.375) + 6 = 9 + 6 = 15
第 4 步:反量化验证  x̂(0) = 0.2133 × (0 - 6) = -1.28   (原始 -1.2, 误差 0.08)  x̂(6) = 0.2133 × (6 - 6) = 0.0     (原始 0.0, 误差 0)  x̂(8) = 0.2133 × (8 - 6) = 0.427   (原始 0.5, 误差 0.073)  x̂(15) = 0.2133 × (15 - 6) = 1.92  (原始 2.0, 误差 0.08)
可以看到,4 位量化后每个值的误差都在 0.08 左右——精度确实下降了,但大体保留了原始数值的相对大小关系。这就是量化的本质:用可控的误差换取巨大的存储和计算节省。
量化误差的数学度量
Section titled “量化误差的数学度量”量化质量通常用均方误差(MSE,Mean Squared Error,即误差平方的平均值)来度量:
其中 xᵢ 是原始浮点值,x̂ᵢ 是反量化后的近似值,n 是元素总数。上面的例子中:
MSE 越小说明量化质量越高。GPTQ、AWQ 等高级算法的目标,本质上就是在给定位宽下最小化这个误差(或其对模型输出的影响)。
对称量化与非对称量化
Section titled “对称量化与非对称量化”对称量化假设数值围绕零点对称分布(例如 -3 到 3),zero_point 固定为 0,公式简化为:
它计算高效、硬件友好,常用于权重——因为权重通常是近似零均值的高斯分布(即大部分值聚集在零附近,呈钟形曲线)。
非对称量化允许 min 和 max 不对称(例如 0.2 到 2.5,常见于激活值——尤其是经过 ReLU 激活函数后全部变成非负数),需要计算一个 zero_point 偏移。它的精度更高但计算略复杂,因为反量化时要做一次额外的减法。
为什么 ReLU 后激活值全为非负? ReLU(Rectified Linear Unit,修正线性单元)的定义是 ,即把所有负数截断为 0。这导致 ReLU 之后的激活值永远 ,分布明显不对称,所以激活值量化通常用非对称方案。
分组量化与通道量化
Section titled “分组量化与通道量化”当一组权重内部数值范围差异很大时(有些通道的值在 0.01 量级,另一些在 100 量级),用单一 scale 量化会导致小值通道精度极差。解决方案是分组量化(Group-wise Quantization):把权重分成若干小组,每组单独计算 scale。
- 逐张量量化(per-tensor):整个矩阵共用一个
scale。最简单,但精度最差。 - 逐通道量化(per-channel):每个输出通道一个
scale。精度好,但需要存储多个scale。 - 分组量化(per-group):折中方案,每 N 个连续权重共用一个
scale(常见 N=32、64、128)。
import numpy as np
# 演示分组量化:每 4 个权重一组,各自独立量化weights = np.array([0.01, 0.02, 0.01, 0.03, 50.0, 60.0, 55.0, 58.0])group_size = 4
for start in range(0, len(weights), group_size):    group = weights[start:start + group_size]    g_min, g_max = group.min(), group.max()    scale = (g_max - g_min) / 15  # INT4: 16 档    q = np.round((group - g_min) / scale).astype(np.int8)    deq = g_min + q * scale    print(f"组 {start//group_size}: 原始 {group} → 量化 {q} → 反量化 {np.round(deq, 3)}")
输出将显示两组各自的量化精度都很好——如果用单一 scale,第一组(0.01 量级)几乎全部量化为 0,信息全丢。
训练后量化(PTQ)
Section titled “训练后量化(PTQ)”PTQ(Post-Training Quantization,训练后量化)是最简单的路径:模型训练完成后,用一小批校准数据(calibration data,即用于统计激活值分布的样本,通常几百条)统计每层激活值的范围,直接把权重和激活量化到低精度。优点是无需重新训练、几行代码即可完成;缺点是低位宽(如 INT4)下精度损失明显,因为模型从未”见过”量化带来的误差。
PTQ 的工作流程可以概括为:
- 加载预训练模型(FP16 或 FP32)。
- 准备校准数据集(100~1000 条与推理分布相近的样本)。
- 前向传播收集统计量:记录每层激活值的 min/max(或更精细的分布直方图)。
- 计算量化参数:为每层的权重和激活分别确定
scale和zero_point。 - 导出量化模型:权重转为低精度整数,推理时用整数运算。
量化感知训练(QAT)
Section titled “量化感知训练(QAT)”QAT(Quantization-Aware Training,量化感知训练)在训练或微调阶段就插入”伪量化”操作:前向传播时模拟量化与反量化的舍入误差,反向传播时用直通估计器(Straight-Through Estimator,即绕过不可导的 round() 函数、把梯度直接传过去的近似方法)把梯度传回去。这样模型能学会在量化约束下尽量保持精度,INT8 下几乎无损,INT4 下也比 PTQ 好得多。代价是需要训练数据和算力,流程更重。
为什么需要直通估计器?
round()函数是阶梯形的,几乎处处导数为 0,这意味着梯度无法通过它回传。STE 的做法很简单:反向传播时假装round()不存在,直接把下游梯度原封不动地传给上游。这在数学上不严谨,但在实践中效果出奇地好。
GPTQ:基于 Hessian 的逐层权重量化
Section titled “GPTQ:基于 Hessian 的逐层权重量化”GPTQ 是一种高效的训练后权重量化方法,能把大模型压到 INT4 甚至 INT3 而精度损失很小。核心思想是逐层处理:把该层的权重视为矩阵 ,该层输入为 ,目标是找到量化后的 ,使得 ,即层输出差异最小。
GPTQ 的数学推导基于一个关键观察。量化误差对输出的影响可以用 Hessian 矩阵(即二阶导数矩阵,衡量”改变一个权重对输出的二阶影响”)来加权:
其中 是该层输入的 Hessian 矩阵(注意:这里是对权重而言的经验 Hessian)。 越大表示第 个权重越”不重要”(改变它对输出影响小),因此可以优先量化那些不重要的权重。
GPTQ 的具体做法是按列依次量化并补偿:
- 对权重矩阵 按列逐个处理。
- 量化第 列后,量化误差为 。
- 用尚未量化的列去补偿这个误差:更新 的剩余列,使得它们的输出能”抵消”掉 的影响。
- 补偿公式利用 Hessian 逆矩阵来决定每列贡献多少补偿。
由于只需一次前向传播收集 Hessian 信息,量化速度很快(一个 1750 亿参数的模型可在几小时内量化完)。
AWQ:激活感知权重量化
Section titled “AWQ:激活感知权重量化”AWQ(Activation-aware Weight Quantization,激活感知权重量化)的关键洞察是:并非所有权重都同等重要,权重的重要性取决于它对应的激活值大小。如果某个通道的激活值经常很大,那么这个通道的权重即使量化误差很小,也会被放大传播到输出。
用数学语言说:对于线性层 ,如果第 个通道的激活 很大,那么权重 的量化误差 会被放大为 。因此我们要保护那些”乘以大激活值”的权重。
AWQ 的解决方案非常优雅。给每个通道乘上一个缩放系数 ( 表示该通道”重要”):
但量化后的误差不再等价: 被放大了,量化时占据更多整数档位,相对误差变小;而 变小了,乘以同样有误差的 后绝对误差也变小了。AWQ 通过搜索最佳的 向量来最小化量化误差,整个过程不需要反向传播,也不需要重建训练数据,量化速度快、效果好,是目前 INT4 部署的主流选择之一。
SmoothQuant:激活迁移到权重
Section titled “SmoothQuant:激活迁移到权重”SmoothQuant 解决的是离群值通道(outlier channels,即激活值中极少数但极大的通道)的问题。当个别通道的激活值比其他通道大 100 倍时,对称量化必须让 scale 适应这些极端值,导致其余 99% 的通道精度极差。
SmoothQuant 的思路是”劫富济贫”——把激活值中的极端大值缩小,同时把对应的权重放大,保持乘积不变:
迁移后,激活值的分布变得平滑(不再有极端离群值),容易量化;权重的分布略有拉伸,但权重是静态的、离群值少的,量化起来也还好。SmoothQuant 让 INT8 全量化(权重 + 激活)成为可能,是 NVIDIA TensorRT-LLM 中的核心量化流程。
旋转量化:QuaRot 与 SpinQuant(2024-2025)
Section titled “旋转量化:QuaRot 与 SpinQuant(2024-2025)”2024 年以来,一类基于随机旋转(Random Rotation)的量化方法引起了广泛关注,代表方法包括 QuaRot 和 SpinQuant。
核心思想很巧妙:如果权重矩阵 的某些通道有极端值,我们可以在量化前对 乘一个正交矩阵 (旋转操作),得到 。数学上:
因为 (正交矩阵的性质),旋转不改变输出 。但旋转后的 数值分布更加均匀(极端值被”摊平”),量化误差大幅降低。这就像把一张偏暗的照片做直方图均衡化——内容不变,但数值分布更友好。
QuaRot 结合旋转技术和 GPTQ 式的残差补偿,首次实现了 INT4 权重 + INT4 激活的 W4A4 全量化,在 LLaMA 系列上几乎无损。SpinQuant(Meta,2024)进一步优化了旋转矩阵的学习方法,成为 2025 年低比特量化的重要方向。
BitNet 与 1.58-bit 量化:原生低精度训练(2024-2025)
Section titled “BitNet 与 1.58-bit 量化:原生低精度训练(2024-2025)”传统的量化流程是”先训练高精度模型,再量化降精度”。微软研究院的 BitNet 系列提出了一个颠覆性思路:直接在低精度下从零训练模型。
BitNet b1.58(2024 年)将每个权重量化为三值 ——即每个权重只有 3 种状态,理论上只需 个比特。这被称为 1.58-bit 量化。权重矩阵乘法退化为加减法(乘以 +1 不变,乘以 -1 取反,乘以 0 为零),完全不需要浮点乘法器。
2025 年,BitNet 生态进一步发展:
- BitNet b1.58-2B4T:微软发布了 20 亿参数的实用化 BitNet 模型,在同等规模下性能可比肩 FP16 模型,推理速度和内存效率大幅领先。
- 原生 1.58-bit 训练框架开源,社区开始探索在 1.58-bit 权重基础上的 MoE(Mixture of Experts,混合专家模型)架构。
- 这类模型被称为 “原生量化”(Native Quantization) 模型——它们不是高精度模型量化而来,而是天生就活在低精度空间里。
BitNet 的意义在于:它证明了如果从一开始就用低精度训练,模型能学会在极低精度下工作,而不需要事后的量化补偿。这为未来”天生小而快”的模型架构开辟了新路径。
FP8 量化:GPU 原生浮点低精度(2024-2025)
Section titled “FP8 量化:GPU 原生浮点低精度(2024-2025)”与整数量化(INT8/INT4)不同,FP8(8-bit Floating Point)保留了浮点数的指数-尾数结构,只是在更少的比特中表示。NVIDIA H100 / H200 / Blackwell GPU 原生支持 FP8 运算,使其成为 2024-2025 年推理加速的新标准。
FP8 有两种格式:
- E4M3(4 位指数 + 3 位尾数):动态范围大,适合前向传播。
- E5M2(5 位指数 + 2 位尾数):动态范围更大但精度低,适合反向传播的梯度。
FP8 相比 INT8 的优势在于:浮点数的指数结构天然适配不均匀分布的数据(大部分值小、少部分值大),不需要复杂的校准和缩放就能获得好精度。2025 年,NVIDIA Blackwell B200 GPU 进一步支持了 FP4(4 位浮点) 运算,为下一代超低精度推理铺平了道路。TensorRT-LLM、vLLM 等推理引擎均已支持 FP8 推理。
GGUF 与 k-quants
Section titled “GGUF 与 k-quants”GGUF(GPT-Generated Unified Format,GPT 生成的统一格式)是 llama.cpp 生态使用的模型文件格式,把权重、词表、配置统一打包到一个文件,便于跨平台加载。它内置的 k-quants 方法是一种分块混合位宽方案:把权重分成若干小组(常见的是每 32 或 64 个权重一组),每组单独计算 scale;同时允许不同张量使用不同位宽(重要的用 5 位或 6 位,次要的用 3 位或 4 位)。
llama.cpp 常见的量化等级(Q 后缀数字代表每权重平均比特数):
| 量化等级 | 每权重比特数 | 说明 |
|---|---|---|
| Q8_0 | 8.5 bit | 接近无损,体积约为 FP16 的一半 |
| Q5_K_M | ~5.5 bit | 性价比高,精度损失极小 |
| Q4_K_M | ~4.8 bit | 最流行的选择,体积小、精度好 |
| Q3_K_M | ~3.9 bit | 极限压缩,精度有一定下降 |
| Q2_K | ~2.6 bit | 超低位宽,适合极小显存设备 |
这种”按重要性分配比特”的策略在极低位宽下表现稳健,适合在 CPU 或低显存 GPU 上运行。
对精度与速度的影响
Section titled “对精度与速度的影响”经验上,INT8 量化通常带来约 2 倍的推理加速、模型体积减半,且精度几乎无损;INT4 量化带来约 4 倍加速、体积压缩到四分之一,但需要配合 GPTQ/AWQ 等技术才能保持可接受精度。需要注意的是,“速度倍数”高度依赖硬件和推理框架——专用整数矩阵乘法单元(如部分 GPU 的 INT8 Tensor Core)才能充分兑现加速,否则瓶颈会转移到内存带宽上,加速比更多体现在”能塞进显存”而非”算得更快”。
一个关于大模型推理的重要事实:大模型推理是内存带宽瓶颈(memory-bound)而非计算瓶颈。生成每个 token 时只需要做一次矩阵-向量乘法,计算量很小,但需要从显存读取全部权重。量化降低了权重体积,等价于”每秒能读取更多份权重”,因此即使在缺乏专用整数算力单元的设备上,仅权重量化(weight-only quantization)也能通过减少内存带宽压力来显著加速推理。
关于混合精度训练与数值格式的更多背景,可参考 混合精度训练。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
# For a 7B model: model size = params * bytes_per_parammodel_params = 7e9formats = [    ("FP32", 4, 0.0, "#4CAF50", "o", 200),    ("FP16/BF16", 2, 0.1, "#2196F3", "o", 200),    ("INT8 (PTQ)", 1, 0.5, "#FF9800", "s", 160),    ("INT8 (QAT)", 1, 0.2, "#E91E63", "s", 160),    ("FP8 (E4M3)", 1, 0.3, "#9C27B0", "D", 160),    ("INT4 (GPTQ)", 0.5, 2.0, "#F44336", "^", 140),    ("INT4 (AWQ)", 0.5, 1.5, "#FF5722", "^", 140),    ("1.58-bit (BitNet)", 0.2, 3.0, "#607D8B", "P", 140),]
fig, ax = plt.subplots(figsize=(10, 6))fig.patch.set_facecolor("white")
for label, bps, acc_loss, color, marker, size in formats:    sz = model_params * bps / 1e9    ax.scatter(sz, acc_loss, c=color, marker=marker, s=size, zorder=5, edgecolors="white", linewidths=0.8)    ax.annotate(label, (sz, acc_loss), xytext=(5, 5), textcoords="offset points",                fontsize=8.5, fontweight="bold", color="#333")
ax.axhspan(0, 0.5, alpha=0.04, color="green")ax.axhspan(0.5, 2.0, alpha=0.04, color="orange")ax.axhspan(2.0, 4.0, alpha=0.04, color="red")ax.set_xlabel("Model Size (GB, 7B params)", fontsize=12, fontweight="bold")ax.set_ylabel("Accuracy Drop (% vs FP32)", fontsize=12, fontweight="bold")ax.set_title("Quantization Trade-off: Model Size vs Accuracy (7B Model)", fontsize=13, fontweight="bold")ax.grid(True, alpha=0.2, linestyle="--"); ax.set_xlim(-1, 32); ax.set_ylim(-0.5, 4)
plt.tight_layout()plt.savefig("/mnt/kvm_ata-Netac_SSD_480GB_AA000000000000000904-part1/proj/docs/img/generated/quantization-size-accuracy.png",            dpi=180, bbox_inches="tight", facecolor="white")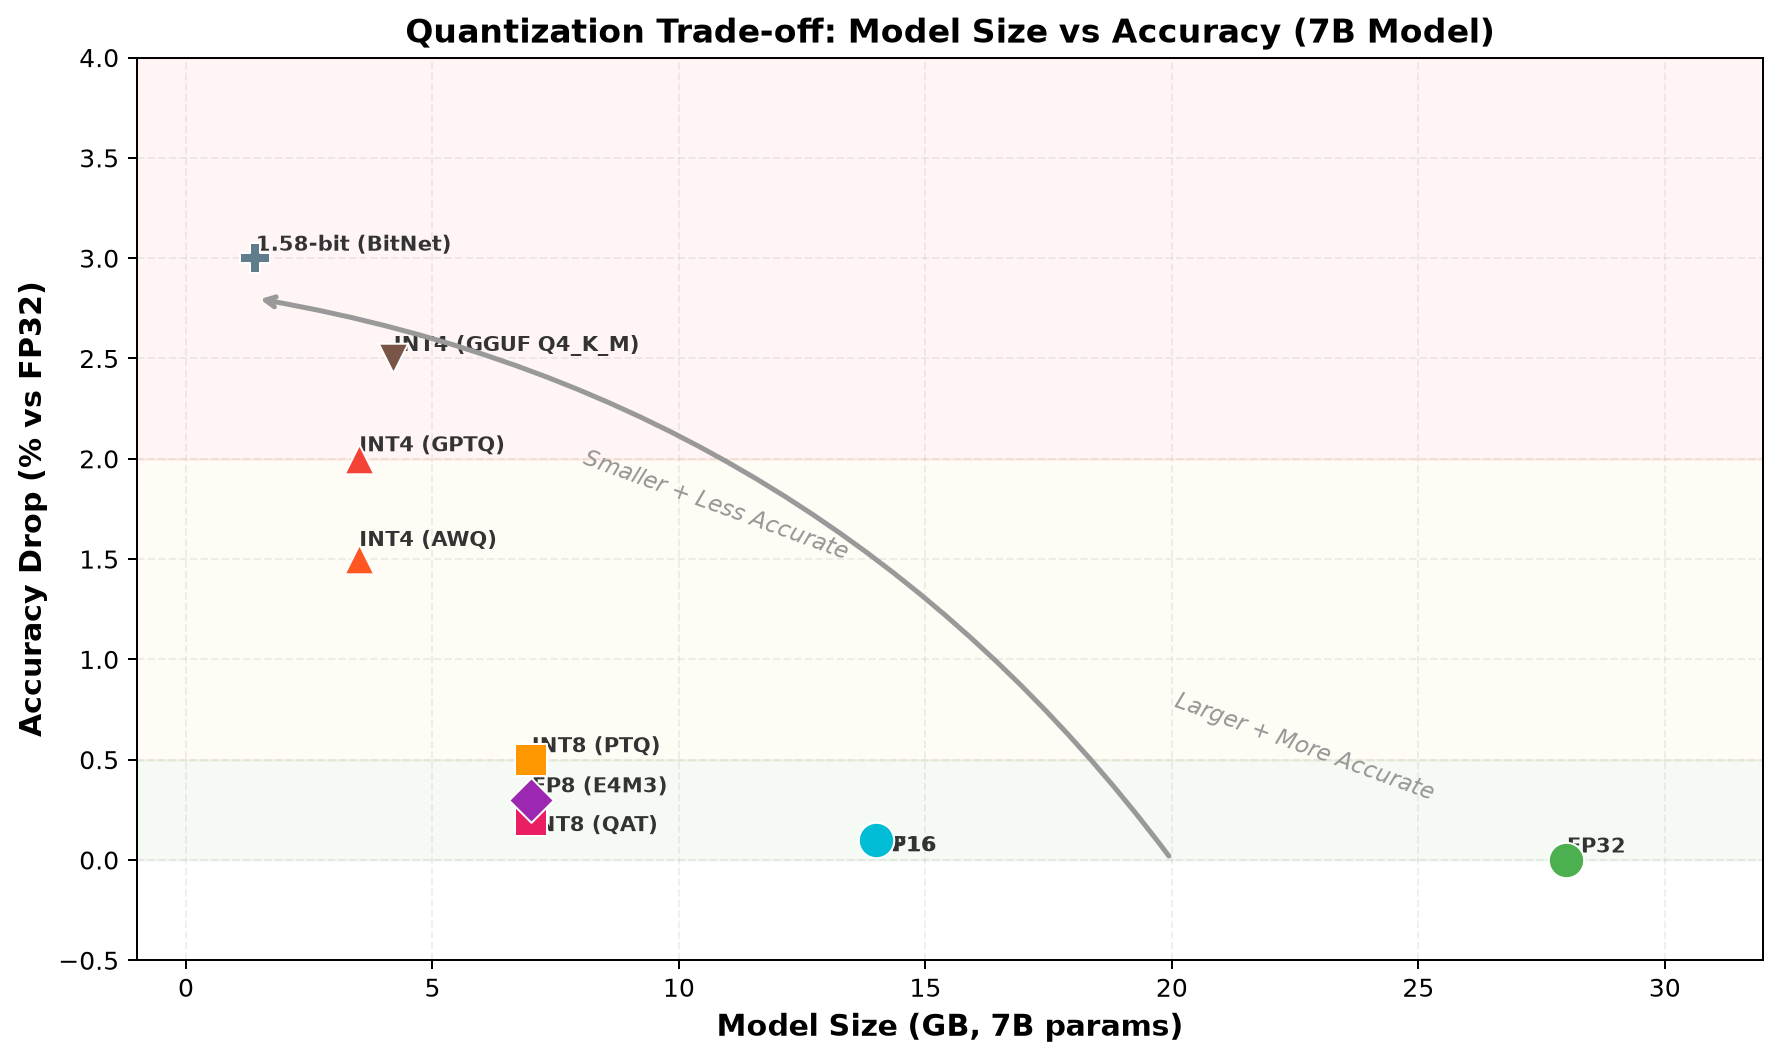
示例 1:从零实现一个量化器
Section titled “示例 1:从零实现一个量化器”下面用纯 NumPy 实现对称量化与非对称量化,帮助理解底层原理:
import numpy as np
def asymmetric_quantize(x: np.ndarray, n_bits: int = 8) -> tuple[np.ndarray, float, int]:    """    非对称量化:将浮点数组 x 映射到 n_bits 位整数。    返回 (量化后的整数数组, scale, zero_point)。    """    q_min, q_max = 0, 2 ** n_bits - 1  # 例如 INT8: 0 ~ 255    x_min, x_max = x.min(), x.max()
    scale = (x_max - x_min) / (q_max - q_min)  # 每一档代表的浮点跨度    zero_point = round(q_min - x_min / scale)   # 让浮点零值对齐到某个整数
    # 量化:浮点 → 整数    q = np.clip(np.round(x / scale + zero_point), q_min, q_max).astype(np.int32)    return q, scale, zero_point

def symmetric_quantize(x: np.ndarray, n_bits: int = 8) -> tuple[np.ndarray, float]:    """    对称量化:zero_point = 0,数值围绕零点对称。    返回 (量化后的整数数组, scale)。    """    q_max = 2 ** (n_bits - 1) - 1  # 例如 INT8: -128 ~ 127    abs_max = np.abs(x).max()    scale = abs_max / q_max    q = np.clip(np.round(x / scale), -q_max - 1, q_max).astype(np.int32)    return q, scale

def dequantize(q: np.ndarray, scale: float, zero_point: int = 0) -> np.ndarray:    """反量化:整数 → 近似浮点数"""    return scale * (q.astype(np.float32) - zero_point)

# ---- 测试 ----np.random.seed(42)weights = np.random.randn(1000).astype(np.float32) * 0.1  # 模拟一层权重
# 非对称 INT8 量化q_asym, scale_a, zp_a = asymmetric_quantize(weights, n_bits=8)deq_a = dequantize(q_asym, scale_a, zp_a)mse_a = np.mean((weights - deq_a) ** 2)
# 对称 INT8 量化q_sym, scale_s = symmetric_quantize(weights, n_bits=8)deq_s = dequantize(q_sym, scale_s, zero_point=0)mse_s = np.mean((weights - deq_s) ** 2)
print(f"非对称 INT8  MSE: {mse_a:.2e}")print(f"对称   INT8  MSE: {mse_s:.2e}")print(f"原始存储: {weights.nbytes} 字节")print(f"量化存储: {q_asym.nbytes} 字节 (压缩 {weights.nbytes / q_asym.nbytes:.1f}x)")
运行后你会看到 MSE 在 1e-7 量级(极小),而存储压缩了 4 倍(float32 → int8)。尝试把 n_bits 改为 4,观察误差如何增大。
示例 2:用 bitsandbytes 加载 INT4 大模型
Section titled “示例 2:用 bitsandbytes 加载 INT4 大模型”下面用 transformers 与 bitsandbytes 加载一个 INT4 量化的 LLM,对比直接加载与量化加载的显存占用:
import torchfrom transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
model_id = "meta-llama/Llama-2-7b-hf"tokenizer = AutoTokenizer.from_pretrained(model_id)
# 方式一:直接加载 FP16 基线模型base = AutoModelForCausalLM.from_pretrained(    model_id, torch_dtype=torch.float16, device_map="auto")print("FP16 显存(GB):", round(base.get_memory_footprint() / 1024**3, 2))del base  # 释放显存torch.cuda.empty_cache()
# 方式二:用 bitsandbytes 加载 INT4 量化模型(NF4 精度)# NF4 = Normal Float 4-bit,专为正态分布权重设计的 4 位数据类型quant_cfg = BitsAndBytesConfig(    load_in_4bit=True,    bnb_4bit_quant_type="nf4",            # 使用 NF4 量化类型    bnb_4bit_compute_dtype=torch.float16,  # 计算时反量化为 FP16    bnb_4bit_use_double_quant=True,        # 双重量化:连 scale 本身也量化)q_model = AutoModelForCausalLM.from_pretrained(    model_id, quantization_config=quant_cfg, device_map="auto")print("INT4 显存(GB):", round(q_model.get_memory_footprint() / 1024**3, 2))
# 快速生成测试,验证模型可用inputs = tokenizer("量化让大模型跑在笔记本上", return_tensors="pt").to(q_model.device)out = q_model.generate(**inputs, max_new_tokens=20)print(tokenizer.decode(out[0], skip_special_tokens=True))
运行后通常可以看到 FP16 占用约 13 GB 显存,而 INT4 仅占用约 4 到 5 GB,在 6 GB 显存的消费级显卡上即可流畅推理。更多部署优化技巧见 推理优化 与 LLM 推理。
示例 3:用 PyTorch 内置 API 做量化感知训练
Section titled “示例 3:用 PyTorch 内置 API 做量化感知训练”import torchimport torch.nn as nn
# PyTorch 提供了量化感知训练(QAT)的 API# 这里演示如何在简单全连接网络上做 QAT
class SimpleNet(nn.Module): def __init__(self): super().__init__() self.fc1 = nn.Linear(784, 256) self.relu = nn.ReLU() self.fc2 = nn.Linear(256, 10)
def forward(self, x): return self.fc2(self.relu(self.fc1(x)))
# ---- 步骤 1:准备 QAT 版本的模型 ----# qconfig 指定了权重和激活的假量化方案(这里用对称 INT8)model = SimpleNet()model.qconfig = torch.ao.quantization.get_default_qat_qconfig('fbgemm')# 在模型中插入假量化节点(FakeQuantize)model_train = torch.ao.quantization.prepare_qat(model.train())
# ---- 步骤 2:正常训练(假量化会在前向传播时模拟量化误差)----optimizer = torch.optim.Adam(model_train.parameters(), lr=1e-3)criterion = nn.CrossEntropyLoss()
for epoch in range(3): # 简单训练 3 个 epoch for x, y in train_loader: # 假设已有 train_loader out = model_train(x) loss = criterion(out, y) optimizer.zero_grad() loss.backward() # STE 让梯度穿过 round() 函数 optimizer.step()
# ---- 步骤 3:转换为真正的 INT8 量化模型 ----model_train.eval()quantized_model = torch.ao.quantization.convert(model_train)# 现在权重量已变为 INT8,推理时使用高效的整数运算print(quantized_model)这段代码展示了 QAT 的三个关键阶段:插入假量化 → 训练让模型适应量化误差 → 转换为真正的量化模型。注意 FakeQuantize 在前向传播时模拟量化-反量化的舍入操作,在反向传播时用 STE 传递梯度。
- 优先权重量化,再考虑激活量化:权重是静态的,量化简单且无误差累积;激活值随输入变化,需要校准数据。仅量化权重(weight-only quantization)就能显著降低显存与内存带宽占用。
- 校准数据要有代表性:PTQ 的精度高度依赖校准集。用与真实推理分布相近的数据(例如对话模型用真实问答样本),少量但覆盖面广即可。
- INT8 选 PTQ,INT4 选 GPTQ/AWQ:INT8 下 PTQ 已足够好;降到 INT4 必须用带误差补偿的方法,否则精度断崖式下跌。
- 关注离群值通道:少数极端大的激活通道会撑大
scale、压低整体精度。处理离群值(如 SmoothQuant 的激活迁移、QuaRot 的旋转预处理)是低位宽下保持精度的关键技巧。 - 不要盲目追求低位宽:位宽越低,对硬件整数算力支持越敏感。若推理框架或硬件没有 INT4 矩阵乘内核,加速效果可能远不如预期,反而不如 INT8。
- 保留少数敏感层为高精度:输出投影层、最终 logits 层通常对量化敏感,保持 FP16 而其余量化(混合精度),能以极小代价换取明显精度提升。
- 善用旋转预处理:对于需要全量化(W8A8 或 W4A4)的场景,先做随机旋转(如 Hadamard 变换)再量化,已成为 2025 年的标准操作,能显著缓解离群值问题。
- 测完真实任务再下结论:困惑度(perplexity,语言模型对文本的”惊讶程度”指标)下降不一定等于能力下降。务必在下游评测集上验证,参考 模型评估。
- llama.cpp:开源项目,使用 GGUF 格式与 k-quants,让 LLaMA、Mistral 等模型在普通笔记本 CPU 上运行,是量化在端侧部署的标杆案例。详见 LLaMA 系列。
- GPTQ-model / AutoGPTQ:为大量 Hugging Face 模型提供 INT4 GPTQ 量化权重,社区已发布数千个量化模型可直接下载使用。
- vLLM:高性能推理引擎,支持 AWQ、GPTQ、FP8 等多种量化格式,通过 PagedAttention 与低精度权重结合,在单卡上服务高并发请求。2025 年 vLLM 进一步集成了 FP8 推理支持,在 NVIDIA H100 上实现了接近 2 倍于 FP16 的吞吐量。
- TensorRT-LLM:NVIDIA 的推理加速库,内置 SmoothQuant 与 INT4/INT8/FP8 量化流程,针对自家 GPU 的 Tensor Core 做了深度优化。2025 年已支持 Blackwell GPU 的 FP4 精度。
- Ollama:面向开发者的本地大模型运行工具,底层基于 llama.cpp 的 GGUF 量化方案,一条命令即可拉取并运行量化模型。
- BitNet 推理框架:微软开源的 bitnet.cpp(原 llm.c 分支),专门针对 1.58-bit 模型优化,在 CPU 和 ARM 设备上实现了极高的能效比。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| bitsandbytes | Python | 8 位与 4 位(NF4)量化,集成于 transformers,最易上手 |
| AutoGPTQ | Python | GPTQ 量化训练框架,支持大规模 LLM 的 INT4 量化 |
| AutoAWQ | Python | AWQ 量化实现,支持主流开源模型的一键量化 |
| llama.cpp | C++ | GGUF 格式与 k-quants 方法,跨平台端侧推理 |
| TensorRT-LLM | Python/C++ | NVIDIA 官方推理库,支持 SmoothQuant、INT8/INT4/FP8/FP4 |
| Quanto (HuggingFace Optimum) | Python | transformers 官方量化后端,支持多种量化算法 |
| HQQ (Half-Quadratic Quantization) | Python | 数据无关的快速量化方法,无需校准数据集 |
| bitnet.cpp | C++/CUDA | 微软 BitNet 1.58-bit 模型专用推理框架 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 量化 | Quantization | 把高精度浮点数映射到低精度整数的过程 |
| 训练后量化 | Post-Training Quantization (PTQ) | 训练完成后直接量化,无需重训 |
| 量化感知训练 | Quantization-Aware Training (QAT) | 训练时模拟量化误差以提升低位宽精度 |
| 对称量化 | Symmetric Quantization | 数值围绕零点对称分布,zero_point 为 0 |
| 非对称量化 | Asymmetric Quantization | 允许不对称范围,需计算 zero_point 偏移 |
| 缩放因子 | Scale | 每个整数档位对应的浮点跨度 |
| 零点 | Zero Point | 浮点零值对应的整数索引,用于精确表示零 |
| 校准 | Calibration | 用少量数据统计激活值范围的过程 |
| 仅权重量化 | Weight-Only Quantization | 只量化权重、激活保持高精度的折中方案 |
| 离群值通道 | Outlier Channel | 数值明显偏大的通道,会拖低整体量化精度 |
| 直通估计器 | Straight-Through Estimator (STE) | 让不可导的舍入操作能回传梯度的技巧 |
| 分组量化 | Group-wise Quantization | 把权重分成小组,每组独立计算 scale |
| 全量化 | Weight-Activation Quantization (WA) | 权重和激活同时量化,如 W8A8、W4A4 |
| 旋转量化 | Rotation-based Quantization | 用正交矩阵旋转权重以平滑分布,再量化的方法 |
| 原生量化 | Native Quantization | 模型从零开始就在低精度下训练,而非事后量化 |
| 双重量化 | Double Quantization | 把量化产生的 scale 参数本身也量化,进一步压缩 |
经典论文与方法:
- GPTQ 原始论文:Frantar et al., “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers” (2022)
- AWQ 原始论文:Lin et al., “AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration” (2023)
- SmoothQuant:Xiao et al., “SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models” (2022)
- LLM.int8():Dettmers et al., “LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale” (2022)
- bitsandbytes NF4:Dettmers et al., “QLoRA: Efficient Finetuning of Quantized LLMs” (2023)
2024-2025 年前沿进展:
- BitNet b1.58:Ma et al., “The Era of 1-bit LLMs: All Large Language Models are in 1.58 Bits” (2024) — 微软提出的原生三值量化训练
- BitNet b1.58-2B4T:微软 2025 年发布的首个实用化 1.58-bit 模型(20 亿参数),开源权重与推理框架
- QuaRot:Ashkboos et al., “QuaRot: Outlier-free 4Bit Inference in Rotated LLMs” (2024) — 基于旋转的 W4A4 全量化
- SpinQuant:Liu et al., “SpinQuant: LLM Quantization with Learned Rotations” (Meta, 2024) — 学习最优旋转矩阵
- FP8 精度与格式:NVIDIA, “FP8 Formats for Deep Learning” (2022),以及 H100/Blackwell 架构白皮书
- QServe:Lin et al., “QServe: W4A8KV4 Quantization and System Co-design for Efficient LLM Serving” (2024) — 混合精度量化服务系统
工具与文档:
- llama.cpp 与 GGUF 格式文档:github.com/ggerganov/llama.cpp
- Hugging Face 量化指南:huggingface.co/docs/transformers/main/quantization/overview
- NVIDIA TensorRT-LLM 量化教程:github.com/NVIDIA/TensorRT-LLM
- bitnet.cpp(BitNet 推理框架):github.com/microsoft/BitNet