
CV 模型部署
本页介绍计算机视觉(Computer Vision, CV)模型从训练完成到在生产环境上线的全流程——从 PyTorch 导出到 ONNX,再到 TensorRT / ONNX Runtime 推理加速,以及量化(Quantization)与算子融合等关键优化技术。它是 CNN 主线 与 目标检测与 YOLO 的工程延伸——训练出一个好模型只是起点,让它以毫秒级延迟、稳定地跑在 GPU / CPU / 边缘设备上才是真正的挑战。关于 LLM 的部署差异,见 LLM 模型部署;更深入的量化原理见 量化与加速;GPU 硬件基础见 GPU 与多卡基础。
CV 模型部署的核心问题可以用一句话概括:训练关心的是精度,部署关心的是”精度 × 速度 × 内存”的三方权衡。
想象你训练了一个 ResNet-50 分类模型——在实验室里用一张 A100 GPU 跑推理,50ms 一张,一切完美。但当你需要把它部署到以下场景时,挑战才真正开始:
- 云端 API 服务:单卡每秒要处理数百张图的并发请求,延迟必须控制在 20ms 以内。
- 自动驾驶车端:模型跑在 NVIDIA Orin 或地平线征程芯片上,感知延迟必须低于 33ms(30 FPS),且不能抢占其他模块的算力预算。
- 手机端 APP:模型跑在用户的骁龙芯片上,没有独占 GPU,内存预算 50MB,电池不能秒没。
- IoT / 树莓派:算力只有几 TOPS,模型必须极致轻量。
训练框架(PyTorch / TensorFlow)是为梯度计算和灵活开发设计的,推理时大量中间变量、自动求导图、Python 解释器开销都是多余的。部署的本质就是去掉一切训练专用开销,把模型编译成针对目标硬件的最优计算图。
为什么需要中间表示(IR)? 深度学习框架五花八门(PyTorch、TensorFlow、JAX、PaddlePaddle…),硬件后端同样五花八门(NVIDIA GPU、AMD GPU、Intel CPU、ARM、Apple Silicon…)。ONNX(Open Neural Network Exchange)作为中间格式,让”M × N”的复杂映射简化为”M + N”——每个框架只需导出到 ONNX,每个推理引擎只需支持 ONNX 输入。
ONNX:神经网络交换格式
Section titled “ONNX:神经网络交换格式”ONNX(Open Neural Network Exchange)是微软与 Facebook(现 Meta)于 2017 年联合提出的开放标准。它定义了一套与框架无关的算子(operator)集合和**计算图(computational graph)**格式——用 Protobuf 序列化,描述模型的拓扑结构和参数权重。
ONNX 的核心思想是把神经网络拆解为一组标准化的算子节点(Conv、Relu、MaxPool、Gemm、Softmax…),每个节点有明确的输入/输出和属性。这样无论模型原来用 PyTorch 还是 TensorFlow 训练,导出到 ONNX 后都是同一套描述。
一个典型的 Conv 节点在 ONNX 中的表示(简化):
node { op_type: "Conv" inputs: ["input", "conv_weight", "conv_bias"] outputs: ["conv_output"] attributes: { kernel_shape: [3, 3] strides: [2, 2] padding: [1, 1] dilations: [1, 1] group: 1 }}ONNX Opset 版本:ONNX 的算子集会随时间迭代,每个版本称为一个 opset(operator set)。导出时需指定 opset 版本(如
opset_version=17),版本越高支持的算子越多,但旧版推理引擎可能不兼容。生产环境要确保导出 opset 与推理引擎支持版本匹配。
TensorRT:NVIDIA GPU 推理引擎
Section titled “TensorRT:NVIDIA GPU 推理引擎”TensorRT 是 NVIDIA 开发的高性能深度学习推理 SDK,专为 NVIDIA GPU 优化。它接收 ONNX 模型后执行一系列图级优化,生成一个针对特定 GPU 型号编译的推理引擎(.engine 文件),通常能比直接用 PyTorch 推理快 3–10 倍。
TensorRT 的核心优化技术包括:
1. 算子融合(Layer / Kernel Fusion)
Section titled “1. 算子融合(Layer / Kernel Fusion)”这是 TensorRT 最基础也最有效的优化。相邻的算子如果能合并成一个 GPU kernel(核函数),就能减少 GPU kernel 启动开销和中间结果的显存读写。
最经典的融合模式是 Conv-BN-ReLU 三合一:一个卷积层后接 BatchNorm 和 ReLU,在推理时可以合并成单个 GPU kernel 执行。以 CNN 主线 中介绍的 Conv→BN→ReLU 结构为例:
推理时 BN 的参数 都是固定值(训练阶段累积的移动平均统计量),因此 BN 可被折叠进前一层的卷积权重中。设折叠后的等效卷积权重和偏置为 和 :
折叠后 Conv(W', b') → ReLU 可以进一步融合成一个 kernel,一次 pass 完成。
融合前:3 次 GPU kernel 启动 + 2 次中间显存读写。融合后:1 次 kernel 启动,中间结果全部留在寄存器或 L1 cache 中。对于 ResNet-50 这种 50+ 层的网络,仅这一项优化就能减少上百次 kernel 启动开销和等量的显存访问。
2. 精度校准与量化
Section titled “2. 精度校准与量化”TensorRT 支持 FP32、FP16、BF16、INT8、INT4 等多种精度。最常用的是 INT8 量化——将 FP32 权重和激活值映射到 [-128, 127] 的 8 位整数空间,理论计算吞吐量提升 4 倍(NVIDIA GPU 的 INT8 Tensor Core 吞吐通常是 FP32 的 4 倍),模型体积缩小 4 倍。
INT8 对称量化的映射公式(详见 量化与加速):
其中 是缩放因子(scale), 是量化后的整数值。TensorRT 的 训练后量化(Post-Training Quantization, PTQ) 使用一小批校准数据(calibration data)统计每层激活值的分布,自动确定最优缩放因子——不需要重新训练模型。
3. kernel 自动调优
Section titled “3. kernel 自动调优”同一个卷积运算在 GPU 上有多种实现(如 cuDNN 提供的不同算法、implicit GEMM、Winograd 变换等),最优实现取决于卷积参数(核大小、通道数、batch size)和 GPU 型号。TensorRT 在编译时对所有候选 kernel 逐一实际运行并计时,选出当前 GPU 上最快的那个。这意味着同一个 ONNX 模型在不同 GPU 上(如 T4 vs A100)会生成不同的最优引擎。
4. 动态显存复用与 Workspace
Section titled “4. 动态显存复用与 Workspace”TensorRT 会分析计算图的中间张量生命周期,对不重叠的中间结果复用同一段显存,大幅降低峰值显存占用。同时,它会为每个层分配最优大小的 workspace(临时工作空间),让卷积算法有足够空间存放中间矩阵。
ONNX Runtime:跨平台推理引擎
Section titled “ONNX Runtime:跨平台推理引擎”并非所有场景都有 NVIDIA GPU。ONNX Runtime 是微软开发的跨平台推理引擎,支持 CPU(x86 / ARM)、GPU(NVIDIA / AMD / Intel)、甚至 WebAssembly。它的优势是部署简单——一行 pip 安装、一个 API 调用就能推理,无需针对硬件单独编译引擎。
ONNX Runtime 的优化原理与 TensorRT 类似(算子融合、量化、kernel 选择),通过**执行提供器(Execution Provider, EP)**机制适配不同硬件后端:
| Execution Provider | 硬件后端 | 典型场景 |
|---|---|---|
| CPU EP | x86 / ARM CPU | 服务端 CPU 推理、IoT 设备 |
| CUDA EP | NVIDIA GPU | 通用 GPU 推理 |
| TensorRT EP | NVIDIA GPU | 嵌入 TensorRT 引擎获得极致性能 |
| DirectML EP | Windows GPU(NVIDIA / AMD / Intel) | Windows 平台游戏 / 桌面 AI |
| CoreML EP | Apple Silicon | macOS / iOS 端侧推理 |
| OpenVINO EP | Intel CPU / iGPU / VPU | Intel 硬件推理 |
| QNN EP | Qualcomm NPU | 安卓手机端侧推理 |
推理延迟拆解
Section titled “推理延迟拆解”理解模型推理的时间花在哪里,是优化的前提。一次推理的端到端延迟可以拆分为:
其中 是 GPU 上的纯计算时间,而前后处理和数据搬运往往被忽视,却可能占据总延迟的 30–50%:
- :图像解码(JPEG → RGB 张量)、resize、归一化、通道转换(HWC → CHW)。这些操作在 CPU 上执行,高并发时成为瓶颈。
- :输入数据从 CPU 内存拷贝到 GPU 显存(PCIe 带宽限制)。
- :模型前向推理,是 TensorRT 优化的主要目标。
- :输出结果从 GPU 拷回 CPU。
- :NMS(非极大值抑制)、坐标变换、业务逻辑。
优化经验法则:先用 profiler(如 PyTorch Profiler、Nsight Systems、ONNX Runtime 的
enable_profiling)找到瓶颈在哪一段,再针对性优化。盲目优化 而忽略前后处理,可能只提升了总延迟的一小部分。
1. 从 PyTorch 导出 ONNX
Section titled “1. 从 PyTorch 导出 ONNX”import torchimport torchvision
# 加载预训练 ResNet-50model = torchvision.models.resnet50(weights=torchvision.models.ResNet50_Weights.DEFAULT)model.eval() # 切换到评估模式——关闭 Dropout,BatchNorm 使用 running stats
# 创建虚拟输入(ONNX 导出需要通过一次前向传播来追踪计算图)dummy_input = torch.randn(1, 3, 224, 224) # batch=1, 3 通道, 224×224
# 导出 ONNXonnx_path = "resnet50.onnx"torch.onnx.export( model, dummy_input, onnx_path, opset_version=17, # 使用 opset 17(支持较新算子,兼容性好) input_names=["input"], # 输入节点名(推理时按名引用) output_names=["output"], dynamic_axes={ # 支持动态 batch size "input": {0: "batch"}, "output": {0: "batch"}, },)print(f"ONNX 模型已导出: {onnx_path}")
dynamic_axes让模型支持可变 batch size——部署时 batch=1 做低延迟推理、batch=32 做高吞吐批量推理都无需重新导出。代价是 TensorRT 编译时无法对特定 batch 做 kernel 调优,性能略低于固定 batch 的引擎。
2. ONNX Runtime 推理
Section titled “2. ONNX Runtime 推理”import numpy as npimport onnxruntime as ortfrom PIL import Image
# 创建推理会话——选择可用的 Execution Providerproviders = ["CUDAExecutionProvider", "CPUExecutionProvider"] # 优先用 GPUsession = ort.InferenceSession("resnet50.onnx", providers=providers)
# 图像预处理(必须与训练时一致!)image = Image.open("test.jpg").resize((224, 224))input_data = np.array(image, dtype=np.float32) / 255.0 # 归一化到 [0, 1]input_data = (input_data - [0.485, 0.456, 0.406]) / [0.229, 0.224, 0.225] # ImageNet 标准化input_data = input_data.transpose(2, 0, 1) # HWC → CHWinput_data = input_data[np.newaxis, ...] # 增加 batch 维: (1, 3, 224, 224)
# 推理outputs = session.run(["output"], {"input": input_data})logits = outputs[0] # shape: (1, 1000)predicted_class = np.argmax(logits, axis=1)print(f"预测类别: {predicted_class[0]}")3. TensorRT 推理(Python API)
Section titled “3. TensorRT 推理(Python API)”import tensorrt as trtimport pycuda.driver as cuda # TensorRT 推理需要管理 GPU 显存import pycuda.autoinitimport numpy as np
# --- 第一步:构建 TensorRT 引擎(通常离线执行一次)---def build_engine(onnx_path, fp16=True): """将 ONNX 模型编译为 TensorRT 引擎""" logger = trt.Logger(trt.Logger.WARNING) builder = trt.Builder(logger)
# 创建网络定义 network = builder.create_network( 1 << int(trt.NetworkDefinitionCreationFlag.EXPLICIT_BATCH) )
# 解析 ONNX parser = trt.OnnxParser(network, logger) with open(onnx_path, "rb") as f: parser.parse(f.read())
# 配置构建器 config = builder.create_builder_config() config.set_memory_pool_limit(trt.MemoryPoolType.WORKSPACE, 4 << 30) # 4GB workspace
if fp16 and builder.platform_has_fast_fp16: config.set_flag(trt.BuilderFlag.FP16) # 启用 FP16 精度 print("已启用 FP16 混合精度")
# 构建并序列化引擎 serialized = builder.build_serialized_network(network, config) with open("resnet50.engine", "wb") as f: f.write(serialized) print("TensorRT 引擎已生成: resnet50.engine")
# --- 第二步:加载引擎并推理 ---class TRTInference: def __init__(self, engine_path): self.logger = trt.Logger(trt.Logger.WARNING) self.runtime = trt.Runtime(self.logger) with open(engine_path, "rb") as f: self.engine = self.runtime.deserialize_cuda_engine(f.read()) self.context = self.engine.create_execution_context()
# 分配 GPU 显存(输入 + 输出) self.input_shape = (1, 3, 224, 224) self.output_shape = (1, 1000) self.d_input = cuda.mem_alloc( int(np.prod(self.input_shape)) * np.float32().itemsize ) self.d_output = cuda.mem_alloc( int(np.prod(self.output_shape)) * np.float32().itemsize )
def infer(self, input_np): """执行推理,返回输出 numpy 数组""" # 1. 数据从 Host 拷到 Device cuda.memcpy_htod(self.d_input, input_np)
# 2. 执行推理 self.context.execute_v2([int(self.d_input), int(self.d_output)])
# 3. 结果从 Device 拷回 Host output_np = np.empty(self.output_shape, dtype=np.float32) cuda.memcpy_dtoh(output_np, self.d_output) return output_np
# 使用build_engine("resnet50.onnx", fp16=True)trt_model = TRTInference("resnet50.engine")result = trt_model.infer(input_data)TensorRT 的 Python API 依赖 PyCUDA 手动管理显存拷贝,代码较繁琐。生产环境推荐用 NVIDIA 的 Triton Inference Server——它封装了引擎管理、动态 batching、多模型调度和 HTTP/gRPC 接口,直接用 HTTP 请求即可推理。
4. INT8 训练后量化(PyTorch)
Section titled “4. INT8 训练后量化(PyTorch)”import torchimport torchvisionfrom torch.ao.quantization import get_default_qconfig, prepare, convert
model = torchvision.models.resnet50(weights=torchvision.models.ResNet50_Weights.DEFAULT)model.eval()
# 融合 Conv+BN+ReLU(推理时 BN 可折叠,量化前必须先做这步)model = torch.ao.quantization.fuse_modules(model, [ ["conv1", "bn1", "relu1"], # ResNet 的每个 bottleneck block 内部也需逐个指定...])
# 配置 INT8 量化(使用 QNNPACK 后端,适合 ARM CPU)torch.backends.quantized.engine = "qnnpack"model.qconfig = get_default_qconfig("qnnpack")
# 插入量化/反量化 observer 节点model_prepared = prepare(model)
# 用校准数据跑若干 batch,让 observer 统计激活值范围for images in calibration_data_loader: # 约 500-1000 张代表性图片 model_prepared(images)
# 将 observer 统计结果转为实际量化参数,生成 INT8 模型model_quantized = convert(model_prepared)
# 比较模型大小fp32_size = sum(p.nelement() * p.element_size() for p in model.parameters()) / 1e6print(f"FP32 模型: {fp32_size:.1f} MB")print("INT8 模型约为 FP32 的 1/4")
# 保存torch.jit.save(torch.jit.script(model_quantized), "resnet50_int8.pt")校准数据的选择:校准集应尽量覆盖真实推理数据的分布——如果模型用于检测白天道路场景,校准图片也应是白天道路,不能混入大量无关图像。分布不匹配会导致量化误差显著增大。
5. 目标检测模型的特殊部署考量(YOLO)
Section titled “5. 目标检测模型的特殊部署考量(YOLO)”YOLO 等检测模型的部署比分类模型复杂得多,因为它有后处理(NMS)——一个涉及动态循环、排序和条件分支的操作,ONNX 和 TensorRT 对这类操作的支持不佳。常见做法是将 NMS 从模型图中分离出来,模型只输出原始检测框(raw boxes + objectness + class scores),NMS 在推理框架的后处理阶段用代码实现。
# YOLO 导出 ONNX 时通常排除 NMS 后处理from ultralytics import YOLO
model = YOLO("yolov8n.pt")model.export(    format="onnx",    opset=17,    simplify=True,        # 用 onnx-simplifier 简化计算图    dynamic=True,          # 支持动态 batch    imgsz=640,)# 导出的 ONNX 输出原始张量,NMS 需在推理代码中调用
对于延迟极度敏感的场景(如自动驾驶),可以用 NMS-free 设计——YOLO-X、RT-DETR 等模型用一对一标签分配策略(one-to-one assignment),无需 NMS 后处理,端到端延迟更低。
预处理(图像解码 + resize + 归一化)常被忽视,却可能占据 30% 以上的端到端延迟。优化手段:
- GPU 预处理:把 resize、归一化、HWC→CHW 转换移到 GPU 上做。NVIDIA 的 DALI(Data Loading Library)和
torchvision.transforms.v2的 GPU 版本可以做到零拷贝预处理。 - 硬解码:用 NVIDIA NVJPEG(GPU JPEG 解码)或 Intel oneVPL 替代 CPU 上的 libjpeg/turbojpeg,解码速度提升 5–10 倍。
- 避免 Python 循环:预处理用 NumPy / OpenCV 的向量化操作,不要用 PIL 的逐像素操作。
动态 Batching
Section titled “动态 Batching”在服务端,请求到达的频率不均匀——有时一秒一个请求,有时同时来 10 个。**动态 batching(dynamic batching)**把短时间窗口内到达的多个请求自动打包成一个 batch 一次推理,大幅提高吞吐量:
batch 越大,(kernel 启动、数据搬运)的分摊越小,吞吐越高。但 batch 太大会增加单请求延迟(要等够 batch 才执行),需要设置合理的最大等待时间(max queue delay)和最大 batch size。
NVIDIA Triton Inference Server 内置了动态 batching 支持,只需在
config.pbtxt中配置dynamic_batching { max_queue_delay_microseconds: 50000; preferred_batch_size: [4, 8] }即可。50000 微秒 = 50ms 是常用值——用户几乎无感。
精度选择策略
Section titled “精度选择策略”不同层对量化误差的敏感度不同。一般经验:
| 精度 | 模型体积 | 推理速度 | 精度损失 | 适用场景 |
|---|---|---|---|---|
| FP32 | 1× | 1× | 基准 | 开发调试、精度敏感场景 |
| FP16 | 0.5× | 2–3× | 几乎无 | GPU 推理默认首选 |
| BF16 | 0.5× | 2–3× | 几乎无 | NVIDIA Hopper / Ada 架构 |
| INT8 | 0.25× | 3–4× | 0.5–2% | CPU 推理、高吞吐服务 |
| INT4 | 0.125× | 4–6× | 1–5% | 极致压缩、边缘设备 |
第一层和最后一层要小心:模型的输入层(靠近像素)和输出层(靠近 logits)对量化最敏感。TensorRT 和 PyTorch 量化都支持部分量化(partial quantization)——保留首尾层 FP16 精度,中间层用 INT8,在速度和精度间取最优平衡。
量化精度 Pareto 对比
Section titled “量化精度 Pareto 对比”下图以 ResNet-50 为例,直观展示不同量化精度在推理加速比与精度保持之间的 Pareto 前沿关系,帮助快速选择合适的量化方案。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as npfrom matplotlib.lines import Line2D
OUTPUT = "cv-deployment-quantization-pareto.png"
# (label, speedup, accuracy% of FP32, color, marker)methods = [    ("FP32",       1.0, 100.0, "#607D8B", "o"),    ("FP16",       2.5,  99.8, "#4CAF50", "s"),    ("BF16",       2.5,  99.9, "#2196F3", "s"),    ("INT8 (PTQ)", 3.8,  98.5, "#FF9800", "D"),    ("INT8 (QAT)", 3.8,  99.2, "#9C27B0", "D"),    ("INT4",       5.5,  96.0, "#F44336", "^"),]
fig, ax = plt.subplots(figsize=(9, 5.5))fig.patch.set_facecolor("white")
# Shaded quality regionsax.axhspan(99.0, 101.0, alpha=0.07, color="green", zorder=0)ax.axhspan(97.0, 99.0, alpha=0.07, color="orange", zorder=0)ax.axhspan(93.0, 97.0, alpha=0.07, color="red", zorder=0)ax.text(5.7, 99.7, "Near-lossless", fontsize=8, color="#2E7D32", ha="center", fontstyle="italic")ax.text(5.7, 98.0, "Acceptable loss", fontsize=8, color="#E65100", ha="center", fontstyle="italic")ax.text(5.7, 94.5, "Significant loss", fontsize=8, color="#C62828", ha="center", fontstyle="italic")
# Pareto frontierpareto_x = [1.0, 2.5, 3.8, 5.5]pareto_y = [100.0, 99.9, 99.2, 96.0]ax.plot(pareto_x, pareto_y, "k--", alpha=0.35, linewidth=1.6, zorder=2)ax.annotate("Pareto Frontier", xy=(4.2, 97.8), fontsize=9, color="#999", fontstyle="italic")
# Scatter pointsnp.random.seed(42)for label, speedup, acc, color, marker in methods:    ax.scatter(speedup, acc, c=color, marker=marker, s=180, zorder=5,               edgecolors="white", linewidths=0.9)    dx, dy = 10, 7    if label == "FP16":        dx, dy = -40, 10    if label == "INT8 (PTQ)":        dx, dy = 10, -14    if label == "INT4":        dx, dy = -25, -16    ax.annotate(label, (speedup, acc), textcoords="offset points",                xytext=(dx, dy), fontsize=9, fontweight="bold", color="#333")
ax.set_xlabel("Relative Inference Speedup (× vs FP32 baseline)", fontsize=11, fontweight="bold")ax.set_ylabel("Top-1 Accuracy (% of FP32 baseline)", fontsize=11, fontweight="bold")ax.set_title("CV Model Quantization: Speed vs Accuracy Pareto Front (ResNet-50)",             fontsize=12, fontweight="bold")ax.set_xlim(0.4, 6.2)ax.set_ylim(95.0, 100.8)ax.grid(True, alpha=0.2, linestyle="--")ax.tick_params(labelsize=10)
legend_elements = [    Line2D([0], [0], marker="o", color="w", markerfacecolor="#607D8B", markersize=10, label="FP32 (baseline)"),    Line2D([0], [0], marker="s", color="w", markerfacecolor="#2196F3", markersize=10, label="16-bit (FP16 / BF16)"),    Line2D([0], [0], marker="D", color="w", markerfacecolor="#9C27B0", markersize=10, label="INT8 (PTQ / QAT)"),    Line2D([0], [0], marker="^", color="w", markerfacecolor="#F44336", markersize=10, label="INT4"),]ax.legend(handles=legend_elements, loc="lower left", fontsize=8, framealpha=0.9)
plt.tight_layout()plt.savefig(OUTPUT, dpi=180, bbox_inches="tight", facecolor="white")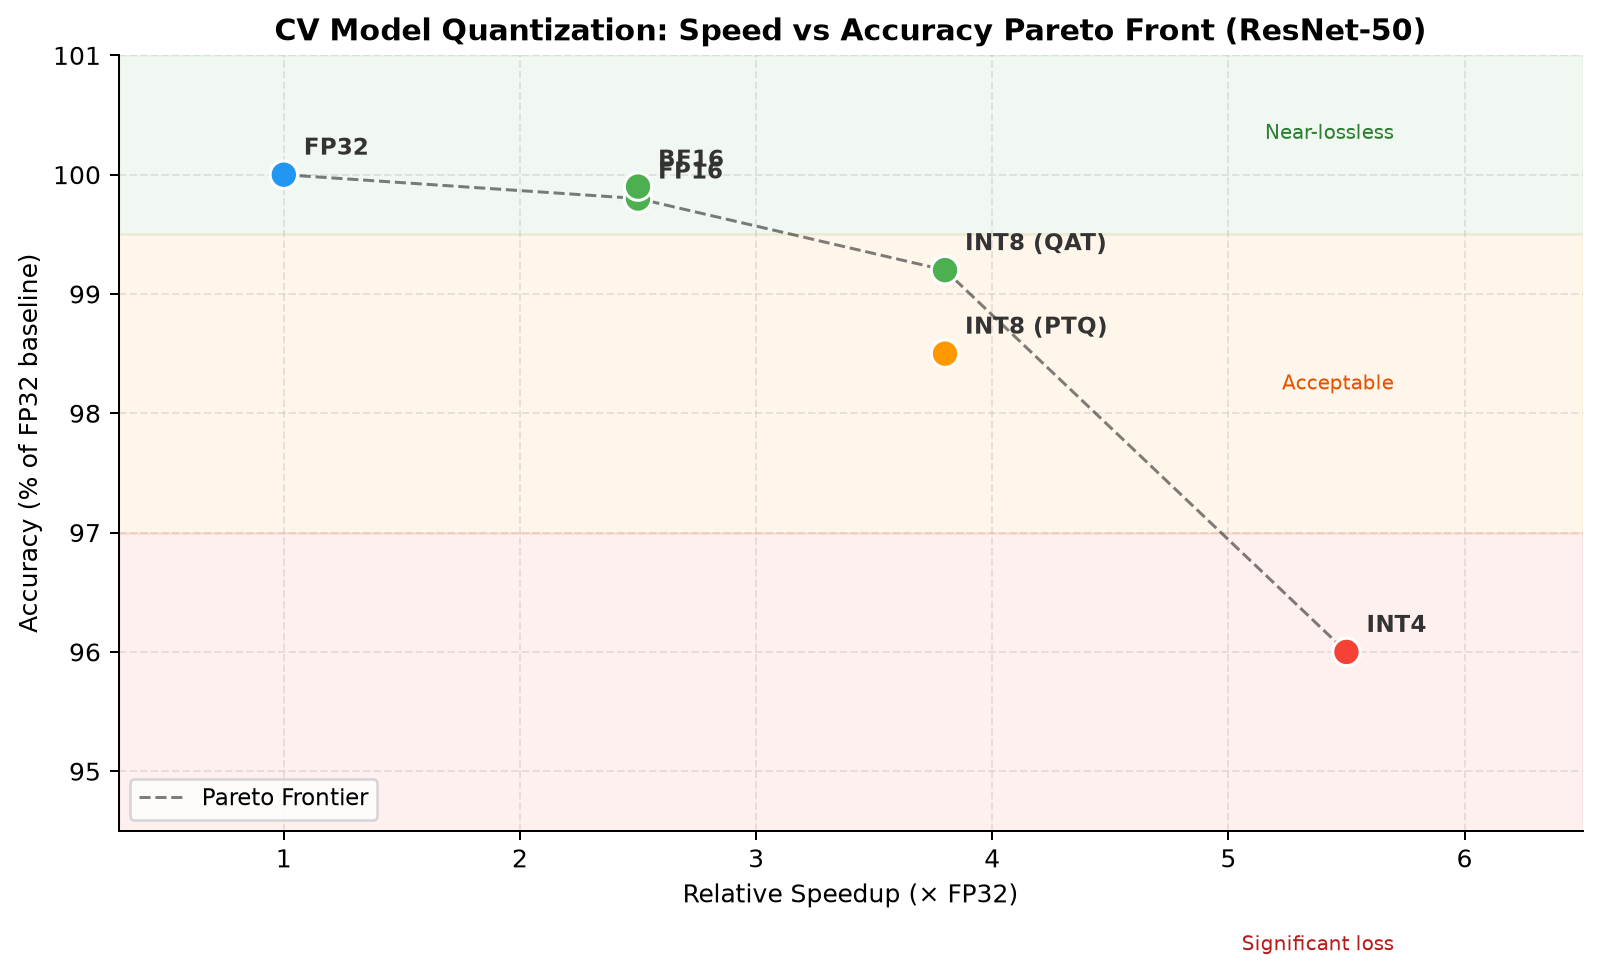
量化精度 Pareto 对比
Section titled “量化精度 Pareto 对比”下图以 ResNet-50 为例,展示了不同量化精度在推理加速与精度保持之间的 Pareto 前沿,帮助快速选择最优量化方案:
import matplotlibmatplotlib.use("Agg")
import matplotlib.pyplot as pltimport numpy as np
np.random.seed(42)
labels = ["FP32", "FP16", "BF16", "INT8 (PTQ)", "INT8 (QAT)", "INT4"]speedup = [1.0, 2.5, 2.5, 3.8, 3.8, 5.5]accuracy = [100.0, 99.8, 99.9, 98.5, 99.2, 96.0]
colors = ["#2196F3", "#4CAF50", "#4CAF50", "#FF9800", "#4CAF50", "#f44336"]
fig, ax = plt.subplots(figsize=(9, 5.5))
# Shaded regionsax.axhspan(99.5, 101, color="#4CAF50", alpha=0.08, zorder=0)ax.axhspan(97.0, 99.5, color="#FF9800", alpha=0.08, zorder=0)ax.axhspan(90.0, 97.0, color="#f44336", alpha=0.08, zorder=0)
ax.text(5.7, 100.3, "Near-lossless", fontsize=8, color="#2E7D32", ha="right")ax.text(5.7, 98.2, "Acceptable", fontsize=8, color="#E65100", ha="right")ax.text(5.7, 93.5, "Significant loss", fontsize=8, color="#B71C1C", ha="right")
# Pareto frontier linepareto_x = [1.0, 2.5, 3.8, 5.5]pareto_y = [100.0, 99.8, 99.2, 96.0]ax.plot(pareto_x, pareto_y, "k--", linewidth=1.2, alpha=0.5, zorder=3, label="Pareto Frontier")
# Scatterax.scatter(speedup, accuracy, c=colors, s=120, zorder=5, edgecolors="white", linewidths=1.2)
# Annotate each pointoffsets = {    "FP32": (8, -10),    "FP16": (8, 6),    "BF16": (8, -10),    "INT8 (PTQ)": (8, -10),    "INT8 (QAT)": (8, 6),    "INT4": (8, -10),}for lbl, sx, ac in zip(labels, speedup, accuracy):    dx, dy = offsets[lbl]    ax.annotate(lbl, (sx, ac), textcoords="offset points",                xytext=(dx, dy),                fontsize=9, fontweight="bold", color="#333")
ax.set_xlabel("Relative Speedup (× FP32)", fontsize=10)ax.set_ylabel("Accuracy (% of FP32 baseline)", fontsize=10)ax.set_title(    "CV Model Quantization: Speed vs Accuracy Pareto Front (ResNet-50)",    fontsize=12,    fontweight="bold",)ax.set_xlim(0.3, 6.5)ax.set_ylim(94.5, 101.0)ax.grid(True, linestyle="--", alpha=0.3)ax.spines["top"].set_visible(False)ax.spines["right"].set_visible(False)ax.legend(loc="lower left", fontsize=9)
plt.tight_layout()plt.savefig(    "static/img/generated/cv-deployment-quantization-pareto.png",    dpi=180,    bbox_inches="tight",    facecolor="white",)plt.close()
ONNX 模型验证
Section titled “ONNX 模型验证”导出 ONNX 后必须验证推理结果是否与原模型一致。量化后同理——每个优化步骤都要验证:
import onnxruntime as ortimport torchimport numpy as np
# 1. PyTorch 原始输出model = torchvision.models.resnet50(weights=torchvision.models.ResNet50_Weights.DEFAULT)model.eval()dummy = torch.randn(1, 3, 224, 224)with torch.no_grad():    pt_output = model(dummy).numpy()
# 2. ONNX Runtime 输出session = ort.InferenceSession("resnet50.onnx", providers=["CPUExecutionProvider"])ort_output = session.run(None, {"input": dummy.numpy()})[0]
# 3. 比较输出差异max_diff = np.max(np.abs(pt_output - ort_output))cos_sim = np.dot(pt_output.flatten(), ort_output.flatten()) / (    np.linalg.norm(pt_output) * np.linalg.norm(ort_output))print(f"最大绝对误差: {max_diff:.6f}")      # 应 < 1e-4print(f"余弦相似度:   {cos_sim:.8f}")       # 应 > 0.9999
FP32 → ONNX 的误差应 < (浮点精度差异)。FP32 → INT8 量化的余弦相似度通常 > 0.99。如果差异过大,说明导出有误(如动态轴处理错误)或量化校准数据不匹配。
部署检查清单
Section titled “部署检查清单”- 模型已设为
eval()模式(关闭 Dropout,BN 使用 running stats) - Conv+BN 已融合(或在框架中自动处理)
- 预处理逻辑与训练完全一致(归一化参数、resize 方式、颜色通道顺序 BGR/RGB)
- ONNX 导出后经 onnx-simplifier 简化
- 验证导出模型的输出与原模型一致(余弦相似度 > 0.9999)
- 量化后验证精度(mAP / Top-1 下降在可接受范围)
- 性能 benchmark(延迟 P50/P95/P99,吞吐量 QPS)
- 显存/内存峰值在预算内
- 异常输入测试(空图片、超大图片、损坏文件不 crash)
- 模型版本管理和灰度发布机制
2025–2026 最新进展
Section titled “2025–2026 最新进展”ONNX 生态的成熟
Section titled “ONNX 生态的成熟”2024–2025 年 ONNX 生态持续完善:ONNX Runtime 1.20+ 引入了全新的 Trainer API 和对 torch.compile 导出路径的原生支持,使得从 PyTorch 2.x 导出 ONNX 更加可靠。微软还推出了 ONNX Runtime Web(ORT Web) 的 v2 版本,支持 WebGPU 后端——浏览器中运行 CV 模型的延迟从秒级降到了百毫秒级,催生了一批纯前端的人脸检测、AR 试妆等应用。
TensorRT 10 与生成式 AI
Section titled “TensorRT 10 与生成式 AI”TensorRT 10(2024 年发布)对引擎编译做了重大改进:编译速度提升 2–5 倍(ResNet-50 从分钟级降到秒级),内存占用减半。更重要的是,TensorRT 10 增加了对扩散模型(Stable Diffusion)和大语言模型的优化支持——CV 与生成式 AI 的部署工具链正在融合。NVIDIA 还推出了 TensorRT-LLM,虽然主攻 LLM,但其中的 Continuous Batching、PagedAttention 等技术正在反向影响 CV 多模态模型的部署。
端侧推理框架百花齐放
Section titled “端侧推理框架百花齐放”移动端和边缘设备的 CV 部署框架在 2024–2025 年快速演进:
| 框架 | 维护方 | 目标平台 | 特点 |
|---|---|---|---|
| NCNN | Tencent | ARM CPU / Android / iOS | 极致轻量,无第三方依赖,移动端老牌方案 |
| MNN | Alibaba | ARM / Vulkan / iOS | 支持 GPU 加速(Vulkan),生态完整 |
| TFLite | Android / iOS / Micro | TFLite Micro 支持微控制器(< 1MB 内存) | |
| ONNX Runtime Mobile | Microsoft | Android / iOS | 包体积极小,支持量化与算子裁剪 |
| Core ML | Apple | macOS / iOS | 深度集成 Apple Neural Engine(ANE) |
| OpenVINO | Intel | Intel CPU / iGPU / VPU | Intel 硬件最优推理方案 |
| CANN / MindSpore Lite | Huawei | Ascend NPU | 华为昇腾芯片专用推理框架 |
INT4 与超低比特量化
Section titled “INT4 与超低比特量化”2024–2025 年,INT4 量化在 CV 模型上取得突破性进展。GPTQ(原为 LLM 设计)被成功适配到 ResNet、ViT 等 CV 模型,INT4 量化后精度损失仅 0.3–1%。高通的 AIMET 工具链提供了全流程的 PTQ + QAT 方案,在骁龙 8 Gen 3 的 Hexagon NPU 上实现 INT4 CNN 推理,吞吐量比 INT8 提升 2 倍。这与 量化与加速 中讨论的方法论一致,只是应用范围从 LLM 扩展到了 CV。
编译器路线:TVM 与 torch.compile
Section titled “编译器路线:TVM 与 torch.compile”传统推理引擎(TensorRT、ONNX Runtime)通过”手工优化算子库 + 图级规则优化”来加速。新一代 AI 编译器(TVM、torch.compile / TorchDynamo、XLA)走的是另一条路——把神经网络编译成底层的 C++ / CUDA / 汇编代码,用自动调度(auto-scheduling)搜索最优实现。
Apache TVM 的 Unity 路线在 2024 年引入了 MetaSchedule,自动搜索卷积 / 矩阵乘在特定硬件上的最优 kernel,对非标准硬件(如国产 NPU、RISC-V 加速器)特别有价值。PyTorch 2.x 的 torch.compile 则把这一能力集成进了训练框架本身——model = torch.compile(model) 一行代码即可获得 1.5–2× 推理加速,无需导出 ONNX 或单独编译引擎。
CV-CNN 在端侧的复兴
Section titled “CV-CNN 在端侧的复兴”虽然 Transformer 在云端大模型上占据主导,但 2024–2025 年的端侧 AI 浪潮让 轻量 CNN 重新成为焦点(详见 CNN 主线 的 2025–2026 前沿部分)。Google 的 MobileNetV4 用硬件感知 NAS 搜索手机 NPU 上的最优结构,配合 INT8 量化在 Pixel 8 上达到 1.5ms 推理延迟。EfficientFormerV2 把 Transformer 的全局注意力与 CNN 的局部卷积混合,在 iPhone 15 上实现 ViT 级精度的实时推理。这些模型的部署流程天然适配现有的 ONNX + TensorRT / NCNN 工具链,降低了工程门槛。
多模态模型的部署挑战
Section titled “多模态模型的部署挑战”2025 年最大的部署新挑战来自视觉语言模型(VLM),如 LLaVA、Qwen-VL。这类模型同时包含 CV 编码器(ViT / CLIP)和 LLM 解码器,需要同时优化两种截然不同的计算模式:
- ViT 编码器:计算密集型,适合 TensorRT 的 Conv / Attention kernel 融合。
- LLM 解码器:访存密集型,需要 KV Cache 管理和 PagedAttention。
目前的做法是将两部分分别部署在不同引擎上(ViT 用 TensorRT、LLM 用 TensorRT-LLM 或 vLLM),中间用高速 IPC 通信。统一的 VLM 推理引擎(如 NVIDIA Triton 的多模型管线)仍在快速迭代中。关于 LLM 部署的详细讨论见 LLM 模型部署。
典型类库与工具
Section titled “典型类库与工具”| 工具 | 类型 | 说明 |
|---|---|---|
| ONNX | 模型格式 | 开放神经网络交换格式,框架间模型转换的通用中间表示 |
| ONNX Runtime | 推理引擎 | 微软开发,跨平台 CPU/GPU 推理,部署简单 |
| TensorRT | 推理引擎 | NVIDIA 官方,GPU 推理性能最强,支持 INT8/FP16 |
| Triton Inference Server | 服务框架 | NVIDIA 开源推理服务,支持动态 batching、多模型管理 |
| OpenVINO | 推理引擎 | Intel 开发,针对 Intel CPU/iGPU/VPU 优化 |
| NCNN | 端侧推理 | 腾讯开源,移动端 ARM CPU 推理首选 |
| MNN | 端侧推理 | 阿里开源,支持 Vulkan GPU 加速 |
| TFLite | 端侧推理 | Google 开发,Android / 嵌入式设备 |
| Core ML Tools | 端侧推理 | Apple 平台模型转换与部署 |
| TVM | AI 编译器 | Apache 项目,跨硬件自动调优编译 |
| DALI | 数据加载 | NVIDIA GPU 加速图像预处理管线 |
| AIMET | 量化工具 | 高通的模型量化与压缩工具链 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 推理 | Inference | 模型训练完成后,用模型对输入数据做预测的过程 |
| 部署 | Deployment | 将训练好的模型集成到生产环境中运行的过程 |
| 中间表示 | Intermediate Representation (IR) | 框架无关的模型描述格式,ONNX 是最流行的 IR |
| 算子融合 | Operator / Kernel Fusion | 将相邻的多个计算算子合并为一个 GPU kernel,减少启动开销和显存读写 |
| 训练后量化 | Post-Training Quantization (PTQ) | 模型训练完成后,用少量校准数据统计激活分布,直接将 FP32 权重转为 INT8 |
| 量化感知训练 | Quantization-Aware Training (QAT) | 训练过程中模拟量化误差,让模型适应低精度,精度损失比 PTQ 更小 |
| 校准 | Calibration | PTQ 中用代表性数据统计激活值范围,确定量化缩放因子的过程 |
| 缩放因子 | Scale Factor | 量化中将浮点数映射到整数空间的系数 |
| 动态 Batching | Dynamic Batching | 将短时间窗口内到达的多个推理请求自动打包成 batch,提高吞吐量 |
| 执行提供器 | Execution Provider (EP) | ONNX Runtime 中适配不同硬件后端的插件机制 |
| kernel 调优 | Kernel Auto-tuning | 编译时对多种 GPU kernel 实现逐一运行并选最优的过程 |
| 显存复用 | Memory Reuse | 分析中间张量生命周期,对不重叠的张量复用同一段显存 |
| NMS | Non-Maximum Suppression | 目标检测后处理,去除重叠的冗余检测框 |
| 推理延迟 | Inference Latency | 单次推理请求从输入到输出结果的耗时 |
| 吞吐量 | Throughput (QPS) | 单位时间内能处理的推理请求数量 |
- ONNX 的局限:ONNX 并非万能——一些自定义算子(如可变形卷积、FlashAttention)不在标准 opset 中,需要写成自定义插件或等待社区支持。这也是 TVM 等 AI 编译器仍有价值的原因——它们可以自动生成未覆盖算子的实现。
- TensorRT 引擎的硬件绑定:TensorRT 引擎(
.engine)与编译时的 GPU 型号严格绑定——在 T4 上编译的引擎不能在 A100 上运行,换 GPU 型号需要重新编译。跨环境部署时应保留 ONNX 模型,在目标机器上现编引擎,或用容器固化环境。 - 更多量化细节:本页的量化部分侧重工程使用,关于 PTQ vs QAT 的精度对比、激活值分布分析、per-channel vs per-tensor 量化策略等深入内容,详见 量化与加速。
- GPU 并行与多卡:当单卡推理吞吐不足时,需要用多 GPU 并行处理。数据并行(每个 GPU 独立处理不同请求)是最简单的方案;模型并行(将大模型切分到多卡)适用于超大模型。详见 GPU 与多卡基础。
- LLM 部署的差异:LLM 部署与 CV 部署的技术栈差异很大——LLM 的核心瓶颈是 KV Cache 显存管理和自回归生成的访存带宽,而非 CV 的矩阵计算密度。详见 LLM 模型部署。