
模型评估与指标
本页介绍机器学习的评估方法论:如何科学地衡量一个模型好不好。无论你用决策树、SVM 还是深度网络(见 监督学习、卷积神经网络 CNN),训练完都要面对同一个问题——“这个模型到底行不行?“。选错指标会得出错误结论,划分数据不当会让评估虚高,这些都是实战中最常见的坑。评估方法论是数学基础与工程实践交汇的地方,也是写论文和做技术报告的通用语言。
模型评估要回答两个问题:模型在任务上表现如何(用对指标)、这个表现能不能推广到新数据(用对的验证方法)。常见误区是把训练集上的表现当成真实表现——模型可能只是”背下了”训练数据,遇到新数据就崩溃。
关键直觉:
- 分类用准确率可能骗人:一个 99% 是正常邮件、1% 是垃圾邮件的场景,模型全部预测”正常”就有 99% 准确率——但它根本没学会区分。这种”类别不平衡”问题要靠精确率、召回率、F1、AUC-ROC 来公正评价。
- 偏差-方差权衡:模型太简单会”学不会”(欠拟合/高偏差),太复杂会”死记硬背”(过拟合/高方差)。学习曲线能直观看出你卡在哪一头。
- 交叉验证 = 不浪费数据:把数据切成 K 份,轮流用每份做验证集,其余做训练集,K 次结果的平均更可靠,特别在数据量不大时。
混淆矩阵与分类指标
Section titled “混淆矩阵与分类指标”对一个二分类问题,所有预测结果可分为四种情况:
从这四个量推导出常用指标(纯文本公式):
| 指标 | 公式 | 含义与适用场景 |
|---|---|---|
| 准确率 Accuracy | (TP + TN) / 总数 | 整体预测对的比例;类别平衡时才有参考价值 |
| 精确率 Precision | TP / (TP + FP) | 预测为正的里,实际有多少是正;“宁可放过不可误杀”时关注它 |
| 召回率 Recall | TP / (TP + FN) | 实际为正的里,被抓出来多少;“宁可误杀不可放过”时关注它 |
| F1 分数 | 2 × P × R / (P + R) | 精确率与召回率的调和平均,平衡二者的单一指标 |
| AUC-ROC | —— | 不同阈值下召回率 vs 假正例率的曲线下面积,衡量排序能力 |
精确率 vs 召回率怎么选? 癌症筛查要高召回(漏诊代价大,宁可多做检查);垃圾邮件过滤要高精确(误杀重要邮件代价大,宁可漏放几封垃圾)。两者的权衡由任务的实际代价决定。
分类指标的数学推导
Section titled “分类指标的数学推导”F1 分数 = 精确率与召回率的调和平均
Section titled “F1 分数 = 精确率与召回率的调和平均”调和平均(Harmonic Mean) 的定义是:对两个正数 P 和 R,其调和平均为 2PR / (P + R)。为什么用调和平均而不是算术平均 (P + R) / 2?因为调和平均对极端值更”敏感”——只要 P 或 R 中有一个很小,结果就会被狠狠拉低。
推导过程(从调和平均定义出发):
将 P = TP/(TP+FP) 和 R = TP/(TP+FN) 代入,可化简为只含 TP/FP/FN 的形式:
直观理解:如果 P = 0.01、R = 1.0,算术平均给出 0.505(看起来还行),但 F1 只有 0.0198(暴露了精确率极低的真相)。调和平均”惩罚”了这种偏科,这正是我们想要的。
何时该用 / 不该用 F1:
- ✅ 正负类都不平衡,且两者同等重要时(如一般的二分类基准)
- ❌ 假正例和假反例代价不对称时——用 F_beta(beta > 1 偏召回,beta < 1 偏精确)代替
- ❌ 多分类时用 macro-F1(每类算 F1 再取算术平均)或 micro-F1(先汇总所有类的 TP/FP/FN 再算)
AUC-ROC 的概率解释
Section titled “AUC-ROC 的概率解释”AUC(Area Under the ROC Curve,ROC 曲线下面积)有一个优雅的概率解释:
即:随机取一个正样本和一个负样本,模型给正样本的分数高于负样本分数的概率。这意味着 AUC 衡量的是模型的排序能力——它能不能把正样本排在负样本前面,与具体阈值无关。
推导思路:ROC 曲线上的每一点对应一个阈值 t,坐标为 (FPR(t), TPR(t))。对所有阈值积分:
可以证明(通过交换积分顺序),这等价于对所有 (正样本 i, 负样本 j) 对做平均,统计 score(i) > score(j) 的比例。这正是上面的概率形式。
数值直觉:
- AUC = 0.5 → 模型排序能力等价于随机猜(正负分数随机分布)
- AUC = 1.0 → 所有正样本分数都高于所有负样本(完美排序)
- AUC < 0.5 → 比随机还差(通常说明标签反了)
何时该用 / 不该用 AUC-ROC:
- ✅ 类别较平衡、关注整体排序能力时
- ❌ 类别极度不平衡时——此时 FPR 的分母(TN)巨大,FPR 永远很小,ROC 曲线看起来”虚高”。这种场景应改用 PR 曲线与 AUC-PR
R²(决定系数)的数学定义
Section titled “R²(决定系数)的数学定义”R²(Coefficient of Determination,决定系数)衡量回归模型相对于”永远预测均值”这条基线的改善程度:
- SS_res(残差平方和):模型预测值与真实值之差的平方和
- SS_tot(总平方和):真实值与其均值之差的平方和,即”均值基线”的误差
解释:
- R² = 1.0 → 完美预测(SS_res = 0)
- R² = 0 → 模型等价于”永远预测均值”(没有任何 explanatory power)
- R² < 0 → 模型比”永远预测均值”还差(通常意味着模型严重错误)
⚠️ 注意:在测试集上,R² 可以为负。这并非 bug——它正确地告诉你模型还不如基线。训练集上的 R² 则永远 ≥ 0。
Cohen’s Kappa:修正随机一致性的分类指标
Section titled “Cohen’s Kappa:修正随机一致性的分类指标”Cohen’s Kappa(κ)衡量两个”评估者”(这里一个是模型、一个是真实标签)的一致程度,关键在于减去了”碰巧一致”的部分。在类别不平衡时,即使模型瞎猜多数类,准确率也会很高,而 Kappa 能识破这一点。
- p_o(observed agreement)= 实际一致率 = 准确率 = (TP + TN) / N
- p_e(expected agreement)= 假设两者独立时的期望随机一致率,由各类的边缘分布计算
p_e 的计算(以二分类为例):
解读标准(Landis & Koch,1977):
- κ < 0 → 一致性比随机还低(几乎不会出现)
- κ = 0 → 等于随机水平
- 0.4 < κ < 0.6 → 中等一致性
- 0.6 < κ < 0.8 → 良好一致性
- κ > 0.8 → 几乎完美一致
何时该用:类别不平衡严重、或者想消除”瞎猜多数类”带来的虚高准确率时。
Matthews 相关系数(MCC)
Section titled “Matthews 相关系数(MCC)”MCC(Matthews Correlation Coefficient,Matthews 相关系数)综合考虑 TP/FP/FN/TN 四个值,产生一个单一指标。它的数学性质在所有二分类指标中最优雅:
- 取值范围 [-1, +1]:+1 完美、0 随机、−1 全错
- 是一个φ系数(phi coefficient),本质上就是 2×2 列联表的皮尔逊相关系数
- 即使类别极度不平衡也可靠——不像 F1 那样对 TN 不敏感
MCC vs F1 的关键差异:F1 公式里没有 TN,所以在”绝大多数都是负样本”的场景(TN 巨大),F1 可能给出误导性的好成绩,而 MCC 会正确反映模型在负样本上的表现。很多研究表明 MCC 是二分类任务中信息量最大的单一指标。
过拟合 vs 欠拟合(学习曲线)
Section titled “过拟合 vs 欠拟合(学习曲线)”偏差-方差权衡(Bias-Variance Tradeoff):模型的总误差 = 偏差² + 方差 + 不可约噪声。欠拟合时偏差主导(模型表达能力不够),过拟合时方差主导(模型对训练数据太敏感)。正则化、增加数据、降低模型复杂度都能减小方差;增加特征、换更强模型能减小偏差。
偏差-方差分解的完整数学推导
Section titled “偏差-方差分解的完整数学推导”偏差-方差分解是机器学习理论中最优雅的结果之一。它把模型在测试点 x 处的期望泛化误差分解为三个可解释的部分。
设定:真实关系为 y = f(x) + ε,其中 f(x) 是真实函数,ε 是噪声,E[ε] = 0,Var(ε) = σ²。我们用训练集 D 训练得到模型 f̂_D(x),不同训练集 D 得到不同的 f̂_D(x)。
在某个测试点 x₀ 处,期望平方误差为:
注意这里的期望是对训练集 D 的随机性取的(y 本身因 ε 也是随机的)。推导过程:
最终结果:
其中:
- Bias(x₀) = E[f̂(x₀)] − f(x₀):模型预测的期望与真实值之差。偏差大 → 欠拟合(模型太简单,表达不了真实关系)
- Var(x₀) = E[(f̂(x₀) − E[f̂(x₀)])²]:模型预测在不同训练集上的波动。方差大 → 过拟合(对训练数据太敏感)
- σ²(不可约噪声,Irreducible Noise):数据本身的噪声,任何模型都无法消除
实践指导:
- 模型复杂度 ↑ → Bias ↓、Var ↑(U 形误差曲线的左右两侧)
- 增加数据量主要降低 Var(方差),对 Bias 影响不大
- 增加模型复杂度(更深网络、更多特征)降低 Bias,但可能增加 Var
- 正则化(L1/L2、dropout、early stopping)直接抑制 Var,代价是可能略增 Bias
- 学习曲线(见下文代码)能帮你判断当前是 Bias 主导还是 Var 主导,从而决定该”加数据”还是”加复杂度”
铁律:测试集只能用一次。 在测试集上调超参等于”偷看答案”,评估会虚高。如果数据很少,用交叉验证代替固定验证集,但测试集仍然要严格隔离到最后。
更多评估指标
Section titled “更多评估指标”上面介绍的是最基础的分类/回归指标。实际工作中还有一批专门针对特定场景的指标——不平衡数据、多分类排序、文本生成、语言模型——它们在各自领域是标配。
PR 曲线与 AUC-PR
Section titled “PR 曲线与 AUC-PR”PR 曲线(Precision-Recall Curve,精确率-召回率曲线)以召回率为横轴、精确率为纵轴,画出不同阈值下的 (R, P) 点。其下面积 AUC-PR 在类别极度不平衡时比 AUC-ROC 更有区分度。
为什么?在正样本只有 1% 的场景中:
- ROC 的 FPR = FP/(FP+TN),TN 巨大 → FPR 永远很小 → ROC 曲线”虚高”到接近左上角
- PR 曲线的 Precision = TP/(TP+FP),直接受 FP 影响 → 只要 FP 多,Precision 立刻降 → 更真实地反映少数类的预测质量
经验法则:正负比 < 1:10 时,优先看 PR 曲线和 AUC-PR。何时该用:欺诈检测、罕见疾病筛查、缺陷检测——凡是”正样本稀少”的场景。
Top-K 准确率
Section titled “Top-K 准确率”Top-K Accuracy(Top-K 准确率):只要真实标签在模型预测概率最高的 K 个类别中,就算正确。
Top-K Acc = (预测概率 Top-K 中包含真实标签的样本数) / 总样本数- Top-1 就是普通准确率
- Top-5 在 ImageNet 图像分类中是标配(1000 类中猜对前 5 个就算 OK)
- 推荐系统中常用 Recall@K(推荐 K 个商品中用户实际喜欢了多少)
何时该用:类别很多(多分类/多标签)、或”猜个大概就行”的场景(推荐、搜索、图像检索)。
BLEU / ROUGE / METEOR(文本生成评估)
Section titled “BLEU / ROUGE / METEOR(文本生成评估)”这三者是机器翻译、文本摘要、图像描述等文本生成任务的标准自动评估指标。
BLEU(Bilingual Evaluation Understudy,双语评估替补):
- 核心思想:将模型输出与人工参考译文按 n-gram(连续 n 个词)做匹配,计算匹配比例
- BLEU-n:n-gram 精确率(precision),BLEU-4 最常用
- 引入 brevity penalty(简短惩罚):防止模型只输出极短句子来刷精确率
其中 ,
( = 输出长度, = 参考长度)
- 优点:计算快、可复现、广泛用于机器翻译基准
- 缺点:只看表面 n-gram 重叠,不关心语义;对同义词改写惩罚过重
ROUGE(Recall-Oriented Understudy for Gusting Evaluation):
- 与 BLEU 偏精确率不同,ROUGE 偏召回率——参考译文中的 n-gram 有多少被模型输出覆盖
- ROUGE-N:参考译文中 n-gram 的召回率
- ROUGE-L:基于最长公共子序列(LCS)的 F 分数
- 何时用:文本摘要任务的标准指标(参考文本通常较长,要衡量”覆盖了多少要点”)
METEOR(Metric for Evaluation of Translation with Explicit ORdering):
- 在 n-gram 匹配基础上引入同义词匹配和词干还原(stemming)
- 对语序和精确匹配给予不同权重,与人工评价相关性比 BLEU 更高
- 何时用:需要更高的人工评价相关性时(代价是依赖外部同义词资源)
共同局限:BLEU/ROUGE/METEOR 都是”表面词重叠”指标,无法捕捉语义等价性。“猫坐在垫子上”和”小猫待在地毯上”语义一致但 n-gram 重叠为 0。现代 LLM 评估更多转向语义相似度(BERTScore)和 LLM-as-Judge。
Perplexity(困惑度)
Section titled “Perplexity(困惑度)”Perplexity(PPL,困惑度)是自回归语言模型最经典的评估指标,衡量模型对一段文本的”困惑程度”。
数学定义——给定一段文本 w₁, w₂, …, w_N,模型的困惑度为交叉熵的指数:
直观解释:
- PPL = 模型在每个位置上”等效的有效选择数”。PPL = 10 意味着模型在每个词位置上像是在 10 个等概率候选中”犹豫”
- PPL 越低 → 模型对真实文本的概率估计越高 → 模型”更不困惑”
- 最低 PPL 理论上等于文本的真实熵(entropy)
何时该用 / 不该用:
- ✅ 评估语言模型本身的建模能力(PTB、WikiText 等标准语料的 PPL 是经典基准)
- ✅ 比较同一架构不同训练阶段的模型(如预训练过程中的监控指标)
- ❌ 不能直接反映下游任务表现——PPL 低不代表问答/翻译/摘要质量好
- ❌ 跨不同 tokenizer / 词汇表比较没有意义(PPL 依赖分词方式)
[!NOTE] Perplexity 与 信息论中的交叉熵直接相关:PPL = exp(交叉熵)。对语言模型来说,最小化交叉熵 = 最小化 PPL = 最大化数据的对数似然。
校准度(Calibration)与 Brier Score / ECE
Section titled “校准度(Calibration)与 Brier Score / ECE”模型的置信度应该与实际正确率一致——一个说”我有 90% 把握”的预测,应该真的有 90% 的概率正确。这叫校准度(Calibration)。
Brier Score(布莱尔分数):衡量概率预测的均方误差,越小越好:
其中 = 模型预测的概率, = 实际结果(0 或 1)。
- BS = 0 → 完美概率预测
- BS 越小越好。可以分解为三部分:校准损失(calibration loss)+ 区分度(refinement)+ 不确定性
ECE(Expected Calibration Error,期望校准误差):将预测按置信度分桶,计算每桶的”平均置信度”与”平均准确率”之差的加权绝对值:
其中 = 第 b 个置信度区间内的样本, = 该区间内的平均预测概率, = 该区间内的实际正确率。
ECE = 0 → 完美校准。ECE 大 → 模型”嘴上说很确定,实际没那么准”(过度自信)。
何时关注校准:医疗诊断、自动驾驶、风控——任何需要基于模型置信度做决策(而非仅排序)的场景。深度学习模型普遍过度自信(overconfident),需要通过温度缩放(temperature scaling)、Platt scaling 等后处理来校准。
可靠性图(Reliability Diagram):以置信度为横轴、实际准确率为纵轴画柱状图。完美校准的模型,所有柱子落在对角线上;偏离对角线说明该置信度区间存在系统性偏差。
最新进展(2024–2025)
Section titled “最新进展(2024–2025)”传统的准确率 / F1 / BLEU 等指标在大模型时代面临前所未有的挑战。以下是近年来评估范式的重大变化。
LLM-as-Judge:用大模型评估大模型
Section titled “LLM-as-Judge:用大模型评估大模型”传统评估指标(BLEU、ROUGE)无法衡量 LLM 生成内容的质量——因为它们只看表面词重叠。2023 年起兴起的 LLM-as-Judge(大模型评审)方法(代表工作:Zheng et al., 2023, “Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena”)让一个强大的 LLM(如 GPT-4)充当裁判,对被评估模型的输出打分或做两两比较。
典型范式:
- 成对比较(Pairwise):给两个模型的回答,让裁判模型选更好的一个
- 单答打分(Pointwise):给一个回答,按多维度(有帮助性、安全性、准确性)打 1-10 分
- 参考答案对比(Reference-guided):提供标准答案,裁判评估模型回答与标准答案的吻合度
已知问题:
- 位置偏差(Position Bias):裁判可能偏好第一个或第二个回答 → 解决方案:交换顺序做两次,取一致结果
- 冗长偏差(Verbosity Bias):裁判偏好更长的回答 → 需要控制长度
- 自我偏好(Self-Bias):GPT-4 倾向于给 GPT-4 系列的回答打高分
- 能力上限:裁判模型在需要超出自身能力的推理时不可靠(“弱裁判评强模型”问题)
新兴基准:对传统评估的改进
Section titled “新兴基准:对传统评估的改进”经典基准(MMLU、GSM8K、HumanEval)在 2024-2025 年暴露出严重局限——饱和(顶级模型接近满分)和数据污染。新一代基准应运而生:
- MMLU-Pro(Wang et al., 2024):在 MMLU 基础上扩充到 10 个选项(原为 4 个,降低猜对概率)、增加推理难度、覆盖 14 个领域。原本 90%+ 的模型在 MMLU-Pro 上骤降到 70% 左右
- GPQA(Graduate-Level Google-Proof Q&A,Rein et al., 2023):博士级科学问答,专门设计成”Google 搜不到答案”,需要深度推理。专家在自己领域外也难以靠搜索回答
- ARC-AGI(Abstraction and Reasoning Corpus for AGI,Chollet, 2019;2024 版重新关注):视觉抽象推理任务,衡量”学习新规则”的泛化能力。当前 LLM 在此基准上表现远低于人类——它暴露了 LLM 在真正 few-shot 泛化上的短板
- SWE-bench(Jimenez et al., 2023):真实 GitHub issue 的代码修复任务,要求模型理解整个代码库。这是目前最接近”软件工程能力”的评估
- LiveBench / LiveCodeBench(2024):持续更新题库,对抗数据污染——每月发布新题,确保模型不可能在训练时见过
评估的可复现性危机:数据污染与 Benchmark Leakage
Section titled “评估的可复现性危机:数据污染与 Benchmark Leakage”2024 年的一个重大发现:许多公开基准的测试集已经泄漏进了主流 LLM 的训练数据。这导致排行榜上的高分部分是”背诵”而非”推理”。
- 数据污染(Data Contamination):测试集出现在训练集中,模型记住了答案。表现为:在原始测试集上分数虚高,而在略有改写的版本上骤降
- 检测方法:给测试样本做 paraphrase 或 perturbation,观察分数是否大幅下降;或检查模型能否逐字背诵测试集内容
- 应对策略:动态评估(实时生成新题)、私有测试集(不公开发布,如 Kaggle 竞赛的隐藏测试集)、使用反事实 / 对抗变体
这一问题使得 2024 年前的许多 benchmark 成绩需要重新审视。社区正在推动动态基准和对抗性评估成为新标准。
人类偏好评估:Elo Rating 与 Bradley-Terry 模型
Section titled “人类偏好评估:Elo Rating 与 Bradley-Terry 模型”LLM 的很多能力(有帮助性、安全风格、创意写作)无法用客观指标衡量,只能靠人类判断。Chatbot Arena(LMSYS,2023-)成为事实标准:用户输入一条 prompt,两个匿名模型的回答并排呈现,用户投票选出更好的一个。基于这些成对比较:
- Elo Rating(埃洛等级分,源自国际象棋):每场比赛后,赢家分数上升、输家下降,幅度取决于两者的分差和期望胜率。模型在 Arena 上的 Elo 分数实时更新
- Bradley-Terry 模型:假设每个模型 i 有一个实力参数 β_i,模型 i 战胜模型 j 的概率为:
这等价于逻辑回归——用所有成对比赛结果做极大似然估计,得到每个模型的 Bradley-Terry 分数。相比 Elo,Bradley-Terry 能利用全部历史数据联合优化,估计更稳定。
争议:人类偏好本身有噪声和偏差(偏好更长的回答、偏好礼貌但不正确的回答)。社区正在研究如何结合 LLM-as-Judge 与人类标注来降低成本。
动态评估与对抗性评估
Section titled “动态评估与对抗性评估”- 动态评估(Dynamic Evaluation):不使用固定题库,而是根据模型能力实时生成新难度的问题。代表:Dynabench(Li et al., 2023)、ARES。核心理念是”模型一旦在某个基准上饱和,该基准就不再有区分力,必须进化”
- 对抗性评估(Adversarial Evaluation):专门设计能”难倒”模型的问题。包括对抗样本(输入微小扰动导致输出反转)、OOD 推理(训练分布外的问题)、红队测试(Red Teaming,专门探测安全漏洞和幻觉)
sklearn:分类报告 + 交叉验证
Section titled “sklearn:分类报告 + 交叉验证”from sklearn.datasets import load_breast_cancerfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.model_selection import cross_val_score, train_test_splitfrom sklearn.metrics import classification_report
X, y = load_breast_cancer(return_X_y=True)X_tr, X_te, y_tr, y_te = train_test_split(X, y, random_state=42)
clf = RandomForestClassifier(random_state=42)clf.fit(X_tr, y_tr)
# 1. 分类报告:精确率/召回率/F1 一目了然print(classification_report(y_te, clf.predict(X_te)))# 2. 5 折交叉验证:更稳健的准确率估计scores = cross_val_score(clf, X, y, cv=5)print(f"5 折准确率: {scores.mean():.3f} ± {scores.std():.3f}")# 输出示例: 5 折准确率: 0.961 ± 0.023回归任务对应的是
mean_squared_error(MSE)、mean_absolute_error(MAE)、r2_score(R²)。MSE 对大误差更敏感(平方放大),MAE 更鲁棒,R² 是”模型比’永远预测均值’好多少”的比例(1.0 完美,0 等于瞎猜)。
混淆矩阵可视化(seaborn heatmap)
Section titled “混淆矩阵可视化(seaborn heatmap)”混淆矩阵(Confusion Matrix)可视化能一眼看出模型在哪两类之间容易混淆:
import matplotlib.pyplot as pltimport seaborn as snsfrom sklearn.datasets import load_breast_cancerfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import confusion_matrix
X, y = load_breast_cancer(return_X_y=True)X_tr, X_te, y_tr, y_te = train_test_split(X, y, random_state=42)clf = RandomForestClassifier(random_state=42).fit(X_tr, y_tr)
cm = confusion_matrix(y_te, clf.predict(X_te))
plt.figure(figsize=(5, 4))sns.heatmap(cm, annot=True, fmt='d', cmap='Blues',            xticklabels=['预测: 恶性', '预测: 良性'],            yticklabels=['实际: 恶性', '实际: 良性'])plt.ylabel('真实标签'); plt.xlabel('预测标签')plt.title('混淆矩阵')plt.tight_layout(); plt.show()# 对角线(TP/TN)越深越好,非对角线(FP/FN)越浅越好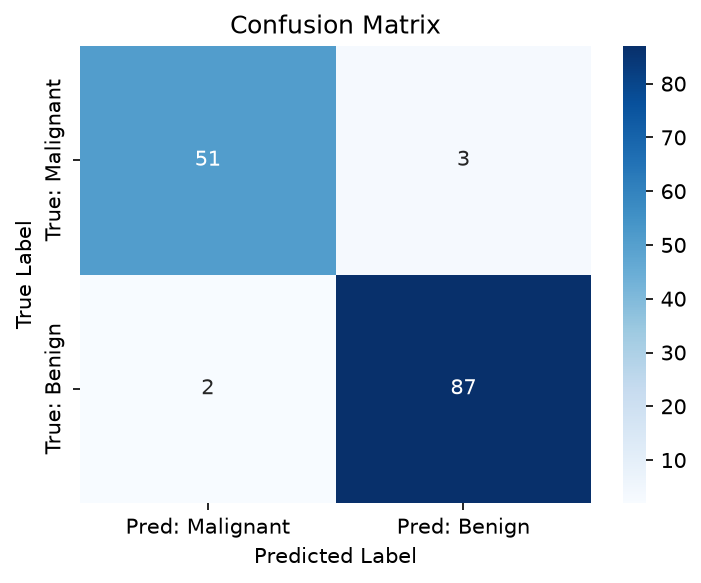
ROC 曲线与 PR 曲线绘制
Section titled “ROC 曲线与 PR 曲线绘制”ROC 和 PR 曲线对比——注意在类别不平衡时两者的差异:
import matplotlib.pyplot as pltfrom sklearn.datasets import make_classificationfrom sklearn.linear_model import LogisticRegressionfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import (roc_curve, auc,                             precision_recall_curve, average_precision_score)
# 造一个极度不平衡的数据集(正样本仅 5%)X, y = make_classification(n_samples=5000, weights=[0.95, 0.05], random_state=42)X_tr, X_te, y_tr, y_te = train_test_split(X, y, random_state=42)clf = LogisticRegression().fit(X_tr, y_tr)scores = clf.predict_proba(X_te)[:, 1]   # 正类概率
# --- ROC 曲线 ---fpr, tpr, _ = roc_curve(y_te, scores)roc_auc = auc(fpr, tpr)
# --- PR 曲线 ---precision, recall, _ = precision_recall_curve(y_te, scores)pr_auc = average_precision_score(y_te, scores)   # AUC-PR
fig, axes = plt.subplots(1, 2, figsize=(12, 5))
axes[0].plot(fpr, tpr, label=f'AUC-ROC = {roc_auc:.3f}')axes[0].plot([0, 1], [0, 1], '--', color='gray', label='随机基线')axes[0].set_xlabel('假正例率 FPR'); axes[0].set_ylabel('真正例率 TPR')axes[0].set_title('ROC 曲线'); axes[0].legend()
axes[1].plot(recall, precision, label=f'AUC-PR = {pr_auc:.3f}')axes[1].axhline(y=sum(y_te)/len(y_te), linestyle='--', color='gray', label='随机基线')axes[1].set_xlabel('召回率 Recall'); axes[1].set_ylabel('精确率 Precision')axes[1].set_title('PR 曲线'); axes[1].legend()
plt.tight_layout(); plt.show()# 在不平衡数据上,ROC 看起来不错(AUC ~0.9+),但 PR 曲线暴露了# 精确率在某些召回率区间急剧下降——这正是 PR 曲线更有区分力的地方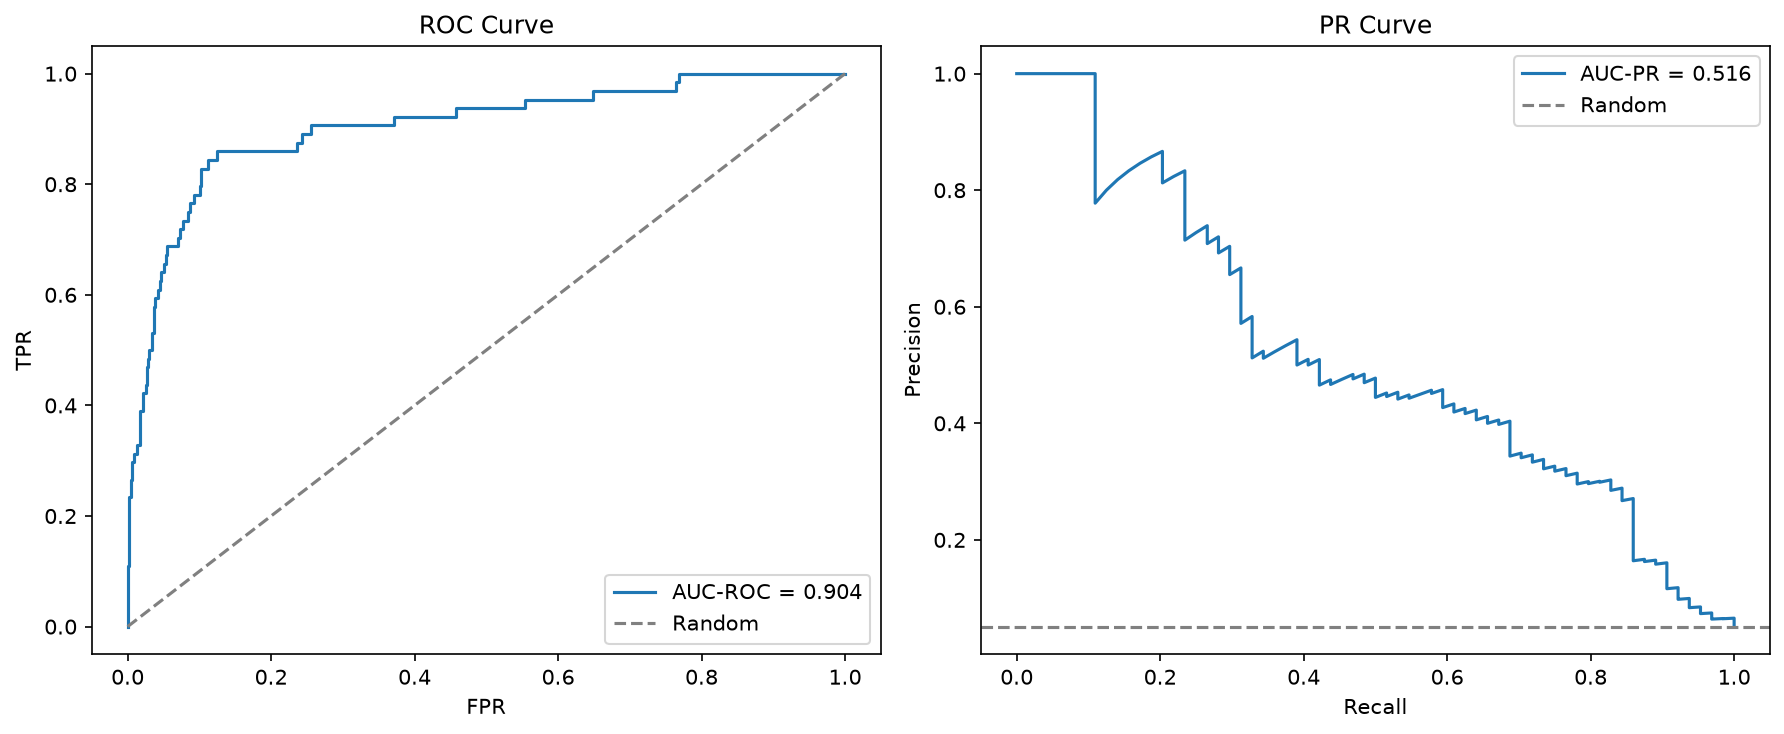
学习曲线:判断过拟合还是欠拟合
Section titled “学习曲线:判断过拟合还是欠拟合”学习曲线(Learning Curve)画出训练集大小 vs 训练/验证分数。两条线的形态直接告诉你模型处于什么状态:
import numpy as npimport matplotlib.pyplot as pltfrom sklearn.model_selection import learning_curvefrom sklearn.ensemble import RandomForestClassifierfrom sklearn.datasets import load_breast_cancer
X, y = load_breast_cancer(return_X_y=True)clf = RandomForestClassifier(random_state=42)
train_sizes, train_scores, val_scores = learning_curve(    clf, X, y, cv=5, train_sizes=np.linspace(0.1, 1.0, 10),    scoring='accuracy', n_jobs=-1)
train_mean = train_scores.mean(axis=1)val_mean = val_scores.mean(axis=1)train_std = train_scores.std(axis=1)val_std = val_scores.std(axis=1)
plt.figure(figsize=(8, 5))plt.plot(train_sizes, train_mean, 'o-', label='训练集准确率')plt.plot(train_sizes, val_mean, 's-', label='验证集准确率')plt.fill_between(train_sizes, train_mean - train_std, train_mean + train_std, alpha=0.1)plt.fill_between(train_sizes, val_mean - val_std, val_mean + val_std, alpha=0.1)plt.xlabel('训练样本数'); plt.ylabel('准确率')plt.title('学习曲线'); plt.legend(); plt.grid(True, alpha=0.3)plt.tight_layout(); plt.show()
# 解读:# - 训练分高、验证分低、差距大  → 过拟合(高方差)→ 加数据 / 降复杂度 / 正则化# - 两条线都低且接近            → 欠拟合(高偏差)→ 加特征 / 换更强模型# - 两条线都高且接近、趋于收敛  → 理想状态# - 验证分仍在上升              → 加数据可能还有提升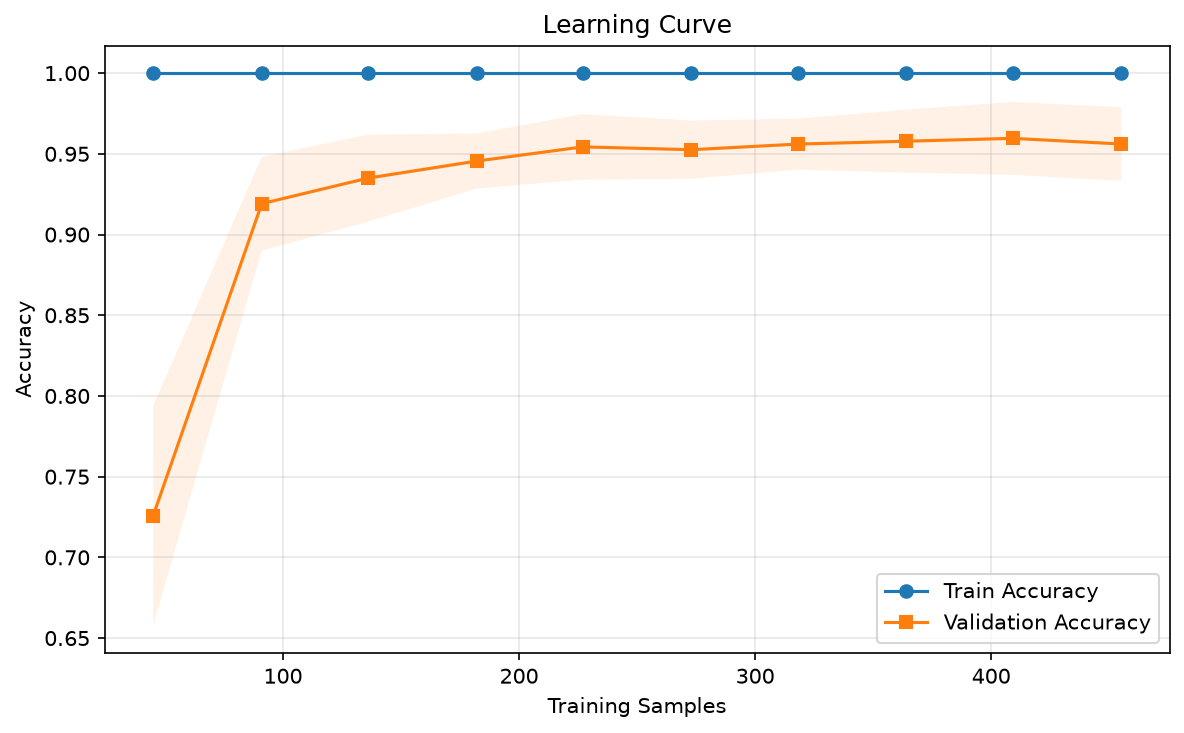
分层 K 折交叉验证
Section titled “分层 K 折交叉验证”对类别不平衡的数据,普通 KFold 可能某些折里完全没有少数类样本。分层抽样保证每折的类别比例与整体一致:
from sklearn.datasets import make_classificationfrom sklearn.linear_model import LogisticRegressionfrom sklearn.model_selection import cross_val_score, StratifiedKFold, KFoldimport numpy as np
# 不平衡数据集:正类仅 5%X, y = make_classification(n_samples=1000, weights=[0.95, 0.05], random_state=42)
clf = LogisticRegression()
# 普通 KFold:可能某折里几乎没有正样本kfold = KFold(n_splits=5, shuffle=True, random_state=42)scores_plain = cross_val_score(clf, X, y, cv=kfold, scoring='f1')
# StratifiedKFold:每折类别比例保持一致skfold = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)scores_strat = cross_val_score(clf, X, y, cv=skfold, scoring='f1')
print(f'普通 KFold   F1: {scores_plain.mean():.3f} ± {scores_plain.std():.3f}')print(f'分层 KFold   F1: {scores_strat.mean():.3f} ± {scores_strat.std():.3f}')# 分层 KFold 的方差通常更小,估计更可靠——分类任务几乎总应该用它
用困惑度评估语言模型
Section titled “用困惑度评估语言模型”以下示例展示如何用 PyTorch 计算一个语言模型在给定文本上的困惑度(Perplexity):
import torchfrom transformers import AutoTokenizer, AutoModelForCausalLM
def compute_perplexity(model_name, text, device='cuda'):    """计算语言模型在给定文本上的困惑度"""    tokenizer = AutoTokenizer.from_pretrained(model_name)    model = AutoModelForCausalLM.from_pretrained(model_name).to(device)    model.eval()
    encodings = tokenizer(text, return_tensors='pt').to(device)    input_ids = encodings['input_ids']    # seq_len = input_ids.shape[1]
    with torch.no_grad():        outputs = model(input_ids, labels=input_ids)        # HuggingFace 的 CausalLM 会自动算交叉熵损失        neg_log_likelihood = outputs.loss   # 已经是平均交叉熵
    perplexity = torch.exp(neg_log_likelihood)    return perplexity.item()
# 示例:比较两个模型在同一段文本上的困惑度text = "机器学习是人工智能的一个分支,它使计算机能够从数据中学习规律。"
# ppl_small = compute_perplexity("gpt2", text)           # 较小模型,PPL 通常更高# ppl_large = compute_perplexity("gpt2-medium", text)     # 较大模型,PPL 更低# print(f"GPT-2 small  PPL: {ppl_small:.2f}")# print(f"GPT-2 medium PPL: {ppl_large:.2f}")# PPL 越低 → 模型对这段文本的预测越自信 → 在该文本上"建模能力"越强
⚠️ 困惑度只能在相同 tokenizer 下比较两个模型。不同词汇表/分词方式的 PPL 数值没有可比性。PPL 低也不代表下游任务好——它是必要非充分条件。
- 类别不平衡时禁用准确率:99:1 的数据分布下,全预测多数类就有 99% 准确率。这时看 F1、AUC-ROC,或者看少数类的精确率/召回率;极度不平衡(1:100 以上)时优先用 AUC-PR 和 MCC。
- 单指标选哪个?MCC 信息量最大:MCC 同时考虑 TP/FP/FN/TN 四个值,在所有类别平衡条件下都不会被”欺骗”。需要向非技术读者报告时用 F1(更直觉),做严谨模型对比时用 MCC。
- 交叉验证的折数:K=5 或 K=10 最常用。数据少时用更大的 K(如留一法 LOOCV)榨取更多信息,但计算更贵且方差更大。分层抽样(
StratifiedKFold)保证每折类别比例一致,分类任务必用。 - 时间序列不能随机划分:必须按时间切分——用过去数据训练、未来数据验证,否则相当于”用未来预测过去”,评估完全失效。
- 超参调优用验证集,定稿后用测试集:网格搜索 / 贝叶斯优化在验证集上选超参,最终模型在测试集上只评估一次,结果才是可发表的。
- 回归指标看场景:关注异常值用 MSE/RMSE,关注平均表现用 MAE,需要相对解释力用 R²。
- 文本生成评估别只靠 BLEU/ROUGE:它们只看表面词重叠,与人工评价相关性有限。2024 年起主流做法是 BLEU/ROUGE 做快速筛选 + LLM-as-Judge 或 BERTScore 做质量评估。
- 关注模型校准度:如果你的系统会根据模型置信度做决策(如”置信度 > 0.9 才自动审批”),必须检查校准度(ECE、Brier Score)。深度学习模型普遍过度自信,必要时用温度缩放校准。
- LLM 评估要看 LiveBench 类动态基准:静态基准有数据污染风险。如果模型在 MMLU 上 90%+ 但在 MMLU-Pro 上只有 70%,说明有背诵成分。
- 模型选择与超参调优:比较决策树 vs SVM vs 随机森林时,用交叉验证的分数决定选哪个;选定模型后用验证集调
max_depth、C等超参。这是任何机器学习项目的标准流程。 - 不平衡分类(欺诈检测、疾病筛查、故障预测):欺诈交易只占 0.1%,用精确率-召回率曲线(PR Curve)和 AUC-PR 比 ROC 更能反映真实表现。银行反欺诈、医院疾病早筛都依赖这些指标;需要单一对比指标时用 MCC。
- 论文与竞赛报告标准:学术论文和 Kaggle 竞赛都有明确的评估指标(accuracy、F1、AUC、MCC、RMSE 等),结果必须用交叉验证或多随机种子平均来保证可复现性。
- A/B 测试中的模型上线评估:离线指标(F1、AUC)只做初筛,线上效果最终要看业务指标(点击率、转化率)。模型评估方法论是离线评估的基础。
- 风险决策系统的模型校准:信贷审批、医疗辅助诊断等场景不仅需要模型预测准,还需要置信度可靠——“90% 确信会违约”的客户确实应该有约 90% 的违约率。这类系统必须检查 ECE 和 Brier Score,必要时用温度缩放校准。
- LLM 能力评估与排行榜:MMLU-Pro、GPQA、HumanEval、SWE-bench 等基准衡量 LLM 的知识、推理、编码能力;Chatbot Arena 用人类偏好的 Elo rating 衡量对话质量;Perplexity 用于监控预训练进度。现代 LLM 评估已经从”单一准确率”演变为多维度、多基准的综合评估体系。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
scikit-learn metrics | Python | 全套分类/回归/排序指标,classification_report 一行出报告;含 cohen_kappa_score、matthews_corrcoef、brier_score_loss、roc_auc_score、average_precision_score |
scikit-learn model_selection | Python | K 折/分层/留一交叉验证、网格搜索、随机搜索、learning_curve |
| seaborn / matplotlib | Python | 混淆矩阵 heatmap、ROC/PR 曲线、学习曲线等可视化 |
| sacrebleu / rouge-score | Python | BLEU / ROUGE 标准化实现(机器翻译、文本摘要评估) |
| evaluate(HuggingFace) | Python | 统一接口调用 BLEU、ROUGE、BERTScore、Perplexity 等数十种指标 |
| lm-evaluation-harness(EleutherAI) | Python | 开源 LLM 评估框架,支持 MMLU、HellaSwag、GSM8K 等数十种 benchmark |
| Yellowbrick | Python | 可视化诊断工具,学习曲线、ROC 曲线、残差图开箱即用 |
scipy.stats | Python | 模型比较的统计检验(t 检验、Wilcoxon 检验) |
Weka / R caret | Java / R | 传统机器学习评估工具包,适合教学与统计背景用户 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 混淆矩阵 | Confusion Matrix | TP/FP/FN/TN 四象限表,分类指标的基础 |
| 精确率 | Precision | 预测为正中实际为正的比例 |
| 召回率 | Recall | 实际为正中被正确预测的比例 |
| F1 分数 | F1-score | 精确率与召回率的调和平均 |
| AUC-ROC | Area Under ROC Curve | ROC 曲线下面积,衡量分类器的排序能力;等于 P(score(正) > score(负)) |
| AUC-PR | Area Under PR Curve | PR 曲线下面积,不平衡数据场景比 AUC-ROC 更可靠 |
| Cohen’s Kappa | Cohen’s Kappa | 修正随机一致性的分类一致度指标,消除”瞎猜多数类”的虚高 |
| MCC | Matthews Correlation Coefficient | 综合考虑 TP/FP/FN/TN 的单一相关指标,即使类别极度不平衡也可靠 |
| R²(决定系数) | Coefficient of Determination | 回归模型相对均值基线的改善比例,1.0 完美、0 等于基线 |
| Top-K 准确率 | Top-K Accuracy | 真实标签在预测概率最高的 K 个类别中即算正确 |
| BLEU | BLEU | 基于 n-gram 精确率的机器翻译评估指标 |
| ROUGE | ROUGE | 基于 n-gram 召回率的文本摘要评估指标 |
| METEOR | METEOR | 引入同义词和词干匹配的翻译评估指标,与人工评价相关性更高 |
| 困惑度 | Perplexity | 语言模型交叉熵的指数,衡量模型对文本的”困惑程度”,越低越好 |
| Brier Score | Brier Score | 概率预测的均方误差,衡量校准度和准确度 |
| ECE | Expected Calibration Error | 期望校准误差,衡量置信度与实际正确率的偏差 |
| 校准度 | Calibration | 模型置信度与实际正确率的一致程度 |
| 偏差-方差权衡 | Bias-Variance Tradeoff | 模型复杂度与泛化能力的权衡关系 |
| 交叉验证 | Cross-Validation | 数据分 K 折轮流验证的评估方法 |
| 过拟合 | Overfitting | 模型在训练集表现好、验证/测试集表现差(高方差) |
| 欠拟合 | Underfitting | 模型在训练集和验证集都表现差(高偏差) |
| 不可约噪声 | Irreducible Noise | 数据本身的噪声,任何模型都无法消除(偏差-方差分解中的 σ²) |
| 数据污染 | Data Contamination | 测试集泄漏到训练集中,导致评估虚高 |
| LLM-as-Judge | LLM-as-Judge | 用强大 LLM 充当裁判评估其他模型的输出质量 |
| Elo Rating | Elo Rating | 基于成对比赛结果实时更新的能力评分系统,用于 Chatbot Arena |
经典基础
- 偏差-方差分解:理论推导见 Hastie et al.《The Elements of Statistical Learning》第 2 章和第 7 章,是理解过拟合的经典论述。
- 不平衡学习:He & Garcia (2009) “Learning from Imbalanced Data” 综述,系统讨论重采样、代价敏感学习等方法。
- 交叉验证的统计性质:关于 K 折与留一法方差的深入分析,见 Kohavi (1995) “A Study of Cross-Validation and Bootstrap for Accuracy Estimation and Model Selection”。
- MCC vs F1 的系统比较:Chicco & Jurman (2020) “The advantages of the Matthews correlation coefficient (MCC) over F1 score and accuracy in binary classification evaluation”,论证 MCC 是二分类信息量最大的单一指标。
- 校准度:Guo et al. (2017) “On Calibration of Modern Neural Networks”,系统分析深度网络过度自信问题并提出温度缩放校准法。
LLM 评估(2023–2025)
- LLM-as-Judge:Zheng et al. (2023) “Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena”(arXiv:2306.05685),开创用 GPT-4 评审模型输出的范式。
- MMLU-Pro:Wang et al. (2024) “MMLU-Pro: A More Robust and Challenging Benchmark for LLMs”(arXiv:2406.01574),对 MMLU 的全面升级。
- GPQA:Rein et al. (2023) “GPQA: A Graduate-Level Google-Proof Q&A Benchmark”(arXiv:2311.12022),博士级科学问答。
- Chatbot Arena 与 Bradley-Terry:Chiang et al. (2024) “Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference”(arXiv:2403.04132),Arena 评分系统的统计方法。
- 数据污染综述:Balloççe & Renoust (2024) 对 LLM benchmark contamination 的系统梳理,涵盖检测方法和影响分析。
- SWE-bench:Jimenez et al. (2023) “SWE-bench: Can Language Models Resolve Real-World GitHub Issues?”(arXiv:2310.06770),真实软件工程评估。
- LiveBench:White et al. (2024) “LiveBench: A Challenging, Contamination-Limited LLM Benchmark”(arXiv:2406.19314),持续更新的动态基准。
工具与平台
- Chatbot Arena(
https://chat.lmsys.org):LMSYS 维护的实时人类偏好评估平台,是 LLM 能力排名的事实标准。 - Open LLM Leaderboard(Hugging Face):社区驱动的开源模型评估排行榜。
- lm-evaluation-harness(EleutherAI):开源 LLM 评估框架,支持数十种 benchmark 的标准化评估。
相关文档