用于非线性可分数据的支持向量机
在本教程中,你将学习如何:
- 当训练数据无法线性分离时,定义 SVM 的优化问题。
- 如何配置参数以使你的 SVM 适应这类问题。
为什么扩展 SVM 优化问题以处理非线性可分训练数据很有趣?在计算机视觉中使用 SVM 的大多数应用都需要比简单的线性分类器更强大的工具。这源于这样一个事实:在这些任务中,训练数据很少能使用一个超平面来分离。
考虑这些任务之一,例如人脸检测。在这种情况下,训练数据由一组是人脸的图像和另一组非人脸的图像(世界上除人脸以外的所有其他东西)组成。此训练数据过于复杂,以至于无法找到每个样本的表示(特征向量)使整个人脸集合与整个非人脸集合线性可分。
优化问题的扩展
Section titled “优化问题的扩展”记住,使用 SVM 我们获得一个分离超平面。因此,由于训练数据现在是非线性可分的,我们必须承认所找到的超平面会对某些样本进行误分类。这种_误分类_是优化中必须考虑的一个新变量。新模型必须既包括找到具有最大间隔的超平面这一旧要求,也包括通过不允许过多分类错误来正确泛化训练数据这一新要求。
我们从此处开始:从最大化__间隔__的超平面优化问题的表述开始(这在上一篇教程(tutorial_introduction_to_svm)中已有说明):
有多种方式可以修改此模型以考虑误分类错误。例如,可以想到最小化相同的量加上一个常数乘以训练数据中误分类错误的数量,即:
然而,这不是一个很好的解,因为除其他一些原因外,我们不区分以其与其适当决策区域的小距离被误分类的样本和未被误分类的样本。因此,一个更好的解将考虑_误分类样本到其正确决策区域的距离_,即:
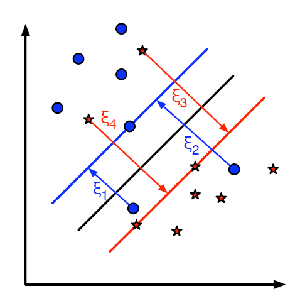
为训练数据的每个样本定义一个新参数 。这些参数中的每一个都包含其相应训练样本到其正确决策区域的距离。下图显示了两个类别的非线性可分训练数据、一个分离超平面以及被误分类样本到其正确区域的距离。
注意: 图中只显示了被误分类样本的距离。其余样本的距离为零,因为它们已经位于其正确的决策区域中。
图中出现的红线和蓝线是到每个决策区域的间隔。非常__重要__的是要认识到,每个 都从一个被误分类的训练样本延伸到其适当区域的间隔。
最后,优化问题的新表述为:
应当如何选择参数 C?显然,这个问题的答案取决于训练数据的分布方式。虽然没有一般性的答案,但考虑这些规则是有用的:
- 较大的 C 值给出_误分类错误更少_但_间隔更小_的解。考虑在这种情况下误分类的代价很高。由于优化的目标是最小化参数,因此只允许少量误分类错误。
- 较小的 C 值给出_间隔更大_和_分类错误更多_的解。在这种情况下,最小化并不太考虑求和项,因此它更专注于寻找具有大间隔的超平面。
你也可以在 OpenCV 源码库的 samples/cpp/tutorial_code/ml/non_linear_svms 文件夹中找到源代码,或从此处下载。
- 设置训练数据
本练习的训练数据由一组带标签的二维点组成,这些点属于两个不同类别之一。为了使练习更有吸引力,使用均匀概率密度函数(PDF)随机生成训练数据。
我们将训练数据的生成分成了两个主要部分。
在第一部分中,我们为两个类别生成线性可分的数据。
在第二部分中,我们为两个类别创建非线性可分的、重叠的数据。
- 设置 SVM 的参数
注意: 在上一篇教程 tutorial_introduction_to_svm 中,有对 cv::ml::SVM 类属性的说明,我们在训练 SVM 之前在此对其进行配置。
我们在此所做的配置与作为参考的上一篇教程(tutorial_introduction_to_svm)中所做的配置之间只有两个区别。
-
C。我们在此选择此参数的一个较小值,以便在优化中不对误分类错误惩罚过多。这样做的想法源于希望获得接近直观预期的解。然而,我们建议通过调整此参数来更好地理解问题。
注意: 在这种情况下,类别之间的重叠区域中只有很少的点。通过给 FRAC_LINEAR_SEP 一个较小的值,可以增加点的密度,从而更深入地探索参数 C 的影响。
-
算法的终止准则。必须大幅增加最大迭代次数,才能正确解决具有非线性可分训练数据的问题。具体而言,我们将此值增加了五个数量级。
-
训练 SVM
我们调用 cv::ml::SVM::train 方法来构建 SVM 模型。注意,训练过程可能需要相当长的时间。运行程序时请耐心等待。
- 显示决策区域
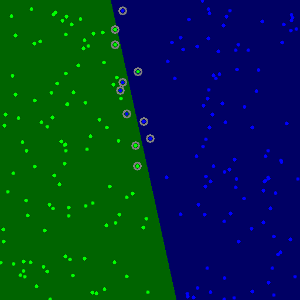
cv::ml::SVM::predict 方法用于使用训练好的 SVM 对输入样本进行分类。在本示例中,我们使用此方法根据 SVM 所做的预测为空间着色。换句话说,遍历一幅图像,将其像素解释为笛卡尔平面上的点。根据 SVM 预测的类别对每个点着色;如果它是标签为 1 的类别则为深绿色,如果它是标签为 2 的类别则为深蓝色。
- 显示训练数据
cv::circle 方法用于显示组成训练数据的样本。标签为 1 的类别的样本以浅绿色显示,标签为 2 的类别的样本以浅蓝色显示。
- 支持向量
我们在此使用几个方法来获取有关支持向量的信息。cv::ml::SVM::getSupportVectors 方法获取所有支持向量。我们在此使用这些方法来找到作为支持向量的训练样本并突出显示它们。
- 代码打开一幅图像并显示两个类别的训练样本。一个类别的点以浅绿色表示,另一个类别使用浅蓝色。
- 训练 SVM 并将其用于对图像的所有像素进行分类。这导致图像被划分为蓝色区域和绿色区域。两个区域之间的边界是分离超平面。由于训练数据是非线性可分的,可以看到两个类别的一些样本被误分类;一些绿色点位于蓝色区域,一些蓝色点位于绿色区域。
- 最后,使用灰色圆环围绕训练样本显示支持向量。
你可以在这里的 YouTube上观察此程序的一个运行实例。