
分布式训练
大语言模型(GPT-4、LLaMA 等)的参数量从数十亿到数万亿,单张 GPU 的显存和算力远远不够——必须依靠多卡甚至多机的分布式训练。本页系统讲解数据并行(DDP)、模型并行、流水线并行、张量并行、FSDP 和 DeepSpeed ZeRO 等核心技术。前置阅读:梯度下降与优化器、混合精度训练。
把分布式训练想象成”工厂流水线”——不同的并行策略就像工厂不同的组织方式:
- 数据并行(DDP)= 每个工人(GPU)都有完整的图纸(完整模型),但各做不同的零件(不同数据)。做完后大家同步对齐进度(梯度 all-reduce)。瓶颈:每个工人都需要一份完整的模型,大模型放不下。
- 模型并行= 图纸太大一个人铺不开,拆开分给多个人。怎么拆是关键——
- 流水线并行= 按工序拆。工人 A 负责第 1-4 层、工人 B 负责第 5-8 层……半成品在工人之间传递(像流水线)。问题:如果串行执行,大部分时间工人在等上一个人传半成品(流水线气泡)。
- 张量并行= 把一张大图纸切成几块,几个人同时画不同的部分再拼起来。一个矩阵乘法被拆到多张卡上并行计算,通信密集但负载均衡好。
- FSDP / ZeRO= 数据并行的极致优化版。不再让每个工人持有完整模型,而是把模型本身也切碎——用到哪块就临时拼起来,用完再碎开存着。显存占用大幅降低,是当前大模型训练的主流方案。
为什么不能”简单地”多买几张卡?
Section titled “为什么不能”简单地”多买几张卡?”一个常见的误解是:“训练慢了就多加几张卡。” 但分布式训练的难点不在于硬件本身,而在于如何让多张卡高效协作:
- 通信瓶颈:每一步训练后,所有 GPU 都要交换信息(梯度、参数分片等)。这些通信走的是 NVLink(机内,~900 GB/s)或 InfiniBand(机间,~100 GB/s),速度远低于 GPU 内部显存带宽(~3 TB/s)。如果通信不能被计算掩盖(overlap),加再多卡也只是让 GPU 更久地”干等”。
- 显存墙:大模型不光参数占显存,优化器状态(Adam(自适应矩估计优化器,为每个参数维护一阶动量和二阶方差)需要额外 2 倍参数量的 FP32 状态)、梯度、激活值都要占空间。一张 80 GB 的 A100 训练 7B 模型都会捉襟见肘。
- 容错与恢复:数千张卡中总会有几张出故障(GPU 挂掉、网络中断等),需要快速保存和恢复训练状态(checkpoint)。大规模训练中,平均每天都会有硬件故障。
数据并行 DDP(DistributedDataParallel)
Section titled “数据并行 DDP(DistributedDataParallel)”DDP 是最基础、最常用的并行策略。核心流程:
- 每张 GPU 持有完整的模型副本(相同参数)。
- 将训练数据分成 N 份(N = GPU 数),每张 GPU 处理自己的数据分片(不同数据)。
- 各 GPU 独立做前向 + 反向传播,计算各自数据分片的梯度。
- 梯度 All-Reduce:所有 GPU 交换并平均各自的梯度,确保每张卡得到相同的平均梯度。
- 各 GPU 用相同的平均梯度分别更新自己那份模型参数,保持所有副本同步。
DDP 的优点是简单通用,缺点是每张卡都要存完整模型和优化器状态——当模型超过单卡显存时 DDP 就无能为力了。
数学推导:为什么 All-Reduce 后梯度等价于大 batch?
Section titled “数学推导:为什么 All-Reduce 后梯度等价于大 batch?”假设全局 batch 大小为 B,N 张 GPU 各处理 B/N 个样本。第 i 张 GPU 上计算的平均梯度为:
其中 是第 张 GPU 上的第 个样本, 是当前模型参数。
All-Reduce 对所有 GPU 的梯度取平均:
这正是全局 batch B 上所有样本梯度的平均值——因此 DDP + All-Reduce 在数学上完全等价于单卡跑完整 batch B 的梯度下降。这就是分布式数据并行的理论保证。
All-Reduce 的通信代价
Section titled “All-Reduce 的通信代价”Ring All-Reduce(环形归约)是最常用的 All-Reduce 算法,通信量为 2 * (N-1)/N * M(M 为模型参数总字节数),与 GPU 数 N 几乎无关。以 7B 模型 FP32 梯度为例:
在 100 GB/s InfiniBand 上传输需约 0.56 秒。若每步训练(前向 + 反向)耗时 1 秒,则通信占比高达 36%。
这就是为什么 DDP 需要高带宽互联(如 NVLink、InfiniBand),以及为什么通信与计算的 overlap(重叠)至关重要。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
n_gpus = np.array([1, 2, 4, 8, 16, 32, 64, 128, 256])ideal = n_gpus.astype(float)
# Simulate scaling with communication overheadddp_eff = 100 / (1 + 0.56 * np.log2(n_gpus) / np.log2(8))fsdp_eff = 100 / (1 + 0.8 * np.log2(n_gpus) / np.log2(8))overlap_eff = 100 / (1 + 0.2 * np.log2(n_gpus) / np.log2(8))
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(13, 5))fig.patch.set_facecolor("white")
# Left: speedupax1.plot(n_gpus, ideal, "k--", linewidth=1.5, alpha=0.4, label="Ideal (linear)")ax1.plot(n_gpus, n_gpus * ddp_eff / 100, "o-", color="#e91e63", linewidth=2, markersize=6, label="DDP")ax1.plot(n_gpus, n_gpus * fsdp_eff / 100, "s-", color="#FF9800", linewidth=2, markersize=6, label="FSDP / ZeRO-3")ax1.plot(n_gpus, n_gpus * overlap_eff / 100, "^-", color="#4CAF50", linewidth=2, markersize=6, label="DDP + comm overlap")ax1.set_xlabel("Number of GPUs", fontsize=11, fontweight="bold")ax1.set_ylabel("Speedup (x vs single GPU)", fontsize=11, fontweight="bold")ax1.set_title("Training Speedup vs GPU Count", fontsize=12, fontweight="bold")ax1.set_xscale("log", base=2); ax1.set_yscale("log", base=2)ax1.legend(fontsize=9, loc="upper left"); ax1.grid(True, alpha=0.2, linestyle="--", which="both")
# Right: efficiencyax2.plot(n_gpus, np.ones_like(n_gpus) * 100, "k--", linewidth=1.5, alpha=0.4, label="Ideal (100%)")ax2.plot(n_gpus, ddp_eff, "o-", color="#e91e63", linewidth=2, markersize=6, label="DDP")ax2.plot(n_gpus, fsdp_eff, "s-", color="#FF9800", linewidth=2, markersize=6, label="FSDP / ZeRO-3")ax2.plot(n_gpus, overlap_eff, "^-", color="#4CAF50", linewidth=2, markersize=6, label="DDP + comm overlap")ax2.set_xlabel("Number of GPUs", fontsize=11, fontweight="bold")ax2.set_ylabel("Scaling Efficiency (%)", fontsize=11, fontweight="bold")ax2.set_title("Multi-GPU Scaling Efficiency", fontsize=12, fontweight="bold")ax2.set_xscale("log", base=2); ax2.set_ylim(0, 110)ax2.legend(fontsize=9, loc="upper right"); ax2.grid(True, alpha=0.2, linestyle="--", which="both")
plt.tight_layout()plt.savefig("/mnt/kvm_ata-Netac_SSD_480GB_AA000000000000000904-part1/proj/docs/img/generated/distributed-scaling-efficiency.png",            dpi=180, bbox_inches="tight", facecolor="white")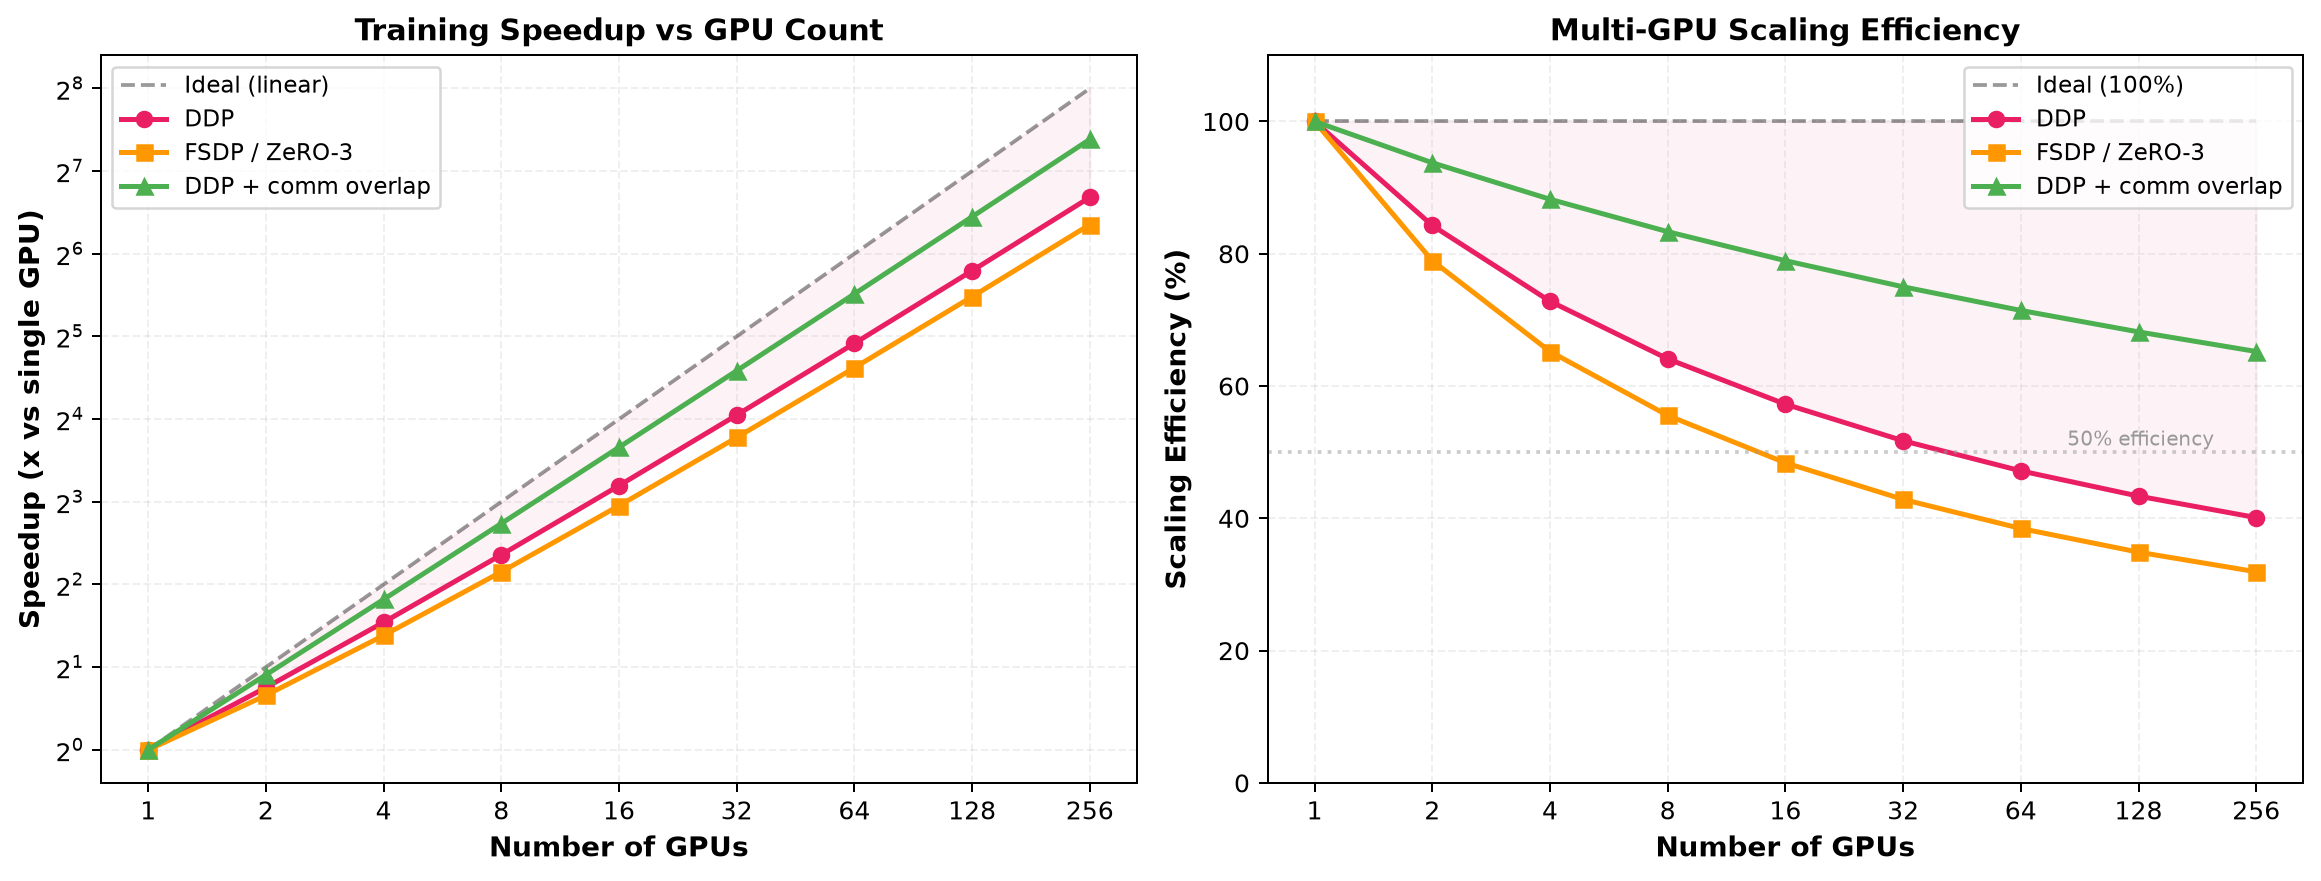
All-Reduce 的 Ring 算法详解
Section titled “All-Reduce 的 Ring 算法详解”Ring All-Reduce 是 NCCL(NVIDIA Collective Communications Library,NVIDIA 集体通信库)的默认算法,理解它有助于明白通信效率从何而来:
假设 N 张 GPU 组成一个逻辑环,每张卡持有梯度分片 [g_0, g_1, ..., g_{N-1}]
阶段 1:Reduce-Scatter(N-1 步)  第 k 步:GPU i 将分片 (i - k) mod N 发送给 GPU (i+1) mod N           GPU (i+1) 接收后与本地分片相加  结果:每张 GPU 最终持有 1/N 的全局求和分片
阶段 2:All-Gather(N-1 步)  将每张 GPU 持有的 1/N 结果广播给所有其他 GPU
总通信量(每卡发送+接收):  = 2 * (N-1)/N * M ≈ 2M(当 N 大时)
关键优势:通信量与 GPU 数 N 几乎无关,可扩展到数千张卡。
模型并行(Model Parallelism)
Section titled “模型并行(Model Parallelism)”当模型太大单卡放不下时,需要把模型本身切分到多张卡上:
流水线并行(Pipeline Parallelism)
Section titled “流水线并行(Pipeline Parallelism)”将模型按层切分——如 24 层网络,GPU 0 负责第 1-6 层、GPU 1 负责第 7-12 层……前向传播时中间激活值在相邻 GPU 之间传递,反向传播时梯度沿反方向传递。
朴素流水线(串行执行)效率极低:GPU 0 做第 1-6 层时其他 GPU 全在等(流水线气泡)。解决方案是微批次流水线(Micro-batching):将一个 batch 分成多个 micro-batch,像流水线一样交错填充各 GPU,极大减少空闲时间。GPipe 和 PipeDream 是经典实现。
流水线气泡的数学分析
Section titled “流水线气泡的数学分析”设模型有 L 层,分为 P 个流水线阶段(P 张 GPU),每个 stage 的前向时间为 、反向时间为 ,一个 batch 分成 M 个 micro-batch。
朴素流水线(无微批次)的气泡比例:
例如 P=8 个阶段、M=1(不切微批次):气泡比例 = 7/8 = 87.5%,效率仅 12.5%。
微批次流水线(GPipe 调度),M=16 个微批次:
气泡显著减小。经验法则:M 应至少为 P 的 2-4 倍,才能将气泡控制在可接受范围。
1F1B 调度(One-Forward-One-Backward)
Section titled “1F1B 调度(One-Forward-One-Backward)”GPipe 的改进版 1F1B 调度(PipeDream-Flush)让前向和反向更早交错,减少同时存活的激活值数量,从而降低显存占用:
时间线示意(P=4, M=4):
GPU0: F0 F1 F2 F3 B0 F4 B1 F5 B2 F6 B3 F7 ...  (稳态:一前向一反向交替)GPU1:    F0 F1 F2 B0 F3 B1 F4 B2 F5 B3 ...GPU2:       F0 F1 B0 F2 B1 F3 B2 ...GPU3:          F0 B0 F1 B1 F2 B2 ...
关键优势:稳态阶段每张 GPU 最多同时持有 P 个 micro-batch 的激活值         (而 GPipe 需要持有 M 个),显存占用降低 (M / P) 倍。
张量并行(Tensor Parallelism)
Section titled “张量并行(Tensor Parallelism)”流水线按”层”切,张量并行则把单个层的矩阵乘法切开。以 Megatron-LM 为例,一个线性层 Y = XW 可以按列切分:
对于注意力机制中的 QKV 投影、FFN 层等,Megatron-LM 给出了精巧的切分方案,使每张卡只需约 1/N 的计算和显存。张量并行的通信量比流水线大得多,通常只在同一台机器内(NVLink 高速互联)使用。
Megatron-LM 的列切分与行切分详解
Section titled “Megatron-LM 的列切分与行切分详解”Megatron-LM 的核心洞察是:不同的矩阵乘法可以用不同方式切分,使得通信只在必要处发生。
1. 列并行(Column Parallelism)——用于第一个 GEMM:
将 按列切分:,每个 。每张卡独立计算 ,结果 (不需要通信, 在每张卡上都有完整副本)。最终:
2. 行并行(Row Parallelism)——用于第二个 GEMM:
将 按行切分:,每个 。每张卡用本地 计算 ,结果 (每张卡得到的是部分和)。最终:
3. 组合使用——FFN 层的完美切分:
关键:列切分后接行切分,中间的激活值不需要通信。只有一个 All-Reduce 在 FFN 的末尾。Megatron-LM 就是用这种”列切 → 行切”的组合,让 Transformer 的 FFN 层在 TP 下只有一次 All-Reduce 通信。
4. Self-Attention 的 QKV 切分:
QKV 投影矩阵按列切分:每张卡只计算 N 个注意力头中的 1/N    → 多头注意力天然适合并行,每个头独立计算 attention
Attention 输出投影按行切分 → 末尾一次 All-Reduce
张量并行的通信量分析
Section titled “张量并行的通信量分析”每个 Transformer 层的 TP 通信: - Attention 输出后:1 次 All-Reduce,数据量 = batch * seq_len * d_model * 2 bytes (BF16) - FFN 输出后:1 次 All-Reduce,同上
每层 2 次 All-Reduce,总共 2 * L 次(L = 层数)
对比 DDP: - DDP 每步 1 次 All-Reduce,数据量 = 全部梯度 - TP 每步 2L 次 All-Reduce,但每次数据量小(仅激活值大小)
关键区别:TP 的通信是"层间"的(每层都要通信),DDP 是"步间"的(每步一次)。→ TP 对延迟更敏感,必须在低延迟的 NVLink 环境使用。FSDP(Fully Sharded Data Parallelism)
Section titled “FSDP(Fully Sharded Data Parallelism)”FSDP 是 PyTorch 原生的完全分片数据并行方案,灵感来自 DeepSpeed ZeRO。与 DDP 的区别:
DDP: 每卡存完整模型参数 + 完整优化器状态 + 完整梯度FSDP: 每卡只存 1/N 的参数分片 + 1/N 优化器状态 + 1/N 梯度FSDP 在需要用到某一层时,先通过 all-gather 从其他卡临时收集完整的该层参数,做前向/反向计算后立即丢弃完整参数只保留分片。以更高的通信开销换取大幅降低的显存占用,使得可以用更多 GPU 训练更大的模型。
FSDP 的显存精算
Section titled “FSDP 的显存精算”以 7B 模型、AdamW 优化器、FP32 训练为例:
FSDP( 张卡):
FSDP 的前向/反向通信时序
Section titled “FSDP 的前向/反向通信时序”前向传播,对于每一层 Layer_i: 1. All-Gather: 收集 Layer_i 的完整参数 W_i(临时) 2. 丢弃分片 w_i(临时让出空间) 3. 前向计算: a_{i+1} = Layer_i(a_i, W_i) 4. 丢弃完整参数 W_i(只保留输入激活 a_i 用于反向)
反向传播,对于每一层 Layer_i(逆序): 1. All-Gather: 重新收集完整参数 W_i 2. 反向计算: 计算梯度 ∂L/∂W_i 和 ∂L/∂a_i 3. Reduce-Scatter: 对梯度分片求和,每卡只保留 1/N 的梯度分片 4. 丢弃完整参数 W_i
参数更新: 每张卡只更新自己持有的 1/N 参数分片 w_i 和优化器状态DeepSpeed ZeRO
Section titled “DeepSpeed ZeRO”ZeRO(Zero Redundancy Optimizer,零冗余优化器)是微软 DeepSpeed 库的核心创新,分三个阶段逐步消除数据并行中的显存冗余:
| 阶段 | 分片内容 | 显存节省 | 通信开销 |
|---|---|---|---|
| ZeRO-1 | 优化器状态(如 Adam 的动量/方差) | ~4x | 与 DDP 相同 |
| ZeRO-2 | ZeRO-1 + 梯度 | ~8x | 略增 |
| ZeRO-3 | ZeRO-2 + 模型参数 | ~Nx | 显著增加(接近张量并行) |
ZeRO-3 本质上就是 FSDP 的 DeepSpeed 实现——将模型参数也分片,用通信换显存。ZeRO-Offload 进一步将优化器状态卸载到 CPU 内存,ZeRO-Infinity 还可卸载到 NVMe SSD。
ZeRO 各阶段的显存分析
Section titled “ZeRO 各阶段的显存分析”借鉴 ZeRO 论文的符号,设模型有 Ψ 个参数,用 FP16 参数和梯度,FP32 Adam 优化器状态(2 份拷贝 + 动量 m + 方差 v,共 12Ψ bytes,即 K=12):
ZeRO-1(分片优化器状态):
ZeRO-2(分片优化器状态 + 梯度):
ZeRO-3(分片所有):
这就是为什么 ZeRO-3 / FSDP 能让数百亿甚至千亿参数的模型在合理的 GPU 集群上训练。
ZeRO-Offload 与 ZeRO-Infinity
Section titled “ZeRO-Offload 与 ZeRO-Infinity”ZeRO 的进一步扩展将显存与 CPU 内存、SSD 结合:
ZeRO-Offload:  - 优化器状态(FP32 的 m, v, master weights)放在 CPU 内存  - GPU 只存 FP16 参数和梯度  - 梯度通过 PCIe 传到 CPU → CPU 做参数更新 → 更新后的参数传回 GPU  - 代价:CPU 计算慢,但可与 GPU 计算重叠(overlap)
ZeRO-Infinity:  - 进一步支持将参数卸载到 NVMe SSD  - 利用分层显存:GPU HBM → CPU DRAM → NVMe SSD  - 可训练超大模型(千亿+),但训练速度显著降低
显存层级带宽对比:  GPU HBM:       ~3 TB/s    (A100)  CPU DRAM:      ~100 GB/s  (8-channel DDR5)  NVLink:        ~900 GB/s  (机内 GPU-GPU)  InfiniBand:    ~100 GB/s  (机间)  PCIe Gen5:     ~64 GB/s   (GPU-CPU)  NVMe SSD:      ~7 GB/s    (单盘)
3D 并行:数据 + 流水线 + 张量
Section titled “3D 并行:数据 + 流水线 + 张量”百亿到千亿参数模型的训练标准配置是 3D 并行——同时使用三种并行维度:
假设 1024 张 GPU,模型 175B(GPT-3 规模):
张量并行大小 TP = 8   (机内 8 卡,NVLink 互联)流水线并行大小 PP = 8  (8 个 stage,跨机 InfiniBand)数据并行大小 DP = 16   (16 个数据并行组)
验证:TP * PP * DP = 8 * 8 * 16 = 1024 ✓
每张 GPU 的负载:  - 模型参数:  175B / (TP * PP) = 175B / 64 ≈ 2.7B 参数的等效计算量  - 数据并行组内 16 张 GPU 做 All-Reduce 同步梯度
通信模式: - 机内:TP 的 All-Reduce(每层 2 次),走 NVLink - 机间:PP 的点对点 activation 传递(pipeline 通信),走 InfiniBand - 跨集群:DP 的梯度 All-Reduce,走 InfiniBand → 三种通信走不同物理链路,可并行执行,互不干扰DDP vs ZeRO-3 vs Pipeline Parallelism
Section titled “DDP vs ZeRO-3 vs Pipeline Parallelism”DDP 训练流程(4 GPU 示意)
Section titled “DDP 训练流程(4 GPU 示意)”FSDP 参数生命周期
Section titled “FSDP 参数生命周期”3D 并行拓扑示意
Section titled “3D 并行拓扑示意”PyTorch DDP:torchrun 启动多卡训练
Section titled “PyTorch DDP:torchrun 启动多卡训练”import osimport torchimport torch.distributed as distfrom torch.nn.parallel import DistributedDataParallel as DDP
# torchrun 会自动设置环境变量 RANK / WORLD_SIZE / LOCAL_RANKdist.init_process_group(backend="nccl") # 初始化进程组(NCCL 用于 GPU 通信)local_rank = int(os.environ["LOCAL_RANK"])torch.cuda.set_device(local_rank)
model = MyModel().cuda(local_rank)model = DDP(model, device_ids=[local_rank]) # 包装为 DDP 模型optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
for batch in dataloader: loss = model(batch) # 前向(DDP 自动 hook 梯度同步) optimizer.zero_grad(); loss.backward(); optimizer.step()
# 启动命令(8 张卡):# torchrun --nproc_per_node=8 train.py手写 All-Reduce 理解 DDP 梯度同步
Section titled “手写 All-Reduce 理解 DDP 梯度同步”以下代码用 numpy 手动模拟 All-Reduce 过程,帮助你理解 DDP 的梯度同步到底在做什么:
import numpy as np
# 模拟 4 张 "GPU" 各自计算的梯度(不同数据 → 不同梯度)np.random.seed(42)N = 4  # GPU 数量param_size = 8  # 参数维度(实际中是数十亿)
# 每张 "GPU" 独立计算自己的梯度local_grads = [np.random.randn(param_size).astype(np.float32) for _ in range(N)]
print("各卡本地梯度:")for i, g in enumerate(local_grads):    print(f"  GPU {i}: {g[:4]}...")
# ===== 模拟 Ring All-Reduce 的 Reduce-Scatter 阶段 =====# 将每个梯度分成 N 段,逐段环形累加chunk_size = param_size // Nreduced = [g.copy() for g in local_grads]  # 每卡的工作副本
for step in range(N - 1):    new_reduced = [None] * N    for i in range(N):        # GPU i 接收 GPU (i-1) 的分片,与自己对应分片相加        src = (i - 1) % N        chunk_idx = (i - step) % N        new_reduced[i] = reduced[i].copy()        s = chunk_idx * chunk_size        e = s + chunk_size        new_reduced[i][s:e] += reduced[src][s:e]    reduced = new_reduced
# ===== 模拟 All-Gather 阶段:广播各段的最终结果 =====# 此处简化:每段取最终累加结果(第 step 步的 GPU 持有正确结果)final_grad = np.zeros_like(local_grads[0])for chunk_idx in range(N):    # 找到持有正确累加结果的 GPU    owner = (chunk_idx + (N - 1)) % N    s = chunk_idx * chunk_size    e = s + chunk_size    final_grad[s:e] = reduced[owner][s:e]
# ===== 验证:与直接求平均比较 =====expected = np.mean(local_grads, axis=0)print(f"\nAll-Reduce 结果: {final_grad[:4]}...")print(f"直接求平均:      {expected[:4]}...")print(f"最大误差: {np.max(np.abs(final_grad - expected)):.2e}")# 输出:最大误差 ≈ 0(浮点误差范围内)
PyTorch FSDP:完全分片数据并行
Section titled “PyTorch FSDP:完全分片数据并行”import osimport torchimport torch.distributed as distfrom torch.distributed.fsdp import FullyShardedDataParallel as FSDPfrom torch.distributed.fsdp import ShardingStrategy, MixedPrecision
dist.init_process_group(backend="nccl")local_rank = int(os.environ["LOCAL_RANK"])torch.cuda.set_device(local_rank)
model = MyLargeModel().cuda(local_rank)
# FSDP 配置fsdp_config = { "sharding_strategy": ShardingStrategy.FULL_SHARD, # 等价于 ZeRO-3 # FULL_SHARD = ZeRO-3, SHARD_GRAD_OP = ZeRO-2, NO_SHARD = 普通 DDP "mixed_precision": MixedPrecision( param_dtype=torch.bfloat16, # 参数用 BF16 计算 reduce_dtype=torch.bfloat16, # 梯度归约也用 BF16 buffer_dtype=torch.bfloat16, ), "cpu_offloading": None, # 可选:CPUOffload(offload_params=True) 启用 ZeRO-Offload "forward_prefetch": True, # 预取下一层参数,重叠通信与计算 "use_orig_params": True, # 保留原始参数名,方便保存 checkpoint}
model = FSDP(model, **fsdp_config)optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
for batch in dataloader: loss = model(batch) optimizer.zero_grad() loss.backward() optimizer.step()
# 启动(8 卡):# torchrun --nproc_per_node=8 train_fsdp.pyDeepSpeed ZeRO-3 配置示例
Section titled “DeepSpeed ZeRO-3 配置示例”# deepspeed_config.json(关键字段)deepspeed_config = { "train_micro_batch_size_per_gpu": 4, "gradient_accumulation_steps": 8, # 梯度累积:等效 batch = 4 * 8 * N_gpu "zero_optimization": { "stage": 3, # ZeRO-3:分片参数+梯度+优化器状态 "offload_optimizer": { # 优化器状态卸载到 CPU "device": "cpu", "pin_memory": True # 锁页内存,加速 PCIe 传输 }, "offload_param": { # 参数也卸载到 CPU(ZeRO-Infinity) "device": "cpu", "pin_memory": True }, "overlap_comm": True, # 重叠通信与计算 "contiguous_gradients": True, # 连续内存梯度,减少碎片 "sub_group_size": 1e9, }, "bf16": { # BF16 混合精度 "enabled": True }, "gradient_clipping": 1.0, # 梯度裁剪,防止梯度爆炸 "steps_per_print": 100,}
# 训练脚本中用 deepspeed 启动器# deepspeed --num_gpus=8 train.py --deepspeed_config deepspeed_config.json张量并行的手动实现(教学版)
Section titled “张量并行的手动实现(教学版)”以下用 PyTorch 手动实现 Megatron-LM 风格的列切分 + 行切分 FFN:
import torchimport torch.nn as nnimport torch.distributed as dist
class ColumnParallelLinear(nn.Module):    """列并行线性层:权重按输出维度切分到各卡"""    def __init__(self, in_features, out_features, world_size, rank):        super().__init__()        assert out_features % world_size == 0        self.out_per_partition = out_features // world_size        self.rank = rank        self.world_size = world_size        # 每张卡只持有 1/N 的权重列        self.weight = nn.Parameter(torch.randn(self.out_per_partition, in_features))        self.bias = nn.Parameter(torch.zeros(self.out_per_partition))
    def forward(self, x):        # x: [batch, in_features] — 每张卡都有完整输入        # output: [batch, out_per_partition] — 每张卡得到部分输出列        return torch.nn.functional.linear(x, self.weight, self.bias)

class RowParallelLinear(nn.Module):    """行并行线性层:权重按输入维度切分,前向需 All-Reduce"""    def __init__(self, in_features, out_features, world_size, rank):        super().__init__()        assert in_features % world_size == 0        self.in_per_partition = in_features // world_size        self.rank = rank        self.world_size = world_size        # 每张卡只持有 1/N 的权重行        self.weight = nn.Parameter(torch.randn(out_features, self.in_per_partition))        self.bias = nn.Parameter(torch.zeros(out_features))
    def forward(self, x):        # x: [batch, in_per_partition] — 每张卡只有部分输入(来自上一列并行层)        # partial_output: [batch, out_features] — 部分和        partial_output = torch.nn.functional.linear(x, self.weight)        # All-Reduce:将所有卡的部分和累加得到完整结果        dist.all_reduce(partial_output, op=dist.ReduceOp.SUM)        return partial_output + self.bias

class TensorParallelFFN(nn.Module):    """Megatron-LM 风格的 TP FFN:列切分 → GeLU → 行切分"""    def __init__(self, d_model, d_ff, world_size, rank):        super().__init__()        # 第一个 GEMM 列切分,第二个 GEMM 行切分        # 关键:中间激活不需要通信!        self.fc1 = ColumnParallelLinear(d_model, d_ff, world_size, rank)        self.fc2 = RowParallelLinear(d_ff, d_model, world_size, rank)        self.act = nn.GELU()
    def forward(self, x):        # 列切分:每卡计算 d_ff/N 个输出 → 不需要通信        h = self.fc1(x)        h = self.act(h)        # 行切分:每卡计算部分和 → All-Reduce 求和(唯一的通信点)        out = self.fc2(h)        return out
# 初始化后使用# dist.init_process_group(backend="nccl")# world_size = dist.get_world_size()# rank = dist.get_rank()# ffn = TensorParallelFFN(d_model=4096, d_ff=16384, world_size=world_size, rank=rank).cuda()
梯度累积(Gradient Accumulation)
Section titled “梯度累积(Gradient Accumulation)”当显存不够跑大 batch 时,梯度累积等效于增大 batch size:
import torch
model = MyModel().cuda()optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
GRADIENT_ACCUMULATION_STEPS = 8   # 累积 8 步,等效 batch 放大 8 倍MICRO_BATCH_SIZE = 4              # 每步实际处理的样本数# 等效 batch = MICRO_BATCH_SIZE * GRADIENT_ACCUMULATION_STEPS = 32
optimizer.zero_grad()             # 在累积循环外清零梯度
for step, batch in enumerate(dataloader):    # 前向 + 反向(梯度自动累积到 .grad)    loss = model(batch)    loss = loss / GRADIENT_ACCUMULATION_STEPS  # 缩放 loss,等效于平均梯度    loss.backward()
    # 每累积 N 步才做一次参数更新    if (step + 1) % GRADIENT_ACCUMULATION_STEPS == 0:        torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)        optimizer.step()        optimizer.zero_grad()
# 数学等价性说明:# 标准 batch_size=B 的梯度 = (1/B) * sum_{i=1}^{B} ∇L(x_i, θ)# 梯度累积 K 步、每步 micro_batch=M 的等效梯度# = (1/K) * sum_{k=1}^{K} (1/M) * sum_{j=1}^{M} ∇L(x_{k,j}, θ)# = (1/(K*M)) * sum_{all} ∇L(x, θ)# 当 K*M = B 时,两者完全等价。- 单机能放下用 DDP:模型参数 + 优化器状态 + 激活值都能放进单卡时,DDP 是最简单高效的选择。配置只需一行
DDP(model)。 - 单卡放不下用 FSDP / ZeRO-3:70 亿参数(7B)用 AdamW 在 FP32 下需要约 112 GB 显存(参数 28GB + 优化器状态 56GB + 梯度 28GB),单张 80GB A100 放不下——必须用 FSDP 或 ZeRO-3 分片。
- 3D 并行是大模型标配:千亿参数模型的训练通常同时用三种并行:张量并行(机内,NVLink)+ 流水线并行(跨机)+ 数据并行(跨机)。Megatron-LM / DeepSpeed 都支持这种组合。
- NCCL 是 GPU 通信后端的唯一选择:
backend="nccl"是 GPU 训练的标准,NVIDIA 针对 NVLink / InfiniBand 高度优化。 - 张量并行只在机内用:TP 通信量极大,跨机器(带宽低、延迟高)会严重拖慢训练。跨机用流水线并行或数据并行。
- 梯度累积可以模拟大 batch:显存不够用大 batch 时,多次小 batch 前向反向后累积梯度再统一更新,等效于大 batch 训练。
- 混合精度 + 分布式是标配:几乎所有大模型训练都同时开混合精度(BF16)和分布式策略。详见混合精度训练。
- 通信与计算 overlap:DDP 默认在反向传播时就启动梯度同步(通过 hook),让通信与后续层的反向计算重叠。FSDP 的
forward_prefetch=True可预取下一层参数。务必启用这些 overlap 选项。 - checkpoint 要用分片保存:大模型完整 checkpoint 可能数百 GB。FSDP/DeepSpeed 支持每卡只保存自己的分片,加载时再 all-gather 拼合。
- 警惕死锁和挂起:分布式训练中一个进程崩溃(OOM、NCCL 超时等)会导致所有进程挂起。设置
NCCL_TIMEOUT和使用容错框架(如 Torchrun 的 elastic mode)很重要。 - 负载均衡:流水线并行中各 stage 的计算量要尽量均匀(按 FLOPs 或显存),否则最慢的 stage 拖累全局。Transformer 的层通常比较均匀,但 embedding 层和 LM head 需要特殊处理。
最新进展(2025-2026)
Section titled “最新进展(2025-2026)”PyTorch 生态的分布式训练新进展
Section titled “PyTorch 生态的分布式训练新进展”PyTorch Monarch:单控制器(single-controller)分布式训练框架,让开发者用类似单进程的代码编写多机训练逻辑,由运行时自动调度到各 GPU。2026 年扩展到 AMD GPU(ROCm(AMD 的 GPU 计算平台,对标 CUDA)),打破 NVIDIA 独家生态。
torchtitan:PyTorch 官方维护的轻量级预训练参考实现,支持 FSDP + 张量并行(TP)+ 流水线并行(PP)的组合。它的目标是提供”足够好且足够简单”的生产级参考,不像 Megatron-LM 那样复杂。截至 2026 年持续更新,是学习 3D 并行最佳实践的首选。
FlexAttention(PyTorch 2.5+):灵活的注意力 API,允许用简洁的代码定义各种注意力变体(如 sliding window、ALiBi(相对位置编码的一种方式,通过加性偏置替代位置编码)、文档级 mask 等),编译后自动生成融合的 FlashAttention(一种通过分块计算减少 HBM 访问的快速注意力算法)内核。大幅简化了注意力机制的研究和工程。
Compiled Autograd:PyTorch 2.5 引入,将反向传播也纳入 torch.compile 的编译范围,进一步优化分布式训练的反向计算图。
Helion(2026):PyTorch 推出的 DSL(领域特定语言),用于编写性能可移植的 ML kernel。目标是让自定义算子在 CUDA / ROCm / TPU 上都能高效运行,降低分布式训练中自定义算子的工程成本。
DeepSpeed 的持续演进
Section titled “DeepSpeed 的持续演进”DeepCompile(2025/04):编译器优化的分布式训练调度器,自动搜索最优的通信/计算 overlap 策略,减少手工调参。
ZenFlow(2025/08):无停顿(stall-free)offloading 引擎,通过异步更新将 CPU/SSD 卸载的通信与 GPU 计算完全重叠,显著减少 ZeRO-Offload 的性能惩罚。
Arctic Long Sequence Training(ALST, 2025/06):支持百万级 token 长序列的可扩展训练方案。针对超长上下文(如完整代码库、长文档)场景,解决了传统方案中注意力计算的 O(n²) 瓶颈。
SuperOffload(ASPLOS 2026):面向超算芯片(superchip,如 NVIDIA GH200、AMD MI300)的大规模 LLM 训练卸载方案,充分利用超算芯片的大内存(如 GH200 的 96GB HBM + 576GB LPDDR)来训练更大的模型。
DeepSpeed Core API 更新(2025/12):引入 PyTorch 风格的 backward 接口和低精度(low-precision)master states,减少优化器状态的显存占用。
Muon Optimizer 支持(2026/05):DeepSpeed 集成 Muon(一种基于矩阵正交化的新型优化器,在某些场景优于 AdamW),在分布式环境下高效实现。
SDMA for AMD GPU(2026/05):为 ZeRO-3 的 offload 集合通信优化 AMD GPU 路径,使 DeepSpeed 在 ROCm 平台上的性能接近 CUDA。
硬件与系统层面
Section titled “硬件与系统层面”3D 并行仍是前沿标准:GPT-4、Llama 3、Claude 等前沿模型的训练都依赖 3D 并行(数据 + 流水线 + 张量)。尽管 ZeRO-3 / FSDP 在不断进步,张量并行在机内的极致效率(得益于 NVLink 带宽的持续增长)仍是不可替代的。
ZeRO++(2023,持续影响):通过量化通信(quantized communication)减少 ZeRO 的 all-gather 和 all-reduce 数据量,在跨机低带宽场景下效果显著。2025-2026 年被广泛集成到各训练框架中。
NVIDIA Blackwell B200(2024):第五代 NVLink 提供 1.8 TB/s 的 GPU 间带宽(对比 H100 的 900 GB/s 翻倍),使张量并行在更大规模上仍然高效。
cuDNN SDPA 后端:cuDNN 为 Scaled Dot-Product Attention 提供专用后端,在 H100 上相比 FlashAttention 实现高达 75% 的加速,降低了注意力机制的通信/计算比。
- 训练框架简化:HuggingFace Accelerate、torchtitan 等工具持续降低 FSDP/DeepSpeed 的使用门槛,“三行代码启动多机训练”成为现实。
- 容错训练:千卡以上规模的训练平均每天遭遇硬件故障,快速 checkpoint 恢复(如 1TB/min 级别的保存/恢复速度)成为必备能力。
- 超长上下文训练:从 32K → 1M token 的长序列训练需求催生了 ALST、Ring Attention(一种将注意力计算分布到多卡的环形通信方案)等新技术。
- 异构计算:AMD ROCm 生态在 2025-2026 年快速成熟,Monarch、DeepSpeed、PyTorch 纷纷增加 ROCm 支持,训练不再绑定 NVIDIA。
- 所有大语言模型训练:GPT-4、Claude、LLaMA 等全部使用数千张 GPU 做多机分布式训练(3D 并行 + ZeRO)。详见语言模型演进。
- 大模型微调:LoRA(Low-Rank Adaptation,低秩自适应微调,通过在原模型旁注入可训练的低秩矩阵来减少训练参数量)等参数高效微调也常配合 DDP 做多卡加速。详见大模型微调。
- 扩散模型训练:Stable Diffusion 等高分辨率生成模型同样需要多卡分布式训练。详见扩散模型。
- 大规模图像分类:EfficientNet 等大模型用 DDP 在多卡上训练。详见CNN 卷积神经网络。
- MoE(Mixture of Experts,混合专家模型)训练:Mixtral、DeepSeek-MoE 等稀疏激活模型引入了 expert parallelism(专家并行)这一新的并行维度,与 3D 并行结合形成 4D 并行。
- 多模态大模型:GPT-4V、Gemini 等视觉-语言模型的训练涉及图像编码器(高分辨率 CNN/ViT)和语言解码器的联合分布式训练,并行策略更加复杂。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| torch.distributed / torchrun | Python | PyTorch 原生分布式模块,DDP 和 FSDP 的标准启动方式 |
| DeepSpeed | Python | 微软大模型训练库,ZeRO 优化、3D 并行、Offload 等 |
| Megatron-LM | Python | NVIDIA 张量并行 / 流水线并行参考实现,大模型训练基石 |
| accelerate | Python | HuggingFace 训练加速库,简化 DDP/FSDP/多机配置 |
| torch.distributed.pipeline | Python | PyTorch 原生流水线并行支持 |
| torchtitan | Python | PyTorch 官方轻量级预训练参考,支持 FSDP+TP+PP 组合 |
| Monarch | Python | PyTorch 单控制器分布式训练框架,简化多机编程 |
| ZeRO++ | Python | DeepSpeed 的量化通信优化,降低跨机带宽需求 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 数据并行 | Data Parallelism (DDP) | 每张 GPU 持有完整模型副本,处理不同数据分片,梯度 all-reduce 同步 |
| 梯度 All-Reduce | Gradient All-Reduce | 所有 GPU 交换并平均各自的梯度,确保参数同步更新 |
| Ring All-Reduce | Ring All-Reduce | 环形归约算法,通信量与 GPU 数几乎无关,NCCL 的默认算法 |
| Reduce-Scatter | Reduce-Scatter | 归约 + 散射:先求和再分段,每卡只得到 1/N 的结果 |
| All-Gather | All-Gather | 全收集:每卡持有完整数据的分段,拼合成完整结果 |
| 模型并行 | Model Parallelism | 将大模型切分到多张 GPU 上,每张卡只存模型的一部分 |
| 流水线并行 | Pipeline Parallelism | 按层将模型切分到不同 GPU,微批次交错填充减少空闲(气泡) |
| 流水线气泡 | Pipeline Bubble | 流水线并行中 GPU 等待上下游数据时的空闲时间 |
| 1F1B 调度 | 1F1B Schedule | 一前向一反向交替调度,减少激活值显存占用 |
| 张量并行 | Tensor Parallelism | 将单个矩阵运算切分到多张 GPU 上并行计算(Megatron-LM) |
| 列并行 | Column Parallelism | 权重按输出维度切分,前向不需要通信 |
| 行并行 | Row Parallelism | 权重按输入维度切分,前向需要 All-Reduce 求和 |
| 完全分片数据并行 | FSDP | PyTorch 原生方案,将模型参数/梯度/优化器状态全部分片 |
| ZeRO | Zero Redundancy Optimizer | DeepSpeed 的核心技术,分阶段消除数据并行中的显存冗余 |
| ZeRO-Offload | ZeRO-Offload | 将优化器状态卸载到 CPU 内存,降低 GPU 显存压力 |
| ZeRO-Infinity | ZeRO-Infinity | 进一步支持卸载到 NVMe SSD,训练超大模型 |
| 3D 并行 | 3D Parallelism | 数据并行 + 流水线并行 + 张量并行的组合,千亿模型标配 |
| 梯度累积 | Gradient Accumulation | 多次小 batch 累积梯度后统一更新,等效于大 batch 训练 |
| 通信-计算 overlap | Comm-Compute Overlap | 将通信操作与计算操作并行执行,隐藏通信延迟 |
| NVLink | NVLink | NVIDIA GPU 间的高速互联,张量并行的基础 |
| NCCL | NCCL | NVIDIA Collective Communications Library,GPU 集体通信库 |
| InfiniBand | InfiniBand | 高性能计算中常用的低延迟网络协议,用于机间互联 |
| 微批次 | Micro-batch | 流水线并行中将一个 batch 切分成的多个小批次 |
| 容错训练 | Fault Tolerant Training | 大规模训练中自动检测故障、保存/恢复 checkpoint 的能力 |
- Rajbhandari et al.,「ZeRO: Memory Optimizations Toward Training Trillion Parameter Models」(SC 2020):DeepSpeed ZeRO 论文,分阶段消除显存冗余,大模型训练的里程碑。
- Shoeybi et al.,「Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism」(2019):NVIDIA 张量并行论文,大模型训练的工程基石。
- Narayanan et al.,「Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM」(SC 2021):3D 并行(数据+流水线+张量)的系统实现论文。
- Huang et al.,「GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism」(NeurIPS 2019):微批次流水线并行的经典论文。
- Ren et al.,「ZeRO++: Extremely Efficient Collective Communication for Giant Model Training」(2023):量化通信优化 ZeRO,降低跨机带宽需求。
- Liu et al.,「Ring Attention with Blockwise Parallelism」(2023):Ring Attention,将超长序列的注意力计算分布到多卡。
- Bai et al.,「DeepSpeed System Optimizations for Training Large Language Models」:DeepSpeed 系统级优化的技术报告。
2025-2026 最新论文与资源
Section titled “2025-2026 最新论文与资源”- DeepCompile (2025):DeepSpeed 的编译器优化方案,自动搜索分布式训练调度策略。
- ZenFlow: Stall-Free Offloading Engine (2025):无停顿卸载引擎,异步 overlap 卸载通信与 GPU 计算。
- Arctic Long Sequence Training (ALST, 2025/06):百万级 token 长序列训练的可扩展方案。
- SuperOffload (ASPLOS 2026):面向超算芯片的大规模 LLM 训练卸载方案。
- torchtitan (PyTorch 官方):
https://github.com/pytorch/torchtitan,轻量级预训练参考实现。 - PyTorch FlexAttention 文档:灵活注意力 API,编译为融合 FlashAttention 内核。
- PyTorch Monarch:单控制器分布式训练框架,简化多机编程。
- Helion (2026):PyTorch 性能可移植 ML kernel 的 DSL。
官方文档与教程
Section titled “官方文档与教程”- PyTorch 官方文档,「Getting Started with Distributed Data Parallel」:DDP 官方教程,动手入门首选。
- PyTorch FSDP 教程:Fully Sharded Data Parallel 的官方入门指南。
- DeepSpeed 官方文档:
https://www.deepspeed.ai,ZeRO / Offload / 3D 并行的完整文档。 - Megatron-LM GitHub:
https://github.com/NVIDIA/Megatron-LM,张量并行参考实现。 - NCCL 文档:理解 Ring All-Reduce、tree all-reduce 等集体通信算法。