
聚类分析
本页深入讲解聚类分析(Clustering)——无监督学习中最核心的任务。聚类在无监督学习中作为概览介绍,本页作为独立教程展开各算法的数学原理、适用场景和代码实践。聚类的目标是将相似样本归为一组,是客户分群、文档聚类、图像分割等任务的基础技术。
聚类的本质:物以类聚——让相似的数据自动成团。不同算法对”相似”和”成团”的定义截然不同:
- K-means = 撒种子、归团队、移中心:随机放 K 个中心点,每个样本归到最近的中心,然后中心移动到团队的重心——重复直到稳定。只能发现球形簇,需要预先指定 K。
- 层次聚类 = 画家谱树:从每个样本自成一类开始,不断合并最相似的两类,最终形成一棵”家族树”(树状图 dendrogram)——在任意高度”切一刀”就得到对应数量的簇。不需要预设 K,可视化直观。
- DBSCAN = 看人群密度:人多的地方自然成团(核心点),边缘的人也算(边界点),孤立的零星人就是噪声。不需要预设簇数,还能发现任意形状的簇——月牙形、环形都行。
- GMM = 软分配的概率模型:不是硬邦邦地”这个点属于 A 簇”,而是”这个点 70% 可能属于 A,30% 可能属于 B”。假设数据由多个高斯分布混合而成,用 EM 算法同时学分布参数和分配概率。
为什么要聚类? 当你手头有数据但没有任何标签(不知道正确答案),却想把数据”分门别类”时,聚类就是最自然的工具。它广泛用于探索性数据分析(EDA)——先看看数据自然形成哪些结构,再决定后续策略。
K-means 的 EM 视角
Section titled “K-means 的 EM 视角”K-means 本质上是 EM 算法的特例——E 步分配样本,M 步更新中心:
K-means 是硬分配(Hard Assignment)的 EM——E 步中每个样本 100% 归属一个簇。GMM 是软分配(Soft Assignment)的 EM——E 步算的是样本属于各簇的概率。
不同算法的聚类形状
Section titled “不同算法的聚类形状”各算法对同一数据聚类,效果差异巨大:
K-means 和 GMM 基于距离/概率假设,适合球形簇;DBSCAN 基于密度,适合任意形状;谱聚类把数据建成图,通过图分割聚类,特别适合非凸形状。
四种聚类算法对比
Section titled “四种聚类算法对比”from sklearn.cluster import KMeans, DBSCAN, AgglomerativeClusteringfrom sklearn.mixture import GaussianMixturefrom sklearn.datasets import make_moons
# 生成月牙形数据(非球形,用来测试各算法)X, _ = make_moons(n_samples=300, noise=0.08, random_state=42)
# K-means: 预设 K=2,只能找球形簇kmeans = KMeans(n_clusters=2, random_state=42, n_init=10).fit_predict(X)
# DBSCAN: 基于密度,能发现任意形状dbscan = DBSCAN(eps=0.2, min_samples=5).fit_predict(X)
# 层次聚类: 自底向上合并agg = AgglomerativeClustering(n_clusters=2, linkage="ward").fit_predict(X)
# GMM: 高斯混合模型 + EM 算法gmm = GaussianMixture(n_components=2, random_state=42).fit_predict(X)
# 只有 DBSCAN 能正确聚类月牙形数据print(f"K-means 标签: {kmeans[:10]}") # 线性切开print(f"DBSCAN 标签: {dbscan[:10]}") # 正确识别两个月牙HDBSCAN:更智能的密度聚类
Section titled “HDBSCAN:更智能的密度聚类”HDBSCAN(Hierarchical DBSCAN)是 DBSCAN 的层次化升级版,最大的改进是不需要手动调 ε——它自动探索不同密度层级并选出最稳定的簇:
# pip install hdbscanimport hdbscanfrom sklearn.datasets import make_blobsimport numpy as np
# 生成密度不均匀的数据(真实场景中簇密度往往不同)centers = [[0, 0], [5, 5], [10, 0]]X, _ = make_blobs(n_samples=[50, 200, 50], centers=centers,                  cluster_std=[0.5, 2.0, 0.5], random_state=42)
# HDBSCAN:只需指定 min_cluster_size(最小簇大小),无需调 εclusterer = hdbscan.HDBSCAN(min_cluster_size=15, min_samples=5)labels = clusterer.fit_predict(X)
print(f"发现簇数: {len(set(labels)) - (1 if -1 in labels else 0)}")print(f"噪声点数: {np.sum(labels == -1)}")print(f"聚类置信度(0~1,越高越确定): {clusterer.probabilities_[:5]}")
# HDBSCAN 还提供簇的稳定性分数和层次结构可视化clusterer.condensed_tree_.plot(select_clusters=True)
HDBSCAN vs DBSCAN 的核心区别:DBSCAN 用单一 ε 值,当不同簇密度差异大时顾此失彼;HDBSCAN 构建完整的密度层次树,自动提取不同密度下最”稳定”(持久存在)的簇。实践中 HDBSCAN 几乎总是优于 DBSCAN——它让”调参”这件事简单到只需指定”一个簇至少多大”。
聚类评估:轮廓系数
Section titled “聚类评估:轮廓系数”from sklearn.metrics import silhouette_score
# 尝试不同 K 值,选择轮廓系数最高的for k in range(2, 7): labels = KMeans(n_clusters=k, random_state=42, n_init=10).fit_predict(X) score = silhouette_score(X, labels) # 越接近 1 越好 print(f"K={k}, 轮廓系数={score:.3f}")# 输出示例: K=2 最高,说明分 2 簇最优肘部法则与多指标评估
Section titled “肘部法则与多指标评估”实际项目中,选 K 不能只靠一个指标。下面演示肘部法则(Elbow Method)+ 轮廓系数 + Calinski-Harabasz 指数三者结合的综合评估:
import matplotlib.pyplot as pltfrom sklearn.metrics import silhouette_score, calinski_harabasz_score, davies_bouldin_score
inertias = []silhouettes = []ch_scores = []db_scores = []K_range = range(2, 11)
for k in K_range:    km = KMeans(n_clusters=k, random_state=42, n_init=10).fit(X)    labels = km.labels_    inertias.append(km.inertia_)                          # 越小越好(但会持续下降)    silhouettes.append(silhouette_score(X, labels))        # 越大越好    ch_scores.append(calinski_harabasz_score(X, labels))   # 越大越好    db_scores.append(davies_bouldin_score(X, labels))      # 越小越好
fig, axes = plt.subplots(1, 4, figsize=(18, 4))
# 肘部法则:看 inertia 曲线的"肘部"拐点axes[0].plot(K_range, inertias, 'bo-'); axes[0].set_title('肘部法则 (Inertia)')axes[0].set_xlabel('K'); axes[0].set_ylabel('Inertia (越小越好)')
# 轮廓系数:越大越好axes[1].plot(K_range, silhouettes, 'gs-'); axes[1].set_title('轮廓系数')axes[1].set_xlabel('K'); axes[1].set_ylabel('Silhouette (越大越好)')
# Calinski-Harabasz:越大越好axes[2].plot(K_range, ch_scores, 'r^-'); axes[2].set_title('CH 指数')axes[2].set_xlabel('K'); axes[2].set_ylabel('CH Index (越大越好)')
# Davies-Bouldin:越小越好axes[3].plot(K_range, db_scores, 'md-'); axes[3].set_title('Davies-Bouldin')axes[3].set_xlabel('K'); axes[3].set_ylabel('DB Index (越小越好)')
plt.tight_layout(); plt.savefig('clustering_evaluation.png', dpi=150)# 多个指标共同指向的 K 值通常最可靠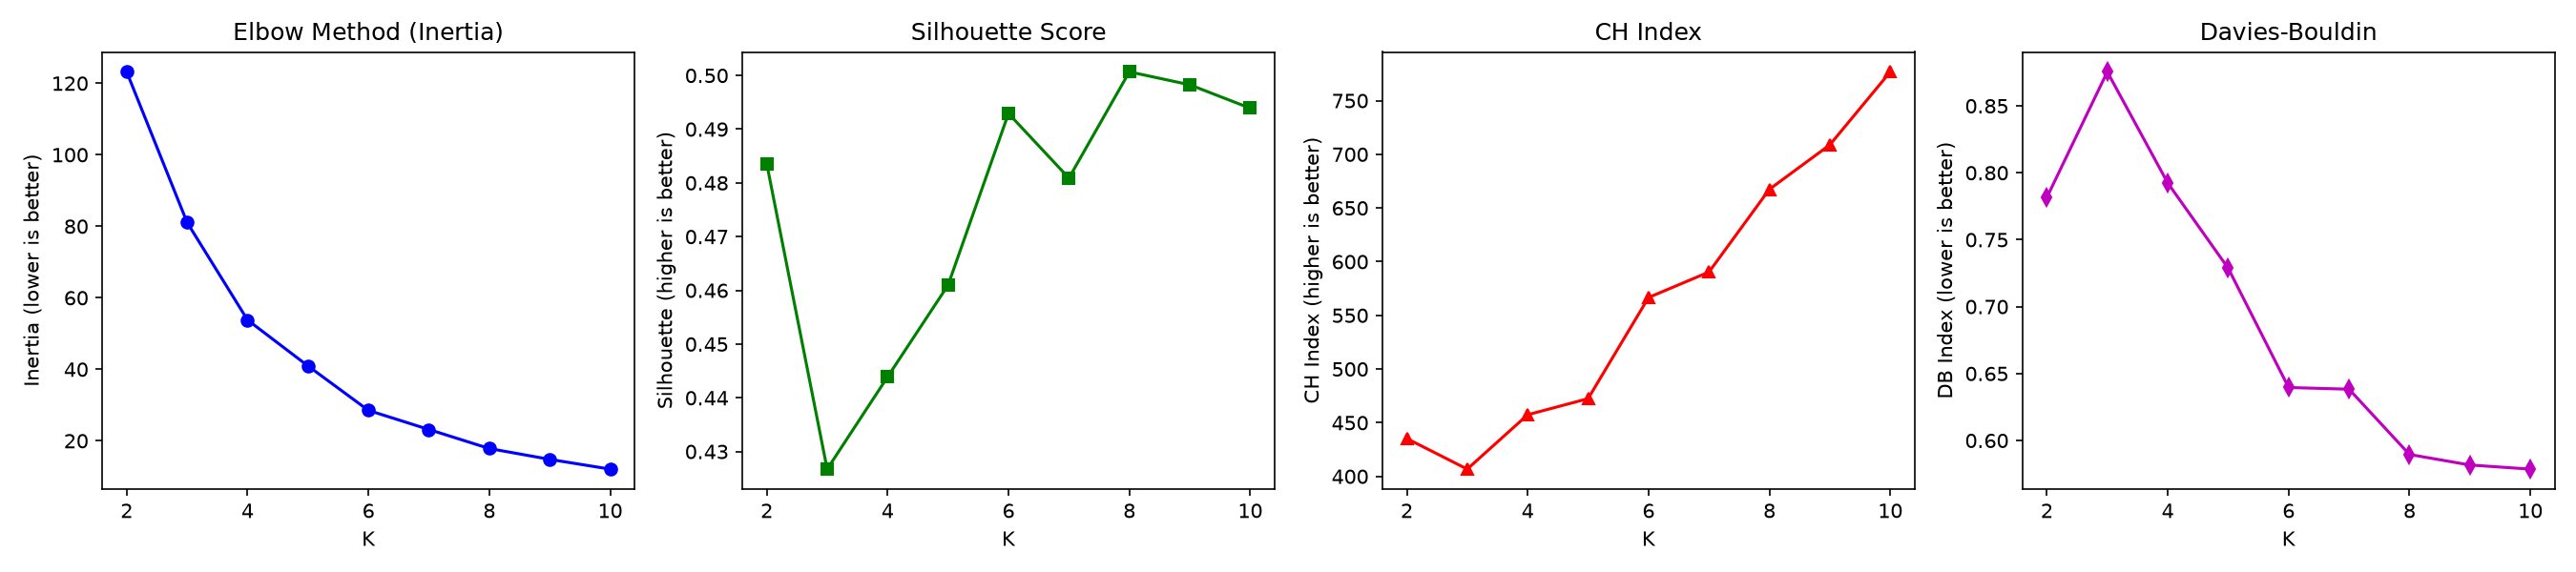
指标解读直觉:inertia 衡量”簇内有多紧凑”(必然随 K 增大而下降,所以找”拐点”而非最小值);轮廓系数同时考虑”簇内紧凑”和”簇间分离”,是综合指标;CH 指数类似方差分析中 F 统计量的思想;DB 指数衡量每对簇之间的相似度,越低说明簇之间分得越开。
K-means 数学原理
Section titled “K-means 数学原理”目标是最小化所有样本到其所属簇中心的距离平方和(inertia / WCSS,Within-Cluster Sum of Squares):
其中 是簇 的均值中心, 是样本 所属的簇。
EM 视角:
- E 步(Expectation):固定中心,每个样本分配到最近中心 →
- M 步(Maximization):固定分配,每个中心更新为所属样本的均值 →
K-means 收敛性证明
Section titled “K-means 收敛性证明”K-means 为什么一定能收敛(停下)?关键在于目标函数 J 是单调递减且有下界的:
-
E 步后 J 不增:固定中心 ,每个样本 选最近中心,新的分配 。这意味着 ,所以 不可能增大。
-
M 步后 J 不增:固定分配 ,把 更新为簇内均值。可以证明:均值是最小化 的解。对 求导令其为零:
所以 M 步的均值更新就是最优解, 不会增大。
- 有下界:(距离平方和不可能为负)。
综合以上: 在每一步 E 和 M 后都不增大,且 ,由单调收敛定理, 必然收敛到一个极限值。由于样本分配的方案是有限种( 种),最终会到达一个 不再变化的稳定分配——这就是收敛。
直觉理解:K-means 像一个球只会往下滚不会往上升——每一步要么让总误差变小,要么不变。它不可能永远变化下去,因为状态空间有限。但它可能停在”半山腰”的局部最优,而非全局最优——这就是为什么需要多次随机初始化(
n_init=10)取最好的结果。
K-means++ 初始化
Section titled “K-means++ 初始化”K-means 的收敛质量严重依赖初始中心的位置。K-means++(Arthur 2007)用一种巧妙的概率采样来分散初始中心:
- 随机选第一个中心
- 对每个剩余点 ,计算它到已选中心的最短距离
- 以概率 选下一个中心——离已有中心越远的点越可能被选中
- 重复直到选满 K 个
这保证了初始中心在空间上充分分散,数学上可以证明 K-means++ 的期望近似比(approximation ratio)为 ,远优于纯随机初始化。scikit-learn 的 KMeans 默认就使用 K-means++。
局限:K-means 隐含假设簇是球形且大小相近,对非球形数据(月牙、环形)效果差;对异常值敏感(一个极端点会拉动中心);维度灾难(curse of dimensionality)使得高维空间中距离的区分度变差。
DBSCAN 详解
Section titled “DBSCAN 详解”DBSCAN(Density-Based Spatial Clustering of Applications with Noise)基于两个参数:ε(邻域半径)和 MinPts(最小邻居数)。
- 核心点(Core Point):ε 邻域内至少有 MinPts 个邻居 → 簇的”骨架”
- 边界点(Border Point):在某个核心点的 ε 邻域内,但自己不是核心点 → 簇的”边缘”
- 噪声点(Noise Point):既不是核心点也不是边界点 → 异常值
密度连通性的形式化定义
Section titled “密度连通性的形式化定义”DBSCAN 的核心概念是密度可达(density-reachable)和密度相连(density-connected):
- 直接密度可达:如果 是核心点,且 在 的 ε 邻域内(),则 从 直接密度可达。
- 密度可达:如果存在一条链 ,使得 从 直接密度可达(, ),则 从 密度可达。注意:密度可达是不对称的——核心点可以到达边界点,但边界点不能反过来到达核心点。
- 密度相连:如果存在一个核心点 ,使得 和 都从 密度可达,则 和 密度相连。密度相连是对称的(这是一个等价关系的核心性质)。
一个簇就是密度相连关系的最大集合——这保证了簇内任意两点都通过密度关系连通,且不存在跨簇的密度连接。这种基于密度的连通性,不是基于距离的圆形划分,所以能发现任意形状。
k-距离图辅助选 ε
Section titled “k-距离图辅助选 ε”from sklearn.neighbors import NearestNeighborsimport numpy as npimport matplotlib.pyplot as plt
# 计算每个点到第 k 近邻的距离,排序后画图k = 5 # 对应 min_samples=5neighbors = NearestNeighbors(n_neighbors=k).fit(X)distances, _ = neighbors.kneighbors(X)k_distances = np.sort(distances[:, -1]) # 第 k 近邻的距离
plt.plot(k_distances)plt.xlabel('样本(按距离排序)')plt.ylabel(f'第 {k} 近邻距离')plt.title('k-距离图 — 拐点处即为合适的 ε')plt.axhline(y=0.3, color='r', linestyle='--', label='建议 ε≈0.3')plt.legend()plt.savefig('k_distance_plot.png', dpi=150)# k-距离图的"拐点"(elbow)通常就是 ε 的好选择:# 拐点之前 = 簇内点(密度高),拐点之后 = 噪声/簇间点(密度低)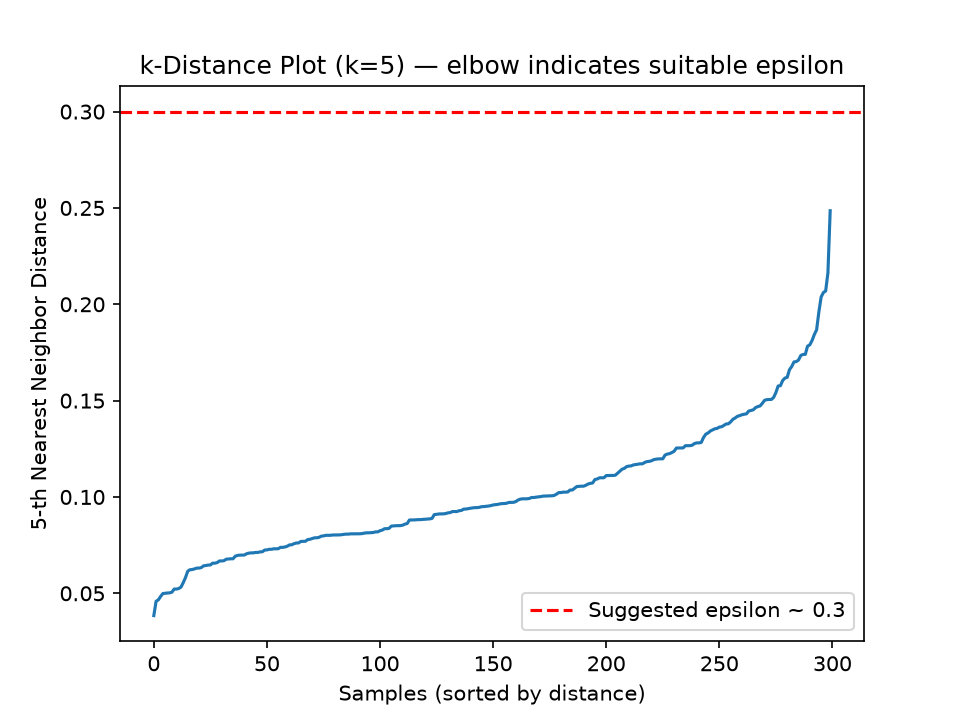
直觉:k-距离图把所有点按”第 k 近邻有多远”排序后画出来。大部分点(簇内)的第 k 近邻很近,所以曲线前段平坦。到了簇的边缘和噪声区域,第 k 近邻突然变远,曲线陡升——拐点对应的距离值就是区分”簇内”和”簇外”的天然分界,即 ε。
GMM + EM 算法
Section titled “GMM + EM 算法”GMM(Gaussian Mixture Model)假设数据由 K 个高斯分布混合而成:
其中 是第 个高斯分布的权重(), 和 是其均值向量和协方差矩阵。
EM 算法的完整推导
Section titled “EM 算法的完整推导”目标:最大化对数似然 。这个对数似然内部有个求和,直接对 求导会得到复杂的耦合方程,无法闭式求解。EM 算法通过引入隐变量(每个样本属于哪个高斯分量)来巧妙绕过这一困难。
E 步(Expectation):计算每个样本属于每个高斯分量的后验概率(软分配 / responsibility):
这里 是样本 属于分量 的概率,满足 。直觉上:如果 离 很近,且 很小(分布很集中),那么 就大。
M 步(Maximization):用软分配概率作为权重更新各高斯分布的参数。令 (分量 的有效样本数),则:
直觉:E 步在说”每个数据点有多大可能属于哪个高斯”,M 步在说”在这些概率下,最优的高斯参数应该长什么样”。两者交替进行,就像一个人蒙眼拼图:先猜每块属于哪个位置(E),再根据猜测调整拼图块(M),反复直到拼对。EM 算法在 Dempster, Laird & Rubin (1977) 的经典论文中被正式提出,是统计学习中最重要的算法之一。
EM 的收敛性:和 K-means 类似,EM 的对数似然在每次迭代后单调不降(这是 EM 的一个基本定理),且有上界(数据决定的),所以必定收敛——但同样只能保证收敛到局部最优。
GMM vs K-means:K-means 是 GMM 的特殊情况——当所有高斯分布的协方差相等 且 时,后验概率退化为”赢者通吃”的硬分配,GMM 的 M 步就变成了 K-means 的均值更新。GMM 更灵活(支持椭圆形簇、软分配),但计算量更大,且对初始化更敏感。
谱聚类(Spectral Clustering)不走距离/密度的路子,而是从**图论(Graph Theory)**的角度切入:
把 个数据点看作图的顶点,点之间的相似度看作边的权重:
-
构建相似度矩阵 :用高斯核(RBF kernel)计算边权重 。 控制”相似”的尺度—— 小时只有非常近的点才有边, 大时远处的点也有弱连接。实践中常取与数据的尺度匹配的值,或用自调整(self-tuning)方法自动确定。
-
度矩阵 :对角矩阵,,即顶点 的所有边权重之和——衡量顶点的”连接强度”。
-
图拉普拉斯矩阵(Graph Laplacian):。这个矩阵有非常优美的性质:
- 是半正定的()
- 的最小特征值为 0,对应特征向量是常数向量
- 零特征值的重数等于图的连通分量数——如果图有 个独立的连通子图, 就有 个零特征值
直觉:图拉普拉斯衡量的是信号在图上的”平滑度”。,如果相邻(权重大的)点的值差异大,这个能量就大。所以 的小特征值对应的特征向量,就是图上最”平滑”的模式——它们自然地把不同连通分量分到不同的值。
-
求 的前 个最小特征向量(跳过第一个全零的),构成矩阵 。
-
行归一化后,在 的列构成的 维空间中跑 K-means。
为什么谱聚类能处理非凸形状? 因为图拉普拉斯的特征向量做了一种非线性降维——它把原始空间中通过密度/相似度连通的点映射到低维空间中相近的位置。月牙形、环形等在原始空间中是非凸的,但在拉普拉斯特征空间中变成了线性可分的块,K-means 就能轻松切分了。这和流形学习(如 LLE、t-SNE)的思想一脉相承。
归一化谱聚类
Section titled “归一化谱聚类”实践中更常用归一化拉普拉斯矩阵 (Ng, Jordan & Weiss 2002)或 (Shi & Malik 2000),它们对度数差异大的图更鲁棒。scikit-learn 的 SpectralClustering 默认使用归一化版本。
层次聚类详解
Section titled “层次聚类详解”层次聚类不需要预设 K,而是构建一个完整的层次结构(hierarchy),有两种方向:
- 凝聚式(Agglomerative,自底向上):从每个样本自成一类开始,每步合并最相似的两类,直到所有样本合为一类。
- 分裂式(Divisive,自顶向下):从一个大类开始,每步将一类分成两类,直到每个样本自成一类。
凝聚式更常用,关键是** linkage(连接方式)**定义了两类之间的距离:
| Linkage | 两类间距离定义 | 特点 |
|---|---|---|
| Single(单连接) | 两类间最近的点对距离 | 容易产生链式效应(chaining),把细长的点串连成一个簇 |
| Complete(全连接) | 两类间最远的点对距离 | 倾向紧凑的球形簇,对噪声敏感 |
| Average(平均连接) | 所有点对距离的平均值 | 折中方案 |
| Ward | 合并后 inertia 的增量 | 类似 K-means 思想,倾向于等大小的簇 |
from scipy.cluster.hierarchy import linkage, dendrogram, fclusterimport matplotlib.pyplot as plt
# 使用 Ward linkage 做层次聚类Z = linkage(X, method='ward')
# 画树状图(dendrogram)plt.figure(figsize=(12, 5))dendrogram(Z, truncate_mode='lastp', p=20)  # 只显示最后 20 次合并plt.axhline(y=Z[-3, 2], color='r', linestyle='--', label='切割线 → 4 簇')plt.title('层次聚类树状图 (Dendrogram)')plt.xlabel('样本 / 簇'); plt.ylabel('合并距离')plt.legend(); plt.savefig('dendrogram.png', dpi=150)
# 在指定高度切割得到簇标签labels = fcluster(Z, t=4, criterion='maxclust')  # 得到 4 个簇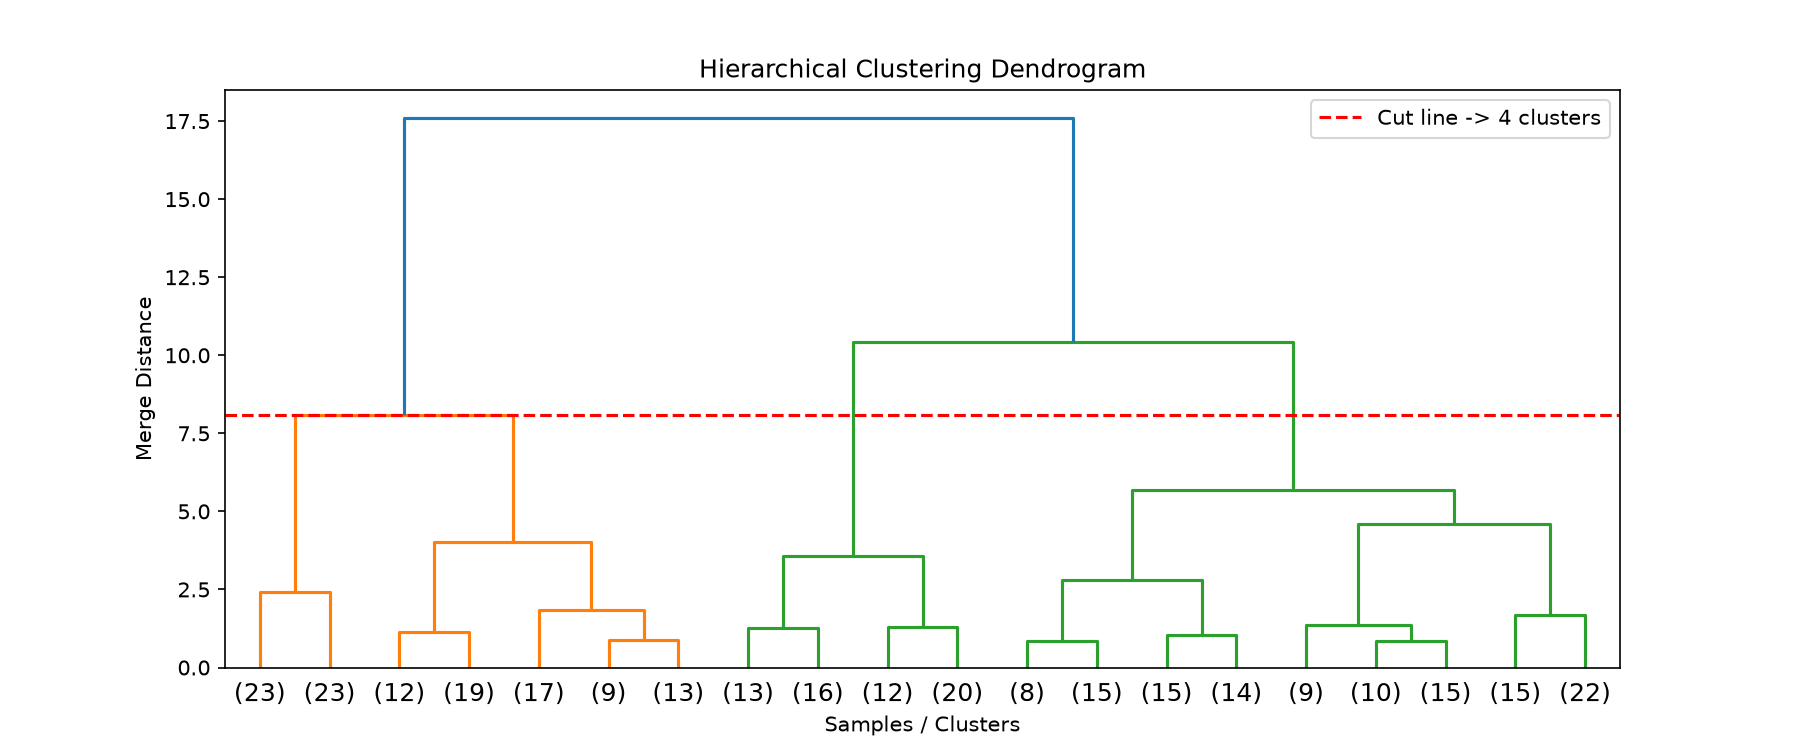
树状图的读取:横轴是样本(或合并后的簇),纵轴是合并时的距离——合并越晚(线越高)说明两类越不相似。在某个高度画一条水平线,穿过的竖线数量就是切割后的簇数。这就是层次聚类的”先聚类后选 K”优势。
- K-means 要先标准化:它基于欧氏距离,大量纲特征会主导聚类结果。用
StandardScaler是标准操作。 - 选 K 的方法:肘部法则(elbow method,看 inertia 随 K 变化的拐点)或轮廓系数(silhouette score,越大越好)——两者结合判断更可靠。
- DBSCAN 参数调优:ε 太大所有点成一簇,太小所有点都是噪声。实践中可以画 k-距离图(k-distance plot)辅助选 ε。更推荐直接用 HDBSCAN,只需指定最小簇大小。
- GMM 注意初始化:EM 算法可能收敛到局部最优,多次随机初始化取最优结果(
n_init参数)。 - 大规模数据用 MiniBatchKMeans:K-means 的小批量版本,用随机子样本更新中心,速度大幅提升,适合百万级数据。
- 维度灾难:在高维空间中,所有点对之间的距离趋于相同,距离的区分力急剧下降。对策:先降维(PCA、UMAP),再聚类。UMAP 降维后接 HDBSCAN 是 2024-2025 年文本聚类的主流 pipeline。
- 聚类结果不稳定:不同随机种子可能给出不同结果(尤其 K-means 和 GMM)。实践中应多次运行取共识结果,或用集成聚类(ensemble clustering)提升稳定性。
- 客户分群 → 精准营销:电商用 K-means 或 GMM 根据消费金额、频次、品类偏好将用户分为”高价值用户""价格敏感型""潜力用户”等群体,支撑差异化运营和个性化推荐。
- 文档聚类 → 内容组织:用 TF-IDF 向量化文档后聚类,自动发现主题分组——新闻聚合(Google News 把同一事件的多篇报道聚类在一起)是最典型的应用。2025 年,用 LLM embedding(如 OpenAI
text-embedding-3-large、BGE-M3)替代 TF-IDF 已成为主流,详见下方聚类与 LLM Embedding。 - 图像分割 → 计算机视觉:对图像像素的 RGB 值聚类,每簇代表一个颜色区域——这是经典的无监督图像分割方法(更先进的方法见图像分割)。
- 异常检测 → 风控与质检:DBSCAN 的噪声点天然是异常点,聚类中远离簇中心的小簇也是异常候选——聚类和异常检测(见异常检测)天然相关。
- 基因表达分析 → 生物信息学:对不同基因在不同条件下的表达水平聚类,发现功能相关的基因组——聚类是生物信息学的基本工具。
- 网络社群发现 → 社交网络分析:对社交网络、引用网络等图结构做聚类(社区检测),自动发现紧密连接的用户群体。谱聚类和模块度优化(Louvain 算法)是核心方法。
- 日志聚类 → AIOps 运维:将海量服务器日志按模板聚类,自动发现异常日志模式,支撑智能告警和根因分析。
- 图像检索与推荐 → 向量聚类:将图片/商品编码为向量后聚类(常用 FAISS 加速的 K-means),实现近似最近邻搜索(ANN),是电商推荐和视觉检索系统的底层技术。
聚类与 LLM Embedding
Section titled “聚类与 LLM Embedding”2024-2026 年,大语言模型(LLM)的 embedding 能力深刻改变了聚类实践。传统方法用 TF-IDF 或 word2vec 获得文本表示,而现代 LLM embedding 捕捉到更深层、更上下文相关的语义信息:
# 现代 LLM embedding 聚类 pipelinefrom sentence_transformers import SentenceTransformerimport hdbscanimport umap
# 1. 用 LLM 编码文本为稠密向量(捕捉深层语义)model = SentenceTransformer('BAAI/bge-large-zh-v1.5')  # 中文 embedding 模型documents = ["机器学习算法入门", "深度学习神经网络", "今天天气真好",             "CNN 图像分类", "明天可能下雨", "Transformer 架构"]embeddings = model.encode(documents)  # → shape (6, 1024)
# 2. UMAP 降维(从 1024 维降到 5 维,保留流形结构)reducer = umap.UMAP(n_components=5, random_state=42)embeddings_2d = reducer.fit_transform(embeddings)
# 3. HDBSCAN 聚类(无需指定簇数,自动发现语义类)clusterer = hdbscan.HDBSCAN(min_cluster_size=2)labels = clusterer.fit_predict(embeddings_2d)
for doc, label in zip(documents, labels):    print(f"[簇 {label}] {doc}")# 簇 0: 机器学习/深度学习/CNN/Transformer(AI 主题)# 簇 1: 天气相关
为什么 UMAP + HDBSCAN 成为黄金组合? LLM embedding 通常有几百上千维,直接在高维空间聚类会遭遇维度灾难。UMAP(Uniform Manifold Approximation and Projection)是一种流形学习降维方法,能保留数据在高维空间中的拓扑结构(谁和谁相邻),同时把维度降到适合聚类的范围。HDBSCAN 在低维空间中基于密度聚类,不预设簇数,还能标出噪声。这个 pipeline 被称为 BERTopic 的核心技术路线,广泛用于主题建模和文档聚类。
这一组合在 RAG(Retrieval-Augmented Generation)系统中也至关重要——聚类后的语义簇用于构建多级检索索引、去重和主题分析。
深度聚类(Deep Clustering)
Section titled “深度聚类(Deep Clustering)”传统聚类算法在原始特征空间上操作,而深度聚类(Deep Clustering)利用神经网络学习更适合聚类的特征表示,然后再做聚类。核心思想是端到端联合优化:表示学习和聚类目标。
| 方法 | 年份 | 核心思想 |
|---|---|---|
| DEC (Deep Embedded Clustering) | 2016 | 自编码器预训练 → 用 KL 散度迭代微调,使表示适配聚类目标 |
| VaDE (Variational Deep Embedding) | 2018 | VAE + GMM 的变分推断框架,深度版的 GMM |
| DeepCluster | 2018 | 用 K-means 的簇标签作为伪标签训练 CNN,表示与聚类互相提升 |
| SwAV (Swassing Assignments Views) | 2020 | 对同一图像的不同增强视图做一致性聚类约束 |
| SCAN | 2020 | 利用预训练特征 + 近邻一致性做聚类微调 |
| CLIP-based 聚类 | 2023-2025 | 利用 CLIP/多模态 embedding 做跨模态聚类(图文混合聚类) |
| DINOv2 + K-means | 2024-2025 | 冻结 DINOv2 自监督特征 + 经典聚类,以极简 pipeline 超越复杂深度聚类方法 |
| DCDC (Deep Conceptor Deep Clustering) | 2024 | 用 conceptor 理论引导深度聚类,避免表征坍塌问题 |
# 深度聚类的简化伪代码(DEC 思路)import torchimport torch.nn as nn
class AutoEncoder(nn.Module):    def __init__(self, input_dim, latent_dim):        super().__init__()        self.encoder = nn.Sequential(            nn.Linear(input_dim, 512), nn.ReLU(),            nn.Linear(512, 128), nn.ReLU(),            nn.Linear(128, latent_dim)        )        self.decoder = nn.Sequential(            nn.Linear(latent_dim, 128), nn.ReLU(),            nn.Linear(128, 512), nn.ReLU(),            nn.Linear(512, input_dim)        )    def forward(self, x):        z = self.encoder(x)        return z, self.decoder(z)
# 步骤 1: 预训练自编码器(最小化重构误差)# 步骤 2: 在 latent space 上跑 K-means 得到初始簇中心# 步骤 3: 用 KL 散度微调 —— 让 latent 表示更适配聚类目标# 目标: L = 重构损失 + λ * KL(软分配 || 目标分布)
深度聚类 vs 传统聚类:传统聚类(K-means、DBSCAN)是”特征给定后做聚类”;深度聚类是”边学特征边聚类”。当原始数据是图像、文本、音频等非结构化数据时,原始像素/词向量空间不适合直接聚类,深度聚类通过学到的语义特征,往往能大幅提升效果。代价是需要大量数据和 GPU 训练。
纯无监督聚类不使用任何标签,而半监督聚类(Semi-Supervised Clustering)利用少量已知信息(must-link / cannot-link 约束,或少量种子标签)来引导聚类,效果往往显著优于纯无监督方法。
- Must-link 约束:“这两个样本必须在同一个簇”(已知同类)
- Cannot-link 约束:“这两个样本不能在同一个簇”(已知不同类)
代表算法:
- COP-KMeans:修改 K-means 的 E 步,分配样本时检查约束,如果违反约束就跳过该点。
- MPCKMeans(Metric Pairwise Constraint K-Means):不仅用约束引导分配,还同时学习一个马氏距离(Mahalanobis distance)度量,使约束在特征空间中被更好地满足——这实际上是**度量学习(Metric Learning)**与聚类的结合。
- ** seeded K-Means**:用少量已知标签的样本初始化簇中心,然后正常跑 K-means。
# COP-KMeans 示意(使用约束引导聚类)from active_semi_clustering.semi_supervised.pairwise_constraints import COPKMeans
# must-link: 第 0 和第 1 个样本必须同簇# cannot-link: 第 0 和第 3 个样本不能同簇ml = [(0, 1), (2, 3)]cl = [(0, 3), (1, 4)]
cop_kmeans = COPKMeans(n_clusters=3)labels = cop_kmeans.fit_predict(X, ml=ml, cl=cl)# 少量约束就能大幅改善聚类质量,尤其当数据本身难以区分时实际价值:在很多场景中,获取全量标签成本极高,但少量标注(“这几条客服对话是同一类投诉”、“这两个用户明显不属于同一客群”)成本很低。半监督聚类用这些廉价约束显著提升聚类质量,性价比极高。
2025-2026 年前沿趋势
Section titled “2025-2026 年前沿趋势”聚类分析领域在 2025-2026 年呈现以下主要趋势:
1. LLM 驱动的语义聚类成为默认方案
Section titled “1. LLM 驱动的语义聚类成为默认方案”传统 TF-IDF + K-means 的文档聚类正在被 LLM embedding + UMAP + HDBSCAN 的 pipeline 全面取代。这一趋势的代表是 BERTopic(Grootendorst, 2022-2025),它将 LLM embedding 聚类与主题表示提取(c-TF-IDF)结合,成为主题建模的新标准。商业产品如 OpenAI、Cohere 提供的 embedding API 使得任何应用都能轻松获得高质量的语义向量。
2025 年 BERTopic 生态进一步成熟:支持动态主题建模(追踪主题随时间演化)、层次主题建模(构建主题层级树)、以及 LLM 自动主题命名与摘要。这些能力使 BERTopic 从学术工具变成企业内容分析的基础设施——新闻聚合、客服对话分析、学术文献挖掘等场景广泛采用。
2. 向量数据库中的聚类
Section titled “2. 向量数据库中的聚类”随着 RAG 系统的普及,向量数据库(Pinecone、Weaviate、Milvus、Qdrant)普遍内置了 K-means 或 IVF(Inverted File Index)聚类来加速近似最近邻搜索。聚类从”分析工具”变成了”基础设施组件”。Facebook 的 FAISS 库支持 GPU 加速的 K-means,可在分钟级完成十亿级向量的聚类。
2025 年的趋势是分层聚类索引——先用粗粒度 K-means 把向量空间分成大区域,再在每个区域内做细粒度聚类,形成多级索引树。Milvus 和 Qdrant 都已实现这种分层 IVF 索引,在十亿级向量检索中实现了亚毫秒级延迟。
3. 深度聚类与自监督学习融合
Section titled “3. 深度聚类与自监督学习融合”自监督预训练(SimCLR、DINO、MAE)产生的高质量特征表示,使得”预训练特征 + 经典聚类”的组合在图像、音频等非结构化数据上效果接近专门的深度聚类方法,且更简单。纯端到端深度聚类的研究仍在继续,但工业界更倾向于两阶段 pipeline。
2024-2025 年的关键突破来自 DINOv2(Meta AI):其自监督视觉特征质量极高,以至于”冻结 DINOv2 + K-means”这个极其简单的组合,在图像聚类任务上的效果就能超越复杂的端到端深度聚类方法。这进一步验证了”强表征 > 好聚类算法”的趋势——当特征已经足够好时,聚类算法的选择变得不那么重要。
4. 半监督与约束聚类的新应用
Section titled “4. 半监督与约束聚类的新应用”随着 LLM 成为”标注引擎”(用 GPT-4 生成大量伪标签和约束),半监督聚类获得了丰富的约束来源。LLM 引导聚类(LLM-Guided Clustering)成为新兴方向——用 LLM 生成的语义约束来引导传统聚类算法,结合了 LLM 的语义理解能力和经典算法的效率。
2025 年的最新进展包括:
- LLM-as-a-Cluster-Labeler:聚类完成后,让 LLM 为每个簇自动生成自然语言标签和描述(如”簇 0 = 关注价格、偏好折扣的年轻用户”),大幅降低人工解读成本。
- LLM 主动约束生成:在聚类过程中,让 LLM 判断”这两个样本是否应该在同一簇”,自动生成 must-link / cannot-link 约束,实现迭代优化的半监督聚类。
5. HDBSCAN 的广泛采用
Section titled “5. HDBSCAN 的广泛采用”HDBSCAN 已从学术算法变成工业界密度聚类的首选工具。它的 hdbscan Python 库持续维护更新,被集成到 BERTopic、scikit-learn-contrib 等主流生态中。相比 DBSCAN 需要痛苦调参 ε,HDBSCAN 只需指定 min_cluster_size,这个参数有明确的业务含义(“一个簇至少包含多少点”),更易于领域专家理解和操作。
2024-2025 年,hdbscan 库引入了 soft clustering 能力——每个样本不再被硬分配到唯一簇,而是获得属于各簇的概率向量。这对模糊边界场景(如一个文档同时涉及多个主题)特别有用,也使得聚类结果可以下游任务做更灵活的融合。
6. 可解释聚类
Section titled “6. 可解释聚类”随着 AI 透明性要求的提高,可解释聚类(Explainable Clustering)受到关注——不仅要分好簇,还要解释”为什么这样分”。代表方法如 EXPERT(决策树风格的聚类解释)、基于 SHAP 值的簇特征解释等。LLM 在这一方向也有应用:让 LLM 自动为每个簇生成自然语言描述(“簇 0 是对价格敏感、偏好折扣的年轻用户”)。
2025 年的 可解释 K-means(Explainable K-means, IKM)方法更进一步:用一棵浅层决策树替代质心分配规则,使得”样本为什么被分到这个簇”可以用 2-3 个简单规则解释(如”年龄 < 35 且月消费 > 500 → 簇 2”),在牺牲极小聚类质量的前提下大幅提升可解释性。
7. 不确定性感知聚类(2025 新兴方向)
Section titled “7. 不确定性感知聚类(2025 新兴方向)”传统聚类给出确定性的簇分配,但在安全关键场景(医疗、金融)中,知道”模型对某个样本的簇分配有多不确定”同样重要。2025 年出现了多种不确定性量化方法:
- Conformal Clustering:结合保形预测(Conformal Prediction)框架,为每个样本提供有保证覆盖率的预测集——即”这个样本有 90% 的概率属于这 N 个簇之一”。
- 贝叶斯深度聚类:在深度聚类的神经网络中引入贝叶斯推断,输出簇分配的后验分布而非点估计,自然量化不确定性。
- 能量分数聚类:利用能量模型(Energy-Based Models)为每个簇分配计算能量分数,低能量 = 高置信度,高能量 = 边界或异常样本。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| scikit-learn | Python | 提供 KMeans、DBSCAN、AgglomerativeClustering、GMM、SpectralClustering 全谱算法 |
| SciPy(scipy.cluster) | Python | 提供层次聚类的 linkage、fcluster、dendrogram 等经典函数 |
| hdbscan | Python | DBSCAN 的改进版(HDBSCAN),自动选择最优参数,无需手动调 ε |
| FAISS | C++/Python | Facebook 的向量聚类与检索库,支持 GPU 加速的 K-means |
| UMAP-learn | Python | 流形学习降维库,常与 HDBSCAN 组合用于高维聚类 |
| BERTopic | Python | 基于 LLM embedding + UMAP + HDBSCAN 的主题建模框架 |
| sentence-transformers | Python | 获取高质量文本 embedding,聚类 pipeline 的第一步 |
| MCL(Markov Cluster) | Python/命令行 | 基于马尔可夫链流动模拟的图聚类算法,常用于网络分析 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 簇 | Cluster | 聚类结果中一组相似的样本 |
| 质心 | Centroid | 一个簇内所有样本的均值中心点,K-means 迭代更新的对象 |
| 簇内平方和 | Inertia / WCSS | 所有样本到其所属簇中心的距离平方和,K-means 的最小化目标 |
| 肘部法则 | Elbow Method | 绘制 inertia 随 K 的变化曲线,在拐点(肘部)选择 K |
| 轮廓系数 | Silhouette Score | 衡量聚类质量的指标,结合簇内紧密度与簇间分离度,范围 [-1, 1] |
| 软分配 | Soft Assignment | GMM 中给样本分配属于各簇的概率(而非唯一归属)的方式 |
| 硬分配 | Hard Assignment | K-means 中每个样本唯一归属一个簇的分配方式 |
| 树状图 | Dendrogram | 层次聚类结果的树形可视化,在任意高度切割得到对应簇数 |
| 核心点 / 边界点 / 噪声点 | Core / Border / Noise Point | DBSCAN 中按邻域密度对点的三种分类 |
| 图拉普拉斯 | Graph Laplacian | 谱聚类中度矩阵减去相似度矩阵得到的矩阵,其特征向量用于降维 |
| 密度可达 | Density-Reachable | DBSCAN 中通过核心点链连接两点的关系,是簇定义的基础 |
| 流形学习 | Manifold Learning | 假设高维数据位于低维流形上的学习方法,UMAP/t-SNE 属于此类 |
| 自编码器 | Autoencoder | 输入等于输出的神经网络,通过瓶颈层学习压缩表示,深度聚类的基础 |
| 维度灾难 | Curse of Dimensionality | 高维空间中距离区分力下降的现象,是高维聚类的主要挑战 |
| 近似最近邻 | ANN (Approximate Nearest Neighbor) | 通过聚类索引加速的近邻搜索,是向量数据库的核心技术 |
| 度量学习 | Metric Learning | 从数据中学习一个距离度量(如马氏距离),使同类样本更近、异类更远 |
术语表补充:聚类评估指标
Section titled “术语表补充:聚类评估指标”| 指标 | 英文 | 解释 |
|---|---|---|
| Calinski-Harabasz 指数 | CH Index | 簇间方差与簇内方差之比,越大越好,计算快 |
| Davies-Bouldin 指数 | DB Index | 簇内紧密度与簇间分离度之比,越小越好 |
| 调整兰德指数 | Adjusted Rand Index (ARI) | 有真实标签时,衡量聚类结果与真实标签的一致性,随机聚类时 ARI≈0 |
| 归一化互信息 | NMI (Normalized Mutual Information) | 有真实标签时,衡量聚类结果与真实标签的信息共享量,范围 [0, 1] |
- 划分式聚类谱系:K-means(Lloyd 1957 提出、MacQueen 1967 命名)→ K-means++(Arthur 2007,改进初始化)→ MiniBatchKMeans(Sculley 2010,大规模数据加速)→ K-medoids / PAM(用真实样本点而非均值作为中心,对异常值鲁棒)。
- 层次聚类谱系:Agglomerative(自底向上合并,Ward 1963 / 单连接 / 全连接 / 平均连接)→ Divisive(自顶向下分裂,DIANA)→ BIRCH(大规模数据的层次聚类,用 CF 树加速)。
- 密度聚类谱系:DBSCAN(Ester 1996,经典论文)→ OPTICS(Ankerst 1999,自动处理不同密度的簇)→ HDBSCAN(Campello 2013,层次化 DBSCAN,自动选最优簇)。
- 模型式聚类:GMM + EM(Dempster, Laird, Rubin 1977,EM 算法经典论文)→ Dirichlet Process GMM(非参数贝叶斯,自动确定簇数)。概率图模型的更多内容见概率图模型与半监督学习。
- 谱聚类:基于图论的聚类方法(Shi & Malik 2000,Normalized Cut;Ng, Jordan & Weiss 2002)。谱聚类与谱降维(Laplacian Eigenmaps)一脉相承,都是利用图拉普拉斯矩阵的特征分解。
- 深度聚类:DEC(Xie, Girshick & Farhadi 2016,开创性的深度聚类工作)→ VaDE(Jiang et al. 2018,VAE+GMM)→ DeepCluster(Caron et al. 2018)→ 基于自监督预训练的方法(DINO、SCAN, 2020-2025)。
- 主题建模与文本聚类:LDA(Blei, Ng & Jordan 2003,经典概率主题模型)→ BERTopic(Grootendorst 2022-2025,LLM embedding 时代的主题建模)→ Top2Vec(Angelov 2020,基于 embedding 的主题发现)。
- 聚类与 LLM 结合的前沿:用 LLM embedding 替代传统文本表示做聚类(2023-2026 趋势),用 LLM 生成约束引导半监督聚类,用 LLM 自动生成聚类描述和解释。