
视觉语言模型 VLM
本页介绍视觉语言模型(Vision-Language Model, VLM)——让 AI 同时”看懂”图像和”理解”语言的多模态模型。它是 多模态 LLM 家族中最成熟的分支,也是连接计算机视觉(CV)与自然语言处理(NLP)的桥梁。从 CLIP 的对比学习到 LLaVA/Qwen-VL 的视觉对话,VLM 正在重新定义人机交互的方式。
VLM = 给 LLM 装上一双眼睛。
传统 LLM 只能处理文本——你问它”描述这张图”,它会说”我不能看图”。VLM 把图像也变成一种”语言”:通过视觉编码器(Vision Encoder)把图片压缩成一串向量(就像文本被 tokenize 成向量一样),然后喂给 LLM 处理。LLM 本身不需要改变太多——它只需要学会”读”这种新的视觉 token。
- CLIP = 看图说话的连线游戏:给一堆图片和一堆文字描述,训练模型把”对的图片-对的文字”配对打高分——对不上的打低分。学完后,模型就理解了”图像内容”和”文字语义”是同一个空间里的两种表达。
- LLaVA = 把图像当外语:视觉编码器把图片”翻译”成一组向量(视觉 token),通过一个投影层(Projection Layer)对齐到 LLM 的词嵌入空间,LLM 就像处理一种”外语”一样处理图像信息。
- Q-Former = 翻译官:BLIP-2 发明的 Q-Former 先用一组可学习的 query 从视觉编码器那里”榨取”关键信息,压缩成固定数量的 token 再给 LLM——比直接拼接全部视觉 token 更高效。
多模态(Multimodal) 指模型能同时处理多种数据类型——文本、图像、音频、视频等。VLM 特指视觉+语言两种模态。更广泛的多模态 LLM 讨论见 多模态 LLM。
VLM 三大架构范式
Section titled “VLM 三大架构范式”VLM 如何将视觉信息接入 LLM?业界发展出三种主流架构:
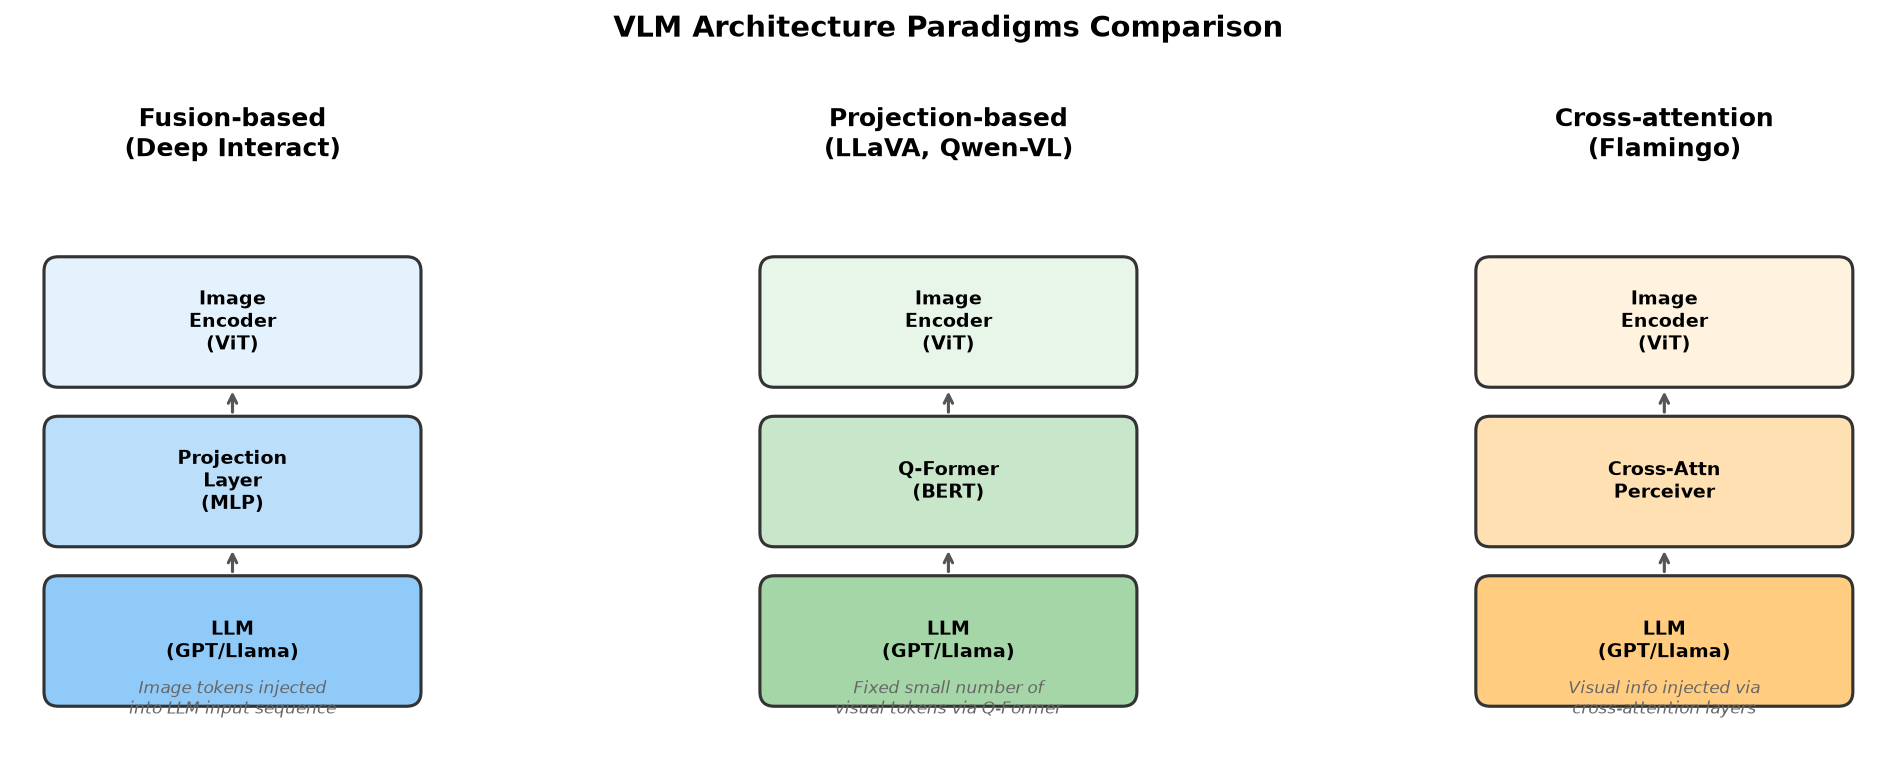
范式一:Projection-based(LLaVA 路线)
Section titled “范式一:Projection-based(LLaVA 路线)”最简单直接的方案——视觉编码器输出 个视觉特征向量,通过一个线性层或 MLP 把它们映射到 LLM 的词嵌入维度,然后当作”虚拟文本 token”拼接到 LLM 输入中:
其中 是视觉编码器的输出维度, 是 LLM 的隐藏维度, 就是投影后的视觉 token 序列。LLM 的输入变为 (视觉 token + 文本 token 的拼接)。
- 优点:实现最简单,只训练 Projection Layer(LLM 和 Vision Encoder 可以冻结),训练成本低。
- 缺点:视觉 token 数量 往往很大(ViT-L 输出 256-576 个 token),占用大量 LLM 上下文。
- 代表模型:LLaVA-1.5、Qwen-VL、InternVL。
范式二:Q-Former(BLIP-2 路线)
Section titled “范式二:Q-Former(BLIP-2 路线)”引入一个轻量级的 Transformer 模块(Q-Former),包含一组可学习的 query(通常 32 个),从视觉编码器的全部特征中”提取”出与语言最相关的信息,压缩成固定数量的 token:
Q-Former 通过 Cross-Attention 让 个 query 从 个视觉特征中”筛选”关键信息。典型设置 ,远小于 ——大幅减少喂给 LLM 的 token 数。
- 优点:token 数量固定且少(32 vs 576),LLM 上下文开销小。
- 缺点:Q-Former 需要多阶段训练(先学视觉-语言对齐,再接 LLM),工程复杂。
- 代表模型:BLIP-2、InstructBLIP、MiniGPT-4。
范式三:Cross-Attention(Flamingo 路线)
Section titled “范式三:Cross-Attention(Flamingo 路线)”不在 LLM 输入端拼接视觉 token,而是在 LLM 的某些层之间插入 Cross-Attention 层,让 LLM 在处理文本时通过交叉注意力”查看”视觉特征:
其中 来自 LLM 的文本隐状态, 和 来自视觉编码器的输出。LLM 的原始自注意力层保持冻结,只训练插入的 Cross-Attention 层和 Perceiver Resampler。
- 优点:可以冻结 LLM 参数(只训练新增层),适合参数高效训练。
- 缺点:修改了 LLM 架构,部署时不能直接复用标准 LLM 推理框架。
- 代表模型:Flamingo、IDEFICS。
CLIP:视觉-语言对齐的奠基者
Section titled “CLIP:视觉-语言对齐的奠基者”CLIP(Contrastive Language-Image Pre-training)是 OpenAI 在 2021 年提出的模型——它不是 VLM 本身,但它的对比学习思想几乎是所有现代 VLM 的视觉编码器基础。
CLIP 的训练目标
Section titled “CLIP 的训练目标”CLIP 同时训练一个图像编码器(Image Encoder)和一个文本编码器(Text Encoder),目标很简单:让匹配的图文对相似度最高,不匹配的最低。
给定一个 batch 含 个图文对,分别编码后得到图像特征 和文本特征 ,计算两两之间的余弦相似度矩阵 :
CLIP 的对比损失(InfoNCE loss)为:
其中 是可学习的温度参数。第一项是”给定图像找正确文本”的损失,第二项是”给定文本找正确图像”的损失——两个方向的对比。
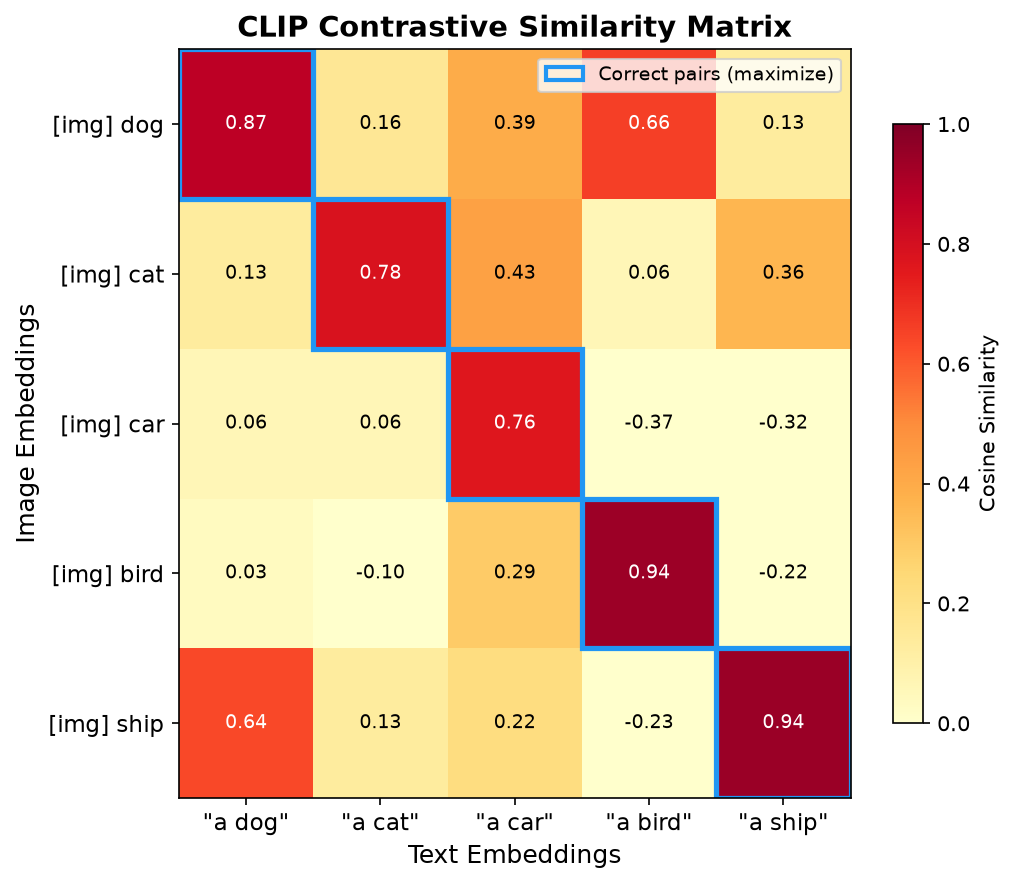
直觉理解:CLIP 的训练就像一场”连连看”——每张图片对应一句正确描述,模型要学会把正确配对的相似度推高,错误配对的推低。训练 4 亿对图文后,CLIP 学会了把视觉概念和语言概念映射到同一个语义空间——这使得它的图像编码器可以直接作为 VLM 的视觉前端。
CLIP 的零样本分类
Section titled “CLIP 的零样本分类”CLIP 最令人印象深刻的能力是零样本分类(Zero-shot Classification)——不需要任何微调就能对新类别分类。方法是把分类问题转化为”文本匹配”问题:
import torchfrom transformers import CLIPModel, CLIPProcessor
model = CLIPModel.from_pretrained("openai/clip-vit-base-patch32")processor = CLIPProcessor.from_pretrained("openai/clip-vit-base-patch32")
# 零样本分类:把类别名变成文本,计算相似度image = ...  # PIL Imagecandidate_labels = ["a photo of a dog", "a photo of a cat", "a photo of a car"]
inputs = processor(text=candidate_labels, images=image, return_tensors="pt", padding=True)outputs = model(**inputs)
logits_per_image = outputs.logits_per_image  # shape: (1, 3)probs = logits_per_image.softmax(dim=1)# tensor([[0.85, 0.10, 0.05]]) → 85% probability it's a dog
ViT:视觉编码器的主流选择
Section titled “ViT:视觉编码器的主流选择”几乎所有现代 VLM 都使用 ViT(Vision Transformer)作为视觉编码器。ViT 把图像当作”序列”处理——和 NLP 中的 Transformer 思路一致。详见 ViT。
ViT 的核心流程:
- 分块(Patchify):把 的图像切成 的小块(patch),通常 。一张 的图片被切成 个 patch。
- 展平 + 线性投影:每个 patch 展平成向量后通过线性层映射到维度 ,得到 196 个视觉 token。
- 加位置编码:给每个 token 加上位置信息(告诉模型每个 patch 在图像中的位置)。
- 过 Transformer 编码器:多层 Self-Attention + FFN。
其中 是第 个 patch 的展平向量, 是 patch 投影矩阵, 是位置嵌入。
Grounding:从”看懂”到”指认”
Section titled “Grounding:从”看懂”到”指认””Visual Grounding(视觉定位)是 VLM 的高级能力——不仅描述图片内容,还能指出”图中哪个区域对应描述中的哪个词”。例如给定 “the red car on the left”,模型不仅理解这句话,还能在图中框出对应的红色汽车。
Referring Expression Comprehension(指代表达理解)
Section titled “Referring Expression Comprehension(指代表达理解)”任务定义:给定一张图片和一段自然语言描述,输出图片中对应区域的 bounding box。
Grounding 与 Detection 的区别:目标检测(见 目标检测与 YOLO)找出图中所有物体的位置,Grounding 则是根据语言描述定位特定物体——它需要同时理解视觉和语言,是典型的多模态任务。
相关任务:图像描述与视觉问答
Section titled “相关任务:图像描述与视觉问答”VLM 的能力覆盖多种视觉-语言任务,其中最基础的两类是:
- 图像描述(Image Captioning):给模型一张图片,让它生成一段自然语言描述——“图里有什么、在做什么”。这是 VLM 最基础的能力,也是训练阶段的核心任务之一。更多背景见 图像描述。
- 视觉问答(Visual Question Answering, VQA):给模型一张图片和一个问题(如”图中的人穿什么颜色的衣服?""左桌上有几个杯子?”),模型需要结合视觉理解给出答案。VQA 是衡量 VLM 综合能力的经典基准——详见 视觉问答。
现代对话式 VLM(如 Qwen-VL、LLaVA)将图像描述、VQA、Grounding 等任务统一到**指令跟随(Instruction Following)**框架下——用户用自然语言提问,模型自动理解任务类型并响应,不再需要为每种任务单独训练。
OCR + VLM 融合
Section titled “OCR + VLM 融合”传统 OCR 系统(见 OCR 技术专题)只输出识别的文本——“图片上写了什么字”。但很多场景不仅需要识别文字,还需要理解文字的含义和布局(发票分析、文档问答、图表解读)。VLM + OCR 的融合方案应运而生:
这种融合架构的优势:
- OCR 提供精确的文字内容(VLM 直接读小字容易出错)
- VLM 提供语义理解(知道哪个数字是”总计金额”,哪个是”税额”)
- 文本坐标信息帮助模型理解文档布局(表格、段落、标题)
Qwen-VL 系列在 OCR 场景做了深度优化:训练阶段引入了大量中英文文档数据,可以直接输出带格式的 OCR 结果,在文档理解基准(DocVQA、ChartQA)上表现领先。
视频是图像的时序延伸——VLM 从理解单张图片进化到理解视频序列。核心挑战是时序建模(temporal modeling):
时序采样策略
Section titled “时序采样策略”视频很长(几分钟到几小时),不可能处理每一帧。常用策略:
- 均匀采样:从视频中均匀抽取 帧(如 或 ),每帧单独过 ViT,时间维度的信息通过 LLM 的 Self-Attention 隐式建模。
- 3D Patch:用 3D 卷积/注意力同时处理空间和时间维度(如 ViViT、TimeSformer)。
- 关键帧检测:用轻量网络先找到”信息量大”的关键帧(场景切换、动作发生时),只对这些帧编码。
时序位置编码
Section titled “时序位置编码”不同帧的视觉 token 需要时序位置信息。常见做法是给每帧的 token 加上时序位置编码(Temporal Position Embedding):
其中 是帧内空间位置编码, 是帧间时序位置编码。
PyTorch 代码:简化的 VLM 前向传播
Section titled “PyTorch 代码:简化的 VLM 前向传播”import torchimport torch.nn as nn
class SimpleVLM(nn.Module): """A minimal Projection-based VLM (LLaVA-style)."""
def __init__(self, vision_encoder, llm, vision_dim=1024, llm_dim=4096): super().__init__() self.vision_encoder = vision_encoder # e.g. CLIPVisionModel self.llm = llm # e.g. LlamaForCausalLM # Projection layer: map vision features to LLM embedding space self.projection = nn.Sequential( nn.Linear(vision_dim, llm_dim), nn.GELU(), nn.Linear(llm_dim, llm_dim), )
def encode_image(self, pixel_values): """Encode image into visual tokens via vision encoder + projection.""" with torch.no_grad(): # Freeze vision encoder vision_outputs = self.vision_encoder(pixel_values) # shape: (batch, num_patches, vision_dim) image_features = vision_outputs.last_hidden_state # Project to LLM embedding space image_embeds = self.projection(image_features) # shape: (batch, num_patches, llm_dim) return image_embeds
def forward(self, pixel_values, input_ids, attention_mask, labels=None): """ Args: pixel_values: (batch, 3, H, W) - input images input_ids: (batch, seq_len) - tokenized text with <image> placeholder labels: (batch, seq_len) - labels for next-token prediction """ # Step 1: Encode image into visual tokens image_embeds = self.encode_image(pixel_values) # Step 2: Get text embeddings from LLM text_embeds = self.llm.get_input_embeddings()(input_ids) # Step 3: Replace <image> token positions with visual embeddings # Assuming <image> token has a specific ID in the vocabulary image_token_id = 32000 # example: <image> token ID for b in range(input_ids.shape[0]): mask = (input_ids[b] == image_token_id) num_image_tokens = mask.sum().item() text_embeds[b, mask] = image_embeds[b, :num_image_tokens] # Step 4: Forward through LLM outputs = self.llm( inputs_embeds=text_embeds, attention_mask=attention_mask, labels=labels, ) return outputs
# 使用示例# from transformers import CLIPVisionModel, LlamaForCausalLM# vlm = SimpleVLM(# vision_encoder=CLIPVisionModel.from_pretrained("openai/clip-vit-large-patch14"),# llm=LlamaForCausalLM.from_pretrained("meta-llama/Llama-2-7b-hf"),# )CLIP 对比学习代码
Section titled “CLIP 对比学习代码”import torchimport torch.nn as nnimport torch.nn.functional as F
class CLIPModel(nn.Module): """Simplified CLIP for contrastive image-text pretraining."""
def __init__(self, image_encoder, text_encoder, embed_dim=512): super().__init__() self.image_encoder = image_encoder self.text_encoder = text_encoder self.image_projection = nn.Linear(image_encoder.dim, embed_dim) self.text_projection = nn.Linear(text_encoder.dim, embed_dim) self.logit_scale = nn.Parameter(torch.ones([]) * np.log(1 / 0.07))
def forward(self, images, texts): # Encode and project to shared embedding space image_features = self.image_projection(self.image_encoder(images)) text_features = self.text_projection(self.text_encoder(texts)) # Normalize features image_features = F.normalize(image_features, dim=-1) text_features = F.normalize(text_features, dim=-1) # Cosine similarity matrix logit_scale = self.logit_scale.exp() logits_per_image = logit_scale * image_features @ text_features.T logits_per_text = logits_per_image.T # Symmetric contrastive loss labels = torch.arange(logits_per_image.shape[0]).to(images.device) loss_i = F.cross_entropy(logits_per_image, labels) loss_t = F.cross_entropy(logits_per_text, labels) loss = (loss_i + loss_t) / 2 return loss主流 VLM 模型对比
Section titled “主流 VLM 模型对比”| 模型 | 视觉编码器 | LLM | 架构 | 特色 |
|---|---|---|---|---|
| CLIP (2021) | ViT-L/14 | Text Transformer | 对比学习(非生成式) | 零样本分类先驱 |
| BLIP-2 (2023) | ViT-G/14 | FlanT5/OPT | Q-Former | 两阶段训练,高效 |
| LLaVA-1.5 (2023) | CLIP-ViT-L/14 | Vicuna-7B/13B | MLP Projection | 最简单的 VLM,开源标杆 |
| Qwen-VL (2023) | ViT-bigG | Qwen-7B | Cross-Attention | 中文最强,OCR 能力突出 |
| LLaVA-NeXT (2024) | CLIP-ViT-L | Llama-3-8B | MLP + AnyRes | 动态分辨率 |
| Qwen2-VL (2024) | ViT(675M) | Qwen2-7B/72B | Naive Dynamic Resolution | 原生动态分辨率,视频理解 |
| InternVL2 (2024) | InternViT-6B | InternLM2 | MLP Projection | 最大视觉编码器(6B) |
VLM 基准评测演进
Section titled “VLM 基准评测演进”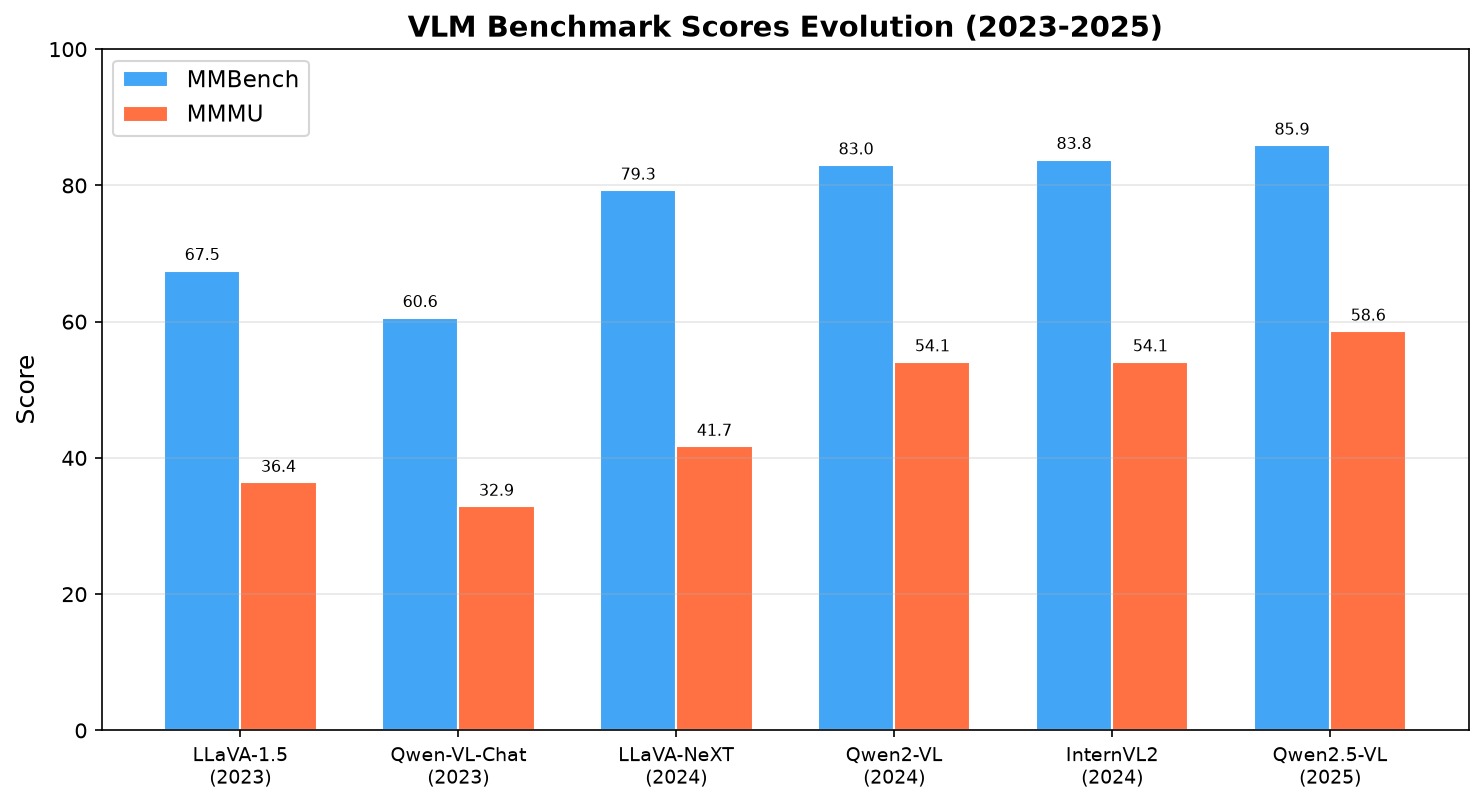
MMMU(Massive Multi-discipline Multimodal Understanding)是一个大学级别的多学科 VLM 基准,包含 30 个学科(艺术、科学、医学、工程等)的图文题目。它测试的不只是”看图说话”,而是用视觉信息做推理——2023 年最好的模型只能做对 36% 的题,2025 年 Qwen2.5-VL 达到 58.6%,但仍远低于人类的 75-80%。
模型选择指南
Section titled “模型选择指南”| 使用场景 | 推荐模型 | 理由 |
|---|---|---|
| 英文图文对话 | LLaVA-NeXT | 开源、社区活跃、部署简单 |
| 中文图文对话/OCR | Qwen2-VL / Qwen2.5-VL | 中文原生支持,OCR 精度领先 |
| 文档理解/表格分析 | Qwen2-VL / Donut | 专门的文档理解训练 |
| 视频问答 | Qwen2-VL / Video-LLaVA | 支持多帧输入 |
| 零样本图像分类 | CLIP / SigLIP | 轻量、快速、无需训练 |
| 商用 API | GPT-4o / Gemini / Claude 3.5 | 精度最高,但成本高 |
- 视觉编码器可以异步执行:图片编码(ViT)和文本处理可以并行——先把图片编码好缓存起来,LLM 只处理文本 + 缓存的视觉特征。
- 视觉 token 压缩:高分辨率图片会产生数百个视觉 token,可以通过 Token Pooling(如将相邻的 2×2 token 平均成一个)减少 75% 的 token 数量。
- 动态分辨率:LLaVA-NeXT 和 Qwen2-VL 支持根据图片大小动态调整 patch 数量——小图用少 token,大图用多 token,避免分辨率浪费。
- 分辨率限制:大多数 VLM 的视觉编码器训练时用 224×224 或 336×336 分辨率,输入高分辨率图片时效果可能下降——要么先 resize,要么选择支持动态分辨率的模型。
- OCR 幻觉:VLM 有时会”编造”图片中不存在的文字。对于需要精确文字识别的场景(发票、合同),优先用专用 OCR 引擎。
- 位置理解偏差:当前 VLM 对”左边""右上方”等空间关系的理解仍不够可靠——在需要精确定位的场景配合 Grounding 模型使用。
- 多图推理:大多数 VLM 对 2 张以上图片的比较推理能力较弱(如”A 图和 B 图哪个更亮?”),选择模型时注意其对多图的支持能力。
2024-2025 年关键进展
Section titled “2024-2025 年关键进展”- 原生多模态训练:GPT-4o、Gemini 1.5 等不再使用”视觉编码器 + LLM”的拼接架构,而是从头训练一个统一处理图像、文本、音频的原生多模态模型——所有模态共享同一套 Transformer 参数。这消除了模块间的信息瓶颈,但在开源社区难以复现。
- Qwen2-VL 的动态分辨率:抛弃传统的固定尺寸 resize,直接将任意分辨率图片编码为相应数量的 patch,通过 M-RoPE(Multimodal Rotary Position Embedding)编码位置——既保留了细节信息,又避免了信息丢失。
- AnyRes 策略(LLaVA-NeXT):将高分辨率图片切成多个子图分别编码,再拼接——在保持高分辨率细节的同时控制 token 数量。
- SigLIP:Google 提出的 CLIP 改进版,将对比损失的 softmax 换成 sigmoid(每对图文独立判断 match/mismatch,不需要在 batch 内做归一化),训练更稳定,batch size 更灵活。已成为新一代 VLM 的默认视觉编码器。
- 视频理解长程化:Qwen2-VL 支持最长 16 分钟的视频输入(采样约 4000 帧),Gemini 1.5 支持长达 1 小时的视频——对长视频的时序推理(如”视频中主角在第几分钟换了衣服?“)成为新的前沿。
- 细粒度视觉理解:当前 VLM 对整体场景描述很好,但对细节(如”图片角落里小字写的什么”)仍容易出错。
- 空间推理:对 3D 空间关系(前后、远近、遮挡)的理解仍然薄弱。
- 多图推理与比较:同时理解多张图片并做比较推理的能力不足。
- 视觉幻觉:VLM 有时会描述图片中不存在的内容——研究界正通过 RLHF、DPO 等方法减轻视觉幻觉。
- 效率:视觉 token 大量占用上下文窗口(一张高清图可能产生上千 token),推理成本是纯文本的数倍。
VLM 的终极目标是真正的多模态理解——不仅是看图说话,而是像人类一样用视觉信息做推理、决策和创造。当前最好的 VLM 在视觉感知上已接近人类水平,但在视觉推理(根据图像内容做多步逻辑推断)上仍有显著差距。
- Radford, A. et al. “Learning Transferable Visual Models From Natural Language Supervision.” ICML 2021. (CLIP)
- Li, J. et al. “BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models.” ICML 2023.
- Liu, H. et al. “Visual Instruction Tuning.” NeurIPS 2023. (LLaVA)
- Bai, J. et al. “Qwen-VL: A Versatile Vision-Language Model.” arXiv 2308.12966, 2023.
- Wang, P. et al. “Qwen2-VL: Enhancing Vision-Language Model’s Perception of the World at Any Resolution.” arXiv 2409.12191, 2024.
- Alayrac, J.-B. et al. “Flamingo: a Visual Language Model for Few-Shot Learning.” NeurIPS 2022.
- Dosovitskiy, A. et al. “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale.” ICLR 2021. (ViT)
- Zhai, X. et al. “Sigmoid Loss for Language Image Pre-Training.” ICCV 2023. (SigLIP)
- Yue, X. et al. “MMMU: A Massive Multi-discipline Multimodal Understanding and Reasoning Benchmark.” CVPR 2024.
- Chen, Z. et al. “InternVL: Scaling up Vision Foundation Models and Aligning for Generic Visual-Linguistic Tasks.” CVPR 2024.