
如何使用 OpenCV parallel_for_ 函数并行化你的代码(卷积示例)
本教程的目标是演示如何使用 OpenCV 的 parallel_for_ 框架轻松并行化你的代码。为了说明这个概念,我们将编写一个对图像执行卷积操作的程序。完整的教程代码在此处。
第一个前置条件是 OpenCV 在构建时启用了某个并行框架。在 OpenCV 4.5 中,以下并行框架按此顺序可用:
- Intel Threading Building Blocks(第三方库,需要显式启用)
- OpenMP(集成在编译器中,需要显式启用)
- APPLE GCD(系统级,自动使用,仅限 APPLE)
- Windows RT concurrency(系统级,自动使用,仅限 Windows RT)
- Windows concurrency(运行时的一部分,自动使用,仅限 Windows - MSVC++ >= 10)
- Pthreads
如你所见,OpenCV 库中可以使用多种并行框架。一些并行库是第三方库,必须在构建之前在 CMake 中显式启用,而另一些则随平台自动可用(例如 APPLE GCD)。
当多个线程尝试同时写入、或同时读写某个特定内存位置时,就会发生竞态条件(race condition)。基于此,我们可以将算法大致分为两类:
-
只有单个线程向特定内存位置写入数据的算法。
- 例如在卷积中,即使多个线程可能在某一时刻读取某个像素,也只有单个线程向特定像素写入。
-
多个线程可能向同一个内存位置写入的算法。
- 例如查找轮廓、特征等。此类算法可能要求每个线程同时向一个全局变量添加数据。例如,在检测特征时,每个线程会把自己负责的那部分图像的特征添加到一个公共向量中,从而造成竞态条件。
我们将以执行卷积为例,演示如何使用 parallel_for_ 来并行化计算。这是一个不会导致竞态条件的算法示例。
卷积是图像处理中广泛使用的一种简单数学运算。我们将一个较小的矩阵(称为卷积核,kernel)在图像上滑动,像素值与卷积核中对应值的乘积之和就给出了输出中特定像素的值(该位置称为卷积核的锚点)。根据卷积核中取值的不同,我们会得到不同的结果。在下面的例子中,我们使用一个 3x3 卷积核(锚点位于其中心)对一个 5x5 矩阵做卷积,产生一个 3x3 矩阵。输出的尺寸可以通过用合适的值填充输入来改变。
关于不同卷积核及其作用的更多信息,请参见此处。
在本教程中,我们将实现该函数最简单的形式:它接收一幅灰度图像(1 通道)和一个奇数长度的方阵卷积核,并产生一幅输出图像。该操作不会就地(in-place)执行。
注: 我们可以临时存储几个相关像素,以确保在卷积过程中使用原始值,然后就地执行。然而,本教程的目的是介绍 parallel_for_ 函数,就地实现可能过于复杂。
InputImage src, OutputImage dst, kernel(size n)makeborder(src, n/2)for each pixel (i, j) strictly inside borders, do:{    value := 0    for k := -n/2 to n/2, do:        for l := -n/2 to n/2, do:            value += kernel[n/2 + k][n/2 + l]*src[i + k][j + l]
    dst[i][j] := value}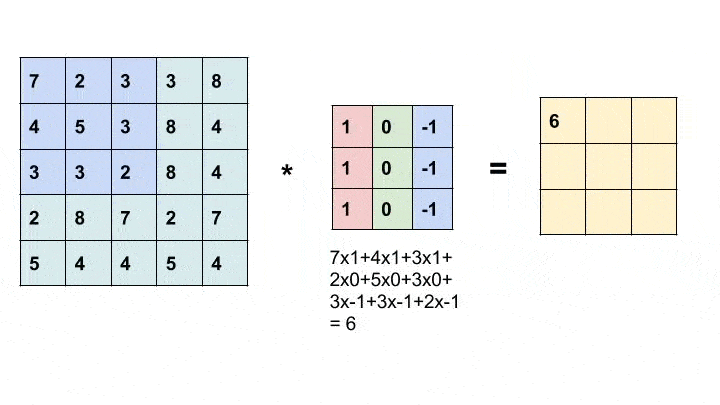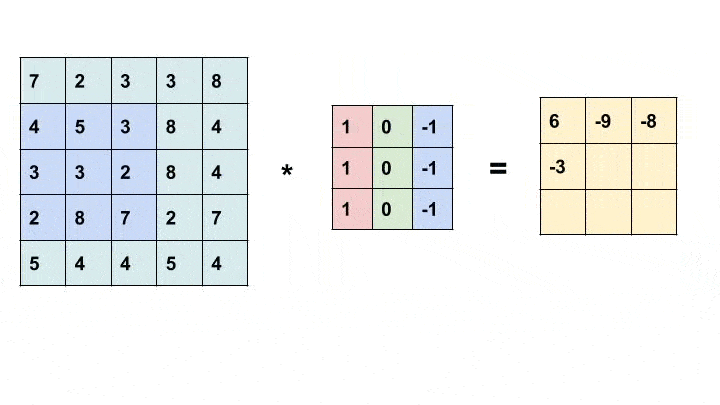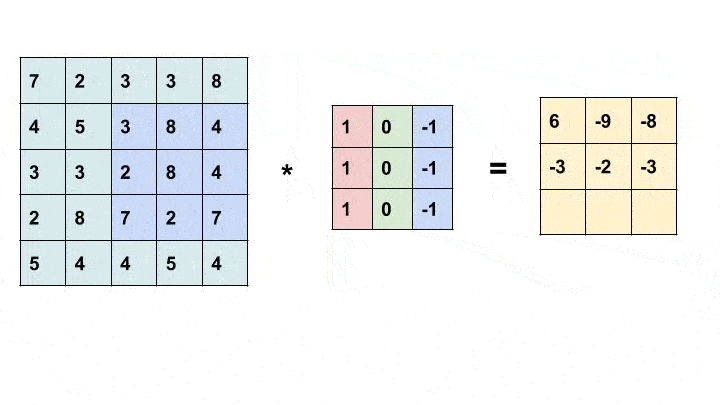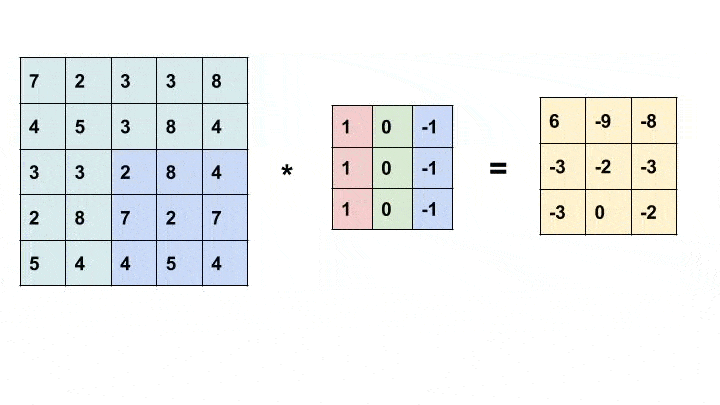
对于 n 大小的卷积核,我们将添加一个大小为 n/2 的边界来处理边缘情况。然后我们运行两个循环沿卷积核移动,并把乘积累加到总和中。
void conv_seq(Mat src, Mat &dst, Mat kernel){    int rows = src.rows, cols = src.cols;    dst = Mat(rows, cols, src.type());
    // Taking care of edge values    // Make border = kernel.rows / 2;
    int sz = kernel.rows / 2;    copyMakeBorder(src, src, sz, sz, sz, sz, BORDER_REPLICATE);
    for (int i = 0; i < rows; i++)    {        uchar *dptr = dst.ptr(i);        for (int j = 0; j < cols; j++)        {            double value = 0;
            for (int k = -sz; k <= sz; k++)            {                // slightly faster results when we create a ptr due to more efficient memory access.                uchar *sptr = src.ptr(i + sz + k);                for (int l = -sz; l <= sz; l++)                {                    value += kernel.ptr<double>(k + sz)[l + sz] * sptr[j + sz + l];                }            }            dptr[j] = saturate_cast<uchar>(value);        }    }}
我们首先创建一个与 src 尺寸相同的输出矩阵(dst),并为 src 图像添加边界(以处理边缘情况):
int rows = src.rows, cols = src.cols;dst = Mat(rows, cols, src.type());
// Taking care of edge values// Make border = kernel.rows / 2;
int sz = kernel.rows / 2;copyMakeBorder(src, src, sz, sz, sz, sz, BORDER_REPLICATE);
然后我们顺序遍历 src 图像中的像素,在卷积核和相邻像素值上计算数值,再把该值填入 dst 图像中对应的像素:
for (int i = 0; i < rows; i++){    uchar *dptr = dst.ptr(i);    for (int j = 0; j < cols; j++)    {        double value = 0;
for (int k = -sz; k <= sz; k++) { // slightly faster results when we create a ptr due to more efficient memory access. uchar *sptr = src.ptr(i + sz + k); for (int l = -sz; l <= sz; l++) { value += kernel.ptr<double>(k + sz)[l + sz] * sptr[j + sz + l]; } } dptr[j] = saturate_cast<uchar>(value); }}观察顺序实现时我们可以注意到:每个像素依赖于多个相邻像素,但一次只编辑一个像素。因此,为了优化计算,我们可以把图像拆分为多个条带(stripe),利用现代处理器的多核架构并行地对每个条带执行卷积。OpenCV 的 cv::parallel_for_ 框架会自动决定如何高效地拆分计算,并为我们完成大部分工作。
注: 尽管某个条带中像素的值可能依赖于该条带之外的像素值,但这些只是只读操作,因此不会导致未定义行为。
我们首先声明一个继承自 cv::ParallelLoopBody 的自定义类,并重写 virtual void operator ()(const cv::Range& range) const:
class parallelConvolution : public ParallelLoopBody{private:    Mat m_src, &m_dst;    Mat m_kernel;    int sz;
public:    parallelConvolution(Mat src, Mat &dst, Mat kernel)        : m_src(src), m_dst(dst), m_kernel(kernel)    {        sz = kernel.rows / 2;    }
    virtual void operator()(const Range &range) const CV_OVERRIDE    {        for (int r = range.start; r < range.end; r++)        {            int i = r / m_src.cols, j = r % m_src.cols;
            double value = 0;            for (int k = -sz; k <= sz; k++)            {                uchar *sptr = m_src.ptr(i + sz + k);                for (int l = -sz; l <= sz; l++)                {                    value += m_kernel.ptr<double>(k + sz)[l + sz] * sptr[j + sz + l];                }            }            m_dst.ptr(i)[j] = saturate_cast<uchar>(value);        }    }};
operator () 中的 range 表示将由单个线程处理的数值子集。根据需求,可能有不同的拆分 range 的方式,而这反过来会改变计算过程。
例如,我们可以:
-
拆分整个图像的遍历,并按以下方式获取
[row, col]坐标(如上面的代码所示):virtual void operator()(const Range &range) const CV_OVERRIDE{for (int r = range.start; r < range.end; r++){int i = r / m_src.cols, j = r % m_src.cols;double value = 0;for (int k = -sz; k <= sz; k++){uchar *sptr = m_src.ptr(i + sz + k);for (int l = -sz; l <= sz; l++){value += m_kernel.ptr<double>(k + sz)[l + sz] * sptr[j + sz + l];}}m_dst.ptr(i)[j] = saturate_cast<uchar>(value);}}然后我们按以下方式调用 parallel_for_ 函数:
parallelConvolution obj(src, dst, kernel);parallel_for_(Range(0, rows * cols), obj); -
按行拆分,并对每一行进行计算:
virtual void operator()(const Range &range) const CV_OVERRIDE{for (int i = range.start; i < range.end; i++){uchar *dptr = dst.ptr(i);for (int j = 0; j < cols; j++){double value = 0;for (int k = -sz; k <= sz; k++){uchar *sptr = src.ptr(i + sz + k);for (int l = -sz; l <= sz; l++){value += kernel.ptr<double>(k + sz)[l + sz] * sptr[j + sz + l];}}dptr[j] = saturate_cast<uchar>(value);}}}在这种情况下,我们用不同的 range 调用 parallel_for_ 函数:
parallelConvolutionRowSplit obj(src, dst, kernel);parallel_for_(Range(0, rows), obj);
注: 在我们的例子中,两种实现的表现相似。某些情况下可能会有更好的内存访问模式或其他性能收益。
要设置线程数,你可以使用 cv::setNumThreads。你还可以使用 cv::parallel_for_ 中的 nstripes 参数来指定拆分数量。例如,如果你的处理器有 4 个线程,设置 cv::setNumThreads(2) 或设置 nstripes=2 应该是等效的,因为默认情况下它会使用所有可用的处理器线程,但只把工作负载拆分到两个线程上。
注: C++ 11 标准允许简化并行实现:去掉
parallelConvolution类,用 lambda 表达式替换它:
parallel_for_(Range(0, rows * cols), [&](const Range &range)                {                    for (int r = range.start; r < range.end; r++)                    {                        int i = r / cols, j = r % cols;
double value = 0; for (int k = -sz; k <= sz; k++) { uchar *sptr = src.ptr(i + sz + k); for (int l = -sz; l <= sz; l++) { value += kernel.ptr<double>(k + sz)[l + sz] * sptr[j + sz + l]; } } dst.ptr(i)[j] = saturate_cast<uchar>(value); } });两种实现在以下输入上的执行耗时:
- 512x512 输入,5x5 卷积核:
This program shows how to use the OpenCV parallel_for_ function andcompares the performance of the sequential and parallel implementations for aconvolution operationUsage:./a.out [image_path -- default lena.jpg]
Sequential Implementation: 0.0953564sParallel Implementation: 0.0246762sParallel Implementation(Row Split): 0.0248722s- 512x512 输入,3x3 卷积核:
This program shows how to use the OpenCV parallel_for_ function andcompares the performance of the sequential and parallel implementations for aconvolution operationUsage:./a.out [image_path -- default lena.jpg]
Sequential Implementation: 0.0301325sParallel Implementation: 0.0117053sParallel Implementation(Row Split): 0.0117894s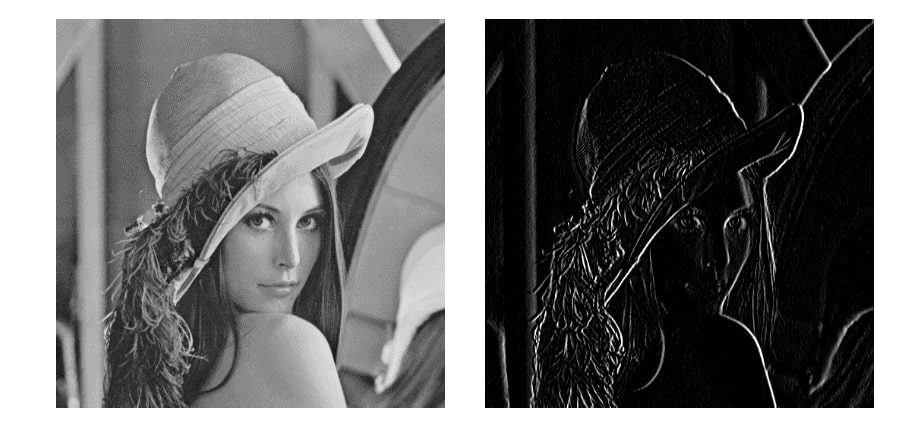
并行实现的性能取决于你的 CPU 类型。例如,在 4 核 8 线程的 CPU 上,运行时间可能比顺序实现快 6 到 7 倍。有许多因素可以解释为什么我们没有达到 8 倍的加速:
- 创建和管理线程的开销;
- 并行运行的后台进程;
- 「4 个物理核心、每核 2 个逻辑线程」与「8 个物理核心」之间的差异。
在本教程中,我们使用了一个水平梯度滤波器,它产生一幅突出垂直边缘的图像。