
RAG 进阶技术
RAG 基础介绍了 RAG(Retrieval-Augmented Generation,检索增强生成)的基本流程:文档切片 → Embedding → 向量检索 → 拼接到 Prompt → LLM 生成。这套朴素 RAG(Naive RAG)虽然简单可用,但在生产环境中常常遇到精度不足、召回偏差、上下文冗余等问题。本页介绍进阶 RAG(Advanced RAG)技术栈,涵盖 Hybrid Search、Query Rewrite、高级 Chunk 策略、Metadata Filter 和 RAG 评估体系。
为什么需要进阶 RAG? 朴素 RAG 的典型问题:(1) 用户提问和文档措辞不一致,语义检索召回不到正确答案;(2) 仅靠向量相似度,无法利用关键词精确匹配;(3) 固定长度切片破坏文档结构;(4) 无法按元数据(时间、来源、类别)过滤结果。进阶 RAG 通过多路检索、查询改写、智能分块和评估闭环来解决这些问题。
把 RAG 想象成一个图书馆管理员帮你查资料的过程:
- 朴素 RAG = 你说一句话,管理员拿这句话去书架上搜,搜到什么就给你看什么
- 进阶 RAG = 管理员先帮你重新组织问题(Query Rewrite),同时用多种方式搜(关键词 + 语义 + 知识图谱),过滤掉不相关的书(Metadata Filter),把最相关的几页重新排序(Reranking),最后检查答案是否真的来自原文(RAGAS 评估)
进阶 RAG 的完整流水线:
Hybrid Search:混合检索
Section titled “Hybrid Search:混合检索”为什么单一检索不够?
Section titled “为什么单一检索不够?”RAG 中两种主流检索方式各有优劣:
| 特性 | Dense Retrieval(密集检索) | Sparse Retrieval(稀疏检索) |
|---|---|---|
| 原理 | 语义向量相似度(余弦相似度) | 关键词匹配(TF-IDF / BM25) |
| 优势 | 理解同义词、语义相近的概念 | 精确匹配专有名词、代码、ID |
| 劣势 | 对精确匹配不敏感,可能漏掉关键词完全匹配的文档 | 无法理解语义,“汽车”搜不到”轿车” |
| 适用场景 | 概念性问题、长尾查询 | 事实查询、特定术语检索 |
BM25(Best Matching 25)是经典的基于词频的全文检索算法,通过 TF-IDF 的改进版来计算查询与文档的相关性。详见 BM25。
核心问题:用户问 “Python 的 GIL 是什么?” 时——Dense 检索可能找到 “全局解释器锁” 的语义文档,但 Sparse 检索能精确匹配到包含 “GIL” 这个缩写的代码文档。两者各有不可或缺的价值。
Hybrid Search 架构
Section titled “Hybrid Search 架构”RRF(Reciprocal Rank Fusion)融合算法
Section titled “RRF(Reciprocal Rank Fusion)融合算法”Dense 和 Sparse 两路检索各返回一个排序结果列表,需要一个融合策略来合并。最常用的是 RRF(倒数排名融合),它不依赖原始相似度分数(Dense 和 BM25 的分数量纲不同,直接比较无意义),而是只看排名:
其中 是所有检索系统的集合, 是文档 在第 个检索结果中的排名(从 1 开始), 是平滑常数(通常取 60)。RRF 的直觉很简洁:在多个检索系统中都排名靠前的文档,最终得分高。
为什么用 RRF 而非加权平均分数? 因为 Dense 相似度(余弦相似度,范围 0~1)和 BM25 分数(无上界)的尺度完全不同。如果直接加权求和,BM25 的高分会淹没 Dense 的信号。RRF 只用排名信息,天然避免了尺度不一致问题,且不需要调参。
Python 实现
Section titled “Python 实现”from rank_bm25 import BM25Okapifrom typing import List, Dictimport numpy as np
class HybridRetriever: """混合检索器:Dense + Sparse + RRF 融合"""
def __init__(self, documents: List[str], embed_fn, k_rrf: int = 60): self.documents = documents self.embed_fn = embed_fn # Embedding 函数 self.k_rrf = k_rrf
# 构建 Sparse 索引(BM25) tokenized_docs = [doc.lower().split() for doc in documents] self.bm25 = BM25Okapi(tokenized_docs)
# 构建 Dense 索引(向量) self.doc_embeddings = np.array([embed_fn(doc) for doc in documents])
def dense_search(self, query: str, top_k: int = 20) -> List[int]: """向量语义检索""" query_emb = self.embed_fn(query) # 余弦相似度 scores = self.doc_embeddings @ query_emb ranked = np.argsort(scores)[::-1][:top_k] return ranked.tolist()
def sparse_search(self, query: str, top_k: int = 20) -> List[int]: """BM25 关键词检索""" tokenized_query = query.lower().split() scores = self.bm25.get_scores(tokenized_query) ranked = np.argsort(scores)[::-1][:top_k] return ranked.tolist()
def hybrid_search(self, query: str, top_k: int = 10) -> List[Dict]: """RRF 融合检索""" dense_results = self.dense_search(query, top_k=20) sparse_results = self.sparse_search(query, top_k=20)
# RRF 融合 rrf_scores = {} for rank, doc_id in enumerate(dense_results, 1): rrf_scores[doc_id] = rrf_scores.get(doc_id, 0) + 1 / (self.k_rrf + rank) for rank, doc_id in enumerate(sparse_results, 1): rrf_scores[doc_id] = rrf_scores.get(doc_id, 0) + 1 / (self.k_rrf + rank)
# 排序并返回 Top-K sorted_ids = sorted(rrf_scores, key=rrf_scores.get, reverse=True)[:top_k] return [ {"doc_id": did, "content": self.documents[did], "rrf_score": rrf_scores[did]} for did in sorted_ids ]
# 使用示例(embed_fn 需替换为实际的 Embedding 函数)# retriever = HybridRetriever(documents, embed_fn)# results = retriever.hybrid_search("Python GIL 全局解释器锁", top_k=5)Query Rewrite:查询改写
Section titled “Query Rewrite:查询改写”为什么需要查询改写?
Section titled “为什么需要查询改写?”用户提问往往不完美——可能过于简短、表述模糊、包含指代、或与文档措辞差距过大。Query Rewrite(查询改写) 用 LLM 对原始查询进行预处理,提升检索召回率。
常见模式:
| 策略 | 原始查询 | 改写后 | 适用场景 |
|---|---|---|---|
| Query Expansion | “RAG” | “RAG (Retrieval-Augmented Generation) 检索增强生成” | 缩写、专业术语 |
| Sub-question Decomposition | “比较 RAG 和 Fine-tuning 的优缺点” | [“RAG 的优点是什么?”, “RAG 的缺点?”, “Fine-tuning 的优点?”, “Fine-tuning 的缺点?”] | 复杂多跳问题 |
| Step-back Prompting | “Transformer 为什么比 RNN 快?” | [“Transformer 的并行计算机制”, “RNN 的序列依赖问题”] | 需要背景知识的问题 |
| HyDE | “什么是 BatchNorm?” | LLM 先生成一个假设答案,用该答案的 Embedding 去检索 | 用户措辞与文档差距大 |
HyDE(Hypothetical Document Embeddings)
Section titled “HyDE(Hypothetical Document Embeddings)”HyDE 的核心洞察:用户提问的措辞通常像”问题”(简短、疑问句),而文档措辞通常像”答案”(详尽、陈述句)。直接用问题去检索文档,语义空间不匹配。HyDE 的做法是先让 LLM 假设性地回答这个问题,然后用这个”假答案”的 Embedding 去检索真实文档——因为”假答案”和”真答案”在表述风格上更接近,语义匹配更精准。
Python 实现
Section titled “Python 实现”from openai import OpenAI
client = OpenAI()
def hyde_retrieve(query: str, retriever, top_k: int = 5): """HyDE:生成假设文档后检索""" prompt = f"""Please write a short passage (3-5 sentences) that answers the following question.Do not add any preamble or meta-commentary. Write only the passage.
Question: {query}"""
response = client.chat.completions.create( model="gpt-4o-mini", messages=[{"role": "user", "content": prompt}], temperature=0.7, ) hypothetical_doc = response.choices[0].message.content
# 用假答案(而非原始查询)做 Embedding 检索 results = retriever.dense_search(hypothetical_doc, top_k=top_k) return results, hypothetical_doc
def sub_question_decompose(query: str) -> list[str]: """子问题分解""" prompt = f"""Break down the following complex question into 2-4 simpler sub-questions.Return one sub-question per line, without numbering.
Question: {query}"""
response = client.chat.completions.create( model="gpt-4o-mini", messages=[{"role": "user", "content": prompt}], temperature=0.3, ) sub_questions = response.choices[0].message.content.strip().split('\n') return [q.strip() for q in sub_questions if q.strip()]
def multi_query_retrieve(query: str, retriever, top_k: int = 5): """子问题分解 → 多路检索 → 合并去重""" sub_queries = sub_question_decompose(query) all_results = {}
for sq in sub_queries: results = retriever.hybrid_search(sq, top_k=top_k) for r in results: if r["doc_id"] not in all_results or r["rrf_score"] > all_results[r["doc_id"]]["rrf_score"]: all_results[r["doc_id"]] = r
return sorted(all_results.values(), key=lambda x: x["rrf_score"], reverse=True)[:top_k]Query Rewrite 详见更多 Prompt 工程技术见 Prompt 工程和 Context 工程。
高级 Chunk 策略
Section titled “高级 Chunk 策略”固定长度切片的局限
Section titled “固定长度切片的局限”朴素 RAG 使用固定长度(如 512 tokens)滑动窗口切片,简单但有以下问题:
- 语义截断:一句话可能在中间被切断,丢失上下文
- 结构丢失:Markdown 标题、代码块、表格被打散到不同 chunk
- 上下文不足:检索到的 chunk 可能缺少必要的上下文(如”它”指代什么)
语义分块(Semantic Chunking)
Section titled “语义分块(Semantic Chunking)”语义分块不按固定 token 数,而按语义连续性切分。核心思路是计算相邻句子的 Embedding 相似度,当相似度骤降(语义”跳跃”)时进行切分:
import numpy as np
def semantic_chunking(text: str, embed_fn,                      breakpoint_threshold: float = 0.5) -> list[str]:    """基于语义相似度的分块"""    # 1. 按句子分割    sentences = text.split('。')  # 中文按句号分    sentences = [s.strip() for s in sentences if s.strip()]
    # 2. 计算相邻句子的 Embedding 余弦距离    embeddings = np.array([embed_fn(s) for s in sentences])
    distances = []    for i in range(len(embeddings) - 1):        # 余弦距离 = 1 - 余弦相似度        cos_sim = np.dot(embeddings[i], embeddings[i + 1])        distances.append(1 - cos_sim)
    # 3. 根据距离分布确定断点    threshold = np.percentile(distances, int(breakpoint_threshold * 100))
    # 4. 在语义跳跃处切分    chunks = []    current_chunk = [sentences[0]]    for i, dist in enumerate(distances):        if dist > threshold:            chunks.append('。'.join(current_chunk))            current_chunk = [sentences[i + 1]]        else:            current_chunk.append(sentences[i + 1])    chunks.append('。'.join(current_chunk))
    return chunks
递归分块(Recursive Chunking)
Section titled “递归分块(Recursive Chunking)”LangChain 的默认策略:按分隔符优先级递归拆分。先尝试按最高级分隔符(如 \n\n 双换行 = 段落)拆分,如果 chunk 仍太大,再按下一级分隔符(如 \n 单换行 = 句子)拆分,直到每个 chunk 不超过目标长度:
def recursive_chunking(text: str, max_chunk_size: int = 512,                       separators: list[str] = None) -> list[str]:    """递归字符分块(LangChain RecursiveCharacterTextSplitter 简化版)"""    if separators is None:        separators = ["\n\n", "\n", "。", ",", " ", ""]
    # 尝试当前级别的分隔符    sep = separators[0]    if sep:        splits = text.split(sep)    else:        splits = list(text)  # 逐字符
    final_chunks = []    for split in splits:        if len(split) <= max_chunk_size:            final_chunks.append(split)        else:            # 递归用下一级分隔符            if len(separators) > 1:                final_chunks.extend(                    recursive_chunking(split, max_chunk_size, separators[1:])                )            else:                # 最后兜底:硬切                final_chunks.extend([                    split[i:i+max_chunk_size]                    for i in range(0, len(split), max_chunk_size)                ])
    # 合并过小的片段    merged = []    for chunk in final_chunks:        if merged and len(merged[-1]) + len(sep) + len(chunk) <= max_chunk_size:            merged[-1] = merged[-1] + sep + chunk        else:            merged.append(chunk)
    return merged
Parent-Child / Small-to-Big 策略
Section titled “Parent-Child / Small-to-Big 策略”核心问题:检索时小 chunk 精准匹配好,但给 LLM 的上下文太少;大 chunk 上下文丰富,但检索精度低。
解法:检索时用小 chunk(精确匹配),生成时替换为其父 chunk(提供完整上下文):
上下文扩展(Context Expansion):一种类似策略是检索到某个 chunk 后,自动将其前后各 个 chunk 一并包含(称为 “sibling” 或 “window” chunk),确保上下文连续性。LlamaIndex 的
SentenceWindowNodeParser实现了这一方案。
Metadata Filter:元数据过滤
Section titled “Metadata Filter:元数据过滤”在真实应用中,用户常常隐含了过滤条件——如”2024 年的论文”、“Python 语言的教程”、“来自官方文档的答案”。Metadata Filter 在检索前先按元数据缩小范围,再做语义匹配:
from dataclasses import dataclassfrom typing import Optional
@dataclassclass Document:    content: str    metadata: dict  # {"source": "docs", "year": 2024, "language": "python", "category": "tutorial"}
class FilteredRetriever:    """支持元数据过滤的检索器"""
    def __init__(self, documents: list[Document], embed_fn):        self.documents = documents        self.embed_fn = embed_fn        self.embeddings = [embed_fn(doc.content) for doc in documents]
    def retrieve(self, query: str,                 filters: Optional[dict] = None,                 top_k: int = 5) -> list[Document]:        """        Args:            query: 查询文本            filters: 元数据过滤条件,如 {"year": 2024, "source": "docs"}                     支持 {"field": {"$gte": value}} 等操作符        """        query_emb = self.embed_fn(query)
        candidates = []        for doc, emb in zip(self.documents, self.embeddings):            # 元数据过滤            if filters and not self._match_filters(doc.metadata, filters):                continue            # 语义相似度            score = self._cosine_sim(query_emb, emb)            candidates.append((score, doc))
        # 排序取 Top-K        candidates.sort(key=lambda x: x[0], reverse=True)        return [doc for _, doc in candidates[:top_k]]
    def _match_filters(self, metadata: dict, filters: dict) -> bool:        """检查元数据是否满足过滤条件"""        for key, condition in filters.items():            if isinstance(condition, dict):                # 操作符条件:{"$gte": 2024}, {"$in": ["python", "java"]}                val = metadata.get(key)                for op, target in condition.items():                    if op == "$gte" and not (val is not None and val >= target):                        return False                    elif op == "$lte" and not (val is not None and val <= target):                        return False                    elif op == "$in" and val not in target:                        return False                    elif op == "$ne" and val == target:                        return False            else:                # 精确匹配                if metadata.get(key) != condition:                    return False        return True
    @staticmethod    def _cosine_sim(a, b) -> float:        return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))
# 使用示例# retriever = FilteredRetriever(documents, embed_fn)# results = retriever.retrieve(#     "如何使用装饰器",#     filters={"language": "python", "year": {"$gte": 2024}},#     top_k=5# )
Metadata Filter 通常与 Hybrid Search 结合使用:先按元数据缩小候选集,再做 Dense + Sparse 混合检索。多数向量数据库(Milvus、Qdrant、Pinecone)原生支持这种组合查询。详见 向量数据库。
Reranking:重排序
Section titled “Reranking:重排序”初步检索(Hybrid Search)通常返回 Top-2050 个候选,但其中质量参差不齐。Reranking 用一个更精确(但更慢)的模型对候选重新打分,挑出最相关的 Top-35。
Cross-Encoder vs Bi-Encoder
Section titled “Cross-Encoder vs Bi-Encoder”检索阶段和精排阶段使用的模型架构不同:
Bi-Encoder 分别编码 Query 和 Document,然后计算相似度——可以离线预计算文档向量,检索速度快。Cross-Encoder 将 Query 和 Document 拼接后一起输入 Transformer,模型能捕获两者之间的深层交互——精度高但无法预计算,每个候选都要前向传播一次。
详见 重排序和 Embedding 模型。
RAG 评估:RAGAS 框架
Section titled “RAG 评估:RAGAS 框架”为什么需要 RAG 评估?
Section titled “为什么需要 RAG 评估?”RAG 系统的失败模式多样:检索不到正确文档、检索到了但 LLM 忽略了、LLM 编造了文档中没有的内容(幻觉)等。RAGAS(Retrieval-Augmented Generation Assessment) 是一个专门针对 RAG 的评估框架,从多个维度衡量系统质量。
核心评估指标
Section titled “核心评估指标”RAGAS 定义了三个核心指标,无需人工标注的参考答案:
1. Faithfulness(忠实度)——生成的答案是否忠实于检索到的文档(不编造):
将 LLM 生成的答案拆解为原子陈述(atomic statements),逐条检查是否能在检索文档中找到支持。如果 5 条陈述中有 4 条有文档支持,Faithfulness = 0.8。低 Faithfulness 意味着幻觉严重。
2. Answer Relevancy(答案相关性)——生成的答案是否切题(回答了用户问的问题):
其中 是从生成的答案反向生成的”这个问题可能对应什么提问”, 是原始提问。直觉:好的答案应该让人能反推出原始问题——如果答案跑题了,反推出的问题和原始问题相似度就低。
3. Context Precision(上下文精确率)——检索到的文档中,有多少真正相关:
4. Context Recall(上下文召回率)——回答问题所需的信息,有多少被检索到了:
RAGAS Python 实现
Section titled “RAGAS Python 实现”from ragas import evaluatefrom ragas.metrics import ( faithfulness, answer_relevancy, context_precision, context_recall,)from datasets import Dataset
# 准备评估数据eval_data = { "question": [ "BatchNorm 和 LayerNorm 的区别是什么?", "如何用 PyTorch 实现多头注意力?", ], "answer": [ # RAG 系统生成的答案 "BatchNorm 对 batch 维度归一化,LayerNorm 对特征维度归一化。" "BatchNorm 依赖 batch 统计量,推理时需要 running mean/var;" "LayerNorm 不依赖 batch 统计量,适合变长序列。", "实现多头注意力需要定义 W_qkv 投影矩阵,..." ], "contexts": [ # 检索到的文档(列表) ["BatchNorm 在 batch 维度上计算均值和方差...", "LayerNorm 在特征维度上计算均值和方差..."], ["Multi-Head Attention 首先将 Q/K/V 分成 h 组...", "每组独立做 Scaled Dot-Product Attention..."], ], "ground_truth": [ # 参考答案(可选,用于 Context Recall) "BatchNorm 沿 batch 维度归一化每个特征通道," "需要 running statistics,适合 CNN;" "LayerNorm 沿特征维度归一化每个样本," "不依赖 batch,适合 NLP/Transformer。", "(参考答案...)" ],}
dataset = Dataset.from_dict(eval_data)
# 运行 RAGAS 评估results = evaluate( dataset, metrics=[ faithfulness, answer_relevancy, context_precision, context_recall, ],)
print(results)# 输出示例:# {'faithfulness': 0.85, 'answer_relevancy': 0.92,# 'context_precision': 0.78, 'context_recall': 0.88}RAGAS 使用 LLM-as-a-Judge 来计算这些指标(即用一个强模型如 GPT-4 来评估答案质量),因此评估本身也有成本。更多 LLM 评估方法见 LLM 评估。
端到端 RAG 优化检查清单
Section titled “端到端 RAG 优化检查清单”| 问题症状 | 可能原因 | 优化方向 |
|---|---|---|
| 检索不到相关文档 | 仅用 Dense,缺少关键词匹配 | 加 Hybrid Search(Dense + BM25) |
| 检索到但答案不对 | 检索文档不够精确 / LLM 幻觉 | 加 Reranking(Cross-Encoder) |
| 用户术语与文档不匹配 | 查询和文档语义空间不匹配 | 用 HyDE 或 Query Expansion |
| 答案缺少上下文 | Chunk 太小或语义截断 | 用 Parent-Child 或上下文扩展 |
| 检索结果跨领域混杂 | 缺少过滤条件 | 加 Metadata Filter |
| 复杂多跳问题回答差 | 单次检索信息不足 | 用 Sub-question Decomposition |
| 答案编造文档外的内容 | 缺少约束 | 检查 Faithfulness,加 Prompt 约束 |
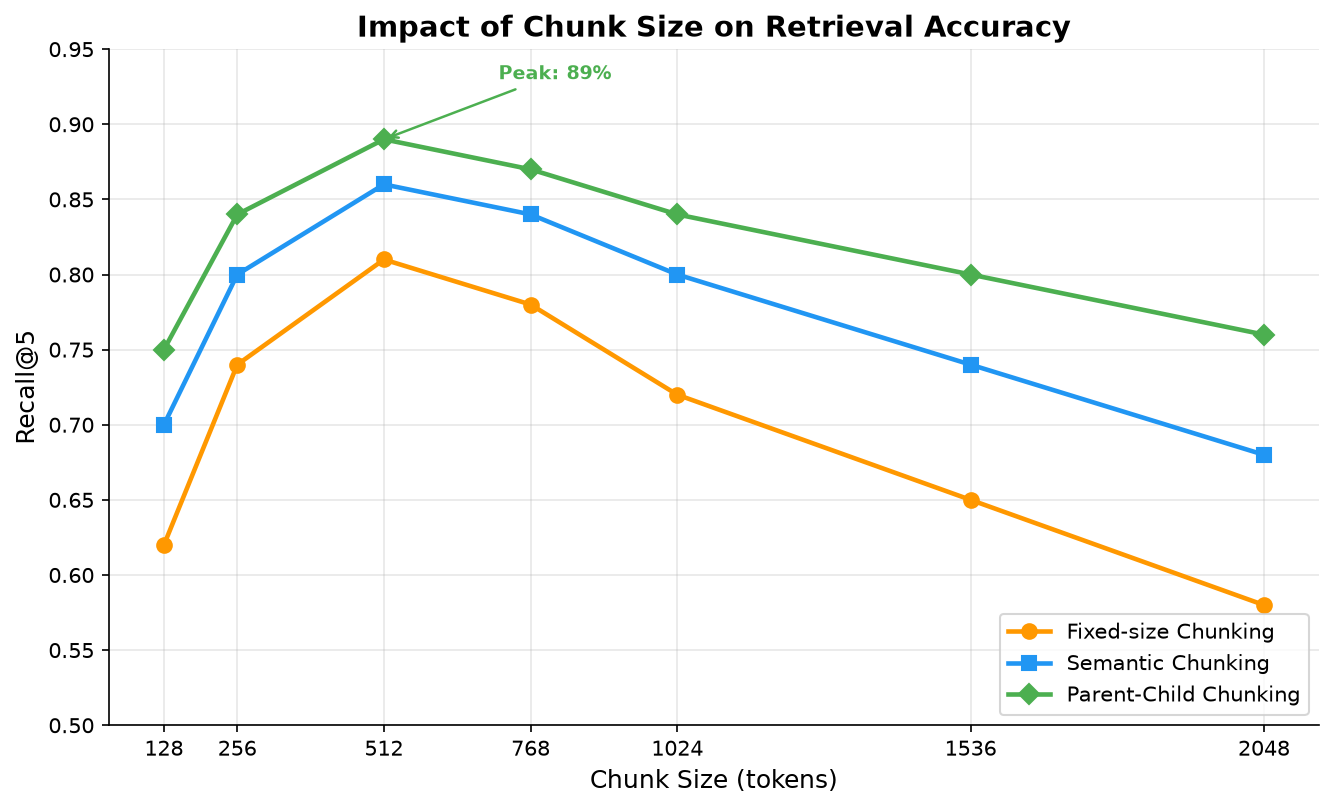
Chunk 大小经验值
Section titled “Chunk 大小经验值”| 文档类型 | 推荐 Chunk 大小 | Overlap | 原因 |
|---|---|---|---|
| 技术文档 / 教程 | 400-600 tokens | 50-100 | 段落完整,保留代码块 |
| FAQ / 知识库 | 200-300 tokens | 0 | 每条 QA 天然独立 |
| 长篇论文 | 500-800 tokens | 100-200 | 学术段落较长 |
| 代码仓库 | 按函数/类分割 | 0 | 函数是语义完整单元 |
| 对话记录 | 按轮次/主题 | 0 | 自然语义边界 |
GraphRAG:知识图谱增强检索
Section titled “GraphRAG:知识图谱增强检索”Microsoft 于 2024 年提出 GraphRAG,将知识图谱引入 RAG。传统向量检索只能找到局部相似的文档片段,难以回答需要跨文档全局推理的问题(如”整个数据集的主要主题是什么?”)。GraphRAG 先用 LLM 从文档中抽取实体和关系构建知识图谱,检索时同时在图谱和向量库中搜索,显著提升了全局推理能力。详见 GraphRAG。
Agentic RAG(2024-2025)
Section titled “Agentic RAG(2024-2025)”Agentic RAG 将 Agent 架构引入检索过程——LLM 不再被动地接收检索结果,而是主动决定何时检索、检索什么、是否需要多轮检索:
- Self-RAG(2023):LLM 自主判断是否需要检索,并在生成后自我评估答案是否需要修正。
- CRAG(Corrective RAG):检索后自动评估结果质量,低质量时触发 Web 搜索作为补充。
- Adaptive RAG(2024):根据查询复杂度动态选择检索策略——简单查询用单次检索,复杂查询用多跳检索。
详见 Agent 架构模式。
Late Interaction 模型:ColBERT v2
Section titled “Late Interaction 模型:ColBERT v2”ColBERT 提出了一种介于 Bi-Encoder 和 Cross-Encoder 之间的架构——Late Interaction(延迟交互)。它为每个 token(而非整篇文档)生成 Embedding,检索时计算 Query 的所有 token 与文档 token 之间的最大相似度之和(MaxSim):
这种方式兼顾了 Bi-Encoder 的可预计算性和 Cross-Encoder 的精度。ColBERT v2(ElasticSearch 原生支持)成为 2024-2025 年 RAG 检索的热门选择。
多模态 RAG(2024-2025)
Section titled “多模态 RAG(2024-2025)”传统 RAG 只处理文本。多模态 RAG(如 ColPali)直接对文档页面做视觉 Embedding(使用 VLM),无需 OCR 和文本提取——直接把 PDF 页面当作图像编码到向量空间。这种方式天然保留了表格、图表、公式等视觉信息,在技术文档检索中表现优异。详见 多模态 LLM。
Long-context vs RAG 的争论(2024-2025)
Section titled “Long-context vs RAG 的争论(2024-2025)”随着 LLM 上下文窗口扩展到 128K-2M tokens(GPT-4 Turbo、Gemini 1.5 Pro、Claude 3.5),一种观点认为”RAG 已死”——直接把所有文档塞进上下文即可。但研究表明:
- 成本效率:长上下文推理成本远高于 RAG 检索 + 短上下文生成
- 精度:LLM 在超长上下文中存在”lost in the middle”现象(中间位置信息容易被忽略),RAG + Reranking 的精确性更高
- 可更新性:知识库更新时 RAG 只需重新索引,长上下文需重新预处理全部文档
2025 年的共识:长上下文和 RAG 是互补而非替代关系。RAG 用于大规模知识库的精确检索,长上下文用于检索结果的多文档深度推理。“RAG + 长上下文”的混合方案是主流方向。
- Gao et al. “Retrieval-Augmented Generation for Large Language Models: A Survey” (2023)
- Asai et al. “Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection” (2023)
- Gao et al. “Precise Zero-Shot Dense Retrieval without Relevance Labels” (HyDE, 2022)
- Es et al. “RAGAS: Automated Evaluation of Retrieval Augmented Generation” (2023)
- Edge et al. “From Local to Global: A GraphRAG Approach to Query-Focused Summarization” (Microsoft, 2024)
- Santhanam et al. “ColBERTv2: Effective and Efficient Retrieval via Lightweight Late Interaction” (2022)
- Lewis et al. “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks” (Facebook AI, 2020)