
参数初始化策略
参数初始化决定了训练的起点——好的初始化让网络快速收敛,差的初始化可能导致梯度消失、梯度爆炸甚至完全无法训练。本页梳理从全零初始化到 Xavier、He、正交初始化的完整谱系,再到 2024-2026 年面向超大规模 LLM 的 μP、ZerO、Unit Scaling 等新方法,解释”为什么初始化如此重要”。前置阅读:反向传播详解、激活函数。
想象你把 100 个人排成一列传递口令(多层网络传递信号)。如果每个人都把声音放小到原来的一半(权重小于 1),传到最后一个人听到的声音几乎为零——信号消失了。如果每个人都放大两倍,最后一个人听到的就是爆炸的噪音——信号爆炸了。
参数初始化的任务就是让每一层的信号强度保持稳定:既不衰减也不放大,像一条精心调音的传输链路。
- 全零初始化(错误示范)= 所有人同时开始说同一句话。同一层所有神经元拿到相同的权重、算出相同的输出、得到相同的梯度、做出相同的更新——永远对称,永远学不到不同的特征。这叫”对称破缺失败”。
- 随机初始化(但方差太大)= 每个人音量随机忽大忽小。信号传着传着要么消失要么爆炸——层数越多越严重。
- Xavier 初始化= 根据输入维度调音量:输入越多,每个权重越小(因为信号是输入的加权和),保证方差稳定。专门为 sigmoid/tanh 设计。
- He 初始化= Xavier 的 ReLU 版。ReLU 会把一半信号截断为零,所以方差需要额外放大两倍来补偿。
什么是梯度(Gradient)? 梯度是损失函数对参数的偏导数向量,指向”让损失增大最快”的方向;训练时朝其反方向更新参数,从而逐步降低损失。梯度消失指梯度值逐层趋近 0,使深层参数几乎得不到更新;梯度爆炸指梯度值逐层放大,最终变成 NaN。
一个更精确的类比:为什么是”方差”而非”值”
Section titled “一个更精确的类比:为什么是”方差”而非”值””信号在网络中是以向量形式传播的。一个向量的”大小”由其各分量的方差(Variance,衡量随机变量偏离均值的平均程度的指标,记作 或 )刻画。初始化关心的是:经过每一层后,向量方差的缩放倍数 。
- 若每层 :方差不变,信号稳定传播——理想状态。
- 若每层 :经过 层后方差变为 。 时只剩 ——梯度消失。
- 若每层 :——梯度爆炸。
这就是为什么初始化公式总是试图让每层的方差缩放因子 尽可能接近 1。整个数学推导都是在计算”怎样的权重分布能让 ”。
为什么不能全零初始化
Section titled “为什么不能全零初始化”如果所有权重初始化为相同的值(包括全零),同一层的所有神经元在前向传播时输出完全相同,在反向传播时梯度也完全相同。结果它们永远做出相同的参数更新,永远保持对称——整个层等价于一个神经元,白白浪费了容量。这叫”对称破缺问题”(symmetry breaking problem)。偏置可以初始化为零(不影响对称性),但权重必须随机初始化。
用数学语言说明:设第 层权重矩阵 ,偏置 ,输入 ,激活函数 。前向传播为:
若 的每一行都相同(例如全零),则 的每一维都相同;反向传播中梯度 对所有 也相同,于是 SGD(Stochastic Gradient Descent,随机梯度下降,每次用小批量数据更新参数的训练算法)更新后权重仍然相同。对称永远无法被打破,这是必须随机初始化的根本原因。
形式化证明对称性保持:设第 层所有行相同,即 。前向传播 对所有 相同,故 对所有 相同。反向传播中 ,由于 不依赖 ,只需 相同。而 ,由于 和 对所有 相同(由归纳假设上一层也对称), 确实相同。SGD 更新 后,所有行仍相同。
偏置为何可以初始化为零? 因为偏置是加在每个神经元上的独立常数 。即使 ,只要权重随机不同,每个神经元就得到不同的前向输出 ,对称性已被打破。因此偏置的初始值不影响对称破缺。
信号传播视角:前向传播
Section titled “信号传播视角:前向传播”考虑全连接层 ,其中 ,。假设 的各分量独立同分布(i.i.d.),均值为 0、方差为 ; 各分量独立同分布,均值为 0、方差为 。那么线性部分 的方差为:
这里用到了独立性假设下方差的可加性:当 与 独立时 ,由于两者均值为 0,简化为 。
要让 (信号方差在每层保持不变),需要:
这就是最基本的直觉——权重的方差应与输入维度(fan-in)成反比。输入维度越大,每个权重就必须越小,才能让”加和中”的方差稳定。
信号传播视角:反向传播
Section titled “信号传播视角:反向传播”反向传播中,梯度信号从输出层向输入层传播。设损失对第 层预激活 的梯度为 ,则对第 层激活的梯度为:
展开每个分量:
同样假设 各分量独立同分布,均值为 0、方差为 ,则:
要让反向梯度方差稳定(),需要:
关键矛盾:前向传播要求 ,反向传播要求 。两者一般不相等(除非 ),需要折中——这就是 Xavier 初始化取调和平均的由来。
Xavier / Glorot 初始化
Section titled “Xavier / Glorot 初始化”Xavier 初始化(Glorot & Bengio, 2010)取前向与反向两个约束的调和平均作为折中:
为什么用调和平均而非算术平均? 调和平均 对较小值更敏感。当前向需要 、反向需要 时,调和平均 恰好满足 和 的倒数之和的倒数——这保证了前向方差缩放因子 和反向缩放因子 都在 区间内,对任意宽度比都可控。
实践中用均匀分布或正态分布实现:
| 分布 | 公式 |
|---|---|
| 均匀分布 | ,其中 |
| 正态分布 | ,其中 |
均匀分布的边界 来自均匀分布 方差为 的关系:令 ,解得 。
Xavier 初始化保证了信号在前向传播和反向传播中都能保持方差稳定,是 tanh 网络的标配。但对于 sigmoid 激活函数,由于其输出均值非 0 且容易进入饱和区(梯度接近 0),实际效果不如 tanh。
He / Kaiming 初始化
Section titled “He / Kaiming 初始化”ReLU 激活函数 把负值截断为零,相当于在概率上丢掉了一半信号。假设 是零均值对称分布,则经过 ReLU 后:
对于零均值、方差 的对称分布, 只保留正半部分:
因此:
实践中 He 等人(2015)采用简化:忽略均值项(因为 相对 较小),近似 。要补偿这个 因子,权重方差需要放大两倍:
实践中通常取前向稳定公式 (PyTorch 默认)。
完整推导:设 的方差为 。线性部分 的方差为 (如前节)。经过 ReLU 后 。令其等于 ,解得 。
正态分布实现:,其中 。
He 初始化是所有使用 ReLU 族激活函数(ReLU、Leaky ReLU、PReLU、ELU 等)的网络的标配。PyTorch 的 nn.Linear 默认用 Kaiming 均匀分布(实际上是 kaiming_uniform_ with ,等效于 He 方差的均匀版本)。
Leaky ReLU / PReLU 是什么? 它们是 ReLU 的变体:负区间不再是 0,而是一个小的斜率(Leaky ReLU 固定斜率 ,PReLU 让斜率可学习),避免 ReLU 的”死神经元”问题(某些神经元永久输出 0)。对 Leaky ReLU,He 初始化的方差修正因子变为 ,但实践中 通常很小(0.01),标准 He 初始化已经够用。
LeCun 初始化
Section titled “LeCun 初始化”用于 SELU 激活函数(Scaled Exponential Linear Unit,自归一化神经网络 Self-Normalizing NN 的核心激活),方差设为:
SELU 网络的特殊之处在于激活函数经过精心设计(含固定缩放常数 和 ),使信号自动保持均值 0、方差 1 的稳定传播,不需要 BatchNorm(Batch Normalization,批归一化,对每层输出做均值方差归一化的技术)。这使得 SELU 网络在无归一化层时也能训练很深。
SELU 的数学保证基于不动点定理(Fixed Point Theorem):存在均值-方差组合 作为映射 的吸引不动点,只要权重满足 ,任意层的激活分布都会收敛到 附近。
将权重矩阵初始化为正交矩阵,即 (单位矩阵)。正交变换保持向量范数不变:,因此信号在多层传播后范数既不放大也不缩小,特别适合 RNN(Recurrent Neural Network,循环神经网络,处理序列数据)和很深的网络。
为什么正交矩阵保持范数? 证明:
因此正交初始化能严格保证每层信号方差缩放因子 。
生成方法:从一个随机高斯矩阵出发,通过 QR 分解 ,取 (正交部分)作为初始化矩阵;或用 SVD 分解。再乘以一个可选的缩放因子 控制整体幅度。
import numpy as np
def orthogonal_init(shape, gain=1.0):    """生成正交初始化矩阵"""    flat_shape = (shape[0], int(np.prod(shape[1:])))    a = np.random.randn(*flat_shape)    q, r = np.linalg.qr(a)       # QR 分解    q *= np.sign(np.diag(r))     # 保证行列式为正    return gain * q.reshape(shape)
正交初始化的局限:当 时,正交矩阵退化为半正交矩阵( 或 ),范数保持性质只能在一个方向上成立。此外,深度非线性网络中,即使初始正交,训练过程中权重也会偏离正交性,正交性只在初始时刻严格成立。
偏置通常初始化为零(不影响对称破缺),但有重要例外:
- 门控单元中的遗忘门偏置(LSTM/GRU)初始化为 1,让遗忘门初始倾向于”记住”而非”遗忘”。Jozefowicz et al. (2015) 的实验表明,这是 LSTM 训练最关键的超参数之一。
- BatchNorm 的 beta 参数初始化为 0(第二个偏置项),gamma 初始化为 1。
- 当激活函数输出均值非零时(如 sigmoid),偏置可以初始化为使初始输出落在激活函数的线性区(即导数不为零的区域),避免梯度消失。对于 sigmoid ,线性区中心在 ,所以偏置初始化为 0 即可让初始输出在 0.5 附近。
- Transformer 中的 QKV bias:GPT-2 不使用偏置,BERT 的 Query/Key/Value 投影层有偏置并初始化为 0,Qwen 系列也保留 QKV bias 初始化为 0 以稳定注意力分布。
Embedding 层初始化
Section titled “Embedding 层初始化”NLP(Natural Language Processing,自然语言处理)中的 Embedding 层(词向量层)通常用 或 Xavier 初始化。Transformer 中的特殊技巧:
- Word2Vec:用均匀分布 , 为嵌入维度。
- BERT / GPT:用正态分布 ,方差很小。
- GPT-2 的特殊处理:输出层的投影矩阵(共享 Embedding 权重时)会额外除以 ,等效于缩小初始 logit 方差,使初始 softmax 分布接近均匀分布。
为什么 BERT 用 0.02 这么小的方差?因为 Transformer 多层叠加时,方差会沿层放大;初始方差小一点,给前向/反向传播留出”放大空间”,配合 LayerNorm 共同稳定训练。
深入理解:Edge of Chaos 理论
Section titled “深入理解:Edge of Chaos 理论”Poole et al. (2016) 提出了用动态系统理论(Dynamical Systems Theory)分析初始化的框架。核心概念是”混沌边缘”(Edge of Chaos):对于深度网络,信号传播的方差演化可以用一个迭代映射描述:
其中 是第 层激活的方差, 是激活函数, 是权重方差, 表示对标准正态分布的积分。这个映射有一个不动点 ,当权重方差 较小时 (梯度消失),较大时 (梯度爆炸),恰好处于临界值时信号能稳定传播——这就是”混沌边缘”。
这个理论给出了一个超越 Xavier/He 的视角:初始化质量不仅取决于方差缩放,还取决于激活函数的非线性特征。例如,tanh 的混沌边缘比 sigmoid 更宽,这也是 tanh 比 sigmoid 更容易训练的深层原因。
初始化方法选择
Section titled “初始化方法选择”初始化对信号传播的影响
Section titled “初始化对信号传播的影响”方差缩放因子的指数效应
Section titled “方差缩放因子的指数效应”PyTorch 中使用各种初始化
Section titled “PyTorch 中使用各种初始化”import torch.nn as nnimport torch.nn.init as init
class MyNet(nn.Module): def __init__(self): super().__init__() self.fc1 = nn.Linear(784, 256) self.fc2 = nn.Linear(256, 10) self._initialize_weights()
def _initialize_weights(self): # He 正态初始化(ReLU 网络首选) init.kaiming_normal_(self.fc1.weight, mode='fan_in', nonlinearity='relu') init.zeros_(self.fc1.bias) # 偏置归零 # Xavier 均匀初始化(输出层,接 softmax) init.xavier_uniform_(self.fc2.weight) init.zeros_(self.fc2.bias)
model = MyNet()print(model.fc1.weight.std().item()) # ≈ sqrt(2/784) ≈ 0.05mode=‘fan_in’ 是什么意思? 指用输入维度 作为分母(前向稳定),适合隐藏层;
mode='fan_out'用输出维度,适合反向稳定。PyTorch 默认 fan_in,符合 He 论文的推荐。
CNN 卷积层的初始化
Section titled “CNN 卷积层的初始化”卷积层的 是 in_channels × kernel_height × kernel_width,PyTorch 会自动计算:
conv = nn.Conv2d(3, 64, kernel_size=3, padding=1)init.kaiming_normal_(conv.weight, mode='fan_out', nonlinearity='relu')init.zeros_(conv.bias)# 验证方差print(conv.weight.std().item()) # ≈ sqrt(2 / (64 * 3 * 3 * 3)) ≈ 0.030Embedding 层初始化(Transformer 风格)
Section titled “Embedding 层初始化(Transformer 风格)”import torchimport torch.nn as nn
vocab_size, d_model = 50000, 512embedding = nn.Embedding(vocab_size, d_model)
# GPT/BERT 风格:N(0, 0.02)nn.init.normal_(embedding.weight, mean=0.0, std=0.02)
# 或用 Xaviernn.init.xavier_uniform_(embedding.weight)通用权重初始化函数
Section titled “通用权重初始化函数”以下是一个适用于大多数网络的自定义初始化函数,封装了”根据层类型自动选择策略”的逻辑:
import torch.nn as nnimport torch.nn.init as init
def initialize_model(model: nn.Module, init_type: str = "he"):    """对模型中不同类型的层应用合适的初始化。
    Args:        model: 要初始化的 PyTorch 模型        init_type: "he"(ReLU 族)、"xavier"(tanh/sigmoid)、"lecun"(SELU)    """    for m in model.modules():        if isinstance(m, (nn.Linear, nn.Conv2d, nn.ConvTranspose2d)):            if init_type == "he":                init.kaiming_normal_(m.weight, mode="fan_in", nonlinearity="relu")            elif init_type == "xavier":                init.xavier_normal_(m.weight)            elif init_type == "lecun":                init.normal_(m.weight, std=(1.0 / m.weight.size(1)) ** 0.5)            if m.bias is not None:                init.zeros_(m.bias)        elif isinstance(m, (nn.BatchNorm2d, nn.LayerNorm, nn.GroupNorm)):            if m.weight is not None:                init.ones_(m.weight)       # gamma = 1            if m.bias is not None:                init.zeros_(m.bias)        # beta = 0        elif isinstance(m, nn.Embedding):            init.normal_(m.weight, std=0.02)        elif isinstance(m, (nn.LSTM, nn.GRU)):            for name, param in m.named_parameters():                if "weight" in name:                    init.orthogonal_(param)                elif "bias" in name:                    init.zeros_(param)                    # 遗忘门偏置设为 1(LSTM 的 bias_ih 和 bias_hh 各有 3*hidden_size 个偏置)                    if isinstance(m, nn.LSTM):                        hidden = m.hidden_size                        param.data[hidden:2 * hidden].fill_(1.0)
numpy 直观对比不同初始化的信号传播
Section titled “numpy 直观对比不同初始化的信号传播”import numpy as np
def forward_signal(init_fn, n_layers=50, dim=512): """模拟信号经多层网络传播,观察方差变化""" x = np.random.randn(dim) # 输入,方差=1 variances = [x.var()] for _ in range(n_layers): W = init_fn(dim, dim) # 生成权重矩阵 x = np.maximum(0, W @ x) # ReLU 激活 variances.append(x.var()) return variances
# 对比三种初始化he = lambda n_in, n_out: np.random.randn(n_out, n_in) * np.sqrt(2. / n_in)too_small = lambda n_in, n_out: np.random.randn(n_out, n_in) * 0.01too_large = lambda n_in, n_out: np.random.randn(n_out, n_in) * 2.0
for name, fn in [("He(正确)", he), ("太小(0.01)", too_small), ("太大(2.0)", too_large)]: v = forward_signal(fn, n_layers=50) print(f"{name}: 第1层={v[0]:.2f}, 第10层={v[9]:.4f}, 第50层={v[-1]:.4e}")# He(正确): 1.00 → 0.98 → 0.95(基本稳定)# 太小(0.01): 1.00 → 0.05 → 1e-25(梯度消失,几乎为零)# 太大(2.0): 1.00 → 2e3 → inf(梯度爆炸,溢出为无穷)验证 Xavier 和 He 的方差稳定性
Section titled “验证 Xavier 和 He 的方差稳定性”import numpy as np
def check_variance_stability(init_fn, activation, n_layers=50, dim=512, trials=10): """多次试验取平均,验证初始化方法的方差稳定性""" all_final_vars = [] for _ in range(trials): x = np.random.randn(dim) for _ in range(n_layers): W = init_fn(dim, dim) z = W @ x x = activation(z) all_final_vars.append(x.var()) mean_var = np.mean(all_final_vars) std_var = np.std(all_final_vars) return mean_var, std_var
xavier = lambda n_in, n_out: np.random.randn(n_out, n_in) * np.sqrt(2.0 / (n_in + n_out))he = lambda n_in, n_out: np.random.randn(n_out, n_in) * np.sqrt(2.0 / n_in)tanh_act = lambda z: np.tanh(z)relu_act = lambda z: np.maximum(0, z)
# Xavier + tanh:方差应稳定在 ~1mv, sv = check_variance_stability(xavier, tanh_act)print(f"Xavier + tanh: 最终方差 = {mv:.3f} ± {sv:.3f}")
# He + ReLU:方差应稳定在 ~1mv, sv = check_variance_stability(he, relu_act)print(f"He + ReLU: 最终方差 = {mv:.3f} ± {sv:.3f}")
# 错误搭配:Xavier + ReLU(方差会衰减)mv, sv = check_variance_stability(xavier, relu_act)print(f"Xavier + ReLU: 最终方差 = {mv:.3f} ± {sv:.3f} (应衰减!)")可视化不同初始化的方差传播
Section titled “可视化不同初始化的方差传播”import matplotlib.pyplot as plt
fig, axes = plt.subplots(1, 3, figsize=(15, 4))
for ax, (name, fn) in zip(axes, [ ("He (正确)", he), ("太小 (0.01)", too_small), ("太大 (2.0)", too_large)]): v = forward_signal(fn, n_layers=50) ax.plot(range(len(v)), v, 'o-') ax.set_yscale('log') ax.set_title(name) ax.set_xlabel("层数") ax.set_ylabel("方差 (log)") ax.axhline(1.0, color='green', linestyle='--', alpha=0.5, label="理想=1") ax.legend()
plt.tight_layout()plt.savefig("init_variance.png", dpi=100)# He 图:方差围绕 1.0 上下波动(理想)# 太小 图:方差指数衰减到 0(梯度消失)# 太大 图:方差指数爆炸到 inf(梯度爆炸)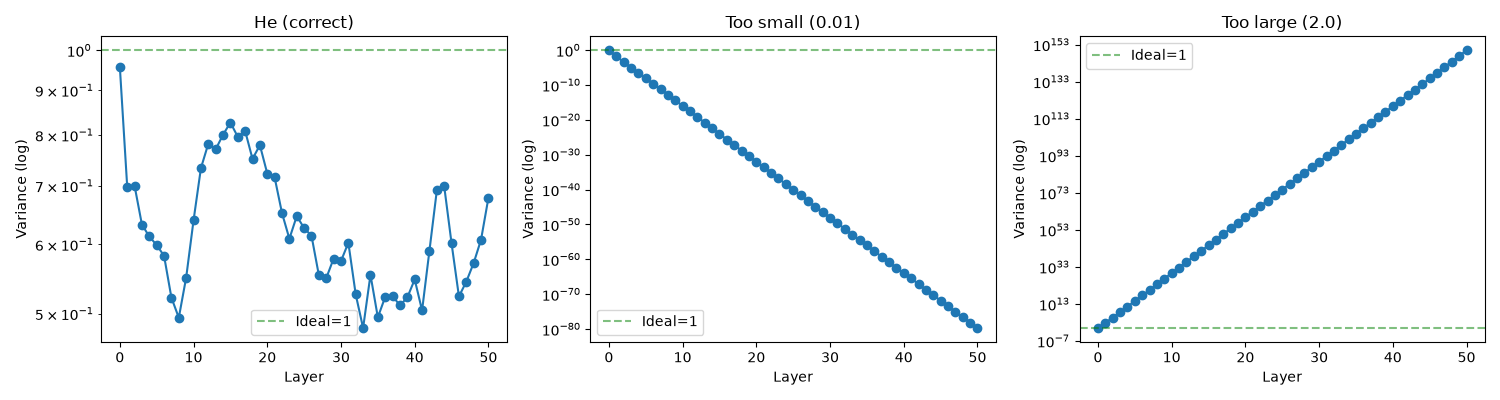
实际应用案例
Section titled “实际应用案例”案例 1:ResNet-50 为什么能训练 50+ 层?
Section titled “案例 1:ResNet-50 为什么能训练 50+ 层?”ResNet(残差网络)能训练到 152 层而 Deep 网络不能,除了残差连接(skip connection,绕过一层的直连)本身,初始化技巧也至关重要:
- He 初始化保证 ReLU 网络的方差稳定。
- 零 gamma 初始化:每个残差块的最后一个 BatchNorm 层的
gamma参数初始化为 0(而非默认的 1),使得残差分支初始输出为 0,整个残差块初始等价于恒等映射 。这意味着训练初始时网络就像一个浅层网络,随训练进行残差分支逐渐”激活”。 - 效果:不加零 gamma,50 层以上 ResNet 训练初期的 loss 会剧烈震荡甚至发散。
# ResNet 残差块的零 gamma 初始化import torch.nn as nnimport torch.nn.init as init
class BasicBlock(nn.Module):    def __init__(self, in_ch, out_ch):        super().__init__()        self.conv1 = nn.Conv2d(in_ch, out_ch, 3, padding=1, bias=False)        self.bn1   = nn.BatchNorm2d(out_ch)        self.conv2 = nn.Conv2d(out_ch, out_ch, 3, padding=1, bias=False)        self.bn2   = nn.BatchNorm2d(out_ch)   # 最后一个 BN        self.relu  = nn.ReLU(inplace=True)
    def _initialize(self):        init.kaiming_normal_(self.conv1.weight, mode='fan_out', nonlinearity='relu')        init.kaiming_normal_(self.conv2.weight, mode='fan_out', nonlinearity='relu')        init.ones_(self.bn1.weight)        init.zeros_(self.bn1.bias)        # ★ 关键:最后一个 BN 的 gamma 初始化为 0        init.zeros_(self.bn2.weight)        init.zeros_(self.bn2.bias)        # 初始时 bn2 输出恒为 0,残差分支 = 0,整个 block = 恒等映射
案例 2:GPT/BERT 的统一初始化
Section titled “案例 2:GPT/BERT 的统一初始化”GPT 和 BERT 系列几乎用 统一初始化所有权重(Embedding、Attention、FFN)。为什么统一用这么小的方差?
- Transformer 有 LayerNorm 在每层做归一化,但初始的前几次前向传播仍依赖合理的权重方差,否则 logit 会过大。
- 多头注意力的 softmax 对 logit 的尺度极其敏感——logit 过大时注意力会变成 one-hot(hard attention),梯度几乎不流通。
- 0.02 是一个经验性的”安全值”,配合 warmup(学习率预热)共同稳定训练。
数学分析:Transformer 注意力分数 。若 的各分量方差为 ,则 的方差为 ( 个独立乘积之和)。除以 后方差为 。当 时,注意力分数的方差约为 ,softmax 输出接近均匀分布——这是理想的初始状态。
案例 3:LSTM 遗忘门偏置 = 1 的威力
Section titled “案例 3:LSTM 遗忘门偏置 = 1 的威力”LSTM 有三个门(输入门、遗忘门、输出门)。遗忘门 决定保留多少历史记忆。若 ,初始遗忘门输出 ,网络倾向于遗忘;将 后,,倾向于保留长期信息。这一个小改动能让 LSTM 在长序列任务上的表现提升 10-30%。
案例 4:DeepSeek-V2/V3 的 MoE 路由初始化
Section titled “案例 4:DeepSeek-V2/V3 的 MoE 路由初始化”DeepSeek 系列采用 MoE(Mixture of Experts,混合专家)架构,其路由层(Router/Gating,决定每个 token 分配给哪个专家的小网络)需要特别小的初始化方差。如果路由权重方差过大,初始时 softmax 输出会非常不均匀——大量 token 涌向少数专家,造成”路由坍塌”(Routing Collapse,某些专家永远收不到 token,训练完全浪费)。
DeepSeek 的做法:路由权重用 而非 ,配合辅助无损负载均衡(Auxiliary-Loss-Free Load Balancing,不通过额外损失项而是通过调整偏置来均匀分配 token 到专家):
# MoE 路由层的安全初始化class MoERouter(nn.Module): def __init__(self, d_model, n_experts): super().__init__() self.gate = nn.Linear(d_model, n_experts, bias=False) # 路由权重用更小的方差,防止初始路由偏置 nn.init.normal_(self.gate.weight, mean=0.0, std=0.006) # 每个专家的偏置(可学习),用于负载均衡 self.bias = nn.Parameter(torch.zeros(n_experts))- ReLU 网络用 He,tanh 网络用 Xavier:这是最重要的规则。搞混了会导致收敛极慢或梯度异常。PyTorch 的
nn.Linear默认是 Kaiming 均匀(对 ReLU 基本够用),但手动指定更可靠。 - 偏置初始化为零:绝大多数情况偏置初始化为零即可。LSTM 的遗忘门偏置初始化为正数是一个值得记住的例外。
- BatchNorm / LayerNorm 减轻了对初始化的依赖:有了归一化层之后,网络对初始化变得鲁棒很多——因为每层输出都被归一化到均值零、方差一,初始化的方差偏差被自动矫正。但好的初始化仍然能加速早期收敛。
- Transformer 的初始化:GPT/BERT 用 初始化几乎所有权重(包括 Embedding、注意力权重、FFN 权重),配合 LayerNorm 使用。这种统一的较小方差是一种经验性的稳健选择。
- 迁移学习时冻结预训练权重:微调时不重新初始化预训练权重,只初始化新增的分类头(通常用 Xavier),否则会破坏预训练特征。
- 残差连接的初始化技巧:ResNet 将每个残差块的最后一个 BN 的 gamma 参数初始化为零,使残差分支初始输出为零(整个残差块初始等价于恒等映射),训练更稳定。
- Embedding 初始化后可微调:可以加载预训练的 Word2Vec / GloVe 向量作为 Embedding 初始值,比从头学习效果更好。
- 深层网络需要更谨慎:层数超过 50 时,建议结合 warmup 学习率(前几个 epoch 学习率从 0 线性增长),或使用 Fixup / ReZero 等无归一化初始化方案。
- 梯度检查(Gradient Check):训练前用
torch.autograd.gradcheck或手动检查各层梯度范数是否在合理范围( 到 ),可及早发现初始化问题。
- 所有从头训练的神经网络:选对初始化策略是训练成功的第一步。CNN、MLP 用 He,RNN 用 Xavier 或正交初始化。详见卷积神经网络、RNN。
- Transformer 预训练:GPT-2/3、BERT 统一用 初始化,配合 LayerNorm 保证深层 Transformer 训练稳定。详见Transformer 架构。
- ResNet 训练:He 初始化 + 残差连接的零 gamma 技巧,让上百层的网络也能稳定训练。详见卷积神经网络。
- LSTM 长序列建模:遗忘门偏置初始化为 1,让 LSTM 在训练初期倾向于保留长期记忆,避免梯度消失。详见RNN。
- 扩散模型 U-Net:时间嵌入层和卷积层分别初始化,保证多尺度特征传播稳定。详见扩散模型。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
torch.nn.init | Python | PyTorch 初始化模块:kaiming_normal_、xavier_uniform_、orthogonal_ 等 |
tf.keras.initializers | Python | TensorFlow / Keras 初始化器:GlorotNormal、HeNormal、RandomNormal 等 |
nn.init.calculate_gain | Python | PyTorch 工具函数,根据激活函数类型计算推荐增益值 |
flax.linen | Python | JAX/Flax 的初始化策略,支持方差缩放和 LecunNormal 等 |
mup | Python | μP(Maximal Update Parameterization)库,用于大模型超参迁移 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 对称破缺 | Symmetry Breaking | 随机初始化打破神经元间的对称性,使各神经元学到不同特征 |
| Xavier 初始化 | Xavier / Glorot Init | 方差为 的初始化,适合 tanh/sigmoid |
| He 初始化 | He / Kaiming Init | 方差为 的初始化,适合 ReLU 族激活函数 |
| LeCun 初始化 | LeCun Init | 方差为 的初始化,适合 SELU 激活函数 |
| 正交初始化 | Orthogonal Init | 权重矩阵初始化为正交矩阵,保持向量范数不变 |
| 方差缩放 | Variance Scaling | 根据输入/输出维度调整权重方差的通用初始化范式 |
| 增益 | Gain | 根据激活函数类型对方差做的缩放修正因子 |
| 零伽马初始化 | Zero Gamma Init | ResNet 中将最后一个 BN 的 gamma 初始化为零的技巧 |
| 线性区 | Linear Region | 激活函数导数近似为常数的区间,有利于梯度传播 |
| fan-in / fan-out | Fan-in / Fan-out | 权重矩阵的输入/输出维度,初始化方差公式的分母来源 |
| 恒等映射 | Identity Mapping | ,残差连接在零 gamma 初始化下的初始行为 |
| 混沌边缘 | Edge of Chaos | 信号方差在临界初始化下方差既不消失也不爆炸的状态 |
| 路由坍塌 | Routing Collapse | MoE 中 token 涌向少数专家,其余专家训练停滞的现象 |
- Glorot & Bengio,「Understanding the Difficulty of Training Deep Feedforward Neural Networks」(AISTATS 2010):Xavier 初始化论文,从信号传播视角分析初始化,深度学习训练优化的重要理论基础。
- He et al.,「Delving Deep into Rectifiers」(ICCV 2015):He 初始化论文,推导 ReLU 网络的最优初始化方差,ResNet 训练成功的关键之一。
- LeCun et al.,「Efficient BackProp」(1998):经典反向传播指南,提出 LeCun 初始化,系统分析了初始化、归一化对训练的影响。
- Saxe et al.,「Exact Solutions to the Nonlinear Dynamics of Learning in Deep Linear Neural Networks」(ICLR 2014):从动态系统视角分析正交初始化在深层网络中的优势。
- Mishkin & Matas,「All You Need Is a Good Init」(ICLR 2016):提出 Layer-Sequential Unit-Variance (LSUV) 初始化,一种数据驱动的自适应初始化方法。
- Poole et al.,「Exponential Expressivity in Deep Neural Networks Through Transient Chaos」(NeurIPS 2016):Edge of Chaos 理论,用动态系统框架分析初始化与信号传播。
- Yang et al.,「Tensor Programs V: Tuning Large Neural Networks via Zero-Shot Hyperparameter Transfer」(2022):μP 论文,为大模型训练提供了初始化+学习率规模化的完整理论框架。
2024-2026 最新进展
Section titled “2024-2026 最新进展”说明:以下内容基于笔者截至 2025 年的知识。部分 2026 年论文可能尚未公开发布,请以最新 arXiv 为准。
1. μP(Maximal Update Parameterization):让小模型的超参直接迁移到大模型
Section titled “1. μP(Maximal Update Parameterization):让小模型的超参直接迁移到大模型”背景问题:当模型从 1 亿参数扩展到千亿参数时,最优初始化方差、学习率、残差缩放因子等超参数都会变化。传统做法是每次手动调参或用预测公式(如 ),但误差大且不可靠。
μP 的核心思想:Greg Yang 等人在”Tensor Programs”系列论文中提出,通过精心设计的参数化(Parameterization,指参数如何随宽度缩放的规则),使得小模型上调好的最优学习率和初始化可以直接迁移到大模型上,称为”zero-shot hyperparameter transfer”。
μP 的关键规则(针对宽度 的网络):
这看起来简单,但与”所有层用相同学习率”的朴素做法在训练动态上有本质区别:μP 保证了每一层的激活值更新幅度 在宽度变化时保持不变,从而训练曲线可预测。
实践影响:μP 已被多个开源 LLM 训练框架(如 Mistral、部分 LLaMA 系)采纳,是”先在小模型上 sweep 超参,再大规模训练”工作流的理论基础。
# μP 的简化实现示意(真实库更复杂,处理了 attention scaling 等)import torch.nn as nnimport torch.nn.init as init
def mup_init(layer: nn.Linear, width: int, is_output: bool = False):    """μP 风格初始化"""    n_in, n_out = layer.weight.shape    if is_output:        # 输出层:方差 ∝ 1/width^2(更小)        init.normal_(layer.weight, std=1.0 / width)    else:        # 隐藏层:标准 1/n_in 方差        init.normal_(layer.weight, std=(1.0 / n_in) ** 0.5)    init.zeros_(layer.bias)
2. Fixup / T-Fixup / ReZero:不用 BatchNorm 也能训练极深网络
Section titled “2. Fixup / T-Fixup / ReZero:不用 BatchNorm 也能训练极深网络”Fixup(2019):Zhang et al. 提出,通过精心设计的缩放因子(类似零 gamma),让 ResNet 在完全没有归一化层的情况下训练 100+ 层。初始化时残差分支乘以 ( 为层数),保证总方差不变。
T-Fixup(2019):将 Fixup 思想迁移到 Transformer,提出:
- 权重用 Xavier 初始化后再乘以 ( 为 Transformer 层数)。
- 移除 LayerNorm 和 warmup,训练速度反而更快。
ReZero(2021):Bachlechner et al. 提出,在每个残差分支加一个可学习的标量 ,初始为 0:
初始时 ,整个网络等价于恒等映射;训练中 逐渐增长,残差分支”激活”。这个极简方案让 10000 层的 Transformer 都能收敛,是对”零 gamma”思想的极致推广。
3. ZerO Initialization:用 Hadamard 变换替代随机初始化
Section titled “3. ZerO Initialization:用 Hadamard 变换替代随机初始化”ZerO(2023,Huang et al.) 提出了一种确定性初始化方案,完全不用随机数,而是用 Walsh-Hadamard 变换矩阵(一种正交矩阵的离散版本)初始化权重。
核心洞察:随机初始化的真正作用是保证信号的正向/反向传播稳定,而正交矩阵(如 Hadamard)恰好满足范数保持性质,且是确定性的、可复现的。实验显示 ZerO 初始化在 Vision Transformer、MLP 上都能与 He/Xavier 媲美,且训练初期收敛更平稳。
其中 是 阶 Walsh-Hadamard 矩阵()。
Hadamard 矩阵是什么? 元素只有 的正交方阵,构造上可递归生成(Sylvester 构造法)。它在信号处理中用于快速变换,在深度学习中因其确定性正交性质成为初始化的新工具。
4. Unit Scaling:面向 FP8 / 低精度训练的初始化
Section titled “4. Unit Scaling:面向 FP8 / 低精度训练的初始化”Unit Scaling(2022-2023,Blake et al.) 针对 FP8(8 位浮点数)训练场景提出:在低精度下,初始化不仅要保证方差稳定在 1,还要让每层的中间激活值、梯度、权重更新的数值范围都恰好落在 FP8 的可表示区间(动态范围极窄)。
核心做法是给每个操作(矩阵乘、激活、softmax)引入缩放因子,使信号在网络各处保持单位方差:
# Unit Scaling 思想示意:每层乘缩放因子class UnitScaledLinear(nn.Module):    def __init__(self, in_features, out_features):        super().__init__()        self.weight = nn.Parameter(torch.empty(out_features, in_features))        nn.init.normal_(self.weight, std=(1.0 / in_features) ** 0.5)        # 前向缩放:保证输出方差为 1        self.scale = 1.0 / (in_features ** 0.5)
    def forward(self, x):        return (x @ self.weight.t()) * self.scale
Unit Scaling 让 FP8 训练无需昂贵的 loss scaling(损失缩放,手动放大梯度避免下溢的技术),对大模型训练成本有实质性影响。
5. DeepNorm:训练极深 Transformer 的归一化+初始化协同
Section titled “5. DeepNorm:训练极深 Transformer 的归一化+初始化协同”DeepNorm(Wang et al., 2022,微软) 提出了一种修改 LayerNorm 公式的方法,使 Transformer 可以训练到 1000 层:
其中 是一个大于 1 的常数。初始化时,残差分支中的权重用 Xavier 初始化后额外乘以 ( 为层数, 为 Transformer block 数),使得初始时残差路径占主导地位。DeepNorm 已被用于训练 32 亿参数的 DeepNet 等模型。
6. 大模型实战初始化经验(LLaMA / DeepSeek / Qwen 系列)
Section titled “6. 大模型实战初始化经验(LLaMA / DeepSeek / Qwen 系列)”2023-2025 年间,主流开源 LLM 的初始化策略趋同,但有一些关键差异值得注意:
| 模型 | Embedding | 注意力权重 | FFN 权重 | 特殊技巧 |
|---|---|---|---|---|
| LLaMA 2/3 | RMSNorm 代替 LayerNorm | |||
| DeepSeek-V2/V3 | (MoE 专家) | MoE 路由层用更小方差避免初始路由偏置 | ||
| Qwen 2/2.5 | QKV bias 初始化为 0 | |||
| Mistral | μP 调参 | μP 调参 | μP 调参 | 用 μP 在小模型上扫超参 |
关键趋势:
- RMSNorm 取代 LayerNorm:RMSNorm(Root Mean Square Normalization)去掉均值归一化,只按 RMS 归一化,计算更快,且对初始化更不敏感,已成为 LLM 的标配。
- MoE(Mixture of Experts,混合专家)路由层需要特别小心的初始化:路由权重(决定每个 token 分配给哪个专家的网络)用更小的方差(如 0.006),避免初始时大量 token 涌向同一专家(路由坍塌 routing collapse)。
- 缩放注意力输出的初始化:部分模型将注意力输出投影层的权重初始化方差额外乘以 ,补偿多头拼接后的维度放大。
7. 自动化初始化搜索与元学习
Section titled “7. 自动化初始化搜索与元学习”2024 年的研究趋势是用元学习(Meta-Learning,让模型学习如何学习)或神经架构搜索(NAS)自动寻找最优初始化。代表工作:
- Learn2Init:用一个小的”初始化网络”根据架构描述动态生成初始权重,而非用固定公式。
- GradInit / GradNorm:通过优化一个”初始化目标”(如最小化首步训练 loss 的方差)来学习最优初始化方差。
这些方法目前在中等规模模型上有效,大规模 LLM 上仍以经验性方案( + μP)为主。
小结:2024-2026 的趋势
Section titled “小结:2024-2026 的趋势”| 趋势 | 代表方法 | 核心动机 |
|---|---|---|
| 超参可迁移 | μP | 小模型调参直接用于大模型 |
| 无归一化训练 | Fixup / ReZero / DeepNorm | 去掉或改造 BatchNorm/LayerNorm,训练更深网络 |
| 确定性初始化 | ZerO | 用 Hadamard 变换替代随机数 |
| 低精度友好 | Unit Scaling | 适配 FP8 / INT8 训练 |
| MoE 稳定初始化 | DeepSeek / Qwen 路由层技巧 | 防止路由坍塌 |
| 自动化搜索 | GradInit / Learn2Init | 用元学习找最优初始化 |
一句话总结:经典初始化(He/Xavier)解决的是”信号传播稳定”,而 2024-2026 的前沿工作解决的是”超参可迁移、低精度训练、MoE 稳定性、架构去归一化”这些大模型时代的新问题。理解经典方法是理解新方法的基础。
最新进展(2025-2026)
Section titled “最新进展(2025-2026)”以下内容聚焦 2025 年初至 2026 年发表或成为主流的初始化相关进展,是对上文”2024-2026 最新进展”的补充和延伸。
8. 量化感知初始化(Quantization-Aware Initialization)
Section titled “8. 量化感知初始化(Quantization-Aware Initialization)”随着大模型推理全面转向 FP8 / INT4 甚至 INT2 量化(Quantization,将高精度浮点数压缩为低精度整数以降低显存和加速推理),研究者发现传统的 初始化在量化后性能严重下降——因为低精度量化会将接近 0 的小权重舍入为零,导致有效参数大幅减少。
2025 年的代表工作包括:
- Q-Init(Quantization-aware Initialization):在初始化时就考虑量化误差。核心思想是将初始化分布”展开”到量化网格上,确保每个权重值至少有一个非零的量化表示。具体做法是在标准初始化后,做一次模拟量化-反量化(fake quantization),让初始权重落在量化网格的有效点上:
- SpinQuant 系列:通过学习一个旋转矩阵 (正交矩阵),使 在量化后保留更多信息。初始化时先做标准初始化,再施加旋转变换。
量化为什么影响初始化? 假设权重服从 ,标准差仅 0.02,绝大多数权重的绝对值 。如果用 INT8 量化且权重范围映射到 ,量化步长约为 ,那么 的权重全部被舍入为零。经测算,标准初始化的 BERT 权重在 INT8 量化后约 30-40% 变为零。
9. μP 的工业级落地与扩展
Section titled “9. μP 的工业级落地与扩展”2025 年,μP 理论在工业实践中得到进一步验证和扩展:
- mup-transfer 库成熟:HuggingFace 等平台开始原生支持 μP 超参迁移工作流。典型流程:在 100M-500M 参数的小模型上 grid search 学习率和初始化方差,找到最优组合后直接应用于 70B+ 参数模型,节省大量 GPU 调参时间。
- Tensor Programs VI(2024-2025):Greg Yang 将 μP 理论扩展到注意力的序列长度维度和 MoE 架构。新理论表明,当序列长度 增长时,注意力层的初始化方差需要额外缩放 ,否则 attention score 的方差会随序列长度爆炸。
10. 超长上下文模型的初始化策略
Section titled “10. 超长上下文模型的初始化策略”2024-2025 年间,LLM 的上下文窗口从 4K 扩展到 1M+(如 Gemini 1.5、Llama 3.1)。超长序列训练引入了新的初始化挑战:
-
位置编码初始化:RoPE(Rotary Position Embedding,旋转位置编码)的基频参数 (通常设为 10000)影响不同距离的注意力衰减。2025 年的研究发现,对于超长上下文模型, 应随上下文长度动态调整——短上下文用较小的 (如 500),长上下文用较大的 (如 500000),或采用 NTK-aware 插值(NTK-Aware Interpolation,一种调整 RoPE 基频以适应更长序列的方法)。
-
注意力温度初始化:部分超长上下文模型(如 Yi、Qwen2.5-Turbo)在注意力 softmax 中引入可学习的温度参数 (初始化为 ),训练中让模型自适应调整注意力锐度:
11. MTP(Multi-Token Prediction)的初始化
Section titled “11. MTP(Multi-Token Prediction)的初始化”DeepSeek-V3(2024 年底)引入了 Multi-Token Prediction(多 token 预测,同时预测未来多个位置的 token 以提高训练效率和推理速度)。MTP 模块引入了额外的预测头和投影矩阵,其初始化需要特殊处理:
- MTP 的投影矩阵用 初始化,但共享 Embedding 层( tying input embedding 和 output projection)时,输出投影需要额外缩放 ,防止初始 logit 方差过大。
- MTP 的预测头权重初始化为接近零的值,使初始时 MTP 预测接近均匀分布,不干扰主任务的 next-token prediction。
12. 从初始化到”免训练初始化”(Train-Free Initialization)
Section titled “12. 从初始化到”免训练初始化”(Train-Free Initialization)”2025 年的一个新兴方向是研究不经过随机初始化、直接用数据或预训练特征构造权重的方案:
- 数据驱动初始化:用一批训练数据的前向传播结果(激活值的均值和方差)反向校准初始化方差,类似 LSUV(Layer-Sequential Unit-Variance)的现代版。这对异构架构(如 MoE 中专家维度不同、混合卷积-注意力模型)特别有用——固定公式(如 He)无法适配所有层。
- 知识蒸馏初始化:用教师模型的中间层激活值作为初始化目标,让学生模型的初始权重快速”靠近”教师模型的表征空间,加速微调。
13. 分布式训练下的初始化一致性
Section titled “13. 分布式训练下的初始化一致性”随着张量并行(Tensor Parallelism,将单层权重切分到多张 GPU 上)和流水线并行(Pipeline Parallelism,将不同层分配到不同 GPU 上)成为大模型训练标配,初始化的跨 GPU 一致性变得重要:
- 不同 GPU 必须用相同的随机种子(通过广播种子或
torch.distributed的all_reduce同步)初始化权重,否则拼接后的权重矩阵会出现不一致。 - Megatron-LM 和 DeepSpeed 等框架在初始化时自动处理分片后的 fan-in / fan-out 计算(分片后的实际输入维度是全局维度,而非单张 GPU 上的局部维度),避免初始化方差因并行度不同而变化。
14. 2025-2026 趋势总结
Section titled “14. 2025-2026 趋势总结”| 趋势 | 代表工作 | 核心动机 |
|---|---|---|
| 量化感知初始化 | Q-Init, SpinQuant | 适配 INT4/INT8 推理量化 |
| μP 扩展到 MoE 和长序列 | Tensor Programs VI | 超参迁移覆盖新架构 |
| 超长上下文初始化 | RoPE NTK 插值, 注意力温度 | 1M+ 上下文训练稳定 |
| MTP 初始化 | DeepSeek-V3 | 多 token 预测模块的稳定启动 |
| 数据驱动 / 免训练初始化 | 现代 LSUV, 知识蒸馏初始化 | 适配异构架构 |
| 分布式初始化一致性 | Megatron-LM, DeepSpeed | 多 GPU 训练的确定性 |
展望:初始化研究正从”方差缩放公式”向”系统级工程问题”演进——量化、分布式并行、长上下文、MoE 路由等大模型时代的每个子系统都有自己的初始化挑战。经典 Xavier/He 仍然是入门必修,但理解 2025-2026 的前沿趋势对于训练现代大模型至关重要。