
BM25 与全文检索
BM25 是全文检索领域最经典、最广泛使用的相关性评分算法。它是 Elasticsearch、Lucene、Solr 等搜索引擎的默认排序算法,也是传统关键词检索与向量检索混合方案的关键一环。即使在 2025 年大模型与向量检索全面普及的今天,BM25 依然是几乎所有生产级搜索和 RAG(Retrieval-Augmented Generation,检索增强生成)系统中不可替代的**稀疏检索(Sparse Retrieval)**基线。前置阅读:排序学习、向量数据库。
搜索的核心问题是:给定一个查询词,如何给所有文档打分并排序?最朴素的想法是”文档里出现这个词的次数越多,越相关”——这就是 TF(Term Frequency,词频)。
但 TF 有两个明显的缺陷:
- 长文档天然词频更高:一篇 1 万字的文章提到”苹果”5 次,和一篇 100 字的短文提到”苹果”3 次,谁更相关?显然短文更聚焦。需要用文档长度来归一化。
- 常见词没有区分度:在所有文档中都频繁出现的词(如”的”、“是”、“在”)几乎没有信息量。一个词在少数文档中出现才更有区分度——这就是 IDF(Inverse Document Frequency,逆文档频率)。
BM25(Best Match 25)在 TF-IDF 的基础上引入了巧妙的饱和函数(Saturation Function)和长度归一化(Length Normalization),用一个简洁的公式将这两个直觉量化。它的效果如此之好,以至于从 1994 年提出至今仍是搜索引擎的默认选择。
为什么叫 “BM25”? “BM” 代表 Best Match(最佳匹配),“25” 是该系列算法的版本序号——Stephen Robertson 和 Karen Spärck Jones 在伦敦城市大学(City University London)的实验室里迭代了二十多个版本,第 25 版最终脱颖而出,成为经典。这并非算法的参数数量,而是实验编号。
从 TF-IDF 到 BM25
Section titled “从 TF-IDF 到 BM25”TF-IDF 的打分公式:。其中 TF 是词在文档中的出现次数,,N 是总文档数,DF(Document Frequency)是包含该词的文档数。
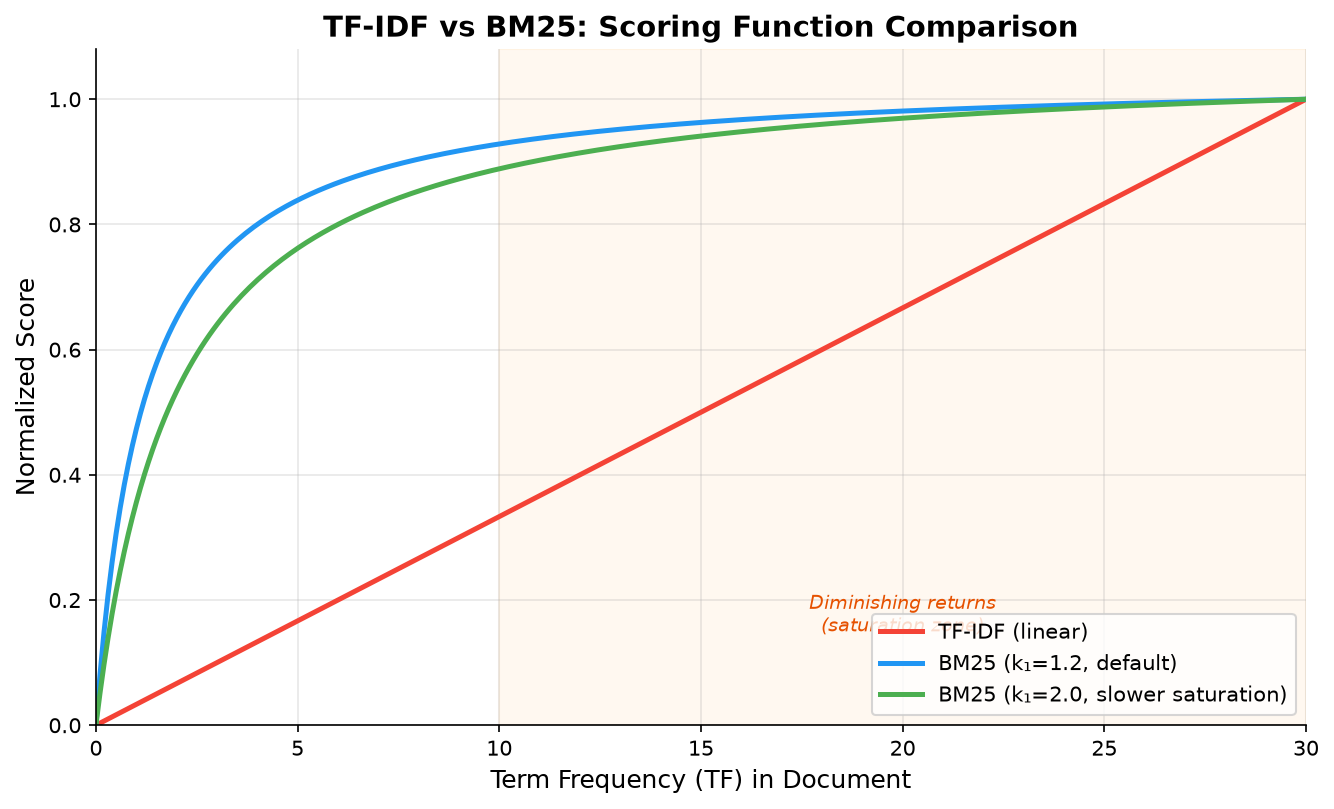
TF-IDF 的问题是 TF 线性增长——出现 10 次就比出现 1 次重要 10 倍,这不太合理。一个词出现 5 次和出现 50 次的”重要性差距”不应该有那么大。直觉上,词频增长带来的边际收益应当递减。
BM25 公式
Section titled “BM25 公式”BM25 的打分公式(对于查询 q 和文档 D):
其中:
- TF(t, D):词 t 在文档 D 中的出现频次(term frequency)
- |D|:文档 D 的长度(词数)
- avgdl(average document length):所有文档的平均长度
- k1:词频饱和参数,控制 TF 增长的上限。典型值 1.2 到 2.0
- b:长度归一化参数,取值 0 到 1。典型值 0.75
- IDF(t):词 t 的逆文档频率,BM25 中常用 。加 0.5 是平滑项,避免除零;末尾的 “+1” 保证 IDF 恒为正(Lucene 的实现做法)
数学直觉:可以把分数拆成两部分理解。
IDF(t)衡量”这个词有多稀有”——出现在越少文档中的词,越能精准定位目标。后面的分式衡量”这个词在这篇文档里出现得有多充分”——它是一个以(k1+1)为上界的饱和函数:TF 从 0 增长时打分快速上升,但越接近上界增长越慢。k1决定饱和发生的速度,b决定文档长度对饱和的偏移。
概率论推导:BM25 从何而来
Section titled “概率论推导:BM25 从何而来”BM25 并非拍脑袋拼凑出的公式,它源自信息检索的概率相关性框架(Probabilistic Relevance Framework, PRP)。其推导逻辑如下(此处做简化版叙述,完整推导见 Robertson 2009 综述):
-
基本假设:一个词 t 对文档 D 相关性的贡献,应该正比于”该词在相关文档中出现的概率 P(t | R)“与”在不相关文档中出现的概率 P(t | NR)“之比。这个比值叫优势比(odds ratio)。
-
对数优势比作为权重:取对数后,词 t 的权重(即 IDF 的雏形)为:
-
2-Poisson 模型(二泊松模型):Robertson 假设词在一个文档子集中的出现频率服从两个泊松分布的混合——一个是”精英集(elite set,即这个词真正’属于’的那些文档)“,另一个是”非精英集”。词频在精英集中期望值较高,在非精英集中较低。基于这个假设可以推出:词频贡献应该是一个有上界的饱和函数,而非线性函数。
-
近似与经验参数:在没有相关反馈(relevance feedback)的情况下,P(t | R) 未知,用 DF 近似 P(t | NR),再加上对文档长度的经验校正,最终就得到了 BM25 的 IDF 项和 TF 饱和项。
这就是为什么 BM25 的公式”恰好”长成那个样子——它不是纯经验的,而是概率论推导在合理近似下的闭式解。这也解释了 BM25 为何能在 TREC 等评测中长期保持强劲表现。
参数 k1 和 b 的作用
Section titled “参数 k1 和 b 的作用”k1 控制词频饱和速度:
- TF 项的分母是 ,所以当 TF 远大于 k1 时,打分趋于上限
- k1 越大,TF 的影响越接近线性(饱和越慢);k1=0 时完全忽略 TF(退化为布尔检索)
- 默认 k1=1.2 是大量实验的经验值,在大多数场景下效果良好
b 控制长度归一化强度:
- b=0:完全不归一化(长文档不惩罚)
- b=1:完全归一化(严格按长度比例缩放)
- b=0.75 是默认值,在”惩罚长文档”和”保留长文档优势”之间取得平衡
调参直觉:如果文档库的长度方差很大(比如既有 50 字的推文也有 5000 字的论文),可以把 b 降到 0.3–0.5 以减少对长文档的过度惩罚;如果业务中词频的细微差异确实重要(比如专利检索中关键词出现 20 次和 5 次确实有质的差别),可以适当增大 k1 到 2.0。
BM25F:多字段扩展
Section titled “BM25F:多字段扩展”现实中的文档通常有多个字段——标题、正文、摘要、标签等,它们的长度和重要性差别很大。直接把所有字段拼成一个长文本算 BM25 会丢失这种结构信息。BM25F(BM25 with Fields)就是为此设计的扩展:
其中 TF_normalized 不再是单一字段的词频,而是各字段词频的加权和:
关键区别:
- 权重 w_f:不同字段不同权重,例如标题权重可以是正文的 3–5 倍(标题命中比正文命中更重要)
- 字段级长度归一化 b_f:每个字段用自己的平均长度做归一化(标题的平均长度和正文截然不同)
- 先求和、后饱和:BM25F 先把各字段的归一化词频加起来,再整体过饱和函数。这避免了”标题里出现一次”被饱和函数压低的问题
Elasticsearch 通过 multi_match 的 cross_fields 或 best_fields 模式、以及 function_score 实现了类似 BM25F 的效果:给标题字段设置 boost: 3,正文字段 boost: 1,每个字段独立打分后融合。
在 Lucene / Elasticsearch 中的实现
Section titled “在 Lucene / Elasticsearch 中的实现”Elasticsearch 的 BM25 similarity 参数:
k1:默认 1.2b:默认 0.75discount_overlaps:是否将同义词(同一位置的多个词项)位置计入文档长度,默认 true
Lucene 的 BM25 实现做了一些工程优化:用倒排索引(Inverted Index)——一种从词项到包含该词的文档列表的映射结构——快速获取每个词的 DF 和 TF;打分时只对匹配文档计算(通过跳表 / skip list 跳过不相关文档),效率极高。这也是为什么 ES 的 BM25 检索通常在毫秒级完成,即使文档量达到亿级。
倒排索引为什么快:与正向遍历每篇文档不同,倒排索引直接从查询词出发定位候选文档集,时间复杂度近似 O(匹配文档数) 而非 O(总文档数)。这是搜索引擎能毫秒级响应的根本原因。
BM25 与向量检索的混合方案
Section titled “BM25 与向量检索的混合方案”现代搜索系统常采用 BM25 + 向量检索 的混合架构(Hybrid Search):
- BM25 负责精确关键词匹配——用户搜”iPhone 15”时必须命中精确词项;产品型号、专有名词、代码标识符等 BM25 天然擅长
- 向量检索(Dense Retrieval,稠密检索)负责语义匹配——用户搜”苹果手机”也能匹配”iPhone”
- 两路结果用 **RRF(Reciprocal Rank Fusion,倒数秩融合)或加权求和(weighted sum)**融合
这种混合方案在 RAG 系统中已成为标配。详见检索增强生成 RAG。
2025–2026 最新进展
Section titled “2025–2026 最新进展”BM25 虽然已有三十年历史,但在大模型时代反而迎来了”第二春”。以下是最值得关注的发展方向。
BM25 在 RAG 系统中的不可替代角色
Section titled “BM25 在 RAG 系统中的不可替代角色”随着 RAG 成为 LLM 应用的事实标准,业界发现纯向量检索并不够好。原因是:
- 精确性不足:当用户问”RFC 768 是什么?“或”引用论文 arXiv:1706.03762”,向量检索可能返回语义相近但不精确匹配的文档,而 BM25 能精确命中编号
- 罕见词与专有名词:人名、产品型号、医学术语等在训练语料中出现稀少,嵌入向量(embedding)质量差,BM25 的精确匹配反而更可靠
- 可解释性与调试:BM25 的打分完全透明(可以逐词查看 IDF 和 TF 贡献),向量相似度则是黑箱
因此 2024–2025 年的共识是:生产级 RAG 必须用混合检索(BM25 + 向量),仅用向量是新手错误。LangChain、LlamaIndex、Weaviate、Pinecone、Milvus 等主流框架和向量数据库都已内置了混合检索的一等支持。
学习型稀疏检索:SPLADE 与神经 BM25
Section titled “学习型稀疏检索:SPLADE 与神经 BM25”SPLADE(Sparse Lexical and Expansion模型,2021 提出,2024–2025 持续演进)是一类用 Transformer 学习产生稀疏词项权重的模型,被誉为”学习型 BM25”:
- 查询/文档扩展(expansion):BM25 只能匹配原文出现的词,而 SPLADE 可以通过模型”预测”出语义相关但未出现的词项并赋权——相当于自动做了同义词扩展
- 稀疏表示:输出仍是高维稀疏向量(词表维度),可以继续用倒排索引加速,工程兼容性好
- 效果:在 MS MARCO 等 benchmark 上,SPLADE 的召回率显著超过 BM25,接近甚至超过一些稠密检索方法,同时保持了精确匹配能力
SPLADE 的变体包括 SPLADE++、SPLADE-v3 等,后者在 2024 年进一步用蒸馏和对比学习提升了效果,成为 RAG 中”比 BM25 更聪明的稀疏检索”的热门选择。
ColBERT 与后期交互模型
Section titled “ColBERT 与后期交互模型”ColBERT(Contextualized Late Interaction over BERT,2020 提出,2024–2025 持续迭代到 ColBERTv2、JaColBERT、Jina-ColBERT 等)走了一条不同的路:
- Token 级向量:不把整篇文档压缩成一个向量(这会丢失细节),而是保留每个 token 的向量
- 后期交互(Late Interaction):查询的每个 token 向量与文档的所有 token 向量做最大相似度(MaxSim)后求和,得到精细的匹配分数
- 效果与成本:精度高于单向量稠密检索,且具备一定的词项精确匹配能力(介于 BM25 和稠密检索之间),但存储和计算成本远高于 BM25
ColBERT 在 2025 年的生产部署越来越普遍,尤其适合对检索质量要求极高的场景(法律、医疗、学术)。
混合检索融合策略的演进
Section titled “混合检索融合策略的演进”2025 年的实践表明,融合策略比单路检索算法的选择更影响最终效果:
- RRF(倒数秩融合):仍然是工业界最常用的方案,无需调参、对不同分数尺度鲁棒。公式:,k 常取 60
- 加权求和:需要先把两路分数归一化(如 min-max 或 z-score),再按经验权重加权。效果好但需要调参
- 学习型融合(Learned Fusion):用一个小模型(如交叉编码器 Cross-Encoder)对多路召回的 top-K 结果做重排序(rerank),这是当前效果最好的方案。代表模型有 Cohere Rerank、BGE-Reranker、Jina Reranker 等
一个 2025 年典型的生产级 RAG 检索管线是:
用户查询 → [BM25 召回 top-100] + [向量召回 top-100] + [可选: SPLADE/ColBERT 召回] → RRF 融合 → top-50 → Cross-Encoder 重排序 → top-5 → 送入 LLM 生成回答向量数据库对 BM25 的原生支持
Section titled “向量数据库对 BM25 的原生支持”2024–2025 年的一个明显趋势是:向量数据库纷纷”反向”集成了 BM25 等关键词检索能力,从”纯向量”走向”混合”:
- Weaviate:1.24+ 版本内置 BM25(基于 OSS Ranklib),与向量检索结果用
hybrid查询融合 - Milvus:2.4+ 引入稀疏向量与 BM25 全文检索的混合搜索 API
- Pinecone:推出 sparse-dense hybrid index,内置 BM25 打分
- Qdrant:支持稀疏向量字段,可配合 BM25 实现混合检索
这说明业界已经形成共识:BM25 不会被向量检索取代,两者是互补关系。
BM25 相比 TF-IDF 的改进
Section titled “BM25 相比 TF-IDF 的改进”词频饱和曲线对比
Section titled “词频饱和曲线对比”如何看这张图:随着词频从 1 涨到 20,TF-IDF 的分数线性飙升到 20 倍(严重过度奖励高频词),而 BM25 的分数从 0.55 缓慢趋近上限 1.0——这正是饱和函数的价值。数值仅为示意(假设 k1=1.2, b=0, 归一化后),实际值取决于参数和文档长度。
BM25 + 向量检索混合架构
Section titled “BM25 + 向量检索混合架构”用 rank_bm25 库做全文检索
Section titled “用 rank_bm25 库做全文检索”# pip install rank_bm25from rank_bm25 import BM25Okapiimport jieba # pip install jieba
# 中文必须先分词——BM25 基于词频,中文没有空格分隔def tokenize(text): return list(jieba.cut(text))
# 文档库raw_docs = [ "深度学习是机器学习的一个重要分支", "卷积神经网络广泛用于图像识别和目标检测", "Transformer 是自然语言处理的核心架构", "残差连接解决了深层网络训练困难的问题", "循环神经网络适合处理序列数据如文本和语音", "生成对抗网络可以生成逼真的图像",]tokenized_docs = [tokenize(d) for d in raw_docs]
# 构建索引(内部计算 IDF、文档长度等统计量)bm25 = BM25Okapi(tokenized_docs)
# 查询并打分query = tokenize("深度学习 神经网络")scores = bm25.get_scores(query)print("查询词:", query)print("各文档分数:")for i, (doc, score) in enumerate(zip(raw_docs, scores)): print(f" [{i}] {score:.4f} {doc}")
# 取最相关的 2 篇top_k = bm25.get_top_n(query, raw_docs, n=2)print("Top-2 结果:", top_k)输出示例:
查询词: ['深度', '学习', ' ', '神经', '网络']各文档分数: [0] 1.8234 深度学习是机器学习的一个重要分支 [1] 1.0567 卷积神经网络广泛用于图像识别和目标检测 [2] 0.0000 Transformer 是自然语言处理的核心架构 [3] 0.9812 残差连接解决了深层网络训练困难的问题 ...Top-2 结果: ['深度学习是机器学习的一个重要分支', '卷积神经网络广泛用于图像识别和目标检测']观察:文档 0 同时命中”深度”和”学习”两个词项,得分最高;文档 1 命中”神经""网络”得分次之;文档 2 虽然与查询语义高度相关,但因为 BM25 是词项匹配,“Transformer”和”自然语言处理”都没有直接命中查询词,得分为 0——这正是 BM25 的固有局限,也是需要向量检索来弥补的地方。
用 NumPy 手写 BM25(理解内部机制)
Section titled “用 NumPy 手写 BM25(理解内部机制)”import numpy as np
class BM25FromScratch: """用 NumPy 从零实现 BM25,帮助理解公式""" def __init__(self, docs, k1=1.2, b=0.75): self.k1 = k1 self.b = b self.docs = docs # 已分词的文档列表 self.N = len(docs) self.doc_len = np.array([len(d) for d in docs]) self.avgdl = self.doc_len.mean()
# 构建词表和倒排统计 self.vocab = {} self.tf = [] # 每篇文档的词频字典 self.df = {} # 每个词出现在多少篇文档中
for doc in docs: freq = {} for word in doc: freq[word] = freq.get(word, 0) + 1 self.tf.append(freq) for word in freq: self.df[word] = self.df.get(word, 0) + 1
def idf(self, word): """BM25 的 IDF(带平滑项)""" df = self.df.get(word, 0) return np.log((self.N - df + 0.5) / (df + 0.5) + 1)
def score(self, query, doc_idx): """计算单篇文档的 BM25 分数""" score = 0.0 dl = self.doc_len[doc_idx] for word in query: tf = self.tf[doc_idx].get(word, 0) if tf == 0: continue idf = self.idf(word) # 核心公式:饱和函数 + 长度归一化 tf_norm = tf * (self.k1 + 1) / ( tf + self.k1 * (1 - self.b + self.b * dl / self.avgdl) ) score += idf * tf_norm return score
def search(self, query, top_k=3): scores = [(i, self.score(query, i)) for i in range(self.N)] scores.sort(key=lambda x: -x[1]) return scores[:top_k]
# 测试docs = [ "the cat sat on the mat".split(), "the dog sat on the log".split(), "cats and dogs are pets".split(),]bm25 = BM25FromScratch(docs, k1=1.2, b=0.75)print(bm25.search("cat sat".split(), top_k=3))# [(0, score), (1, score), (2, 0.0)]Elasticsearch 中的 BM25 配置与查询
Section titled “Elasticsearch 中的 BM25 配置与查询”# pip install elasticsearchfrom elasticsearch import Elasticsearch
es = Elasticsearch("http://localhost:9200")
# ---------- 创建索引时自定义 BM25 参数 ----------es.indices.create(index="articles", mappings={ "properties": { "title": { "type": "text", "similarity": "title_bm25", # 引用下面定义的 similarity "analyzer": "ik_max_word", # 中文分词(需安装 IK 插件) }, "content": { "type": "text", "similarity": "content_bm25", "analyzer": "ik_max_word", }, }}, settings={ "similarity": { "title_bm25": { "type": "BM25", "k1": 1.2, "b": 0.4, # 标题通常很短,降低 b 减少长度惩罚 }, "content_bm25": { "type": "BM25", "k1": 1.2, "b": 0.75, # 正文长度差异大,用默认值 }, }})
# ---------- 多字段查询(类似 BM25F 的效果)----------result = es.search(index="articles", body={ "query": { "multi_match": { "query": "深度学习 神经网络", "fields": ["title^3", "content"], # 标题权重 ×3 "type": "best_fields", } }, "size": 5,})for hit in result["hits"]["hits"]: print(f"BM25 分数: {hit['_score']:.2f} | {hit['_source']['title']}")混合检索:BM25 + 向量检索 + RRF 融合
Section titled “混合检索:BM25 + 向量检索 + RRF 融合”"""完整的混合检索示例:BM25 稀疏检索 + 向量稠密检索 + RRF 融合依赖:pip install rank_bm25 sentence-transformers"""import numpy as npfrom rank_bm25 import BM25Okapifrom sentence_transformers import SentenceTransformerimport jieba
def hybrid_search(query, docs, top_k=5): """BM25 + 向量混合检索,用 RRF 融合""" # ---- 1. 分词 ---- tokenized_docs = [list(jieba.cut(d)) for d in docs] tokenized_query = list(jieba.cut(query))
# ---- 2. BM25 稀疏检索 ---- bm25 = BM25Okapi(tokenized_docs) bm25_scores = bm25.get_scores(tokenized_query) bm25_rank = np.argsort(-bm25_scores) # 按分数降序的文档索引
# ---- 3. 向量稠密检索 ---- # 用支持中文的嵌入模型 model = SentenceTransformer("BAAI/bge-small-zh-v1.5") doc_embeddings = model.encode(docs, normalize_embeddings=True) query_embedding = model.encode([query], normalize_embeddings=True) # 余弦相似度(已归一化,即点积) vec_scores = (doc_embeddings @ query_embedding.T).flatten() vec_rank = np.argsort(-vec_scores)
# ---- 4. RRF(倒数秩融合)---- # 公式:score(d) = Σ 1 / (k + rank(d)),k 常取 60 rrf_k = 60 rrf_scores = np.zeros(len(docs)) for rank, doc_idx in enumerate(bm25_rank): rrf_scores[doc_idx] += 1.0 / (rrf_k + rank + 1) for rank, doc_idx in enumerate(vec_rank): rrf_scores[doc_idx] += 1.0 / (rrf_k + rank + 1)
# ---- 5. 输出最终排序 ---- final_rank = np.argsort(-rrf_scores)[:top_k] return [(docs[i], rrf_scores[i]) for i in final_rank]
# ---- 演示 BM25 和向量检索的互补性 ----docs = [ "深度学习是机器学习的一个重要分支", "卷积神经网络广泛用于图像识别和目标检测", "Transformer 是自然语言处理的核心架构", "残差连接解决了深层网络训练困难的问题", "苹果公司发布了最新的 iPhone 手机", "iOS 是苹果手机的操作系统",]
# 查询"苹果手机"——BM25 能精确命中,向量也能语义匹配results = hybrid_search("苹果手机", docs, top_k=3)for doc, score in results: print(f"[{score:.4f}] {doc}")这个示例展示了混合检索的核心价值:纯 BM25 会精准命中包含”苹果""手机”的文档 4、5;纯向量检索可能还会把语义相关的文档 2(Transformer/NLP)也召回;RRF 融合后两者的优势叠加,既保证精确性又兼顾语义。
Elasticsearch 的混合检索(kNN + BM25)
Section titled “Elasticsearch 的混合检索(kNN + BM25)”# Elasticsearch 8.x 原生支持 kNN 向量检索,可与 BM25 混合result = es.search(index="articles", body={ "query": { # 用 bool 查询同时做 BM25 和向量相似度 "bool": { "should": [ {"match": {"content": {"query": "深度学习", "boost": 1.0}}}, { "knn": { "field": "content_vector", # 预计算的字段 "query_vector": query_vec, # 查询的向量 "num_candidates": 100, "boost": 1.0, } }, ] } }, "size": 10,})Elasticsearch 8.9+ 还内置了 rrf 检索器,可以直接声明式地做 RRF 融合:
{ "size": 10, "retriever": { "rrf": { "retrievers": [ {"standard": {"query": {"match": {"content": "深度学习 神经网络"}}}}, {"knn": {"field": "content_vector", "query_vector": [...], "num_candidates": 100}} ], "rank_window_size": 50, "rank_constant": 60 } }}- 中文必须先分词:BM25 基于词频,中文没有自然空格分隔,必须先用 jieba、HanLP 等分词器切词后再建索引。Elasticsearch 的 IK 分词器或结巴分词插件是中文搜索的标准选择。分词质量直接决定检索效果——“深度学习”应被识别为一个词而非切分成”深度”+“学习”。
- k1 和 b 的调参经验:大多数场景用默认值(k1=1.2, b=0.75)就很好。如果文档长度差异很大,适当降低 b(如 0.5)减少对长文档的惩罚;如果某些词频差异很重要,适当增大 k1(如 2.0)。调参应基于线上 A/B 测试而非离线直觉。
- 停用词过滤:中文的”的、了、在”等高频词 IDF 极低,对打分贡献微乎其微但消耗索引空间。可以在索引前过滤停用词提升效率。但要注意:某些场景下停用词有意义(如”To Be or Not to Be”),不要一刀切。
- 混合检索注意分数尺度:BM25 分数是无界的(不同查询分数范围不同),向量相似度通常在 0-1 之间。直接加权求和会导致 BM25 主导结果。用 RRF(只看排名不看分数)更稳健,或用归一化后再加权。
- 字段权重:Elasticsearch 的
multi_match可以给不同字段(标题 vs 正文)不同权重,标题匹配的 BM25 分数乘以更高系数。这本质上是在模拟 BM25F 的效果。 - BM25 不适合纯语义搜索:搜”苹果手机”匹配不到”iPhone”——这是 BM25 的天然局限。需要语义匹配的场景应该结合向量检索。详见嵌入模型。
- 考虑学习型稀疏检索替代:如果业务对检索质量要求高且有余力部署模型,SPLADE 等”学习型 BM25”能在保持稀疏检索工程优势的同时大幅提升效果,是 2025 年值得关注的升级方向。
- 重排序(Rerank)是性价比最高的提升:不管用 BM25 还是混合检索,在 top-K 后面接一个 Cross-Encoder 重排序模型(如 BGE-Reranker),通常能用很小的推理成本换来显著的精度提升。
- 全文搜索引擎:Elasticsearch、Lucene、Solr 的默认排序算法。几乎所有基于关键词的搜索(电商商品搜索、文档搜索、日志检索)都依赖 BM25。
- 电商搜索:淘宝、京东的商品搜索在 BM25 基础上叠加个性化排序(销量、评价、用户偏好),BM25 负责文本相关性这一环。详见排序学习。
- RAG 系统的稀疏检索通道:LangChain、LlamaIndex 等框架在 RAG 管道中用 BM25 做稀疏检索,与向量检索结果融合。这是 2024–2025 年 LLM 应用中 BM25 最热门的使用场景。详见检索增强生成 RAG。
- 代码搜索:GitHub 的代码搜索基于 BM25 变体,匹配函数名、变量名、注释中的关键词。代码中的标识符(如
pthread_mutex_init)需要精确匹配,向量检索难以替代 BM25。 - 日志与监控:ELK Stack(Elasticsearch + Logstash + Kibana)用 BM25 对海量日志做全文检索。运维人员搜索特定 error code、异常堆栈时依赖精确匹配。
- 法律与医疗文献检索:这类领域术语精确性要求极高(法规编号、药品名、ICD 编码),BM25 的精确匹配能力不可或缺,通常与向量检索混合使用。
- 企业内部知识库:飞书、Notion、Confluence 等企业文档系统的全文搜索都依赖 BM25 或其变体,在千万级文档量下实现毫秒级响应。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| rank_bm25 | Python | 轻量级 BM25 纯 Python 实现,适合小规模数据和原型验证 |
| Elasticsearch | Java / REST API | 企业级搜索引擎,BM25 是默认评分算法,8.x 起原生支持 kNN 混合检索与 RRF |
| Apache Lucene | Java | Elasticsearch 和 Solr 的底层引擎,BM25 的高性能倒排索引实现 |
| Apache Solr | Java | 企业级搜索平台,基于 Lucene,内置 BM25 评分 |
| Meilisearch | Rust | 轻量级搜索引擎,默认用 BM25 变体做相关性打分,对中小型项目极友好 |
| Whoosh | Python | 纯 Python 全文检索库,内置 BM25 评分,适合小型项目 |
| Weaviate | Go | 向量数据库,内置 BM25 全文检索与 hybrid 混合查询,支持 RRF 融合 |
| Milvus | Go | 向量数据库,2.4+ 支持稀疏向量与 BM25 混合搜索 |
| Qdrant | Rust | 向量数据库,支持稀疏向量字段做 BM25 混合检索 |
| SPLADE / sentence-transformers | Python | 学习型稀疏检索与稠密检索模型,用于构建混合检索管线 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 词频 | TF (Term Frequency) | 词在文档中的出现次数 |
| 逆文档频率 | IDF (Inverse Document Frequency) | 衡量词的稀有程度,出现文档越少 IDF 越大 |
| 倒排索引 | Inverted Index | 从词到包含该词的文档列表的映射,搜索引擎的核心数据结构 |
| 饱和函数 | Saturation Function | BM25 中 TF 的增长趋近上限的函数,避免高频词过度主导 |
| 长度归一化 | Length Normalization | 按文档长度调整打分,避免长文档天然得分偏高 |
| 概率相关性框架 | PRP (Probabilistic Relevance Framework) | BM25 的理论基础,从概率论推导出相关性评分 |
| 2-Poisson 模型 | Two-Poisson Model | BM25 推导中假设词频由两个泊松分布混合生成的数学模型 |
| 稀疏检索 | Sparse Retrieval | 基于词项匹配的检索(如 BM25),向量维度稀疏(大部分维度为 0) |
| 稠密检索 | Dense Retrieval | 基于语义向量相似度的检索,向量维度密集(所有维度都有值) |
| 混合检索 | Hybrid Search | 同时使用稀疏(BM25)和稠密(向量)检索并融合结果 |
| 倒数秩融合 | RRF (Reciprocal Rank Fusion) | 只基于排名(不看分数)合并多路检索结果的融合方法,公式 |
| 学习型稀疏检索 | Learned Sparse Retrieval | 用神经网络学习词项权重和查询扩展,代表方法如 SPLADE |
| 后期交互 | Late Interaction | ColBERT 等模型保留 token 级向量、在查询时做细粒度交互的检索范式 |
| 重排序 | Reranking / Cross-Encoder | 对初检的 top-K 结果用更强的模型(如交叉编码器)精排,提升精度 |
| 停用词 | Stop Words | 频繁出现但信息量极低的词(如”的、是、在”),通常过滤掉 |
| BM25F | BM25 with Fields | BM25 的多字段扩展,给标题/正文等不同字段不同权重和长度归一化 |
- Robertson & Zaragoza,「The Probabilistic Relevance Framework: BM25 and Beyond」(Foundation and Trends in IR, 2009):BM25 作者的权威综述,系统讲解 BM25 的概率论推导、2-Poisson 模型和各种变体(含 BM25F),理解 BM25 的必读文献。
- Croft et al.,「Search Engines: Information Retrieval in Practice」(2009):经典信息检索教材,涵盖 TF-IDF、BM25、向量空间模型等基础检索算法。
- Karpukhin et al.,「Dense Passage Retrieval for Open-Domain Question Answering」(EMNLP 2020):DPR 论文,证明了稠密向量检索可以超越 BM25,开启了向量检索时代。详见嵌入模型。
- Formal et al.,「SPLADE: Sparse Lexical and Expansion Model」(SIGIR 2021):学习型稀疏检索的代表作,提出用 Transformer 学习词项权重和查询扩展,是 BM25 的”学习升级版”。
- Khattab & Zaharia,「ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT」(SIGIR 2020):后期交互检索模型,在 BM25 的精确匹配和稠密检索的语义匹配之间找到平衡点。
- Luan et al.,「Sparse, Dense, and Attentional Representations for Text Retrieval」(ACL 2021):对比稀疏(BM25)和稠密(向量)表示在检索任务中的表现,为混合方案提供实证依据。
- Cormack et al.,「Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods」(SIGIR 2009):RRF 融合方法的奠基论文,解释了为什么”只看排名”的简单融合反而效果最好。