
异常检测
本页介绍异常检测(Anomaly Detection)——找出”跟大多数不一样”的数据点。异常检测与聚类(见聚类分析)同属无监督学习范畴:聚类是找”群体”,异常检测是找”异类”。从信用卡欺诈到工业故障预警,异常检测是 AI 在金融、安全、工业领域最实用的技术之一。
异常的三种类型
Section titled “异常的三种类型”在深入算法之前,先理解异常的形态有助于选对方法。异常一般分为三类:
- 点异常(Point Anomaly):单个数据点偏离正常范围。例如信用卡一笔 10 万美元的刷卡,而用户日常消费在 100-500 美元——这一笔就是点异常。这是最简单也最常见的异常类型。
- 上下文异常(Contextual Anomaly):单个值在特定上下文中才算异常。比如夏天 5°C 的气温——如果忽略季节,5°C 只是个低温值;但在 7 月,它就是明确的异常。这类异常要求模型理解”上下文”(时间、地点、条件)。
- 集合异常(Collective Anomaly):单个点都正常,但一组连续点构成异常模式。例如心电图中心跳在 1 分钟内从 60 bpm 跳到 200 bpm 再回落——每个瞬时心率单独看都可能正常,但连续序列表明心律不齐。时间序列异常检测的核心挑战就在这里。
异常检测的本质很简单:先学会什么是”正常”,然后标记所有”不正常”的。但”正常”的建模方式不同,衍生出四大流派:
- 统计方法 = 用概率分布画圈:假设正常数据服从某个分布(如正态分布),偏离分布中心太远的点就是异常——3σ 原则就是说”99.7% 的数据应该在这个圈内,圈外的就是异常”。简单直接,但要求数据确实服从已知分布。
- 距离/密度方法 = 看周围有没有邻居:正常数据应该”扎堆”,异常数据通常”孤立”。LOF(局部异常因子)衡量一个点的局部密度与邻居的比值——密度越低,越可能是异常。Isolation Forest 直接利用”异常点容易被孤立”的特性来检测。
- 重构方法 = 先学重建正常数据,重建不了的就是异常:用 Autoencoder 在正常数据上训练,让它学会重建正常模式。遇到异常数据时,重建误差会显著增大——“学过的会重建,没见过的重建不了”。
- 分类方法 = 把正常数据当成一类:One-class SVM 只用正常数据训练,学习一个把正常数据包围起来的边界,边界外的就是异常。适合只有正常样本、缺少异常样本的场景(这正是现实中的常态)。
半监督 vs 无监督:根据可用标签的不同,异常检测又分为三类范式。监督(Supervised) 同时拥有正常和异常标签,直接训练分类器——但异常样本太少且不断变化,实际中几乎不可用。半监督(Semi-supervised) 只用正常样本训练(如 Autoencoder、One-class SVM),这是工业界最常见的设置。无监督(Unsupervised) 没有任何标签,直接从混合数据中找异常(如 Isolation Forest、LOF),最灵活但也最容易受噪声干扰。
正常分布 vs 异常点
Section titled “正常分布 vs 异常点”不同方法对”什么是异常”的理解不同:
异常检测 2D 可视化
Section titled “异常检测 2D 可视化”下面的散点图直观展示了正常点(蓝色圆点)紧密聚集在中心区域,而异常点(红色 X 标记)散布在远离群体的外围,虚线椭圆表示 3σ 正常边界。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as npfrom matplotlib.patches import Ellipse
np.random.seed(42)
# --- 正常点:以原点为中心的多元高斯分布 ---mean = np.array([0.0, 0.0])cov = np.array([[1.0, 0.3], [0.3, 1.0]])normal = np.random.multivariate_normal(mean, cov, size=300)
# --- 异常点:在远离中心的外环区域均匀分布 ---angles = np.random.uniform(0, 2 * np.pi, 15)radii = np.random.uniform(4.5, 7.0, 15)anomaly = np.column_stack([radii * np.cos(angles), radii * np.sin(angles)])
fig, ax = plt.subplots(figsize=(9, 5.5))
# 绘制 3σ 正常边界(虚线椭圆)eigvals, eigvecs = np.linalg.eigh(cov)angle = np.degrees(np.arctan2(eigvecs[1, 0], eigvecs[0, 0]))boundary = Ellipse(mean, 2 * 3 * np.sqrt(eigvals[0]), 2 * 3 * np.sqrt(eigvals[1]),                   angle=angle, edgecolor="#1565C0", facecolor="#2196F3",                   alpha=0.08, linewidth=2, linestyle="--")ax.add_patch(boundary)
# 正常点ax.scatter(normal[:, 0], normal[:, 1], c="#2196F3", marker="o", s=25,           alpha=0.6, edgecolors="white", linewidths=0.3, label="Normal points (n=300)")# 异常点ax.scatter(anomaly[:, 0], anomaly[:, 1], c="#F44336", marker="X", s=120,           linewidths=0.8, label="Anomalies (n=15)")
ax.set_title("Anomaly Detection: Normal Points vs Outliers", fontsize=12, fontweight="bold")ax.set_xlabel("Feature 1", fontsize=10)ax.set_ylabel("Feature 2", fontsize=10)ax.legend(loc="upper right", fontsize=9, framealpha=0.9)ax.set_xlim(-8.5, 8.5)ax.set_ylim(-6.5, 6.5)ax.set_aspect("equal", adjustable="box")ax.grid(True, alpha=0.25, linestyle="--")
plt.tight_layout()plt.savefig("anomaly-detection-scatter.png", dpi=180, bbox_inches="tight", facecolor="white")plt.close()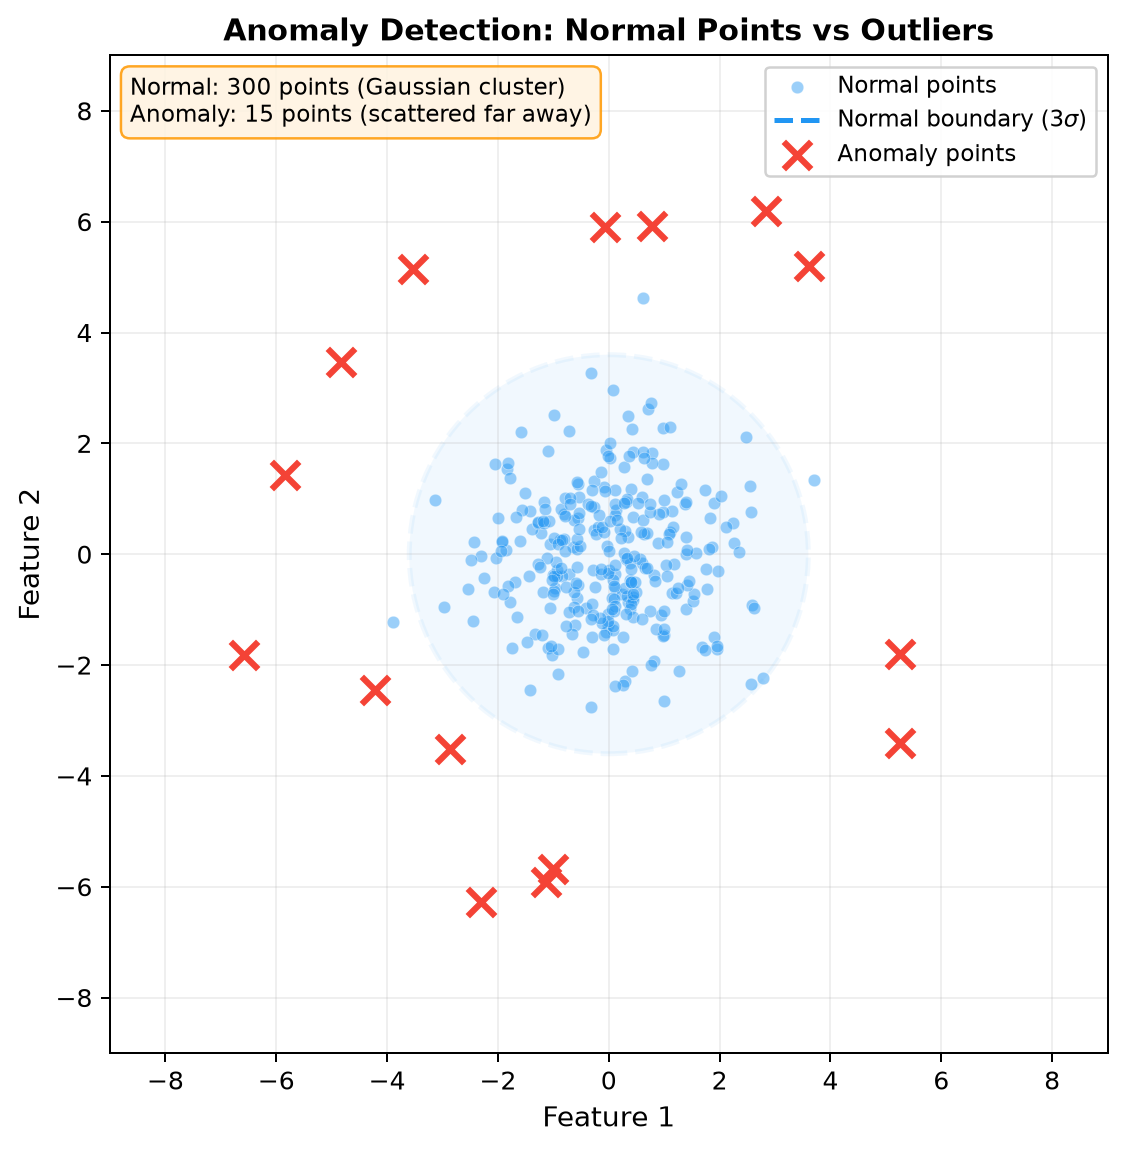
异常检测 2D 可视化
Section titled “异常检测 2D 可视化”下图用 2D 散点图直观展示异常检测场景:正常点(蓝色)聚集在中心附近,异常点(红色 ×)散布在远离中心的边缘区域,虚线椭圆标示”正常边界”。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as npfrom matplotlib.patches import Ellipse
np.random.seed(42)
# 正常点:高斯聚类normal = np.random.randn(300, 2) * 1.2
# 异常点:均匀分布在远离中心的环形区域angles = np.random.uniform(0, 2 * np.pi, 15)radii = np.random.uniform(4.5, 7.0, 15)anomaly = np.column_stack([radii * np.cos(angles), radii * np.sin(angles)])
fig, ax = plt.subplots(figsize=(9, 6.5))
# 正常边界(3σ)boundary = Ellipse(xy=(0, 0), width=7.2, height=7.2,                   edgecolor="#2196F3", facecolor="#2196F3",                   alpha=0.06, linewidth=2, linestyle="--")ax.add_patch(boundary)
ax.scatter(normal[:, 0], normal[:, 1], c="#2196F3", alpha=0.45,           s=25, label="Normal points")ax.scatter(anomaly[:, 0], anomaly[:, 1], c="#F44336", marker="x",           s=120, linewidths=2.5, label="Anomaly points")
ax.set_title("Anomaly Detection: Normal Points vs Outliers",             fontsize=12, fontweight="bold")ax.set_xlabel("Feature 1")ax.set_ylabel("Feature 2")ax.legend(fontsize=9)ax.set_aspect("equal")ax.set_xlim(-9, 9)ax.set_ylim(-9, 9)ax.grid(True, alpha=0.2)plt.tight_layout()plt.savefig("anomaly-detection-scatter.png", dpi=180,            bbox_inches="tight", facecolor="white")
Isolation Forest 孤立原理
Section titled “Isolation Forest 孤立原理”Isolation Forest 的核心洞察:异常点因为稀少且偏离群体,用随机超平面切分时更容易被孤立(需要的切分次数少):
正常点被很多邻居包围,需要很多次切分才能把它单独分出来;异常点孤立在边缘,几次随机切分就能把它分离——路径长度越短,越可能是异常。这个想法极其巧妙又极其高效。
算法原理深入
Section titled “算法原理深入”下面从数学角度逐一拆解四大流派的核心算法。公式不多,但每一步都配以直觉解释。
1. 统计方法:从 Z-score 到 Mahalanobis 距离
Section titled “1. 统计方法:从 Z-score 到 Mahalanobis 距离”Z-score(标准分数) 是最基本的异常度量。给定数据点 ,均值 ,标准差 :
直觉: 衡量 偏离均值多少个标准差。3σ 原则说 的概率约 0.3%,因此 的点可视为异常。
但 Z-score 只适用于单变量。多变量场景下,我们需要 Mahalanobis 距离——它考虑了各维度之间的相关性(协方差),不像欧氏距离那样把各维度一视同仁:
其中 是协方差矩阵, 是其逆矩阵。
数学直觉:如果两个特征高度正相关(比如身高和体重),那么”180cm + 40kg”这种组合就很可疑——虽然单独看身高和体重都不极端,但它们的组合不正常。Mahalanobis 距离通过协方差矩阵的逆把数据”拉直”到各维度独立的空间,等价于先做白化(Whitening),再算欧氏距离。当数据服从多元正态分布时, 服从自由度为 (维度数)的 分布,阈值取 分布的 99% 分位数即可。
Minimum Covariance Determinant(MCD):当数据本身已混入异常点时,直接用全部数据算 会被异常值污染。MCD 算法寻找一个子集,使得该子集的协方差矩阵行列式最小(即最紧凑),从而获得对异常值鲁棒的均值和协方差估计。这是鲁棒统计(Robust Statistics)的经典方法。
2. Isolation Forest:路径长度的数学化
Section titled “2. Isolation Forest:路径长度的数学化”Isolation Forest 由 Liu 等人于 2008 年提出。构建 棵 iTree(孤立树),每棵树的做法是:随机选一个特征,在该特征的最小值和最大值之间随机选一个阈值进行切分,递归进行直到每个点被孤立或达到最大深度。
对于一个点 ,记其在某棵树中被孤立时的路径长度(切分次数)为 。异常分数定义为:
其中 是 在所有树上的平均路径长度, 是用 个样本构建的二叉搜索树的平均路径长度的归一化因子:
是调和级数(Harmonic Number), 是欧拉-马歇罗尼常数(Euler-Mascheroni Constant)。
数学直觉:
- 当 (平均路径长度等于归一化因子)时,,说明该点跟随机猜没什么区别——不好不坏。
- 当 (很快就被孤立)时,,强烈表明是异常。
- 当 (极难被孤立)时,,非常正常。
异常分数 的取值范围是 ,越接近 1 越异常。实践中通常取 或 作为异常阈值。
为什么用指数 ? 这个设计借鉴了二叉搜索树的理论:在 个点上随机构建的 BST 的平均查找长度正是 。用 做归一化后,异常分数就有了跨数据集的可比性。指数函数则把”路径长度差异”放大为”分数差异”,使得异常和正常之间的界限更清晰。
3. LOF:局部密度的比值
Section titled “3. LOF:局部密度的比值”LOF(Local Outlier Factor)由 Breunig 等人于 2000 年提出,核心是衡量一个点的”局部密度”相对于其邻居是偏低还是正常。
定义 可达距离(Reachability Distance):
其中 是 到其第 个最近邻的距离, 是 到 的实际距离。可达距离”削峰”了:如果 太靠近 (),就取 ——避免极近距离点造成距离统计的不稳定。
定义 局部可达密度(Local Reachability Density, LRD):
即 到其 邻域内各点的平均可达距离的倒数。密度越高(距离越短),LRD 越大。
最终,LOF 分数:
数学直觉:LOF 是”邻居的平均密度 / 自身密度”的比值。
- :自身密度与邻居差不多——正常。
- :邻居的密度远高于自身——自身处于稀疏区域,是异常。
- :自身密度比邻居还高——处于密集区域中心,完全正常。
LOF 的精妙之处在于”局部”二字:它能处理不同区域密度不同的数据集(全局方法在此会失效),只要比较的是同一局部区域内的密度比值。
4. One-class SVM:在特征空间中画一个圈
Section titled “4. One-class SVM:在特征空间中画一个圈”One-class SVM 由 Schölkopf 等人于 2001 年提出。它的目标是在高维特征空间中找一个超平面,使得正常数据被尽可能多地包含在超平面”正侧”,同时超平面到原点的距离尽可能远。
优化目标:
约束条件:,。
其中 是将原始数据映射到高维特征空间的函数(通过核函数隐式实现), 是松弛变量(允许少量正常点落在边界外), 是决策阈值, 控制异常比例上界和支持向量比例下界。
数学直觉:想象在高维空间中吹一个气球——气球尽量把正常数据包进去,但气球表面要尽量贴近原点(不能无限膨胀)。气球外的点就是异常。 参数相当于控制”允许多少比例的数据落在气球外面”。用 RBF 核(Radial Basis Function Kernel)时,气球可以是任意弯曲的曲面,适应复杂的正常数据分布。
SVDD(Support Vector Data Description) 是 One-class SVM 的变体:它不是找超平面,而是在特征空间中找一个最小体积的超球体把正常数据包起来。两者的解在很多情况下等价。
5. Autoencoder:重构误差作为异常信号
Section titled “5. Autoencoder:重构误差作为异常信号”Autoencoder(自编码器)由编码器 和解码器 组成。编码器把输入压缩成低维隐表示 ,解码器再从 重构出 。
训练时只在正常数据上最小化重构误差(通常用 MSE):
推理时,异常分数就是重构误差本身:
数学直觉:瓶颈结构(Bottleneck)迫使模型学习数据的低维流形(Manifold)。正常数据都能被很好地压缩和还原,因为它们分布在模型学到的流形上。异常数据偏离流形,强行压缩后会丢失关键信息,重构必然走样。就像一个人只会做川菜——给他食材他能做出来(正常),给他一堆五金零件(异常),他还是做不出像样的菜。
VAE 用于异常检测:Variational Autoencoder 不直接重构,而是学习隐空间的概率分布 ,用重构概率(Reconstruction Probability) 代替重构误差。好处是 VAE 输出的是概率,天然有不确定性度量,比纯误差值更有统计意义。
Isolation Forest 异常检测
Section titled “Isolation Forest 异常检测”from sklearn.ensemble import IsolationForestfrom sklearn.datasets import make_blobsimport numpy as np
# 生成正常数据(一团密集点)+ 手动加入几个异常点X_normal, _ = make_blobs(n_samples=300, centers=1, random_state=42)X_outliers = np.random.uniform(low=-10, high=10, size=(15, 2))X = np.vstack([X_normal, X_outliers])
# Isolation Forest 训练并预测model = IsolationForest(contamination=0.05, random_state=42) # contamination = 异常比例labels = model.fit_predict(X) # 1=正常, -1=异常
n_anomaly = (labels == -1).sum()print(f"检测到 {n_anomaly} 个异常点(共 {len(X)} 个样本)")# 输出示例: 检测到 16 个异常点(共 315 个样本)
# 查看异常分数(越负 = 越异常,是决策函数的负值)scores = model.decision_function(X)print(f"最异常的 5 个点分数: {np.sort(scores)[:5].round(3)}")LOF 局部异常因子
Section titled “LOF 局部异常因子”from sklearn.neighbors import LocalOutlierFactor
# LOF 也可以检测异常(注意:默认无 predict 方法,需 novelty=True 才能预测新数据)lof = LocalOutlierFactor(n_neighbors=20, contamination=0.05)labels = lof.fit_predict(X)
# 查看每个点的异常分数(越负 = 越异常)scores = lof.negative_outlier_factor_print(f"最异常的 5 个点分数: {np.sort(scores)[:5].round(3)}")# LOF 原始分数 > 1 表示异常;sklearn 中取负值,所以越负越异常print(f"LOF 分数范围: [{scores.min():.3f}, {scores.max():.3f}]")One-class SVM 异常检测
Section titled “One-class SVM 异常检测”from sklearn.svm import OneClassSVM
# 只用正常数据训练(半监督范式)X_train = X_normal # 仅用正常数据
# nu 参数 ≈ 允许的异常比例上界,同时是支持向量的下界比例ocsvm = OneClassSVM(kernel='rbf', gamma='scale', nu=0.05)ocsvm.fit(X_train)
# 预测全部数据labels = ocsvm.predict(X) # 1=正常, -1=异常n_anomaly = (labels == -1).sum()print(f"One-class SVM 检测到 {n_anomaly} 个异常点")
# 异常分数:到决策边界的有符号距离,越负越异常scores = ocsvm.decision_function(X)print(f"最异常的 5 个点分数: {np.sort(scores)[:5].round(3)}")Mahalanobis 距离多变量异常检测
Section titled “Mahalanobis 距离多变量异常检测”from scipy.spatial.distance import cdistimport numpy as np
# 用正常数据计算均值和协方差mu = X_normal.mean(axis=0)cov = np.cov(X_normal.T)cov_inv = np.linalg.inv(cov)
# 计算每个点的 Mahalanobis 距离平方mahal_sq = cdist(X, mu.reshape(1, -1), metric='mahalanobis', VI=cov_inv) ** 2
# 卡方分布 99% 分位数作为阈值(自由度 = 特征数)from scipy.stats import chi2threshold = chi2.ppf(0.99, df=X.shape[1])labels = (mahal_sq > threshold).ravel()print(f"Mahalanobis 检测到 {labels.sum()} 个异常点(阈值 D² > {threshold:.3f})")Autoencoder 异常检测(PyTorch)
Section titled “Autoencoder 异常检测(PyTorch)”import torchimport torch.nn as nnimport numpy as npfrom sklearn.datasets import make_blobs
# 准备数据:只用正常数据训练X_normal, _ = make_blobs(n_samples=500, centers=1, n_features=10, random_state=42)X_outliers = np.random.uniform(low=-8, high=8, size=(20, 10))X_all = np.vstack([X_normal, X_outliers])
# 标准化from sklearn.preprocessing import StandardScalerscaler = StandardScaler()X_train = scaler.fit_transform(X_normal)X_eval = scaler.transform(X_all)
# 定义 Autoencoder:10 → 3 → 10(瓶颈维度 3)class Autoencoder(nn.Module): def __init__(self, input_dim=10, latent_dim=3): super().__init__() self.encoder = nn.Sequential( nn.Linear(input_dim, 8), nn.ReLU(), nn.Linear(8, latent_dim), ) self.decoder = nn.Sequential( nn.Linear(latent_dim, 8), nn.ReLU(), nn.Linear(8, input_dim), )
def forward(self, x): z = self.encoder(x) return self.decoder(z)
model = Autoencoder()criterion = nn.MSELoss()optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
# 只用正常数据训练X_tensor = torch.FloatTensor(X_train)for epoch in range(200): optimizer.zero_grad() recon = model(X_tensor) loss = criterion(recon, X_tensor) loss.backward() optimizer.step()
# 推理:计算重构误差作为异常分数model.eval()with torch.no_grad(): X_eval_tensor = torch.FloatTensor(X_eval) recon_all = model(X_eval_tensor) recon_errors = ((X_eval_tensor - recon_all) ** 2).mean(dim=1).numpy()
# 取误差最大的 20 个点作为异常threshold = np.percentile(recon_errors, 95) # 前 5% 为异常labels = recon_errors > thresholdprint(f"Autoencoder 检测到 {labels.sum()} 个异常点")print(f"异常分数最高: {recon_errors.max():.4f}, 正常数据平均分数: {recon_errors[:500].mean():.4f}")多算法对比(用 PyOD)
Section titled “多算法对比(用 PyOD)”PyOD 是专门的异常检测库,提供 50+ 种算法的统一接口。以下代码同时跑多种算法并比较结果:
# pip install pyodfrom pyod.models.iforest import IForestfrom pyod.models.lof import LOFfrom pyod.models.ocsvm import OCSVMfrom pyod.models.hbos import HBOSfrom pyod.models.ecod import ECOD   # 2022 年提出,无需调参import numpy as np
# 假设 X 已准备好(n_samples, n_features)algorithms = {    'Isolation Forest': IForest(contamination=0.05, random_state=42),    'LOF':              LOF(contamination=0.05, n_neighbors=20),    'One-class SVM':    OCSVM(contamination=0.05),    'HBOS':             HBOS(contamination=0.05),    # 直方图法,极快    'ECOD':             ECOD(contamination=0.05),    # 基于经验累积分布}
for name, clf in algorithms.items():    clf.fit(X)    labels = clf.labels_       # 0=正常, 1=异常    scores = clf.decision_scores_  # 原始异常分数    n_anomaly = labels.sum()    print(f"{name:20s}: 检测到 {n_anomaly:3d} 个异常,分数均值 {scores.mean():.3f}")
ECOD(Empirical Cumulative Outlier Detection) 是 2022 年提出的一种极简方法:它利用每个特征的经验累积分布函数,计算每个点在各维度上的尾部概率乘积。无需调参、训练复杂度 ,在很多基准上性能不输 Isolation Forest,适合作为快速基线。
- 先试简单的:数据维度低、分布近似正态 → 先试 3σ / 箱线图;维度中等 → Isolation Forest 是性价比最高的选择;维度高、数据量大 → 考虑 Autoencoder。
- contamination 参数很关键:它指定异常比例,直接决定阈值。不知道实际比例时,可以先用默认值跑,再根据业务调整——宁可多报(误报),不可漏报(漏检欺诈代价更大)。
- 异常检测评估指标:因为异常少且有标签的情况少,评估较难。有标签时看 Precision/Recall/F1(尤其 Recall,漏检代价高)和 ROC-AUC;无标签时看异常分数分布是否合理。
- 时序数据的异常检测:时间序列中的异常(突变、季节性偏离)需要特殊处理——先做时间序列分解(见时间序列分析)去趋势和季节性,再对残差做异常检测。
- 类别极度不平衡时也用异常检测思路:欺诈样本占比通常 < 1%,与其做监督分类(正负样本极度不平衡),不如用正常交易训练异常检测模型——这是思路转换的关键。
- 高维灾难(Curse of Dimensionality):维度很高时,距离和密度都变得不可靠(所有点对之间的距离趋于相同)。此时应先做特征选择或降维(PCA、UMAP),或选择对高维更鲁棒的方法(如 Isolation Forest、子空间方法 SOD)。
- 集成多算法提升鲁棒性:不同算法对不同类型的异常敏感度不同。实践中可以把多种算法的分数归一化后取平均或最大值——这叫异常检测集成(Ensemble Anomaly Detection),通常比单一算法更稳定。
- 注意数据漂移(Data Drift):正常模式会随时间变化(用户行为迁移、季节变化)。模型需要定期用最新正常数据重训,否则误报率会持续上升。
- 信用卡欺诈检测 → 银行/支付平台:实时分析每笔交易的金额、频率、地理位置、商户类型等特征,异常交易(异地大额、短时高频)被拦截或触发验证——Visa、Mastercard、支付宝的风控核心。2024 年全球信用卡欺诈损失估计超过 350 亿美元,异常检测是防线核心。
- 网络入侵检测 → 网络安全:监控网络流量特征(连接数、包大小、访问端口),异常流量(DDoS 攻击、端口扫描、数据外泄)自动告警——从传统规则引擎到机器学习异常检测,是安全行业的进化方向。
- 工业设备故障预警 → 制造业:传感器(温度、振动、压力)数据的异常模式预示设备即将故障——预测性维护(Predictive Maintenance)可提前安排检修,避免非计划停机,每年为工业节省数十亿成本。
- 医疗异常检测 → 辅助诊断:医学影像中的异常区域(X 光片中的可疑阴影)、心电图中的异常波形、检验指标的异常值——AI 辅助医生快速定位问题,提高诊断效率。
- 日志异常检测 → IT 运维(AIOps):服务器日志中的异常模式(错误突增、响应时间飙升)自动触发告警——AIOps 的核心能力,大型互联网公司每天处理 TB 级日志。Netflix、Uber 等公司使用异常检测来监控系统健康,在用户感知前发现问题。
- 视频异常检测 → 安防监控:利用 CNN(卷积神经网络)和 SRU(简单循环单元)分析视频流,自动识别打架、跌倒、闯入禁区等异常行为。2024 年 CVPR 上的 Self-Distilled Masked Auto-Encoder 方法展示了无需标注的自蒸馏视频异常检测新范式。
- IoT 异常检测 → 智能基础设施:物联网设备数量爆炸式增长,安全漏洞和故障检测变得极其重要。多阶段异常检测框架(空间聚类 + 密度聚类 + 局部敏感哈希)能处理 IoT 数据的海量、异构特征。
- 石油天然气管道监测 → 能源行业:传感器数据实时分析,检测传统方法容易遗漏的微小泄漏——既关乎设备安全,也关乎环境保护。
- AIGC 内容检测 → 内容安全:2025 年随着生成式 AI 普及,检测 AI 生成的虚假图像、视频(Deepfake)和文本成为新的异常检测应用场景——本质上也是”找出跟真实人类内容不一样的数据点”。
2025-2026 前沿进展
Section titled “2025-2026 前沿进展”异常检测领域在 2023-2025 年经历了深刻变革,以下是最值得关注的方向:
基础模型(Foundation Models)驱动的异常检测
Section titled “基础模型(Foundation Models)驱动的异常检测”大规模预训练模型(Foundation Models)正被广泛引入异常检测领域,尤其是视觉异常检测:
- CLIP-based 方法(如 WinCLIP,CVPR 2023):利用 CLIP 的图文对齐能力,通过文本提示(“a photo of a normal product” vs. “a photo of a defective product”)实现零样本(Zero-shot)异常检测——无需任何目标数据集的训练样本就能检测异常。这对制造业缺陷检测意义重大:新产品线不再需要重新标注和训练。
- 扩散模型(Diffusion Models)做重构:用预训练的扩散模型(如 Stable Diffusion)重构输入图像。正常图像被很好地还原,异常区域则出现重构偏差——本质上是用最先进的生成模型替代了传统 Autoencoder。2024 年的研究表明,扩散模型在分布外检测(OOD Detection)上优于判别式方法。
Transformer 与时间序列异常检测
Section titled “Transformer 与时间序列异常检测”Transformer 架构在时间序列异常检测上取得了突破:
- Anomaly Transformer(ICLR 2022):提出 Association Discrepancy 概念——用 Transformer 的自注意力机制建模时序关联,异常点的”先验关联”与”序列关联”之间存在显著差异。这个思路非常巧妙:不直接学”什么是异常”,而是学”异常点的注意力模式跟正常有什么不同”。
- TimesNet(ICLR 2023):将 1D 时间序列转换为 2D 张量(基于周期性),用 CNN 提取内部变化,在多个时序异常检测基准上达到 SOTA(State-of-the-Art)。
- 大语言模型(LLM)做时序异常检测:2024-2025 年的研究探索将时间序列数值转化为文本序列,直接输入 GPT-4 / LLaMA 等大模型进行异常判断。实验表明 LLM 的零样本时序异常检测能力出人意料地强,特别是在缺乏训练数据的冷启动场景。
自监督学习(Self-Supervised Learning)
Section titled “自监督学习(Self-Supervised Learning)”自监督学习成为异常检测的主流范式之一:
- PaDiM(PRCV 2021)/ PatchCore(CVPR 2022):用预训练的特征提取器(如 ResNet)提取正常图像的局部特征,构建特征记忆库。推理时比较测试图像与记忆库的距离——距离大的区域即为缺陷。PatchCore 在 MVTec AD 工业缺陷检测基准上达到 99%+ 的 AUROC。
- 掩码自编码器(Masked Autoencoder, MAE):随机遮盖输入的部分区域让模型重建,异常区域的重构误差更大。2024 年 CVPR 上的自蒸馏 MAE 方法将这一思路应用于视频异常检测。
可解释异常检测(Explainable Anomaly Detection)
Section titled “可解释异常检测(Explainable Anomaly Detection)”工业和医疗场景中,光给出异常分数不够,还需要解释”为什么异常”:
- SOD(Subspace Outlier Degree):识别出样本在哪些维度上正常、在哪些维度上偏离——告诉用户”异常出在第 3 和第 7 个特征上”。
- COP(Correlation Outlier Probabilities):计算一个误差向量,指出样本要移动到哪个位置才算正常——相当于给出了”修正建议”。
- SHAP / LIME 的适配:将通用的模型解释工具适配到异常检测模型上,给出每个特征对异常分数的贡献度。这在金融风控中尤其重要——监管要求模型必须给出可解释的拒绝理由。
量子机器学习初步探索
Section titled “量子机器学习初步探索”量子支持向量机(QSVM)使用量子核方法(如 ZZFeatureMap),将数据映射到高维量子特征空间进行异常检测分类。虽然目前受限于量子硬件规模(NISQ 时代),但随着量子硬件发展,量子异常检测在高维数据上展现出潜在优势。
算法选择决策指南
Section titled “算法选择决策指南”面对一个具体的异常检测任务,该选哪个算法?以下决策路径供参考:
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| scikit-learn | Python | 提供 IsolationForest、LOF、One-class SVM 等异常检测算法 |
| PyOD | Python | 专门异常检测库,提供 50+ 种算法的统一接口,含深度学习模型 |
| Anomalib | Python | Intel 开源的深度学习异常检测库,聚焦视觉缺陷检测,集成 PaDiM / PatchCore / WinCLIP 等 SOTA 模型 |
| Alibi Detect | Python | 聚焦数据漂移、对抗检测和时序异常的开源库,支持 TensorFlow / PyTorch |
| ADTK | Python | 专注时间序列异常检测的工具包,提供规则引擎和工作流编排 |
| Elastic ML | Java | Elastic Stack 内置的机器学习异常检测引擎 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 异常点 | Anomaly / Outlier | 偏离大多数数据正常分布模式的罕见数据点 |
| 点异常 | Point Anomaly | 单个数据点偏离正常范围,如一笔巨额欺诈交易 |
| 上下文异常 | Contextual Anomaly | 在特定上下文中才算异常,如夏天出现的低温 |
| 集合异常 | Collective Anomaly | 单个点正常但一组连续点构成异常模式,如心律不齐 |
| 局部异常因子 | LOF (Local Outlier Factor) | 衡量点局部密度与邻居密度的比值,密度低则可能是异常 |
| 孤立森林 | Isolation Forest | 通过随机划分的路径长度检测异常的树集成方法 |
| 重构误差 | Reconstruction Error | Autoencoder 输入与输出的差异,异常数据通常误差大 |
| 单类 SVM | One-class SVM | 只用正常类训练,学习包围正常数据的边界的 SVM 变体 |
| Mahalanobis 距离 | Mahalanobis Distance | 考虑协方差结构的距离度量,等价于白化后的欧氏距离 |
| 污染率 | Contamination | 数据集中异常样本的预期比例,用于设置检测阈值 |
| 误报率 | False Positive Rate | 正常数据被误判为异常的比例,影响用户体验 |
| 漏报率 | False Negative Rate | 异常数据被漏检为正常的比例,在风控场景代价极高 |
| 零样本检测 | Zero-shot Detection | 无需目标数据集训练样本即可检测异常,依赖预训练基础模型 |
| 分布外检测 | OOD Detection | 判断输入是否偏离训练数据分布,是异常检测在深度学习中的延伸 |
| 可达距离 | Reachability Distance | LOF 中”削峰”后的距离,避免极近距离点干扰密度估计 |
| 经验累积分布 | Empirical CDF | ECOD 算法的基础,用数据本身估计各维度的概率分布 |
- 统计方法谱系:3σ 原则(基于正态分布)→ 箱线图 / IQR 方法(Tukey 1977,不依赖分布假设)→ Grubbs 检验(假设检验框架下的异常点检验)→ Hotelling T²(多变量异常检测)。统计学是最早也最直觉的异常检测方法。
- 距离/密度方法谱系:k-NN 距离(简单的距离异常度)→ LOF(Breunig 2000,局部密度,经典论文)→ COF/LOCI/INFLO(LOF 变体)→ DBSCAN 噪声点(见聚类分析,密度聚类的天然副产品)。
- 隔离森林:Liu 2008/2012 提出,因为训练和预测都极快(O(n log n)),且不需要计算成对距离,是高维大数据异常检测的首选方法之一。
- 深度学习方法:Autoencoder 重构误差(Hawkins 2002 的异常检测理论)→ VAE 异常检测 → GANomaly(用 GAN 做异常检测)→ 时序领域 LSTM-AE(使用 LSTM 的自编码器检测时序异常)。深度学习适合高维复杂数据,但需要大量正常样本训练。
- 视觉异常检测 SOTA 综述:PaDiM(2021)→ PatchCore(2022,工业缺陷检测标杆)→ WinCLIP(2023,零样本异常检测)→ 扩散模型重构(2024)。这些方法在 MVTec AD 等基准上将 AUROC 推到 99% 以上。
- Transformer + 时序异常检测:Anomaly Transformer(2022,Association Discrepancy)→ TimesNet(2023,1D 转 2D 建模)→ LLM-based 时序分析(2024-2025,GPT-4 / Time-LLM 等)。Transformer 在多变量时序异常检测上已超越传统 LSTM 方法。
- 经典综述论文:Chandola 等人 2009 年发表在 ACM Computing Surveys 上的 “Anomaly detection: A survey” 是该领域被引用最多的综述,系统梳理了 2009 年前的所有主流方法,是理解领域全貌的最佳起点。