
归一化技术
归一化(Normalization)是现代深度学习模型训练中不可或缺的稳定剂。从 CNN 中的 BatchNorm 到 Transformer 中的 LayerNorm,再到当代大语言模型中的 RMSNorm——归一化层让深层网络的训练从”几乎不可能”变成了”常规操作”。本页系统讲解 BatchNorm、LayerNorm、RMSNorm、GroupNorm、InstanceNorm 五大归一化方法的原理、数学公式、差异和适用场景。
为什么需要归一化? 深层网络训练时,每一层的输入分布会随着前面层的参数更新而不断变化(这叫 Internal Covariate Shift,内部协变量偏移)。想象你在搭积木,底下每一层的位置都在微微晃动——你越往上搭越难放稳。归一化就是在每层之间加一块”稳定平台”,强制把激活值的均值和方差固定住,让训练更稳定、收敛更快。
假设一个特征张量(tensor)有四个维度:Batch(批) × Channel/Feature(通道/特征) × Height(高) × Width(宽)。不同的归一化方法的区别,仅仅在于沿哪些维度计算均值和方差——也就是”把哪些元素放在一起做归一化”。
- BatchNorm(批归一化):对每个通道,跨整个 batch 和所有空间位置计算统计量 → “一群人的某个特征一起对齐”。
- LayerNorm(层归一化):对每个样本,跨所有通道和空间位置计算统计量 → “一个人的所有特征一起对齐”。
- InstanceNorm(实例归一化): 对每个样本的每个通道,只在该通道的空间位置内计算统计量 → “一个人的某一个特征自己跟自己对齐”。
- GroupNorm(组归一化):把通道分成若干组,每个样本在组内跨通道 + 空间计算统计量 → “一个人的某一类特征一起对齐”。
- RMSNorm:LayerNorm 的简化版,只做方差归一化、不减均值 → “只管缩放幅度,不管中心位置”。
下图直观展示每种方法”沿哪些维度归一化”(蓝色高亮区域内的元素一起做归一化):
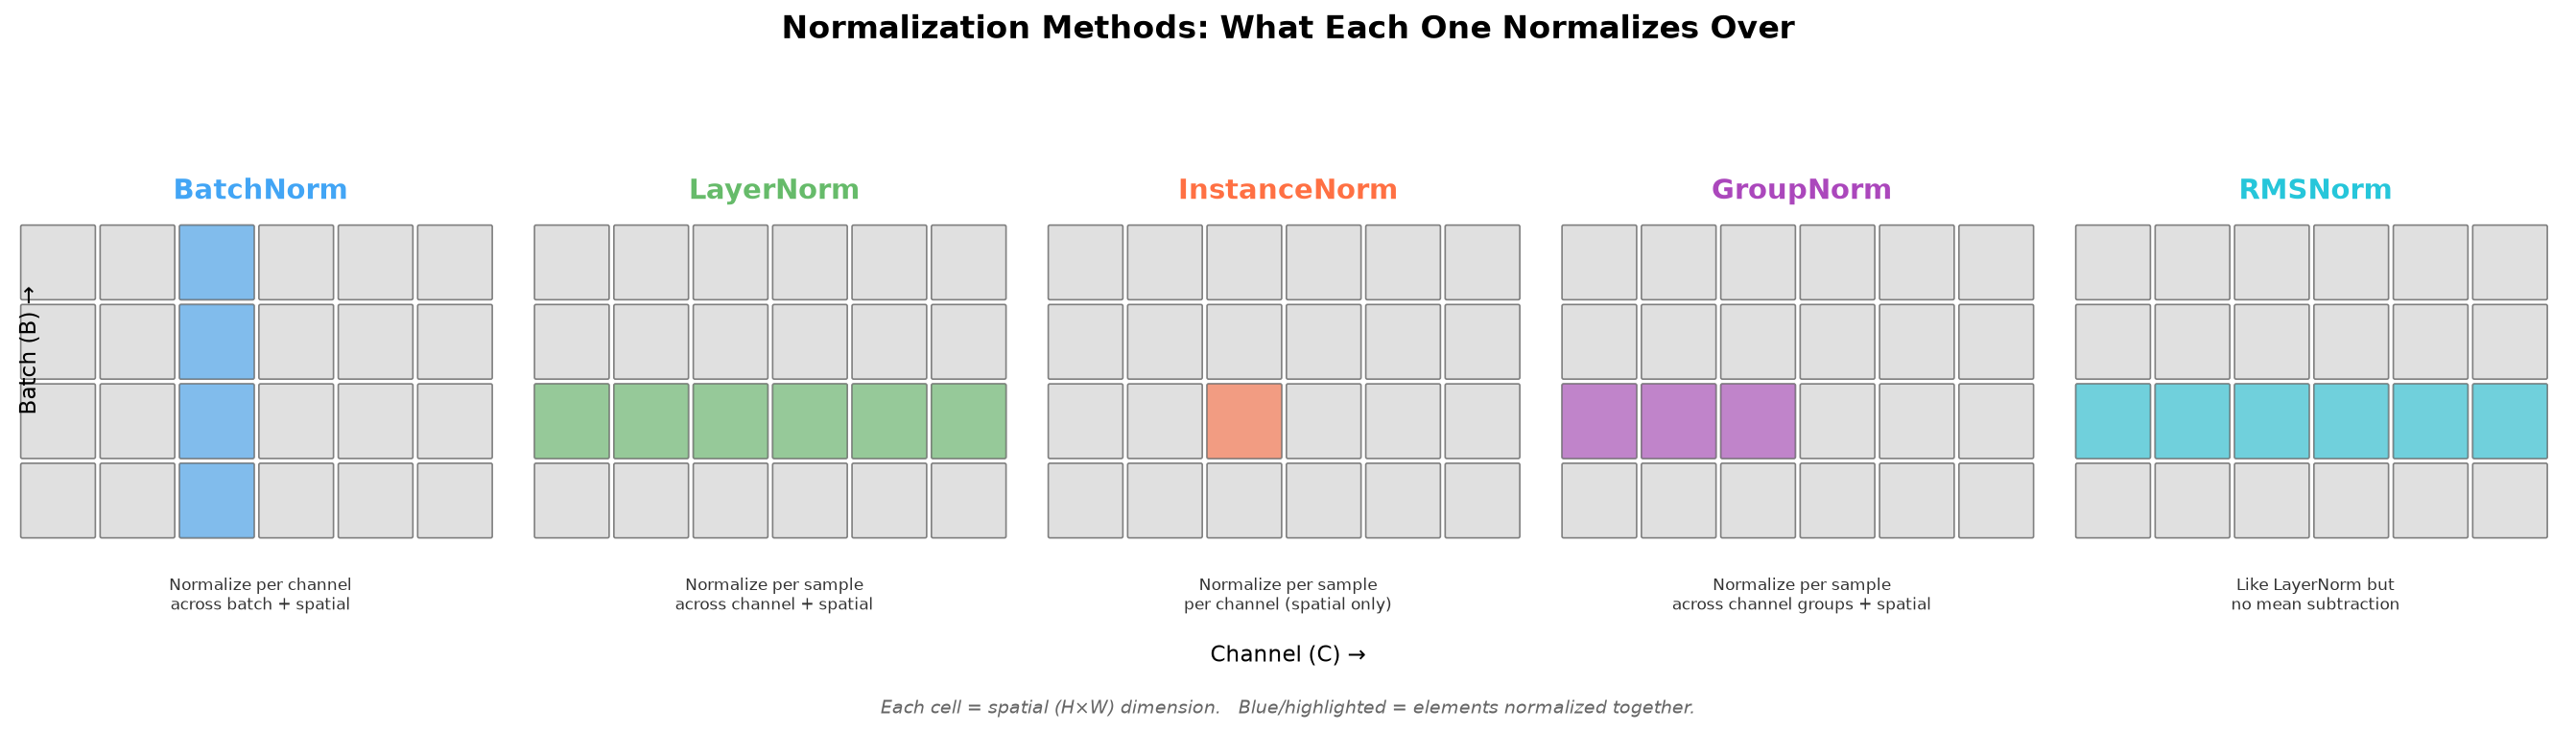
一句话总结:BatchNorm 对齐的是”不同样本之间的某个通道”,LayerNorm 对齐的是”同一个样本的所有通道”,区别仅此而已。但这个看似微小的选择,导致了截然不同的特性——BatchNorm 依赖 batch 大小,LayerNorm 不依赖;BatchNorm 在训练和推理时行为不同(推理用滑动平均统计量),LayerNorm 始终一致。
统一的归一化框架
Section titled “统一的归一化框架”所有归一化方法都可以用一个统一公式描述。设 是归一化时统计的元素集合(即”沿哪些维度做”),则:
其中:
- (缩放参数)和 (平移参数)是可学习参数,让网络有能力”撤销”归一化(如果归一化反而有害的话)。
- 是一个小常数(通常 ),防止除以零。
- 不同归一化方法的唯一区别就是 的选择不同。
为什么需要 和 ? 如果只有归一化操作,所有特征都被强制变成均值 0、方差 1 的分布,网络的表达能力会被严重限制。比如 Sigmoid 激活函数的线性区在 0 附近,如果归一化后所有值都挤在 0 附近,非线性就发挥不出来。 和 让网络自己学习”归一化到什么程度最好”——如果某层需要方差很大的激活值, 会学到一个大的缩放系数。
BatchNorm(批归一化)
Section titled “BatchNorm(批归一化)”BatchNorm 由 Ioffe & Szegedy 于 2015 年提出,是深度学习训练史上的里程碑之一。它直接促成了 ResNet 等 100+ 层超深网络的训练成功。
公式:对于形状为 的特征图,BatchNorm 沿 batch 维度 和空间维度 计算统计量(每个通道 独立计算):
训练 vs 推理的关键区别:
- 训练时:用当前 batch 的统计量 做归一化,同时用指数移动平均(EMA)维护一组”全局统计量” :
- 推理时:不再计算 batch 统计量(因为推理可能只有一张图,batch=1,无法计算有意义的统计量),改用训练阶段积累的全局统计量 。
这个训练/推理行为不一致是 BatchNorm 最容易踩坑的地方。在分布式训练、小 batch 或在线推理场景下,BatchNorm 的统计量不一致可能导致严重的性能下降。
LayerNorm(层归一化)
Section titled “LayerNorm(层归一化)”LayerNorm 由 Ba 等人于 2016 年提出,是 Transformer 架构的标准归一化方式。它的核心优势是不依赖 batch 大小——因为它只在单个样本内部计算统计量。
公式:对于形状为 的特征图,LayerNorm 沿通道维度 和空间维度 计算统计量(每个样本 独立计算):
在 Transformer 中,特征形状通常是 (batch × 序列长度 × 隐藏维度),LayerNorm 沿最后一维 做归一化——即对每个 token 的隐藏表示向量做归一化。
为什么 Transformer 用 LayerNorm 而不是 BatchNorm? 三个原因:(1) 序列长度可变,不同样本的序列长度不同,BatchNorm 跨样本对齐困难;(2) 推理时常 batch=1,BatchNorm 统计量不可靠;(3) LayerNorm 训练/推理行为一致,没有”双重模式”问题。
RMSNorm(Root Mean Square Normalization)
Section titled “RMSNorm(Root Mean Square Normalization)”RMSNorm 由 Zhang & Sennrich 于 2019 年提出,在 LLaMA、Qwen、Mistral 等现代大语言模型中被广泛采用。它是 LayerNorm 的计算效率优化版——去掉了均值减法和偏移参数 。
公式:
与 LayerNorm 的区别:
| 特性 | LayerNorm | RMSNorm |
|---|---|---|
| 减均值 | ✅ 是 | ❌ 否 |
| 归一化 | 均值 0、方差 1 | 方差 1(RMS 为 1) |
| 可学习参数 | 仅 | |
| 计算量 | 2 次统计(均值 + 方差) | 1 次统计(RMS) |
| 相对速度 | 慢 ~7-64% | 快 |
为什么 RMSNorm 效果几乎不差但更受欢迎? 实验表明,在高维隐藏向量中,激活值的均值通常已经很接近 0(尤其是经过注意力机制后的残差连接路径),所以”减均值”这一步的贡献很小。去掉它既省了计算,又减少了参数,在超大规模 LLM 训练中省下的算力是可观的。LLaMA 团队的实验显示 RMSNorm 和 LayerNorm 在最终质量上几乎无差别。
GroupNorm(组归一化)
Section titled “GroupNorm(组归一化)”GroupNorm 由 Wu & He 于 2018 年提出,专为 小 batch 场景(如高分辨率图像分割、检测)设计。它把通道分成 组,每组内做类 LayerNorm 的归一化。
公式:设通道数为 ,分为 组,每组 个通道。对样本 的第 组:
当 时,GroupNorm 等价于 LayerNorm;当 时,GroupNorm 等价于 InstanceNorm。它在这两者之间提供了灵活的折中。
InstanceNorm(实例归一化)
Section titled “InstanceNorm(实例归一化)”InstanceNorm 最初用于图像生成(StyleGAN),对每个样本的每个通道独立做归一化——即”风格归一化”。
公式:对样本 的通道 :
InstanceNorm 等价于 “batch=1 的 BatchNorm”。它去除了每个通道的全局对比度信息(均值和方差),因此在风格迁移中非常有用——因为”风格”很大程度上编码在通道的全局统计量中。
五种方法对比总表
Section titled “五种方法对比总表”| 方法 | 归一化维度 | 依赖 batch? | 训练/推理一致? | 典型场景 |
|---|---|---|---|---|
| BatchNorm | batch + 空间 | ✅ 是 | ❌ 否 | CNN 分类(ResNet、CNN) |
| LayerNorm | 通道 + 空间 | ❌ 否 | ✅ 是 | Transformer、RNN |
| RMSNorm | 通道(无均值) | ❌ 否 | ✅ 是 | 现代 LLM(LLaMA、Qwen) |
| GroupNorm | 通道组 + 空间 | ❌ 否 | ✅ 是 | 小 batch 检测/分割 |
| InstanceNorm | 空间(单通道) | ❌ 否 | ✅ 是 | 风格迁移、图像生成 |
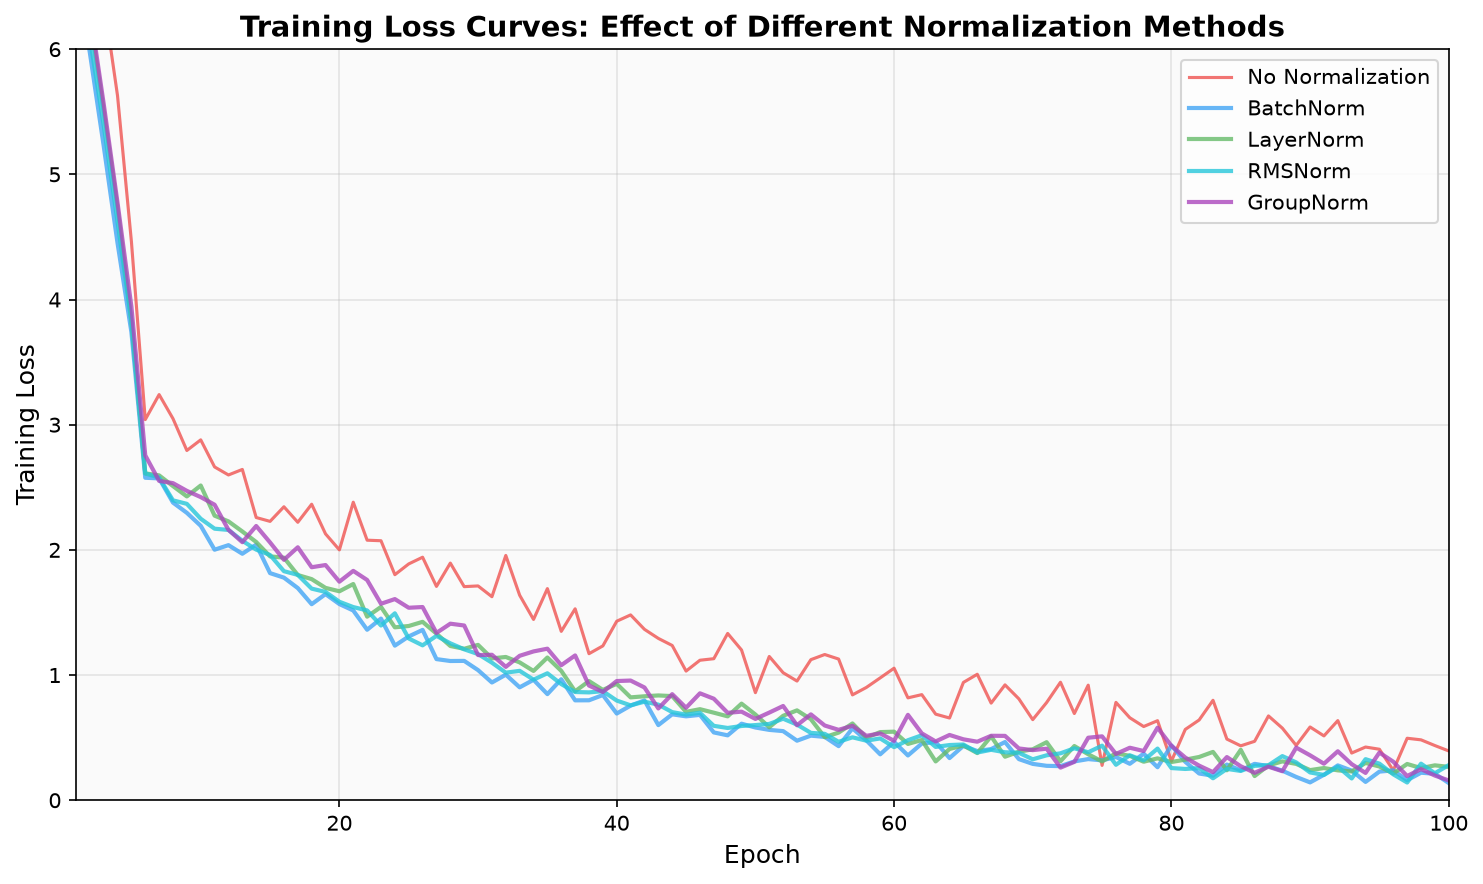
下图展示了使用不同归一化方法时模型训练的稳定性差异:
PyTorch 代码示例
Section titled “PyTorch 代码示例”BatchNorm
Section titled “BatchNorm”import torchimport torch.nn as nn
# 2D 卷积特征图的 BatchNorm# num_features = 通道数bn = nn.BatchNorm2d(num_features=64, eps=1e-5, momentum=0.1)
# 在 ResNet 的残差块中使用class ResidualBlock(nn.Module): def __init__(self, channels): super().__init__() self.conv1 = nn.Conv2d(channels, channels, 3, padding=1, bias=False) self.bn1 = nn.BatchNorm2d(channels) self.conv2 = nn.Conv2d(channels, channels, 3, padding=1, bias=False) self.bn2 = nn.BatchNorm2d(channels) self.relu = nn.ReLU(inplace=True)
def forward(self, x): identity = x out = self.relu(self.bn1(self.conv1(x))) out = self.bn2(self.conv2(out)) out += identity # 残差连接 return self.relu(out)
# 全连接层的 BatchNormbn_linear = nn.BatchNorm1d(num_features=512)
# 注意:推理前务必调用 model.eval() 切换到推理模式!model.eval() # 使用全局移动平均统计量model.train() # 恢复训练模式,使用当前 batch 统计量LayerNorm
Section titled “LayerNorm”import torchimport torch.nn as nn
# Transformer 中的 LayerNorm:对最后一个维度做归一化# normalized_shape 必须与特征最后一维的大小匹配ln = nn.LayerNorm(normalized_element=512)
# 在 Transformer 块中使用(Post-Norm 经典写法)class TransformerBlock(nn.Module): def __init__(self, d_model=512, n_heads=8): super().__init__() self.attention = nn.MultiheadAttention(d_model, n_heads, batch_first=True) self.ln1 = nn.LayerNorm(d_model) self.ffn = nn.Sequential( nn.Linear(d_model, d_model * 4), nn.GELU(), nn.Linear(d_model * 4, d_model), ) self.ln2 = nn.LayerNorm(d_model)
def forward(self, x): # Post-Norm: 子层 → 残差 → 归一化 attn_out, _ = self.attention(x, x, x) x = self.ln1(x + attn_out) ffn_out = self.ffn(x) x = self.ln2(x + ffn_out) return xRMSNorm(手动实现)
Section titled “RMSNorm(手动实现)”import torchimport torch.nn as nn
class RMSNorm(nn.Module): def __init__(self, d_model, eps=1e-6): super().__init__() self.eps = eps self.weight = nn.Parameter(torch.ones(d_model)) # 只有 γ,没有 β
def forward(self, x): # 计算 RMS: sqrt(mean(x^2)) rms = torch.rsqrt(x.pow(2).mean(dim=-1, keepdim=True) + self.eps) return self.weight * x * rms # 不减均值,直接用 RMS 归一化
# 使用方式与 LayerNorm 完全相同rms_norm = RMSNorm(d_model=512)normalized = rms_norm(x)GroupNorm 和 InstanceNorm
Section titled “GroupNorm 和 InstanceNorm”import torch.nn as nn
# GroupNorm: 将 64 个通道分成 32 组,每组 2 个通道gn = nn.GroupNorm(num_groups=32, num_channels=64)
# InstanceNorm2d: 等价于 GroupNorm(num_groups=num_channels)in_norm = nn.InstanceNorm2d(num_features=64)
# InstanceNorm 常用于风格迁移# 注意:InstanceNorm2d 默认 affine=False(无 γ, β)# 如果需要可学习参数,设置 affine=Truein_norm_affine = nn.InstanceNorm2d(64, affine=True, track_running_stats=True)Pre-Norm vs Post-Norm
Section titled “Pre-Norm vs Post-Norm”归一化层在残差连接中的位置是一个重要的架构选择:
# Post-Norm(原始 Transformer 论文):# output = LayerNorm(x + Sublayer(x))# 问题:梯度在深层网络中容易消失,训练困难,需要 warmup
# Pre-Norm(GPT-2、LLaMA 等现代模型):# output = x + Sublayer(LayerNorm(x))# 优势:残差路径上没有归一化,梯度流动更顺畅,训练更稳定
class PreNormTransformerBlock(nn.Module):    def __init__(self, d_model=512):        super().__init__()        self.ln1 = nn.LayerNorm(d_model)        self.attention = nn.MultiheadAttention(d_model, 8, batch_first=True)        self.ln2 = nn.LayerNorm(d_model)        self.ffn = nn.Sequential(            nn.Linear(d_model, d_model * 4),            nn.GELU(),            nn.Linear(d_model * 4, d_model),        )
    def forward(self, x):        # Pre-Norm: 先归一化,再做子层,最后加残差        attn_out, _ = self.attention(self.ln1(x), self.ln1(x), self.ln1(x))        x = x + attn_out        x = x + self.ffn(self.ln2(x))        return x
Pre-Norm vs Post-Norm 的直觉:Post-Norm 把残差路径也归一化了,相当于在信息高速公路上设了收费站——深层网络的梯度传递受阻。Pre-Norm 让残差路径保持”原汁原味”,归一化只在旁路(子层)上做,信息高速公路一路畅通。代价是 Pre-Norm 的理论表达力略弱,但训练稳定性带来的实际收益远大于此。
| 场景 | 推荐方法 | 原因 |
|---|---|---|
| CNN 图像分类(大 batch) | BatchNorm | 经典选择,精度最优 |
| CNN 小 batch(检测、分割) | GroupNorm | 不依赖 batch 大小 |
| Transformer / NLP | LayerNorm 或 RMSNorm | 序列变长、batch 小 |
| 大语言模型(LLM) | RMSNorm | 计算高效,效果相当 |
| 风格迁移 / 图像生成 | InstanceNorm | 去除风格统计量 |
- BatchNorm 在 batch=1 时的问题:推理时 batch=1 不影响结果(用全局统计量),但训练时 batch 太小(如 ≤ 4)会导致统计量噪声过大,训练不稳定。解决方案:SyncBN(跨 GPU 同步 BN)或 GroupNorm。
- 忘记
model.eval():推理前忘记切换到 eval 模式,BatchNorm 会用当前 batch 统计量而非全局统计量,结果可能异常。PyTorch Lightning 等框架会自动管理,但裸 PyTorch 需要手动处理。 - 归一化层和 Dropout 的交互:两者都影响激活值分布,同时使用时要仔细调整位置和比例。一般建议在归一化之后、激活函数之前加 Dropout。
- 冻结 BN 统计量做微调:微调(Fine-tuning)时如果只改少量参数,应冻结 BatchNorm 的统计量(
bn.eval()),否则小 batch 微调会污染全局统计量。
最新进展(2024-2025)
Section titled “最新进展(2024-2025)”RMSNorm 成为大语言模型事实标准
Section titled “RMSNorm 成为大语言模型事实标准”2024-2025 年发布的几乎所有主流大语言模型——LLaMA 3/4、Qwen 2.5/3、Mistral、DeepSeek-V3、Gemma 2——都采用 RMSNorm 而非 LayerNorm。这一趋势始于 LLaMA(2023),目前已完全确立。RMSNorm 的优势在超大规模训练(千亿参数)中尤其显著:省掉均值计算带来的速度提升在大规模集群上可累积为可观的训练成本节约。
DeepNorm:超深网络的归一化
Section titled “DeepNorm:超深网络的归一化”DeepNorm(Microsoft, 2023)通过调整归一化的缩放因子,使得残差路径的梯度在超深网络(1000+ 层)中也能稳定传播,已用于训练超深 Transformer。
DyT(Dynamic Tanh):取代归一化层?
Section titled “DyT(Dynamic Tanh):取代归一化层?”2025 年初,Meta 提出 Dynamic Tanh(DyT)——用一个简单的可学习标量 的 tanh(tx) 替代整个归一化层。实验显示 DyT 在多种架构(Transformer、CNN、ResNet、ViT)上能达到与归一化层相当甚至更好的效果,且不需要计算 batch 统计量,计算量极低。这一工作重新点燃了”归一化到底为什么有效”的理论讨论——DyT 的成功暗示,归一化的核心作用可能不是”减少协变量偏移”,而是”约束激活值的范围”(tanh 也在做这件事)。
TransNormerLLM 与在线归一化
Section titled “TransNormerLLM 与在线归一化”在线归一化(Online Normalization)技术在大模型训练中获得关注——不再维护滑动平均统计量,而是在前向传播过程中动态估计。这类方法在超长序列训练和分布式训练中提供了更好的数值稳定性。
Sandwich Norm / RootNorm
Section titled “Sandwich Norm / RootNorm”研究者发现将归一化层放在子层前后(Sandwich Norm: Norm → Sublayer → Norm),在部分任务上比 Pre-Norm 或 Post-Norm 更稳定。QK-Norm(在注意力的 Q 和 K 向量上加额外归一化)也被证明能稳定大模型训练时的注意力分数。
归一化技术看似简单——就是”减均值、除标准差”——但它解决了深度学习训练中最核心的数值稳定性问题。核心选型逻辑只有一条:如果你的场景 batch 大小不固定或偏小(NLP、LLM),选 LayerNorm / RMSNorm;如果 batch 大小稳定且较大(CV 分类),选 BatchNorm。对于现代大模型实践者,RMSNorm + Pre-Norm 已经是默认配置。
延伸阅读:归一化与 Transformer 架构紧密相关;CNN 中的 BatchNorm 用法见 CNN 和 ResNet;注意力机制详解见 注意力机制。