
量化与加速
本页深入讲解模型部署中最关键的两类优化技术:量化(Quantization)——降低数值精度以换取速度和显存;加速(Acceleration)——通过算法和系统创新提升推理吞吐。这些技术是 CV 模型部署和 LLM 模型部署共同的底层基础,也是 GPU 与多卡基础在推理场景的直接应用。
量化:用更少的比特表示相同的含义
Section titled “量化:用更少的比特表示相同的含义”想象你有一张 1024×1024 的高清照片,上传到微信后变成 256×256 的缩略图——文件小了 16 倍,但你依然能认出照片里是谁。量化做的事情完全一样:把 32 位浮点数(FP32)压缩成 16 位(FP16)、8 位(INT8)甚至 4 位(INT4),在”足够精确”和”足够快”之间找到最佳平衡点。
- 精度(Precision):每个数值用多少比特存储。FP32 用 32 比特,INT8 只用 8 比特——显存占用直接降到 1/4。
- 速度(Speedup):低精度运算更快。GPU 的 Tensor Core 对 INT8 矩阵乘法的吞吐是 FP32 的 4–8 倍,INT4 更可达 10–16 倍。
- 代价(Accuracy Loss):压缩必然丢信息,关键在于”丢得值不值”。
为什么量化有效? 神经网络的权重和激活值通常集中在一个较窄的数值范围内(近似高斯分布),极端值很少。量化就是把这个”有效范围”映射到低精度格式的表示范围内,丢弃的是那些”几乎不影响输出”的微小差异。这类似于音频的 MP3 压缩——去掉人耳听不到的频率,文件大幅缩小但听感几乎不变。
加速:不只是算得快,更是算得巧
Section titled “加速:不只是算得快,更是算得巧”量化解决的是”单次运算更快”,加速技术解决的是”整体系统更高效”:
- Continuous Batching:让不同请求在同一批里各自独立地来去,GPU 不再因等最慢的请求而空转。
- PagedAttention:把 KV Cache 切成固定大小的块(page),像操作系统的虚拟内存一样管理,消除显存碎片。
- Speculative Decoding:用一个小模型”猜”几个词,大模型只需验证——猜对了就白赚几个词的吞吐。
精度格式详解
Section titled “精度格式详解”数值格式谱系:FP32 → FP16 → BF16 → FP8 → INT8 → INT4
Section titled “数值格式谱系:FP32 → FP16 → BF16 → FP8 → INT8 → INT4”| 格式 | 总比特 | 指数位 | 尾数位 | 动态范围 | 典型用途 | 硬件支持 |
|---|---|---|---|---|---|---|
| FP32 | 32 | 8 | 23 | ±3.4×10³⁸ | 训练基准、高精度推理 | 所有 GPU |
| FP16 | 16 | 5 | 10 | ±65504 | 混合精度训练、推理 | Volta+ |
| BF16 | 16 | 8 | 7 | ±3.4×10³⁸ | LLM 训练与推理 | Ampere+ |
| FP8 (E4M3) | 8 | 4 | 3 | ±448 | 推理权重与激活 | Hopper+ |
| FP8 (E5M2) | 8 | 5 | 2 | ±57344 | 推理梯度 | Hopper+ |
| INT8 | 8 | — | 8 | [-128, 127] | CV 模型推理 | 所有 GPU |
| INT4 | 4 | — | 4 | [-8, 7] | LLM 权重量化 | Ampere+ |
FP16 vs BF16:两者都是 16 位,但策略截然不同。FP16 尾数更多(10 位),精度高但动态范围小——训练时容易溢出。BF16 保留了 FP32 的 8 位指数(动态范围相同),牺牲尾数精度(仅 7 位)——对 LLM 来说,范围比精度更重要,因为注意力分数的方差极大。现代 LLM 训练几乎都使用 BF16。
浮点数的数学表示
Section titled “浮点数的数学表示”一个浮点数 由三部分组成:符号位 、指数 、尾数 :
其中 ( 是指数位数)。以 FP32 为例,,:
FP16 的 bias = ,最大可表示值为 。当梯度超过此值就会 overflow(变成 inf),这就是 FP16 训练需要 梯度缩放(Loss Scaling) 的原因:
先放大 loss 使小梯度进入 FP16 可表示范围,反传后再除回 恢复。BF16 动态范围与 FP32 相同(8 位指数),因此不需要梯度缩放。
FP8:推理的新标准
Section titled “FP8:推理的新标准”FP8 有两种变体,适用于不同场景:
- E4M3(4 位指数 + 3 位尾数):精度更高(±448),动态范围适中——适合前向推理的权重和激活。
- E5M2(5 位指数 + 2 位尾数):动态范围更大(±57344),精度更低——适合反向传播的梯度。
NVIDIA Hopper 架构(H100/H200)原生支持 FP8,其 Transformer Engine 可自动在 FP8 和 BF16 之间切换。相比 INT8,FP8 的最大优势是不需要校准数据集——浮点格式天然保留了数值的相对大小关系,量化误差更可控。
INT8 量化原理
Section titled “INT8 量化原理”INT8 量化将浮点张量映射到 的整数范围。设浮点值 的量化参数为缩放因子 和零点 :
反量化(dequantize):
缩放因子 由浮点张量的实际范围决定:
对称量化 vs 非对称量化:对称量化强制 ,数值范围 ,计算更简单(矩阵乘法中零点抵消),适合权重。非对称量化允许 ,适合分布不对称的激活值(如 ReLU 后只有正值)。
LLM 量化算法
Section titled “LLM 量化算法”LLM 的量化比 CV 模型复杂得多——不是因为算法更难,而是因为 LLM 的权重分布有特殊性:少量”离群值(outliers)“(数值特别大的权重)对推理精度影响极大,简单量化会把它们截断导致精度暴跌。
AWQ(Activation-aware Weight Quantization)
Section titled “AWQ(Activation-aware Weight Quantization)”核心思想:不是所有权重都同等重要——根据激活值的大小来判断哪些权重要保护。
AWQ 的出发点:一个权重 的重要性取决于它与激活值 的乘积 。即使 很大,如果 总是很小,量化 也不影响输出。反之,如果 很大(离群通道),对应的 即使不大也需要保护。
AWQ 引入一个缩放因子 ,对重要通道的权重点乘放大后再量化:
具体做法:通过网格搜索找到最优的 (仅对前 1% 最重要的通道做缩放),然后对调整后的权重做分组量化(group-wise quantization,通常 group size = 128)。
效果:INT4 权重量化下,AWQ 几乎不掉精度(< 1% drop),且推理速度优于 GPTQ(因为不依赖实时反量化中的复杂重排序)。
GPTQ(Generalized Post-Training Quantization)
Section titled “GPTQ(Generalized Post-Training Quantization)”核心思想:逐层用二阶信息(Hessian 矩阵)做量化误差补偿。
GPTQ 基于 OBQ(Optimal Brain Quantization)框架——量化某个权重后,微调同一行中其余权重来补偿误差。用 Hessian 矩阵 的逆来决定补偿方向:
其中 是被量化的权重, 是 Hessian 逆矩阵的第 列。GPTQ 的关键创新是用Cholesky 分解来稳定地批量计算 ,让逐列量化过程可以高效进行。
效果:GPTQ 在 3-bit/4-bit 下表现优秀,但量化过程较慢(需要反传计算 Hessian)。推理时需要配套的 fused kernel 来做实时反量化。
GGUF(GPT-Generated Unified Format)
Section titled “GGUF(GPT-Generated Unified Format)”GGUF 是 llama.cpp 的原生格式,不是一种量化算法,而是一个容器格式,内部预存了多种量化级别的权重。核心特点:
- CPU 友好:权重以 SIMD 友好的方式排列,支持 AVX2 / AVX-512 / ARM NEON 指令集加速。
- 多级量化混合:不同层可使用不同精度。最常用的
Q4_K_M将注意力层保持较高精度,其余层用 4-bit。 - k-quant 方案:llama.cpp 自创的量化方法,将权重分成小块(super-block),每块有自己的缩放因子。常见级别:
| 量化级别 | 比特/权重 | 显存占用 (7B) | 精度损失 | 适用场景 |
|---|---|---|---|---|
| F16 | 16 | 13.5 GB | 0% | 基准对比 |
| Q8_0 | 8.5 | 7.2 GB | < 0.5% | 高精度 CPU 推理 |
| Q6_K | 6.6 | 5.5 GB | < 1% | 质量优先 |
| Q5_K_M | 5.5 | 4.8 GB | ~1% | 质量与速度平衡 |
| Q4_K_M | 4.8 | 4.1 GB | ~1.5% | 最常用 |
| Q4_0 | 4.5 | 3.8 GB | ~3% | 极致压缩 |
| Q3_K_M | 3.9 | 3.3 GB | ~4% | 低端设备 |
| Q2_K | 2.6 | 2.7 GB | ~7%+ | 极端省内存 |
三种方法对比
Section titled “三种方法对比”| 维度 | AWQ | GPTQ | GGUF (k-quant) |
|---|---|---|---|
| 量化类型 | 仅权重量化 | 仅权重量化 | 仅权重量化 |
| 精度 (4-bit) | ★★★★★ | ★★★★☆ | ★★★☆☆ |
| 推理速度 | ★★★★☆ | ★★★☆☆ | ★★★★★ (CPU) |
| 量化速度 | 快 | 慢 | 快 |
| 依赖校准数据 | 需要(少量) | 需要 | 不需要 |
| 主要生态 | vLLM, Transformers | ExLlamaV2, Transformers | llama.cpp, Ollama |
| 最佳场景 | GPU 服务部署 | GPU 极致压缩 | CPU/端侧部署 |
量化方法精度-速度 Pareto 图
Section titled “量化方法精度-速度 Pareto 图”下图展示了不同量化方法在精度(相对于 FP32 基准的百分比)与推理加速比之间的权衡关系:
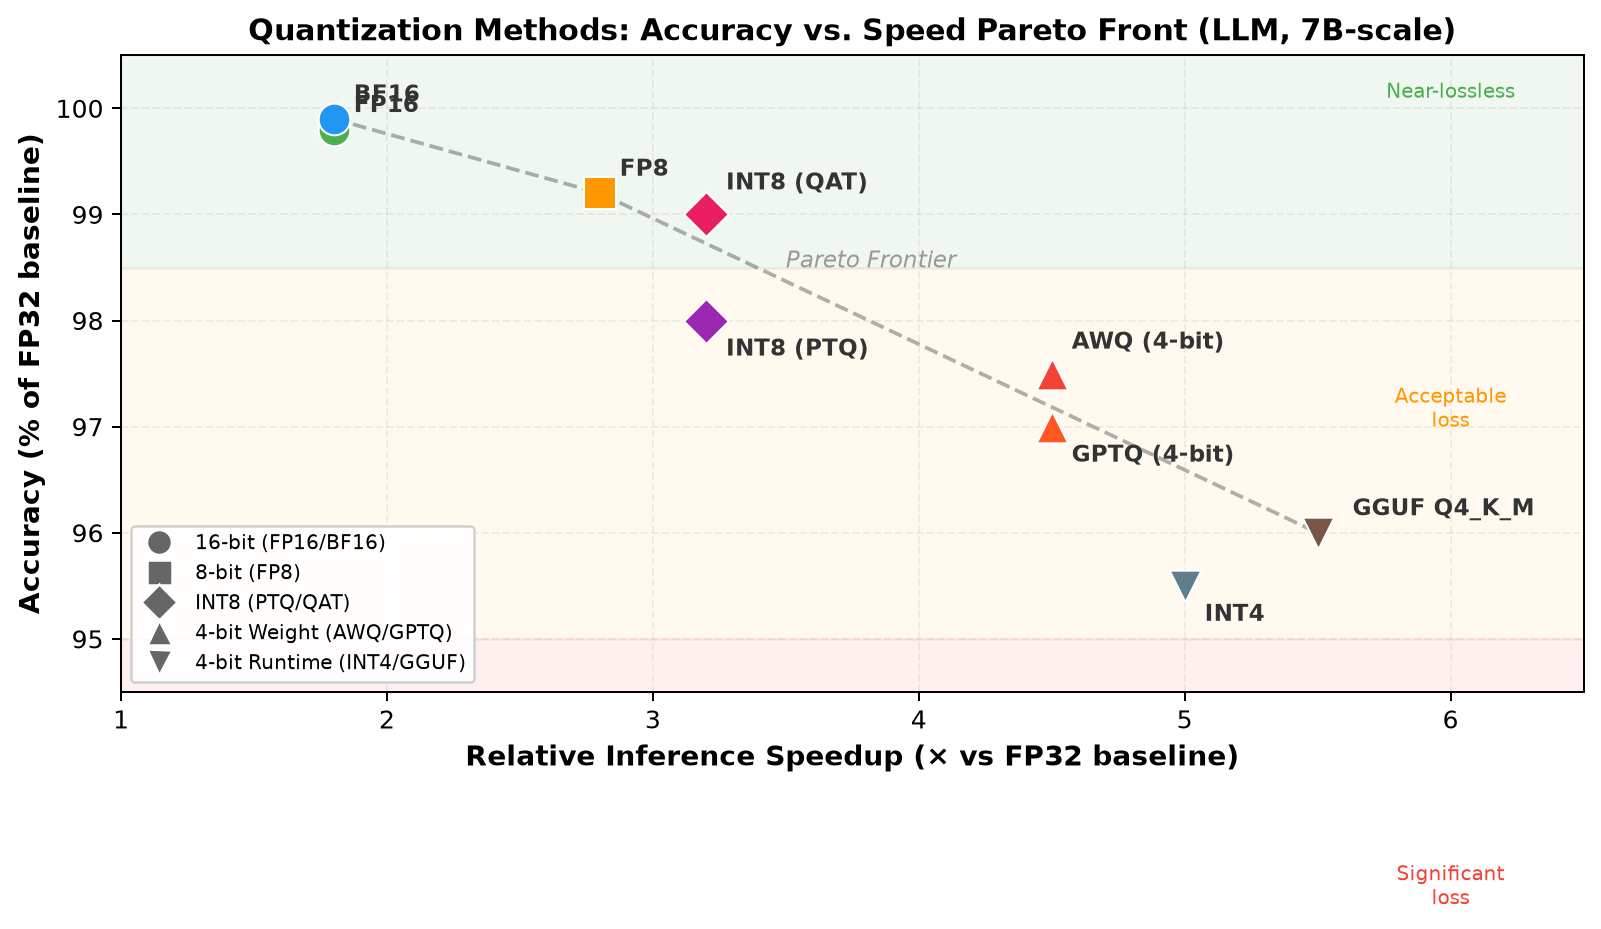
图中每个点代表一种量化方案。Pareto 前沿(虚线连接的点)表示在不牺牲另一个指标的前提下无法改善任一指标的最优方案。选择量化方法时,先确定你的精度底线(如 97% 以上),然后在前沿上找对应的最大加速比。
KV Cache 量化
Section titled “KV Cache 量化”LLM 推理时,KV Cache(详见 LLM 模型部署)是显存的主要消耗者。对于长序列请求,KV Cache 的显存占用远超模型权重本身。
KV Cache 显存公式
Section titled “KV Cache 显存公式”对于 层、每层 个注意力头、每头维度 的模型,序列长度 、batch size 的 KV Cache 显存为:
以 Llama-3-70B 为例(, , , FP16):单个请求在序列长度 4096 时的 KV Cache = GB。Batch 16 时就是 171 GB——比模型权重(~140GB FP16)还大。
KV Cache INT8 / INT4 量化
Section titled “KV Cache INT8 / INT4 量化”将 KV Cache 从 FP16 量化到 INT8,显存直接减半:
KV Cache 量化的特殊之处:Key 和 Value 的分布特性不同。
- Key 的分布中有明显的离群通道(outlier channels),适合按通道量化(per-channel quantization)。
- Value 的分布相对均匀,适合按 token 量化(per-token quantization)。
vLLM 从 0.5.x 版本开始支持 KV Cache INT8 量化,配置方式:
from vllm import LLM, SamplingParams
# 启用 KV Cache INT8 量化llm = LLM(    model="meta-llama/Meta-Llama-3-70B",    kv_cache_dtype="int8",         # 或 "fp8" (Hopper GPU)    quantization="awq",             # 权重量化方法    max_model_len=8192,    gpu_memory_utilization=0.9,)
# fp8 选项(需要 Hopper 架构 H100/H200)# kv_cache_dtype="fp8"# 配合 "fp8" KV Cache,长上下文场景吞吐可提升 40%+
KV Cache FP8 量化:在 NVIDIA Hopper 架构上,FP8 格式比 INT8 更适合 KV Cache——因为 KV 值的动态范围较大,浮点格式比定点格式能更好地保持数值精度。实测在长上下文(32K+)场景下,FP8 KV Cache 几乎无精度损失。
Continuous Batching
Section titled “Continuous Batching”问题:Static Batching 的 GPU 浪废
Section titled “问题:Static Batching 的 GPU 浪废”传统批处理(Static Batching)把多个请求组成一个 batch 一起送入模型。问题是:LLM 是自回归生成,不同请求的输出长度可能差几十倍。一个 10 个词的短回答和一个 500 词的长回答在同一个 batch 里——短回答生成完后,GPU 必须空等长回答完成才能接收新请求。
Continuous Batching 原理
Section titled “Continuous Batching 原理”Continuous Batching(又称 In-flight Batching 或 Iteration-level Batching)的核心思想:不是在请求级别做 batching,而是在每个解码步(iteration)级别做。
具体机制:
- 请求级 slot 管理:维护 个固定 slot(由显存容量决定)。每个 slot 独立持有自己的 KV Cache。
- 每步检查:每个解码步后检查各 slot——已完成的请求移出,等待队列中的新请求立即插入。
- 无等待对齐:新请求在下一个 prefill 步加入,与正在解码的请求共享同一次前向计算。
这就像超市收银台:Static Batching 是”凑齐 10 个人的购物车一起结账,等最后一个人结完才放下一个人”;Continuous Batching 是”每个人买完就走,立刻让下一个排队的人上来”。吞吐量的提升是数量级的。
数学建模:吞吐提升
Section titled “数学建模:吞吐提升”设 batch size = ,请求 的生成长度为 。Static Batching 的总计算步数为 ;Continuous Batching 的总计算步数为 (请求被均匀填充到各步中)。当长度方差大时( 差异显著),加速比可达 2–4 倍。
PagedAttention
Section titled “PagedAttention”问题:KV Cache 的显存碎片
Section titled “问题:KV Cache 的显存碎片”传统 LLM 推理为每个请求预分配连续的 KV Cache 显存空间(大小 = max_seq_len × layers × ...)。这带来两个问题:
- 内部碎片(internal fragmentation):实际生成的长度通常远小于
max_seq_len,预分配空间的 60–80% 被浪费。 - 外部碎片(external fragmentation):频繁分配/释放不同大小的连续块,显存被切割成碎片。
PagedAttention:虚拟内存类比
Section titled “PagedAttention:虚拟内存类比”PagedAttention 的灵感来自操作系统的分页内存管理(Paged Virtual Memory):
核心设计:
- Block(页):KV Cache 被切成固定大小的 block(vLLM 中默认 16 个 token 的 KV 值)。
- Block Table(页表):每个序列维护一个 block table,记录逻辑 block 到物理 block 的映射。
- 按需分配:序列每增长 16 个 token 才申请一个新 block——没有预分配,没有碎片。
显存利用率提升
Section titled “显存利用率提升”传统方案的有效显存利用率约 20–40%(大量预分配浪费),PagedAttention 可达 80–95%。这意味着同一显存下可支持更大的 batch size,直接提升吞吐 2–3 倍。
Prefix Sharing:PagedAttention 的 block 结构天然支持前缀共享。多个请求使用相同的 system prompt 时,它们的 block table 可以指向同一个物理 block——共享 system prompt 的 KV Cache,进一步节省显存。这与 LLM 模型部署中的 Prefix Cache 技术紧密配合。
投机解码(Speculative Decoding)
Section titled “投机解码(Speculative Decoding)”LLM 推理是**内存带宽受限(memory-bound)**的:每生成一个 token,都要把全部权重从显存读到计算单元。对于 70B 模型,每生成 1 个 token 需要读取约 140 GB 权重——而 Tensor Core 的实际计算利用率可能只有 5–10%。
投机解码的思路:用一个小模型(draft model,如 1B 参数)快速”草拟” 个候选 token,然后用大模型一次性验证这 个 token——大模型验证 个 token 和生成 1 个 token 的耗时几乎相同(都是一次前向传播),因为瓶颈在显存带宽而非计算。
设小模型(draft model)与大模型(target model)的 token 分布分别为 和 。投机解码使用**拒绝采样(rejection sampling)**来保证最终输出分布与原始大模型完全一致:
- 小模型从 采样得到候选 token
- 生成随机数
- 若 ——接受
- 否则——拒绝 ,从修正分布 重新采样
这个修正保证了最终采样分布恰好是 ——投机解码不会改变输出质量,只是加速。
接受率与加速比
Section titled “接受率与加速比”设小模型与大模型的接受率(acceptance rate)为 (即小模型猜对的概率),草拟 个 token 的期望接受数为:
当 , 时,期望接受 个 token——即大模型一次前向传播平均产出 2.65 个有效 token,加速约 2–3 倍。
2025 主流方案
Section titled “2025 主流方案”| 方案 | Draft Model | 特点 |
|---|---|---|
| Classic Speculative | 独立小模型 (如 1B) | 简单,但需要加载两个模型 |
| Medusa | 多头并行预测 | 无需独立小模型,主模型加几个预测头 |
| EAGLE / EAGLE-2 | 轻量自回归头 | 利用隐藏状态,接受率高(~80%) |
| Lookahead Decoding | N-gram 并行 | 无需训练,利用 Jacobi 迭代 |
| Self-Speculative | 早期退出(early exit) | 同一模型浅层做 draft,深层验证 |
# vLLM 中启用投机解码(EAGLE 方案)from vllm import LLM, SamplingParams
llm = LLM(    model="meta-llama/Meta-Llama-3-70B",    speculative_model="EAGLE-Llama-3-70B",  # EAGLE draft head    num_speculative_tokens=5,                 # 每次草拟 5 个 token    use_v2_block_manager=True,)
# 实测:文本摘要/代码生成等可接受率高的任务# 吞吐可提升 2-3x,延迟降低 40-60%
代码示例:完整量化流程
Section titled “代码示例:完整量化流程”PyTorch 模型量化(PTQ + QAT)
Section titled “PyTorch 模型量化(PTQ + QAT)”import torchimport torch.ao.quantization as quant
model = MyResNet().eval()
# ─── 方案 1:训练后动态量化(最简单,仅权重)───dynamic_quantized = quant.quantize_dynamic( model, {torch.nn.Linear}, dtype=torch.qint8)# 适合:Linear 层为主的模型(如 BERT)# 不适合:Conv 层为主的 CV 模型(动态量化不支持 Conv2d)
# ─── 方案 2:训练后静态量化(权重 + 激活,需要校准)───# 2a. 插入量化观察 stub(用于收集激活值统计量)model_fp32 = quant.fuse_modules(model, [['conv', 'bn', 'relu']])model_fp32.qconfig = quant.get_default_qconfig('fbgemm') # x86 CPUprepared = quant.prepare(model_fp32)
# 2b. 校准:用少量代表性数据跑前向,收集各层激活值的 min/maxwith torch.no_grad(): for inputs in calibration_dataloader: # ~200 张图就够了 prepared(inputs)
# 2c. 转换为量化模型quantized = quant.convert(prepared)# 量化后:Conv2d → QuantizedConv2d, Linear → QuantizedLinear# 模型大小 ~1/4,CPU 推理速度 ~2-4x
# ─── 方案 3:量化感知训练 QAT(精度最高)───model.train()model.qconfig = quant.get_default_qat_qconfig('fbgemm')prepared_qat = quant.prepare_qat(model)# QAT 在训练过程中模拟量化误差,让模型适应低精度for epoch in range(10): for inputs, targets in train_loader: loss = criterion(prepared_qat(inputs), targets) loss.backward() optimizer.step()quantized_qat = quant.convert(prepared_qat.eval())LLM AWQ 量化(AutoAWQ)
Section titled “LLM AWQ 量化(AutoAWQ)”from awq import AutoAWQForCausalLMfrom transformers import AutoTokenizer
model_path = "meta-llama/Meta-Llama-3-8B"quant_path = "Llama-3-8B-AWQ"
# 加载 FP16 模型model = AutoAWQForCausalLM.from_pretrained(model_path)tokenizer = AutoTokenizer.from_pretrained(model_path)
# AWQ 量化配置quant_config = { "zero_point": True, # 非对称量化(激活值分布不对称) "q_group_size": 128, # 分组大小,越小精度越高但速度越慢 "w_bit": 4, # 权重位宽 "version": "GEMM", # GEMM (GPU) 或 GEMV (CPU/Mobile)}
# 量化(内部会自动收集校准数据)model.quantize( tokenizer, quant_config=quant_config, # 可自定义校准数据: # calib_data="path/to/calibration.txt")
# 保存量化后的模型model.save_quantized(quant_path)tokenizer.save_pretrained(quant_path)
# 输出:# - 模型大小:16GB (FP16) → ~4.5GB (INT4 AWQ)# - 精度损失:< 1% (MMLU benchmark)# - GPU 推理速度:~2x faster (内存带宽瓶颈缓解)GPTQ 量化(AutoGPTQ)
Section titled “GPTQ 量化(AutoGPTQ)”from auto_gptq import AutoGPTQForCausalLM, BaseQuantizeConfig
model_path = "meta-llama/Meta-Llama-3-8B"quant_path = "Llama-3-8B-GPTQ"
# GPTQ 量化配置quant_config = BaseQuantizeConfig( bits=4, # 4-bit 量化 group_size=128, # 分组大小 desc_act=False, # 是否按激活值降序排列权重列)
# 准备校准数据(512 条文本样本通常足够)calibration_examples = [ tokenizer(text) for text in calibration_texts[:512]]
# 量化model = AutoGPTQForCausalLM.from_pretrained(model_path)model.quantize(calibration_examples, quant_config)
# 保存model.save_quantized(quant_path, use_safetensors=True)
# GPTQ vs AWQ 选择建议:# - 追求推理速度 + 精度平衡 → AWQ (vLLM 原生支持更好)# - 追求极致压缩 (3-bit, 2-bit) → GPTQ (低比特下更稳定)# - CPU/Mac 部署 → GGUF (无需量化,直接转换)1. 量化方法选择决策
Section titled “1. 量化方法选择决策”| 场景 | 推荐方案 | 理由 |
|---|---|---|
| GPU 服务端 LLM (4-bit) | AWQ | vLLM 原生支持,速度+精度最优 |
| GPU 服务端 LLM (极致压缩) | GPTQ 3-bit | 低比特下精度保持更好 |
| CPU / 端侧 LLM | GGUF Q4_K_M | llama.cpp 生态,SIMD 加速 |
| CV 模型 GPU 部署 | TensorRT INT8 | 与 TensorRT 深度集成,最大化吞吐 |
| CV 模型 CPU 部署 | ONNX Runtime INT8 | 跨平台,FBGEMM / OneDNN 后端 |
| NVIDIA Hopper GPU | FP8 | 无需校准,原生硬件支持 |
| 训练阶段 | BF16 + AMP | 动态范围大,无需梯度缩放 |
2. 量化校准数据的黄金法则
Section titled “2. 量化校准数据的黄金法则”- CV 模型:200–500 张代表性图片即可,覆盖常见场景和光照条件。
- LLM 权重量化:128–512 条文本样本,应覆盖目标任务领域(代码、对话、长文本等)。
- KV Cache 量化:无需额外校准数据,运行时在线统计。
3. 量化常见陷阱
Section titled “3. 量化常见陷阱”陷阱 1:激活值离群通道。LLM 中少量通道的激活值可能比平均值大 100 倍以上。如果按张量量化(per-tensor),这些离群值会把缩放因子撑大,导致其余 99% 的通道精度急剧下降。解决方案:per-channel 或 per-group 量化。
陷阱 2:第一层和最后一层最敏感。网络的第一层直接处理输入、最后一层产生输出——这两层的量化误差会无衰减地传播到最终结果。实践中常对首尾层保持 FP16 不量化(称为 “first-layer / last-layer sensitivity”)。
陷阱 3:量化后精度骤降先查校准。如果 INT8 量化后精度掉了 5%+,大概率是校准数据不具代表性,或某些层不适合量化。建议先用 TensorRT 的
polygraphy工具逐层对比 FP32 和 INT8 输出的差异(cosine similarity),定位问题层。
4. 部署前的量化检查清单
Section titled “4. 部署前的量化检查清单”- 量化后模型在验证集上的精度损失 < 2%(CV)或 < 1%(LLM)
- 无输出 NaN / Inf(检查动态范围)
- 实测推理延迟确实降低(有些框架的量化反量化开销可能抵消加速)
- 同一输入下,量化模型与 FP32 模型的输出差异在可接受范围(cosine similarity > 0.99)
- 长序列/极端输入下不崩溃(边界测试)
2025–2026 最新进展
Section titled “2025–2026 最新进展”FP8 生态成熟
Section titled “FP8 生态成熟”NVIDIA Hopper(H100/H200)和 AMD MI300 原生支持 FP8 后,FP8 正在取代 INT8 成为推理量化的首选格式:
- 无需校准:浮点格式天然自适应数值范围,跳过了最耗时的校准步骤。
- 精度更高:FP8 E4M3 在 LLM 推理任务上的精度接近 FP16,远优于 INT8。
- TensorRT-LLM / vLLM 均已原生支持 FP8 权重 + FP8 KV Cache。
INT4 推理标准化
Section titled “INT4 推理标准化”INT4 从”实验性”走向”生产级”:
- Marlin kernel:专为 INT4 权重设计的 CUDA kernel,在 Ampere/Hopper 上达到接近理论峰值的吞吐。
- W4A16 模式(4-bit 权重 + 16-bit 激活)成为 LLM 服务部署的事实标准——权重量化到 4-bit 省显存,激活保持 16-bit 保精度,避免了激活量化的精度损失。
- W4A8 模式在探索中:权重 4-bit + 激活 8-bit,进一步压缩激活值传输开销。
投机解码工程化
Section titled “投机解码工程化”- EAGLE-2(2024)将接受率提升到 80%+,实测在代码生成等结构化任务中 3x 加速。
- 推测式流水线并行:投机解码与流水线并行结合,利用 PP 的气泡(bubble)时间做 draft 验证。
- Online Speculative Decoding:vLLM 0.6+ 支持动态调整
num_speculative_tokens,根据实时接受率自适应。
CUDA Graph 与 torch.compile
Section titled “CUDA Graph 与 torch.compile”- CUDA Graph:将整段推理的 CUDA kernel 调用序列录制为静态图,消除 CPU 侧的 kernel launch 开销。对小 batch / 低延迟场景效果显著(延迟降低 20–40%)。
- torch.compile (inductor):PyTorch 2.x 的编译后端,自动做算子融合(flash attention、RMSNorm 融合等),无需手动导出 ONNX。
- 苹果 MLX:Apple Silicon 上的统一内存推理框架,支持 4-bit 量化 + 自动批处理。
- 高通 AI Engine:手机 NPU 原生支持 INT4 推理,在 Snapdragon 8 Gen 3 上可本地运行 7B 模型。
- MediaTek APU:联发科的天玑 9300 支持端侧 4-bit 推理,实测 7B 模型 15 tokens/s。
- GPU 与多卡基础 — GPU 架构、Tensor Core、CUDA 编程模型
- LLM 模型部署 — vLLM、SGLang、PagedAttention 的工程实践
- CV 模型部署 — TensorRT、OpenVINO、边缘部署
- Transformer 架构 — 自注意力机制的数学原理
| 术语 | 解释 |
|---|---|
| 量化(Quantization) | 将高精度浮点数映射为低精度整数或浮点数,减少显存和加速推理 |
| 校准(Calibration) | 用少量数据统计各层激活值的范围,确定量化参数 |
| PTQ | Post-Training Quantization,训练后量化——无需重训练 |
| QAT | Quantization-Aware Training,量化感知训练——训练中模拟量化误差 |
| Pareto 前沿 | 多目标优化中的非劣解集合——无法在不牺牲一个目标的前提下改善另一个 |
| Marlin | 专为 INT4 GEMM 设计的高性能 CUDA kernel |
| W4A16 | 权重 4-bit + 激活 16-bit 的量化模式,LLM 推理事实标准 |