
因果推断
因果推断(Causal Inference)研究的是”如果做了 X,Y 会怎样变化”,回答的是因果问题而非相关问题。它解释了为什么机器学习预测得好却不能直接用于决策——因为预测的是相关性,而决策要的是因果效应。本页讲解潜在结果框架、随机对照试验、观察性研究三大方法(匹配/加权/工具变量)以及因果发现。前置阅读:概率论基础、贝叶斯推断。
把因果推断想象成用药 vs 自愈的拷问:数据里吃药的人比没吃药的人好得慢——能说药让人好得慢吗?不能,因为吃药的人本来病就更重。混杂偏差(confounding bias,即第三个变量同时影响”处理”和”结果”,制造出虚假关联的现象)让”相关性”和”因果性”分道扬镳。
- 相关性 因果性:冰淇淋销量和溺水人数正相关,但禁售冰淇淋救不了人——两者都由夏天这个”混杂因素”驱动。
- 潜在结果框架:同一个人,吃药会怎样()、不吃药会怎样()——因果效应就是 。问题是同一个时刻只能看到一个(吃药或没吃药),另一个就是反事实(counterfactual,即”如果没有吃药,这个人会怎样”这种与事实相反的假想情景),永远观测不到。
- 随机对照试验(RCT)= 因果的黄金标准:把人随机分成吃药和不吃药两组,随机化切断了”病重程度”与”是否吃药”的关联,于是两组平均差异 = 真实因果效应——这是医学临床试验的基石。
- 观察性研究的难题:现实中无法做 RCT(不能强迫人抽烟),只能在已有数据里想办法消除混杂——这就是匹配、逆概率加权、工具变量等方法要做的事。
一句话区别:机器学习问”给定特征 ,预测 是什么”(预测问题);因果推断问”如果我改变 , 会怎么变”(干预问题)。前者是观察世界的模式,后者是改变世界的杠杆。
潜在结果框架(Rubin Causal Model)
Section titled “潜在结果框架(Rubin Causal Model)”对每个个体 ,定义两个潜在结果:
- :如果个体接受处理(吃药)后的结果。
- :如果个体不接受处理(不吃药)时的结果。
个体因果效应(ITE)。但我们只能观测到一个: 时看到 , 时看到 ,另一个是反事实。因果推断的根本困难:反事实永远不可观测。
能估计的是平均处理效应 ATE 。朴素地用”吃药组均值减去不吃药组均值”会有偏,因为两组可能在病重程度等混杂变量 上分布不同。只有当 在两组间相同(即 与处理分配 独立,称为”可忽略性”假设——即在控制了观测变量后,处理分配可视为随机),这个差才等于 ATE。
为什么朴素估计会有偏?——数学推导
Section titled “为什么朴素估计会有偏?——数学推导”朴素估计量为 。展开:
注意我们想要的是 ,而:
选择偏差项的含义:即使不吃药,吃药组与不吃药组的结果本身就有差异(因为吃药的人病更重)。因果推断的核心任务就是消除这个选择偏差。
倾向得分定理(Propensity Score Theorem)
Section titled “倾向得分定理(Propensity Score Theorem)”Rosenbaum & Rubin (1983) 证明了一个深刻的结果:要把高维协变量 (可能几十上百维)“控制”到处理与结果独立,不需要匹配所有 的维度,只需要匹配一个一维的标量——倾向得分。
定义:倾向得分 ,即在给定特征 的条件下接受处理的概率。
定理:如果可忽略性成立(即 ),那么 也成立。
直觉:两个人即使 不同,只要接受处理的概率(倾向得分)相同,那么处理与否就像掷同一个有偏骰子——已知的偏倚被倾向得分”吸收”了,残余的分配就是随机的。这就把高维匹配问题降维到一维。
推导思路:
最后一步说明,在 给定时, 与 独立。这个”降维”定理是匹配、IPTW 等方法的基石。
三个核心假设
Section titled “三个核心假设”- 可忽略性(Ignorability / 无未测混杂):在控制了观测协变量 后,处理分配 与潜在结果独立。等价说法:所有影响 和 的混杂因素都已被观测到并控制。这是观察性研究最关键、也最难满足的假设——你永远无法证明”没有遗漏的混杂因素”。
- 共同支撑(Common Support / Positivity):对任何 的取值,个体被分到处理组和对照组的概率都严格大于 0。否则该子群体没有可比的反事实样本,无法估计因果效应。直觉:如果某类患者 100% 都会吃药,你就找不到”同类但没吃药”的对照。
- SUTVA(稳定个体处理值假设):个体之间的处理互不干扰(无溢出效应),且处理版本唯一。例:我的疫苗接种不会改变你的感染概率(疫情里这个假设往往不成立,需要网络因果模型)。
观察性研究的三大武器
Section titled “观察性研究的三大武器”匹配(Matching):对每个处理组个体,在对照组里找一个/多个协变量最相似的”替身”,使两组在 X 上几乎同分布,再算效应。常用 propensity score(倾向得分)做匹配:倾向得分 = P(W=1 | X),即给定特征下接受处理的概率。对同一倾向得分的个体,处理可视为近似随机。
逆概率加权(IPTW):用倾向得分给样本重新加权,构造一个”伪总体”使处理与混杂独立。处理组样本权重 1/e(X),对照组权重 1/(1-e(X))。加权后两组协变量分布一致,均值差即 ATE。
IPTW 的数学推导——为什么倒数加权能消除混杂?
对第一项取条件期望:
所以:
分子上的 P(W=1|X) = e(X) 恰好和分母的 e(X) 抵消——这就是”倒数加权”的原理:它把被处理概率”扭曲”的分布重新拉平。
工具变量(IV):当存在未测混杂时,找一个只影响处理、不直接影响结果的”工具变量” Z(如离医院的距离影响是否就医但不直接影响健康)。用 Z 的变异来剔除混杂部分,估计纯因果效应。两阶段最小二乘(2SLS)是经典实现。
两阶段最小二乘(2SLS)的数学推导
Section titled “两阶段最小二乘(2SLS)的数学推导”模型设定:真实的因果关系是 Y = τW + U(U 是误差,包含未测混杂),而 W = γZ + V(Z 是工具变量)。问题在于 Corr(W, U) ≠ 0(有未测混杂导致内生性)。
第一阶段:用 Z 预测 W,得到拟合值 Ŵ = γ̂Z。这一步的作用是把 W 拆成两部分——由 Z 驱动的”干净”部分 Ŵ,和由混杂驱动的”脏”部分。
第二阶段:用 Ŵ 回归 Y,得到 τ̂。
为什么这能消除混杂?因为 Ŵ 只由 Z 决定,而 Z 与 U 不相关(工具变量的核心假设),所以 Ŵ 与 U 不相关——内生性被消除了。
正式推导(矩估计视角):
展开 :
所以:
直觉:普通回归用 W 的全部变异来估计 τ,但 W 的变异中混了 U 的影响。2SLS 只用 Z 驱动的那部分 W 的变异——这部分是”外生的”(不受 U 污染),所以估计的 τ 是纯因果效应。
因果图(DAG)
Section titled “因果图(DAG)”用有向无环图刻画变量间的因果假设:节点是变量,A 指向 B 表示 A 直接因果影响 B。混杂 = 同时指向处理和结果的共同原因(后门路径)。后门准则:要识别因果效应,必须阻断所有从处理到结果的后门路径(通过控制路径上的变量)。DAG 帮助我们直观判断”控制哪些变量才正确”——值得注意的是,错误地控制”中介变量”或”对撞变量”反而会引入偏差。
三类危险变量
Section titled “三类危险变量”| 变量类型 | DAG 结构 | 控制后的后果 | 直觉 |
|---|---|---|---|
| 混杂变量 | X → W, X → Y | ✅ 正确,阻断后门路径 | 不控制就会有虚假关联 |
| 中介变量 | W → M → Y | ❌ 错误,阻断因果的一部分 | 你估计的不再是总效应 |
| 对撞变量 | W → C ← Y | ❌ 错误,反而打开一条路径 | 条件化对撞变量会使其父节点相关 |
对撞偏差(collider bias)是最反直觉的:对撞变量本身不由 W 或 Y 引起,而是被它们共同影响。一旦你”控制”了对撞变量(比如限定在某个子样本中),W 和 Y 就会在该子样本里产生虚假关联。一个经典例子:在”美貌且有才华的名人”中,美貌和才华呈负相关——不是因为美貌降低才华,而是因为你同时选中了两者中至少一个很高的人。
因果发现(Causal Discovery)
Section titled “因果发现(Causal Discovery)”当没有领域知识能画 DAG 时,从数据中自动学习因果结构,称为因果发现。主要方法:
- 基于约束:PC 算法用条件独立性检验逐步删除和定向边,得到马尔可夫等价类。
- 基于分数:GES 等用 BIC/BIC-like 评分搜索最优 DAG。
- 基于功能因果模型:LiNGAM 假设非高斯噪声可识别因果方向;ANM 用加性噪声模型识别非对称性。
- NOTEARS:把 DAG 学习转化为连续优化问题,适合大规模连续数据。
- DAGMA(2022-2025):NOTEARS 的改进版,用对数行列式精确建模无环性约束,收敛更快、精度更高,已成为 2024-2025 连续因果发现的主流方法。
- GOLEM(2020-2024):用似然评分替代 NOTEARS 的最小二乘目标,理论基础更严谨,在生物基因调控网络发现中表现突出。
什么是”马尔可夫等价类”? 有些不同的 DAG 结构会产生完全相同的统计独立性模式,数据无法区分它们。例如 A→B→C 和 A←B→C,在统计上”看起来一样”。因果发现算法只能识别到等价类,等价类内部的边方向可能无法确定。
与机器学习的融合:双重机器学习
Section titled “与机器学习的融合:双重机器学习”Chernozhukov et al. (2018) 提出 Double/Debiased ML:用机器学习模型分别预测处理 W 和结果 Y 中由 X 解释的部分,取残差后再做回归,得到无偏的因果效应。这让 GBDT、神经网络能介入因果估计——既享受 ML 的预测力,又保留因果推断的无偏性。因果森林(Causal Forest)则是估计异质处理效应(HTE)——不同人群因果效应不同——的有力工具。
双重 ML 的数学推导
Section titled “双重 ML 的数学推导”考虑部分线性模型:
其中 ε_Y ⊥ ε_W | X,τ 是我们想估计的因果效应。
朴素方法的问题:直接用 ML 拟合 Y ~ W + f(X),ML 模型的正则化偏差会”污染” τ 的估计。
双重 ML 的交叉拟合(cross-fitting)步骤:
- 将样本分成两份 K₁ 和 K₂。
- 第一轮:在 K₁ 上训练 ĝ(X)(预测 Y)和 m̂(X)(预测 W),在 K₂ 上计算残差 Ỹ = Y - ĝ(X) 和 W̃ = W - m̂(X)。
- 第二轮:交换,在 K₂ 上训练模型,在 K₁ 上算残差。
- 合并残差,对 Ỹ 做 W̃ 的回归:τ̂ = Σ(Ỹ·W̃) / Σ(W̃²)
为什么”双重”是必要的?
- 如果只用 ML 去除 Y 中的 g(X)(即”单重去偏”),残余偏差与 W 相关(因为 W 也受 X 影响),τ̂ 仍有偏。
- 同时去除 Y 和 W 中的 X 成分(“双重”),两个偏差项相乘变成高阶小量——这就是 Neyman 正交性的核心价值:估计量对 nuisance function(辅助函数 g 和 m)的误差不敏感,即使 ML 模型有偏差,τ̂ 仍接近无偏。
直觉版总结:先用 ML 从 Y 中”挖掉”能用 X 解释的部分(得到”去除背景因素后的结果”),再从 W 中”挖掉”能用 X 解释的部分(得到”近似随机的处理”),最后对这两个残差做简单回归——结果就是干净的因果效应。
双重稳健估计(Doubly Robust, DR)
Section titled “双重稳健估计(Doubly Robust, DR)”双重 ML 的一个重要变体是双重稳健估计量,它同时建模倾向得分 e(X) 和结果模型 μ(W, X):
它被称为”双重稳健”的原因:只要倾向得分模型或结果模型中有一个是正确的,估计量就无偏。即使两个模型都不完美,误差也只是二阶的(两个小偏差相乘)。这种”容错性”让 DR 在实际应用中广受欢迎。
异质处理效应估计:X-Learner 与 R-Learner
Section titled “异质处理效应估计:X-Learner 与 R-Learner”| 方法 | 思路 | 适用场景 |
|---|---|---|
| T-Learner | 分别在处理组和对照组训练 μ̂(1,X) 和 μ̂(0,X),做差 | 处理组样本充足时简单有效 |
| S-Learner | 把 W 当作普通特征一起训练 μ̂(W,X),不单独建模 | 处理效应弱时可能忽略 W |
| X-Learner (Künzel et al. 2019) | 先训练两个组的模型,再用对照组模型预测处理组的反事实,反之亦然,最后加权合成 | 处理组和对照组样本量不平衡时表现好 |
| R-Learner (Nie & Wager 2021) | 基于 Robinson 转换,直接优化去偏后的目标函数 | 理论性质优良,与双重 ML 关系密切 |
| 因果森林 (Wager & Athey 2018) | 改造随机森林的分裂准则为最大化叶子内处理效应异质性 | 高维特征下的非参数 HTE 估计 |
合成控制法(Synthetic Control)
Section titled “合成控制法(Synthetic Control)”Abadie 等人提出的合成控制法是政策评估领域的重要工具,被 Athey & Imbens 称为”过去十五年最重要的发展”。
核心思想:要评估某政策(如某州提高最低工资)的效果,找到一个”合成对照”——用其他未实施政策的州的加权组合来”复制”处理州在政策前的趋势。处理州实际值与合成值的偏差即政策效应。
数学形式:寻找权重向量 ω = (ω₁, …, ω_J),使得:
其中 X₁ 是处理州的预处理特征向量,Xⱼ 是第 j 个对照州的预处理特征。
增强合成控制(Augmented Synthetic Control, Ben-Michael et al. 2021):当预处理期拟合不够完美时,用结果模型修正残余偏差,兼顾了 SC 的透明性和 ML 的灵活性。
2024-2025 新进展:合成控制法与深度学习结合(如用序列模型学习更灵活的”合成”权重)、多处理单元的高维合成控制、以及与差分中的差分(DID)的统一框架,正在推动这一方法向更复杂的场景扩展。
前沿动态:2024-2026 的因果推断
Section titled “前沿动态:2024-2026 的因果推断”LLM 与因果推断的结合
Section titled “LLM 与因果推断的结合”2024-2025 年最热门的方向之一是利用大语言模型(LLM)的丰富世界知识来辅助因果分析:
- LLM 辅助因果图构建:研究(如 Kıcıman et al., 2023; Karim et al., 2024-2025)发现,GPT-4 等大模型在从变量名推断因果关系方面表现接近甚至超过领域专家和 PC/GES 等传统因果发现算法。LLM 可以快速从自然语言描述中提取变量间因果假设,草拟 DAG 供研究者审核——大幅降低了画因果图的门槛。
- LLM 作为因果推理引擎:将 LLM 嵌入 DoWhy 等框架,用 prompt 让模型自动识别混杂变量、建议控制策略、甚至生成反事实情景分析。
- LLM 生成的反事实数据增强:用 LLM 生成文本反事实(“如果改成 X,用户的反馈会怎么变”),为因果效应估计提供数据增强。
- 因果增强的检索增强生成(Causal RAG):2025 年的研究开始探索在 RAG 管道中加入因果推理步骤,让 LLM 不仅检索相关文档,还区分相关与因果——例如在医疗问答中避免给出”相关但不因果”的建议。
局限性提醒:LLM 在因果推理中仍然会”幻觉”出错误的因果链,尤其在需要多步推理或处理罕见因果机制时。LLM 应被视为因果假设的”草拟助手”而非”最终裁判”——所有 LLM 生成的因果图仍需领域专家审核。
因果表征学习(Causal Representation Learning)
Section titled “因果表征学习(Causal Representation Learning)”深度学习擅长学习表征,因果推断需要可解释的变量结构。2024-2025 年的研究热点是两者的融合:
- 解耦表征(Disentangled Representation):让神经网络学习到的隐变量各自对应真实的因果因素,而非纠缠在一起。这对于医疗影像、基因数据等高维数据的因果分析至关重要。
- 因果 VAE(Causal VAE):在变分自编码器的隐空间中嵌入因果图结构,使生成过程遵循因果机制。
- 结构因果模型 + 深度学习(Deep SCM):用神经网络参数化结构因果模型中的函数方程,实现可干预的深度生成模型。
因果 AI(Causal AI)的产业化
Section titled “因果 AI(Causal AI)的产业化”2024-2025 年,因果 AI 从学术走向产业化的步伐明显加快:
- 企业级因果 AI 平台:专门从事因果 AI 的公司(如 CausaLens、 causaLens 的 Actus 平台)提供端到端的因果分析工具,应用于金融风控、供应链优化、药物开发。
- 因果推荐系统:电商和内容平台开始将因果推断嵌入推荐算法——不再只预测”用户会点击什么”(相关),而是估计”推荐什么对用户的长期行为有正向因果效应”(因果),解决推荐系统中的选择偏差和混杂问题。
- A/B 测试的因果增强:在传统 A/B 测试无法实施时(如网络效应导致 SUTVA 追反),用因果推断方法(如 Switchback 实验、聚类随机化)提供替代方案。
- 可解释 AI 与因果:2025 年的研究趋势是将因果推断嵌入 XAI 框架——不仅解释”模型为什么这样预测”,更回答”改变哪个因素能改变预测”,让模型解释从相关走向因果。
因果基础模型(Causal Foundation Models)
Section titled “因果基础模型(Causal Foundation Models)”2025 年的前沿探索:像训练语言基础模型一样,用大量异构数据集(观测数据、实验数据、模拟数据)预训练一个通用的因果推理模型,使其能在新领域进行 zero-shot 或 few-shot 的因果发现和效应估计。这一方向尚在早期,但已引发学术界的高度关注。
混杂偏差与后门路径
Section titled “混杂偏差与后门路径”红色路径 W ← X → Y 就是后门路径:不吃药的人可能病更轻所以好得更快,这个”假因果”必须通过控制 X 来阻断。
对撞偏差示意
Section titled “对撞偏差示意”条件化 C(如限定样本到 C=1 的子集)会打开 W ← C → Y 这条本来不存在的路径,在子样本中制造虚假相关。
因果推断方法选择
Section titled “因果推断方法选择”双重 ML 的交叉拟合流程
Section titled “双重 ML 的交叉拟合流程”交叉拟合(cross-fitting)确保训练模型的数据和计算残差的数据不重叠——这消除了过拟合导致的偏差,是双重 ML 获得有效统计推断的关键。
倾向得分匹配(PSM)
Section titled “倾向得分匹配(PSM)”import numpy as npfrom sklearn.linear_model import LogisticRegressionfrom sklearn.neighbors import NearestNeighbors
# 模拟数据:X 是协变量,W 是否接受处理,Y 结果rng = np.random.default_rng(42)n = 1000X = rng.normal(0, 1, (n, 3))W = (rng.uniform(size=n) < 1 / (1 + np.exp(-(X[:, 0] + X[:, 1])))).astype(int)Y = 2 * W + 1.5 * X[:, 0] + X[:, 1] + rng.normal(size=n) # 真实 ATE=2
# 1. 估倾向得分ps = LogisticRegression().fit(X, W).predict_proba(X)[:, 1]
# 2. 对每个处理样本在对照组找最近邻替身treated, control = W == 1, W == 0nn = NearestNeighbors().fit(ps[control].reshape(-1, 1))idx = nn.kneighbors(ps[treated].reshape(-1, 1), n_neighbors=1, return_distance=False).ravel()ate = (Y[treated] - Y[control][idx]).mean()print(f"PSM 估计 ATE: {ate:.3f}(真实=2.0)")
# 3. 检查平衡:匹配后标准化均值差 SMD 应 < 0.1def smd(x1, x2): return (x1.mean(axis=0) - x2.mean(axis=0)) / np.sqrt((x1.var(axis=0) + x2.var(axis=0)) / 2 + 1e-8)
smd_before = smd(X[treated], X[control]) # 匹配前smd_after = smd(X[treated], X[control][idx]) # 匹配后print(f"匹配前 SMD: {smd_before.round(3)}")print(f"匹配后 SMD: {smd_after.round(3)}") # 应显著缩小双重机器学习(简化版)
Section titled “双重机器学习(简化版)”from sklearn.ensemble import GradientBoostingRegressor
# 用 ML 拟合 X 对 W 的预测和 X 对 Y 的预测,取残差mu_w = GradientBoostingRegressor().fit(X, W); e_hat = W - mu_w.predict(X)mu_y = GradientBoostingRegressor().fit(X, Y); t_hat = Y - mu_y.predict(X)# 对残差做回归:t_hat ~ e_hat,斜率即去偏后的因果效应ate = (e_hat * t_hat).sum() / (e_hat * e_hat).sum()print(f"双重 ML 估计 ATE: {ate:.3f}")双重 ML 带交叉拟合(更严谨的版本)
Section titled “双重 ML 带交叉拟合(更严谨的版本)”import numpy as npfrom sklearn.ensemble import GradientBoostingRegressorfrom sklearn.model_selection import KFold
def double_ml_crossfit(X, W, Y, n_splits=2): """带交叉拟合的双重 ML,消除过拟合偏差""" kf = KFold(n_splits=n_splits) Y_resid = np.zeros_like(Y, dtype=float) W_resid = np.zeros_like(W, dtype=float)
for train_idx, test_idx in kf.split(X): # 在训练折上训练 nuisance model mu_w = GradientBoostingRegressor(max_depth=3).fit(X[train_idx], W[train_idx]) mu_y = GradientBoostingRegressor(max_depth=3).fit(X[train_idx], Y[train_idx]) # 在测试折上计算残差 W_resid[test_idx] = W[test_idx] - mu_w.predict(X[test_idx]) Y_resid[test_idx] = Y[test_idx] - mu_y.predict(X[test_idx])
# 最终回归 theta_hat = np.sum(W_resid * Y_resid) / np.sum(W_resid ** 2) return theta_hat
ate = double_ml_crossfit(X, W, Y)print(f"交叉拟合双重 ML 估计 ATE: {ate:.3f}")使用 DoWhy 进行完整的因果分析
Section titled “使用 DoWhy 进行完整的因果分析”# pip install dowhy econmlimport dowhyfrom dowhy import CausalModelimport pandas as pd
# 构造可读的数据集df = pd.DataFrame({ 'age': X[:, 0], 'income': X[:, 1], 'edu': X[:, 2], 'treatment': W, 'outcome': Y})
# 1. 建模:用领域知识声明因果图(这是因果推断区别于 ML 的关键一步)model = CausalModel( data=df, treatment='treatment', outcome='outcome', common_causes=['age', 'income', 'edu'], # 声明混杂变量)# DoWhy 会据此自动构建 DAG 并验证后门路径
# 2. 识别:确定因果效应是否可估计(后门准则检查)identified_estimand = model.identify_effect()
# 3. 估计:选择方法估计因果效应estimate = model.estimate_effect( identified_estimand, method_name='backdoor.propensity_score_matching')print(f"DoWhy PSM 估计 ATE: {estimate.value:.3f}")
# 也可以用双重 ML 或因果森林dml_estimate = model.estimate_effect( identified_estimand, method_name='backdoor.econml.dml.DML', # 需要 econml target_units='ate', method_params={ 'init_params': { 'model_y': GradientBoostingRegressor(), 'model_t': GradientBoostingRegressor(), 'model_final': GradientBoostingRegressor(), }, 'fit_params': {}, })
# 4. 反驳:用安慰剂处理、随机共同原因等检验结论稳健性refute = model.refute_estimate( identified_estimand, estimate, method_name='placebo_treatment_refuter')print(f"安慰剂检验 p-value: {refute.new_effect:.4f}(应接近 0)")DoWhy 的四步流程(建模 → 识别 → 估计 → 反驳)是因果分析的最佳实践框架。“反驳”步骤是关键——它通过添加随机混杂、安慰剂处理等方式压力测试你的结论,帮你发现假设是否脆弱。
使用 EconML 估计异质处理效应(HTE)
Section titled “使用 EconML 估计异质处理效应(HTE)”# pip install econmlfrom econml.dml import CausalForestDML
# 因果森林:估计每个人的个体处理效应(ITE)cf = CausalForestDML( model_y=GradientBoostingRegressor(), model_t=GradientBoostingRegressor(), n_estimators=100, min_samples_leaf=20, random_state=42,)cf.fit(Y, W, X=X)
# 预测每个个体的因果效应ite = cf.effect(X) # 个体处理效应ate_cf = ite.mean()print(f"因果森林 ATE: {ate_cf:.3f}")
# 找出因果效应最大的前 10% 人群(精准干预)top_10_threshold = np.percentile(ite, 90)high_impact = X[ite >= top_10_threshold]print(f"高因果效应人群特征均值: {high_impact.mean(axis=0).round(3)}")DAG 可视化与后门路径分析
Section titled “DAG 可视化与后门路径分析”# 使用 networkx 可视化因果图import networkx as nximport matplotlib.pyplot as plt
G = nx.DiGraph()G.add_edges_from([ ('年龄', '是否用药'), ('年龄', '康复时间'), ('病情严重度', '是否用药'), ('病情严重度', '康复时间'), ('是否用药', '康复时间'),])
pos = nx.spring_layout(G, seed=42)nx.draw(G, pos, with_labels=True, node_color='lightblue', node_size=2000, font_size=10, arrows=True, arrowsize=20)plt.title('因果有向无环图(DAG)')plt.savefig('dag.png', dpi=150, bbox_inches='tight')plt.show()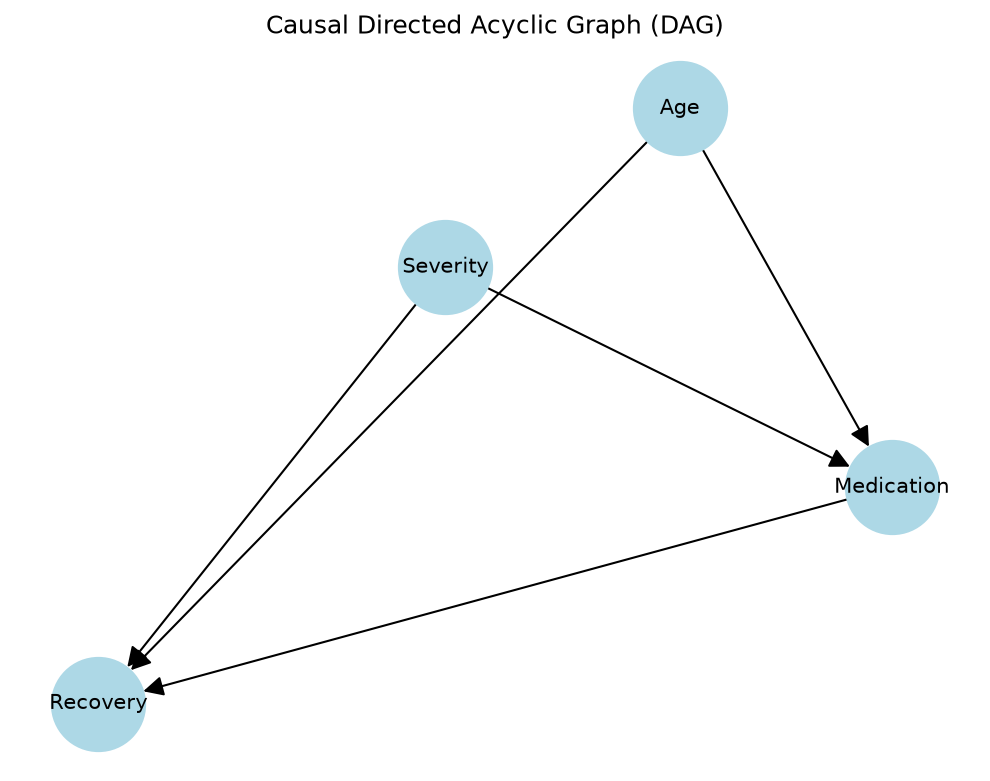
对更严肃的 DAG 分析,推荐使用
causal-learn(causal-learn库的前身是 Tetrad),它提供从数据中学习 DAG、检查后门准则、寻找调整集等功能。
- 先画因果图再建模。在动手前用领域知识画 DAG,明确哪些是混杂(必须控制)、哪些是中介(不能控制)、哪些是对撞(控制反而引入偏差)。这是因果推断区别于普通统计建模的核心一步。
- 可忽略性永远只是假设。观察性研究里”无未测混杂”无法从数据本身验证,必须结合领域知识论证,并做敏感性分析评估结论对未测混杂的稳健程度。
- 倾向得分模型要检查平衡。匹配/加权后必须检查两组协变量分布是否一致(标准化均值差 SMD 小于 0.1),否则匹配失败。
- 共同支撑不足时不要硬估。某些 X 取值下处理概率接近 0 或 1,没有可比反事实,应截断样本或报告效应只对有支撑的子群体成立。
- 不要直接用预测模型做决策。预测”谁会点击”不等于”投放广告让谁点击”——后者是因果问题,需要 uplift modeling 或因果效应估计。
- 异质处理效应(HTE)用因果树/因果森林。不同人群因果效应不同,用 Causal Forest 估计每个个体的 ITE,支撑精细化运营策略。
- A/B 测试是 RCT 的工程化。互联网产品的 A/B 实验就是 RCT,是获得可信因果结论的最可靠方式——能做实验就不要只用观察性数据。
- 注意 SUTVA 违背。当个体间存在溢出效应(如社交网络、传染病、市场份额竞争),传统因果方法会失效,需要考虑网络随机化或社交网络因果推断方法。
- 样本量与统计功效。因果效应估计通常需要比预测更大的样本才能达到统计显著,因为你在估计的是”差值中的差值”——务必在研究设计阶段进行功效分析。
- 医药临床试验:FDA 要求新药通过 RCT 证明疗效,双盲随机对照是药物上市的法定标准,辉瑞/莫德纳疫苗的三期临床即 RCT。
- 互联网产品 A/B 实验:Google、字节、腾讯的几乎所有产品决策都通过 A/B 测试验证因果效应,是 RCT 思想的工程化落地。
- 广告 uplift modeling:预测”广告对谁有正向因果增量”而非”谁会点击”,避免把本来就要买的用户归功于广告——这是精准营销的前沿。Uber 的 CausalML 库正是为此而生。
- 政策效果评估:经济学用观察性数据 + 工具变量/DID/合成控制评估最低工资、教育补贴等政策因果效应。Card 2021 诺贝尔经济学奖即因自然实验方法。Abadie 用合成控制法评估了加州烟草控制法案的效果——经典教科书案例。
- 个性化医疗:用因果森林估计”某治疗方案对哪类患者最有效”,从”平均最优”走向”个体最优”。
- 社会经济研究:研究教育对收入、污染对健康的因果效应,由于无法做 RCT,依赖匹配、IPTW 等观察性方法。
- 推荐系统去偏:推荐系统中存在严重的选择偏差(用户只会点击推荐的内容,形成反馈循环)。2024-2025 年的前沿研究用因果推断方法(如 IPS 加权、反事实风险评估)消除推荐偏差。
- 金融风控:评估”贷款利率调整对违约率的因果效应”——直接用历史数据回归会有严重混杂(利率高的用户本身风险更高),需要用工具变量或双重 ML。
- 气候与环境政策:评估碳排放交易体系对减排的因果效应,合成控制法是常用工具。
- LLM 辅助医疗诊断:2025 年的研究正在探索用 LLM 从电子病历文本中自动提取因果假设、构建 DAG,辅助医生识别混杂因素。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| DoWhy | Python | 微软开源的因果推断统一框架,封装”建模-识别-估计-反驳”四步流程 |
| EconML | Python | 微软开源的 HTE 估计库,含双重 ML、因果森林、X-Learner、深度工具变量等 |
| CausalML | Python | Uber 开源的 uplift modeling 与因果效应估计库 |
| causal-learn | Python | 因果发现算法(PC、GES、LiNGAM、NOTEARS、DAGMA)的 Python 实现,CMU 维护 |
| CausalDiscoveryToolbox | Python | 因果发现的另一选择,支持 GPU 加速 |
| DoubleML | Python/R | 基于双重 ML 框架的因果推断库,与 scikit-learn 深度集成 |
| CausalImpact | Python/R | Google 开源的贝叶斯时间序列因果推断工具,适合政策评估 |
| causalinference | Python | 经典线性工具变量、匹配、加权方法的教学级实现 |
| psmpy / MatchIt | Python / R | 倾向得分匹配工具,R 生态的 MatchIt 是学术标准 |
| gcm (Graphical Causal Models) | Python | 基于 DoWhy 的结构因果模型,支持反事实推理与根因分析 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 因果推断 | Causal Inference | 从数据中估计处理对结果的因果效应,回答”如果干预会怎样” |
| 潜在结果 | Potential Outcome | 同一个体在处理/不处理两种情况下的可能结果之差即因果效应 |
| 反事实 | Counterfactual | 未实际发生的情况下的潜在结果,因果推断的根本困难 |
| 平均处理效应 | ATE (Average Treatment Effect) | 处理对结果因果效应在总体上的平均值 |
| 异质处理效应 | HTE | 处理效应因人而异,HTE 刻画不同子群体的不同因果效应 |
| 混杂偏差 | Confounding Bias | 混杂因素同时影响处理与结果,造成的虚假相关 |
| 选择偏差 | Selection Bias | 处理组和对照组在潜在结果上本身就有差异,非处理导致 |
| 随机对照试验 | RCT | 随机分配处理与对照组,切断混杂的因果效应黄金标准 |
| 倾向得分 | Propensity Score | 给定协变量下接受处理的条件概率,用于匹配与加权 |
| 逆概率加权 | IPTW | 用倾向得分倒数加权构造伪总体,消除混杂偏差 |
| 双重稳健 | Doubly Robust (DR) | 同时建模倾向得分和结果模型,只要一个正确即无偏 |
| 工具变量 | Instrumental Variable | 只通过影响处理间接影响结果的变量,用于应对未测混杂 |
| 后门准则 | Backdoor Criterion | 阻断处理到结果的所有混杂路径以保证因果可识别的准则 |
| 对撞偏差 | Collider Bias | 条件化一个被处理和结果共同影响的变量反而引入的虚假关联 |
| Neyman 正交性 | Neyman Orthogonality | 估计量对辅助模型误差不敏感的性质,双重 ML 的理论基础 |
| 双重机器学习 | Double ML | 用 ML 拟合残差消除混杂,估计无偏因果效应的现代方法 |
| 合成控制法 | Synthetic Control | 用未处理单元的加权组合构造合成对照,评估政策效应 |
| 因果发现 | Causal Discovery | 从观测数据中自动学习变量间因果结构(DAG)的方法 |
| 结构因果模型 | Structural Causal Model (SCM) | 用函数方程组描述变量间因果关系的数学框架,Pearl 提出 |
- Pearl,「Causality: Models, Reasoning, and Inference」(2000):Judea Pearl 的因果图与 do-演算体系奠基之作,因果推断的理论圣经。
- Rubin,「Estimating Causal Effects of Treatments in Randomized and Nonrandomized Studies」(1974):潜在结果框架的奠基论文,与 Pearl 的图模型并称两大流派。
- Imbens & Rubin,「Causal Inference for Statistics, Social, and Biomedical Sciences」(2015):潜在结果视角的权威教科书,系统梳理 RCT 与观察性研究方法。
- Hernán & Robins,「Causal Inference: What If」(2020):免费在线教材,以 DAG 与反事实并重的清晰讲解著称,入门首选。
- Chernozhukov et al.,「Double/debiased machine learning」(Econometrics Journal, 2018):双重 ML 论文,将现代 ML 与因果推断严谨结合的标志性工作。
- Athey & Imbens,「Recursive Partitioning for Heterogeneous Treatment Effects」(PNAS, 2016):因果树/因果森林的开创性论文,HTE 估计的里程碑。
- Künzel et al.,「Metalearners for estimating heterogeneous treatment effects」(PNAS, 2019):X-Learner 和 S/T-Learner 的系统比较,HTE 方法选型指南。
- Rosenbaum & Rubin,「The Central Role of the Propensity Score in Observational Studies for Causal Effects」(1983):倾向得分定理的原始论文,观察性研究的理论基石。
- Abadie et al.,「Synthetic Control Methods for Comparative Case Studies」(JASA, 2010):合成控制法的奠基论文。
- Spirtes et al.,「Causation, Prediction, and Search」(2000):PC 算法与基于约束的因果发现奠基之作。
- Kıcıman et al.,「Causal Reasoning and Large Language Models: Opening a New Frontier for Causality」(2023):LLM 用于因果推理的先驱研究,引发 2024-2025 LLM+因果的热潮。
- Zheng et al.,「Learning Sparse Nonparametric DAGs」(AISTATS, 2020):NOTEARS 系列的进阶,连续优化的因果发现方法。