
学习率调度策略
学习率调度(Learning Rate Scheduling)是深度学习训练中调参收益最大的一环——同样的模型和优化器,换一套调度策略,最终精度可能差出好几个百分点。本页梳理从最朴素的阶梯衰减到当今大模型标配的 Cosine + Warmup 的完整谱系,并深入推导其数学原理与工程实践。前置阅读:梯度下降与优化器。
沿用梯度下降中的”蒙眼下山”比喻,学习率就是每一步迈多大:
- 固定学习率= 从头到尾每步都迈 1 米。开始挺好,到了谷底附近却因为步子太大来回跨过最优点,永远停不下来。
- 阶梯衰减(Step Decay)= 走到一半把步子砍半,再走一半再砍半——像下楼梯,越接近谷底步子越小。
- 余弦衰减(Cosine Decay)= 步子按余弦曲线平滑缩小:开始大、中间均匀、末尾几乎为零,像飞机着陆一样丝滑减速。
- 预热(Warmup)= 起跑时腿还没热,先从极小的步子开始慢慢加速,热身完了再正常跑——防止刚出发就因为方向太乱摔跤。
- One Cycle(超收敛)= 先加速到很高的学习率,再快速降下来——像过山车,一个高峰冲过去就收,在有限步数内榨干性能。
- WSD(Warmup-Stable-Decay)= 预热→稳定巡航→快速衰减三段式,像飞机”起飞→平飞→降落”,2024 年以来在大模型中异军突起。
为什么需要调度
Section titled “为什么需要调度”学习率控制参数更新的步长。训练初期,参数离最优解很远,需要大步快走;训练后期,参数已经在最优解附近,大步会反复跨过最优点,需要小步精调。一个固定的学习率无法同时满足这两个矛盾的需求,所以要在训练过程中动态调整。
从优化的角度理解:梯度下降的更新规则为
其中 是模型参数(一个包含所有权重的高维向量), 是第 步的学习率, 是损失函数(Loss Function,衡量预测与真实值差距的标量)对参数的梯度(Gradient,指向损失增大最快方向的向量,取负号即下降最快方向)。
为什么固定学习率不行? 假设最优解附近损失曲面近似为二次型 ( 是 Hessian 矩阵,描述曲面的曲率),则梯度下降的收敛条件(不发散)要求:
其中 是 Hessian 的最大特征值。但在训练初期,我们处于高曲率区域( 大),需要小学习率才不发散;而在最优解附近的平坦区域,小学习率又导致收敛极慢。调度策略通过让 随时间变化来缓解这个矛盾——前期给较大学习率以快速接近最优点(同时用 Warmup 保证初期稳定),后期逐步缩小以精确收敛。
收敛速率的理论视角
Section titled “收敛速率的理论视角”在凸优化(Convex Optimization,目标函数为凸函数,只有一个全局最优解)理论中,固定学习率梯度下降的收敛速率为 (即误差与步数成反比)。而使用精心设计的递减学习率 ( 为强凸性常数),可达线性收敛(Linear Convergence,误差按指数速度下降)。这从理论上证明了:好的学习率调度能加速收敛。
在非凸的深度学习场景中,虽然没有严格保证,但实验和直觉一致——调度策略能显著影响最终的收敛点和泛化性能(Generalization,模型在未见数据上的表现能力)。
常见调度公式
Section titled “常见调度公式”记初始(峰值)学习率为 ,最终学习率为 ,当前训练进度为 (即 , 为总步数)。各种调度策略都是定义一个函数 ,使得当前学习率 。
阶梯衰减:每隔固定步数将学习率乘以衰减因子 :
其中 是阶梯总数, 通常取 或 。例如 ResNet 在 ImageNet 上的经典配方是第 30、60、90 个 epoch 各乘 (即 )。
指数衰减:学习率随时间连续指数下降:
每步乘以 ,下降速度极快,适合短训练。
余弦衰减:
当 时 ,当 时 。
余弦衰减的导数为(反映学习率下降的”速度”):
当 和 时导数为零,意味着开始和结束阶段学习率变化极缓;(中点)时变化最快。这种”中间快两头慢”的特性正好契合训练需求:初期稳定过渡、中期高效衰减、末期精细收敛。
线性预热:前 步线性升温:
为 Warmup 步数。预热结束后切换到上述衰减策略(如余弦衰减)。预热的本质是:训练初期损失曲面还没被探索,梯度方向噪声极大(因为参数还是随机初始化的),大学习率会让参数飞到不可控的区域。用小学习率缓慢起步,等 Adam 等优化器的一阶/二阶动量估计稳定后(通常需要几百到几千步),再加速到峰值。
多项式衰减(Polynomial Decay):用多项式函数从 衰减到 :
其中 控制衰减曲率: 退化为线性衰减, 前期慢降后期快降, 前期快降后期慢降。BERT 预训练默认使用线性衰减()。
One Cycle:分为上升和下降两段。上升段从 到 ,下降段从 到 ,最后进一步降到极小值。 通常取 10 到 25。其设计思路是:短暂的高学习率帮助跨过尖锐局部最优(Sharp Minima),找到更平坦、泛化更好的解(Flat Minima)。
WSD(Warmup-Stable-Decay):三段式调度:
WSD 的核心创新在于引入了一段恒定学习率的”稳定”阶段:在此阶段模型持续以峰值学习率训练,loss 持续下降但学习率不变;最后用较短的余弦衰减(通常占总步数的 10%-20%)快速”锁定”成果。WSD 的优势是支持无限续训(Continual Training)——如果你想增加训练步数,只需延长 Stable 阶段,不需要重新规划整条衰减曲线,这在 Cosine 调度中是做不到的(因为 Cosine 衰减的形状与总步数 强绑定)。
Warmup 为何对 Transformer 至关重要
Section titled “Warmup 为何对 Transformer 至关重要”Transformer 中的 LayerNorm(层归一化,对每一层的激活值做标准化使其均值为 0 方差为 1)/ 自注意力机制(Self-Attention,让序列中每个位置”关注”其他所有位置的机制)在训练初期极不稳定。具体原因有三层:
- 初始化放大效应:自注意力的 softmax(Softmax,将一组数值归一化为概率分布的操作)对未训练好的 QKV 矩阵非常敏感。初始化时注意力权重接近均匀分布,对任意输入都给出近似的注意力,导致梯度方向几乎是随机的。
- Adam 二阶矩冷启动:Adam 优化器依赖梯度二阶矩(二阶矩即梯度的方差/平方的移动平均)来缩放学习率。初始几步二阶矩估计接近零,导致有效学习率被放大( 中 很小),数值极不稳定。
- 大批量训练的方差:大批量(Large Batch,每次更新使用大量样本)场景下,虽然梯度均值更准,但 Adam 的自适应归一化在初期仍需稳定。
没有 Warmup 时,大学习率配合不稳定梯度会导致权重爆炸或 NaN。Warmup 让模型先用小步子稳定注意力分布和 Adam 的矩估计,再切换到正常学习率。这也是 GPT、BERT、LLaMA 等所有大语言模型训练的标配。
用数学语言表达:Adam 的有效学习率约为 ,在 未充分估计时(前几步),该值方差极大。Warmup 通过限制 来补偿 的不确定性:
当 从 0 增长时, 线性增长的同时 的估计也在逐步稳定,两者配合使有效步长保持在可控范围内。
调度策略谱系
Section titled “调度策略谱系”从最简单的固定学习率到现代大模型的 Cosine + Warmup 组合:
各策略的学习率曲线对比
Section titled “各策略的学习率曲线对比”下表给出关键节点上的学习率数值对比(,,总步数归一化为 1.0):
| 进度 | 阶梯衰减 () | 余弦衰减 | 线性预热(前 10%)+ 余弦 |
|---|---|---|---|
| 0.00 | 1.000 | 1.000 | 0.000 |
| 0.05 | 1.000 | 0.981 | 0.500 |
| 0.10 | 1.000 | 0.924 | 1.000 |
| 0.25 | 0.100 | 0.755 | 0.755 |
| 0.34 | 0.100 | 0.612 | 0.612 |
| 0.50 | 0.010 | 0.505 | 0.505 |
| 0.67 | 0.010 | 0.345 | 0.345 |
| 0.90 | 0.010 | 0.098 | 0.098 |
| 1.00 | 0.010 | 0.010 | 0.010 |
PyTorch 内置调度器对比
Section titled “PyTorch 内置调度器对比”import torchimport torch.nn as nnfrom torch.optim.lr_scheduler import StepLR, CosineAnnealingLR, ExponentialLR
# 简单模型 + 随机数据,对比不同调度器model = nn.Linear(20, 1)X = torch.randn(200, 20)y = X @ torch.randn(20, 1) + 0.1 * torch.randn(200, 1)criterion = nn.MSELoss()
epochs = 50schedulers = { # 阶梯衰减:每 20 个 epoch 学习率乘 0.5 "Step": lambda o: StepLR(o, step_size=20, gamma=0.5), # 指数衰减:每个 epoch 学习率乘 0.97 "Exponential": lambda o: ExponentialLR(o, gamma=0.97), # 余弦退火:T_max 设为总 epoch 数,曲线在 T_max 处降到 eta_min "Cosine": lambda o: CosineAnnealingLR(o, T_max=epochs, eta_min=1e-5),}
results = {}for sched_name, make_sched in schedulers.items(): torch.nn.init.normal_(model.weight, mean=0, std=0.1) torch.nn.init.zeros_(model.bias) opt = torch.optim.SGD(model.parameters(), lr=0.1, momentum=0.9) scheduler = make_sched(opt) # 创建调度器,绑定到优化器 losses = [] for epoch in range(epochs): loss = criterion(model(X), y) opt.zero_grad() # 清空上一步的梯度缓存 loss.backward() # 反向传播计算梯度 opt.step() # 用梯度更新参数 scheduler.step() # 每个 epoch 结束后更新学习率 losses.append(loss.item()) results[sched_name] = losses[-1] print(f"{sched_name:12s}: 最终 loss = {losses[-1]:.4f}, " f"最终 lr = {opt.param_groups[0]['lr']:.6f}")
# 典型输出:Cosine 收敛最平稳,Exponential 衰减最快手写 Warmup + Cosine 调度(大模型标配)
Section titled “手写 Warmup + Cosine 调度(大模型标配)”import mathimport matplotlib.pyplot as plt
# 大模型标配:线性预热 + 余弦衰减lr_max = 1e-3 # 峰值学习率lr_min = 1e-5 # 最小学习率(衰减终点)warmup_steps = 100 # 预热步数total_steps = 1000 # 总训练步数
def get_lr(step): """根据当前步数返回学习率。""" if step < warmup_steps: # 线性预热:从 0 线性升到 lr_max return lr_max * step / warmup_steps # 余弦衰减:从 lr_max 平滑降到 lr_min progress = (step - warmup_steps) / (total_steps - warmup_steps) progress = min(progress, 1.0) # 防止超出范围 return lr_min + 0.5 * (lr_max - lr_min) * (1 + math.cos(math.pi * progress))
# 打印关键节点验证曲线形状print(f"{'step':>6s} {'lr':>10s}")for s in [0, 50, 100, 300, 550, 800, 1000]: print(f"{s:6d} {get_lr(s):10.6f}")
# 可视化(可选)steps = list(range(total_steps + 1))lrs = [get_lr(s) for s in steps]plt.figure(figsize=(8, 3))plt.plot(steps, lrs, linewidth=2)plt.xlabel("Step"); plt.ylabel("Learning Rate")plt.title("Warmup + Cosine Decay")plt.grid(True, alpha=0.3)plt.tight_layout()plt.savefig("lr_schedule.png", dpi=150)# 输出示例:# step lr# 0 0.000000 ← 预热起点# 50 0.000500 ← 预热中段# 100 0.001000 ← 预热结束,到达峰值# 300 0.000905 ← 余弦衰减开始# 550 0.000503 ← 衰减中点# 1000 0.000010 ← 衰减终点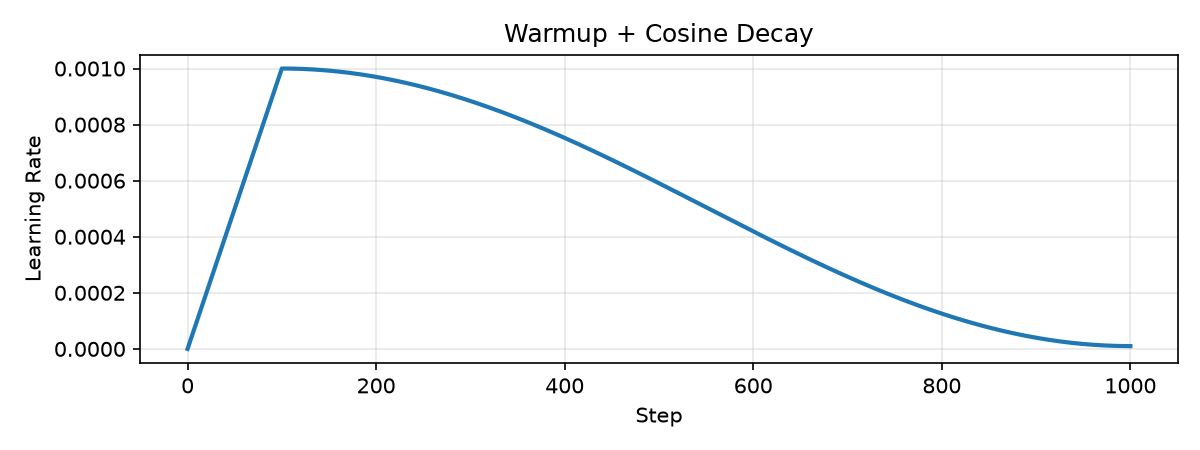
用 HuggingFace Transformers 的大模型调度器
Section titled “用 HuggingFace Transformers 的大模型调度器”from transformers import get_scheduler
# HuggingFace 封装了大模型常用的调度器,一行创建# 支持 "linear", "cosine", "cosine_with_restarts",# "polynomial", "constant", "constant_with_warmup"scheduler = get_scheduler( name="cosine", # 余弦衰减 optimizer=optimizer, # 已创建的优化器 num_warmup_steps=2000, # Warmup 2000 步 num_training_steps=total_steps, # 总步数)
# 在训练循环中使用for step, batch in enumerate(dataloader): loss = model(batch) loss.backward() optimizer.step() scheduler.step() # 关键:每步(不是每 epoch)调用 optimizer.zero_grad()注意:大模型训练中,调度器通常每步(step)调用一次
scheduler.step(),而不是每个 epoch。因为大模型训练一个 epoch 可能需要数万步,调度的粒度需要对齐到 step 级别。
WSD 调度实现(MiniCPM 风格)
Section titled “WSD 调度实现(MiniCPM 风格)”import math
def wsd_scheduler(step, warmup_steps, stable_steps, decay_steps, lr_max, lr_min): """Warmup-Stable-Decay 三段式调度。
Args: warmup_steps: 预热步数 stable_steps: 稳定巡航步数 decay_steps: 最后的快速衰减步数 """ if step < warmup_steps: # 第一段:线性预热 return lr_max * step / warmup_steps elif step < warmup_steps + stable_steps: # 第二段:恒定学习率(稳定巡航) return lr_max else: # 第三段:余弦快速衰减 decay_start = warmup_steps + stable_steps progress = (step - decay_start) / decay_steps progress = min(progress, 1.0) return lr_min + 0.5 * (lr_max - lr_min) * (1 + math.cos(math.pi * progress))
# 示例:总 10000 步,200 步预热,8000 步稳定,1800 步衰减total = 10000for s in [0, 100, 200, 5000, 8200, 9000, 10000]: lr = wsd_scheduler(s, warmup_steps=200, stable_steps=8000, decay_steps=1800, lr_max=1e-3, lr_min=1e-5) print(f"step {s:5d}: lr = {lr:.6f}")学习率范围测试(LR Range Test)
Section titled “学习率范围测试(LR Range Test)”在确定调度策略之前,首先需要找到合适的峰值学习率。**学习率范围测试(Learning Rate Range Test, LRRT)**由 Leslie Smith 提出,是目前最常用的自动化方法:
# 学习率范围测试:从极小 lr 开始线性增长,记录 loss 变化import torchimport matplotlib.pyplot as plt
model = nn.Linear(20, 1)torch.nn.init.normal_(model.weight, mean=0, std=0.1)opt = torch.optim.SGD(model.parameters(), lr=1e-7, momentum=0.9)
lr_log = []loss_log = []lr_factor = 1.01  # 每步将 lr 乘以 1.01
for step in range(300):    # 随机生成数据    X = torch.randn(64, 20)    y = X @ torch.randn(20, 1) + 0.1 * torch.randn(64, 1)    loss = nn.MSELoss()(model(X), y)    opt.zero_grad(); loss.backward(); opt.step()
    lr_log.append(opt.param_groups[0]['lr'])    loss_log.append(loss.item())
    # 手动增大学习率    for pg in opt.param_groups:        pg['lr'] *= lr_factor
# 绘图:x 轴为 lr(对数),y 轴为 lossplt.figure(figsize=(8, 3))plt.semilogx(lr_log, loss_log)plt.xlabel("Learning Rate (log scale)")plt.ylabel("Loss")plt.title("LR Range Test")plt.grid(True, alpha=0.3)plt.tight_layout()plt.savefig("lr_range_test.png", dpi=150)# 经验法则:选择 loss 下降最快处的 lr 作为峰值学习率,# 或选择 loss 开始反弹前一个数量级的 lr。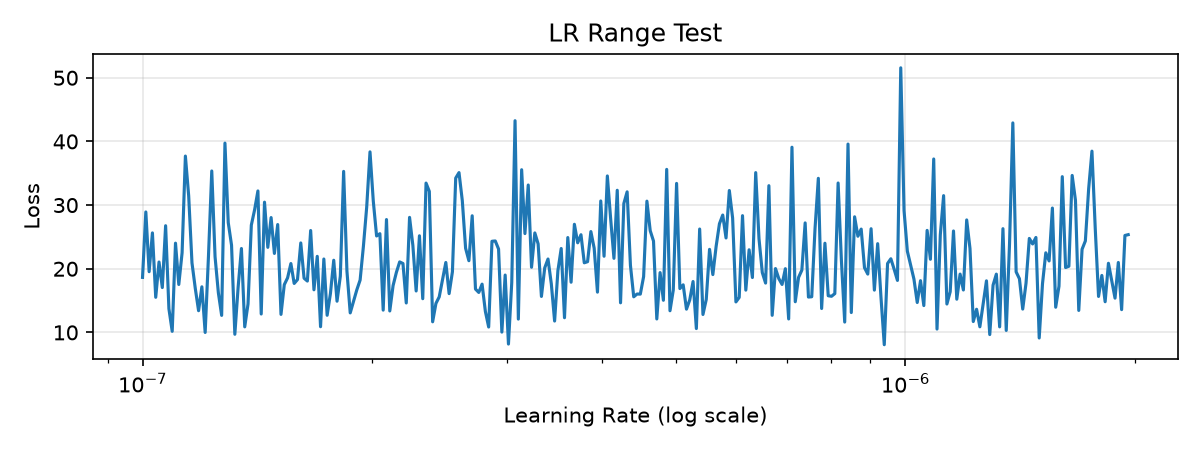
经验法则:在 LR Range Test 图上,loss 持续下降的区间中,取下降最陡处的学习率作为 。通常这个值比 loss 发散的临界值小 3-10 倍。
- 默认选 Cosine + Warmup:绝大多数现代深度学习任务(CV、NLP、扩散模型)的首选组合。Warmup 步数通常设为总步数的 5% 到 10%。
- 阶梯衰减适合快速实验:简单粗暴,每过几个 epoch 砍半。在 CNN 图像分类中仍然常见(如 ResNet 标准训练流程在第 30/60/90 epoch 衰减)。
- ReduceLROnPlateau 是自动兜底:当验证集 loss 连续几个 epoch 不下降时自动降低学习率,不用手动设时间点,适合不确定训练曲线形态时使用。它的数学形式为:当 连续 个 epoch 未低于历史最低值,则 。
- 学习率太小比太大更危险:学习率过大最差是训练发散(立刻能看到),学习率过小则训练极慢、可能陷入局部最优(难以察觉)。先用学习率范围测试(lr 从 1e-7 线性增到 1e1)找到 loss 下降最快的区间。
- 大模型训练的典型配置:GPT-3 用 Cosine Decay,warmup 2000 步,峰值学习率 ,最终降到峰值的 10%。LLaMA-2 用 Cosine Decay 配合 warmup 2000 步,峰值 。LLaMA-3 将 decay ratio 提高到 0.3(即衰减到峰值的 30%),配合更长的训练获得更好效果。
- One Cycle 适合算力有限的场景:在有限 epoch 内达到超收敛(Super-convergence),用更少的步数逼近常规调度的效果,fastai 和部分竞赛选手常用。
- 微调(Fine-tuning)时用更小的学习率:微调预训练模型时,学习率通常比预训练小 10 到 100 倍(如 到 ),配 Cosine Decay,防止破坏预训练特征。
- 不要设为零:余弦衰减终点设为峰值的 10% 左右通常比衰减到零效果更好——末期保留一定学习率可以继续优化,完全归零等于提前结束训练。
- 大语言模型预训练:GPT-4、LLaMA、Qwen 等无一例外使用 Cosine Decay + Warmup,通常衰减到峰值的 10%。MiniCPM 等新一代模型开始采用 WSD 调度以支持灵活续训。详见语言模型演进。
- Transformer 训练:自注意力机制对初期学习率极敏感,Warmup 是必备组件。详见Transformer 架构。
- CNN 图像分类:ResNet 标准配方用 Step Decay(30/60/90 epoch 各乘 0.1),详见CNN 卷积神经网络。
- 扩散模型训练:U-Net 噪声预测网络通常用 Cosine Decay。详见扩散模型。
- 迁移学习与微调:微调时用比预训练小 10 到 100 倍的学习率,通常配 Cosine Decay,防止破坏预训练特征。详见迁移学习。
各策略速查对比
Section titled “各策略速查对比”| 策略 | 公式特征 | 优点 | 缺点 | 典型场景 |
|---|---|---|---|---|
| 固定学习率 | 最简单 | 后期震荡 | 极少使用,仅做 baseline | |
| 阶梯衰减 | 断崖式乘 | 简单可控 | 曲线不连续 | ResNet 等经典 CNN |
| 指数衰减 | 衰减快 | 容易衰减过猛 | 短训练任务 | |
| 余弦衰减 | 曲线 | 平滑优雅 | 需预设总步数 | 大模型标配 |
| Cosine + Warmup | 预热 + 余弦 | 稳定 + 平滑 | 需调两个参数 | GPT/BERT/LLaMA |
| WSD | 预热-稳定-衰减 | 支持续训 | 三段需调参 | MiniCPM 等 2024+ 模型 |
| One Cycle | 先升后降 | 超收敛快 | 对 敏感 | 算力受限场景 |
| Schedule-Free | 无需调度 | 无需设 | 理论较新 | 2024+ AlgoPerf |
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| torch.optim.lr_scheduler | Python | PyTorch 内置调度器:StepLR、CosineAnnealingLR、ReduceLROnPlateau 等 |
| transformers.get_scheduler | Python | HuggingFace Transformers 提供 linear、cosine、cosine_with_restarts、polynomial 等大模型常用调度 |
| fastai Learner.fit_one_cycle | Python | fastai 封装的 One Cycle 策略,一行调用 |
| optax.schedulers | Python | JAX 生态的调度器库,Google 大模型训练首选 |
| schedulefree | Python | Schedule-Free 优化器库(Defazio et al.),无需指定训练总步数 |
| ray.tune | Python | 超参数搜索框架,支持自动搜索最佳调度策略参数 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 学习率调度 | Learning Rate Scheduling | 训练过程中动态调整学习率的策略,平衡早期快速收敛与后期精细调优 |
| 阶梯衰减 | Step Decay | 每隔固定步数将学习率乘以衰减因子(如 0.1),断崖式下降 |
| 余弦衰减 | Cosine Annealing | 学习率按余弦曲线从最大值平滑衰减到最小值,曲线末端梯度趋零 |
| 预热 | Warmup | 训练初期从极小学习率线性升温到目标值,防止早期梯度不稳定 |
| 指数衰减 | Exponential Decay | 学习率每步乘以固定因子,指数下降,速度快但容易衰减过猛 |
| 多项式衰减 | Polynomial Decay | 学习率按多项式函数衰减,曲率可调,BERT 预训练默认使用 |
| One Cycle | One Cycle Policy | 先升温到峰值再快速降温的策略,可在有限步数内实现超收敛 |
| 超收敛 | Super-convergence | 使用 One Cycle 策略在远少于常规训练的 epoch 内达到更高精度 |
| WSD | Warmup-Stable-Decay | 预热-稳定巡航-衰减三段式调度,支持续训和灵活扩展训练步数 |
| ReduceLROnPlateau | ReduceLROnPlateau | 验证集指标停滞时自动降低学习率的自适应策略 |
| 学习率范围测试 | LR Range Test | 从极小 lr 线性增长到极大值,观察 loss 变化以确定最佳峰值学习率 |
| Hessian 矩阵 | Hessian Matrix | 损失函数对参数的二阶偏导矩阵,描述损失曲面的曲率 |
| Schedule-Free | Schedule-Free Optimization | 不需要预设学习率调度和总步数的优化方法,通过迭代平均实现自动调度 |
最新进展(2025-2026)
Section titled “最新进展(2025-2026)”学习率调度领域在 2024-2025 年迎来了一批重要突破,核心趋势是从”精心设计的固定调度”走向”更灵活、更自适应”的方向。
1. WSD 调度的兴起与续训范式
Section titled “1. WSD 调度的兴起与续训范式”MiniCPM 团队在 2024 年提出的 WSD(Warmup-Stable-Decay) 调度正在改变大模型的训练范式。传统 Cosine 调度的核心痛点是:必须预先知道总训练步数 ,一旦 改变,整条衰减曲线都要重算。而 WSD 的”稳定”阶段可以任意延长,最后只需追加一段衰减即可”锁定”模型。
WSD 还揭示了一个有趣的训练动力学现象:在 Stable 阶段,loss 可能长时间停滞不降,但在最后的 Decay 阶段会突然大幅下降(称为 “decay phase drop”)。这表明 Stable 阶段模型实际上在积累”潜力”,而 Decay 阶段将这些潜力转化为实际的 loss 降低。这一发现挑战了”Cosine 调度始终最优”的传统认知。
参考论文:Hu et al., “MiniCPM: Unveiling the Potential of Small Language Models with Scalable Training Strategies”(arXiv:2404.06395, 2024)。
2. Schedule-Free 优化:摆脱调度的枷锁
Section titled “2. Schedule-Free 优化:摆脱调度的枷锁”Aaron Defazzo 等人在 2024 年提出的 Schedule-Free Optimization 更进一步——完全消除学习率调度。其核心思想是结合 迭代平均(Iterate Averaging) 和动量优化:不维护显式的学习率调度,而是对训练过程中的参数轨迹做加权平均,理论上等价于最优的衰减调度。
Schedule-Free AdamW 在 MLCommons 2024 AlgoPerf 算法效率挑战赛的 Self-Tuning 赛道中获得冠军,证明了在不需要手动设置调度的情况下,也能达到甚至超越精心调参的 Cosine 调度。这意味着研究者可以不再纠结”总步数设多少""Warmup 设几步”等问题。
数学直觉:传统调度的作用本质上是让后期的参数更新”权重”降低;而迭代平均通过 的方式,自然地让早期(不稳定的)参数和后期(稳定的)参数都参与最终结果,等价于一种隐式衰减。Schedule-Free 的理论贡献在于证明了这种平均可以在不牺牲收敛速率的前提下完全替代显式调度。
参考论文:Defazzo et al., “The Road Less Scheduled”(arXiv:2405.15682, 2024)。
3. Muon 优化器与调度协同
Section titled “3. Muon 优化器与调度协同”2024 年底由 Keller Jordan 等人发起的 Muon 优化器(Momentum + Orthogonalization)为学习率调度带来了新的考量维度。Muon 对矩阵参数(如注意力权重、FFN 权重)的梯度做正交化(Newton-Schulz 迭代近似 SVD),使得每一步的更新方向更均匀地分布在所有维度上。这意味着与传统 Adam 相比,Muon 对学习率的敏感性降低——峰值学习率可以设得更大,Warmup 可以更短。
Muon + WSD 的组合在 2025 年的小规模 GPT-2/Muon 训练实验中(如 Moonshot 等团队的工作)展现出显著优于 AdamW + Cosine 的效率,被部分团队称为”下一代大模型训练范式”。不过该方向仍处于快速迭代中。
4. 超大批量训练中的调度优化
Section titled “4. 超大批量训练中的调度优化”2024-2025 年,随着 GPU 集群规模扩大到数万张卡,批量大小(Batch Size)从几千增长到数百万 token。超大批量下,传统的线性 Warmup 已显不足——研究者开始探索:
- 批量 Warmup(Batch Size Warmup):不仅预热学习率,还从小批量开始逐步增大批量大小,让梯度估计和学习率同步稳定。
- 递减学习率的替代方案:部分团队发现在极大批量下,保持较高学习率训练更长时间(类似 WSD 的 Stable 阶段)反而比快速衰减效果更好,因为大批量本身提供了天然的梯度平滑效果。
- LLaMA-3 系列将余弦衰减的终点从 10% 提高到 30%,配合 15T token 的超大规模训练,这一经验正在被后续大模型广泛采纳。
5. 自适应调度的探索
Section titled “5. 自适应调度的探索”2025 年的一些研究开始探索完全自适应的调度策略——根据训练过程中的实时信号(如梯度范数、loss 曲率、validation loss 变化率)自动调整学习率,而非依赖预设的时间表。虽然目前还没有一个方案能完全取代手动调参,但 Schedule-Free 和 Muon 的成功表明:让优化器自己”决定”学习率如何变化是一个有前景的方向。
- Loshchilov & Hutter,「SGDR: Stochastic Gradient Descent with Warm Restarts」(ICLR 2017):提出带热重启的余弦退火(Cosine Annealing with Restarts),让学习率周期性重置以跳出局部最优。arXiv:1608.03983
- Smith,「Cyclical Learning Rates for Training Neural Networks」(WACV 2017):提出 One Cycle 策略和学习率范围测试方法,是现代学习率调参的奠基性工作。arXiv:1506.01186
- Goyal et al.,「Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour」(2017):Facebook 的大批量训练实践,详细讨论 Warmup 在大批量场景下的必要性。arXiv:1706.02677
- Hu et al.,「MiniCPM: Unveiling the Potential of Small Language Models with Scalable Training Strategies」(2024):提出 WSD 调度,分析了 Decay 阶段的”潜力释放”现象。arXiv:2404.06395
- Defazzo et al.,「The Road Less Scheduled」(2024):Schedule-Free 优化,无需预设调度的训练方法,AlgoPerf 2024 冠军。arXiv:2405.15682
- HuggingFace Transformers 文档 - Schedulers:罗列了 linear、cosine、cosine_with_restarts 等大模型常用调度的实现细节,适合直接查阅。Transformers Scheduler Docs