
ArUco 标记检测
位姿估计在许多计算机视觉应用中都非常重要:机器人导航、增强现实等等。这一过程基于在真实环境中的点与其二维图像投影之间寻找对应关系。这通常是一个困难的步骤,因此通常会使用合成标记或基准标记(fiducial marker)来简化它。
最常用的方法之一是使用二值方形基准标记。这些标记的主要好处是,单个标记就提供了足够的对应关系(其四个角点)来获取相机位姿。此外,内部的二值编码使它们特别鲁棒,从而有可能应用错误检测和纠正技术。
aruco 模块基于 ArUco 库,这是一个由 Rafael Muñoz 和 Sergio Garrido 开发的用于检测方形基准标记的流行库 (Aruco2014)。
aruco 功能包含在:
#include <opencv2/objdetect/aruco_detector.hpp>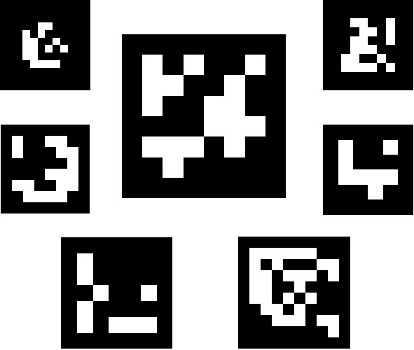
ArUco 标记是一种合成方形标记,由一个宽的黑色边框和一个决定其标识符(id)的内部二值矩阵组成。黑色边框便于在图像中快速检测它,而二值编码则允许对其进行识别并应用错误检测和纠正技术。标记尺寸决定了内部矩阵的大小。例如,4x4 的标记尺寸由 16 个比特位组成。
需要注意的是,标记在环境中可能会被旋转着发现,然而,检测过程需要能够确定其原始旋转,以便每个角点都能被明确地识别。这也是基于二值编码完成的。
标记字典是在特定应用中所考虑的一组标记的集合。它就是其每个标记的二值编码列表。
字典的主要属性是字典大小和标记尺寸。
- 字典大小是组成字典的标记数量。
- 标记尺寸是这些标记的大小(比特位/模块的数量)。
aruco 模块包含一些预定义的字典,涵盖了不同的字典大小和标记尺寸范围。
人们可能会认为标记 id 是将二值编码转换为十进制数得到的数字。然而,这是不可能的,因为对于较大的标记尺寸,比特位数量太多,管理这么大的数字并不实际。相反,标记 id 仅仅是该标记在其所属字典中的索引。例如,字典中的前 5 个标记的 id 为:0、1、2、3 和 4。
有关字典的更多信息在「选择字典」一节中提供。
在检测之前,需要先打印标记以便放置在环境中。可以使用 generateImageMarker() 函数生成标记图像。
例如,让我们分析以下调用:
cv::Mat markerImage;cv::aruco::Dictionary dictionary = cv::aruco::getPredefinedDictionary(cv::aruco::DICT_6X6_250);cv::aruco::generateImageMarker(dictionary, 23, 200, markerImage, 1);cv::imwrite("marker23.png", markerImage);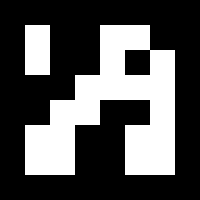
首先,通过在 aruco 模块中选择一个预定义字典来创建 cv::aruco::Dictionary 对象。具体而言,这个字典由 250 个标记和 6x6 比特位的标记尺寸(cv::aruco::DICT_6X6_250)组成。
cv::aruco::generateImageMarker() 的参数是:
- 第一个参数是前面创建的
cv::aruco::Dictionary对象。 - 第二个参数是标记 id,本例中是字典
cv::aruco::DICT_6X6_250的标记 23。注意,每个字典由不同数量的标记组成。本例中,有效的 id 范围是 0 到 249。任何超出有效范围的 id 都会产生异常。 - 第三个参数 200 是输出标记图像的尺寸。本例中,输出图像的尺寸为 200x200 像素。注意,此参数应当足够大,以存储特定字典所需的比特位数。因此,例如,你不能为 6x6 比特位的标记尺寸生成 5x5 像素的图像(而且这还没有考虑标记边框)。此外,为避免变形,此参数应当与比特位数 + 边框尺寸成正比,或者至少比标记尺寸大得多(如示例中的 200),以使变形可以忽略不计。
- 第四个参数是输出图像。
- 最后,最后一个参数是可选参数,用于指定标记黑色边框的宽度。其大小按相对于比特位数的比例指定。例如,值为 2 意味着边框的宽度等于两个内部比特位的尺寸。默认值为 1。
samples/cpp/tutorial_code/objectDetection/ 中的 create_marker.cpp 包含了一个完整的可运行示例。
现在,这些示例使用 cv::CommandLineParser 从命令行获取输入。对于此文件,示例参数如下:
"marker23.png" -d=10 -id=23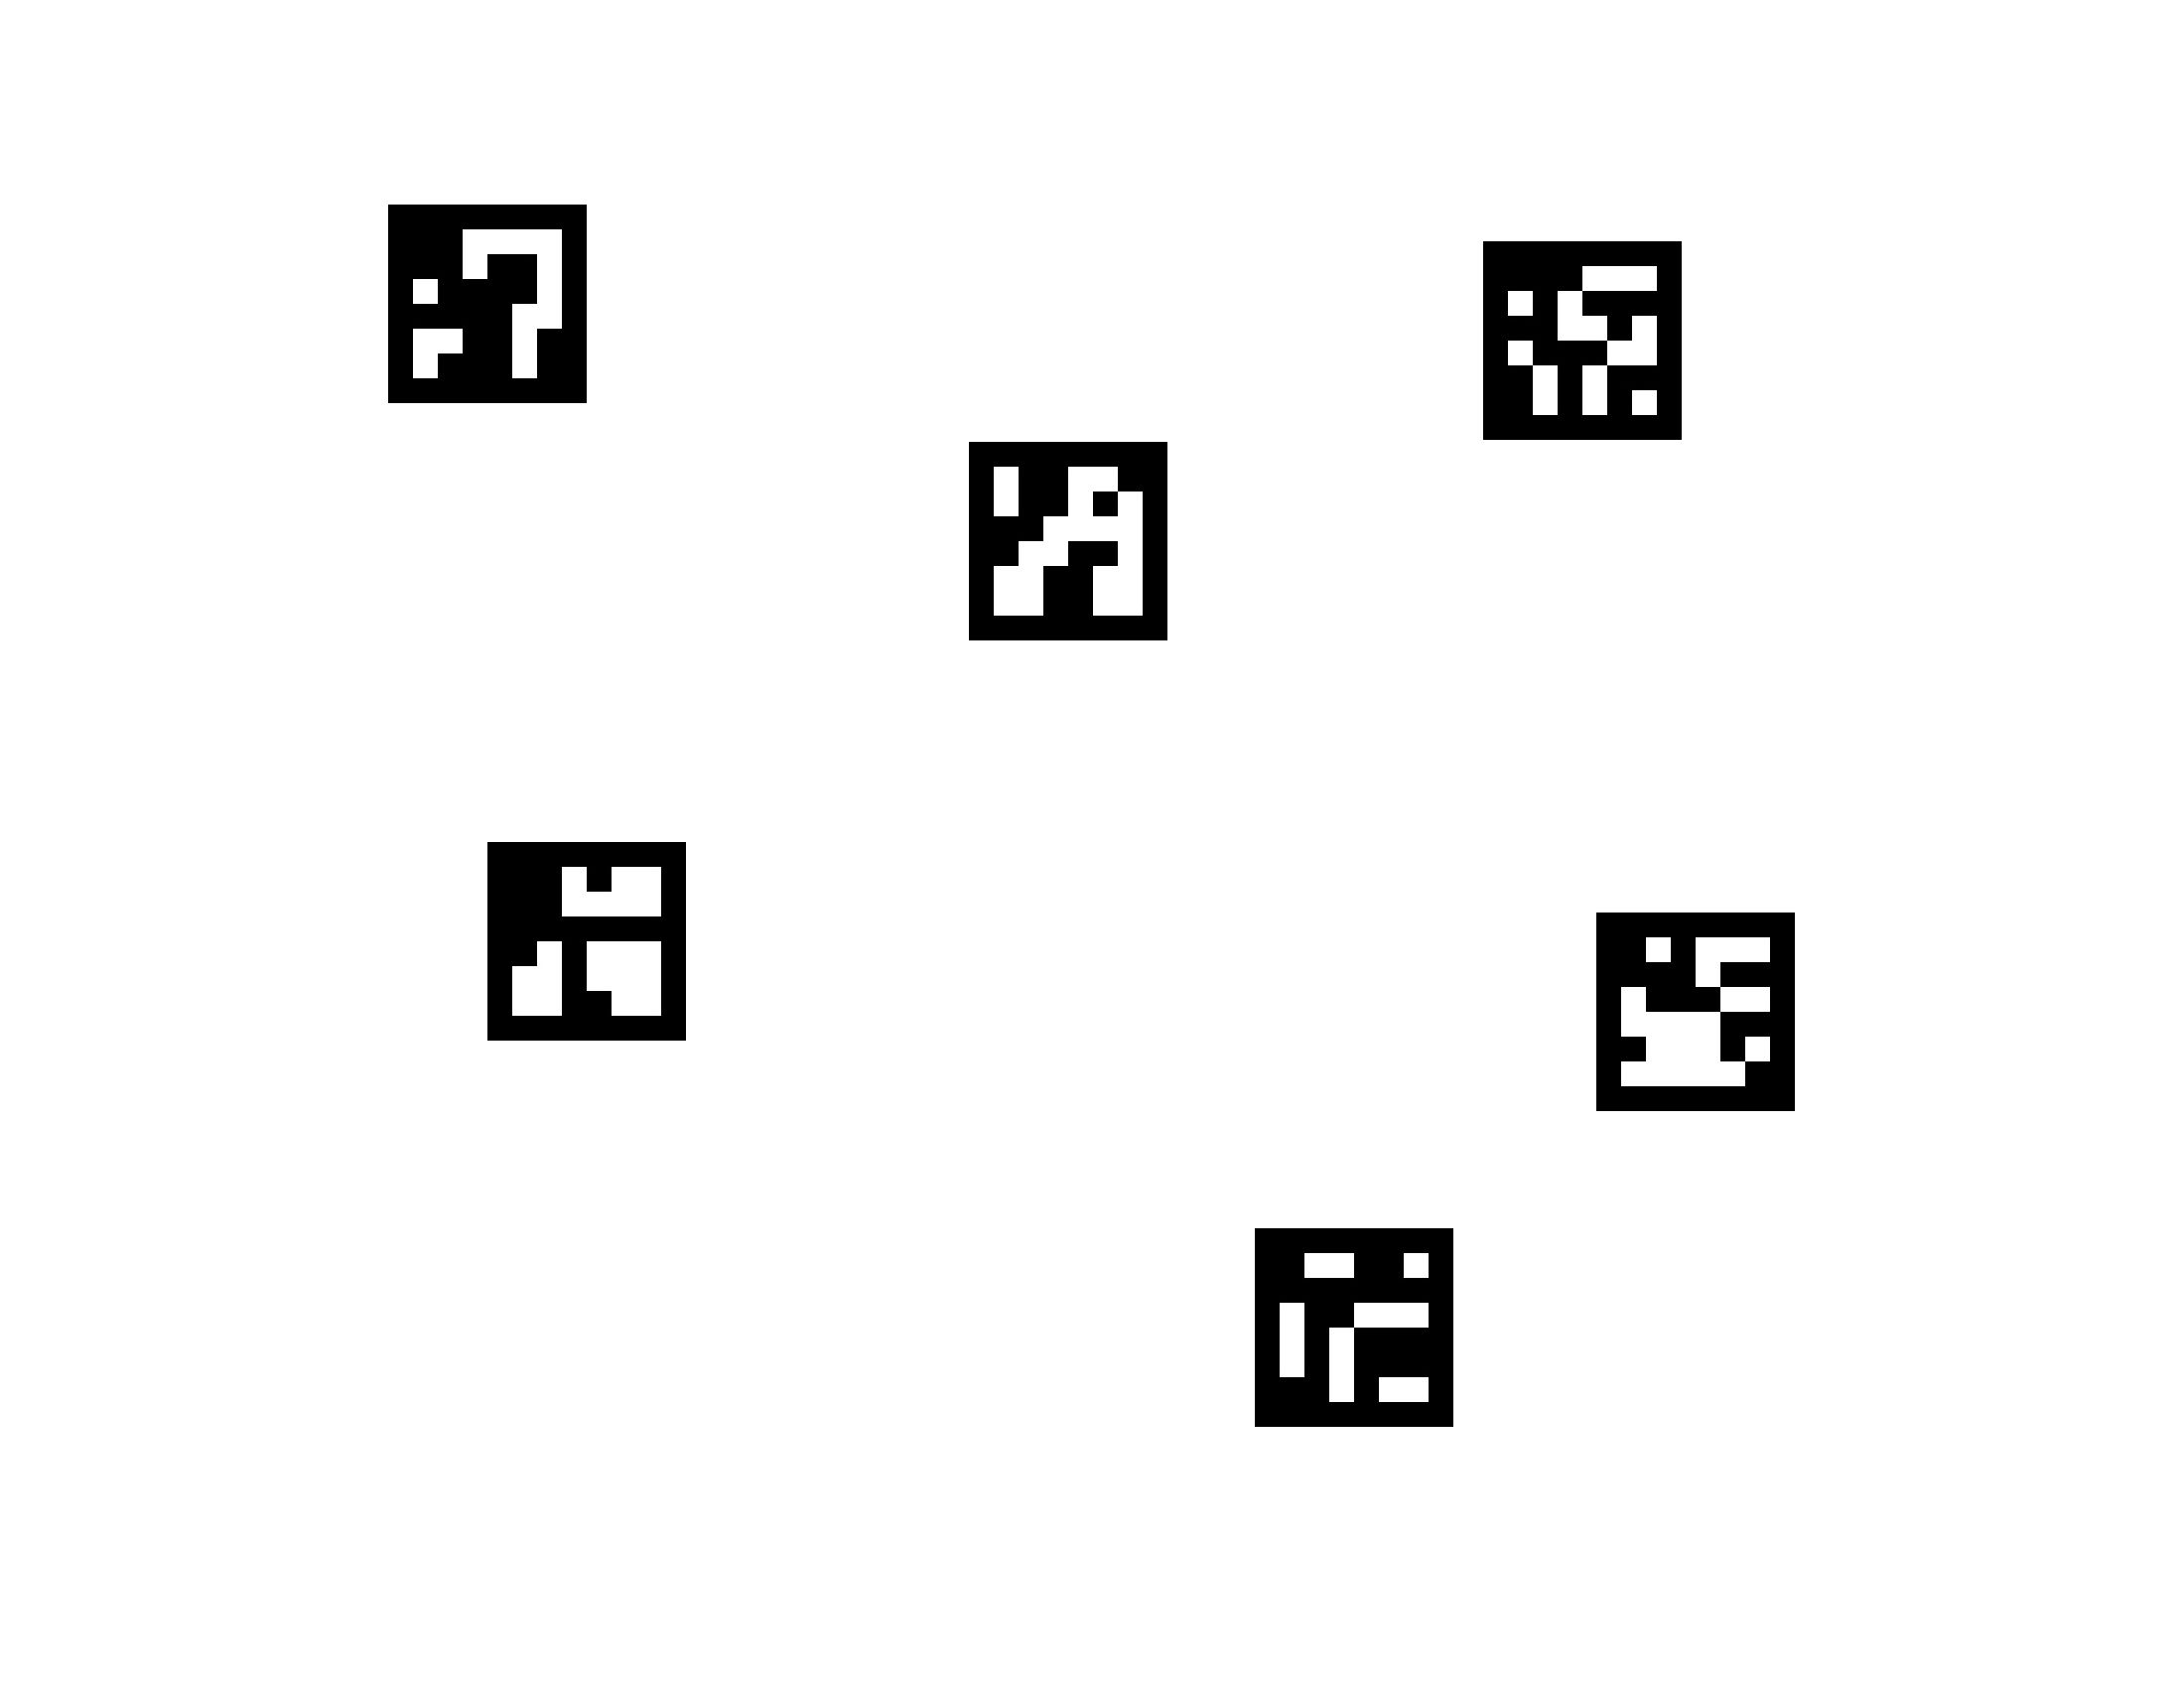
create_marker.cpp 的参数:
const char* keys = "{@outfile |res.png| Output image }" "{d | 0 | dictionary: DICT_4X4_50=0, DICT_4X4_100=1, DICT_4X4_250=2," "DICT_4X4_1000=3, DICT_5X5_50=4, DICT_5X5_100=5, DICT_5X5_250=6, DICT_5X5_1000=7, " "DICT_6X6_50=8, DICT_6X6_100=9, DICT_6X6_250=10, DICT_6X6_1000=11, DICT_7X7_50=12," "DICT_7X7_100=13, DICT_7X7_250=14, DICT_7X7_1000=15, DICT_ARUCO_ORIGINAL=16," "DICT_APRILTAG_16h5=17, DICT_APRILTAG_25h9=18, DICT_APRILTAG_36h10=19, DICT_APRILTAG_36h11=20, DICT_ARUCO_MIP_36h12=21}" "{cd | | Input file with custom dictionary }" "{id | 0 | Marker id in the dictionary }" "{ms | 200 | Marker size in pixels }" "{bb | 1 | Number of bits in marker borders }" "{si | false | show generated image }";给定一张包含 ArUco 标记的图像,检测过程必须返回检测到的标记列表。每个检测到的标记包括:
- 其四个角点在图像中的位置(按其原始顺序)。
- 标记的 id。
标记检测过程由两个主要步骤组成:
-
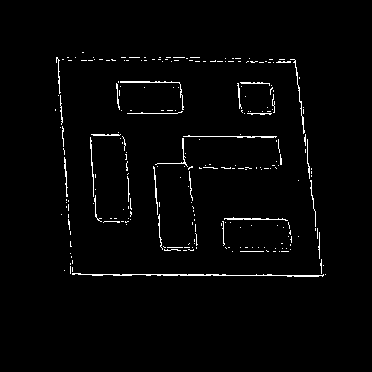
标记候选项检测。在此步骤中,对图像进行分析以找到作为标记候选项的方形形状。它从自适应阈值化开始分割标记,然后从阈值化图像中提取轮廓,并丢弃那些非凸的或不能近似为方形形状的轮廓。还会应用一些额外的过滤(去除太小或太大的轮廓、去除彼此太接近的轮廓等)。
-
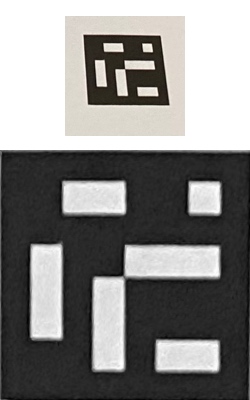
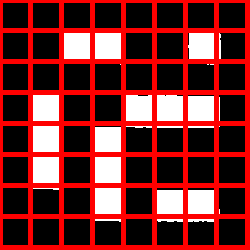
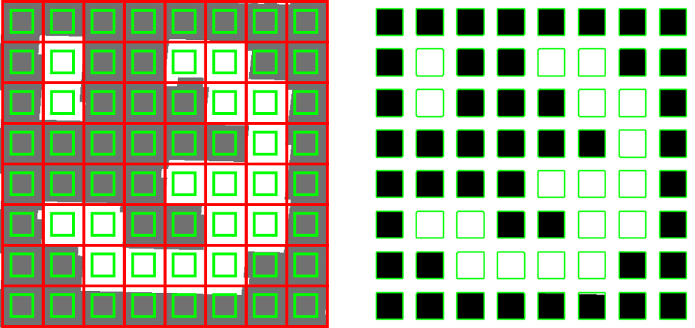
候选项检测之后,需要通过分析其内部编码来确定它们是否实际上是标记。此步骤首先提取每个标记的比特位。为此,首先应用透视变换以获得标记的规范形式。然后,使用 Otsu 对规范图像进行阈值化以分离白色和黑色比特位。根据标记尺寸和边框尺寸,将图像划分为不同的单元格。然后计算每个单元格中黑色或白色像素的数量,以确定它是白色比特位还是黑色比特位。最后,分析比特位以确定该标记是否属于特定的字典。必要时会采用错误纠正技术。
在 aruco 模块中,检测由 cv::aruco::ArucoDetector::detectMarkers() 函数执行。该函数是模块中最重要的函数,因为其余所有功能都基于 cv::aruco::ArucoDetector::detectMarkers() 返回的检测到的标记。
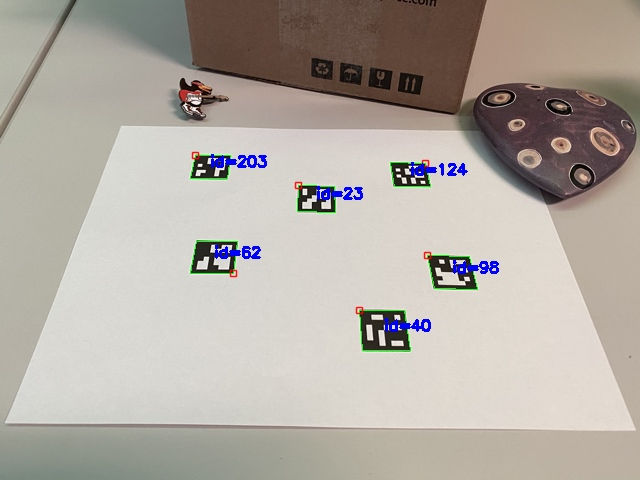
标记检测的一个示例:
cv::Mat inputImage;// ... read inputImage ...std::vector<int> markerIds;std::vector<std::vector<cv::Point2f>> markerCorners, rejectedCandidates;cv::aruco::DetectorParameters detectorParams = cv::aruco::DetectorParameters();cv::aruco::Dictionary dictionary = cv::aruco::getPredefinedDictionary(cv::aruco::DICT_6X6_250);cv::aruco::ArucoDetector detector(dictionary, detectorParams);detector.detectMarkers(inputImage, markerCorners, markerIds, rejectedCandidates);当你创建一个 cv::aruco::ArucoDetector 对象时,你需要向构造函数传递以下参数:
- 一个字典对象,本例中是预定义字典之一(
cv::aruco::DICT_6X6_250)。 cv::aruco::DetectorParameters类型的对象。该对象包含检测过程中可以自定义的所有参数。这些参数将在下一节中说明。
cv::aruco::ArucoDetector::detectMarkers() 的参数是:
- 第一个参数是包含要检测标记的图像。
- 检测到的标记存储在
markerCorners和markerIds结构中:markerCorners是检测到的标记的角点列表。对于每个标记,其四个角点按其原始顺序返回(从左上角开始的顺时针顺序)。因此,第一个角点是左上角,接着是右上角、右下角和左下角。markerIds是markerCorners中每个检测到的标记的 id 列表。注意,返回的markerCorners和markerIds向量具有相同的大小。
- 最后一个可选参数
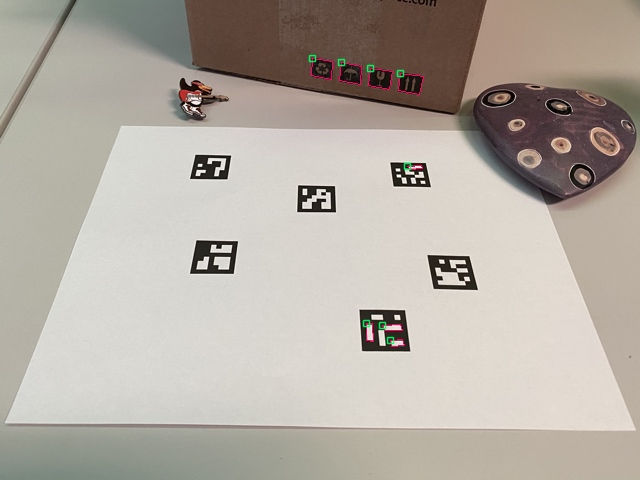
rejectedCandidates是返回的标记候选项列表,即被发现和考虑过但不包含有效标记的形状。每个候选项也由其四个角点定义,其格式与markerCorners参数相同。此参数可以省略,仅用于调试目的和「重新查找」策略(参见cv::aruco::ArucoDetector::refineDetectedMarkers())。
在 cv::aruco::ArucoDetector::detectMarkers() 之后,你可能想做的下一件事是检查你的标记是否已被正确检测。幸运的是,aruco 模块提供了一个在输入图像中绘制检测到的标记的函数,即 drawDetectedMarkers()。例如:
cv::Mat outputImage = inputImage.clone();cv::aruco::drawDetectedMarkers(outputImage, markerCorners, markerIds);
outputImage是将要绘制标记的输入/输出图像(通常与检测到标记的图像相同)。markerCorners和markerIds是cv::aruco::ArucoDetector::detectMarkers()函数返回的检测到的标记结构。
注意,此函数仅用于可视化,可以省略使用。
借助这两个函数,我们可以创建一个基本的标记检测循环来从相机中检测标记:
cv::aruco::ArucoDetector detector(dictionary, detectorParams);cv::VideoCapture inputVideo;int waitTime;if(!video.empty()) {    inputVideo.open(video);    waitTime = 0;} else {    inputVideo.open(camId);    waitTime = 10;}
double totalTime = 0;int totalIterations = 0;
// set coordinate systemcv::Mat objPoints(4, 1, CV_32FC3);objPoints.ptr<Vec3f>(0)[0] = Vec3f(-markerLength/2.f, markerLength/2.f, 0);objPoints.ptr<Vec3f>(0)[1] = Vec3f(markerLength/2.f, markerLength/2.f, 0);objPoints.ptr<Vec3f>(0)[2] = Vec3f(markerLength/2.f, -markerLength/2.f, 0);objPoints.ptr<Vec3f>(0)[3] = Vec3f(-markerLength/2.f, -markerLength/2.f, 0);
while(inputVideo.grab()) {    cv::Mat image, imageCopy;    inputVideo.retrieve(image);
    double tick = (double)getTickCount();
    vector<int> ids;    vector<vector<Point2f> > corners, rejected;
    // detect markers and estimate pose    detector.detectMarkers(image, corners, ids, rejected);
    size_t nMarkers = corners.size();    vector<Vec3d> rvecs(nMarkers), tvecs(nMarkers);
    if(estimatePose && !ids.empty()) {        // Calculate pose for each marker        for (size_t i = 0; i < nMarkers; i++) {            solvePnP(objPoints, corners.at(i), camMatrix, distCoeffs, rvecs.at(i), tvecs.at(i));        }    }
    double currentTime = ((double)getTickCount() - tick) / getTickFrequency();    totalTime += currentTime;    totalIterations++;    if(totalIterations % 30 == 0) {        cout << "Detection Time = " << currentTime * 1000 << " ms "             << "(Mean = " << 1000 * totalTime / double(totalIterations) << " ms)" << endl;    }
    // draw results    image.copyTo(imageCopy);    if(!ids.empty()) {        cv::aruco::drawDetectedMarkers(imageCopy, corners, ids);
        if(estimatePose) {            for(unsigned int i = 0; i < ids.size(); i++)                cv::drawFrameAxes(imageCopy, camMatrix, distCoeffs, rvecs[i], tvecs[i], markerLength * 1.5f, 2);        }    }
    if(showRejected && !rejected.empty())        cv::aruco::drawDetectedMarkers(imageCopy, rejected, noArray(), Scalar(100, 0, 255));
    imshow("out", imageCopy);    char key = (char)waitKey(waitTime);    if(key == 27) break;}
注意,一些可选参数已被省略,如检测参数对象和被拒绝候选项的输出向量。
samples/cpp/tutorial_code/objectDetection/ 中的 detect_markers.cpp 包含了一个完整的可运行示例。
现在,这些示例使用 cv::CommandLineParser 从命令行获取输入。对于此文件,示例参数如下:
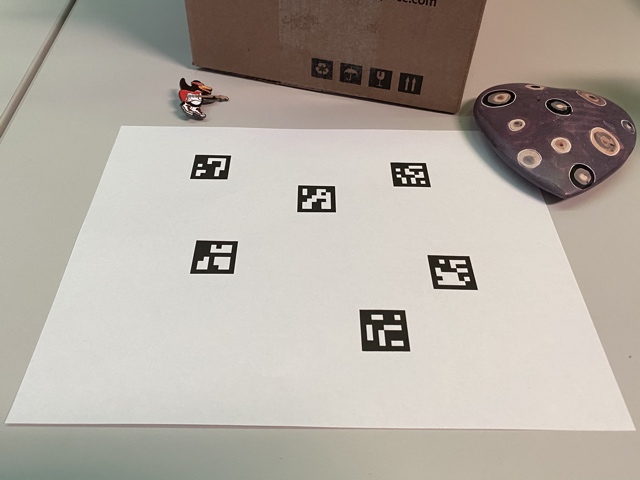
-v=/path_to_opencv/opencv/doc/tutorials/objdetect/aruco_detection/images/singlemarkersoriginal.jpg -d=10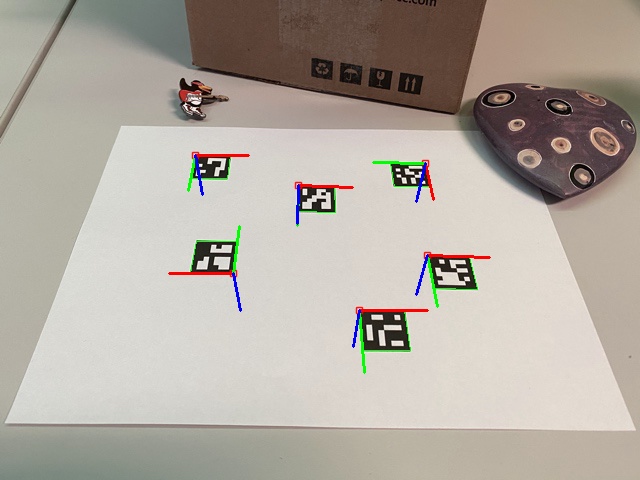
detect_markers.cpp 的参数:
const char* keys = "{d | 0 | dictionary: DICT_4X4_50=0, DICT_4X4_100=1, DICT_4X4_250=2," "DICT_4X4_1000=3, DICT_5X5_50=4, DICT_5X5_100=5, DICT_5X5_250=6, DICT_5X5_1000=7, " "DICT_6X6_50=8, DICT_6X6_100=9, DICT_6X6_250=10, DICT_6X6_1000=11, DICT_7X7_50=12," "DICT_7X7_100=13, DICT_7X7_250=14, DICT_7X7_1000=15, DICT_ARUCO_ORIGINAL = 16," "DICT_APRILTAG_16h5=17, DICT_APRILTAG_25h9=18, DICT_APRILTAG_36h10=19, DICT_APRILTAG_36h11=20, DICT_ARUCO_MIP_36h12=21}" "{cd | | Input file with custom dictionary }" "{v | | Input from video or image file, if ommited, input comes from camera }" "{ci | 0 | Camera id if input doesnt come from video (-v) }" "{c | | Camera intrinsic parameters. Needed for camera pose }" "{l | 0.1 | Marker side length (in meters). Needed for correct scale in camera pose }" "{dp | | File of marker detector parameters }" "{r | | show rejected candidates too }" "{refine | | Corner refinement: CORNER_REFINE_NONE=0, CORNER_REFINE_SUBPIX=1," "CORNER_REFINE_CONTOUR=2, CORNER_REFINE_APRILTAG=3}";在检测到标记之后,你可能想做的下一件事是利用它们来获取相机位姿。
要进行相机位姿估计,你需要知道相机的标定参数,即相机矩阵和畸变系数。如果你不知道如何标定相机,可以查看 calibrateCamera() 函数和 OpenCV 的标定教程。你也可以按照「使用 ArUco 和 ChArUco 进行标定」教程中的说明使用 aruco 模块来标定相机。注意,除非相机光学系统被修改(例如更改其焦距),否则这只需做一次。
标定的结果是,你会得到一个相机矩阵:一个 3x3 元素的矩阵,包含焦距和相机中心坐标(又称内参),以及畸变系数:一个由 5 个或更多元素组成的向量,用于对相机产生的畸变进行建模。
当你用 ArUco 标记估计位姿时,你可以逐个估计每个标记的位姿。如果你想从一组标记中估计一个位姿,请使用 ArUco 标定板(参见「ArUco 标定板检测」教程)。使用 ArUco 标定板而不是单个标记可以允许某些标记被遮挡。
相机相对于标记的位姿是从标记坐标系到相机坐标系的三维变换。它由旋转向量和平移向量指定。OpenCV 提供 cv::solvePnP() 函数来完成此操作:
Mat camMatrix, distCoeffs;if(estimatePose) { // You can read camera parameters from tutorial_camera_params.yml readCameraParamsFromCommandLine(parser, camMatrix, distCoeffs);}// set coordinate systemcv::Mat objPoints(4, 1, CV_32FC3);objPoints.ptr<Vec3f>(0)[0] = Vec3f(-markerLength/2.f, markerLength/2.f, 0);objPoints.ptr<Vec3f>(0)[1] = Vec3f(markerLength/2.f, markerLength/2.f, 0);objPoints.ptr<Vec3f>(0)[2] = Vec3f(markerLength/2.f, -markerLength/2.f, 0);objPoints.ptr<Vec3f>(0)[3] = Vec3f(-markerLength/2.f, -markerLength/2.f, 0);vector<int> ids;vector<vector<Point2f> > corners, rejected;
// detect markers and estimate posedetector.detectMarkers(image, corners, ids, rejected);
size_t nMarkers = corners.size();vector<Vec3d> rvecs(nMarkers), tvecs(nMarkers);
if(estimatePose && !ids.empty()) { // Calculate pose for each marker for (size_t i = 0; i < nMarkers; i++) { solvePnP(objPoints, corners.at(i), camMatrix, distCoeffs, rvecs.at(i), tvecs.at(i)); }}corners参数是cv::aruco::ArucoDetector::detectMarkers()函数返回的标记角点向量。- 第二个参数是标记边长的尺寸,以米或任何其他单位表示。注意,估计位姿的平移向量将使用相同的单位。
camMatrix和distCoeffs是在相机标定过程中创建的相机标定参数。- 输出参数
rvecs和tvecs分别是corners中每个检测到的标记的旋转向量和平移向量。
该函数所假定的标记坐标系位于标记的中心(默认)或左上角,Z 轴朝外指向。轴与颜色的对应关系为 X:红色,Y:绿色,Z:蓝色。注意旋转标记的轴方向。
OpenCV 提供了一个绘制上述坐标轴的函数,以便可以检查位姿估计:
// draw resultsimage.copyTo(imageCopy);if(!ids.empty()) {    cv::aruco::drawDetectedMarkers(imageCopy, corners, ids);
if(estimatePose) { for(unsigned int i = 0; i < ids.size(); i++) cv::drawFrameAxes(imageCopy, camMatrix, distCoeffs, rvecs[i], tvecs[i], markerLength * 1.5f, 2); }}imageCopy是将要显示检测到的标记的输入/输出图像。camMatrix和distCoeffs是相机标定参数。rvecs[i]和tvecs[i]分别是每个检测到的标记的旋转向量和平移向量。- 最后一个参数是坐标轴的长度,单位与 tvec 相同(通常为米)。
示例视频:视频演示
samples/cpp/tutorial_code/objectDetection/ 中的 detect_markers.cpp 包含了一个完整的可运行示例。
现在,这些示例使用 cv::CommandLineParser 从命令行获取输入。对于此文件,示例参数如下:
-v=/path_to_opencv/opencv/doc/tutorials/objdetect/aruco_detection/images/singlemarkersoriginal.jpg -d=10-c=/path_to_opencv/opencv/samples/cpp/tutorial_code/objectDetection/tutorial_camera_params.ymldetect_markers.cpp 的参数与上一节所示的相同。
aruco 模块提供 Dictionary 类来表示标记字典。
除了标记尺寸和字典中标记的数量之外,字典还有一个重要参数——标记间距离(inter-marker distance)。标记间距离是字典标记之间的最小汉明距离(Hamming distance),它决定了字典检测和纠正错误的能力。
通常,较小的字典大小和较大的标记尺寸会增加标记间距离,反之亦然。然而,由于需要从图像中提取的比特位数更多,检测较大尺寸的标记更加困难。
例如,如果你的应用中只需要 10 个标记,那么最好使用仅由这 10 个标记组成的字典,而不是使用由 1000 个标记组成的字典。原因是,由 10 个标记组成的字典将具有更高的标记间距离,因此对错误更鲁棒。
因此,aruco 模块提供了几种选择标记字典的方法,以便你可以提高系统的鲁棒性:
这是选择字典最简单的方法。aruco 模块包含一组预定义的字典,具有多种标记尺寸和标记数量。例如:
cv::aruco::Dictionary dictionary = cv::aruco::getPredefinedDictionary(cv::aruco::DICT_6X6_250);cv::aruco::DICT_6X6_250 是一个预定义字典的示例,它具有 6x6 比特位,共 250 个标记。
在所有提供的字典中,建议选择适合你应用的最小字典。例如,如果你需要 200 个 6x6 比特位的标记,使用 cv::aruco::DICT_6X6_250 比使用 cv::aruco::DICT_6X6_1000 更好。字典越小,标记间距离越高。
可用的预定义字典列表可以在 PredefinedDictionaryType 枚举的文档中找到。
自动字典生成
Section titled “自动字典生成”可以自动生成字典,以调整所需的标记数量和比特位数,从而优化标记间距离:
cv::aruco::Dictionary dictionary = cv::aruco::extendDictionary(36, 5);这将生成一个由 36 个 5x5 比特位标记组成的自定义字典。该过程可能需要几秒钟,具体取决于参数(对于较大的字典和较多的比特位数,它会更慢)。
你也可以使用 opencv/samples/cpp 中的 aruco_dict_utils.cpp 示例。该示例计算生成的字典的最小汉明距离,还允许你创建对镜像反射具有抵抗力的标记。
手动字典定义
Section titled “手动字典定义”最后,可以手动配置字典,从而可以使用任何编码。为此,需要手动分配 cv::aruco::Dictionary 对象的参数。需要注意的是,除非有特殊原因需要手动执行此操作,否则最好使用前面的替代方案之一。
cv::aruco::Dictionary 的参数是:
class Dictionary {public:
    cv::Mat bytesList;      // marker code information    int markerSize;         // number of bits per dimension    int maxCorrectionBits;  // maximum number of bits that can be corrected
    ...
}
bytesList 是包含标记编码所有信息的数组。markerSize 是每个标记维度的尺寸(例如,对于 5x5 比特位的标记为 5)。最后,maxCorrectionBits 是标记检测期间可以纠正的错误比特位最大数量。如果此值太高,可能会导致大量的误报。
bytesList 中的每一行代表字典中的一个标记。然而,标记并非以其二值形式存储,而是以一种特殊格式存储以简化其检测。
幸运的是,可以使用静态方法 Dictionary::getByteListFromBits() 轻松地将标记转换为这种形式。
例如:
cv::aruco::Dictionary dictionary;
// Markers of 6x6 bitsdictionary.markerSize = 6;
// Maximum number of bit correctionsdictionary.maxCorrectionBits = 3;
// Let's create a dictionary of 100 markersfor(int i = 0; i < 100; i++){    // Assume generateMarkerBits() generates a new marker in binary format, so that    // markerBits is a 6x6 matrix of CV_8UC1 type, only containing 0s and 1s    cv::Mat markerBits = generateMarkerBits();    cv::Mat markerCompressed = cv::aruco::Dictionary::getByteListFromBits(markerBits);
    // Add the marker as a new row    dictionary.bytesList.push_back(markerCompressed);}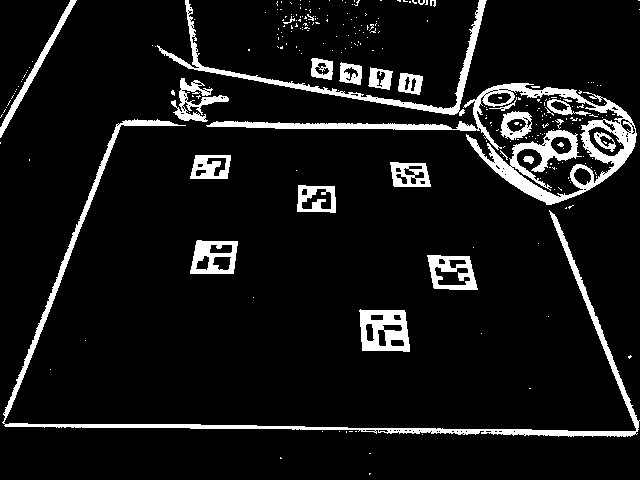
cv::aruco::ArucoDetector 的参数之一是 cv::aruco::DetectorParameters 对象。该对象包含标记检测过程中可以自定义的所有选项。
本节描述每个检测器参数。根据参数所涉及的过程,可以对它们进行分类:
标记检测过程的最初步骤之一是输入图像的自适应阈值化。此阈值化可以用以下参数自定义:
adaptiveThreshWinSizeMin、adaptiveThreshWinSizeMax 和 adaptiveThreshWinSizeStep
Section titled “adaptiveThreshWinSizeMin、adaptiveThreshWinSizeMax 和 adaptiveThreshWinSizeStep”adaptiveThreshWinSizeMin 和 adaptiveThreshWinSizeMax 参数表示为自适应阈值化选择阈值化窗口大小(以像素为单位)的区间(更多细节请参见 OpenCV 的 threshold() 和 adaptiveThreshold() 函数)。
参数 adaptiveThreshWinSizeStep 指示从 adaptiveThreshWinSizeMin 到 adaptiveThreshWinSizeMax 的窗口大小增量。
例如,对于 adaptiveThreshWinSizeMin = 5、adaptiveThreshWinSizeMax = 21 和 adaptiveThreshWinSizeStep = 4,将有 5 个阈值化步骤,窗口大小分别为 5、9、13、17 和 21。在每个阈值化图像上,都将提取标记候选项。
如果标记尺寸太大,较低的窗口大小值会「破坏」标记边框,导致其无法被检测到。
另一方面,如果标记太小,过大的值也会产生同样的效果,并且还会降低性能。此外,该过程将趋向于全局阈值化,从而导致自适应优势的丧失。
最简单的情况是为 adaptiveThreshWinSizeMin 和 adaptiveThreshWinSizeMax 使用相同的值,这会产生单个阈值化步骤。然而,通常最好为窗口大小使用一个范围,尽管许多阈值化步骤也会大大降低性能。
参见 cv::aruco::DetectorParameters::adaptiveThreshWinSizeMin、cv::aruco::DetectorParameters::adaptiveThreshWinSizeMax、cv::aruco::DetectorParameters::adaptiveThreshWinSizeStep。
adaptiveThreshConstant
Section titled “adaptiveThreshConstant”adaptiveThreshConstant 参数表示在阈值化操作中添加的常数值(更多细节请参见 OpenCV 的 threshold() 和 adaptiveThreshold() 函数)。在大多数情况下,其默认值是一个不错的选择。
参见 cv::aruco::DetectorParameters::adaptiveThreshConstant。
阈值化之后,会检测轮廓。然而,并非所有轮廓都被视为标记候选项。它们在不同步骤中被过滤掉,以便丢弃那些不太可能是标记的轮廓。本节中的参数自定义此过滤过程。
需要注意的是,在大多数情况下,这是检测能力和性能之间的平衡问题。所有被考虑的轮廓都将在后续阶段中处理,这些阶段通常具有更高的计算成本。因此,最好在此阶段丢弃无效候选项,而不是在后续阶段。
另一方面,如果过滤条件太严格,真正的标记轮廓可能会被丢弃,从而无法被检测到。
minMarkerPerimeterRate 和 maxMarkerPerimeterRate
Section titled “minMarkerPerimeterRate 和 maxMarkerPerimeterRate”这些参数决定标记的最小和最大尺寸,具体是最小和最大标记周长。它们不是以绝对像素值指定的,而是相对于输入图像的最大维度指定的。
例如,一张尺寸为 640x480 的图像,最小相对标记周长为 0.05,将导致最小标记周长为 640x0.05 = 32 像素,因为 640 是图像的最大维度。maxMarkerPerimeterRate 参数同理。
如果 minMarkerPerimeterRate 太低,检测性能可能会显著降低,因为后续阶段将考虑更多的轮廓。对于 maxMarkerPerimeterRate 参数,这种性能下降不那么明显,因为通常小轮廓比大轮廓多得多。minMarkerPerimeterRate 值为 0 且 maxMarkerPerimeterRate 值为 4(或更大)将等同于考虑图像中的所有轮廓,但出于性能原因,不建议这样做。
参见 cv::aruco::DetectorParameters::minMarkerPerimeterRate、cv::aruco::DetectorParameters::maxMarkerPerimeterRate。
polygonalApproxAccuracyRate
Section titled “polygonalApproxAccuracyRate”对每个候选项应用多边形近似,只有那些近似为方形形状的才会被接受。此值决定多边形近似可能产生的最大误差(更多信息请参见 approxPolyDP() 函数)。
此参数相对于候选项长度(以像素为单位)。因此,如果候选项的周长为 100 像素,且 polygonalApproxAccuracyRate 的值为 0.04,则最大误差为 100x0.04=5.4 像素。
在大多数情况下,默认值工作良好,但对于高度畸变的图像,可能需要更高的误差值。
参见 cv::aruco::DetectorParameters::polygonalApproxAccuracyRate。
minCornerDistanceRate
Section titled “minCornerDistanceRate”同一标记中任意一对角点之间的最小距离。它相对于标记周长表示。以像素为单位的最小距离为 Perimeter * minCornerDistanceRate。
参见 cv::aruco::DetectorParameters::minCornerDistanceRate。
minMarkerDistanceRate
Section titled “minMarkerDistanceRate”来自两个不同标记的任意一对角点之间的最小距离。它相对于两个标记中较小的标记周长表示。如果两个候选项太近,则忽略较小的一个。
参见 cv::aruco::DetectorParameters::minMarkerDistanceRate。
minDistanceToBorder
Section titled “minDistanceToBorder”任何标记角点到图像边界的最小距离(以像素为单位)。如果遮挡较小,被图像边界部分遮挡的标记可以被正确检测到。然而,如果其中一个角点被遮挡,返回的角点通常会被放置在图像边界附近的错误位置。
如果标记角点的位置很重要,例如你想进行位姿估计,最好丢弃角点太靠近图像边界的任何标记。否则,则没有必要。
参见 cv::aruco::DetectorParameters::minDistanceToBorder。
候选项检测之后,将分析每个候选项的比特位,以确定它们是否为标记。
在分析二进制码本身之前,需要先提取比特位。为此,先校正透视畸变,然后使用 Otsu 阈值对所得图像进行阈值化,以分离黑色和白色像素。
然后,将图像划分为一个网格,其单元格数量与标记中的比特位数相同。在每个单元格中,计算黑色和白色像素的数量,以确定分配给该单元格的比特位值(取多数值)。
有几个参数可以自定义此过程:
markerBorderBits
Section titled “markerBorderBits”此参数指示标记边框的宽度。它相对于每个比特位的尺寸。因此,值为 2 表示边框的宽度为两个内部比特位。
此参数需要与你所用标记的边框尺寸一致。边框尺寸可以在标记绘制函数(如 generateImageMarker())中配置。
参见 cv::aruco::DetectorParameters::markerBorderBits。
minOtsuStdDev
Section titled “minOtsuStdDev”此值决定执行 Otsu 阈值化的像素值的最小标准差。如果标准差较低,则可能意味着整个方块都是黑色(或白色),应用 Otsu 没有意义。如果是这种情况,所有比特位都被设置为 0(或 1),具体取决于平均值是高于还是低于 128。
参见 cv::aruco::DetectorParameters::minOtsuStdDev。
perspectiveRemovePixelPerCell
Section titled “perspectiveRemovePixelPerCell”此参数决定校正透视畸变后所得图像中(每个单元格的)像素数量(包括边框)。
例如,假设我们处理的是 5x5 比特位、边框尺寸为 1 比特位的标记(参见 markerBorderBits)。那么,每个维度的总单元格/比特位数为 5 + 2*1 = 7(边框必须计算两次)。总单元格数为 7x7。
如果 perspectiveRemovePixelPerCell 的值为 10,那么所得图像的尺寸将为 10*7 = 70,即 70x70 像素。
此参数的较高值可以改善比特位提取过程(在某种程度上),然而它可能会影响性能。
参见 cv::aruco::DetectorParameters::perspectiveRemovePixelPerCell。
perspectiveRemoveIgnoredMarginPerCell
Section titled “perspectiveRemoveIgnoredMarginPerCell”提取每个单元格的比特位时,会计算黑色和白色像素的数量。通常,不建议考虑单元格的所有像素。相反,最好忽略单元格边缘的一些像素。
原因是,去除透视畸变后,单元格的颜色通常没有完美分离,白色单元格可能会侵入黑色单元格的一些像素(反之亦然)。因此,最好忽略一些像素,以避免计算错误的像素。
perspectiveRemoveIgnoredMarginPerCell 参数指示单元格中被忽略的边缘宽度。
此参数相对于单元格的总尺寸。例如,如果单元格尺寸为 40 像素,且此参数的值为 0.1,则单元格中忽略 40*0.1=4 像素的边缘。这意味着每个单元格中实际分析的像素总数将是 32x32,而不是 40x40。
参见 cv::aruco::DetectorParameters::perspectiveRemoveIgnoredMarginPerCell。
提取比特位之后,下一步是检查提取的编码是否属于标记字典,如有必要,可以执行错误纠正。
maxErroneousBitsInBorderRate
Section titled “maxErroneousBitsInBorderRate”标记边框的比特位应当为黑色。此参数指定边框中允许的错误比特位数量,即边框中白色比特位的最大数量。它相对于标记中比特位的总数表示。
参见 cv::aruco::DetectorParameters::maxErroneousBitsInBorderRate。
errorCorrectionRate
Section titled “errorCorrectionRate”每个标记字典都有一个理论上可以纠正的最大比特位数(Dictionary.maxCorrectionBits)。然而,此值可以通过 errorCorrectionRate 参数修改。
例如,如果允许纠正的比特位数(对于所用字典)为 6,且 errorCorrectionRate 的值为 0.5,则实际可纠正的最大比特位数为 6*0.5=3 个比特位。
此值可用于降低错误纠正能力,以避免误报。
参见 cv::aruco::DetectorParameters::errorCorrectionRate。
检测并识别标记之后,最后一步是对角点位置执行亚像素精化(参见 OpenCV 的 cornerSubPix() 和 cv::aruco::CornerRefineMethod)。
注意,此步骤是可选的,只有在标记角点位置需要精确时(例如用于位姿估计)才有意义。它通常是一个耗时的步骤,因此默认禁用。
cornerRefinementMethod
Section titled “cornerRefinementMethod”此参数决定是否执行角点亚像素过程,以及如果执行则使用哪种方法。如果不需要精确角点,可以禁用它。可能的值为 CORNER_REFINE_NONE、CORNER_REFINE_SUBPIX、CORNER_REFINE_CONTOUR 和 CORNER_REFINE_APRILTAG。
参见 cv::aruco::DetectorParameters::cornerRefinementMethod。
cornerRefinementWinSize
Section titled “cornerRefinementWinSize”此参数决定角点精化过程的最大窗口尺寸。
较大的值可能导致图像中相近的角点被包含在窗口区域内,从而使标记的角点在此过程中移动到不同的、错误的位置。此外,它还可能影响性能。如果 ArUco 标记太小,窗口尺寸可能会减小,请参见 cv::aruco::DetectorParameters::relativeCornerRefinmentWinSize。最终的窗口尺寸计算方式为:min(cornerRefinementWinSize, averageArucoModuleSize*relativeCornerRefinmentWinSize),其中 averageArucoModuleSize 是 ArUco 标记以像素为单位的平均模块尺寸。
参见 cv::aruco::DetectorParameters::cornerRefinementWinSize。
relativeCornerRefinmentWinSize
Section titled “relativeCornerRefinmentWinSize”相对于 ArUco 模块尺寸的角点精化动态窗口尺寸(默认 0.3)。
最终的窗口尺寸计算方式为:min(cornerRefinementWinSize, averageArucoModuleSize*relativeCornerRefinmentWinSize),其中 averageArucoModuleSize 是 ArUco 标记以像素为单位的平均模块尺寸。在标记彼此距离较远的情况下,将参数值增加到 0.4-0.5 可能会有用。在标记彼此距离较近的情况下,将参数值减小到 0.1-0.2 可能会有用。
参见 cv::aruco::DetectorParameters::relativeCornerRefinmentWinSize。
cornerRefinementMaxIterations 和 cornerRefinementMinAccuracy
Section titled “cornerRefinementMaxIterations 和 cornerRefinementMinAccuracy”这两个参数决定亚像素精化过程的停止准则。cornerRefinementMaxIterations 指示最大迭代次数,cornerRefinementMinAccuracy 指示停止过程前的最小误差值。
如果迭代次数太高,可能会影响性能。另一方面,如果太低,则可能导致亚像素精化效果不佳。
参见 cv::aruco::DetectorParameters::cornerRefinementMaxIterations、cv::aruco::DetectorParameters::cornerRefinementMinAccuracy。