
类别不平衡处理
类别不平衡(Class Imbalance)是真实业务中最常见的陷阱:欺诈检测里正样本占比不到 0.1%,医疗诊断里罕见病样本寥寥无几。若直接训练,模型会”偷懒”全预测多数类,准确率虚高但毫无价值。本页系统讲解重采样、重加权、阈值调整、专门损失与评估指标,并覆盖 2020-2026 年长尾学习(Long-Tailed Learning)与深度不平衡学习的前沿进展。前置阅读:监督学习、模型评估与指标。
把不平衡分类想象成一个偏科的班级:班里 99 个学生数学好、1 个差。老师如果只追求”押对大多数人”,永远猜”大家都好”就能拿 99 分——但那个差生永远被忽略。解决思路分三类:
- 改试卷(重采样):要么多复印几份差生的卷子(过采样),要么删掉一些好学生的卷子(欠采样),让两类数量接近。
- 改分值(重加权 / 代价敏感损失):规定”押对一个差生得 99 分,押错一个差生扣 99 分”——让模型不敢忽视少数类。
- 改及格线(阈值调整):不改模型,只把”判定为正”的门槛降低,宁可多误报也不漏报。
更进一步,评估指标也要换:准确率在这类问题上具有欺骗性,要用召回率、F1、PR-AUC、代价敏感损失来衡量。
一句话总结:类别不平衡的核心矛盾是”经验风险最小化”(ERM,即最小化训练集上的平均损失)在少数类上几乎没有梯度信号。所有方法本质上都在重新分配梯度——要么改样本分布,要么改损失权重,要么改决策边界。
不平衡为什么会”毁掉”模型
Section titled “不平衡为什么会”毁掉”模型”大多数分类器最小化的是总错误率(即经验风险)。当负样本占 99%,模型只要全预测为负,错误率就只有 1%——看似很好,但正样本被全部漏掉。本质问题:少数类的损失在总损失里被淹没,梯度几乎不被少数类驱动。
从数学角度更精确地看:假设训练集有 个样本,其中正类 个、负类 个,。标准的交叉熵损失为:
因为 很小,正类样本对总损失的贡献被 稀释。随机梯度下降(SGD)每次按均匀概率采样一个批次,正类被选中的期望次数正比于 ——在极端不平衡下,一个 batch 里可能一个正类都没有,梯度完全由负类驱动。
不同算法对不平衡的敏感度不同:
- 逻辑回归、SVM、神经网络:对类别比例敏感,因为它们直接最小化全局损失,少数类信号容易被淹没。
- 决策树及其集成(随机森林、GBDT):相对鲁棒,因为树按叶子纯度分裂(信息增益 / Gini 系数),少数类仍能在局部形成纯节点;但再鲁棒也会受影响。
- 朴素贝叶斯:理论上对先验概率做调整,但如果特征假设不成立,效果打折。
不平衡的度量:不平衡比(Imbalance Ratio)
Section titled “不平衡的度量:不平衡比(Imbalance Ratio)”定义不平衡比 ,即最大类与最小类样本数之比。 属于轻度不平衡,类权重通常就够; 属于中度到重度,需要重采样 + 专门损失;(如欺诈检测)通常应转向异常检测范式。
实际业务中还可能出现多类长尾分布(Long-Tailed Distribution):类别数很多,频率从高到低呈幂律衰减(如 ImageNet-LT 数据集),头部类有数千样本、尾部类只有几张。这是视觉识别领域 2020 年以来的核心研究课题。
五大主流策略
Section titled “五大主流策略”策略 1:过采样(Oversampling)
Section titled “策略 1:过采样(Oversampling)”复制或合成少数类样本。最著名的是 SMOTE(Synthetic Minority Oversampling Technique,合成少数类过采样技术)。
SMOTE 的数学原理:对少数类中的每个样本 ,在其 个最近邻(通常 )中随机选一个邻居 ,然后在两者的连线上随机插值生成新样本:
直觉理解:假设少数类样本分布在特征空间的某个区域内。SMOTE 假设”少数类样本之间的连线上大概率也属于少数类”,因此在连线之间填充新样本,使决策边界从少数类区域中间移到边界附近,给模型更多”看到少数类内部结构”的机会。相比之下,简单复制(Random Oversampling)只是把同一个点重复出现,决策边界不变,还容易过拟合。
SMOTE 的局限与变体:
| 变体 | 核心改进 | 适用场景 |
|---|---|---|
| Borderline-SMOTE | 只对位于决策边界附近的少数类样本做插值 | 边界模糊的数据 |
| ADASYN(Adaptive Synthetic Sampling) | 给”更难分类”的少数类样本(被多数类包围的)合成更多样本 | 自适应地关注困难区域 |
| SVM-SMOTE | 用 SVM 的支持向量引导插值方向 | 高维特征空间 |
| K-Means SMOTE | 先聚类再在每个簇内做 SMOTE | 少数类内部有多个子簇 |
2024-2026 年的过采样新趋势:传统 SMOTE 在高维数据(图像、文本)上效果有限,因为表格数据的线性插值在像素/嵌入空间中不一定合理。最新方法转向生成模型:
- GAN-based 过采样:训练一个生成对抗网络专门生成少数类样本,合成的样本更”真实”。
- 扩散模型(Diffusion Models)过采样:用 Stable Diffusion 等模型生成少数类图像数据增强,在医学影像(少数类病灶)和工业缺陷检测中效果显著。
- LLM 数据增强:用大语言模型(GPT-4、Claude 等)为少数类生成合成文本样本,在 NLP 分类的不平衡场景中越来越流行。
策略 2:欠采样(Undersampling)
Section titled “策略 2:欠采样(Undersampling)”丢弃部分多数类样本。简单随机欠采样虽然能快速平衡,但会丢失大量信息,尤其是多数类中可能含有重要的子结构。
改进方法利用最近邻规则智能清除冗余或噪声样本:
- Tomek Links:如果样本 (多数类)和 (少数类)互为最近邻,这对 称为 Tomek Link——它们位于决策边界上或属于噪声。删除 Tomek Link 中的多数类样本,相当于”清理边界”,使决策边界更清晰。
- ENN(Edited Nearest Neighbours):对每个样本,看它的 个近邻中多数属于哪个类,如果不一致就删除——相当于用近邻投票做一次噪声过滤。
- ClusterCentroids:对多数类做 K-Means 聚类,用簇中心代替原始样本,在压缩数据量的同时保留分布结构。
策略 3:混合采样(SMOTE + Tomek / ENN)
Section titled “策略 3:混合采样(SMOTE + Tomek / ENN)”先 SMOTE 扩充少数类(可能在边界产生噪声),再用 Tomek Links 或 ENN 清理重叠/噪声样本,兼顾两端。这是 imbalanced-learn 中推荐的常用组合:SMOTETomek 和 SMOTEENN。
策略 4:类权重 / 代价敏感学习
Section titled “策略 4:类权重 / 代价敏感学习”在损失函数里给少数类一个更大的权重。加权交叉熵为:
权重通常取反频率(Inverse Frequency):
其中 是类别数, 是类别 的样本数。对二分类:,。sklearn 的 class_weight='balanced' 就是用这个公式。
代价敏感学习的理论框架:代价敏感学习(Cost-sensitive Learning)源自贝叶斯决策论。定义代价矩阵 表示真实类别为 而预测为 的代价。最优贝叶斯决策规则是选择使期望代价最小的类别。当漏报代价远大于误报代价时(如癌症筛查),最优决策阈值不再是 0.5,而是一个更低的值。代价敏感损失本质上是在损失函数中编码这个代价矩阵,让模型的优化目标直接对齐业务目标。
有效样本数(Effective Number of Samples)理论:Cui et al.(CVPR 2019)提出,随着样本量增加,每个新样本带来的”边际信息”递减(因为新样本和已有样本有重叠)。定义有效样本数为:
其中 是超参数,控制”信息饱和”速度。基于此设计的类权重 比简单反频率更合理,在长尾视觉分类上取得了 SOTA 效果。这种权重设计被广泛称为 Class-Balanced Loss。
策略 5:阈值调整
Section titled “策略 5:阈值调整”模型输出概率 ,默认阈值 0.5。把阈值降到 0.1 或更低,让更多样本被判为正——本质是在 PR 曲线上选一个更靠右的工作点,不重训练。
为什么阈值调整是”免费的”:大多数分类器输出的是概率或分数,阈值 0.5 只是一个惯例。训练完成后,扫描所有可能的阈值(用 precision_recall_curve)得到 PR 曲线,然后根据业务需求(如”召回率必须 ≥ 90%“)选择最优阈值,成本为零。这往往是投入产出比最高的一步。
Focal Loss:让难样本驱动学习
Section titled “Focal Loss:让难样本驱动学习”从交叉熵到 Focal Loss 的推导
Section titled “从交叉熵到 Focal Loss 的推导”标准二分类交叉熵(Cross-Entropy,CE)损失,令 为样本被预测为真实类别的概率:
则 。
问题:即使 (已经分对了),损失 仍不为零。在大量简单样本( 接近 1)堆积的场景中(如目标检测中背景框远多于前景),这些小损失累加起来淹没了少量难样本的损失。
Lin et al.(ICCV 2017)提出 Focal Loss,在交叉熵基础上乘一个调制因子(Modulating Factor):
其中 是聚焦参数(Focusing Parameter)。
参数 的作用分析:
- 当 (简单样本)、 时,调制因子 ,损失被压缩到原来的 1%。
- 当 (困难样本)、 时,调制因子 ,损失几乎不变。
- 时退化为标准交叉熵。 越大,对简单样本的抑制越强(通常取 2)。
还可以加入 平衡因子(类似类权重):
Focal Loss 的数学直觉
Section titled “Focal Loss 的数学直觉”Focal Loss 的核心思想是降低易分类样本的损失权重,让梯度信号集中在难样本上。从梯度角度看,Focal Loss 对简单样本的梯度 远小于交叉熵,相当于 SGD 在简单样本上”减速”,在难样本上保持原速——等价于一种隐式的难样本挖掘(Online Hard Example Mining, OHEM),但不需要显式筛选样本。
Focal Loss 的变体与新进展
Section titled “Focal Loss 的变体与新进展”Focal Loss 自 2017 年提出后衍生出多种变体,在 2020-2026 年间持续演进:
- Quality Focal Loss (QFL)(Li et al., CVPR 2020):将 Focal Loss 扩展到连续标签(如目标检测中的 IoU 质量分数),联合优化分类与定位质量。
- Generalized Focal Loss (GFL)(Li et al., NeurIPS 2020):将分类分数和定位质量统一到一个预测分支中,用广义 Focal Loss 联合优化,在 COCO 检测榜上取得 SOTA。
- Varifocal Loss (VFL)(Zhang et al., CVPR 2021):区分正负样本——对负样本用类似 Focal Loss 的衰减,对正样本用预测质量加权,在 DETR 系列检测器中广泛使用。
- Poly Loss(Leng et al., CVPR 2022):将交叉熵和 Focal Loss 统一到一个多项式展开框架中,,提供一个更灵活的损失设计空间。
长尾学习的前沿范式(2020-2026)
Section titled “长尾学习的前沿范式(2020-2026)”传统方法(采样、重加权、阈值调整)主要针对二分类或少数类。当类别数很多且分布呈长尾时(如大规模视觉分类),这些方法的局限性凸显。2020 年以来,长尾学习(Long-Tailed Learning)形成了几个重要新范式:
范式 1:解耦表征与分类器(Decoupling)
Section titled “范式 1:解耦表征与分类器(Decoupling)”Kang et al.(ICLR 2020)的经典论文 “Decoupling Representation and Classifier for Long-Tailed Recognition” 通过系统实验证明了一个反直觉的结论:
在长尾数据上,联合训练表征和分类器不是最优的。更好的做法是分两阶段:先用所有数据(原始不平衡分布)训练特征提取器,再固定特征提取器,用类别均衡采样重新训练最后一层分类器。
这被称为 解耦范式(Decoupling Paradigm)。重采样对表征学习有害(采样改变了数据的自然分布),但对分类器校准有益。这一发现深刻影响了后续的长尾学习方法。
四种分类器校正方法的对比:
| 方法 | 做法 | 特点 |
|---|---|---|
| 类别均衡采样重训 | 用均衡采样重新训练最后一层 | 简单有效 |
| -normalized | 将分类器权重按范数归一化 | 无需重训练 |
| Logit 调整 | 在推理时对 logit 减去 (类先验) | 理论优雅 |
| Nearest Class Mean | 每类用特征均值作为分类器权重 | 几乎无参数 |
范式 2:标签分布感知的边距损失(LDAM)
Section titled “范式 2:标签分布感知的边距损失(LDAM)”Cao et al.(NeurIPS 2019)提出 LDAM(Label-Distribution-Aware Margin)Loss,为不同类别设置不同的边距(Margin):
- 给少数类更大的边距 ( 为类 的样本数)。
- 类似 SVM 的最大间隔思想,强制少数类的决策边界离类中心更远。
- 配合 Deferred Re-weighting(先正常训练,后期再加大少数类权重),在长尾数据上效果显著。
范式 3:对比学习与长尾
Section titled “范式 3:对比学习与长尾”自监督对比学习(如 SimCLR、MoCo)天然对类别不平衡有一定鲁棒性——因为它不依赖标签做表征学习。在此基础上:
- BCL(Balanced Contrastive Learning)(Zhu et al., CVPR 2022):在对比学习中引入类别均衡采样,使表征空间对尾部类更友好。
- PaCo(Parametric Contrastive Learning)(Cui et al., CVPR 2022):在对比学习中引入可学习的类中心参数,进一步细化边界。
- NCL(Neighborhood Contrastive Learning)(Li et al., CVPR 2022):利用同一批次中样本的近邻关系做对比,特别适合尾部类样本稀少的情况。
范式 4:基础模型与 LLM 驱动的长尾学习
Section titled “范式 4:基础模型与 LLM 驱动的长尾学习”2024-2026 年的最新趋势是利用预训练基础模型(Foundation Models)和大语言模型来应对长尾:
- CLIP / 视觉-语言模型:预训练的 CLIP 模型对长尾分布天然鲁棒,因为其零样本(Zero-shot)能力不依赖类别频率。在下游长尾任务上,即使是零样本也能超过有监督训练的传统方法。
- LLM 合成数据:用 GPT-4 / Claude 等生成尾部类的训练数据(文本或图像描述→图像),缩小长尾差距。
- 提示学习(Prompt Tuning):只微调少量提示参数,固定预训练骨干网络,避免尾部类过拟合。
范式 5:多模态长尾学习(2024-2026 新范式)
Section titled “范式 5:多模态长尾学习(2024-2026 新范式)”随着视觉-语言模型(Vision-Language Models, VLM)的成熟,多模态方法成为长尾学习最有前途的新方向:
- 多模态伪标签(Multimodal Pseudo-Labeling):利用 CLIP 等模型的图文对齐能力,为尾部类自动生成高质量伪标签。例如,用 GPT-4 生成尾部类的文本描述,再用 CLIP 将描述与未标注图像匹配,相当于零成本获得尾部类训练数据。
- 知识蒸馏式长尾学习:将预训练大模型(如 CLIP、DINOv2)作为教师网络,用知识蒸馏将丰富的语义知识迁移到长尾分类器中。教师模型的零样本预测为尾部类提供了”软标签”(soft labels),即使尾部样本极少,模型也能从教师的知识中获益。
- 检索增强分类(Retrieval-Augmented Classification):受 RAG 启发,在推理时从外部知识库中检索与输入最相似的样本作为上下文,辅助分类决策。这对尾部类特别有效——即使模型在训练时只见过几张尾部类图片,检索机制可以在推理时”查阅”更丰富的参考集。
范式 6:ViT 时代的不平衡学习新发现(2024-2025)
Section titled “范式 6:ViT 时代的不平衡学习新发现(2024-2025)”Vision Transformer(ViT)和自监督预训练模型的兴起带来了对不平衡学习的新理解:
- ViT 对长尾的天然鲁棒性:研究表明,ViT 的全局自注意力(Self-Attention)机制天然比 CNN 更能捕捉尾部类的细粒度特征。原因在于 CNN 的局部归纳偏置(Inductive Bias)容易让模型”偷懒”只关注高频局部模式(被头部类主导),而 ViT 的全局视野迫使模型学习更全面的表征。
- DINOv2 + 线性探查:Meta 的 DINOv2 自监督模型产生的特征质量极高,即使在极端长尾分布上,简单的”冻结 DINOv2 + 线性分类器”也能超越精心设计的长尾专用方法。这一发现进一步强化了”强表征 > 好分类器”的结论。
- 冻结 vs 微调的权衡:2024-2025 年的研究表明,对于长尾任务,冻结预训练骨干网络只微调分类头往往比全量微调效果更好——全量微调会让大量头部类样本主导梯度更新,破坏预训练表征中对尾部类友好的部分。
范式 7:测试时自适应(Test-Time Adaptation, TTA)
Section titled “范式 7:测试时自适应(Test-Time Adaptation, TTA)”2024-2026 年的新兴方向是在推理时针对不平衡进行自适应调整,而非在训练时改动:
- 测试时增强(Test-Time Augmentation, TTA):对每个测试样本生成多个增强版本,用模型分别预测后取平均或投票。对尾部类样本尤其有效——多个增强视角降低了单一视角的误判风险。
- Logit 校准(Logit Calibration at Test Time):在推理时根据测试集的类别分布估计动态调整 logits。如果检测到当前批次中尾部类比例偏高(如分布偏移),自动降低阈值。这种方法无需重新训练,特别适合部署后遇到的新分布。
评估指标的正确姿势
Section titled “评估指标的正确姿势”- 不要用准确率(Accuracy)。99:1 的数据里,全猜负就有 99% 准确率,毫无意义。
- 召回率(Recall / Sensitivity):正样本里被抓到了多少,。欺诈/医疗场景的首要指标(宁可误报不可漏报)。
- 精确率(Precision):报出来的有多少真的是正,。营销场景更看重(避免打扰无效用户)。
- F1 / F-beta:两者的调和平均。。F2 更偏召回、F0.5 更偏精确。
- PR-AUC(Average Precision):PR 曲线下面积,对不平衡比 ROC-AUC 更敏感,是业界首选。
- ROC-AUC 的陷阱:ROC-AUC 会因为大量的真负例(TN)而虚高。例如 99:1 数据中,即使把一半负例误判为正,FPR(假正率)也只增加 0.5%,ROC 曲线几乎不变——但 PR 曲线会剧烈下降。
- 代价矩阵(Cost Matrix):给漏报和误报分别赋业务代价,直接最小化总业务损失。
不平衡下的 MCC(Matthews Correlation Coefficient):MCC 综合考虑混淆矩阵的所有四个象限,取值 ,在不平衡数据上是比准确率和 F1 更全面的单值指标:
策略选择决策
Section titled “策略选择决策”SMOTE 合成新样本
Section titled “SMOTE 合成新样本”长尾学习的解耦范式
Section titled “长尾学习的解耦范式”完整示例:SMOTE + 随机森林 + 正确评估
Section titled “完整示例:SMOTE + 随机森林 + 正确评估”from sklearn.datasets import make_classificationfrom sklearn.model_selection import train_test_splitfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.metrics import (classification_report, average_precision_score, balanced_accuracy_score, matthews_corrcoef)from imblearn.over_sampling import SMOTEfrom imblearn.pipeline import Pipeline # 注意:用 imblearn 的 Pipeline,不是 sklearn 的import numpy as np
# ---------- 1. 构造 1:19 的不平衡数据集 ----------X, y = make_classification( n_samples=5000, n_features=20, n_informative=10, weights=[0.05], # 正类只占 5% flip_y=0.02, # 加 2% 标签噪声 random_state=42,)X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42)
print(f"训练集分布: {np.bincount(y_tr)} 测试集分布: {np.bincount(y_te)}")
# ---------- 2. 用 imblearn Pipeline 正确封装(避免数据泄露)----------# 关键:Pipeline 保证 SMOTE 只在训练折上 fit,不在验证/测试折上做pipeline = Pipeline([ ('smote', SMOTE(random_state=42, k_neighbors=5)), ('clf', RandomForestClassifier(n_estimators=200, random_state=42)),])
# ---------- 3. 训练 & 预测概率 ----------pipeline.fit(X_tr, y_tr)proba = pipeline.predict_proba(X_te)[:, 1]y_pred = pipeline.predict(X_te)
# ---------- 4. 多指标评估 ----------print("\n=== 分类报告 ===")print(classification_report(y_te, y_pred))print(f"平衡准确率 Balanced Accuracy: {balanced_accuracy_score(y_te, y_pred):.3f}")print(f"PR-AUC (Average Precision): {average_precision_score(y_te, proba):.3f}")print(f"Matthews 相关系数 MCC: {matthews_corrcoef(y_te, y_pred):.3f}")关键陷阱:上面使用
imblearn.pipeline.Pipeline而不是sklearn.pipeline.Pipeline,是因为只有前者能在交叉验证时正确地”只在训练折上做 SMOTE”。如果先对全部数据做 SMOTE 再划分,少数类的合成样本会泄露到测试集,评估结果会严重虚高。
混合采样:SMOTE + Tomek Links 清噪
Section titled “混合采样:SMOTE + Tomek Links 清噪”from imblearn.combine import SMOTETomek, SMOTEENNfrom sklearn.linear_model import LogisticRegression
# 先 SMOTE 过采样,再用 Tomek Links 清除边界噪声resampler = SMOTETomek(random_state=42)X_res, y_res = resampler.fit_resample(X_tr, y_tr)print(f"重采样后: {np.bincount(y_res)}")
clf = LogisticRegression(max_iter=1000, random_state=42).fit(X_res, y_res)print(classification_report(y_te, clf.predict(X_te)))类权重 + 阈值调整可视化
Section titled “类权重 + 阈值调整可视化”from sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import precision_recall_curveimport numpy as npimport matplotlib.pyplot as plt
# class_weight='balanced' 自动按反频率加权clf = LogisticRegression(class_weight="balanced", max_iter=1000).fit(X_tr, y_tr)proba = clf.predict_proba(X_te)[:, 1]
# 按业务目标选阈值:这里要求召回率 >= 0.9prec, rec, thr = precision_recall_curve(y_te, proba)idx = np.argmax(rec >= 0.9) # 找到满足召回的最小阈值y_pred = (proba >= thr[idx]).astype(int)print(f"阈值={thr[idx]:.3f} 召回={rec[idx]:.3f} 精确={prec[idx]:.3f}")
# 可视化 PR 曲线及选定的工作点plt.figure(figsize=(7, 5))plt.plot(rec, prec, label="PR 曲线")plt.scatter(rec[idx], prec[idx], color='red', s=100, zorder=5, label=f"选定工作点 (thr={thr[idx]:.3f})")plt.xlabel("召回率 Recall")plt.ylabel("精确率 Precision")plt.title("阈值调整:在 PR 曲线上选工作点")plt.legend()plt.grid(True, alpha=0.3)plt.tight_layout()plt.savefig("pr_curve_threshold.png", dpi=150)plt.show()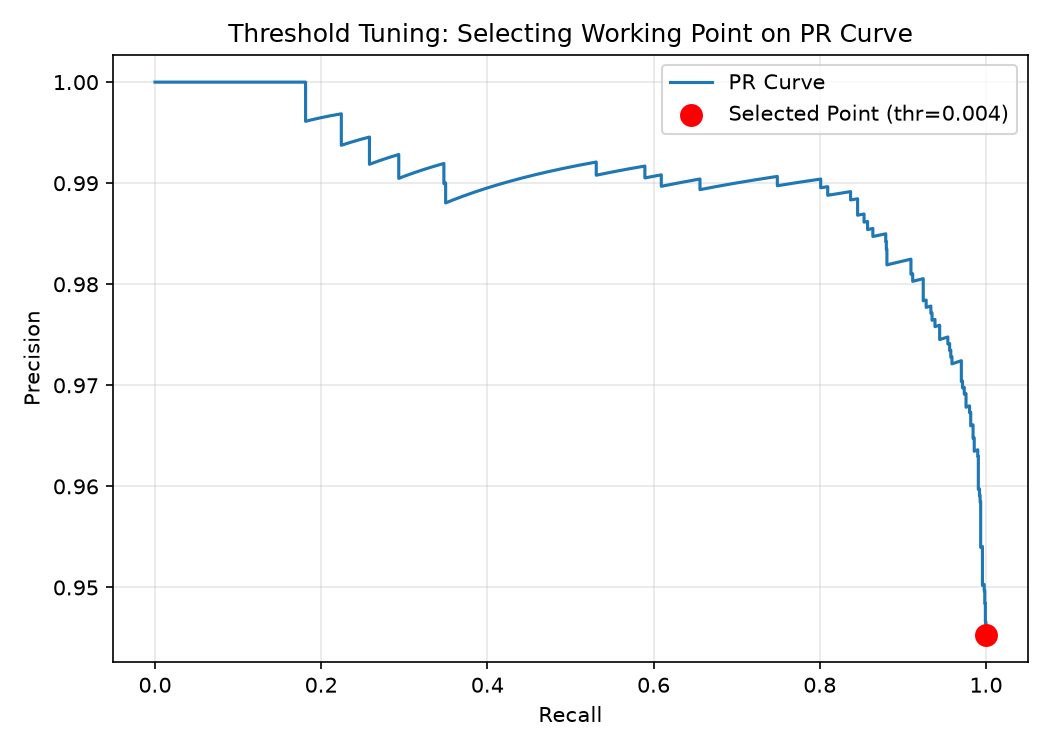
Focal Loss 的 PyTorch 实现
Section titled “Focal Loss 的 PyTorch 实现”import torchimport torch.nn as nnimport torch.nn.functional as F
class FocalLoss(nn.Module): """二分类 / 多分类 Focal Loss 的通用 PyTorch 实现。
Args: alpha: 类权重。若为 None 则不使用;若为 float 则正类权重为 alpha、负类为 1-alpha; 若为列表/张量则按类别索引。对多分类需传入长度等于类别数的权重。 gamma: 聚焦参数,控制对简单样本的抑制强度。默认 2.0。 reduction: 'none' | 'mean' | 'sum' """
def __init__(self, alpha=None, gamma=2.0, reduction="mean"): super().__init__() self.gamma = gamma self.reduction = reduction # alpha 可以是 float(二分类)或 tensor(多分类类权重) if alpha is not None and not isinstance(alpha, (float, int)): self.alpha = torch.tensor(alpha, dtype=torch.float32) else: self.alpha = alpha
def forward(self, logits, targets): """ Args: logits: (N, C) 未经 softmax/sigmoid 的原始输出 targets: (N,) 类别索引(多分类)或 (N, 1) 0/1(二分类) """ # 多分类路径:logits 形状 (N, C) if logits.dim() > 1 and logits.size(1) > 1: ce_loss = F.cross_entropy(logits, targets, reduction="none") pt = torch.exp(-ce_loss) # p_t = softmax(logits)[true_class] else: # 二分类路径 logits = logits.view(-1) targets = targets.view(-1).float() ce_loss = F.binary_cross_entropy_with_logits(logits, targets, reduction="none") pt = torch.exp(-ce_loss)
focal_loss = ((1 - pt) ** self.gamma) * ce_loss
# 可选的 alpha 加权 if self.alpha is not None: if isinstance(self.alpha, float): alpha_t = torch.where(targets > 0.5, self.alpha, 1 - self.alpha) focal_loss = alpha_t * focal_loss else: self.alpha = self.alpha.to(logits.device) alpha_t = self.alpha[targets.long()] focal_loss = alpha_t * focal_loss
if self.reduction == "mean": return focal_loss.mean() elif self.reduction == "sum": return focal_loss.sum() return focal_loss
# ---------- 使用示例 ----------if __name__ == "__main__": torch.manual_seed(42)
# 模拟一个简单的不平衡分类网络 num_samples, num_classes = 1000, 10 # 制造长尾分布:类别 0 有 500 样本,尾部类只有 ~10 个 class_counts = torch.tensor([500] + [55] * 9) targets = torch.cat([torch.full((c,), i) for i, c in enumerate(class_counts)])
logits = torch.randn(num_samples, num_classes, requires_grad=True)
# 用 Class-Balanced 权重初始化 alpha beta = 0.999 effective_num = 1.0 - beta ** class_counts cb_weights = (1.0 - beta) / effective_num cb_weights = cb_weights / cb_weights.sum() * num_classes # 归一化到均值为 1
criterion = FocalLoss(alpha=cb_weights.tolist(), gamma=2.0) loss = criterion(logits, targets) print(f"Focal Loss (γ=2, Class-Balanced α): {loss.item():.4f}")
# 对比标准交叉熵 ce_criterion = FocalLoss(alpha=None, gamma=0.0) # gamma=0 退化为 CE ce_loss = ce_criterion(logits, targets) print(f"Standard Cross-Entropy: {ce_loss.item():.4f}")长尾学习:两阶段解耦训练(概念代码)
Section titled “长尾学习:两阶段解耦训练(概念代码)”"""两阶段解耦训练的概念框架(PyTorch 风格伪代码)。适用于长尾分布的视觉分类任务。"""import torchimport torch.nn as nn
# ---------- 阶段一:用原始(不平衡)数据训练表征 ----------def train_representation(model, dataloader_imbalanced, epochs=90): """正常训练,不做任何重采样/重加权。
理由:研究表明,自然分布的数据训练出的特征提取器更鲁棒, 因为它学到了数据的真实分布结构。 """ optimizer = torch.optim.SGD(model.parameters(), lr=0.1, momentum=0.9) criterion = nn.CrossEntropyLoss() # 普通交叉熵,不加权 for epoch in range(epochs): for images, labels in dataloader_imbalanced: logits = model(images) loss = criterion(logits, labels) optimizer.zero_grad() loss.backward() optimizer.step() # 冻结特征提取器 for param in model.features.parameters(): param.requires_grad = False
# ---------- 阶段二:用类别均衡采样重新训练分类器 ----------from torch.utils.data import WeightedRandomSampler
def make_balanced_sampler(dataset, class_counts): """构造类别均衡采样的 sampler:每个样本的采样权重与类频率成反比。""" weights = [1.0 / class_counts[label] for label in dataset.labels] return WeightedRandomSampler(weights, num_samples=len(dataset), replacement=True)
def train_classifier_balanced(model, dataset, class_counts, epochs=10): """固定骨干网络,只用均衡采样训练分类头。""" sampler = make_balanced_sampler(dataset, class_counts) dataloader = torch.utils.data.DataLoader(dataset, batch_size=64, sampler=sampler) # 只优化分类器参数 optimizer = torch.optim.SGD(model.classifier.parameters(), lr=0.01) criterion = nn.CrossEntropyLoss() for epoch in range(epochs): for images, labels in dataloader: logits = model(images) loss = criterion(logits, labels) optimizer.zero_grad() loss.backward() optimizer.step()
# ---------- 推理时的 τ-normalization 替代方案 ----------def tau_normalize_classifier(model, tau=1.5): """无需重训练,直接对分类器权重做 τ-范数归一化。
原理:长尾训练后,少数类的分类器权重范数偏小(因为训练样本少), 导致少数类的 logit 被系统性压低。τ-normalization 补偿这一偏差。 """ with torch.no_grad(): for name, param in model.classifier.named_parameters(): if 'weight' in name: param /= param.norm(dim=1, keepdim=True) ** tau- 绝对不要在过/欠采样后再划分训练/测试集。正确顺序:先划分,再只对训练集做重采样,测试集必须保留原始分布——否则评估会过于乐观。最佳实践是使用
imblearn.pipeline.Pipeline,它会在交叉验证中自动正确处理。 - 类权重是最省事的第一招。多数 sklearn / XGBoost / LightGBM 模型都支持
class_weight='balanced'或scale_pos_weight,无需改数据,是性价比最高的方案。 - 过采样适合样本量小,欠采样适合数据量大;数据量极小时考虑 SMOTE 变体(Borderline-SMOTE、ADASYN、K-Means SMOTE)或数据增强。
- 先看基线分布,再定策略。1:10 用类权重就够;1:1000(如欺诈)需要重采样 + 异常检测思路结合;多类长尾(如 1000+ 类)考虑两阶段解耦训练。
- 阈值是免费的杠杆。训练后调整决策阈值成本为零,业务上线前务必在 PR 曲线上根据业务代价选最优点。
- 极端不平衡(1:10000)转向异常检测。此时普通监督学习失效,改用孤立森林(Isolation Forest)、One-Class SVM 或自编码器重构误差,详见 异常检测。
- 评估必须用 PR-AUC,不要只看 ROC-AUC。ROC-AUC 在极端不平衡下会虚高,PR-AUC 才真实反映少数类性能。同时报告 MCC 作为综合单值指标。
- 深度学习场景优先考虑 Focal Loss / LDAM,而非 SMOTE。在图像、文本等高维数据上,SMOTE 的线性插值假设不成立;而 Focal Loss、LDAM 等损失层面的方法天然适配神经网络。
- 长尾多类任务用解耦训练。先用全部数据训练表征,再用均衡采样校正分类器,这在 ImageNet-LT、iNaturalist 等长尾基准上是公认的强基线。
- 2025 年实践建议:如果你的任务有合适的预训练基础模型(如 CLIP),优先尝试零样本 / 少样本(Few-shot)评估——预训练的丰富知识往往比在小规模长尾数据上从头训练更有效。
- 2025-2026 年首选 pipeline:对于视觉长尾任务,推荐”冻结 DINOv2 / CLIP 骨干 + 类别均衡采样训练线性分类头 + 推理时 Logit 校准”的三步策略。这一组合在 ImageNet-LT、iNaturalist 等基准上的表现已超过大多数专门设计的长尾方法,且实现极简。
- 扩散模型做数据增强:对于少数类样本极少但属于图像/视频域的场景,使用 Stable Diffusion 3、FLUX 等现代扩散模型合成少数类样本,是 2025 年工业界的主流做法。关键技巧是用 ControlNet 或 IP-Adapter 保持合成图像的类别一致性,避免生成”看着像但实际不对”的样本。
- LLM 合成表格数据:对于结构化表格数据的不平衡,2025 年出现了用 LLM 生成合成少数类表格样本的方法(如 GReaT、CTGAN 的 LLM 增强版),在金融风控、医疗诊断等领域效果优于传统 SMOTE。
- 信用卡欺诈检测:典型正样本占比 0.1% 以下,Visa、Mastercard、蚂蚁集团的风控系统结合 SMOTE 过采样、GBDT 与图神经网络,在召回率 90%+ 的同时把误报控制在可接受水平。近年来 DeepMind、Google 等开始用序列模型(Transformer)建模用户行为序列,配合 Focal Loss 处理欺诈的极端不平衡。
- 医疗罕见病筛查:罕见病阳性样本稀缺,医院用 SMOTE + 迁移学习扩充阳性样本,并以召回率为首要指标,宁可多做检查也不漏诊。2024-2025 年的趋势是用扩散模型(Diffusion Models)合成病灶影像做数据增强。
- 工业缺陷检测:产线上缺陷产品占比极低(通常 < 1%),工厂用欠采样 + Focal Loss 训练视觉模型,详见 图像分割 与 目标检测。
- 垃圾邮件 / 垃圾内容过滤:正常内容远多于垃圾内容,邮件服务商用类加权贝叶斯与 GBDT 平衡召回与精确率。
- 广告反作弊:点击欺诈识别中作弊流量占比低,广告平台用 Focal Loss + 图特征建模,Focal Loss 正是 Lin et al. 在目标检测 RetinaNet 中为解决前景/背景不平衡而提出。
- 野生动物物种识别:相机陷阱(Camera Trap)拍摄的野生动物数据天然呈长尾分布——常见物种(鹿、松鼠)照片成千上万,濒危物种(雪豹、穿山甲)只有几张。Microsoft AI for Earth 用长尾学习技术辅助生物多样性保护。
- 罕见药物不良反应监测:FDA 不良事件报告系统(FAERS)中,罕见药物-不良反应组合的样本极少,需要不平衡学习方法识别潜在的药物安全问题。
- 电商长尾商品分类:电商平台动辄有数万个商品类目,热门类目(手机壳、T 恤)样本海量,冷门类目(特种工业零件)样本极少,长尾分类直接影响搜索和推荐质量。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| imbalanced-learn | Python | 提供 SMOTE、ADASYN、Tomek、ENN 等全套重采样方法,scikit-learn 风格接口;支持 imblearn.pipeline.Pipeline 避免数据泄露 |
| scikit-learn | Python | class_weight、compute_class_weight、precision_recall_curve、balanced_accuracy_score 等 |
| XGBoost / LightGBM | Python | scale_pos_weight、focal loss(LightGBM 通过自定义目标函数支持) |
| PyTorch / torchvision | Python | 灵活实现 Focal Loss、LDAM、Class-Balanced Loss 等自定义损失 |
| torchtuples / fastai | Python | PyTorch 生态中实现 Focal Loss、class_weight 的辅助工具 |
| Detectron2 / MMDetection | Python | 内置 Focal Loss、Varifocal Loss、Quality Focal Loss,用于目标检测中的前景背景不平衡 |
| CLIP / OpenCLIP | Python | 预训练视觉-语言模型,对长尾分布天然鲁棒,可做零样本/少样本长尾分类 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 类别不平衡 | Class Imbalance | 训练集中各类别样本数量严重不均,少数类占比很低 |
| 长尾分布 | Long-Tailed Distribution | 类别频率从高到低呈幂律衰减的多类分布,头部类多、尾部类极少 |
| 不平衡比 | Imbalance Ratio (IR) | 最大类与最小类样本数之比,衡量不平衡严重程度 |
| 过采样 | Oversampling | 增加少数类样本数量(复制或合成),使类别分布更均衡 |
| 欠采样 | Undersampling | 减少多数类样本数量,使类别分布更均衡 |
| SMOTE | Synthetic Minority Oversampling | 在少数类样本最近邻之间插值合成新样本的经典过采样方法 |
| ADASYN | Adaptive Synthetic Sampling | 自适应地给”更难分类”的少数类样本合成更多新样本 |
| Tomek Links | Tomek Links | 互为最近邻的异类样本对,位于决策边界或属于噪声 |
| 类权重 | Class Weight | 给少数类损失更大权重,使其在总损失中权重提升 |
| Class-Balanced Loss | Class-Balanced Loss | 基于”有效样本数”理论设计的加权损失,比简单反频率更合理 |
| 代价敏感学习 | Cost-sensitive Learning | 在损失函数中显式区分不同错误类型的代价,最小化总业务损失 |
| 有效样本数 | Effective Number of Samples | 衡量 个样本中真正有信息的样本量,随 增长边际递减 |
| Focal Loss | Focal Loss | 给已分对样本的损失乘衰减因子 ,让模型聚焦难样本与少数类 |
| 聚焦参数 | Focusing Parameter (γ) | Focal Loss 中控制对简单样本抑制强度的超参数,通常取 2 |
| LDAM Loss | Label-Distribution-Aware Margin Loss | 为少数类设置更大边距的损失函数,源自 SVM 最大间隔思想 |
| 解耦训练 | Decoupling (Representation & Classifier) | 分两阶段:先正常训练表征,再用均衡采样校正分类器 |
| Logit 调整 | Logit Adjustment | 推理时从 logit 减去类先验的对数,校正不平衡偏差 |
| 召回率 | Recall | 正样本中被正确预测为正的比例,不平衡问题的首要指标 |
| PR-AUC | PR AUC | 精确率-召回率曲线下面积,对不平衡比 ROC-AUC 更敏感 |
| MCC | Matthews Correlation Coefficient | 综合混淆矩阵四象限的相关系数,取值 [-1,1],不平衡下比 F1 更全面 |
| 阈值调整 | Threshold Tuning | 调整判定为正的概率门槛,在不重训练的情况下改变工作点 |
- Chawla et al.,「SMOTE: Synthetic Minority Over-sampling Technique」(JAIR, 2002):SMOTE 原始论文,不平衡学习领域引用最高的经典工作。
- He & Garcia,「Learning from Imbalanced Data」(IEEE TKDE, 2009):不平衡学习的权威综述,系统梳理评估、采样、代价敏感方法。
- Lin et al.,「Focal Loss for Dense Object Detection」(ICCV 2017):RetinaNet 论文,提出 Focal Loss,目标检测中前景背景不平衡的里程碑解法。
- Cui et al.,「Class-Balanced Loss Based on Effective Number of Samples」(CVPR 2019):提出”有效样本数”理论,设计出比反频率更合理的类权重,长尾分类的奠基性工作。
- Cao et al.,「Learning Imbalanced Datasets with Label-Distribution-Aware Margin Loss」(NeurIPS 2019):LDAM Loss 原始论文,用类别感知的边距处理长尾。
- Kang et al.,「Decoupling Representation and Classifier for Long-Tailed Recognition」(ICLR 2020):解耦范式的开创性论文,证明分两阶段训练优于联合训练。
- Yang et al.,「Rethinking the Value of Labels for Improving Class-Imbalanced Learning」(NeurIPS 2020):系统研究半监督和自监督方法在类别不平衡中的价值。
- Li et al.,「Generalized Focal Loss」(NeurIPS 2020):将 Focal Loss 推广到连续标签场景,目标检测 SOTA。
- Branco et al.,「A Survey of Predictive Modeling on Imbalanced Domains」(ACM Computing Surveys, 2016):全面综述不平衡领域的评估指标与方法选择策略。
- Lemaitre et al.,「Imbalanced-learn: A Python Toolbox to Tackle the Curse of Imbalanced Datasets」(JMLR, 2017):imbalanced-learn 库论文,实践首选工具的官方介绍。
- Yang et al.,「Deep Long-Tailed Learning: A Survey」(arXiv, 2022):深度长尾学习的最新综述,涵盖解耦、对比学习、自监督等前沿范式的全景梳理,是进入该领域的最佳路线图。
- Zhang et al.,「Deep Long-Tailed Learning: A Recipe for Large-Scale Recognition」(arXiv, 2023):系统性实验研究,揭示预训练(尤其是自监督预训练)对长尾性能的决定性影响,推动”强预训练 + 简单分类器”范式。
- Shi et al.,「AI Benchmark: Large-Scale Long-Tailed Recognition」(2024):引入更大规模、更贴近真实场景的长尾基准数据集,推动从学术数据集到工业级评测的过渡。
- DINOv2 (Oquab et al., Meta AI, 2023-2024):自监督视觉基础模型,其产生的通用视觉特征在长尾分类上展现了惊人的零样本 / 线性探查性能。
- Wang et al.,「ViTs for Long-Tailed Recognition」(CVPR 2024):系统研究 Vision Transformer 在长尾分布上的优势,揭示全局自注意力对尾部类的友好性。