
GraphRAG 图增强检索
GraphRAG(Graph-based Retrieval-Augmented Generation)是微软于 2024 年提出的一种增强检索方案:它在传统向量检索之上叠加一层知识图谱,先抽取实体与关系、再做社区检测、最后用社区摘要回答全局性问题。如果说传统 RAG 解决的是”找到相关段落”,那么 GraphRAG 解决的是”理解整篇文档的主题脉络”;它常与向量数据库配合使用,前者负责结构化推理,后者负责语义相似度匹配。
2024 年下半年到 2025 年,GraphRAG 生态快速发展:微软自己推出了成本大幅降低的 LazyGraphRAG,学术界涌现了 LightRAG、HippoRAG、RAPTOR 等变体,开源社区也产出了 nano-graphrag 等轻量实现。这些新方案共同把 GraphRAG 从”原理惊艳但太贵”推向了”可落地的生产技术”。本页在系统讲解 GraphRAG 原理的同时,会重点覆盖成本优化、变体对比、增量更新、查询路由等工程落地中的关键议题。
先用一个比喻把 GraphRAG 的本质讲透。
传统 RAG 像翻书找段落:你问”Transformer 中的多头注意力是什么”,它翻开一本书,找到标记了”多头注意力”的那几页递给你。这对”查一个具体事实”很好用。但如果你问”这本书主要讲了什么”,它就犯难了——因为它只能一页一页地看,无法把整本书的主题串起来。
GraphRAG 像先画一张知识地图,再按图索骥:它不急于翻书,而是先把整本书读一遍,画出一张”谁认识谁、哪里属于哪里”的关系网(知识图谱)。然后它把关系网里紧密抱团的人划分成一个个”村落”(社区),再请人给每个村落写一份简短的村情介绍(社区摘要)。当你问全局性问题时,它读一遍所有村情介绍就能回答;当你问局部问题时,它从某个人出发,顺着关系网一步步找到答案。
再打一个更生活化的比方:传统 RAG 是”查字典”,适合查一个词;GraphRAG 是”看地图”,适合规划一条路线或理解一座城市的全貌。两者不是替代关系,而是互补——查具体事实用 RAG,做全局分析用 GraphRAG。
GraphRAG 的工作流程分为四个阶段:实体与关系抽取、社区检测、社区摘要、检索。下面逐个拆解。
阶段一:实体与关系抽取
Section titled “阶段一:实体与关系抽取”给定一批文档,GraphRAG 用 LLM 逐段扫描文本,从中抽取实体(entity)和关系(relationship),形成知识图谱的核心构件——三元组(triple)。
一个三元组的结构是:(头实体, 关系, 尾实体)。例如从句子”张三在阿里巴巴担任算法工程师”中,可以抽取:
- 实体:张三(人物)、阿里巴巴(公司)、算法工程师(职位)
- 三元组:(张三, 任职于, 阿里巴巴)、(张三, 职位, 算法工程师)
把所有文档段落抽取出的三元组合并起来,就得到了一张知识图谱:节点是实体,边是关系。这张图记录了文档集合中”谁和谁有关联”,是后续所有步骤的基础。
形式化地,设文档集合为 ,每个文本片段 经过 LLM 抽取后得到三元组集合 。整个知识图谱 由所有片段的三元组聚合而成:
其中 是所有实体的集合, 是所有关系的集合,每条边 表示实体 通过关系 连接到实体 。
抽取质量至关重要。实际操作中通常会要求 LLM 输出结构化的 JSON(实体名、实体类型、关系描述),并对同一实体的不同写法做实体消歧与对齐(entity resolution)——把”阿里巴巴”、“阿里”、“Alibaba”合并为同一个节点,否则图谱会变得支离破碎。
阶段二:社区检测(Community Detection)
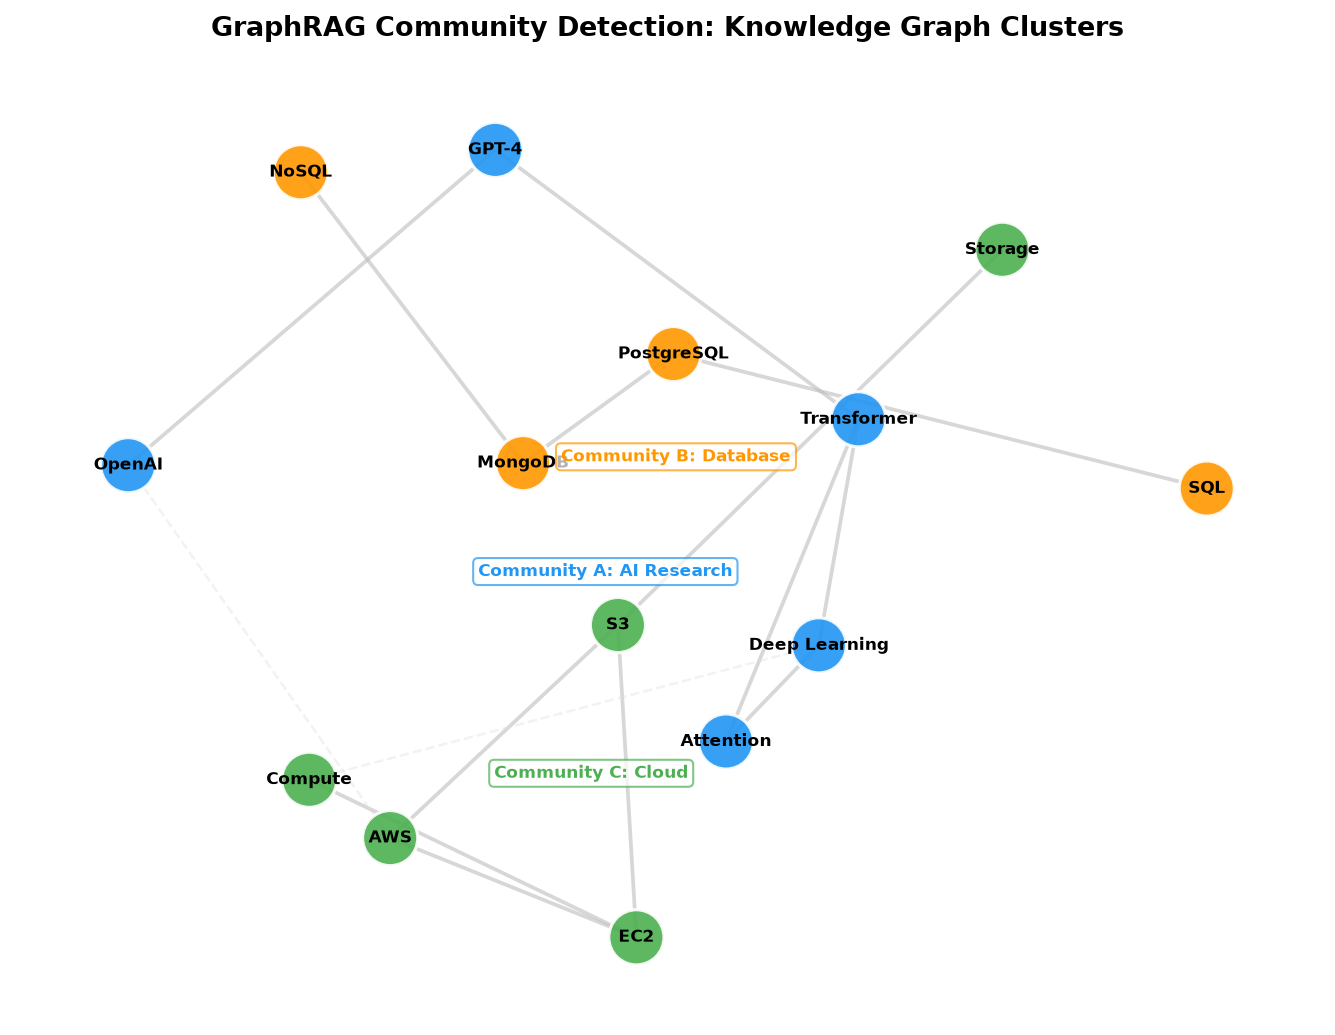
Section titled “阶段二:社区检测(Community Detection)”知识图谱建好后,里面可能有成千上万个节点,直接用整张图做检索既慢又缺乏结构。GraphRAG 的关键创新是用图聚类算法把紧密关联的实体归入同一个社区(community),形成层次化的主题分组。
社区检测的目标是:让社区内部的连接尽量密集,社区之间的连接尽量稀疏。直观地说,就是把图谱里”抱团”的节点圈在一起,每个团代表一个主题集群。
GraphRAG 默认采用 Leiden 算法(一种比 Louvain 更稳健的社区检测算法),它通过优化模块度(modularity)来衡量聚类质量。模块度 的定义为:
= (社区内实际边数占比) 减去 (随机情况下该社区内期望边数占比)
越大,说明社区结构越显著。Leiden 算法通过迭代地移动节点到能最大提升模块度的社区,逐步收敛到较好的划分。
更重要的是,GraphRAG 做层次化社区检测:先在整张图上划分出几个大社区(比如”人物”、“地点”、“技术”),然后对每个大社区内部再递归地细分,得到多层社区结构。顶层社区粒度粗(覆盖面广),底层社区粒度细(主题聚焦)。这种层次结构让检索时可以在不同粒度间灵活切换。
阶段三:社区摘要(Community Summary)
Section titled “阶段三:社区摘要(Community Summary)”社区划分好后,GraphRAG 为每个社区生成一份摘要(community report)。具体做法是:把该社区包含的所有实体及其关系、以及相关的文档片段,一并喂给 LLM,让它写一段结构化的主题概述——这个社区讲的是什么、涉及哪些关键实体、它们之间有什么重要关系。
层次化社区会产生多层次的摘要:顶层社区摘要是全局主题概览(“这份文档集主要讨论 AI 在医疗领域的应用”),底层社区摘要是具体子主题的细节(“某章节讨论了医学影像中的 CNN 应用”)。
社区摘要是 GraphRAG 的灵魂。它把零散的实体和关系”浓缩”成人类可读、LLM 可用的主题级知识单元,使得回答全局性问题成为可能——你不再需要逐段检索,只需阅读社区摘要就能把握全局。
阶段四:检索方式
Section titled “阶段四:检索方式”GraphRAG 提供两种主要检索模式,分别对应不同类型的问题:
Global Search(全局检索):把所有(或某一层的)社区摘要喂给 LLM,让它在多个摘要上并行生成候选答案片段,再汇总成最终答案。适合”全局性”问题,例如:“这份研究报告的核心主题有哪些?""整个文档集对 X 话题的整体立场是什么?“这类问题无法靠检索几个片段回答,但社区摘要天然提供了全局视角。
Local Search(局部检索):从一个种子实体出发,取出它在知识图谱中的邻居实体、相关关系、以及关联的文本片段,组装成一个局部上下文喂给 LLM。适合”具体实体相关”的问题,例如:“张三和谁合作过?""项目 X 依赖哪些技术?“这类问题需要围绕特定实体做精确推理。
此外还可以做 DRIFT 检索(Dual-level Information Flow to Traversal,一种结合全局与局部的混合方式),先在社区摘要层面定位相关区域,再下沉到局部图谱做精细推理,兼顾覆盖度和精确度。
与传统 RAG 的详细对比
Section titled “与传统 RAG 的详细对比”理解 GraphRAG 价值的最快方式,是把它和传统 RAG 放在一起对比。
传统 RAG 的工作方式:把文档切块、对每块计算向量嵌入、存入向量数据库;查询时把问题也变成向量,用相似度检索出最相关的若干块,拼进 prompt 交给 LLM 回答。它本质上是”局部相似度匹配”。
传统 RAG 的强项:事实查找类问题。“X 的定义是什么?""Y 的参数是多少?“这类问题答案集中在某个片段里,向量检索能精准命中。
传统 RAG 的弱点:
- 全局性问题无力:问”这份报告的主要主题是什么”,相关线索分散在几十个片段里,检索 top-k 个片段只能看到冰山一角,LLM 拼不出全局图景。
- 多跳推理困难:问”A 是否通过 B 间接认识 C”,答案要跨越多个文档片段才能连起来(A 和 B 的关系在片段一,B 和 C 的关系在片段二),单纯靠向量相似度很难把这两个片段同时捞出来并建立连接。
- 缺乏结构化关系:向量检索只能告诉你”这两段话语义相似”,却不知道”这两个实体是什么关系”。
GraphRAG 如何弥补:
- 社区摘要解决全局问题:全局性问题直接读社区摘要即可,摘要已经是主题级浓缩,天然支持”文档集讲了什么”这类提问。
- 图结构支持多跳推理:在知识图谱上沿边遍历(A 连到 B,B 连到 C),可以显式地完成跨文档的多跳推理,而不必祈祷向量检索恰好把两个片段同时召回。
- 结构化关系显式可用:实体之间的边就是结构化关系,可以直接回答”X 和 Y 是什么关系”。
当然,GraphRAG 不是银弹:它的索引成本极高(要用 LLM 抽取所有实体和关系、生成所有社区摘要,token 消耗可能是传统向量 RAG 的几十甚至上百倍),而且对频繁变动的文档集不友好(每加新文档可能要重跑图构建和社区检测)。因此实际中常常是 GraphRAG 与传统 RAG 并存,按问题类型分流。
GraphRAG 的成本问题
Section titled “GraphRAG 的成本问题”GraphRAG 最常被诟病的就是索引成本太高。这一问题在 2024 年下半年成为社区讨论焦点,直接催生了一批成本优化方案。
Token 成本到底有多高
Section titled “Token 成本到底有多高”GraphRAG 的索引阶段需要为每一个文本片段调用 LLM 抽取实体和关系,还要为每一个社区生成摘要。假设你有一批文档,切分后约 10,000 个文本片段:
- 实体/关系抽取:每个片段约消耗 2,000–5,000 token(输入 + 输出),总计 2,000 万–5,000 万 token。
- 社区摘要生成:假设检测出 500 个社区,每个社区摘要约消耗 3,000–8,000 token,总计 150 万–400 万 token。
- 叠加层次化摘要的多轮调用,总 token 消耗轻松突破数千万。
对比传统向量 RAG:同样的 10,000 个片段只需调用一次 embedding API(每个片段几百 token,总价低一两个数量级)。微软自己的基准测试表明,完整 GraphRAG 的索引成本大约是向量 RAG 的 100–1000 倍。如果你的文档集有几百万片段,索引费用可能高达数千甚至数万美元。
查询阶段同样不便宜:Global Search 要把几十到上百个社区摘要都喂给 LLM 做多轮 Map-Reduce 式生成,单次查询的 token 消耗也是传统 RAG 的数十倍。
成本优化的核心思路
Section titled “成本优化的核心思路”面对高昂成本,业界发展出几个主要优化方向:
- 推迟昂贵的 LLM 调用:索引阶段只做廉价的 NLP 处理(如名词短语提取),把 LLM 摘要推迟到查询时按需执行——这是 LazyGraphRAG 的核心策略。
- 简化图构建:减少抽取的实体和关系数量、去除层次化摘要,用更轻量的图结构降低索引开销——这是 LightRAG 的思路。
- 分级模型使用:抽取和摘要用便宜模型(GPT-4o-mini、Claude Haiku、开源模型),只在最终回答时用昂贵模型。
- 增量更新:只对新文档做抽取,不重建整个图谱——避免每次文档变动都全量重跑。
- 查询路由:不是每个问题都需要 GraphRAG,把简单事实查找路由到廉价向量检索,只在全局/多跳问题上启用 GraphRAG。
LazyGraphRAG:微软的低成本变体
Section titled “LazyGraphRAG:微软的低成本变体”LazyGraphRAG 是微软研究院于 2024 年 10 月提出的 GraphRAG 变体,目标是在保持回答质量的前提下,把索引成本降到原来的 1% 以下。它的核心思想正如其名——“懒”:索引阶段只做廉价的概念级处理,把昂贵的 LLM 摘要推迟到查询时按需生成。
LazyGraphRAG 的流程分为两步走:
索引阶段(低成本):
- 用 SPCy 等 NLP 工具从文本中抽取名词短语(noun phrases)和共现关系,构建一张概念共现图。这一步不调用 LLM,成本极低。
- 对概念图做社区检测(同样用图算法,不需要 LLM)。
- 为每个社区建立一个概念到文本片段的倒排索引——记录每个概念出现在哪些片段里。
整个索引阶段零 LLM 调用,成本与文本量基本呈线性关系,接近传统向量索引。
查询阶段(按需调用 LLM):
- 把用户问题与社区做相关性匹配(用 embedding 相似度),选出一组最相关的社区。
- 对选出的社区做图算法层面的子图扩展,收集相关的文本片段。
- 此时才调用 LLM:让 LLM 阅读相关片段并生成针对性摘要,再用这个摘要回答问题。
因为只在查询时、且只对相关社区调用 LLM,LazyGraphRAG 大幅减少了 token 消耗。
微软公布的基准测试(在同一份文档集上)显示:
| 方案 | 索引成本(相对值) | 全局问题质量 | 局部问题质量 |
|---|---|---|---|
| 向量 RAG | 1× | 差(无法回答全局问题) | 好 |
| LazyGraphRAG | ~1–2× | 接近完整 GraphRAG | 好 |
| 完整 GraphRAG | ~100–1000× | 最好 | 最好 |
也就是说,LazyGraphRAG 用接近向量 RAG 的索引成本,获得了接近完整 GraphRAG 的全局问答能力。代价是查询延迟略高(每次查询要做社区匹配 + LLM 摘要生成),以及回答一致性略低(同一问题不同时刻可能基于不同片段生成摘要)。
何时选用 LazyGraphRAG
Section titled “何时选用 LazyGraphRAG”- 文档量大、索引预算有限——LazyGraphRAG 是首选起点。
- 查询频率不高(每天几百到几千次),可以接受查询时的额外 LLM 开销。
- 需要灵活控制成本-质量权衡:查询量高时可以切回向量 RAG,需要深度分析时切回完整 GraphRAG。
2025 年 GraphRAG 变体与竞品
Section titled “2025 年 GraphRAG 变体与竞品”2024–2025 年间,学术界和开源社区涌现了一批 GraphRAG 变体,各自从不同角度优化了”知识图谱增强检索”的某个环节。下面对最重要的几个做介绍。
LightRAG
Section titled “LightRAG”LightRAG 由香港大学团队于 2024 年 10 月提出,设计理念是”用更简单的方式获得 GraphRAG 的大部分收益”。
核心特点:
- 双层检索(dual-level retrieval):低层检索从具体实体出发找邻居关系,高层检索从关键词出发找主题级关联。两种粒度在一个统一框架内完成。
- 更轻量的图构建:不做层次化社区检测,直接在扁平的知识图谱上做检索,索引速度更快。
- 原生增量更新:LightRAG 支持向已有图谱中追加新文档,只需抽取新文档的三元组并合并入图,不需要重建整个社区结构。
- 低成本:由于省去了社区摘要生成,索引 token 消耗约为完整 GraphRAG 的 1/10 到 1/5。
LightRAG 的实验显示,在多个基准数据集上,它的回答质量与微软 GraphRAG 相当或略优,但索引速度快一个数量级。对于”想用 GraphRAG 但嫌微软版太重”的团队,LightRAG 是一个务实的选择。
HippoRAG
Section titled “HippoRAG”HippoRAG 由俄亥俄州立大学(OSU)团队于 2024 年 5 月提出,灵感来自人脑的海马体(hippocampus)记忆机制。
核心特点:
- 模拟人脑记忆:人脑的海马体负责将短期记忆整合为长期记忆。HippoRAG 用知识图谱模拟海马体中的”模式分离”(pattern separation)和”模式补全”(pattern completion)。
- PageRank 检索:不使用社区检测,而是在知识图谱上运行个性化 PageRank(Personalized PageRank)算法——从查询相关的种子节点出发,用 PageRank 传播重要性分数,分数高的节点即为最相关的上下文。这种机制可以在单次检索中完成多跳推理。
- 多模态关联:HippoRAG 还引入了场景图(scene graph)来处理图像等多模态内容。
HippoRAG 在自然语言推理(NLI)和多跳问答基准上的表现显著优于传统 RAG,且不需要社区摘要这一昂贵步骤,索引成本介于向量 RAG 和完整 GraphRAG 之间。
RAPTOR
Section titled “RAPTOR”RAPTOR(Recursive Abstractive Processing for Tree-Organized Retrieval)由斯坦福团队于 2024 年初提出。严格来说它用的是树而不是图,但解决的是同一类问题——层次化摘要检索。
核心特点:
- 树状摘要结构:把底层文本片段聚类成组,为每组生成摘要;再对摘要聚类、再摘要,递归构建一棵从叶子(原始片段)到根(全局概览)的摘要树。
- 不抽取实体和关系:RAPTOR 跳过了知识图谱构建这一步,直接在文本块层面做层次化摘要,因此索引成本低于 GraphRAG(不需要 LLM 抽取三元组)。
- 检索时遍历树:查询时可以同时检索叶子节点(具体细节)和中间节点(主题概览),天然兼顾全局和局部需求。
RAPTOR 的优势是简单、成本低、效果好;劣势是缺乏显式的实体关系结构,无法回答”A 和 B 是什么关系”这类需要图遍历的问题。可以把它理解为”没有知识图谱的层次化 RAG”。
nano-graphrag
Section titled “nano-graphrag”nano-graphrag 是开源社区(GitHub 用户 gszx)推出的轻量级 GraphRAG 实现,核心代码约 1,000 行,目标是用最少的代码复现微软 GraphRAG 的核心能力。
核心特点:
- 极简实现:去掉了微软官方版本的大量配置项和企业级工程代码,只保留实体抽取、社区检测、摘要生成、检索这一主线。
- 模型可插拔:支持任意 OpenAI 兼容 API,也可以接入本地部署的 Llama / Qwen 等开源模型。
- 易于理解和修改:代码量小,适合研究者和工程师快速理解 GraphRAG 内部机制,也方便在此基础上做定制化实验。
变体总览对比
Section titled “变体总览对比”| 方案 | 图结构 | 社区检测 | 索引成本(相对向量 RAG) | 擅长场景 | 增量更新 |
|---|---|---|---|---|---|
| 向量 RAG | 无 | 无 | 1× | 事实查找 | 原生支持 |
| 微软 GraphRAG | 实体关系图 | 层次化 Leiden | 100–1000× | 全局分析、多跳推理 | 困难 |
| LazyGraphRAG | 概念共现图 | 有(NLP 级) | ~1–2× | 低成本全局问答 | 中等 |
| LightRAG | 实体关系图 | 无(扁平) | 10–20× | 均衡型 GraphRAG | 原生支持 |
| HippoRAG | 实体关系图 | 无(PageRank) | 5–15× | 多跳推理、低延迟 | 支持 |
| RAPTOR | 摘要树 | 层次化聚类 | 10–30× | 层次化摘要检索 | 困难 |
| nano-graphrag | 实体关系图 | Leiden | 同 GraphRAG | 学习/定制原型 | 困难 |
选型建议:预算极度敏感选 LazyGraphRAG 或干脆用向量 RAG;要均衡选 LightRAG 或 HippoRAG;要最强全局分析能力且预算充足选微软 GraphRAG;只需要层次化摘要不需要实体关系选 RAPTOR。
增量更新策略
Section titled “增量更新策略”GraphRAG 的一个工程痛点是:知识图谱和社区结构一旦建好就难以低成本更新。传统向量 RAG 新增文档只需计算 embedding 追加进库即可,但 GraphRAG 新增文档后:
- 新文档的实体和关系需要抽取并合入图谱。
- 新节点的加入可能改变社区结构(新节点和某些旧节点抱团,社区边界发生变化)。
- 社区摘要需要重新生成以反映新内容。
如果每次新增文档都全量重跑,成本和延迟都不可接受。业界探索了几种增量更新策略:
策略一:Delta 抽取 + 图谱合并
Section titled “策略一:Delta 抽取 + 图谱合并”最基础的增量方案——只对新文档做 LLM 抽取,将新三元组合入已有图谱,不重新做社区检测。社区边界保持不变,新实体被分配到”最近的”现有社区(通过 embedding 相似度或图距离判断归属)。
优点是简单、增量成本低;缺点是社区结构会随时间老化,新实体的归属不一定准确。适合文档增量不大、主题相对稳定的场景(如季度报告追加)。
策略二:局部社区重建
Section titled “策略二:局部社区重建”只对受新文档影响的区域做局部社区重检测。具体做法:找到新实体关联的社区,把这些社区及相邻社区一起作为子图重新跑 Leiden,其余社区保持不变。
这种”外科手术式”的局部重建在大部分文档集上效果接近全量重建,但成本只有后者的 5%–20%。LightRAG 天然支持这种策略,因为它不做全局社区检测,可以直接在受影响区域重跑。
策略三:定期全量重建 + 持续增量
Section titled “策略三:定期全量重建 + 持续增量”一个务务实的折中方案:日常新增文档走 Delta 抽取合入图谱(不重建社区),每隔一段时间(如每月或每季度)做一次全量重建,确保社区结构跟上内容演进。类似于”数据库的增量 checkpoint + 定期 compaction”策略。
社区结构稳定性分析
Section titled “社区结构稳定性分析”经验上,当新增文档量不超过总量的 10%–15% 时,社区结构变化很小(核心社区的成员基本不变,只是边缘社区有微调)。当增量超过 20%–30% 时,社区结构会发生显著漂移,建议触发全量重建。可以在系统中设置阈值自动监控:当”新文档占已有图节点数的比例”超过阈值时触发重建。
查询路由:GraphRAG vs 向量 RAG vs 混合
Section titled “查询路由:GraphRAG vs 向量 RAG vs 混合”成熟的 RAG 系统通常不会只用一种方案,而是根据查询意图动态路由到最合适的检索引擎。这既是为了质量,也是为了成本——没必要对每个”查一个定义”的问题都调用昂贵的 GraphRAG。
查询路由的第一步是对用户问题做意图分类,常见类别包括:
- 事实查找型(factual):如”Adam 优化器的学习率默认值是多少?“——向量 RAG 即可完美回答,成本最低。
- 实体关系型(entity-centric):如”A 和 B 是什么关系?“——需要图遍历,适合 GraphRAG Local Search 或 HippoRAG。
- 多跳推理型(multi-hop):如”引用了论文 X 的方法中,哪些用到了 Y 数据集?“——需要跨文档串联,适合 GraphRAG 或 HippoRAG。
- 全局主题型(global):如”这批文档的主要研究主题有哪些?“——需要社区摘要,适合 GraphRAG Global Search 或 LazyGraphRAG。
路由实现方式
Section titled “路由实现方式”基于规则:用关键词和句式模板做初步分类(“什么是 X”→事实查找,“主要主题”→全局),简单但不够鲁棒。
基于 LLM 分类器:用一个便宜的模型(如 GPT-4o-mini)对查询做一次分类,输出查询类型和推荐路由。成本可控(每次查询多一次廉价 LLM 调用),准确率高,是目前主流做法。
成本感知路由:在分类的基础上叠加成本考量——如果今日 GraphRAG 查询配额已耗尽,自动降级到向量 RAG + 提示用户”当前为经济模式”。
对于难以明确分类的查询,可以走混合检索(hybrid retrieval):同时调用向量 RAG 和 GraphRAG,各自返回候选上下文,再由 LLM 综合两路信息生成答案。这种方式质量最高但成本也最高,适合高端场景或离线批处理。重排序 技术常用于在融合后对候选上下文做精排。
GraphRAG 与不同 LLM 的搭配
Section titled “GraphRAG 与不同 LLM 的搭配”GraphRAG 流水线中有多处需要调用 LLM,不同环节对模型能力的要求差异很大,合理搭配可以大幅降低总成本。
分级模型策略
Section titled “分级模型策略”| 环节 | 能力要求 | 推荐模型档位 |
|---|---|---|
| 实体/关系抽取 | 中等(需理解文本、输出结构化 JSON) | 廉价档:GPT-4o-mini、Claude Haiku、Qwen-Turbo |
| 社区摘要生成 | 中高(需归纳概括、结构化写作) | 中档:GPT-4o、Claude Sonnet |
| 最终答案生成 | 高(需综合推理、复杂表达) | 高档:GPT-4o、Claude Opus、o3 |
| 查询分类/路由 | 低(简单分类) | 最廉价档:GPT-4o-mini、本地小模型 |
一个典型的成本优化配置:抽取用 GPT-4o-mini(成本是 GPT-4o 的 1/30),摘要用 GPT-4o-mini 或 Sonnet,最终回答用 GPT-4o 或更强的推理模型。这样整体成本可以降低一个数量级,而质量损失很小。
开源模型方案
Section titled “开源模型方案”对于数据隐私要求高或希望完全控制成本的场景,可以使用开源模型替代 API:
- 抽取阶段:Llama 3.1 (8B/70B)、Qwen2.5 (7B/72B) 配合结构化输出(结构化输出),已能胜任实体关系抽取任务。本地部署用 vLLM 或 Ollama 加速推理。
- 嵌入阶段:用 BGE、E5、Nomic-Embed 等开源 embedding 模型替代 OpenAI embedding,零 API 成本。
- 摘要和回答:如果预算允许,用 Llama 3.1 70B 或 Qwen2.5 72B 作为主力模型;如果要求极高,仍建议在最关键的回答环节调用 GPT-4 级别的商业模型。
nano-graphrag 正是为此设计——它原生支持接入本地 LLM,让你在本地跑完整 GraphRAG 流水线而不依赖任何外部 API。配合小模型技术,本地部署的成本可以降到几乎为零。
评估 GraphRAG 的质量
Section titled “评估 GraphRAG 的质量”“GraphRAG 比传统 RAG 好多少?“这个问题看似简单,实际上需要一个专门的评估体系。GraphRAG 的评估维度和传统 RAG 有显著差异。
全局问题回答质量:这是 GraphRAG 最核心的差异化能力。评估方法通常是构造一组”全局性”问题(“文档集的主要主题""对某话题的整体立场”),由人工或 LLM 评委对答案做打分。微软论文中使用 LLM 评委按”comprehensiveness(全面性)、diversity(多样性)、empowerment(信息量)“三个维度打分,GraphRAG 在全面性和多样性上显著优于向量 RAG。
多跳推理准确率:构造需要跨文档推理的问题集(如 MuSiQue、2WikiMultihopQA),比较 GraphRAG 和基线 RAG 的准确率。HippoRAG 在这类基准上表现突出。
局部问题回答质量:对于”查一个具体事实”的问题,GraphRAG 通常不比向量 RAG 差,但也不一定更好。评估时要注意不要只用这类问题——否则会得出”GraphRAG 没用”的错误结论。
检索覆盖率(coverage):对于已知答案涉及多个文档的问题,检查检索阶段是否召回了所有相关文档。GraphRAG 凭借图遍历,覆盖率通常高于向量 RAG。
社区质量:社区检测本身的质量直接影响下游性能。可以用模块度(modularity)分数、社区大小分布、社区内文本主题一致性等指标衡量。
| 指标 | 含义 | 适用环节 |
|---|---|---|
| Comprehensiveness | 答案是否覆盖了问题的所有方面 | 全局问题评估 |
| Diversity | 答案是否提供了多元视角 | 全局问题评估 |
| Empowerment | 答案的信息量是否充足 | 全局问题评估 |
| Coverage | 检索是否召回了所有相关文档 | 检索阶段评估 |
| Modularity | 社区划分的结构显著性 | 索引质量评估 |
| Faithfulness | 答案是否忠于检索到的上下文(无幻觉) | 答案质量评估 |
| F1 / EM | 标准问答的准确率 | 事实型问题评估 |
实践中建议分问题类型分别评估:全局问题用 LLM 评委打 comprehensiveness / diversity,多跳问题用 F1 / EM,事实型问题用传统 RAG 基准。把所有问题混在一起评估往往会让 GraphRAG 的优势被事实型问题拉平。
GraphRAG 完整流程
Section titled “GraphRAG 完整流程”从原始文档到最终回答,GraphRAG 的四阶段流水线如下:
传统 RAG vs GraphRAG 对比
Section titled “传统 RAG vs GraphRAG 对比”两种方案在面对不同问题时各有所长:
查询路由决策
Section titled “查询路由决策”混合系统中,查询如何被分流到不同检索引擎:
RAPTOR 的树状摘要结构
Section titled “RAPTOR 的树状摘要结构”RAPTOR 用层次化摘要构建一棵从细节到概览的树:
下面用 Python 演示 GraphRAG 的核心步骤:用 LLM 抽取三元组、用 NetworkX 构建知识图谱、用 python-louvain 做社区检测。
import networkx as nxfrom community import community_louvain  # pip install python-louvain
# 1. 假设用 LLM 从文本抽取出的三元组列表(实际由 LLM 生成)triples = [    ("张三", "任职于", "阿里巴巴"),    ("李四", "合作过", "张三"),    ("阿里巴巴", "位于", "杭州"),    ("王五", "任职于", "腾讯"),    ("腾讯", "位于", "深圳"),    ("张三", "研究", "大语言模型"),    ("李四", "研究", "大语言模型"),]
# 2. 构建知识图谱:实体为节点,关系为带标签的边G = nx.Graph()for head, rel, tail in triples:    G.add_node(head); G.add_node(tail)    G.add_edge(head, tail, relation=rel)
# 3. 社区检测:把紧密关联的实体聚类成社区communities = community_louvain.best_partition(G)# 结果示例:{"张三":0, "李四":0, "阿里巴巴":0, "大语言模型":0,#           "王五":1, "腾讯":1, "深圳":1, "杭州":0}for node, cid in communities.items():    print(f"实体 {node} → 社区 {cid}")# 社区 0 聚焦"张三/李四/阿里/大模型",社区 1 聚焦"王五/腾讯/深圳"
使用微软 graphrag CLI
Section titled “使用微软 graphrag CLI”实际生产中,可以直接使用微软开源的 graphrag(pip install graphrag)完成完整的索引与检索流程:
# 1. 安装pip install graphrag
# 2. 初始化项目(生成 settings.yaml 等配置文件)graphrag init --root ./my-graphrag-project
# 3. 编辑 settings.yaml,填入:#    - LLM API key 和模型名(建议抽取用 gpt-4o-mini,回答用 gpt-4o)#    - 输入文档目录(默认 ./input)#    - 索引参数(chunk size、community 层级数等)
# 4. 构建索引(会调用大量 LLM API,注意成本)graphrag index --root ./my-graphrag-project# 产物:output/ 目录下会生成实体表、关系表、社区表、社区摘要等
# 5. 全局检索(回答全局性问题)graphrag query --root ./my-graphrag-project \  --method global \  --query "这批文档的主要研究主题有哪些?"
# 6. 局部检索(回答实体相关问题)graphrag query --root ./my-graphrag-project \  --method local \  --query "张三和哪些机构有关联?"
成本估算脚本
Section titled “成本估算脚本”在正式跑索引前,务必先估算 token 成本。下面是一个简易估算器:
def estimate_graphrag_cost(    num_chunks: int,    avg_chunk_tokens: int = 800,    extraction_overhead: float = 1.5,   # 抽取输出约为输入的 1.5 倍 token    community_ratio: float = 0.05,      # 社区数约为片段数的 5%    summary_tokens: int = 5000,         # 每个社区摘要消耗的 token    price_per_million_input: float = 0.15,   # GPT-4o-mini 输入价(美元/百万 token)    price_per_million_output: float = 0.60,  # GPT-4o-mini 输出价) -> dict:    """估算 GraphRAG 索引的 token 消耗与成本。"""    extraction_tokens = num_chunks * avg_chunk_tokens * (1 + extraction_overhead)    num_communities = max(1, int(num_chunks * community_ratio))    summary_total_tokens = num_communities * summary_tokens    total_tokens = extraction_tokens + summary_total_tokens
    # 粗略假设输入输出各占一半    cost = (total_tokens / 2 / 1_000_000 * price_per_million_input +            total_tokens / 2 / 1_000_000 * price_per_million_output)    return {        "片段数": num_chunks,        "抽取 token": int(extraction_tokens),        "社区数": num_communities,        "摘要 token": int(summary_total_tokens),        "总 token": int(total_tokens),        "预估成本(美元)": round(cost, 2),    }
# 示例:1 万个片段用 GPT-4o-mini 做抽取和摘要print(estimate_graphrag_cost(num_chunks=10_000))# {'片段数': 10000, '抽取 token': 20000000, '社区数': 500, ...,#  '总 token': 22500000, '预估成本(美元)': 8.44}# 若改用 GPT-4o(输入 $2.5/M,输出 $10/M),同一批次约 $140——差 17 倍
增量索引示例
Section titled “增量索引示例”新文档加入时只做 delta 抽取并合入已有图谱:
import networkx as nx
# 已有图谱(假设之前已构建好)G = nx.Graph()G.add_edges_from([("张三", "阿里巴巴"), ("阿里巴巴", "杭州")])
def incremental_index(G, new_triples: list, existing_communities: dict):    """将新文档抽取的三元组合入已有图谱,保持社区结构不变。
    新实体按 embedding 相似度归入最近的现有社区(此处简化为按图距离)。    """    new_nodes = set()    for head, rel, tail in new_triples:        G.add_edge(head, tail, relation=rel)        new_nodes.add(head)        new_nodes.add(tail)
    # 把新节点归入其邻居所在的社区    for node in new_nodes:        if node not in existing_communities:            neighbors = list(G.neighbors(node))            if neighbors:                # 取第一个已有社区的邻居的社区 ID                neighbor_comm = existing_communities.get(neighbors[0], 0)                existing_communities[node] = neighbor_comm            else:                existing_communities[node] = max(existing_communities.values()) + 1    return G, existing_communities
# 新文档抽出两条三元组new_triples = [("张三", "发表论文于", "NeurIPS"), ("NeurIPS", "属于", "AI 会议")]communities = {"张三": 0, "阿里巴巴": 0, "杭州": 0}G, communities = incremental_index(G, new_triples, communities)print(communities)# {'张三': 0, '阿里巴巴': 0, '杭州': 0, 'NeurIPS': 0, 'AI 会议': 0}# NeurIPS 被归入张三所在的社区 0- 索引成本高,做好预算:GraphRAG 的实体抽取和社区摘要都要调用 LLM,处理一批文档的 token 消耗可能是传统向量索引的几十倍。上线前务必先在小样本上估算成本(用上面的估算脚本),并选择便宜的模型做抽取,贵模型留给最终回答。
- 优先考虑 LazyGraphRAG 或 LightRAG:如果你的预算有限,不要一上来就用完整微软 GraphRAG。先用 LazyGraphRAG(成本最低)或 LightRAG(均衡)跑起来,质量不够再升级到完整 GraphRAG。
- 适合固定或低频变动的文档集:知识图谱和社区结构一旦建好就相对稳定,但每加入大量新文档都可能需要重跑图构建。对于实时性要求高、文档频繁增删的场景,传统 RAG 更合适,或采用增量更新策略。
- 社区粒度是关键调参点:层次化社区有多个层级,太粗会丢失细节(回答不了具体问题),太细又失去全局视角(退化为普通 RAG)。建议先用中等粒度上线,再根据 bad case 调整层级深度。
- 实体消歧决定图谱质量:同一个实体在不同文档里写法不同(“阿里”/“阿里巴巴”/“Alibaba”),如果不做对齐,图谱会四分五裂,社区检测也毫无意义。务必在抽取后加一步实体归一化。
- Global 与 Local 按问题类型分流:不要对所有问题都用 Global Search(又慢又费 token)。先用问题分类器判断是全局性还是局部性问题,全局走社区摘要,局部走图遍历或直接向量检索,能大幅降低成本。
- 与传统 RAG 互补而非替代:成熟的系统通常是混合架构——向量检索负责事实查找,GraphRAG 负责全局分析和多跳推理,根据查询意图动态路由。不要把 GraphRAG 当成 RAG 的替代品。
真实世界案例
Section titled “真实世界案例”- 微软内部知识管理:微软自身的工程团队使用 GraphRAG 对内部文档、设计规格、邮件讨论构建知识图谱,帮助员工快速回答”这个服务依赖哪些组件""这批变更的整体影响范围”等跨文档问题。LazyGraphRAG 正是在这些内部实践中为解决成本问题而诞生的。
- 企业知识图谱 + GraphRAG:大型企业通常已有 Neo4j 等图数据库存储的产品/客户/供应链知识图谱。把 GraphRAG 叠加在已有知识图谱之上,可以实现”现有结构化知识 + 非结构化文档”的联合检索,典型的应用是合规审查和风险评估——从合同文档中抽取实体并链接到已有的供应商图谱,做关联风险分析。
- 科研文献分析:把一个领域(如”扩散模型”)的数千篇论文建成 GraphRAG 知识图谱,社区摘要天然形成”该领域的研究主题划分”,多跳检索支持”某方法依赖哪些前置工作""哪些团队在做类似方向”这类跨论文推理。微软论文中即以医疗领域的科研文献做了基准实验。
- 法律与合规:对大批合同、法规、判例文档做主题挖掘和关联分析——“这批合同涉及哪些供应商、它们之间有什么关联""某条款在哪些案例中被引用过”这类问题正是 GraphRAG 全局分析 + 多跳推理的强项。
- 客服与故障诊断:将产品手册、故障案例、零部件关系建成图谱,客服提问时沿图遍历定位根因,比单纯向量检索更能处理”症状 A 可能由部件 B 故障引起”这类因果链问题。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| graphrag | Python | 微软开源的 GraphRAG 官方实现,完整的索引与检索流水线 |
| nano-graphrag | Python | 轻量级 GraphRAG 实现(约 1,000 行),支持本地 LLM,适合学习和定制 |
| LightRAG | Python | HKU 团队的低成本 GraphRAG 变体,原生支持增量更新 |
| HippoRAG | Python | OSU 团队的仿海马体记忆 RAG,用 PageRank 做多跳检索 |
| networkx | Python | 通用图分析库,用于构建和操作知识图谱 |
| python-louvain | Python | Louvain 社区检测算法实现,配合 NetworkX 使用 |
| neo4j | Python/Cypher | 主流图数据库,常用于存储知识图谱并支持多跳查询 |
| LlamaIndex | Python | 支持 KnowledgeGraphIndex 等图谱检索方案,集成多种 GraphRAG 变体 |
| LangChain | Python | 提供 GraphCypherQAChain 等组件,连接图数据库做问答 |
| igraph | C/Python/R | 高性能图分析库,内置多种社区检测算法(Leiden、Louvain 等) |
| 术语 | 英文 | 解释 |
|---|---|---|
| 知识图谱 | Knowledge Graph | 以实体为节点、关系为边的图结构知识表示 |
| 三元组 | Triple | 知识图谱的基本单元,形如(头实体, 关系, 尾实体) |
| 实体抽取 | Entity Extraction | 从文本中识别人名、地名、机构、概念等命名实体的过程 |
| 关系抽取 | Relation Extraction | 从文本中识别实体之间的语义关系 |
| 实体消歧 | Entity Resolution | 把指向同一现实对象的不同写法合并为同一个节点的过程 |
| 社区检测 | Community Detection | 把图中紧密关联的节点聚类成组的图算法 |
| Leiden 算法 | Leiden Algorithm | 一种改进的社区检测算法,比 Louvain 更稳健,保证社区连通性 |
| 模块度 | Modularity | 衡量社区划分质量的指标,值越大说明社区结构越显著 |
| 社区摘要 | Community Report | 用 LLM 为每个社区生成的主题概述,是 GraphRAG 全局检索的基础 |
| 全局检索 | Global Search | 基于社区摘要回答全局性问题的检索模式 |
| 局部检索 | Local Search | 从种子实体出发沿图遍历回答局部问题的检索模式 |
| 多跳推理 | Multi-hop Reasoning | 需要跨越多个事实或文档片段串联才能得出答案的推理方式 |
| 查询路由 | Query Routing | 根据查询意图将请求分发到最合适检索引擎的机制 |
| 个性化 PageRank | Personalized PageRank | 从给定种子节点出发传播重要性的图算法,HippoRAG 用于多跳检索 |
| 概念共现图 | Concept Co-occurrence Graph | 以概念为节点、共现关系为边的图,LazyGraphRAG 索引阶段使用 |
| 检索增强生成 | RAG | Retrieval-Augmented Generation,检索外部知识辅助大模型生成回答 |
- Edge et al.,「From Local to Global: A Graph RAG Approach to Query-Focused Summarization」(Microsoft, 2024):微软 GraphRAG 的奠基论文,提出”社区检测 + 层次化摘要”的全局检索框架,是本页全部内容的源头,强烈推荐先读这篇。
- Microsoft LazyGraphRAG(2024 年 10 月技术报告):微软研究院发表的 LazyGraphRAG 方案文档,详细介绍了”概念级索引 + 查询时 LLM 摘要”的设计,以及与完整 GraphRAG 的成本质量对比,是理解低成本 GraphRAG 的核心参考。
- Guo et al.,「LightRAG: Simple and Fast Retrieval-Augmented Generation」(HKU, 2024):LightRAG 论文,提出双层检索和原生增量更新,是均衡型 GraphRAG 变体的代表,工程落地价值很高。
- Gutiérrez et al.,「HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models」(OSU, NeurIPS 2024):HippoRAG 论文,从海马体记忆机制出发设计 RAG,用个性化 PageRank 实现高效多跳检索,视角新颖。
- Sarthi et al.,「RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval」(Stanford, ICLR 2024):RAPTOR 论文,用树状层次化摘要解决全局检索问题,虽不用图但思路与 GraphRAG 异曲同工。
- Microsoft GraphRAG 官方开源仓库:微软在 GitHub 上开源的 GraphRAG 完整实现,附带详细的索引配置文档和示例数据集,跑一遍官方 notebook 是理解原理最快的方式。
- nano-graphrag(GitHub: gszx/nano-graphrag):约 1,000 行的轻量 GraphRAG 实现,代码清晰易读,支持本地 LLM,适合快速理解 GraphRAG 内部机制并做定制实验。
- Traag et al.,「From Louvain to Leiden: guaranteeing well-connected communities」(Scientific Reports, 2019):Leiden 算法原始论文,解释了 Louvain 算法可能产生断连社区的缺陷,并给出更稳健的改进方案——GraphRAG 默认社区检测算法的理论依据。
- Neo4j GraphRAG 文档:Neo4j 官方的 GraphRAG 实践指南,展示了如何把知识图谱存入图数据库并用 Cypher 做多跳查询,是工程化落地的优秀参考。
- Gao et al.,「Graph Learning Based Retrieval-Augmented Generation」(2024):一篇较全面的 GraphRAG 综述,系统梳理了从知识图谱构建到图神经网络增强检索的各种变体,适合在读完上述论文后扩展视野。