
信息论基础
信息论(Information Theory)由 Claude Shannon 于 1948 年在贝尔实验室创立,原本用于量化通信信道中的信息量与传输极限。七十多年后,这套数学语言已深深嵌入机器学习的根基——交叉熵(Cross-Entropy)是几乎所有分类模型的损失函数,KL 散度(Kullback-Leibler Divergence)是变分推断的目标函数,互信息(Mutual Information)是表征学习与特征选择的理论依据。可以毫不夸张地说:不理解信息论,就无法真正理解深度学习的损失函数在做什么。
本页从直觉出发,逐步推导信息论中与机器学习直接相关的核心概念,配以数学公式、Python/PyTorch 代码和真实应用案例。即使你是计算机专业但第一次接触 AI,也能跟着理解。前置阅读:概率论基础、线性代数基础。
核心直觉:一套”惊奇度量具”
Section titled “核心直觉:一套”惊奇度量具””把信息论想象成一套惊奇度量具(a set of surprise meters)。它回答一个看似简单的问题:得知某个结果时,你获得了多少”信息”?
- 信息量(self-information)= 一个事件发生带来的”惊讶程度”。太阳从东边升起(概率≈1)→ 零信息量;你中了彩票头奖(概率极低)→ 巨大信息量。越不可能发生的事,发生了越有信息量。
- 熵(entropy)= 一个随机变量的”平均惊讶程度”。你平均每次获得多少信息?熵越大,随机变量越不可预测、越混乱。
- 交叉熵 = 用一套猜测的概率分布去解释真实分布时,平均的”惊讶程度”。猜得越离谱,交叉熵越大——这就是分类任务用它做损失函数的原因。
- KL 散度 = 两个分布之间的”距离”(严格说是不对称的)。衡量你的猜测分布和真实分布差了多远,是生成模型、变分推断的核心度量。
- 互信息 = 知道一个变量后,对另一个变量不确定性的减少量。衡量两个变量共享了多少信息,是特征选择和表征学习的理论基础。
为什么用对数? 信息论中所有核心度量都基于对数函数 。根本原因是:两个独立事件同时发生的概率是各自概率之积 ,而我们直觉上认为”两个独立事件的信息量应该相加”。对数恰好把乘法变成加法:。这就是 Shannon 选择对数的数学动机。
还有一个更深的物理动机:信息论与热力学(Thermodynamics)有深刻的数学联系。统计力学中的 Boltzmann 熵公式 ( 是微观状态数)本质上就是离散熵的连续化——Shannon 的导师 John von Neumann 正是借鉴这一联系,建议 Shannon 将他的度量称为”熵”。
一个概率为 的事件的自信息(self-information)定义为:
其中 可以取以 2 为底(单位为比特 bit)或以 为底(单位为奈特 nat)。在机器学习中通常用自然对数( 为底),因为优化时求导更方便()。
性质一览:
| (bit) | 含义 | |
|---|---|---|
| 1.0 | 0 | 必然事件,没有信息 |
| 0.5 | 1 | 抛硬币正面,1 比特信息 |
| 0.25 | 2 | 四选一,2 比特信息 |
| 0.01 | 6.64 | 百分之一的罕见事件 |
| 极罕见事件,信息量趋无穷 |
直觉:如果一件极不可能的事发生了,你”学到”了很多东西。例如,天气预报说”明天 99% 不下雨”,结果下雨了——这个结果的信息量远大于预报说”50% 可能下雨”时无论下不下的信息量。
从编码角度看自信息:假设你要用二进制串编码一组可能的消息。一个概率为 的消息,最优编码(Huffman 编码 / 算术编码)需要恰好 个比特。概率越高的消息用越短的编码,概率越低的消息用越长的编码——这与日常直觉一致(常用词用简写,罕见词用全称)。这就是”比特”这个单位在信息论中的精确含义。
信息熵(entropy)是一个随机变量 的自信息的期望值,即平均信息量:
对于连续型随机变量,求和变为积分,称为微分熵(differential entropy):
术语解释: 是期望算子(Expectation),即对所有可能值按概率加权求和。 是随机变量 的取值空间(所有可能结果的集合)。
熵衡量”不确定性”或”混乱程度”,这是信息论最核心的洞察:
- 确定性事件(如骰子永远出 6):熵为零,没有不确定性,你知道结果后没有获得任何信息。
- 均匀分布(骰子等概率出 1-6):熵最大,最不可预测。
- 熵越大 = 越混乱、越不可预测;熵越小 = 越有序、越确定。
关键定理:最大熵原理。在所有满足某些约束的分布中,均匀分布的熵最大。这一原理在机器学习中用于构建概率模型——当你对某个问题只知道部分信息时,最大熵分布是最”不偏不倚”的选择(不引入额外假设)。详见 概率论基础 中的最大熵分布。
推导:公平硬币的熵恰好为 1 比特。这是”比特”这个单位的由来:
这意味着:平均每次抛一枚公平硬币,你获得恰好 1 比特的信息量(你消除了恰好 1 比特的不确定性)。这个结论如此优雅,以至于整个数字通信的数据量单位都建立在它之上。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
p = np.linspace(0.001, 0.999, 500)entropy = -p * np.log2(p) - (1 - p) * np.log2(1 - p)
fig, ax = plt.subplots(figsize=(8, 5))fig.patch.set_facecolor("white")
ax.plot(p, entropy, color="#2196F3", linewidth=2.5)ax.fill_between(p, entropy, alpha=0.08, color="#2196F3")
# Mark key pointsax.plot(0.5, 1.0, "o", color="#e91e63", markersize=10, zorder=5)ax.annotate("Max: H(0.5) = 1.0 bit\n(Fair coin = max uncertainty)",            xy=(0.5, 1.0), xytext=(0.62, 0.95), fontsize=9, fontweight="bold",            color="#e91e63", arrowprops=dict(arrowstyle="->", color="#e91e63", lw=1.5))
ax.plot(0.1, -0.1*np.log2(0.1) - 0.9*np.log2(0.9), "o", color="#FF9800", markersize=8, zorder=5)ax.annotate("H(0.1) = 0.47 bit\n(Biased coin = more predictable)",            xy=(0.1, -0.1*np.log2(0.1) - 0.9*np.log2(0.9)), xytext=(0.05, 0.65),            fontsize=9, fontweight="bold", color="#FF9800",            arrowprops=dict(arrowstyle="->", color="#FF9800", lw=1.5))
ax.set_xlabel("P(X = 1) = p", fontsize=12, fontweight="bold")ax.set_ylabel("Entropy H(X)  (bits)", fontsize=12, fontweight="bold")ax.set_title("Bernoulli Entropy: H(p) = -p log2(p) - (1-p) log2(1-p)", fontsize=13, fontweight="bold")ax.set_xlim(0, 1); ax.set_ylim(-0.05, 1.15)ax.grid(True, alpha=0.2, linestyle="--")
plt.tight_layout()plt.savefig("/mnt/kvm_ata-Netac_SSD_480GB_AA000000000000000904-part1/proj/docs/img/generated/bernoulli-entropy-curve.png",            dpi=180, bbox_inches="tight", facecolor="white")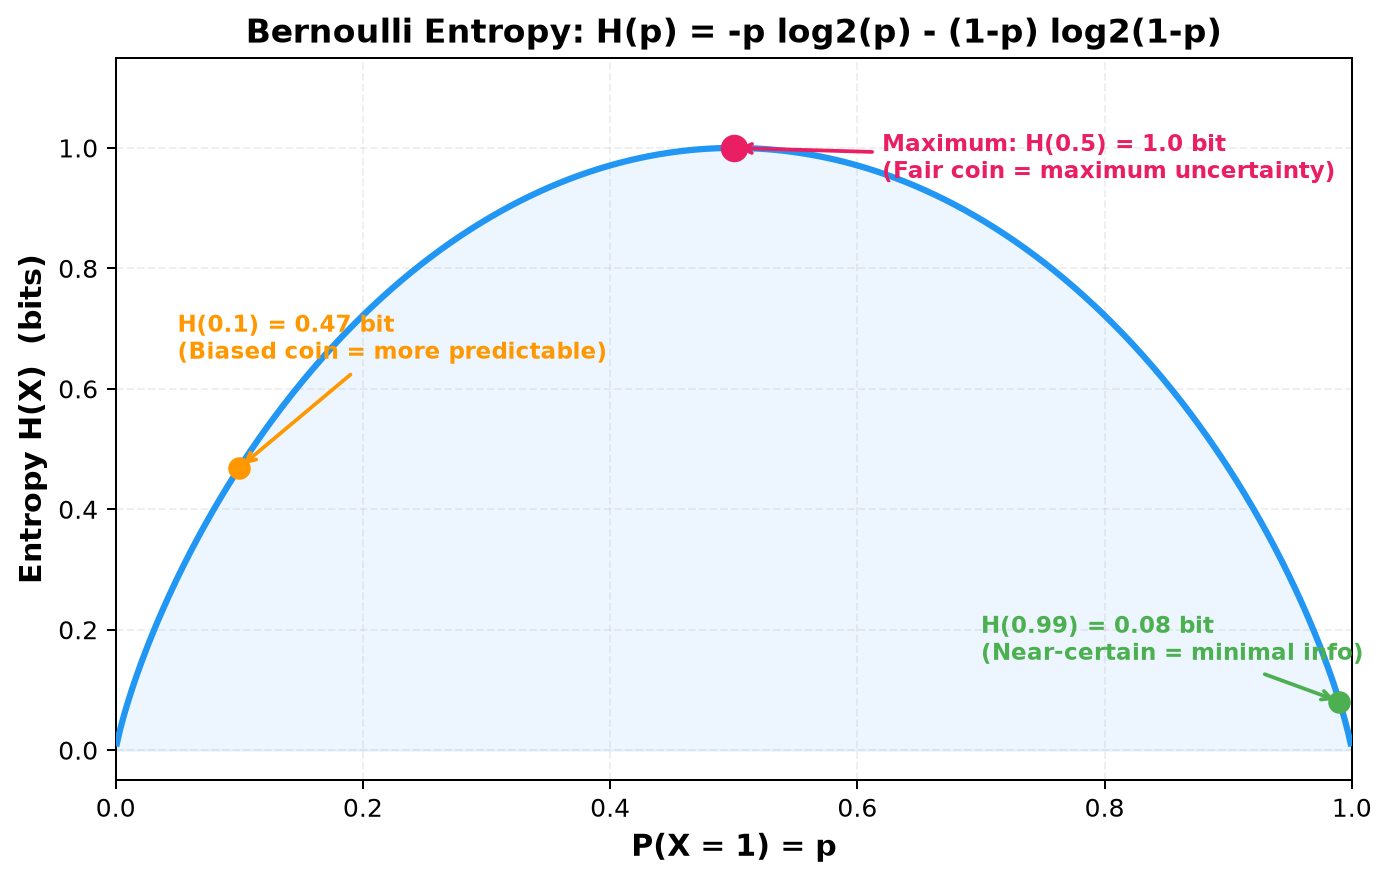
熵的极值推导:n 个等概率结果时熵最大
Section titled “熵的极值推导:n 个等概率结果时熵最大”让我们严格证明,对于一个有 种可能取值的离散随机变量,均匀分布使熵最大。使用 Lagrange 乘子法(Lagrange multipliers),约束条件为 :
对 求偏导并令其为零:
所有 相等——即均匀分布 ,此时 。这就是最大熵原理的最简形式。
在机器学习中的意义:Logistic 回归的输出是 Softmax。Softmax 的分母是 ,这个形式可以从最大熵原理推导出来——给定特征-标签的期望匹配约束,满足约束且使熵最大的分布恰好是指数族分布(Exponential Family),Softmax 是其多分类特例。详见 逻辑回归。
微分熵的特殊性
Section titled “微分熵的特殊性”连续变量的熵(微分熵)有一些与离散熵不同的性质,必须注意:
- 可以为负值:例如均匀分布 的微分熵为 。当 时,。这在离散熵中不可能发生。
- 依赖坐标系:如果你对变量做变换 ,则 。改变度量单位就会改变微分熵的值。
- 无明确的”信息量”含义:离散熵有”最优编码的平均比特数”的精确含义,微分熵没有直接对应的编码解释。
实践建议:在连续场景下,优先使用互信息 而非微分熵 。互信息在连续和离散情况下都非负,且不依赖坐标系(互信息是两个微分熵之差,坐标系变换的影响相互抵消)。
联合熵与条件熵
Section titled “联合熵与条件熵”联合熵(joint entropy)是两个随机变量 和 作为一个整体的熵:
它衡量同时考虑两个变量的总不确定性。
条件熵(conditional entropy)是在已知 的条件下 的剩余不确定性:
术语解释: 读作”给定 时 的条件概率”,即在已知 的前提下 的概率。 是联合概率,即 且 同时发生的概率。
链式法则(chain rule)揭示了联合熵、条件熵和边缘熵的关系:
这条法则可以推广到 个变量:
直觉:条件熵告诉你”知道 之后, 还有多不确定”。
- 如果 完全决定了 (如 是 的确定性函数),则 ——知道 后 毫无悬念。
- 如果 和 独立,则 ——知道 没有任何帮助。
- 一般情况:——知道 只会减少不确定性(或不变),永远不会增加。这个不等式称为条件作用降低熵(conditioning reduces entropy)。
实际案例:假设 = 一封邮件是否为垃圾邮件, = 邮件中是否包含”免费赚钱”。如果垃圾邮件几乎都包含这个词,那么知道 会大幅减少 的不确定性,即 。这正是朴素贝叶斯分类器的信息论直觉。
条件作用不一定降低熵(多变量场景):需要特别注意,“条件作用降低熵”只对两个变量成立。当涉及三个或更多变量时,可能出现 不成立的情况——即条件作用可能增加熵,这称为 Simpson 悖论的信息论版本。但在机器学习实践中,这一反直觉现象很少影响模型设计。
交叉熵(cross-entropy)衡量用分布 (你的猜测/模型预测)去编码来自真实分布 的数据时,平均需要多少信息量:
注意:交叉熵的期望是对真实分布 取的,而 内是预测分布 。你可以理解为”按照真实的频率去采样,但用你的编码方案 去衡量每个样本的惊讶程度”。
当 时,交叉熵等于熵 ,这是最小值——用正确的分布编码最经济。 偏离 越远,交叉熵越大。
这就是为什么交叉熵是分类任务的标准损失函数:模型的预测概率 越接近真实标签分布 ,交叉熵越小。深度学习中几乎所有分类模型(图像分类、文本分类、语言模型)都用交叉熵损失。详见损失函数。
交叉熵的拆解:为什么它同时包含了”正确”和”精确”
Section titled “交叉熵的拆解:为什么它同时包含了”正确”和”精确””交叉熵可以分解为两部分:
- :数据本身固有的不确定性,与模型无关,无法消除。
- :模型预测 与真实分布 的差距,这是模型可以通过学习缩小的。
由于 对给定数据集是常数,最小化交叉熵等价于最小化 KL 散度——这一等价性贯穿整个深度学习。
推导:交叉熵对 Softmax 的梯度
Section titled “推导:交叉熵对 Softmax 的梯度”这是理解分类模型如何学习的关键推导。设模型输出 logits ,Softmax 将其转换为概率 。对于 one-hot 真实标签 (仅类别 概率为 1),交叉熵为:
对 求偏导:
即 梯度 = 预测概率 − one-hot 标签。这个结果异常简洁:
- 对正确类别 :梯度为 (因为 ),梯度下降会增大 ,提升正确类别的分数。
- 对错误类别 :梯度为 ,梯度下降会减小 ,压低错误类别的分数。
这个梯度公式形式优美、数值稳定,是深度学习中最常用的梯度之一。PyTorch 的 F.cross_entropy 在前向传播中计算 Loss,反向传播时自动使用这个公式。
import torchimport torch.nn.functional as F
# 验证 Softmax + Cross-Entropy 的梯度公式logits = torch.tensor([[2.0, 1.0, 0.5, -0.5]], requires_grad=True)label = torch.tensor([0])  # 正确类别为 0
loss = F.cross_entropy(logits, label)loss.backward()
probs = F.softmax(logits.detach(), dim=1)one_hot = F.one_hot(label, num_classes=4).float()manual_grad = probs - one_hot  # 手动计算的梯度
print(f"PyTorch 自动梯度: {logits.grad[0]}")print(f"手动梯度 (q - y):  {manual_grad[0]}")print(f"是否一致: {torch.allclose(logits.grad, manual_grad)}")  # True
KL 散度(Kullback-Leibler divergence),又称相对熵(relative entropy),衡量两个分布 和 的差异:
术语解释: 称为似然比(likelihood ratio)。 后称为对数似然比。KL 散度是对数似然比的期望值。
关键性质与推导:
-
非负性:,当且仅当 (几乎处处)时为零。
-
证明:利用 Jensen 不等式(Jensen’s Inequality)。对于凹函数 ( 是凹的),。
因此 。当且仅当 为常数(即 )时取等。
-
-
不对称性:。因此它严格来说不是”距离”(距离需要满足对称性)。它更像是一种”方向性的代价”。
-
与交叉熵的关系:。正如上文所述,最小化交叉熵等价于最小化 KL 散度。
正向 KL vs 逆向 KL:均值搜索 vs 模式搜索
Section titled “正向 KL vs 逆向 KL:均值搜索 vs 模式搜索”KL 散度的不对称性在生成模型中有极重要的实践含义:
- 正向 KL :模型必须覆盖真实数据的所有高概率区域(否则 但 时,)。结果是模型试图”覆盖”所有模式,导致均值搜索(mean-seeking),图像偏模糊。VAE 使用正向 KL。
- 逆向 KL :模型只需要在自己给出高概率的地方与真实分布吻合,可以忽略低概率区域。结果是模式搜索(mode-seeking),生成样本更尖锐但可能遗漏部分模式。GAN 使用逆向 KL。
直观比喻:正向 KL 像”务实的保险经纪人”,必须覆盖所有风险点;逆向 KL 像”专注的艺术家”,只关心自己擅长的领域,做到精致。
KL 散度不对称的可视化
Section titled “KL 散度不对称的可视化”import numpy as np
def kl_div(p, q): """计算 D_KL(P||Q),自动处理 P(x)=0 的情况。""" mask = p > 0 return np.sum(p[mask] * np.log(p[mask] / np.clip(q[mask], 1e-12, None)))
# 两个高斯分布x = np.linspace(-5, 8, 1000)def gaussian(x, mu, sigma): return np.exp(-0.5 * ((x - mu) / sigma) ** 2) / (sigma * np.sqrt(2 * np.pi))
P = gaussian(x, mu=0, sigma=1) # 真实分布:窄、居中Q = gaussian(x, mu=3, sigma=2) # 模型分布:宽、偏右
P /= P.sum() # 归一化为概率Q /= Q.sum()
print(f"D_KL(P||Q) 正向: {kl_div(P, Q):.4f}") # 模型必须覆盖真实分布所有区域print(f"D_KL(Q||P) 逆向: {kl_div(Q, P):.4f}") # 模型只管自己的高概率区print(f"两者不相等: {kl_div(P, Q):.4f} ≠ {kl_div(Q, P):.4f}")KL 散度在机器学习中无处不在:VAE 的损失函数(ELBO)包含 KL 项,知识蒸馏中学生模型要最小化与教师模型的 KL 散度,正则化中的权重衰减可以从 KL 散度的贝叶斯视角推导出来。详见变分自编码器、正则化。
JS 散度(Jensen-Shannon divergence)是 KL 散度的对称化版本:
其中 是 和 的逐点平均分布。
JS 散度相比 KL 散度的优势:
- 对称:。
- 有界:以 2 为底时上界为 1,以 为底时上界为 。
- 有定义:当 时,只要 也为 0,JS 散度仍有限(因为 只要 );而 KL 散度在此时趋于无穷。
- JS 散度的平方根是一个真正的度量(metric):满足三角不等式,因此 可以当作距离来使用。
GAN 的原始论文用 JS 散度分析了生成器与判别器的博弈。当生成分布和真实分布完全不重叠时,(常数),梯度为零——这解释了 GAN 训练中梯度消失的根本原因。详见生成对抗网络。
Wasserstein 距离:当 KL/JS 失效时
Section titled “Wasserstein 距离:当 KL/JS 失效时”当两个分布的支撑集(support,即概率大于零的区域)完全不重叠时,KL 散度趋于无穷、JS 散度变为常数——梯度完全消失,优化无法进行。这在 GAN 训练初期非常常见(生成器产生的样本与真实样本处于完全不同的区域)。
Wasserstein 距离(又称推土机距离,Earth Mover’s Distance, EMD)解决了这个问题。它衡量”将一个概率分布’搬运’成另一个分布所需的最小代价”:
其中 是所有边缘分布分别为 和 的联合分布 的集合。直觉上, 描述”从位置 搬运多少泥土到位置 ”, 就是使总搬运距离最小的方案。
关键优势:即使两个分布完全不重叠,Wasserstein 距离仍然连续且几乎处处可导,提供有意义的梯度。这是 Wasserstein GAN (WGAN) 的核心动机。详见生成对抗网络。
互信息(mutual information)衡量两个随机变量之间共享的信息量:
直觉:知道 之后, 的不确定性减少了多少。减少得越多, 和 越相关。
互信息的 KL 散度形式——这是最深刻的一种表述:
最后一行说明:互信息等于联合分布 与”假设独立时的边缘分布之积” 之间的 KL 散度。 和 越独立,互信息越小;完全独立时为零。
互信息 vs 相关系数:皮尔逊相关系数(Pearson correlation)只衡量线性关系,即使两个变量有完美的非线性依赖,相关系数也可能为零。互信息捕获任意统计依赖(线性和非线性),因此在特征选择和表征学习中远比相关系数强大。例如 ,当 服从对称分布时 ,但 。
互信息在特征选择、表征学习、信息瓶颈(Information Bottleneck)方法中广受重视。深度学习中的对比学习(Contrastive Learning,如 SimCLR、CLIP)本质上就是在最大化同一样本不同视角之间的互信息。
Fano 不等式:信息论对分类精度的根本限制
Section titled “Fano 不等式:信息论对分类精度的根本限制”Fano 不等式(Fano’s Inequality)给出了一个深刻的结果:给定特征 和标签 ,任何分类器的错误率 有一个由互信息 决定的下界:
其中 是类别数。粗略地说:
直觉:如果特征 和标签 之间的互信息很小,那么任何分类器都不可能达到低错误率——因为特征里就没有足够的信息来区分标签。这不是算法的问题,而是信息论的根本限制(fundamental limit)。
对深度学习的启示:如果你在某个任务上怎么调模型精度都上不去,先检查 是否够大——也许问题不在模型,而在数据本身信息量不足。
信息瓶颈理论
Section titled “信息瓶颈理论”信息瓶颈(Information Bottleneck, IB)由 Naftali Tishby 提出,为理解深度学习提供了一个优雅的理论框架:
其中 是网络的中间表示(hidden representation), 是拉格朗日乘子。目标是:
- 压缩:减小 ,即中间表示应尽可能少地保留输入信息。
- 保留:维持 ,即中间表示应尽可能多地保留与标签相关的信息。
这一框架解释了深度神经网络为什么有效——它们在学习”压缩输入,只保留预测有用信息”的表示。2017 年 Tishby 等人提出”信息瓶颈深度学习”假说,认为深度网络训练分为两个阶段:先快速减小 的拟合误差(fitting phase),再缓慢压缩 (compression phase)。这一假说引发了激烈争论——后续研究表明压缩现象是否出现取决于所用的激活函数和双变量互信息估计方法。
数据处理不等式
Section titled “数据处理不等式”数据处理不等式(Data Processing Inequality, DPI)是信息论的基本定理之一:如果 构成马尔可夫链(即 只通过 依赖于 ),则:
直觉:数据处理不会凭空创造信息。对数据进行的任何变换(无论多么复杂的算法)都不会增加信息量——只会保持或减少。这就是为什么”垃圾进,垃圾出”(Garbage In, Garbage Out)有严格的数学基础。
对深度学习的启示:神经网络的每一层是对信息的有损变换。网络深度增加时,标签相关信息 ( 是第 层表示)随层数递减(或不变),这也是深度网络训练困难的信息论视角之一。
DPI 的推论——不变性:如果 ,其中 是确定性函数,则 。这意味着任何降维操作(PCA、池化、注意力压缩)都不会增加信息量。模型架构设计本质上是在”压缩信息”和”保留任务相关信息”之间权衡。
交叉熵与极大似然估计的等价性
Section titled “交叉熵与极大似然估计的等价性”最小化交叉熵损失等价于极大似然估计(Maximum Likelihood Estimation, MLE)。对数据集 上的负对数似然:
当 时,由大数定律:
即负对数似然的期望恰好就是交叉熵。在分类场景下,真实分布 是 one-hot 分布(正确类别概率为 1,其余为 0),此时交叉熵退化为:
即正确类别预测概率的负对数——这就是 PyTorch F.cross_entropy 在做的事。
为什么这个等价性重要? 它把信息论和统计学统一了起来:你既可以说”模型在最小化预测分布与真实分布的信息差异”,也可以说”模型在最大化观测数据的出现概率”。两种视角殊途同归,但信息论视角更直观(有”惊讶程度”的物理意义),统计学视角更严谨(有渐近一致性等保证)。详见EM 算法、梯度下降。
速率-失真理论:压缩的根本极限
Section titled “速率-失真理论:压缩的根本极限”速率-失真理论(Rate-Distortion Theory)是 Shannon 信息论的另一大支柱,研究”在允许一定误差的前提下,最少需要多少比特来表示一个随机变量”。
设编码后的表示为 ,失真度量为 (如均方误差),允许的最大失真为 ,则速率-失真函数定义为:
即:在平均失真不超过 的所有编码方案中,所需的最小互信息 。
与机器学习的联系:
- 自编码器(Autoencoder)可以看作速率-失真问题的神经网络实现——瓶颈层(bottleneck)的维度控制速率 ,重构损失控制失真 。VAE 的 ELBO 中,KL 项约束隐空间的速率,重构项约束失真。
- 模型量化(Quantization):将 float32 压缩为 int8/int4 本质上是速率-失真问题——用更少比特(更低速率)表示权重,同时控制精度损失(失真)。
- 特征降维:PCA 在均方误差失真下是最优的线性速率-失真编码。
信道容量与注意力机制
Section titled “信道容量与注意力机制”Shannon 的信道容量(Channel Capacity)定义了噪声信道可靠传输信息的最大速率:
其中 是输入, 是输出。Shannon 的信道编码定理证明:只要传输速率 ,就存在编码方式使错误率任意小;若 ,则不可能可靠传输。
与注意力机制的类比:Transformer 中的 Attention 可以从信息论角度理解——它是学习一个”信道”,将 query 的信息高效”传输”到 key-value 对中。Multi-Head Attention 类似多个并行信道,每个头专注于不同类型的信息传输。Softmax 的温度参数则类似于调节信道的”信噪比”——温度越高,分布越平滑(低信噪比),温度越低,越尖锐(高信噪比)。详见 Transformer。
信息论核心概念关系
Section titled “信息论核心概念关系”熵的直觉:不同分布的不确定性对比
Section titled “熵的直觉:不同分布的不确定性对比”互信息的维恩图视角
Section titled “互信息的维恩图视角”互信息、熵、条件熵和联合熵之间的关系可以用一张维恩图完美展示:
- 左圆 = : 的总不确定性。
- 右圆 = : 的总不确定性。
- 重叠部分 = :共享的信息。
- 两圆并集 = :联合不确定性。
numpy 手算熵、交叉熵与 KL 散度
Section titled “numpy 手算熵、交叉熵与 KL 散度”import numpy as np
# --- 熵的计算:两个分布,哪个更混乱? ---p_fair = np.array([0.5, 0.5]) # 公平硬币p_biased = np.array([0.9, 0.1]) # 偏币
def entropy(p, base=2): """计算离散分布的熵。base=2 时单位为 bit。""" p = p[p > 0] # 避免 log(0),因为 0·log0 按约定为 0 return -np.sum(p * np.log(p)) / np.log(base)
print(f"公平硬币熵: {entropy(p_fair):.4f} bit") # 1.0000 (最大)print(f"偏币熵: {entropy(p_biased):.4f} bit") # 0.4690 (较有序)
# --- 交叉熵与 KL 散度 ---P = np.array([0.7, 0.2, 0.1]) # 真实分布(三分类)Q_good = np.array([0.6, 0.3, 0.1]) # 模型预测(接近真实)Q_bad = np.array([0.1, 0.1, 0.8]) # 模型预测(严重偏离)
def cross_entropy(p, q): """交叉熵 H(P, Q):用 Q 编码来自 P 的数据的平均代价。""" q = np.clip(q, 1e-12, 1.0) # 避免 log(0) return -np.sum(p * np.log(q)) # 以 e 为底, 单位 nat
def kl_divergence(p, q): """KL 散度 D_KL(P||Q):衡量 P 和 Q 的差异。""" mask = p > 0 # 只在 P(x)>0 处有意义 p, q = p[mask], np.clip(q[mask], 1e-12, 1.0) return np.sum(p * np.log(p / q))
ce_good = cross_entropy(P, Q_good)ce_bad = cross_entropy(P, Q_bad)H_P = entropy(P, base=np.e) # 用 e 为底以保持单位一致
print(f"\n真实分布熵 H(P): {H_P:.4f}")print(f"好预测交叉熵 H(P,Q_good): {ce_good:.4f} (KL = {ce_good - H_P:.4f})")print(f"差预测交叉熵 H(P,Q_bad): {ce_bad:.4f} (KL = {ce_bad - H_P:.4f})")# 验证:交叉熵 = 熵 + KL 散度assert np.allclose(ce_good, H_P + kl_divergence(P, Q_good))运行后你会看到:好预测的交叉熵接近 (KL 散度小),差预测的交叉熵远大于 (KL 散度大)。
PyTorch 交叉熵损失(分类任务标配)
Section titled “PyTorch 交叉熵损失(分类任务标配)”import torchimport torch.nn.functional as F
# 模拟三分类:模型输出 logits,真实标签是类别1logits = torch.tensor([[2.0, 1.5, 0.3]], requires_grad=True) # 未归一化的预测分数label = torch.tensor([1]) # 正确答案: 类别1
# F.cross_entropy 内部自动做 LogSoftmax + NLL,数值稳定loss = F.cross_entropy(logits, label)print(f"交叉熵损失: {loss.item():.4f}")
# 反向传播,观察梯度loss.backward()print(f"logits 梯度: {logits.grad}")# 正确类别(1)的梯度为负 → 优化器会增大该类别 logit → 损失下降
# 手动等价计算:先 softmax 再取负对数probs = F.softmax(logits.detach(), dim=1)nll = -torch.log(probs[0, label])print(f"手动 NLL: {nll.item():.4f}") # 与 F.cross_entropy 完全一致互信息特征选择实战
Section titled “互信息特征选择实战”from sklearn.feature_selection import mutual_info_classiffrom sklearn.datasets import make_classificationimport numpy as np
# 生成数据:1000 个样本,20 个特征,但只有 5 个真正有用X, y = make_classification(n_samples=1000, n_features=20, n_informative=5, n_redundant=5, random_state=42)
# 计算每个特征与标签的互信息mi_scores = mutual_info_classif(X, y, random_state=42)
# 按互信息从大到小排序for idx in np.argsort(mi_scores)[::-1][:10]: print(f"特征 {idx:2d}: 互信息 = {mi_scores[idx]:.4f}")# 排名靠前的特征与标签共享最多信息,应优先选用使用 KL 散度实现知识蒸馏
Section titled “使用 KL 散度实现知识蒸馏”知识蒸馏(Knowledge Distillation)是模型压缩的经典技术,核心就是最小化学生模型与教师模型之间的 KL 散度:
import torchimport torch.nn.functional as F
# 教师模型(大模型)和学生模型(小模型)的输出 logitsteacher_logits = torch.tensor([[3.0, 1.0, 0.5, -1.0]])  # 大模型:自信student_logits = torch.tensor([[1.0, 0.8, 0.5, 0.2]])   # 小模型:不够自信
temperature = 3.0  # 温度参数:软化概率分布,暴露类别间关系
# 软目标(soft targets):教师的高温 softmaxsoft_teacher = F.softmax(teacher_logits / temperature, dim=1)# 学生的高温 log-softmaxlog_soft_student = F.log_softmax(student_logits / temperature, dim=1)
# KL 散度损失(注意 PyTorch 的 F.kl_div 要求 log-prob 作为输入)distillation_loss = F.kl_div(log_soft_student, soft_teacher,                             reduction='batchmean') * (temperature ** 2)print(f"蒸馏损失: {distillation_loss.item():.6f}")# 乘 T^2 是因为高温 softmax 缩小了梯度,需补偿以保持量级
神经互信息估计(MINE)
Section titled “神经互信息估计(MINE)”在高维连续空间中,直接计算互信息几乎不可能。MINE(Mutual Information Neural Estimation) 用一个神经网络来估计互信息的下界,基于 KL 散度的 Donsker-Varadhan 表示:
其中 是一个可学习的统计量网络(statistics network), 是边缘分布的乘积(即假设 独立时的联合分布)。
import torchimport torch.nn as nn
class MINE(nn.Module):    """神经互信息估计器(MINE)。    通过训练一个统计量网络 T(x, y) 来逼近互信息的下界。"""    def __init__(self, dim_x, dim_y, hidden=64):        super().__init__()        self.net = nn.Sequential(            nn.Linear(dim_x + dim_y, hidden),            nn.ReLU(),            nn.Linear(hidden, hidden),            nn.ReLU(),            nn.Linear(hidden, 1),        )
    def forward(self, x, y):        """返回互信息下界的估计值。"""        # 联合样本(真实分布)        joint = torch.cat([x, y], dim=1)        # 边缘样本(打乱 y 破坏依赖,模拟独立分布)        y_shuffle = y[torch.randperm(y.size(0))]        marginal = torch.cat([x, y_shuffle], dim=1)
        t_joint = self.net(joint).mean()              # E[T(x,y)] under P(x,y)        t_marginal = torch.logsumexp(self.net(marginal), dim=0) - \                     torch.log(torch.tensor(float(marginal.size(0))))        # Donsker-Varadhan 下界        mi_lower = t_joint - t_marginal        return mi_lower
# 示例:估计两个相关高斯变量之间的互信息torch.manual_seed(42)N = 2000x = torch.randn(N, 1)y = x + 0.5 * torch.randn(N, 1)  # y 与 x 相关,理论 MI > 0
mine = MINE(dim_x=1, dim_y=1)optimizer = torch.optim.Adam(mine.parameters(), lr=1e-3)
for epoch in range(2000):    optimizer.zero_grad()    # 最大化 MI 下界 → 取负号最小化    loss = -mine(x, y)    loss.backward()    optimizer.step()    if epoch % 500 == 0:        print(f"Epoch {epoch}: MI 下界 = {-loss.item():.4f}")
# 理论值:两个相关高斯 I(X;Y) = -0.5 * log(1 - rho^2)rho = 1.0 / (1.0 + 0.25)  # 相关系数true_mi = -0.5 * np.log(1 - rho**2)print(f"理论互信息: {true_mi:.4f}")
可视化不同温度下 Softmax 的熵
Section titled “可视化不同温度下 Softmax 的熵”温度参数(Temperature)控制 Softmax 输出的熵——这是 LLM 解码中的核心概念:
import numpy as np
def softmax_with_temperature(logits, T):    """带温度的 Softmax。T 越大分布越平滑(熵越高)。"""    logits = np.array(logits) / T    exp_logits = np.exp(logits - logits.max())  # 数值稳定    return exp_logits / exp_logits.sum()
def entropy_bits(probs):    """以 bit 为单位的熵。"""    probs = probs[probs > 0]    return -np.sum(probs * np.log2(probs))
logits = [3.0, 2.0, 1.0, 0.5, -1.0]  # 5 个类别的 logits
print(f"{'温度 T':>6} | {'熵 (bit)':>10} | {'分布':>40}")print("-" * 65)for T in [0.5, 0.8, 1.0, 2.0, 5.0, 10.0]:    probs = softmax_with_temperature(logits, T)    H = entropy_bits(probs)    bar = "".join(f"{p*100:5.1f}%" for p in probs)    print(f"{T:6.1f} | {H:10.4f} | {bar}")
# T→0: 接近 argmax(熵→0),模型极端自信# T→∞: 接近均匀分布(熵→log2(5)=2.32),模型完全不确定
运行这段代码,你会看到温度从 0.5 升到 10.0 时,输出熵从接近 0(集中在最高 logit 的类别)增加到接近 (均匀分布)。这就是为什么高温采样使 LLM 输出更有创意(更高熵),低温采样更确定(更低熵)。
-
交叉熵 + Softmax 的数值稳定性:直接先 softmax 再取 log 再取负,在预测概率极小时会出现 导致 NaN。实际实现中(如 PyTorch 的
F.cross_entropy)使用 LogSumExp 技巧:先减去最大值再取指数,避免数值溢出/下溢。永远优先使用框架内置的交叉熵函数,不要手动实现。
-
KL 散度不对称性的实践影响:正向 KL(, 为真实)是”均值搜索”(mean-seeking),逆向 KL()是”模式搜索”(mode-seeking)。VAE 用正向 KL(覆盖所有模式但有模糊),GAN 用逆向 KL(生成尖锐样本但可能丢失模式)。选择哪个方向直接影响生成行为。
-
Label Smoothing 的信息论视角:标签平滑(Label Smoothing)将 one-hot 标签 替换为 ,从信息论看是在真实分布中加入一定熵(不确定性),防止模型对训练标签过度自信,提升泛化能力。这在现代大语言模型训练(GPT、LLaMA)中是标准配置。
从信息论角度,标签平滑等价于在优化目标中加入一个熵正则项(entropy regularization):它鼓励模型输出的预测分布具有一定的不确定性,而不是退化为 point mass。实验证明,这能显著提高模型的校准度(calibration)——即模型的预测置信度与实际准确率更加匹配。
-
离散 vs 连续的熵含义不同:离散熵总是非负且有明确的信息量含义;微分熵(连续型)可以为负,且依赖于坐标系(改变度量单位会改变其值)。互信息在两种情况下都有效且非负,因此连续场景下优先使用互信息而非微分熵。
-
信息论度量在 GAN 训练中的局限:当生成分布和真实分布的支撑集不重叠时(训练初期很常见),JS 散度为常数 ,KL 散度趋于无穷,梯度完全消失。这是 GAN 训练不稳定的根本原因之一,也是 Wasserstein GAN 提出的动机——Wasserstein 距离即使分布不重叠时也连续可导。详见生成对抗网络。
-
交叉熵损失对类别不平衡敏感:当某些类别样本极少时,交叉熵会被多数类主导。实践 remedy 包括 focal loss(降低易分样本权重)、class-weighted cross-entropy(按类别频率加权)。Focal Loss 的公式 本质上是对交叉熵的自适应加权:模型越确信正确答案(),权重 ,自动降低”已经学会”的样本的贡献。详见损失函数。
-
信息熵不等于热力学熵(但有关联):机器学习中说”熵”默认指信息熵(Shannon 熵),衡量概率分布的不确定性。不要与物理学中的热力学熵混淆——尽管两者在统计力学中有深刻的数学联系(Boltzmann 公式 )。
-
困惑度(Perplexity)是熵的指数化:语言模型的标准评估指标 (取决于对数底)。PPL 表示”模型在每个位置平均等价于在多少个候选词中均匀选择”。PPL = 1 意味着模型完全确定下一个词;PPL = 词表大小意味着模型一无所知。GPT-4 在英文文本上的 PPL 约 5-10,远低于 GPT-2 的 20-30。
-
分类任务的交叉熵损失:几乎所有分类模型(ResNet 图像分类、BERT 文本分类、GPT 语言模型)都用交叉熵作为损失函数。它是 softmax 输出与负对数似然的完美结合。交叉熵的梯度恰好是 ,形式简洁且数值友好。详见损失函数、反向传播。
-
VAE 的变分下界(ELBO):变分自编码器的损失函数由重构项(交叉熵/负对数似然)和 KL 散度项组成,KL 项迫使近似后验接近先验分布,是正则化的信息论表述:
从速率-失真理论看:第一项是失真(重构质量),第二项是速率(隐空间复杂度)。-VAE 通过引入权重 显式控制这一权衡—— 越大,隐空间越紧凑(高压缩),但重构越粗糙。详见变分自编码器、贝叶斯推断。
-
知识蒸馏:让小模型(学生)模仿大模型(教师)的输出概率分布(“暗知识”或 soft targets),通过最小化两者输出间的 KL 散度实现模型压缩。温度参数 控制了”暗知识”的可见度——高温使分布更平滑,暴露出类别间的相似性关系(如教师模型认为”猫”和”狗”比”猫”和”汽车”更相似)。详见模型蒸馏。
-
特征选择:用互信息衡量特征与标签的相关性,选择信息量最大的特征子集,比纯线性相关方法(如皮尔逊系数)更能捕获非线性依赖。scikit-learn 的
mutual_info_classif是标准工具。 -
信息瓶颈理论:用互信息解释深度神经网络学到了什么——网络在压缩输入信息(减小 )的同时保留与标签相关的信息(维持 ),其中 是中间表示。这一理论在 2017 年 Tishby 等人的论文中引发了”深度学习是否经历压缩阶段”的学术争论。
-
对比学习:SimCLR、MoCo、CLIP 等对比学习方法,其损失函数(InfoNCE)可以被理解为互信息的下界估计——最大化同一样本不同增强视角之间的互信息,同时最小化不同样本之间的互信息。InfoNCE 损失的形式:
其中 是相似度函数, 是温度参数, 是正样本(同一样本的另一视角), 遍历负样本。从信息论看,最小化 InfoNCE 等价于最大化正样本对之间的互信息下界 ( 是负样本数),且 越大下界越紧。
-
语言模型的困惑度(Perplexity):困惑度是交叉熵的指数:。它表示”模型在每个位置平均有多少个等概率的候选词”。PPL 越低,模型对语言的预测越确定。GPT-4 在标准基准上的困惑度远低于早期模型。
-
模型量化与剪枝:将 float32 权重量化为 int8/int4 从信息论看是速率-失真问题——更少比特 = 更低速率,精度损失 = 更高失真。GPTQ、AWQ 等量化算法本质上是在寻找给定速率约束下的最小失真编码。互信息可用于评估剪枝后模型的信息保留程度。
-
差分隐私训练:差分隐私(Differential Privacy, DP)训练中,隐私预算 与模型输出的互信息 直接相关。信息论为隐私-效用权衡提供了精确的数学框架——更强的隐私保护(更小 )意味着模型输出携带更少的训练数据信息,但也限制了模型的学习能力。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
torch.nn.functional.cross_entropy | Python | PyTorch 交叉熵损失,内含数值稳定的 LogSoftmax + NLL |
torch.nn.KLDivLoss | Python | PyTorch KL 散度损失,用于知识蒸馏、VAE 等 |
torch.nn.CrossEntropyLoss(label_smoothing=) | Python | PyTorch 内置标签平滑的交叉熵 |
scipy.stats.entropy | Python | SciPy 信息熵计算,支持任意离散分布 |
scipy.special.kl_div | Python | SciPy 逐元素 KL 散度,需手动求和 |
sklearn.feature_selection.mutual_info_classif | Python | scikit-learn 互信息特征选择,适用于分类任务 |
sklearn.feature_selection.mutual_info_regression | Python | scikit-learn 互信息特征选择,适用于回归任务 |
numpy(手动实现) | Python | 熵和 KL 散度公式简单,几行 numpy 即可实现 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 自信息 | Self-Information | ,单个事件发生带来的信息量,越罕见信息量越大 |
| 信息熵 | Entropy | 随机变量自信息的期望,衡量平均不确定性或混乱程度 |
| 联合熵 | Joint Entropy | ,两个随机变量作为整体的总不确定性 |
| 条件熵 | Conditional Entropy | $H(X |
| 交叉熵 | Cross-Entropy | ,用分布 编码来自真实分布 的数据时的平均代价 |
| KL 散度 | KL Divergence | 两个分布差异的不对称度量,最小化交叉熵等价于最小化 KL 散度 |
| JS 散度 | JS Divergence | KL 散度的对称化版本,有界,GAN 训练分析的核心度量 |
| Wasserstein 距离 | Wasserstein Distance | 两个分布间的”搬运代价”,分布不重叠时仍连续可导 |
| 互信息 | Mutual Information | ,知道一个变量后另一个变量不确定性的减少量 |
| 微分熵 | Differential Entropy | 连续型随机变量的熵,可以为负,依赖坐标系 |
| 负对数似然 | Negative Log-Likelihood | ,在分类中与交叉熵等价 |
| 极大似然估计 | Maximum Likelihood Estimation | 选择使观测数据出现概率最大的参数,等价于最小化交叉熵 |
| 困惑度 | Perplexity | ,交叉熵的指数化,语言模型标准评估指标 |
| 信息瓶颈 | Information Bottleneck | 用互信息描述网络学习目标的框架:压缩输入、保留标签信息 |
| 数据处理不等式 | Data Processing Inequality | 信息经处理不会增加, |
| Fano 不等式 | Fano’s Inequality | 给定互信息时,分类错误率的信息论下界 |
| Jensen 不等式 | Jensen’s Inequality | 凹函数的期望不超过期望的函数值,KL 散度非负性的证明基础 |
| 速率-失真理论 | Rate-Distortion Theory | 在允许一定误差下,表示随机变量所需的最小互信息 |
| 信道容量 | Channel Capacity | 噪声信道可靠传输信息的最大速率 |
| 最大熵原理 | Maximum Entropy Principle | 在满足约束的分布中,熵最大的分布是最无偏的选择 |
- Shannon,「A Mathematical Theory of Communication」(1948):信息论的开山之作,Claude Shannon 在此定义了熵、互信息等核心概念,奠定了数字通信的理论基础。论文清晰而优美,值得每个机器学习从业者阅读。
- Cover & Thomas,「Elements of Information Theory」(2nd Ed., 2006):信息论最权威的教材,覆盖从基本概念到网络信息论的全部内容,是机器学习研究者的标准参考书。
- MacKay,「Information Theory, Inference, and Learning Algorithms」(2003):剑桥大学经典教材,将信息论与机器学习无缝结合,免费在线版可获取,直觉清晰、例题丰富。
- Goodfellow, Bengio & Courville,「Deep Learning」Ch.3 (2016):深度学习圣经的第三章,为机器学习读者精炼了信息论核心概念,重点突出、实用性强。
- Tishby & Zaslavsky,「Deep Learning and the Information Bottleneck Principle」(2017):用信息瓶颈理论解释深度学习的信息流,是”深度学习为什么有效”的前沿理论探索。
- Oord et al.,「Representation Learning with Contrastive Predictive Coding」(2018):提出 InfoNCE 损失,建立了对比学习与互信息估计之间的桥梁。
- Belghazi et al.,「MINE: Mutual Information Neural Estimation」(2018):提出用神经网络估计高维互信息的方法,打破了互信息估计的维度瓶颈。
- Arjovsky, Chintala & Bottou,「Wasserstein GAN」(2017):用最优传输理论取代 KL/JS 散度,从根本上解决了 GAN 训练不稳定的问题。
最新进展(2025-2026)
Section titled “最新进展(2025-2026)”信息论在大模型时代正焕发新的生命力。以下是 2025-2026 年间最值得关注的方向。
1. 信息论视角下的 LLM 缩放律与能力涌现
Section titled “1. 信息论视角下的 LLM 缩放律与能力涌现”2025 年间,研究者从信息论角度重新审视了大语言模型的缩放律(Scaling Laws)和能力涌现(Emergent Abilities)。核心观察是:LLM 的交叉熵损失随参数量和数据量呈幂律下降,而某些能力(如数学推理、代码生成)在损失下降到特定阈值后突然出现。
信息论给出了一个优雅的解释框架:
- 信息瓶颈视角:模型训练前期压缩通用语言模式(减小 ),后期才”解锁”需要精确信息保持的高阶推理能力(维持 )。
- 临界相变假说:DeepMind 的研究提出,涌现能力对应于训练过程中表征空间的信息结构发生相变——互信息 的增长曲线在某点出现拐点,与能力突现的时间点高度吻合。
- Chinchilla 之后的数据效率:2025 年的研究表明,当训练数据量超过模型”信息容量”(与参数量相关的互信息上界)时,边际信息增益急剧递减。这一发现指导了 LLaMA-3、GPT-4o 等模型的”计算最优”训练配比。
2. 神经互信息估计的突破
Section titled “2. 神经互信息估计的突破”深度网络中互信息的精确估计一直是 NP-hard 难题。2025-2026 年出现了重要进展:
- 扩散模型辅助的互信息估计:利用扩散模型(Diffusion Model)的去噪分数匹配(score matching)过程,理论上可以精确估计两个高维随机变量之间的互信息。这一突破来自score-based generative models 与互信息之间的数学等价性——扩散模型学习的是 ,而互信息可以表示为分数函数的积分。这被视为 2025 年最重要的理论突破之一。
- CLUB 及其改进(Contrastive Log-ratio Upper Bound):用一个辅助神经网络来近似互信息的上界,可用于表示学习中做互信息最小化(如解耦表征学习 disentangled representation)。
- 变分互信息估计器(MINE++ / InfoNCE++):2025 年的研究改进了 MINE 和 InfoNCE 的方差和偏差问题,使互信息下界估计更紧、更稳定,直接影响对比学习的训练效率。
- 可微互信息:一批新工作使互信息估计完全可微分,可以直接嵌入端到端训练管道,用于信息瓶颈正则化、隐私约束优化等场景。
3. 信息论驱动的 LLM 推理加速与压缩
Section titled “3. 信息论驱动的 LLM 推理加速与压缩”2025-2026 年,信息论工具直接推动了 LLM 推理效率的飞跃:
- Speculative Decoding 的信息论最优性:投机解码(Speculative Decoding)利用小模型快速生成候选 token、大模型验证。从信息论看,这利用了文本的条件熵冗余——许多 token 的条件熵极低(几乎确定),小模型已足够;只有高熵 token 才需要大模型。2025 年的理论工作证明了 Speculative Decoding 在给定小模型质量下的最优加速比上界。详见投机解码。
- 基于算术编码的 LLM 压缩:Meta 和 Google 的工作表明,大语言模型的权重和激活可以用信息论最优的算术编码大幅压缩,理论上达到分布的熵率下界(entropy rate)。实践中,4-bit 量化(如 GPTQ、AWQ)已被证明接近 float32 信息熵的下限——进一步压缩的边际收益急剧递减。
- Token 级困惑度作为数据质量筛选标准:在 LLM 训练数据清洗中,一个 token 的困惑度可以用来判断它是否”意外”——困惑度过高(信息量极大)的 token 可能是噪声或标注错误,困惑度过低则信息冗余。这一原则被广泛用于 2025 年的数据筛选管道(如 FineWeb、RedPajama v2)。
- 熵感知采样(Entropy-Aware Sampling):2025 年提出的新解码策略根据每步预测的熵动态调整采样策略——高熵位置使用 top-p/nucleus sampling 保持多样性,低熵位置使用 greedy decoding 保证确定性。这比固定温度采样在生成质量和多样性之间取得了更优平衡。
4. 生成模型评估的新信息论指标
Section titled “4. 生成模型评估的新信息论指标”GAN 时代用 JS 散度和 Inception Score 评估生成质量,但在扩散模型时代这些指标已不适用:
- 最优传输(Optimal Transport)与 Wasserstein 距离:2025 年的研究提出了基于最优传输的新评估框架,直接在样本空间计算 Wasserstein 距离(而非特征空间),消除了 Inception-V3 特征的偏差。Sliced Wasserstein Distance 因其计算效率成为大规模评估的首选。
- 互信息语义保真度:基于互信息的指标衡量生成样本与文本条件之间的语义一致性,比 CLIP Score 更全面。CLIP Score 本质上是图像-文本跨模态互信息的近似,但 2025 年的工作用更精确的神经互信息估计器取代了 CLIP 的简估计。
- Fréchet 距离的信息论推广:FID(Fréchet Inception Distance)假设特征服从高斯分布,2025 年的研究用基于熵和互信息的非参数度量取代高斯假设,在扩散模型评估中更准确。
5. 信息论与 AI 安全
Section titled “5. 信息论与 AI 安全”信息论正成为 AI 安全研究的核心工具:
- 记忆化(Memorization)的信息论度量:用互信息 量化模型记住了多少训练数据——这是隐私泄露风险的直接度量。2025 年的研究表明,大语言模型记忆训练数据的信息量与模型规模呈对数增长(而非线性),为差分隐私(Differential Privacy)训练提供了理论指导:适当规模 + DP-SGD 可以在效用和隐私间取得良好平衡。
- 水印(Watermarking)的信息论极限:在 LLM 输出中嵌入水印(如 Google 的 SynthID),本质上是在不显著增加困惑度的前提下注入可检测的统计信号——这是一个经典的信道容量问题。2025 年的工作给出了水印容量(watermark capacity)与检测可靠性之间的理论下界,证明了在给定文本质量约束下的最大可嵌入信息量。SynthID-2 进一步利用了信息论编码(类似 LDPC 码)来提高水印鲁棒性。
- 越狱攻击(Jailbreak)的信息论分析:2025 年的研究用互信息分析越狱攻击为何有效——攻击 prompt 通过精心构造使模型输出与原始安全约束之间的互信息最小化,绕过了对齐训练中学到的安全策略。
6. 大模型训练中的熵动态监控
Section titled “6. 大模型训练中的熵动态监控”2025-2026 年的工程实践表明,监控训练过程中模型输出分布的熵(entropy dynamics)是发现训练异常的有效手段:
- 训练崩溃(Training Collapse)前兆:输出熵突然下降意味着模型变得过度自信——这通常是训练崩溃的前兆。主流训练框架(DeepSpeed、Megatron-LM、Nanotron)已内置熵监控仪表盘。
- 模式坍塌(Mode Collapse):在生成模型训练中,熵异常波动是模式坍塌的信号。
- 数据混合比例的熵优化:2025 年的研究发现,训练数据中不同领域(代码、数学、自然语言)的混合比例会影响模型输出分布的熵。通过监控验证集上各领域的条件熵,可以动态调整数据混合比例,使模型在所有领域保持合理的不确定性——这成为了 LLaMA-3、Qwen-2.5 等模型的关键训练技术。详见分布式训练、DeepSpeed 与 FSDP。
7. 最大熵原理与 LLM 后训练(RLHF / DPO)
Section titled “7. 最大熵原理与 LLM 后训练(RLHF / DPO)”在 LLM 的对齐阶段,信息论发挥着隐性但关键的作用:
- KL 约束防止奖励黑客:RLHF 的目标函数中显式包含一个 KL 惩罚项 ,防止微调后的策略偏离参考模型太远。这个 KL 项的作用是:(1) 保持输出多样性(防止熵崩塌);(2) 防止奖励黑客(reward hacking,模型钻奖励函数的空子);(3) 维持通用能力(防止对齐税 alignment tax)。KL 权重直接控制了模型行为的”保守程度”。
- DPO 的信息论本质:直接偏好优化(DPO)可以推导为在一个隐式 KL 约束下的奖励最大化。DPO 的损失函数隐含地保持了策略与参考模型之间的信息距离。从信息论看,DPO 等价于最小化偏好数据上的交叉熵加上一个自适应的 KL 正则项。详见强化学习与 RLHF。
- GRPO 的熵正则化:2025 年 DeepSeek 提出的 GRPO(Group Relative Policy Optimization)在 RLHF 中引入了显式的熵奖励项,鼓励模型保持探索性(高熵策略),避免策略过早收敛到次优的确定性输出。这一信息论正则化在数学推理任务上取得了显著效果——DeepSeek-R1 的推理能力部分归功于此。
8. 多模态信息论
Section titled “8. 多模态信息论”2025 年,多模态大模型(GPT-4o、Gemini、Claude 3.5)的兴起催生了跨模态信息论研究:
- 跨模态对齐的互信息最大化:CLIP 等模型通过最大化图像-文本对的互信息实现跨模态对齐。2025 年的理论工作给出了多模态场景下互信息估计的样本复杂度界——模态越多(图像+文本+音频+视频),所需训练数据呈对数增长,这解释了为什么多模态模型需要海量数据。
- 模态间的信息瓶颈:研究表明,不同模态携带的语义信息有显著冗余(如”一只猫”的图片和文字描述大部分信息重叠)。最优多模态融合策略应去除冗余信息(减小模态间互信息),保留互补信息(维持条件互信息)。这为多模态 Transformer 的架构设计提供了理论指导。
- Tokenization 的信息效率:将图像/音频/视频转化为离散 token(如 VQ-VAE 的量化过程)本质上是一个速率-失真问题。2025 年的研究给出了给定 token 词汇表大小下的最优量化方案,直接指导了多模态 tokenizer 的设计。