
句子嵌入模型
句子嵌入模型(Sentence Embedding Model)把一整句话映射为一个稠密向量,使得语义相近的句子在向量空间中距离也相近——它是语义搜索、RAG 检索增强生成和文本去重等任务的基础设施。与侧重嵌入全景概览的嵌入模型一页不同,本页深入聚焦句子嵌入的架构设计(Siamese 双塔)、训练方法(对比学习与难负样本挖掘)、现代模型对比(E5/BGE/GTE/NV-Embed)、指令微调嵌入、Matryoshka 自适应维度以及 MTEB 评测基准。前置阅读:损失函数中的 InfoNCE 与 Triplet Loss 部分。
把每一句话映射到一个”语义 GPS 坐标”——意思越接近的两个句子,坐标靠得越近;意思毫不相关,坐标相隔很远。有了坐标,语义相似度就变成了简单的数学距离计算。
- 为什么不能直接用 BERT 的 [CLS]:原始 BERT 只训练了”预测被遮挡的词”和”判断下一句是否相连”,它的 [CLS] 向量从来没有被显式训练去衡量”两句话到底有多像”。直接拿来做语义相似度,效果跟随机向量差不多——你需要专门拿相似度任务来”教会”它。
- Sentence-BERT(双塔)= 给句子造一座”标准化加工厂”。两句话分别进各自的加工流水线(同一套权重,所以叫 Siamese 孪生塔),各自出厂一个标准化的坐标向量,然后比一比两个坐标有多近。关键在于两句话各走各的、互不串门(没有 cross-attention),所以可以提前把所有文档的坐标算好存起来,查询时只算一次查询句的坐标再去比对——效率极高。
- 对比训练= 教模型”谁跟谁是一伙的”。把语义相近的句子坐标拉到一起(正样本对),把不相关的推开(负样本对)。就像训练一个人区分双胞胎:反复给他看”这两张是同一个人""那两张不是”,看着看着他就学会抓关键特征了。
- 难负样本= 专挑”长得像但确实不是”的样本当反例来练。比起随便找一个八竿子打不着的反例,这种”差点就认错”的样本最能逼模型练出真本事。
- 指令微调= 同一句话在不同任务下应该有不同的坐标。比如”如何做红烧肉”这句话,在”找菜谱”任务里要跟菜谱文档靠近,在”判断是否垃圾信息”任务里则要跟正常内容靠近——给模型一个任务指令前缀,让它知道当前是在干什么。
- Matryoshka 嵌入(套娃嵌入)= 像”俄罗斯套娃”一样,一个大向量里嵌套着多个不同粒度的小向量。截取前 256 维就能用,截取前 768 维更精准——一次编码,按需取用,兼顾存储和精度。
为什么不能直接用 BERT 的 [CLS] 向量
Section titled “为什么不能直接用 BERT 的 [CLS] 向量”BERT(Devlin et al., 2018)的训练目标是掩码语言模型(MLM,Masked Language Modeling,即随机遮挡部分词让模型猜)和下一句预测(NSP,Next Sentence Prediction),这两个任务都不涉及”衡量两句话语义相似度”。实验表明,直接用 BERT 的 [CLS] 向量计算余弦相似度,效果甚至不如 2014 年平均词向量(GloVe average)的基线——语义相似的句子向量之间没有明显的靠近趋势。
更糟糕的是,如果想让 BERT 判断两句话相似度,只能把两句话拼成 “[CLS] 句子A [SEP] 句子B [SEP]” 一起送进去做 cross-attention(交叉注意力,即两句话的每个词都跟另一句话的每个词做注意力交互)。这样在约 10,000 个句对的语料上找最相似句时,需要做约 5000 万次 BERT 前向传播(在 V100 GPU 上约 65 小时),完全不可用。
Sentence-BERT(Reimers & Gurevych, 2019)正是为了解决这两个问题而提出的。
Sentence-BERT:Siamese 双塔架构
Section titled “Sentence-BERT:Siamese 双塔架构”SBERT 的核心架构是”孪生网络(Siamese Network,源自暹罗双胞胎,指两个网络共享同一套参数)“——两个共享权重的 BERT 编码器分别处理两个句子:
- 句子 A 送入编码器,输出一组 token 向量,经池化得到固定长度的句子向量 u。
- 句子 B 送入同一个编码器(权重完全相同),同样池化得到向量 v。
- 用余弦相似度、欧氏距离或点积计算 u 和 v 的相似度。
关键点在于:两个句子独立编码,之间没有 cross-attention 交互。这意味着句子 B 无论和谁配对比较,它的向量 v 都是一样的——因此可以把语料库中所有句子的向量预先计算并缓存。查询时只需对查询句编码一次,再用向量相似度搜索在毫秒级返回结果。同样的 10,000 句语料,SBERT 在 V100 上编码约 5 秒,用余弦相似度比较约 0.01 秒——比原始 BERT 快上万倍。
BERT 输出的是一组 token 向量(序列中每个 token 对应一个向量),需要把它们聚合为一个句子向量,这就是池化(Pooling):
- Mean Pooling(平均池化):取所有 token 向量的逐维平均。最常用、效果最稳定,SBERT 论文的默认选择。它充分利用了所有 token 的信息,相当于让整句话的每个词都贡献一份语义。数学表达:,其中 是第 个 token 的输出向量, 是 token 数量。
- Max Pooling(最大池化):在每个维度上取所有 token 向量的最大值:。倾向于捕捉最显著的特征,在某些任务上对关键词更敏感,但容易受噪声 token 干扰。
- CLS Pooling([CLS] 池化):直接取 [CLS] token 的输出向量:。实现最简单,但效果通常不如 mean pooling——因为 [CLS] 的表示需要额外训练才能承载整句语义,而对比训练之前的 [CLS] 并不具备这种能力。
- Last-Token Pooling(末 token 池化):取序列最后一个 token 的输出向量。这是 decoder-only 模型(如 LLaMA、Qwen 等 Generative LLM 改做的嵌入模型)的标准做法——因为因果注意力(causal attention,每个 token 只能看到自己和之前的 token)下,最后一个 token”看过”了整句话。
实践中,encoder 模型首选 mean pooling,decoder 模型用 last-token pooling;部分模型(如 BGE)在 mean pooling 基础上额外做 L2 归一化,效果更好。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as npfrom sklearn.datasets import make_blobsfrom sklearn.decomposition import PCA
np.random.seed(42)
# Simulate 4 semantic clusters in 768-dim spaceX, y = make_blobs(n_samples=400, n_features=768, centers=4, cluster_std=3.5, random_state=42)topic_labels = ["Technology & AI", "Sports & Fitness", "Food & Cooking", "Travel & Places"]colors = ["#2196F3", "#4CAF50", "#FF9800", "#e91e63"]markers = ["o", "s", "^", "D"]
# PCA to 2DX_2d = PCA(n_components=2).fit_transform(X)# Simulate "untrained" embeddings with noiseX_noisy_2d = PCA(n_components=2).fit_transform(X + np.random.randn(*X.shape) * 5)
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(13, 5.5))fig.patch.set_facecolor("white")
for i, (label, color, marker) in enumerate(zip(topic_labels, colors, markers)):    mask = y == i    ax1.scatter(X_noisy_2d[mask, 0], X_noisy_2d[mask, 1], c=color, marker=marker,                s=30, alpha=0.6, edgecolors="white", linewidths=0.3, label=label)    ax2.scatter(X_2d[mask, 0], X_2d[mask, 1], c=color, marker=marker,                s=30, alpha=0.7, edgecolors="white", linewidths=0.3, label=label)
ax1.set_title("Before Training\n(Random Embeddings, PCA to 2D)", fontsize=11, fontweight="bold")ax2.set_title("After Contrastive Training\n(Trained Embeddings, PCA to 2D)", fontsize=11, fontweight="bold")for ax in [ax1, ax2]:    ax.set_xlabel("PC1", fontsize=10); ax.set_ylabel("PC2", fontsize=10)    ax.legend(fontsize=8, loc="upper right", framealpha=0.9)    ax.grid(True, alpha=0.15, linestyle="--")
plt.suptitle("Sentence Embedding Space: Semantic Clustering via Contrastive Learning",             fontsize=13, fontweight="bold", y=1.02)plt.tight_layout()plt.savefig("/mnt/kvm_ata-Netac_SSD_480GB_AA000000000000000904-part1/proj/docs/img/generated/embedding-pca-2d.png",            dpi=180, bbox_inches="tight", facecolor="white")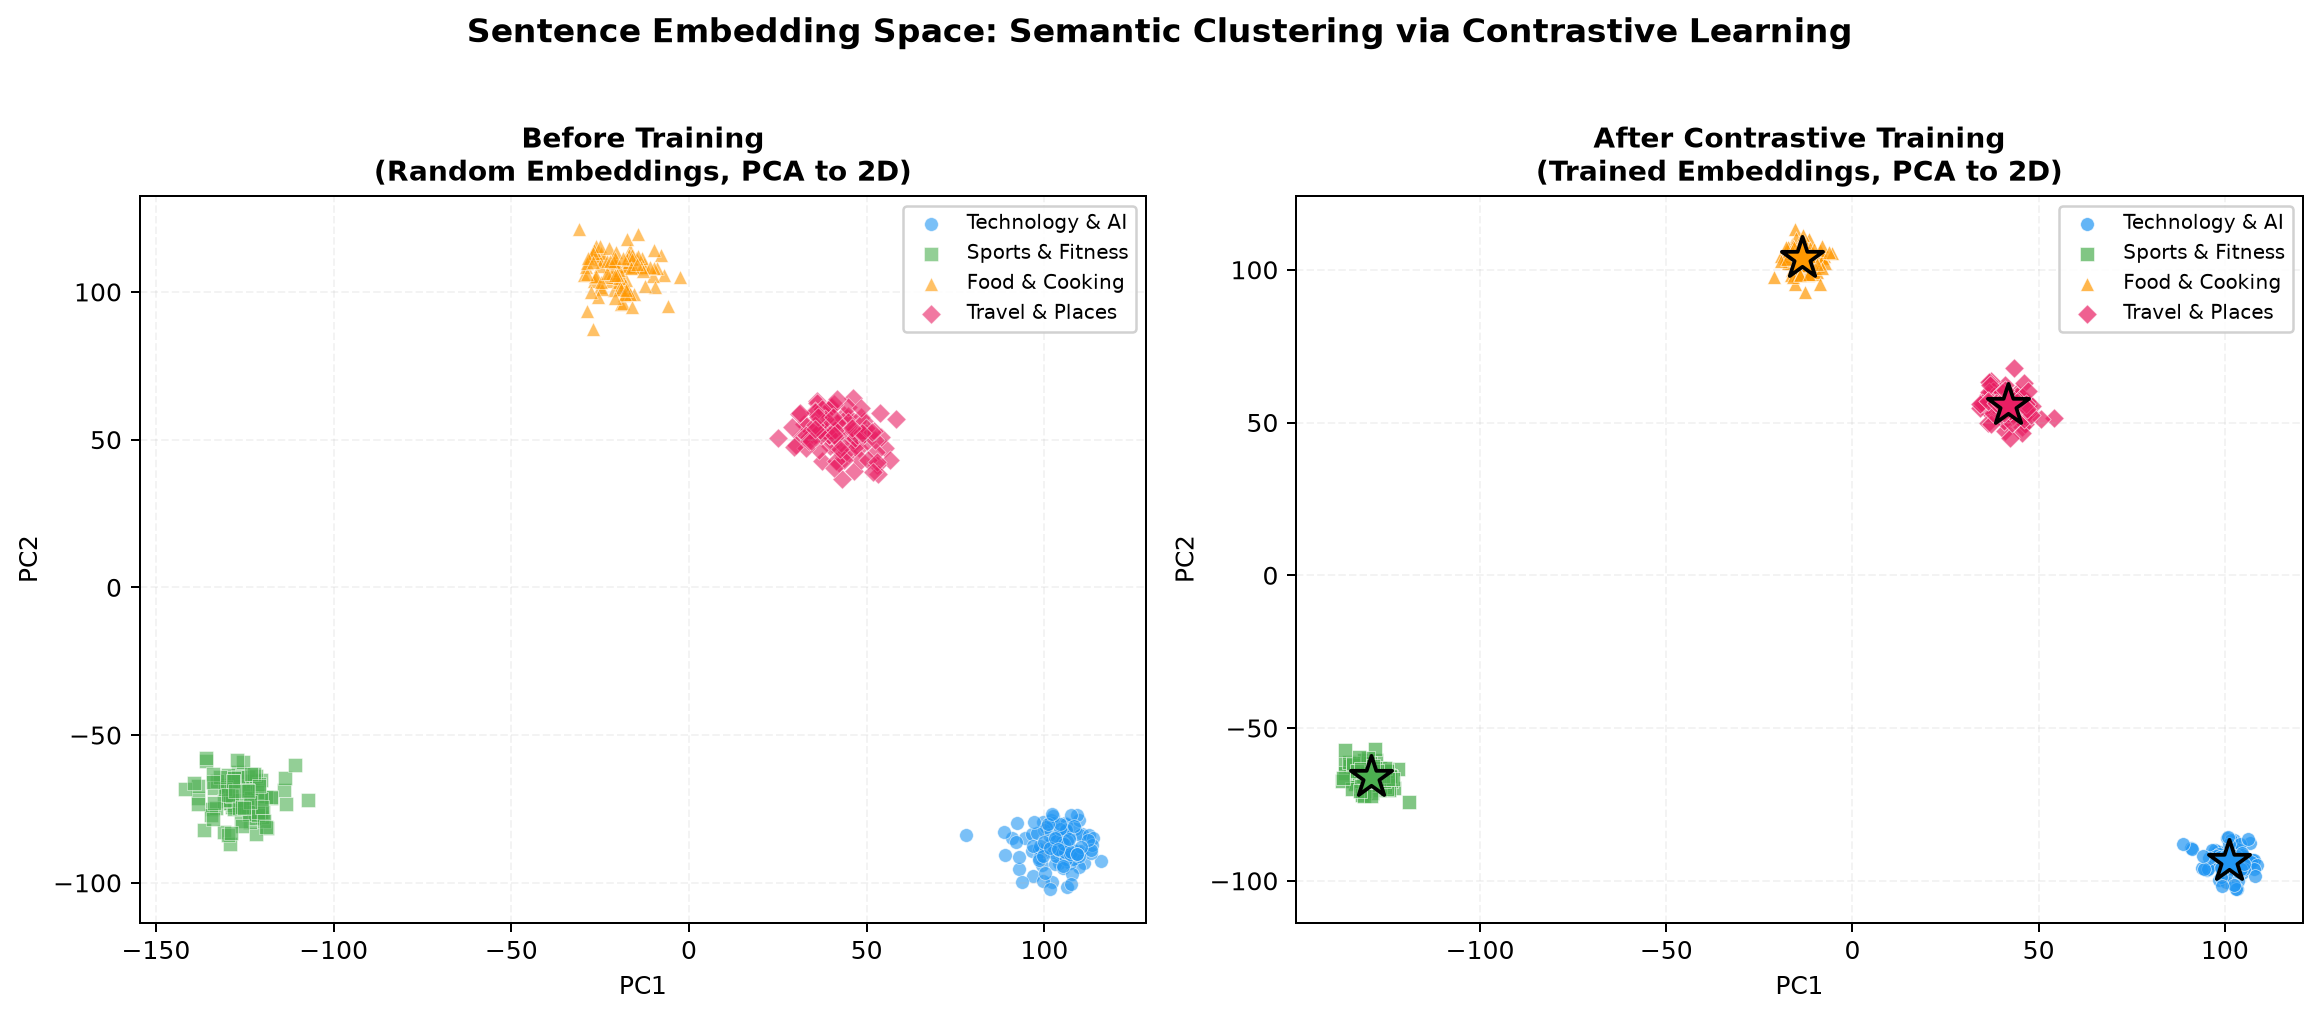
L2 归一化与余弦相似度的关系
Section titled “L2 归一化与余弦相似度的关系”在计算相似度之前,通常对向量做 L2 归一化(normalization):,其中 。
归一化后,余弦相似度(Cosine Similarity)退化为点积(Dot Product / Inner Product):
因为归一化后 ,分母恒为 1。这意味着:
- 存储时归一化:向量入库前统一做 L2 归一化,之后只需用更快的内积(IP, Inner Product)计算就能得到余弦相似度——少一次除法运算,在百万级向量检索中速度优势显著。
- 几何直觉:归一化把所有向量”投影”到单位超球面(unit hypersphere)上,向量不再是任意长度的”射线”,而是球面上的一个点。相似度就是两点之间的夹角余弦——方向一致=相似=1,正交=无关=0,方向相反=0。
对比训练:InfoNCE 损失
Section titled “对比训练:InfoNCE 损失”SBERT 原始论文根据任务用了不同的损失函数:分类任务用 softmax 交叉熵,STS(Semantic Textual Similarity,语义文本相似度)任务用余弦相似度 + 均方误差。但现代句子嵌入模型几乎统一采用**对比学习(Contrastive Learning)**框架,核心损失是 InfoNCE(详见损失函数的 InfoNCE 小节)。
InfoNCE(Info Noise-Contrastive Estimation,信息噪声对比估计)的直觉是”在一堆候选中把正确的正样本挑出来”,可以理解为多分类问题(类别数 = 负样本数 + 1):
其中:
- 是查询(anchor / 锚点)的句子向量
- 是正样本(与 语义相似)的向量
- 遍历所有候选(包括正样本 和全部 个负样本)
- 是相似度函数(通常用余弦相似度或点积)
- 是温度参数(temperature),控制分布的锐度
逐项拆解这个公式:
- 分子 :正样本与查询的相似度越高,这个值越大。
- 分母 :所有候选(含正样本和负样本)的相似度”权重”之和。
- 整个分数 :正样本在所有候选中”胜出”的概率——取值 0 到 1。
- 外层 :取负对数。概率越接近 1,损失越接近 0;概率越接近 0,损失趋向无穷大——这就是模型”犯错时受到惩罚”的来源。
越小,模型对正负样本的区分要求越苛刻(梯度集中在最难的样本上); 越大,分布越平滑、训练越稳定但判别力弱。典型取值在 0.01 到 0.05 之间(CLIP 用 0.07 经可学习缩放)。
负样本来源通常是同一个 batch 中的其他句子(in-batch negatives,批内负样本)——batch 越大,负样本越多,模型学得越好。这也是为什么训练嵌入模型要用超大 batch(如 SimCLR 用 4096)。
AnglE 损失:2024 年的研究(Li & Li, “AnglE: Angelically Optimized Contrastive Learning”)指出,当余弦相似度接近 1 时,InfoNCE 的余弦梯度会趋近于零(梯度消失),模型很难继续优化。AnglLE 在 InfoNCE 基础上额外加入了一项基于角度的损失来缓解这个问题,已被多个 2025 年新模型采用。
难负样本挖掘(Hard Negative Mining)
Section titled “难负样本挖掘(Hard Negative Mining)”随机采样的负样本往往与查询”一眼就能看出无关”,模型不需要费力就能区分,学不到东西。**难负样本(Hard Negative)**指的是”看起来有点相关、但实际上不应被召回”的样本。
例如查询是”如何训练句子嵌入模型”:
- 正样本:“Sentence-BERT 的对比训练方法”
- 随机负样本:“今天北京下雪了”(太容易,模型随便就能区分)
- 难负样本:“BERT 的掩码语言模型预训练”(跟查询有很多词重叠、话题也沾边,但回答的并不是”如何训练嵌入模型”)
难负样本的获取方法:
- BM25 难负样本:用 BM25(Best Matching 25,一种基于词频的经典稀疏检索算法)召回与查询词面重叠度高但相关性低的文档——这些是”字面相似但语义不匹配”的典型样本。
- 模型挖掘(model-based mining):用当前版本的嵌入模型召回 Top-K 结果,剔除已标注的正样本后,排在靠前位置的就是模型最容易搞混的难负样本。Anthropic、Cohere 的嵌入模型训练都大量使用这种方法。
- 交叉编码器标注:用一个强 cross-encoder 给候选对打分,选出”分数中等偏低”的——既不是明显正样本也不是明显无关,最有训练价值。
加入难负样本能显著提升模型在困难场景下的判别力,是 BGE、E5 等现代模型成功的关键技巧之一。详见检索方法中关于混合检索的讨论。
E5 / BGE / GTE / NV-Embed 模型对比
Section titled “E5 / BGE / GTE / NV-Embed 模型对比”当前开源句子嵌入模型的四大主力系列(截至 2025 年):
| 维度 | E5 / GTE(微软/阿里) | BGE(智源 BAAI) | NV-Embed(NVIDIA) | Stella / Qwen3-Embedding |
|---|---|---|---|---|
| 全称 | EmbEddings from bidirectional Encoder / General Text Embeddings | BAAI General Embedding | NVIDIA Embedding | Stella / 通义千问嵌入 |
| 训练数据 | 约 2-8 千万文本对 | 约 1 亿中英文文本对(Wudao 等) | 合成数据 + 多阶段对比学习 | 大规模多语言+合成数据 |
| 训练方法 | 两阶段:弱监督对比预训练 + 有监督微调 | 多阶段:对比预训练 + 难负样本微调 + 指令微调 | decoder-only + 潜在注意力层 + 两阶段 NEFT | 多阶段对比学习 + 指令微调 |
| 基座架构 | 纯编码器(仅 attention 层,不含前馈层) | BERT / XLM-RoBERTa 编码器 | Mistral-7B(decoder-only LLM) | Qwen2/Qwen3 decoder-only |
| 嵌入维度 | small 384 / base 768 / large 1024 | small 384 / base 768 / large 1024 | 4096(支持 Matryoshka 截断) | 1024-4096(支持 Matryoshka) |
| 最大输入 | 512 token | 512 token(BGE-M3 支持 8192) | 32768 token | 32768 token |
| 中文效果 | 良好 | 顶尖(MTEB 中文榜首常客) | 英文顶尖 | 中文顶尖(Qwen3 系列) |
| 多语言 | E5-multilingual 支持 100+ 语言 | BGE-M3 支持 100+ 语言 | 英文为主 | 多语言支持强 |
| 指令微调 | E5-instruct 支持任务指令 | BGE 支持查询前缀指令 | 支持任务指令 | 支持任务指令 |
| 池化方式 | 末层 mean pooling | 末层 mean pooling + L2 归一化 | last-token pooling + 归一化 | last-token pooling |
| 许可证 | MIT(开源可商用) | MIT(开源可商用) | NVIDIA Open Model License | Apache 2.0 / MIT |
2024-2025 年的重要趋势——从 encoder 到 decoder:传统的句子嵌入模型几乎都基于 BERT 等 encoder-only 架构。但 NV-Embed-v2(NVIDIA, 2024)证明了:把 Mistral-7B 这类大型 decoder-only LLM 改造成嵌入模型,在 MTEB 英文排行榜上能取得 72.31 分的历史最高分(截至 2025 年初)。Qwen3-Embedding(阿里,2025)同样采用 decoder-only 架构,在中文和多语言任务上表现优异。这一趋势的核心原因是:decoder LLM 经过海量文本预训练,语义理解能力远超小 encoder,只需少量对比训练就能”解锁”嵌入能力。
选型经验:纯中文场景 BGE(BAAI/bge-large-zh)或 Qwen3-Embedding 效果最好;英文场景 NV-Embed、E5、GTE、BGE 都很强;需要长文档(超过 512 token)推荐 BGE-M3(支持 8192 token)或 Qwen3-Embedding(支持 32768 token);需要多语言选 E5-multilingual 或 BGE-M3。
指令微调嵌入(Instruction-Tuned Embedding)
Section titled “指令微调嵌入(Instruction-Tuned Embedding)”传统嵌入模型是无状态的:同一句话无论在什么任务下,生成的向量都一样。但实际中,“相似”的定义因任务而异——检索时”相似”指可回答查询,聚类时”相似”指话题一致,去重时”相似”指几乎重复。
指令微调嵌入的思路是:在文本前拼接一段任务指令,让模型感知当前任务。例如 E5-instruct 的查询侧指令:
Represent this sentence for searching relevant passages: 如何训练句子嵌入模型同一句”如何训练句子嵌入模型”,加检索指令和加聚类指令后生成的向量会不同——模型学会了”任务语境”。这大大提升了同一模型在多任务上的通用性。BGE 系列虽然没有显式指令文本,但要求查询侧加固定前缀(如”为这个句子生成表示用于检索相关文章:”),也是一种轻量级的指令机制。
2025 年的 Qwen3-Embedding 将指令微调推向极致:它在训练时直接用 LLM 合成多样化的”指令-查询-文档”三元组,使得模型能理解非常复杂的自然语言指令,如:
Given a web search query, retrieve passages that answer the query in a scientific mannerMatryoshka 嵌入:自适应维度(2024-2025 新技术)
Section titled “Matryoshka 嵌入:自适应维度(2024-2025 新技术)”Matryoshka Representation Learning(MRL,套娃表示学习) 由 OpenAI 于 2022 年提出,在 2024-2025 年被广泛集成到主流嵌入模型中(BGE、NV-Embed、jina-embeddings-v3、Qwen3-Embedding 等都支持)。
核心思想:训练时不只优化完整维度(如 768 维)的损失,而是同时优化多个截断维度(如 768、512、256、128、64)的损失:
其中 表示取向量的前 维。这就像俄罗斯套娃——大套娃里装着小套娃,前 256 维已经包含了”粗粒度语义”,前 768 维则叠加了”细粒度语义”。
实际好处:
- 灵活的精度-效率权衡:粗筛阶段只用前 64 维快速检索(内存占用降低 12 倍),精排阶段再用完整 768 维精确排序。
- 一次编码,多场景使用:同一个模型生成的 768 维向量,可以按需截取为不同维度,无需部署多个模型。
- 数学上的保证:因为训练时就优化了所有截断维度,截取后不会出现”重要信息恰好被截掉”的问题。
# Matryoshka 截举示例import numpy as np
full_embedding = np.random.randn(768)  # 假设是模型输出的 768 维向量full_embedding = full_embedding / np.linalg.norm(full_embedding)  # 归一化
# 不同截断维度都需要重新归一化!for dim in [768, 512, 256, 128, 64]: truncated = full_embedding[:dim] truncated = truncated / np.linalg.norm(truncated) # 截取后必须重新归一化 print(f"{dim} 维向量(前5维): {truncated[:5].round(3)}")注意:Matryoshka 截取后必须重新做 L2 归一化,否则余弦相似度计算会出错——这是实际部署中最常见的坑。
MTEB 评测基准
Section titled “MTEB 评测基准”MTEB(Massive Text Embedding Benchmark,大规模文本嵌入基准) 是 HuggingFace 维护的嵌入模型评测基准,也是当前选型最权威的参考。它覆盖 8 类任务、58 个数据集:
- 检索(Retrieval):给定查询,从大规模文档库中召回相关文档——RAG 的核心能力。
- 重排(Reranking):对初步召回的结果做精细化排序,详见重排序。
- 分类(Classification):用嵌入向量做文本分类(通常接一个浅层分类头)。
- 聚类(Clustering):用嵌入向量做主题发现与分组。
- 句子对分类(Pair Classification):判断两句话是否语义等价(如 paraphrase 检测)。
- STS(Semantic Textual Similarity):直接预测两句话的相似度分数(0-5)。
- 摘要(Summarization):衡量生成摘要与参考摘要的语义相似度。
- 比特位检索(Bitext Mining):在平行语料中找到互译的句子对——多语言对齐。
MTEB 提供英文版(52 个数据集)和多语言版(涵盖 112 种语言)。HuggingFace 官方排行榜(MTEB Leaderboard)实时更新,按任务和语言分别排名——选型时应该看与你目标语言和任务最相关的子榜单,而不是只看总分。
2025 年排行榜动态:截至 2025 年初,英文 MTEB 总分榜首被基于大型 decoder LLM 的模型占据(NV-Embed-v2、stella、Qwen3-Embedding-8B 等),72 分以上的模型已不罕见。但在资源受限(CPU 推理、< 1GB 内存)场景下,BGE-small(仅 95MB)仍然是性价比最高的选择。
SBERT 双塔架构
Section titled “SBERT 双塔架构”两句话各自独立编码、池化,得到向量后计算相似度——推理时可以预计算文档侧向量:
对比训练流程
Section titled “对比训练流程”模型在每一批样本中学习”把正样本拉近、把负样本(含难负样本)推远”:
Matryoshka 嵌套结构
Section titled “Matryoshka 嵌套结构”一个 768 维向量中嵌套了多个有效子表示——截取不同前缀维度即可得到不同精度级别的嵌入:
基础:用 sentence-transformers 加载 BGE 模型
Section titled “基础:用 sentence-transformers 加载 BGE 模型”from sentence_transformers import SentenceTransformer, util
# 加载中文嵌入模型(BGE-base,768 维)model = SentenceTransformer("BAAI/bge-base-zh-v1.5")
# BGE 要求查询侧加前缀指令(文档侧不需要)queries = ["为这个句子生成表示用于检索相关文章:如何训练句子嵌入"]docs = ["Sentence-BERT 用对比学习训练句子向量", "今天北京气温骤降"]
# 生成嵌入向量(normalize=True 对向量做 L2 归一化)q_emb = model.encode(queries, normalize_embeddings=True)d_emb = model.encode(docs, normalize_embeddings=True)
# 归一化后余弦相似度 = 点积,值域 0~1scores = util.cos_sim(q_emb, d_emb)print(f"与文档0相似度: {scores[0][0]:.3f}") # 约 0.8(语义相关)print(f"与文档1相似度: {scores[0][1]:.3f}") # 约 0.3(语义无关)进阶:从零实现对比训练 + InfoNCE 损失
Section titled “进阶:从零实现对比训练 + InfoNCE 损失”以下代码完整演示了如何用 PyTorch 手动实现一个最小化的句子嵌入训练流程,帮助理解 InfoNCE 的内部机制:
import torchimport torch.nn as nnimport torch.nn.functional as F
class SimpleSentenceEmbedder(nn.Module):    """最简化的句子嵌入模型:embedding 查表 + mean pooling。"""
    def __init__(self, vocab_size: int, embed_dim: int = 128):        super().__init__()        # 词嵌入层:每个词映射为一个 embed_dim 维向量        self.embeddings = nn.Embedding(vocab_size, embed_dim, padding_idx=0)
    def forward(self, input_ids: torch.Tensor, attention_mask: torch.Tensor):        """        input_ids: [batch_size, seq_len] —— 每句话的 token ID 序列        attention_mask: [batch_size, seq_len] —— 1 表示真实 token,0 表示 padding        """        # 查表得到词向量 [batch, seq_len, embed_dim]        token_vecs = self.embeddings(input_ids)
        # 扩展 mask 以便逐元素相乘 [batch, seq_len, 1]        mask = attention_mask.unsqueeze(-1).float()
        # Mean Pooling:只对真实 token 取平均(忽略 padding)        masked_vecs = token_vecs * mask        sentence_vecs = masked_vecs.sum(dim=1) / mask.sum(dim=1).clamp(min=1e-9)
        # L2 归一化:把向量投影到单位球面        sentence_vecs = F.normalize(sentence_vecs, p=2, dim=1)        return sentence_vecs

def info_nce_loss(query_vecs: torch.Tensor,                  positive_vecs: torch.Tensor,                  temperature: float = 0.05) -> torch.Tensor:    """    InfoNCE 损失,使用 in-batch negatives。    query_vecs:     [batch_size, embed_dim] —— 查询向量(已归一化)    positive_vecs:  [batch_size, embed_dim] —— 正样本向量(已归一化)    """    batch_size = query_vecs.size(0)
    # 计算所有 query 和所有 positive 之间的相似度矩阵 [batch, batch]    # sim_matrix[i][j] = 第 i 个查询与第 j 个正样本的余弦相似度    sim_matrix = query_vecs @ positive_vecs.T  # 归一化后点积 = 余弦相似度
    # 对角线上 sim_matrix[i][i] 是第 i 个查询自己的正样本(正确匹配)    # 其余位置 sim_matrix[i][j] (i≠j) 都是 in-batch 负样本
    # 缩放(温度参数):除以 tau 使分布更尖锐    logits = sim_matrix / temperature
    # 本质是一个 batch_size 类的分类问题:每个查询要"认出"自己的正样本    labels = torch.arange(batch_size, device=query_vecs.device)
    # 交叉熵损失:对每个查询,让对角线位置(正样本)的 logit 最大    loss = F.cross_entropy(logits, labels)    return loss

# --- 训练循环示例 ---vocab_size = 10000embed_dim = 128model = SimpleSentenceEmbedder(vocab_size, embed_dim)optimizer = torch.optim.AdamW(model.parameters(), lr=2e-4)
for step in range(100):    # 模拟一个 batch 的数据(实际中从数据加载器获取)    batch_size = 32    seq_len = 16    query_ids = torch.randint(1, vocab_size, (batch_size, seq_len))    query_mask = torch.ones(batch_size, seq_len)    positive_ids = torch.randint(1, vocab_size, (batch_size, seq_len))    positive_mask = torch.ones(batch_size, seq_len)
    # 前向传播    q_vecs = model(query_ids, query_mask)    p_vecs = model(positive_ids, positive_mask)
    # 计算 InfoNCE 损失    loss = info_nce_loss(q_vecs, p_vecs, temperature=0.05)
    # 反向传播 + 更新参数    optimizer.zero_grad()    loss.backward()    optimizer.step()
    if step % 20 == 0:        print(f"Step {step}, Loss: {loss.item():.4f}")
Matryoshka 截断检索实践
Section titled “Matryoshka 截断检索实践”import numpy as npfrom sentence_transformers import SentenceTransformer
# 加载支持 Matryoshka 的模型(jina-embeddings-v3、BGE 等均支持)model = SentenceTransformer("jinaai/jina-embeddings-v3")
# 示例:对一批文档做嵌入docs = [ "Sentence-BERT 用对比学习训练句子向量", "BERT 通过掩码语言模型预训练", "今天北京气温骤降,需要注意保暖", "对比学习通过拉近正样本、推远负样本来训练",]full_embeddings = model.encode(docs) # [4, 1024] 完整维度
print(f"完整嵌入维度: {full_embeddings.shape}")
# 演示不同截断维度下的检索效果query = model.encode(["如何训练句子嵌入模型"])
for dim in [1024, 512, 256, 128, 64]: # 截取前 dim 维 docs_trunc = full_embeddings[:, :dim].copy() query_trunc = query[:, :dim].copy()
# 截取后必须重新归一化! docs_trunc = docs_trunc / np.linalg.norm(docs_trunc, axis=1, keepdims=True) query_trunc = query_trunc / np.linalg.norm(query_trunc, axis=1, keepdims=True)
# 计算相似度(归一化后点积 = 余弦相似度) scores = query_trunc @ docs_trunc.T top1 = np.argmax(scores[0]) print(f"{dim:4d} 维 → 最相似文档: [{top1}] (score={scores[0][top1]:.3f})")- 池化默认用 mean pooling:这是 SBERT 论文验证过最稳定的策略。如果你在微调自己的嵌入模型,不要轻易换成 CLS pooling,除非有充分实验支持。decoder-only 模型则用 last-token pooling。
- 难负样本数量要克制:一个查询配 3-7 个难负样本通常效果最好,太多(如 50+)反而会让模型过度关注难负样本、忽视正常正样本学习,导致整体召回率下降。
- 温度参数 tau 要调:InfoNCE 的 tau 对效果影响很大。一般从 0.02-0.05 开始试,tau 太大会导致负样本不够被”推开”、tau 太小训练不稳定。SBERT、SimCSE 的经验值可作为起点。
- 指令前缀别漏:BGE 查询侧、E5-instruct、NV-Embed、Qwen3-Embedding 都需要特定前缀指令。生产环境中最常见的”效果莫名变差”原因就是忘了加前缀——务必对照模型文档检查。
- 选型看 MTEB 子榜单:不要只看总分。如果你的任务是中文检索,就看 MTEB-zh 的 Retrieval 子项;如果是聚类,就看 Clustering 子项。不同模型在不同任务上排名差异很大。
- 归一化后再存:嵌入向量存入向量数据库前做 L2 归一化,这样余弦相似度退化为点积,可以用更快的内积索引(如 HNSW + IP)加速检索。
- Matryoshka 截断要重新归一化:截取前 N 维后必须重新计算 L2 范数并归一化,否则相似度计算会出错。
- decoder 嵌入模型的成本权衡:NV-Embed、Qwen3-Embedding-8B 等基于 LLM 的嵌入模型精度顶尖,但推理速度和内存消耗远超 BGE-small。对于百万级文档的 RAG 系统,先用小模型编码文档库、大模型仅编码查询也是可行的混合策略。
- 语义搜索:用户搜”如何提升销量”能召回写着”提高营业额的方法”的文档——不依赖关键词匹配,靠的是语义向量相近。Elasticsearch 8.x、Milvus、Pinecone 都内置了向量检索能力。
- RAG 检索:把知识库文档分块后嵌入向量,用户提问时用查询向量检索最相关的段落喂给 LLM——所有 RAG 产品(如 ChatGPT 文档问答、企业知识库)的核心环节。详见 RAG 检索增强生成。
- 推荐系统:把用户兴趣描述和商品标题都嵌入向量,推荐向量最相似的商品——淘宝的语义搜索、小红书的内容推荐都依赖嵌入。
- 去重与聚类:在海量文档中找出语义重复或近似内容——新闻聚合去重、论文查重、爬虫数据清洗;用 K-means 对嵌入聚类可自动发现主题分组。
- 问答匹配:把用户问题与知识库中的 FAQ 问题做嵌入匹配,找到语义最接近的已有问答——智能客服的第一步。
- 跨语言检索:多语言嵌入模型(如 BGE-M3、E5-multilingual)把不同语言映射到同一向量空间,用中文查询可以直接检索英文文档。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| sentence-transformers | Python | 最流行的句子嵌入库,内置 SBERT、E5、BGE 等数百个预训练模型,一行代码加载 |
| FlagEmbedding | Python | 智源 BGE 系列官方库,支持微调、指令嵌入和难负样本挖掘 |
| HuggingFace Transformers | Python | 底层 Transformer 模型库,可自行加载编码器实现自定义池化策略 |
| Tevatron | Python | 专注于信息检索的嵌入训练框架,支持对比学习和难负样本挖掘 |
| ANCE / Dense trained retrievers | Python | 微软等提出的难负样本挖掘训练框架 |
| MTEB | Python | HuggingFace 官方评测基准库,一键评测嵌入模型在 58 个数据集上的表现 |
| FAISS | Python / C++ | Meta 的高效向量相似度搜索库,配合嵌入向量做毫秒级检索 |
| Milvus / Qdrant / Weaviate | 多语言 | 向量数据库,内置嵌入索引和混合检索能力 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 句子嵌入 | Sentence Embedding | 把一整句话映射为一个固定长度的稠密向量,语义相近则向量相近 |
| 孪生网络 | Siamese Network | 两个共享权重的编码器分别处理两个输入、比较输出的网络结构 |
| 双塔架构 | Bi-Encoder | 两段文本各自独立编码为向量再计算相似度,可预计算、效率高 |
| 交叉编码器 | Cross-Encoder | 两段文本拼接后一起送入编码器做 full attention,精度高但无法预计算 |
| 池化 | Pooling | 把多个 token 向量聚合为一个句向量的操作(mean / max / CLS / last-token) |
| 对比学习 | Contrastive Learning | 通过拉近正样本、推远负样本来训练表示的方法 |
| InfoNCE | InfoNCE Loss | 对比学习核心损失,本质是在正样本与一组负样本中做多分类 |
| 温度参数 | Temperature tau | InfoNCE 中控制相似度分布锐度的超参数,越小判别越苛刻 |
| 难负样本 | Hard Negative | 字面或语义上容易混淆但实际不相关的负样本,比随机负样本更有训练价值 |
| 指令微调嵌入 | Instruction-Tuned Embedding | 嵌入时加入任务指令前缀,使同一文本在不同任务下生成不同向量 |
| Matryoshka 嵌入 | Matryoshka Embedding | 训练时同时优化多个截断维度,使向量可按需截取不同精度级别 |
| L2 归一化 | L2 Normalization | 把向量缩放到单位长度(范数=1),使余弦相似度退化为点积 |
| MTEB | Massive Text Embedding Benchmark | HuggingFace 的嵌入模型评测基准,覆盖 8 类任务 58 个数据集 |
| in-batch negatives | In-batch Negatives | 用同一个 batch 中的其他样本作为负样本,batch 越大负样本越多 |
| 末 token 池化 | Last-Token Pooling | 取序列最后一个 token 的输出作为句子向量,decoder-only 模型的标准做法 |
- Reimers & Gurevych, “Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks” (EMNLP 2019):句子嵌入的里程碑论文,提出 Siamese 双塔架构和池化策略,将语义相似度计算效率提升了上万倍——sentence-transformers 库的基础。
- Gao et al., “SimCSE: Simple Contrastive Learning of Sentence Embeddings” (EMNLP 2021):用 dropout 增广构造正样本的无监督对比学习嵌入方法,刷新了多项 STS 基准,是理解对比训练的最佳入门。
- Wang et al., “Text Embeddings by Weakly-Supervised Contrastive Pre-training” (2022):微软 E5 模型论文,提出弱监督对比预训练 + 有监督微调的两阶段训练方案,是 MTEB 排行榜常客。
- Xiao et al., “C-Pack: Packaged Resources To Advance General Chinese Embedding” (2023):智源 BGE 模型论文,包含 1 亿中文文本对数据集和多阶段训练方法,MTEB 中文榜首。
- Li et al., “Towards General Text Embeddings with Multi-stage Contrastive Learning” (2023):阿里 GTE 模型论文,多阶段对比学习训练通用文本嵌入,多语言和长文本能力强。
- Kusupati et al., “Matryoshka Representation Learning” (NeurIPS 2022):提出 Matryoshka 嵌套表示学习——一个向量同时编码多个精度级别,2024 年被 BGE、jina-embeddings-v3 等主流模型广泛采用。
- Lee et al., “NV-Embed: Improved Techniques for Training LLMs as Generalist Embedding Models” (2024):NVIDIA 的论文,将 Mistral-7B 改造为嵌入模型并在 MTEB 英文榜登顶(72.31 分),是 decoder-only 嵌入模型的代表作。
- Li & Li, “AnglE: Angelically Optimized Contrastive Learning for Sentence Embedding” (ACL 2024):分析了 InfoNCE 在高相似度区的余弦梯度消失问题,提出角度损失来补充,已被多个 2025 年新模型采用。
- Eberhart et al., “MTEB: Massive Text Embedding Benchmark” (EACL 2024):HuggingFace 的嵌入评测基准论文,覆盖 8 类任务 58 个数据集 112 种语言——选型的权威参考。
- Karpukhin et al., “Dense Passage Retrieval for Open-Domain Question Answering” (EMNLP 2020):DPR 论文,首次大规模验证双塔密集检索优于 BM25,是现代 RAG 检索的理论基础。
- Qu et al., “RocketQA: An Optimized Training Approach to Dense Passage Retrieval for Open-Domain Question Answering” (NAACL 2021):系统性地提出了去噪难负样本挖掘和交叉编码器蒸馏,深入理解难负样本训练的必读文献。
- Qwen Team, “Qwen3-Embedding: Advancing Text Embedding and Reranking” (2025):阿里通义千问团队 2025 年最新嵌入模型,采用 decoder-only 架构和大规模合成指令数据,中英文 MTEB 均取得领先成绩。
- Stenner et al., “jina-embeddings-v3: Multilingual Embeddings With Task LoRA” (2024):Jina AI 的 v3 嵌入模型,引入任务级 LoRA 适配器和 Matryoshka 支持,在长文本和多语言场景表现突出。