
训练工程
写出一个模型 forward 只是起点——真正把它”训起来”且训得稳、训得快、训得省显存,靠的是训练工程(Training Engineering)。本页把训练循环的每个工程组件讲透:Dataset/DataLoader、完整训练循环、梯度累积、超参调优、混合精度与梯度检查点、分布式训练(DDP/FSDP/DeepSpeed ZeRO)。前置阅读:PyTorch 入门、梯度下降与优化器、混合精度训练、分布式训练、学习率调度策略。
把训练工程想象成”开一家工厂流水线”:
- Dataset/DataLoader= 原料仓库 + 传送带。仓库负责按索引取货(Dataset),传送带负责打包、排序、按批次送货到车间(DataLoader)。
- 训练循环= 车间的标准作业程序(SOP):取料→加工→检验→调整机器→下一批。每个 epoch 把全部原料跑一遍。
- 梯度累积= 显存太小装不下大订单,就分几次小批量加工,攒够再统一调机——模拟大 batch 效果。
- 超参调优= 找最佳工艺参数(温度、压力、速度)。盲目试错慢,用贝叶斯优化”聪明地猜”。
- 混合精度= 粗加工用半精度(快、省料),关键测量用全精度——在精度与速度间找平衡。
- 梯度检查点= 车间仓库太小放不下所有半成品,就边做边扔、用到时再重算——用算力换显存。
- 分布式训练= 开多家分厂同步生产。数据并行是各做各的零件、最后对账;模型并行是把一台大机器拆开分给多家。
1. Dataset 与 DataLoader 详解
Section titled “1. Dataset 与 DataLoader 详解”PyTorch 的数据加载分两层:
Dataset:定义”如何取一条数据”。你继承它,实现__len__(数据总量)和__getitem__(按下标取一条样本)。DataLoader:定义”如何把数据组成 batch 送往 GPU”。它包装 Dataset,负责批处理、打乱、多进程加载、自动批拼装(collate)。
Dataset 三种形态
Section titled “Dataset 三种形态”from torch.utils.data import Dataset, DataLoaderimport torch
# 1. Map-style Dataset(最常用,支持按下标随机访问)class TextDataset(Dataset): def __init__(self, path): self.samples = [line.strip() for line in open(path)]
def __len__(self): return len(self.samples)
def __getitem__(self, idx): text = self.samples[idx] input_ids = self.tokenize(text) # 自定义分词 label = self.get_label(text) return {"input_ids": input_ids, "label": label}
# 2. IterableDataset(流式,数据太大放不下内存/硬盘时用)class StreamDataset(Dataset): def __init__(self, fileobj): self.fileobj = fileobj def __iter__(self): for line in self.fileobj: yield self.tokenize(line)
# 3. 直接用 TensorDataset(数据已在内存里)ds = torch.utils.data.TensorDataset(X_tensor, y_tensor)大模型场景:预训练语料动辄几百 GB 到几 TB,必须用流式读取(IterableDataset + memory-mapped 文件如
.bin/.npy/webdataset),绝不能一次性load进内存。
DataLoader 的关键参数
Section titled “DataLoader 的关键参数”loader = DataLoader( ds, batch_size=32, shuffle=True, # 训练集打乱,验证集不打乱 num_workers=4, # 多进程预取,加速 I/O pin_memory=True, # 锁页内存,加速 CPU→GPU 传输 drop_last=True, # 丢弃不完整的最后一个 batch(训练时常见,保证 batch 大小一致) collate_fn=custom_fn, # 自定义如何把多条样本拼成 batch)几个容易踩坑的点:
num_workers:设大能并行预取,但太多会耗尽内存、增加进程切换开销。经验值是每 GPU 2–8 个。Windows/Mac 上多进程可能不稳定,调试时先设 0。pin_memory=True:把数据放在锁页内存(Page-Locked Memory)里,GPU 可以用 DMA 直接读取,省一次 CPU 拷贝。几乎总是该开。collate_fn:当样本是变长序列(如文本)时,默认 collate 无法 stack。需自定义:对变长部分 pad 到等长,并返回 attention mask。
# 变长文本的 collate:pad 到 batch 内最大长度def collate_fn(batch): input_ids = [torch.tensor(x["input_ids"]) for x in batch] labels = torch.tensor([x["label"] for x in batch]) # pad_sequence 自动补 0 到等长 input_ids = torch.nn.utils.rnn.pad_sequence(input_ids, batch_first=True, padding_value=0) return input_ids, labelssampler:控制采样顺序。类别不平衡时用WeightedRandomSampler给少数类更高采样权重;分布式训练用DistributedSampler保证各卡数据不重叠。
2. 训练循环的完整实现
Section titled “2. 训练循环的完整实现”一个生产级的训练循环远不止 loss.backward(); optimizer.step()。下面是一个包含梯度裁剪、EMA、梯度累积、checkpoint 的完整骨架:
import torch, os, math
def train_one_epoch(model, loader, optimizer, scheduler, scaler, ema, args):    model.train()    optimizer.zero_grad(set_to_none=True)   # set_to_none=True 比 zero_() 更快    accum_steps = args.grad_accum_steps      # 梯度累积步数
    for step, batch in enumerate(loader):        batch = {k: v.to(args.device, non_blocking=True) for k, v in batch.items()}
        # --- 混合精度 forward ---        with torch.autocast(device_type="cuda", dtype=torch.bfloat16):            outputs = model(**batch)            loss = outputs.loss / accum_steps     # loss 缩放(梯度累积)
        # --- 混合精度 backward ---        scaler.scale(loss).backward()
        # --- 每 accum_steps 步做一次参数更新 ---        if (step + 1) % accum_steps == 0:            # 梯度裁剪(防爆炸)            scaler.unscale_(optimizer)            torch.nn.utils.clip_grad_norm_(model.parameters(), args.max_grad_norm)
            # 参数更新            scaler.step(optimizer)            scaler.update()            optimizer.zero_grad(set_to_none=True)
            # 学习率调度(按 optimizer step 而非 micro-step)            scheduler.step()
            # EMA 更新(指数滑动平均)            if ema is not None:                ema.update(model)
        # --- 定期保存 checkpoint ---        if (step + 1) % args.save_steps == 0:            save_checkpoint(model, optimizer, scheduler, step, args)
def save_checkpoint(model, optimizer, scheduler, step, args):    ckpt = {        "model": (ema.get_model() if ema else model).state_dict(),        "optimizer": optimizer.state_dict(),        "scheduler": scheduler.state_dict(),        "step": step,    }    path = os.path.join(args.output_dir, f"ckpt-{step}.pt")    torch.save(ckpt, path)
梯度裁剪(Gradient Clipping)
Section titled “梯度裁剪(Gradient Clipping)”梯度爆炸(Gradient Explosion)是深层网络和 RNN/Transformer 训练的头号杀手。梯度裁剪把梯度的全局范数限制在一个上限内:
这叫按范数裁剪(clip by norm,clip_grad_norm_),比”按值裁剪”(clip by value,逐元素截断)更常用,因为它保留了梯度方向。 通常取 1.0。大模型训练几乎必开梯度裁剪。
EMA(指数滑动平均)
Section titled “EMA(指数滑动平均)”EMA 维护一份参数的滑动平均副本,推理时用这份平均参数(往往比直接用最后一刻的参数更稳、泛化更好):
其中 是衰减率。EMA 在扩散模型(Diffusion Models)训练中几乎是标配,在 LLM 训练中也常用。它的本质是对参数轨迹做低通滤波,平滑掉训练后期的抖动。
class EMA:    def __init__(self, model, decay=0.9999):        self.decay = decay        self.shadow = {k: v.detach().clone() for k, v in model.state_dict().items()}
    @torch.no_grad()    def update(self, model):        for k, v in model.state_dict().items():            if v.dtype.is_floating_point:                self.shadow[k].mul_(self.decay).add_(v, alpha=1 - self.decay)
    def get_model(self):        # 返回用 EMA 参数的模型副本(用于推理/保存)        ...
Checkpoint 策略
Section titled “Checkpoint 策略”- 保存内容:模型权重、优化器状态、学习率调度器状态、当前 step/epoch、随机数种子。这样断点可精确续训。
- 保存频率:按步数(如每 1000 步)或按 epoch。大模型训练崩溃常见,务必勤存。
- 保留策略:只保留最近 N 个 + 性能最好的几个,避免磁盘爆满。
- 分布式:DDP/FSDP 下只需 rank 0 保存,避免多卡重复写盘。
3. Gradient Accumulation(梯度累积)
Section titled “3. Gradient Accumulation(梯度累积)”显存不够装不下大 batch?梯度累积(Gradient Accumulation)让你用小显存模拟大 batch 的训练效果。
PyTorch 的梯度是累加的——backward() 不会清零梯度,而是叠加到 .grad 上(直到你调用 zero_grad())。利用这一点,可以把一个大 batch 拆成 个 micro-batch,依次前向+反向,梯度自然累加,第 次再调 optimizer.step()。这等价于用 batch size 训练。
数学上,设 micro-batch 上的损失为 ,则累积后的总损失为:
这正是大 batch 的平均损失。因此梯度累积在数学上精确等价于大 batch(假设 BatchNorm 不跨 micro-batch 统计——这是唯一的细微差异)。
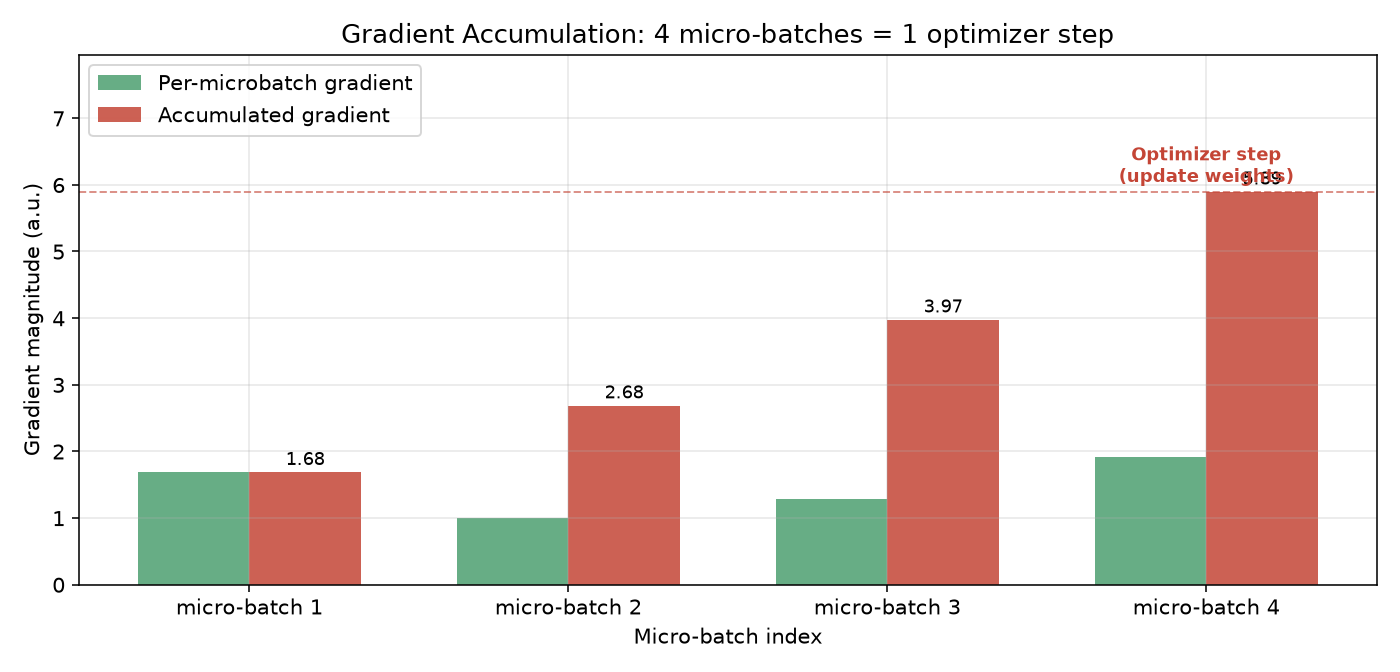
accum_steps = 4optimizer.zero_grad()for i, batch in enumerate(loader): loss = model(batch) / accum_steps # ① loss 除以累积步数 loss.backward() # ② 梯度自然累加 if (i + 1) % accum_steps == 0: clip_grad_norm_(model.parameters(), 1.0) optimizer.step() # ③ 等价于大 batch 的一步 optimizer.zero_grad()三个关键细节:
- loss 要除以
accum_steps——否则梯度被放大 倍,等效 batch 的损失应该是平均而非求和。 - 学习率调度按 optimizer step 计——不是按 micro-batch 计,否则调度会被稀释 倍。
- BatchNorm 警告——BatchNorm 的统计量是按 micro-batch 算的,micro-batch 太小(如 1–2)会让统计量方差极大。大 batch 模拟失效。解决:用 GroupNorm/LayerNorm,或冻结 BN 统计量。
大模型实践:LLaMA/Qwen 训练时,单卡 micro-batch 可能只有 1–4 条序列,靠
grad_accum=16~64拼出有效 batch 数千。这是消费级硬件训大模型的核心技巧。
4. 超参数调优
Section titled “4. 超参数调优”超参数(Hyperparameter)是训练前设定、不参与梯度更新的参数(如学习率、batch size、正则系数、网络层数)。找最佳超参组合的过程叫超参调优(Hyperparameter Optimization, HPO)。
| 策略 | 思想 | 优点 | 缺点 |
|---|---|---|---|
| Grid Search(网格搜索) | 枚举所有组合 | 简单、可并行 | 维度灾难,组合数指数爆炸 |
| Random Search(随机搜索) | 随机采样组合 | 比网格更高效(Bergstra 2012 证明) | 无学习,纯靠运气 |
| Bayesian Optimization(贝叶斯优化) | 用代理模型拟合”超参→性能”函数,选最可能更好的点试 | 样本高效,少试几次 | 串行性强,难大规模并行 |
| Population / 进化算法 | 维护一群超参,交叉变异淘汰 | 适合非凸、多目标 | 收敛慢 |
Random Search 为什么常胜 Grid Search?因为多数情况下只有少数超参重要(低有效维度)。网格搜索在无效维度上浪费大量试验,而随机搜索在每个维度上都均匀探索,更可能命中重要维度的好的取值。
贝叶斯优化用高斯过程(Gaussian Process, GP)或TPE(Tree-structured Parzen Estimator)建模目标函数 ,用采集函数(Acquisition Function)决定下一个试验点——在”探索未知区域”与”利用已知好区域”间权衡。
- EI(Expected Improvement):选最可能改进当前最优的点。
- UCB(Upper Confidence Bound):,平衡均值与不确定性。
数学上,给定已观测数据 ,GP 给出每点的后验均值 和方差 ,EI 定义为:
每次试验后更新 GP,迭代推进。贝叶斯优化适合”单次试验昂贵”的场景(如训练一个大模型)。
Optuna 实践
Section titled “Optuna 实践”Optuna 是当下最流行的 HPO 框架,默认用 TPE 采样器,API 极简:
import optuna
def objective(trial: optuna.Trial):    # 定义搜索空间    lr = trial.suggest_float("lr", 1e-5, 1e-2, log=True)    hidden = trial.suggest_categorical("hidden", [64, 128, 256])    dropout = trial.suggest_float("dropout", 0.0, 0.5)    n_layers = trial.suggest_int("n_layers", 1, 4)
    model = build_model(hidden, dropout, n_layers)    val_score = train_and_eval(model, lr)   # 训练并返回验证集分数    return val_score                        # 最大化
study = optuna.create_study(direction="maximize",                            sampler=optuna.samplers.TPESampler(seed=42))study.optimize(objective, n_trials=50, n_jobs=1)  # n_jobs 控制并行试验数print(study.best_params, study.best_value)
Optuna 还支持:剪枝(Pruning,提前终止差的试验)、可视化(参数重要性、优化历史)、分布式试验。
大模型的 HPO 困境
Section titled “大模型的 HPO 困境”大模型单次训练动辄几百 GPU 小时,跑几十组超参不现实。实践做法:
- 先在小模型/小数据上调,再把超参迁移到大模型(学习率通常按 sqrt(scaling) 调整)。
- 只调最关键的几个:学习率、warmup 步数、权重衰减、dropout。其余用社区默认值。
- Population-Based Training(PBT):把进化算法嵌入训练,多组并行训、差的向好的”复制变异”。Ray Tune 支持。
5. 混合精度训练回顾 + Gradient Checkpointing
Section titled “5. 混合精度训练回顾 + Gradient Checkpointing”混合精度(Mixed Precision)
Section titled “混合精度(Mixed Precision)”混合精度用 FP16/BF16 做 forward/backward(快、省显存),用 FP32 累积梯度和更新参数(精度)。核心机制是损失缩放(Loss Scaling)防止 FP16 小梯度下溢。详见 混合精度训练 的完整推导。
2024–2025 年的关键趋势:BF16(bfloat16)逐渐取代 FP16 成为默认。BF16 与 FP32 同为 8 位指数,动态范围相同,无需损失缩放,大幅降低训练不稳定性。现代 GPU(A100/H100/Blackwell)和 TPU 都原生支持 BF16。PyTorch 里只需:
with torch.autocast(device_type="cuda", dtype=torch.bfloat16): outputs = model(**batch) loss = outputs.lossloss.backward()优先用 BF16;只在老硬件(V100 及更早,不支持 BF16)才用 FP16 + 损失缩放。
Gradient Checkpointing(梯度检查点)
Section titled “Gradient Checkpointing(梯度检查点)”反向传播需要保留前向所有中间激活值(用于链式法则求导)。深层网络激活值显存占用极大——这是大模型训练的主要显存瓶颈。Gradient Checkpointing(又叫 Activation Checkpointing / Recomputation)的思路:前向时不保存部分中间激活,反向需要时重新前向计算一次——用一次额外前向的算力换大幅显存节省。
数学上,标准反向的显存占用 ( 为层数),检查点后降至 (按层分块,只保存检查点层的激活),计算开销增加约 33%(一次额外前向)。
from torch.utils.checkpoint import checkpoint
class TransformerBlock(torch.nn.Module):    def forward(self, x):        return self.layer(x)
class MyModel(torch.nn.Module): def forward(self, x): for block in self.blocks: # use_reentrant=False 是 PyTorch 新推荐(更稳、支持更多算子) x = checkpoint(block, x, use_reentrant=False) return x显存三件套:对大模型训练,几乎总是组合使用 混合精度 + 梯度检查点 + 梯度累积。三者叠加,单卡能训的模型规模可放大数倍。
6. 分布式训练实践
Section titled “6. 分布式训练实践”单卡训不动大模型时,必须分布式。三大范式:数据并行(每卡完整模型、不同数据)、模型并行(模型拆开分到多卡)、混合(FSDP/ZeRO/3D 并行)。详见 分布式训练 与 DeepSpeed/FSDP 指南 的系统论述,这里给出上手代码。
DDP(DistributedDataParallel)——数据并行入门
Section titled “DDP(DistributedDataParallel)——数据并行入门”DDP 是最简单、最常用的分布式方式:每张卡持有完整模型,各自处理不同数据,反向时用 All-Reduce 同步梯度。
import torch, torch.distributed as distfrom torch.distributed.fsdp import FullyShardedDataParallel as FSDP  # 仅示意from torch.nn.parallel import DistributedDataParallel as DDP
dist.init_process_group(backend="nccl")torch.cuda.set_device(dist.get_rank())
model = MyModel().cuda()model = DDP(model, device_ids=[dist.get_rank()])
# 注意:DataLoader 要用 DistributedSampler,保证各卡数据不重叠sampler = torch.utils.data.distributed.DistributedSampler(dataset, shuffle=True)loader = DataLoader(dataset, batch_size=per_gpu_bs, sampler=sampler)
for epoch in range(epochs):    sampler.set_epoch(epoch)   # 关键!保证每 epoch 数据打乱方式不同    for batch in loader:        loss = model(batch)        loss.backward()        optimizer.step()        optimizer.zero_grad()
DDP 的瓶颈:每卡都要装下完整模型 + 优化器状态 + 梯度 + 激活。对 7B+ 的模型,单卡 80GB 显存也吃不消。
FSDP(Fully Sharded Data Parallel)
Section titled “FSDP(Fully Sharded Data Parallel)”FSDP 把模型参数、梯度、优化器状态分片(shard)到各卡,用到时再临时 All-Gather 拼回。它本质上就是 ZeRO-3 的 PyTorch 原生实现,是大模型训练的主流方案。
from torch.distributed.fsdp import FullyShardedDataParallel as FSDPfrom torch.distributed.fsdp import ShardingStrategy, MixedPrecision
mp_policy = MixedPrecision(    param_dtype=torch.bfloat16,    reduce_dtype=torch.bfloat16,    buffer_dtype=torch.bfloat16,)
model = MyModel().cuda()model = FSDP(    model,    sharding_strategy=ShardingStrategy.FULL_SHARD,   # = ZeRO-3    mixed_precision=mp_policy,    use_orig_params=True,    # 兼容梯度检查点    activation_checkpointing=True,)# 后续用法与普通 model 一致
FSDP 的分片层级对应 ZeRO 的三阶段:
- ZeRO-1:分片优化器状态(省 4x 显存)。
- ZeRO-2:再分片梯度(省更多)。
- ZeRO-3 / FULL_SHARD:再分片参数(最省显存,但通信最多)。
DeepSpeed ZeRO 代码示例
Section titled “DeepSpeed ZeRO 代码示例”DeepSpeed 通过 JSON 配置驱动,与 PyTorch 训练循环解耦:
{ "train_micro_batch_size_per_gpu": 2, "gradient_accumulation_steps": 16, "optimizer": { "type": "AdamW", "params": { "lr": 2e-5, "weight_decay": 0.01 } }, "fp16": { "enabled": "auto" }, "bf16": { "enabled": true }, "zero_optimization": { "stage": 2, "offload_optimizer": { "device": "cpu" } }, "gradient_clipping": 1.0, "activation_checkpointing": { "partition_checkpointing": true }}import deepspeed
model_engine, optimizer, _, _ = deepspeed.initialize( model=model, model_parameters=model.parameters(), config="ds_config.json")
for batch in loader: loss = model_engine(batch) model_engine.backward(loss) model_engine.step() # DeepSpeed 内部处理梯度累积、裁剪、step、zero_gradDeepSpeed 的优势:配置驱动、支持 CPU/NVMe Offload(把优化器状态卸载到 CPU 内存或 SSD,进一步突破显存墙)、集成 1F1B 流水线并行。劣势:抽象较重,调试不如原生 PyTorch 直观。
| 场景 | 推荐方案 |
|---|---|
单卡能放下模型(<7B 训练、微调) | 单卡 + AMP + 梯度累积 |
| 多卡、模型放得下、要加速 | DDP(最简单) |
| 多卡、模型放不下(7B+ 全量训练) | FSDP 或 DeepSpeed ZeRO-2/3 |
| 超大模型(70B+)多机 | FSDP + 流水线并行 + 张量并行(3D 并行),或 Megatron-LM/torchtitan |
| 消费级显卡微调 | LoRA + 8-bit 优化器 + 梯度检查点(详见 量化) |
学习率调度与超参的工程组合
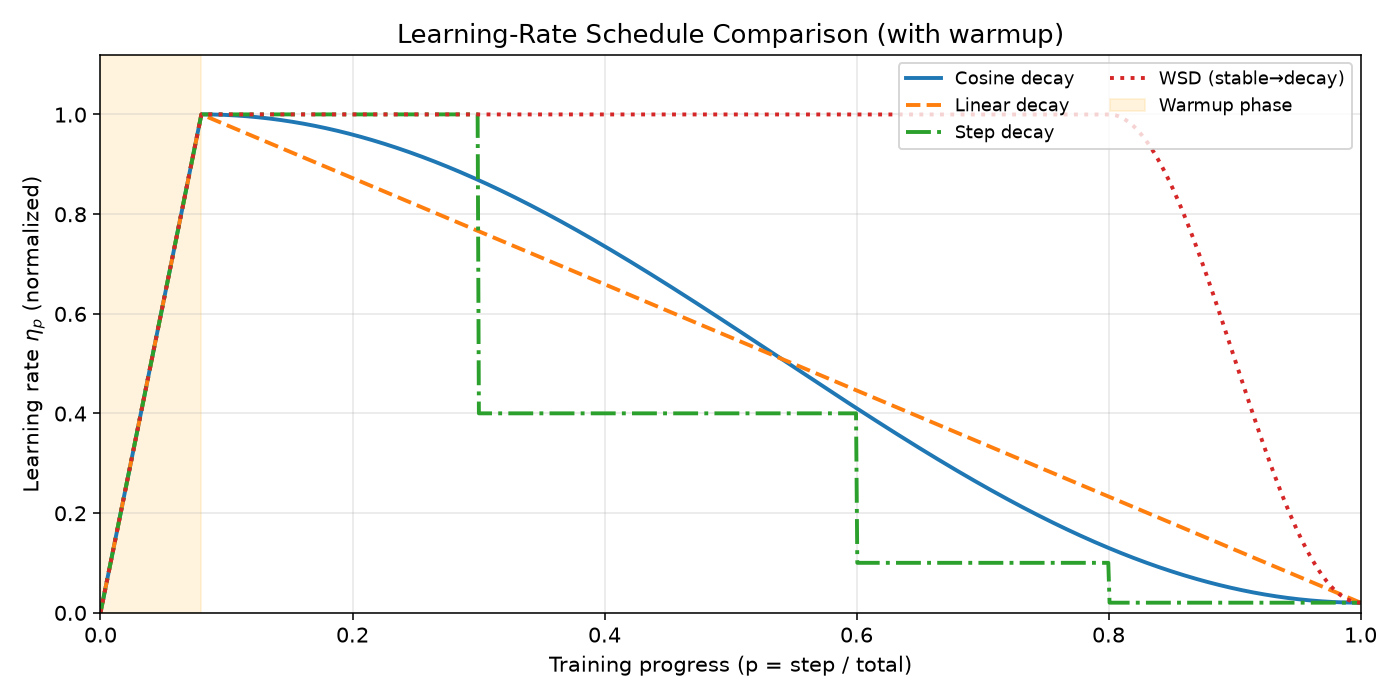
Section titled “学习率调度与超参的工程组合”训练工程的各个组件不是孤立的——学习率调度(详见 学习率调度策略)与 batch size、梯度累积强耦合。下图对比四种主流调度策略(均带 warmup)的曲线形态:
工程经验法则:
- 增大 batch size 时,学习率通常要相应增大。经验公式(线性缩放规则):(大 batch 时要 cap,且 warmup 要更长)。
- WSD 调度(Warmup-Stable-Decay)在 2024–2025 年大模型中流行:长时间稳定学习率训练,末期快速衰减。优点是”训到一半决定要不要继续”很灵活——stable 段可任意延长。
- 梯度累积不影响有效学习率,但影响 optimizer step 数,调度器的
total_steps要按 optimizer step 算。
- 先在小规模跑通,再 scale up:小数据小模型验证循环正确性(loss 下降、梯度不爆),再上大数据大模型。
- 永远监控梯度范数:训练日志里记
grad_norm、loss、lr、tokens/s。梯度范数突增是爆炸的前兆,loss spike 是不稳定信号。 - 混合精度优先 BF16,省去损失缩放的麻烦。
- 显存三件套常备:混合精度 + 梯度检查点 + 梯度累积。三者叠加才玩得转大模型。
- 勤存 checkpoint,分布式训练崩溃是常态,从断点续训能省巨额成本。
- 调参优先级:学习率 > warmup > batch size > 权重衰减 > dropout。别在不重要的超参上浪费时间。
- DDP 用
DistributedSampler并set_epoch,否则各卡数据打乱方式固定,模型会过拟合到固定顺序。 zero_grad(set_to_none=True)比zero_()快,因为省去内存写入。
2025-2026 最新进展
Section titled “2025-2026 最新进展”- BF16 成为绝对主流,FP16 + 损失缩放基本退出大模型训练;新一代 Blackwell GPU 原生支持 FP8(见 混合精度训练 的 FP8 章节)。
- FSDP2 重写:PyTorch 用基于 per-parameter 的新 FSDP 实现替代旧版,内存效率更高、与
torch.compile兼容性更好、调试更直观,2025–2026 年逐步成为默认。 - torchtitan:PyTorch 官方的轻量预训练参考实现,提供 Llama/GPT 类模型的完整 FSDP2 + 张量并行 + FP8 训练配方,是学习工业级训练工程的最佳起点。
- FP8 训练普及:H100/Blackwell 上 FP8 训练吞吐较 BF16 再提 ~2x,但需精细的 E4M3/E5M2 分配与张量级缩放因子管理。
- 3D 并行成熟:数据并行 × 流水线并行 × 张量并行的组合成为千亿模型标配;Megatron-LM、torchtitan、DeepSpeed 提供开箱即用配方。
- 离线/异步并行:如 DeepSpeed 的 ZenFlow、异步卸载引擎,让通信与计算 overlap,逼近线性扩展。
- 超参搜索与训练耦合:Ray Tune + Optuna 支持大规模异步 HPO;PBT 及其变体(如 ASHA 早停调度)让大模型 HPO 在合理预算内可行。
- 长序列训练:百万级 token 上下文训练(如 ALST、Ring/USB Attention)对显存与通信提出新挑战,催生新的激活重计算与序列并行(Sequence Parallelism)技术。
- PyTorch 入门——张量、自动求导、模块的基础。
- 梯度下降与优化器——优化器的完整谱系。
- 混合精度训练——FP16/BF16/FP8 的深入推导。
- 分布式训练——DDP/模型并行/流水线/张量并行的系统讲解。
- DeepSpeed/FSDP 指南——ZeRO 三阶段的代码实践。
- 学习率调度策略——各类调度公式的数学推导。
- 正则化与防过拟合——EMA 等平滑技术的原理。
- PyTorch 官方 DDP/FSDP 教程:动手入门首选。
- torchtitan 仓库(
github.com/pytorch/torchtitan):大模型训练工程的最佳参考代码。