
支持向量机简介
在本教程中,你将学习如何:
- 使用 OpenCV 函数 cv::ml::SVM::train 来构建一个基于 SVM 的分类器,并使用 cv::ml::SVM::predict 来测试其性能。
什么是 SVM?
Section titled “什么是 SVM?”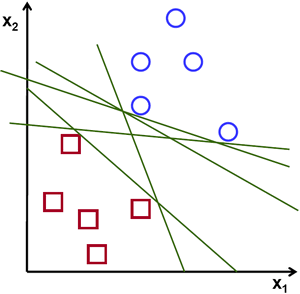
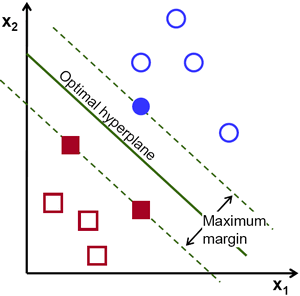
支持向量机(Support Vector Machine,SVM)是一种判别式分类器,由一个分离超平面形式化地定义。换句话说,给定带标签的训练数据(监督学习),该算法输出一个对新样本进行分类的最优超平面。
在什么意义上获得的超平面是最优的?让我们考虑以下简单问题:
对于一个属于两个类别之一且线性可分的二维点集,找到一条分离的直线。
注意: 在本示例中,我们处理的是笛卡尔平面中的直线和点,而不是高维空间中的超平面和向量。这是对问题的简化。重要的是要理解,这样做只是因为我们的直觉更容易从容易想象的示例中建立。然而,相同的概念适用于要分类的样本位于维度高于二维的空间中的任务。
在上图中,你可以看到存在多条直线可以为该问题提供解。其中有任何一条比其他更好吗?我们可以直观地定义一个准则来估计直线的价值:如果一条直线过于靠近这些点,那它就是不好的,因为它对噪声敏感且无法正确泛化。 因此,我们的目标应当是找到一条尽可能远离所有点的直线。
于是,SVM 算法的操作基于找到与训练样本具有最大最小距离的超平面。这个距离的两倍在 SVM 理论中获得了**间隔(margin)**这一重要名称。因此,最优分离超平面最大化了训练数据的间隔。
最优超平面是如何计算的?
Section titled “最优超平面是如何计算的?”让我们引入用于形式化定义一个超平面的记号:
其中 被称为权向量, 被称为偏置。
注意: 关于此内容和超平面的更深入描述,你可以在 T. Hastie、R. Tibshirani 和 J. H. Friedman([HTF01)所著的] Elements of Statistical Learning 一书的第 4.5 节(Separating Hyperplanes)中找到。
最优超平面可以通过对 和 进行缩放,以无数种不同的方式表示。作为惯例,在超平面的所有可能表示中,所选择的是
其中 象征最靠近超平面的训练样本。通常,最靠近超平面的训练样本被称为支持向量。这种表示被称为规范超平面。
现在,我们使用给出一个点 与一个超平面 之间距离的几何结果:
特别地,对于规范超平面,分子等于一,到支持向量的距离为
回忆上一节中引入的间隔,这里记为 ,是到最近样本距离的两倍:
最后,最大化 的问题等价于在满足某些约束条件下最小化函数 的问题。这些约束建模了超平面正确分类所有训练样本 的要求。形式上,
其中 表示每个训练样本的标签。
这是一个拉格朗日优化问题,可以使用拉格朗日乘子来求解,以获得最优超平面的权向量 和偏置 。
- 设置训练数据
本练习的训练数据由一组带标签的二维点组成,这些点属于两个不同类别之一;一个类别由一个点组成,另一个类别由三个点组成。
之后将使用的 cv::ml::SVM::train 函数要求训练数据存储为浮点型的 cv::Mat 对象。因此,我们从上面定义的数组创建这些对象:
-
设置 SVM 的参数
在本教程中,我们以最简单的情况介绍了 SVM 的理论,即训练样本分布在两个线性可分的类别中。然而,SVM 可以用于各种各样的问题(例如具有非线性可分数据的问题、使用核函数提高样本维度的 SVM 等)。因此,在训练 SVM 之前,我们必须定义一些参数。这些参数存储在 cv::ml::SVM 类的一个对象中。
这里:
-
SVM 的类型。我们在此选择类型 C_SVC,它可用于 n 类分类(n 2)。这种类型的重要特点是它能处理类别的不完美分离(即训练数据非线性可分时)。这个特点在这里并不重要,因为数据是线性可分的,我们选择这种 SVM 类型只是因为它是最常用的。
-
SVM 核函数的类型。我们没有讨论核函数,因为它们对我们正在处理的训练数据并不重要。尽管如此,现在让我们简要解释一下核函数背后的主要思想。它是对训练数据进行的映射,以改善其与线性可分数据集的相似性。这种映射包括增加数据的维度,并使用核函数高效地完成。我们在此选择类型 LINEAR,这意味着不进行映射。此参数使用 cv::ml::SVM::setKernel 定义。
-
算法的终止准则。SVM 训练过程是通过以迭代方式求解约束二次优化问题来实现的。这里我们指定最大迭代次数和容差误差,以便即使尚未计算出最优超平面,我们也允许算法在较少的步骤中完成。此参数定义在 cv::TermCriteria 结构中。
-
训练 SVM 我们调用 cv::ml::SVM::train 方法来构建 SVM 模型。
-
由 SVM 分类的区域
cv::ml::SVM::predict 方法用于使用训练好的 SVM 对输入样本进行分类。在本示例中,我们使用此方法根据 SVM 所做的预测为空间着色。换句话说,遍历一幅图像,将其像素解释为笛卡尔平面上的点。根据 SVM 预测的类别对每个点着色;如果它是标签为 1 的类别则为绿色,如果它是标签为 -1 的类别则为蓝色。
-
支持向量
我们在此使用几个方法来获取有关支持向量的信息。cv::ml::SVM::getSupportVectors 方法获取所有支持向量。我们在此使用这些方法来找到作为支持向量的训练样本并突出显示它们。
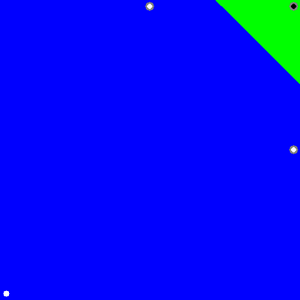
- 代码打开一幅图像并显示两个类别的训练样本。一个类别的点用白色圆圈表示,另一个类别用黑色圆圈。
- 训练 SVM 并将其用于对图像的所有像素进行分类。这导致图像被划分为蓝色区域和绿色区域。两个区域之间的边界是最优分离超平面。
- 最后,使用灰色圆环围绕训练样本显示支持向量。