
采样方法
采样(Sampling)是从复杂概率分布中生成随机样本的技术——当分布太复杂、无法直接解析计算时,采样是数值求解的唯一出路。从蒙特卡洛积分到 MCMC、从重要性采样到扩散模型,采样方法贯穿了统计推断、贝叶斯计算和生成式 AI 的全部脉络。前置阅读:蒙特卡洛方法、数值优化与数学基础。
把概率分布想象成一片地形——平坦处概率高(样本密集),陡峭处概率低(样本稀疏)。采样就是在这片地形上”撒豆子”,让豆子按概率密度自然分布:
- 均匀采样= 闭眼在这片地上随机撒豆子。简单,但豆子不会按概率密度分布,平坦和陡峭处一样多。
- 逆变换采样= 先看这张地形的”等高线图”(累积分布函数 CDF),然后均匀地画横线,反推出每个豆子该落在哪。保证豆子密度恰好等于概率密度。
- 拒绝采样= 用一个更容易撒豆子的”大方盒”罩住地形,均匀撒豆子后扔掉掉在地形外面(盒子比地形高的部分)的豆子。留下的豆子自然按地形分布。简单,但如果盒子太大,浪费率极高。
- 重要性采样= 不真的撒豆子,而是用另一个容易采样的分布来撒,然后给每个豆子加权——落在该密的地方加权大,落在该稀的地方加权小。算期望特别高效。
- MCMC(马尔可夫链蒙特卡洛)= 像在山地散步的醉汉:每一步只看当前位置决定下一步往哪走,走得多了,停留时间就自然按地形分布了。最强大也最通用,但需要”走够久”才能稳定。
一个贯穿全程的关键概念:我们关心的目标分布 通常只差一个常数因子——在贝叶斯推断中我们知道未归一化的后验 ,但无法算出归一化常数 (高维积分无解析解)。后面会看到,MCMC 和重要性采样的一大优势恰恰是不需要知道 就能采样或估计期望。
设目标分布的累积分布函数为 ,它把 映射到 区间,且单调递增。逆变换采样的核心定理:
若 ,则 服从目标分布。
推导(为什么这能行):记 ,我们需要证明 。因为 单调递增:
最后一步用到均匀分布的性质:。于是 的 CDF 恰好是 ,证毕。
步骤:
- 从 采样一个 。
- 计算 。
- 即为服从目标分布的样本。
前提是 CDF 的逆函数能解析求出。对于指数分布 ,,求逆得 ——可以直接用。但对高斯分布等, 没有闭式逆函数,此时需用 Box-Muller 变换等专门技巧,或者改用其他采样方法。
拒绝采样(Rejection Sampling)
Section titled “拒绝采样(Rejection Sampling)”引入一个容易采样的”提议分布” 和一个常数 ,使得对所有 ,(目标分布)。几何上, 就像一块”包装纸”把目标密度 完全罩住。
步骤:
- 从 采样一个候选点 。
- 从 采样 。
- 若 ,接受 ;否则拒绝,回到步骤 1。
为什么接受率恰好让留下的样本服从 ?候选点落在 的概率是 ;被接受的概率是 。两者相乘,留下来的密度正比于 。全局接受率为 (当 归一化时)—— 越接近 1,效率越高。
问题在于高维空间:即使 和 看起来差不多,要保证处处 , 仍会随维度指数增长(因为”罩住”要在每个方向同时成立),接受率 趋零——这就是维度灾难。因此拒绝采样只适用于低维(一般 维)。
重要性采样(Importance Sampling)
Section titled “重要性采样(Importance Sampling)”不生成服从 的样本,而是从提议分布 中采样,然后用权重修正。目标:计算函数 在分布 下的期望 。推导链:
用蒙特卡洛近似最后一个期望:
其中 称为重要性权重(importance weight)。关键技巧:选择 使其在 较大的区域采样更多——这样估计方差最小。这也是”重要性”的含义:把采样资源集中在重要区域。
自归一化重要性采样(Self-normalized IS):当只能得到未归一化密度 时( 未知),权重变为 \tilde\{w\}_i = \frac\{\tilde\{p\}(x_i)\}\{q(x_i)\},估计量修正为 。这是实际中最常用的形式,因为它绕开了归一化常数。
重要性采样在强化学习的离策略(Off-policy)评估、贝叶斯模型证据计算中有核心应用。要注意:如果 在 有显著概率密度的区域概率很低,权重 方差会爆炸,估计极不可靠——监控有效样本大小 是实践中的必备操作。
MCMC:Metropolis-Hastings 算法
Section titled “MCMC:Metropolis-Hastings 算法”MCMC(Markov Chain Monte Carlo,马尔可夫链蒙特卡洛)构造一条马尔可夫链,使其平稳分布恰好是目标分布 。马尔可夫链的精髓:下一步去哪只取决于当前在哪(无记忆性)。当链走得足够久后,其所处位置的分布就趋近于 ——这就是采样的来源。
Metropolis-Hastings 是最基础的 MCMC 算法:
- 从当前状态 ,用提议分布 生成候选 。
- 计算接受概率 。
- 从 采样 。
- 若 ,接受 (链转移到 );否则留在 。
接受概率的直觉:比值 衡量候选点”有多好”——如果候选点概率更高(上坡),分子 分母,,一定接受;如果候选点概率更低(下坡),以概率 接受,既允许探索低概率区又防止一头扎进谷底出不来。 是”可逆性修正”,当提议分布不对称时(比如总是往右走多一点),修正这个偏差。
细致平衡条件(Detailed Balance):MCMC 收敛的数学保证是 ,即从 到 的流量等于反向流量。Metropolis-Hastings 的接受概率正是为此精心设计的。满足细致平衡的马尔可夫链,其平稳分布必为 。
关键优势:只需要知道 的未归一化形式(不需要归一化常数 )——因为比值 中 被约掉了。这对贝叶斯后验 至关重要, 通常无法解析计算。
Gibbs 采样
Section titled “Gibbs 采样”Gibbs 采样是 Metropolis-Hastings 的特例,适用于多维分布 。每次只更新一个维度,条件于其他所有维度的当前值:
每个条件分布的采样通常比联合分布容易得多。可以证明 Gibbs 采样是 MH 的特例,其接受率始终为 1(永远不拒绝)——因为从精确条件分布采样天然满足细致平衡。Gibbs 采样是概率图模型和贝叶斯推断的主力工具。详见概率图模型。
哈密顿蒙特卡洛(HMC)
Section titled “哈密顿蒙特卡洛(HMC)”HMC(Hamiltonian Monte Carlo)利用目标分布的梯度信息,将采样问题转化为物理模拟。核心想法:把负对数概率 看作”势能”(potential energy)——概率高的地方势能低(山谷),概率低的地方势能高(山峰)。再引入辅助的”动量”变量 ,让虚拟粒子在这片势能景观上按哈密顿动力学运动:
粒子沿等高线滑动,能高效穿越高维空间,不像普通 MCMC 那样在原地”随机游走”(random walk)。HMC 需要梯度 ——在现代深度学习框架中由 autograd(自动微分引擎,即自动计算梯度的系统)轻松获得。
NUTS(No-U-Turn Sampler)是 HMC 的自适应版本:它自动决定轨迹长度(走到”该回头”为止),并自动调节步长,无需手动调参。NUTS 是 Stan 和 PyMC 的默认采样器。近年(2023-2025)JAX 生态催生了新一代高性能库——BlackJAX(Google/DeepMind)和 NumPyro(Google/Uber)——它们将 HMC/NUTS 跑在 GPU/TPU 上,对大规模层次模型可实现数十倍加速,逐渐成为贝叶斯计算的新标准。
与生成式 AI 的关系
Section titled “与生成式 AI 的关系”扩散模型(Diffusion Model)的采样过程本质是反向随机微分方程(Reverse SDE)的数值求解——从纯高斯噪声出发,逐步去噪还原数据。数学上,扩散过程定义了前向 SDE ,其逆向时间 SDE 在 Tweedie’s formula 下可解析表达,但需要数值积分。DDPM、DDIM、DPM-Solver 都是该方程的不同离散化方案。
2023-2025 年间,采样方法在生成式 AI 领域经历了爆发式创新:
- DPM-Solver / DPM-Solver++(2022-2023):利用扩散 ODE 是指数积分的数学结构,设计专用高阶求解器,将采样步数从 1000 压缩到 10-20 步,质量几乎无损。
- Flow Matching(2022-2025):抛弃传统高斯扩散框架,直接学习两个分布之间的连续流(continuous normalizing flow)。Stable Diffusion 3 和 Black Forest Labs 的 Flux 模型均采用 Flow Matching(具体为 Rectified Flow 变体),在图像质量与文本对齐上刷新了 SOTA。
- Consistency Models(2023-2025):OpenAI 提出,训练一个单步映射网络直接从噪声生成数据,推理时无需迭代求解 ODE——把”采样”压缩成一次前向传播。2024 年的改进版本(Consistency Training v2)进一步逼近多步扩散器的质量。
- 一致性轨迹模型(Consistency Trajectory Model, CTM)和超快速蒸馏采样器(如 SDXL Turbo、LCM-LoRA)将扩散采样压缩到 1-4 步,使实时生成成为可能。
详见扩散模型。
采样方法谱系
Section titled “采样方法谱系”MCMC 采样过程
Section titled “MCMC 采样过程”numpy 手写逆变换采样、拒绝采样与 MCMC
Section titled “numpy 手写逆变换采样、拒绝采样与 MCMC”import numpy as npimport matplotlib.pyplot as plt
# ============================================================# 1. 逆变换采样: 从指数分布 Exp(λ) 采样# ============================================================# Exp(λ) 的 CDF 为 F(x) = 1 - exp(-λx),逆函数 F⁻¹(u) = -ln(1-u)/λlam = 2.0u = np.random.uniform(0, 1, 10000) # 均匀随机数x_inv = -np.log(1 - u) / lam # CDF 求逆 → 服从 Exp(λ) 的样本
# ============================================================# 2. 拒绝采样: 从标准正态 N(0,1) 采样# ============================================================# 提议分布 q(x) = Uniform(-5, 5),密度 1/10# 目标 p(x) = 标准正态密度,最大值约 0.399(在 x=0 处)# 上界 M·q(x) 需 ≥ max p(x),取 M·q = 0.4 → M = 4.0
def target_pdf(x): """标准正态分布的概率密度函数""" return np.exp(-x**2 / 2) / np.sqrt(2 * np.pi)
upper_bound = 0.4 # M * q(x) 的常数上界samples_rej = []attempts = 0while len(samples_rej) < 5000: x_cand = np.random.uniform(-5, 5) # 从均匀提议分布采样 u = np.random.uniform(0, 1) attempts += 1 if u < target_pdf(x_cand) / upper_bound: # 接受准则 samples_rej.append(x_cand)
accept_rate = len(samples_rej) / attemptsprint(f"拒绝采样: 收集 {len(samples_rej)} 个样本, " f"接受率={accept_rate:.2%}, 均值={np.mean(samples_rej):.3f}")
# ============================================================# 3. Metropolis-Hastings: 从目标分布 p(x) ∝ exp(-x⁴/4) 采样# (这是一个非标准分布,没有现成采样器)# ============================================================def log_target(x): """未归一化目标分布的对数密度: p(x) ∝ exp(-x⁴/4)""" return -x**4 / 4.0
def metropolis_hastings(log_prob, x0, n_samples, proposal_std=1.0): """ Metropolis-Hastings 采样器(对称随机游走提议)。 - log_prob: 未归一化对数目标密度(只需正比即可) - x0: 初始状态 - proposal_std: 高斯提议分布的标准差 """ samples = np.zeros(n_samples) x = x0 log_p = log_prob(x) n_accept = 0 for i in range(n_samples): x_prop = x + np.random.normal(0, proposal_std) # 对称提议 log_p_prop = log_prob(x_prop) # 接受概率 α = min(1, exp(log_p_prop - log_p)) # 对数域计算更稳定,避免溢出 if np.log(np.random.uniform()) < (log_p_prop - log_p): x, log_p = x_prop, log_p_prop n_accept += 1 samples[i] = x return samples, n_accept / n_samples
samples_mh, acc_rate = metropolis_hastings(log_target, x0=0.0, n_samples=20000)# 丢弃前 5000 个样本作为 burn-in(预热),只保留后半段samples_mh_kept = samples_mh[5000:]print(f"MH 采样: 接受率={acc_rate:.2%}, " f"保留样本均值={np.mean(samples_mh_kept):.3f}, " f"方差={np.var(samples_mh_kept):.3f}")
# ============================================================# 4. 可视化三种方法的采样结果# ============================================================fig, axes = plt.subplots(1, 3, figsize=(15, 4))
axes[0].hist(x_inv, bins=80, density=True, alpha=0.7, color='steelblue')axes[0].set_title('逆变换采样: Exp(λ=2)')
axes[1].hist(samples_rej, bins=80, density=True, alpha=0.7, color='green')x_grid = np.linspace(-4, 4, 200)axes[1].plot(x_grid, target_pdf(x_grid), 'r-', lw=2, label='理论 PDF')axes[1].set_title(f'拒绝采样: N(0,1) 接受率 {accept_rate:.1%}')axes[1].legend()
axes[2].hist(samples_mh_kept, bins=80, density=True, alpha=0.7, color='purple')x_grid2 = np.linspace(-3, 3, 200)# 理论密度(归一化常数 ≈ 1.81,数值积分近似)unnorm = np.exp(-x_grid2**4 / 4)axes[2].plot(x_grid2, unnorm / np.trapz(unnorm, x_grid2), 'r-', lw=2, label='理论 PDF')axes[2].set_title(f'MH 采样: exp(-x⁴/4) 接受率 {acc_rate:.1%}')axes[2].legend()
plt.tight_layout()plt.savefig('sampling_comparison.png', dpi=150)print("图表已保存到 sampling_comparison.png")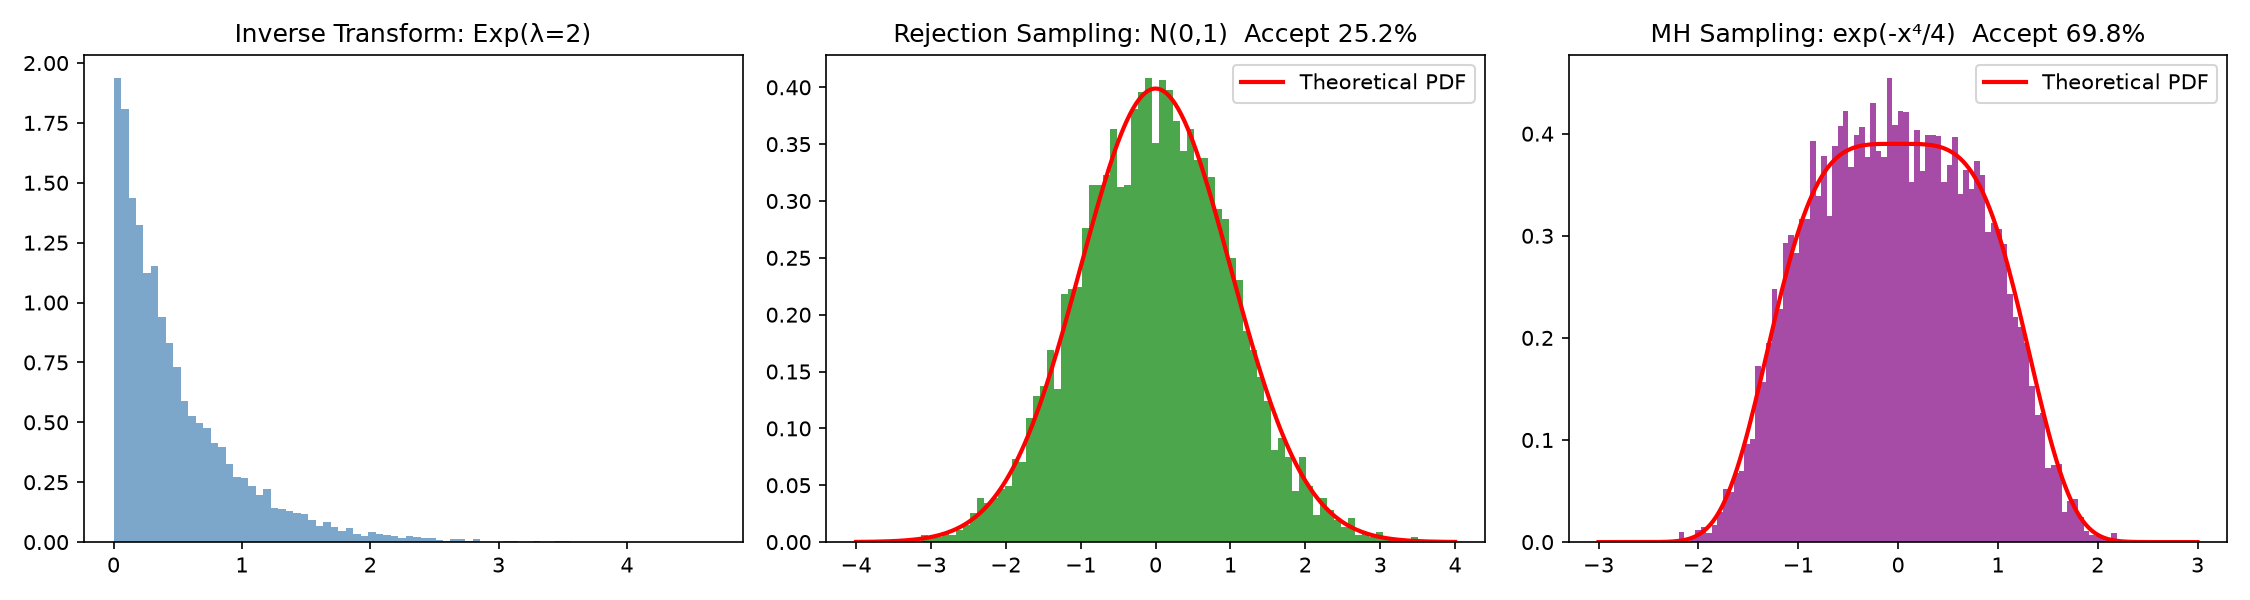
重要性采样估算稀有事件概率
Section titled “重要性采样估算稀有事件概率”import numpy as np
# ============================================================# 用重要性采样估计 P(X > 5) where X ~ N(0,1)# 直接蒙特卡洛需要 ~10⁷ 个样本才能看到几次(概率 ≈ 2.87e-7)# 重要性采样用偏移的提议分布大幅降低方差# ============================================================
def importance_sampling_rare_event(n_samples=100000, threshold=5.0): """ 用重要性采样估计标准正态的尾部概率 P(X > threshold)。 提议分布 q 选为 N(threshold, 1)——把采样资源集中到尾部。 """ # 提议分布: 均值偏移到 threshold proposals = np.random.normal(threshold, 1.0, n_samples)
# 未归一化权重 w = p(x)/q(x),用对数域计算更稳定 # log p(x) = -x²/2 - 0.5·log(2π) # log q(x) = -(x-threshold)²/2 - 0.5·log(2π) log_w = -proposals**2 / 2 + (proposals - threshold)**2 / 2
# 指示函数 f(x) = 1{x > threshold} indicator = (proposals > threshold).astype(float)
# 自归一化重要性采样估计 weights = np.exp(log_w - log_w.max()) # 数值稳定化 estimate = np.sum(indicator * weights) / np.sum(weights)
# 理论值: 1 - Φ(threshold) from scipy.stats import norm theoretical = 1 - norm.cdf(threshold)
return estimate, theoretical
est, truth = importance_sampling_rare_event(n_samples=100000)print(f"重要性采样估计 P(X>5) = {est:.6e}")print(f"理论值 = {truth:.6e}")print(f"相对误差 = {abs(est - truth) / truth:.2%}")# 只需 10⁵ 个样本,IS 就能高精度估计 ~10⁻⁷ 的概率PyMC 贝叶斯推断(NUTS 采样器)
Section titled “PyMC 贝叶斯推断(NUTS 采样器)”import numpy as npimport pymc as pmimport arviz as az # 贝叶斯诊断可视化库
# ============================================================# 贝叶斯线性回归: y = a·x + b + noise# 用 NUTS 采样器自动推断后验分布 p(a, b, σ | data)# ============================================================rng = np.random.default_rng(42)true_a, true_b, true_sigma = 2.5, 1.0, 1.0x = np.linspace(0, 10, 50)y = true_a * x + true_b + rng.normal(0, true_sigma, 50)
with pm.Model() as linear_model: # 先验分布(先验 encode 我们在看到数据之前的信念) a = pm.Normal("a", mu=0, sigma=10) # 斜率先验:宽泛的正态 b = pm.Normal("b", mu=0, sigma=10) # 截距先验 sigma = pm.HalfNormal("sigma", sigma=1) # 噪声标准差先验(半正态保证为正)
# 线性模型与似然函数 mu = a * x + b pm.Normal("obs", mu=mu, sigma=sigma, observed=y) # 似然
# NUTS 采样器自动推断后验 # tune=500: 前 500 步用于调节步长(预热),不保留 # chains=2: 跑两条独立链,用于 R-hat 收敛诊断 trace = pm.sample(1000, tune=500, chains=2, progressbar=False)
# 后验摘要与收敛诊断summary = az.summary(trace, hdi_prob=0.94) # HDI = 最高密度区间print(summary)# R-hat ≈ 1.000 且 ESS > 400 表示链已充分收敛,结果可信
print(f"\n斜率 a: 后验均值 = {trace.posterior['a'].mean():.2f} (真值 {true_a})")print(f"截距 b: 后验均值 = {trace.posterior['b'].mean():.2f} (真值 {true_b})")print(f"σ: 后验均值 = {trace.posterior['sigma'].mean():.2f} (真值 {true_sigma})")- 能用解析方法就别采样:如果分布的归一化常数、期望、边缘分布都能解析计算(如高斯、狄利克雷),直接用公式,不需要采样。采样是”最后手段”。
- 低维用拒绝/逆变换,高维用 MCMC:拒绝采样在高维因接受率暴跌而不可用。逆变换需要 CDF 可逆,高维几乎不可能。高维分布几乎只能用 MCMC 或变分推断。
- 关注收敛诊断:MCMC 需要预热(burn-in,丢弃前若干样本)和收敛检验(如 R-hat 统计量、有效样本数 ESS)。R-hat 接近 1.0 说明链已收敛;大于 1.1 则需要更多迭代或重新调参。ArviZ 库提供一键诊断(
az.summary、az.plot_trace)。 - NUTS 是贝叶斯推断首选:NUTS 自动调节步长和轨迹长度,无需手动调参,PyMC 和 Stan 默认使用。经典 Metropolis-Hastings 只在梯度不可得时使用。如果追求速度,可以尝试 JAX 后端的 NumPyro 或 BlackJAX——它们支持 GPU 加速,适合大规模模型。
- 重要性采样注意方差:如果提议分布 和目标分布 不匹配(权重方差极大),估计会有巨大方差。实践中需要监控有效样本大小()。ESS 远小于实际样本数时,说明权重退化(weight degeneracy),估计不可靠。
- 变分推断是采样的替代方案:当 MCMC 太慢时,用变分推断(VI,Variational Inference)把采样问题转化为优化问题——用一个参数化分布族逼近目标分布,速度极快但精度不如 MCMC(有偏估计)。VI 是大规模主题模型(如 LDA)和大语言模型训练中近似后验的主力。详见蒙特卡洛方法。
- 扩散模型的采样是特殊的逆问题:扩散采样的”质量-速度权衡”在 2023-2025 年被大幅推进——从 1000 步的 DDPM 到 4 步的 LCM(Latent Consistency Model),核心是对反向 SDE/ODE 的更好数值离散化与蒸馏。选采样器时,DPM-Solver++(20 步)和 Flow Matching 的 Euler 采样器(30-50 步)是目前质量与速度的甜点。
- 贝叶斯推断:计算后验分布 的期望、credible interval(可信区间,即贝叶斯版的置信区间)。PyMC、Stan、NumPyro 是工业级 MCMC 工具。详见EM 算法。
- 蒙特卡洛积分:高维定积分的数值求解,如物理模拟中的路径积分、金融衍生品定价。详见蒙特卡洛方法。
- 扩散模型采样:DDPM、DDIM、DPM-Solver、Flow Matching 本质是反向 SDE 的数值采样过程。2024-2025 年的 Consistency Model 和蒸馏采样器将其压缩到 1-4 步。详见扩散模型。
- 强化学习中的策略评估:重要性采样用于 Off-policy 评估——用旧策略收集的数据评估新策略的期望回报,无需重新交互。
- 概率图模型推理:Gibbs 采样用于贝叶斯网络和马尔可夫随机场的近似推理,尤其适合高维离散分布。详见概率图模型。
- 稀有事件模拟:金融风险中的尾部事件(如 VaR、 Expected Shortfall 计算)用重要性采样集中在极端区域,方差可比朴素蒙特卡洛降低数个量级。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| numpy.random | Python | 基础随机数生成:均匀、正态、指数等标准分布 |
| scipy.stats | Python | 连续/离散分布的 PDF、CDF、rvs(采样)完整工具链 |
| PyMC | Python | Python 贝叶斯统计建模库,内置 NUTS、Metropolis 等采样器(v5+ 支持 JAX 后端) |
| Stan (CmdStanPy) | C++/Python | 高性能贝叶斯推断引擎,NUTS 采样器的标杆实现 |
| NumPyro | Python | 基于 JAX 的概率编程库,GPU/TPU 加速的 NUTS 和 HMC |
| BlackJAX | Python | DeepMind 出品的 JAX 原生 MCMC 库,模块化设计,含 HMC/NUTS/ADVI |
| emcee | Python | 天文学常用的仿射不变 MCMC 采样器(Ensemble sampler) |
| ArviZ | Python | 贝叶斯后验诊断与可视化(R-hat、ESS、trace plot) |
| TensorFlow Probability | Python | Google 的概率编程库,含 HMC、VI 等完整采样工具 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 采样 | Sampling | 从概率分布中生成随机样本的过程 |
| 逆变换采样 | Inverse Transform Sampling | 利用 CDF 的逆函数将均匀分布样本转换为目标分布样本 |
| 拒绝采样 | Rejection Sampling | 用提议分布和接受/拒绝机制生成目标分布样本 |
| 重要性采样 | Importance Sampling | 从提议分布采样并用权重修正来估计目标分布下的期望 |
| 马尔可夫链蒙特卡洛 | MCMC | 构造平稳分布为目标分布的马尔可夫链来进行采样 |
| 细致平衡 | Detailed Balance | ,保证平稳分布的充分条件 |
| Metropolis-Hastings | Metropolis-Hastings | 最通用的 MCMC 算法,通过接受/拒绝机制保证收敛到目标分布 |
| Gibbs 采样 | Gibbs Sampling | 逐维度从条件分布采样的 MCMC 方法,适用于多维分布 |
| 哈密顿蒙特卡洛 | HMC | 利用梯度信息和物理动力学加速高维采样的 MCMC 方法 |
| 预热 | Burn-in | 丢弃 MCMC 链初始阶段未收敛的样本 |
| 有效样本大小 | ESS | 衡量 MCMC 样本独立性等效于独立样本的数量 |
| 归一化常数 | Normalizing Constant / Partition Function | 使概率密度积分为 1 的常数因子 ,高维下通常不可解析计算 |
| 反向 SDE | Reverse SDE | 扩散模型中从噪声还原数据的逆向随机微分方程 |
| Flow Matching | Flow Matching | 通过匹配连续概率流来训练生成模型的方法,Stable Diffusion 3 / Flux 的基础 |
- Robert & Casella,「Monte Carlo Statistical Methods」(2004):采样方法的权威教材,从逆变换到 MCMC 到粒子滤波,推导完备。
- Hastings,「Monte Carlo Sampling Methods Using Markov Chains and Their Applications」(1970):Metropolis-Hastings 算法的奠基论文,定义了现代 MCMC 的框架。
- Hoffman & Gelman,「The No-U-Turn Sampler」(JMLR 2014):NUTS 论文,自适应调节 HMC 参数,是 Stan/PyMC 默认采样器的来源。
- Neal,「MCMC using Hamiltonian Dynamics」(2011):HMC 的最佳入门综述,从物理直觉到实现细节讲解透彻。
- Andrieu et al.,「An Introduction to MCMC for Machine Learning」(2003):面向机器学习读者的 MCMC 教程,50 页覆盖核心算法与应用场景。
- Lu et al.,「DPM-Solver: A Fast ODE Solver for Diffusion Models」(NeurIPS 2022, ICLR 2023):将扩散 ODE 视为指数积分,设计专用高阶求解器,10-20 步即可生成高质量样本。
- Lipman et al.,「Flow Matching for Generative Modeling」(ICLR 2023):Flow Matching 的奠基论文,提出通过匹配向量场训练连续归一化流,成为 2024-2025 年主流生成框架。
- Song et al.,「Consistency Models」(ICML 2023):OpenAI 的单步生成模型,将扩散采样压缩到一次前向传播,后续 Consistency Distillation 和 CTM 持续改进。
- BlackJAX 文档 (blackjax-devs.github.io/blackjax):2023-2025 年活跃开发的 JAX 原生 MCMC 库,适合追求 GPU 加速和可组合性的研究者。
- ArviZ 生态系统 (https://python.arviz.org/):贝叶斯后验分析与诊断的标准工具,支持 PyMC、NumPyro、Stan 等多种后端,是 MCMC 收敛诊断的必备。