
主成分分析(PCA)简介
在本教程中,你将学习如何:
- 使用 OpenCV 类 cv::PCA 来计算目标的朝向。
什么是 PCA?
Section titled “什么是 PCA?”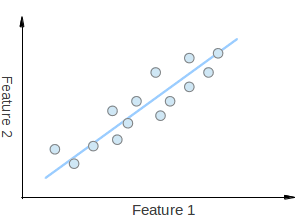
主成分分析(Principal Component Analysis,PCA)是一种统计过程,用于提取数据集最重要的特征。
考虑你有一组二维点,如上图所示。每个维度对应你感兴趣的一个特征。这里有些人可能会认为这些点是随机排列的。然而,如果你仔细观察,你会发现存在一个难以忽视的线性模式(由蓝线表示)。PCA 的一个关键点是降维(Dimensionality Reduction)。降维是减少给定数据集维数的过程。例如,在上述情况下,可以将这组点近似为一条直线,从而将给定点的维度从 2D 降低到 1D。
此外,你还可以看到,这些点沿蓝线的变化最大,比它们沿特征 1 或特征 2 轴的变化都大。这意味着,如果你知道一个点沿蓝线的位置,你就比只知道它在特征 1 轴或特征 2 轴上的位置拥有更多关于该点的信息。
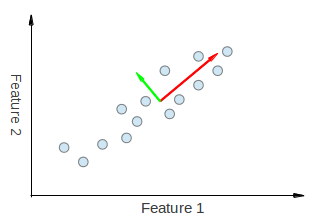
因此,PCA 允许我们找到数据变化最大的方向。事实上,对图中点集运行 PCA 的结果由 2 个称为_特征向量_的向量组成,它们是该数据集的_主成分_。
每个特征向量的大小编码在相应的特征值中,并表示数据沿主成分的变化程度。特征向量的起点是数据集中所有点的中心。对 N 维数据集应用 PCA 会产生 N 个 N 维特征向量、N 个特征值和 1 个 N 维中心点。理论够了,让我们看看如何将这些想法转化为代码。
特征向量和特征值是如何计算的?
Section titled “特征向量和特征值是如何计算的?”目标是将维度为 p 的给定数据集 X 变换为维度较小 L 的备选数据集 Y。等价地,我们在寻找矩阵 Y,其中 Y 是矩阵 X 的 Karhunen–Loève 变换(KLT):
组织数据集
假设你有一组包含 p 个变量观测值的数据,并且你想对数据进行降维,使得每个观测值可以仅用 L 个变量来描述,L < p。进一步假设数据排列为一组 n 个数据向量 ,其中每个 表示对 p 变量的一次分组观测。
- 将 写为行向量,每个行向量有 p 列。
- 将这些行向量放入一个维度为 的单一矩阵 X 中。
计算经验均值
-
沿每个维度 求经验均值。
-
将计算出的均值放入维度为 的经验均值向量 u 中。
计算与均值的偏差
减去均值是寻找最小化数据近似均方误差的主成分基的解的一个组成部分。因此,我们按如下方式对数据进行中心化:
-
从数据矩阵 X 的每一行中减去经验均值向量 u。
-
将减去均值后的数据存储在 矩阵 B 中。
其中 h 是一个 全 1 列向量:
求协方差矩阵
-
从矩阵 B 与其自身的外积求 经验协方差矩阵 C:
其中 * 是共轭转置算子。注意,如果 B 完全由实数组成(许多应用中都是这种情况),“共轭转置”与常规转置相同。
求协方差矩阵的特征向量和特征值
-
计算使协方差矩阵 C 对角化的特征向量矩阵 V:
其中 D 是 C 特征值的对角矩阵。
-
矩阵 D 将采取 对角矩阵的形式:
这里, 是协方差矩阵 C 的第 j 个特征值。
-
矩阵 V 也是 p x p 维的,包含 p 个列向量,每个长度为 p,它们表示协方差矩阵 C 的 p 个特征向量。
-
特征值和特征向量是有序且成对的。第 j 个特征值对应第 j 个特征向量。
注意: 来源 [1]、[2],特别感谢 Svetlin Penkov 提供原始教程。
-
可下载代码:点击 这里
-
代码一览: 代码见下方示例
-
可下载代码:点击 这里
-
代码一览: 代码见下方示例
-
可下载代码:点击 这里
-
代码一览: 代码见下方示例 注意: 在保持一定方差的同时使用 PCA 进行降维的另一个示例可以在 opencv_source_code/samples/cpp/pca.cpp 中找到。
- 读取图像并将其转换为二值图像
在这里,我们应用必要的预处理过程,以便能够检测感兴趣的目标。
- 提取感兴趣的目标
然后按尺寸查找并过滤轮廓,并获取其余目标的朝向。
- 提取朝向
朝向通过调用 getOrientation() 函数提取,该函数执行所有 PCA 过程。
首先,数据需要排列在一个大小为 n x 2 的矩阵中,其中 n 是我们拥有的数据点数量。然后我们可以执行 PCA 分析。计算出的均值(即质心)存储在 cntr 变量中,特征向量和特征值存储在相应的 std::vector 中。
- 可视化结果
最终结果通过 drawAxis() 函数可视化,其中主成分以线条绘制,每个特征向量乘以其特征值并平移到均值位置。
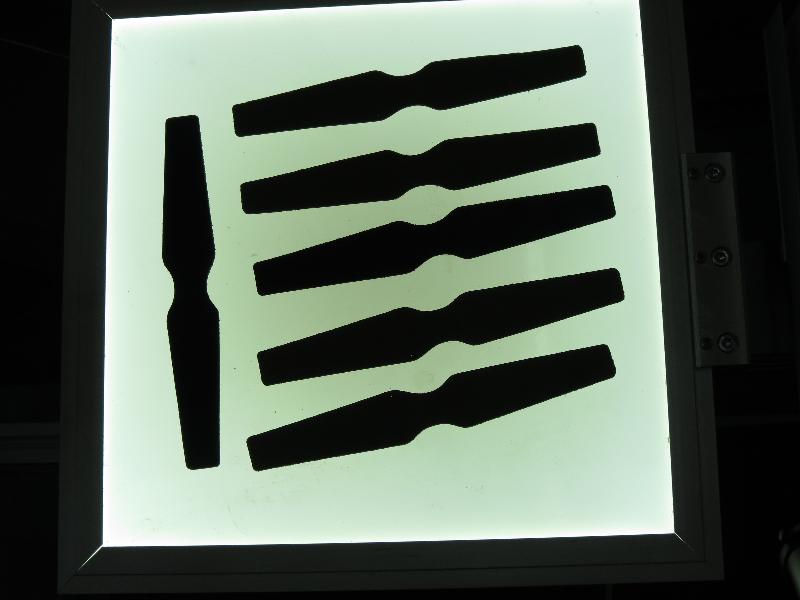
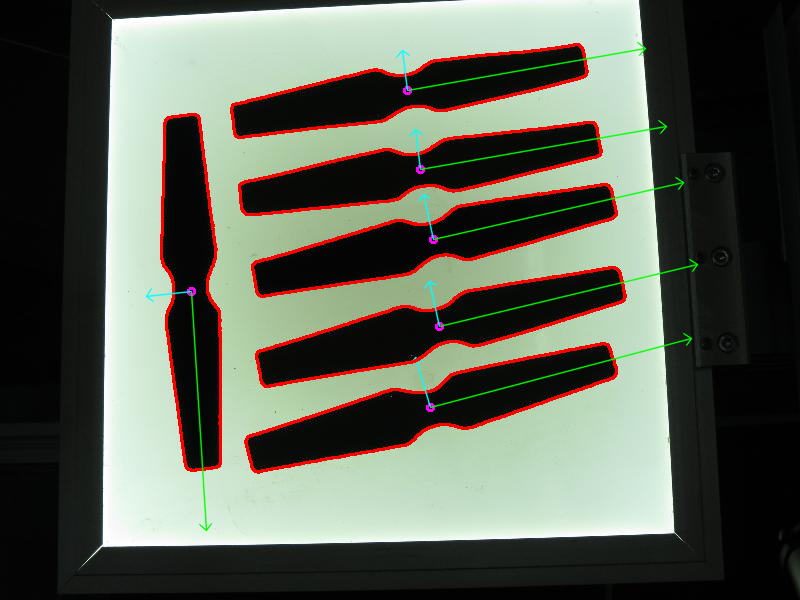
代码打开一张图像,找到检测到的感兴趣目标的朝向,然后通过绘制检测到的感兴趣目标的轮廓、中心点以及与所提取朝向相关的 x 轴、y 轴来可视化结果。