
Python 工程进阶
Python 是 AI 领域最常用的编程语言,但 “能写 Python” 和 “能写出生产级 Python 工程” 之间有着巨大的鸿沟。本页聚焦于将 Python 从”脚本工具”提升到”工程语言”所需的核心技能:类型安全的 Pydantic 数据模型、并发编程的三把利器(线程、进程、协程)、结构化日志、以及类型注解与静态检查。这些内容是后续 AI 后端开发 和 数据库与中间件 的直接前置知识——FastAPI 的请求体验证依赖 Pydantic,高并发推理服务依赖 asyncio,生产排障依赖日志体系。
如果你对 Python 的基础语法和标准库尚不熟悉,建议先阅读 工程开发基础。本页假设你已经具备 Python 中级以上水平,能够独立写出装饰器、上下文管理器,并理解 with 语句和迭代器协议。
核心直觉:四个工程问题的映射
Section titled “核心直觉:四个工程问题的映射”在正式深入之前,先建立一张全景图——为什么这五个主题(Pydantic、并发、Async、日志、类型注解)被归在一起?因为它们恰好解决 Python 在生产环境中面临的四个核心问题:
一句话总结:Pydantic 保证数据进系统时是对的,类型注解保证代码写出来是对的,并发模型保证跑得快,日志保证出了问题能查。
Pydantic:类型安全的数据验证
Section titled “Pydantic:类型安全的数据验证”为什么需要 Pydantic
Section titled “为什么需要 Pydantic”在 AI 工程中,数据从四面八方涌来:用户 API 请求、配置文件、数据库查询结果、模型推理输出。如果用裸 dict 传递数据,你会在代码的各个角落写 data.get("name", "")、data["age"] 这样的防御性代码,既冗长又容易遗漏边界情况。
Pydantic(派生自 “pydantic” = Python + pedantic,意为”学究式的”,强调对类型的严格态度)通过 Python 类型注解定义数据模型(Schema),在数据进入时自动完成类型转换、验证和序列化。它是 FastAPI、LangChain、OpenAI SDK、Hugging Face 等几乎所有现代 Python 框架的底层依赖。
Pydantic v2:Rust 内核带来的 5–50x 性能飞跃
Section titled “Pydantic v2:Rust 内核带来的 5–50x 性能飞跃”2023 年 6 月,Pydantic v2 正式发布。最大的变化是核心验证引擎用 Rust 重写(即 pydantic-core 包),Python 层只保留 API 兼容。这意味着:
| 指标 | Pydantic v1 | Pydantic v2 | 提升幅度 |
|---|---|---|---|
| 模型实例化速度 | 基准 | 5–20x | 显著 |
序列化(model_dump) | 基准 | 10–50x | 极大 |
| 类型验证(复杂嵌套) | 基准 | 5–15x | 显著 |
| 内存占用 | 基准 | 减少 30–50% | 明显 |
为什么用 Rust? Pydantic v1 的验证逻辑完全用 Python 实现,每次验证都要遍历类型注解、做运行时反射(runtime reflection,即程序在运行时检查自身类型信息的能力),开销巨大。Rust 是一门系统级语言,零成本抽象、无 GIL 限制,编译为原生机器码后速度接近 C 语言。Pydantic 团队将热路径(hot path,即程序中执行最频繁的代码路径)用 Rust 重写后,验证性能直接对标 C 扩展。
BaseModel 定义与字段验证
Section titled “BaseModel 定义与字段验证”from pydantic import BaseModel, Field, field_validator, model_validatorfrom datetime import datetimefrom typing import Literal
class UserModel(BaseModel): """用户数据模型——展示 Pydantic v2 的核心功能。"""
# 基本字段定义,Field 提供约束和描述 user_id: int = Field(..., gt=0, description="用户 ID,必须为正整数") name: str = Field(..., min_length=1, max_length=50) email: str role: Literal["admin", "user", "guest"] = "user" # 字面量类型,限定取值 created_at: datetime = Field(default_factory=datetime.now)
# Pydantic v2 的嵌套模型自动支持 preferences: dict[str, str] = Field(default_factory=dict)
# 字段级验证器:在类型转换之后、模型组装之前执行 @field_validator("email") @classmethod def validate_email(cls, v: str) -> str: if "@" not in v: raise ValueError("邮箱格式不正确,缺少 @ 符号") return v.lower().strip() # 可以对值做规范化处理
# 模型级验证器:在所有字段验证通过后执行,可以跨字段校验 @model_validator(mode="after") def validate_model(self) -> "UserModel": if self.role == "admin" and self.name.startswith("guest_"): raise ValueError("admin 角色不能以 guest_ 开头") return self
# --- 使用示例 ---user = UserModel( user_id=42, name="Alice", email=" ALICE@Example.COM ", role="admin",)print(user)# user_id=42 name='Alice' email='alice@example.com' role='admin' ...
# 验证失败时,Pydantic 抛出 ValidationError,包含详细的错误位置try: bad = UserModel(user_id=-1, name="", email="no-at-sign")except Exception as e: print(type(e).__name__) # ValidationError # 错误信息包含每个字段的具体问题序列化与反序列化(v2 新 API)
Section titled “序列化与反序列化(v2 新 API)”Pydantic v2 重命名了核心方法,旧 API 已弃用但暂可用(会发出 DeprecationWarning):
# === 序列化(模型 -> 字典/JSON)===d = user.model_dump()           # v1: .dict()——返回 Python dictj = user.model_dump_json()      # v1: .json()——返回 JSON 字符串d_exclude = user.model_dump(exclude={"email"})  # 排除敏感字段
# === 反序列化(数据 -> 模型)===user2 = UserModel.model_validate(d)          # v1: .parse_obj()——从 dict 构造user3 = UserModel.model_validate_json(j)     # v1: .parse_raw()——从 JSON 字符串构造
# === 从 ORM 对象构造(常见于数据库层)===# class UserORM:  # 假设这是 SQLAlchemy 模型#     ...# user4 = UserModel.model_validate(user_orm, from_attributes=True)
与 FastAPI 的关系:FastAPI 的请求体验证、响应序列化、自动生成 OpenAPI 文档——全部基于 Pydantic。你定义一个
class CreateUserRequest(BaseModel),FastAPI 自动完成:JSON 解析 → 类型验证 → 注入到路由函数 → 返回时序列化回 JSON。整个过程零样板代码。详见 AI 后端开发。
性能对比实测
Section titled “性能对比实测”import timefrom pydantic import BaseModel
class BigModel(BaseModel): items: list[int] metadata: dict[str, str]
data = {"items": list(range(10000)), "metadata": {f"k{i}": f"v{i}" for i in range(100)}}
# Pydantic v2 的实测性能start = time.perf_counter()for _ in range(1000): m = BigModel(**data) _ = m.model_dump()elapsed = time.perf_counter() - startprint(f"1000 次验证+序列化: {elapsed:.3f}s")# Pydantic v2 典型结果: ~0.5s# Pydantic v1 典型结果: ~5-8s(10x 差距)多线程 / 多进程与 GIL
Section titled “多线程 / 多进程与 GIL”GIL:CPython 的”交通灯”
Section titled “GIL:CPython 的”交通灯””GIL(Global Interpreter Lock,全局解释器锁)是 CPython(Python 的官方参考实现)内部的一把互斥锁。它的作用是:在任何时刻,只允许一个线程执行 Python 字节码。
为什么有 GIL? CPython 的内存管理使用引用计数(reference counting)——每个对象内部有一个计数器,记录有多少引用指向它。当计数器归零时,对象立即被回收。如果多个线程同时修改计数器,会产生竞态条件(race condition)。GIL 是最简单的解决方案:用一把全局锁串行化所有 Python 对象操作。这简化了 C 扩展的编写,但代价是多线程无法利用多核 CPU。
threading vs multiprocessing:何时用哪个
Section titled “threading vs multiprocessing:何时用哪个”| 维度 | threading / ThreadPoolExecutor | multiprocessing / ProcessPoolExecutor |
|---|---|---|
| 适用场景 | IO 密集(网络请求、文件读写、数据库查询) | CPU 密集(数值计算、图像处理、模型推理) |
| GIL 影响 | 受 GIL 限制,无法并行执行 Python 代码 | 独立进程,各自有自己的 GIL,真正并行 |
| 内存共享 | 线程共享内存空间,数据共享简单 | 进程独立内存空间,需用 Queue/Manager 通信 |
| 启动开销 | 轻量(~微秒级) | 重量(~毫秒级,需 fork/spawn 子进程) |
| 稳定性 | 线程崩溃可能影响主进程 | 子进程崩溃不影响主进程(隔离性好) |
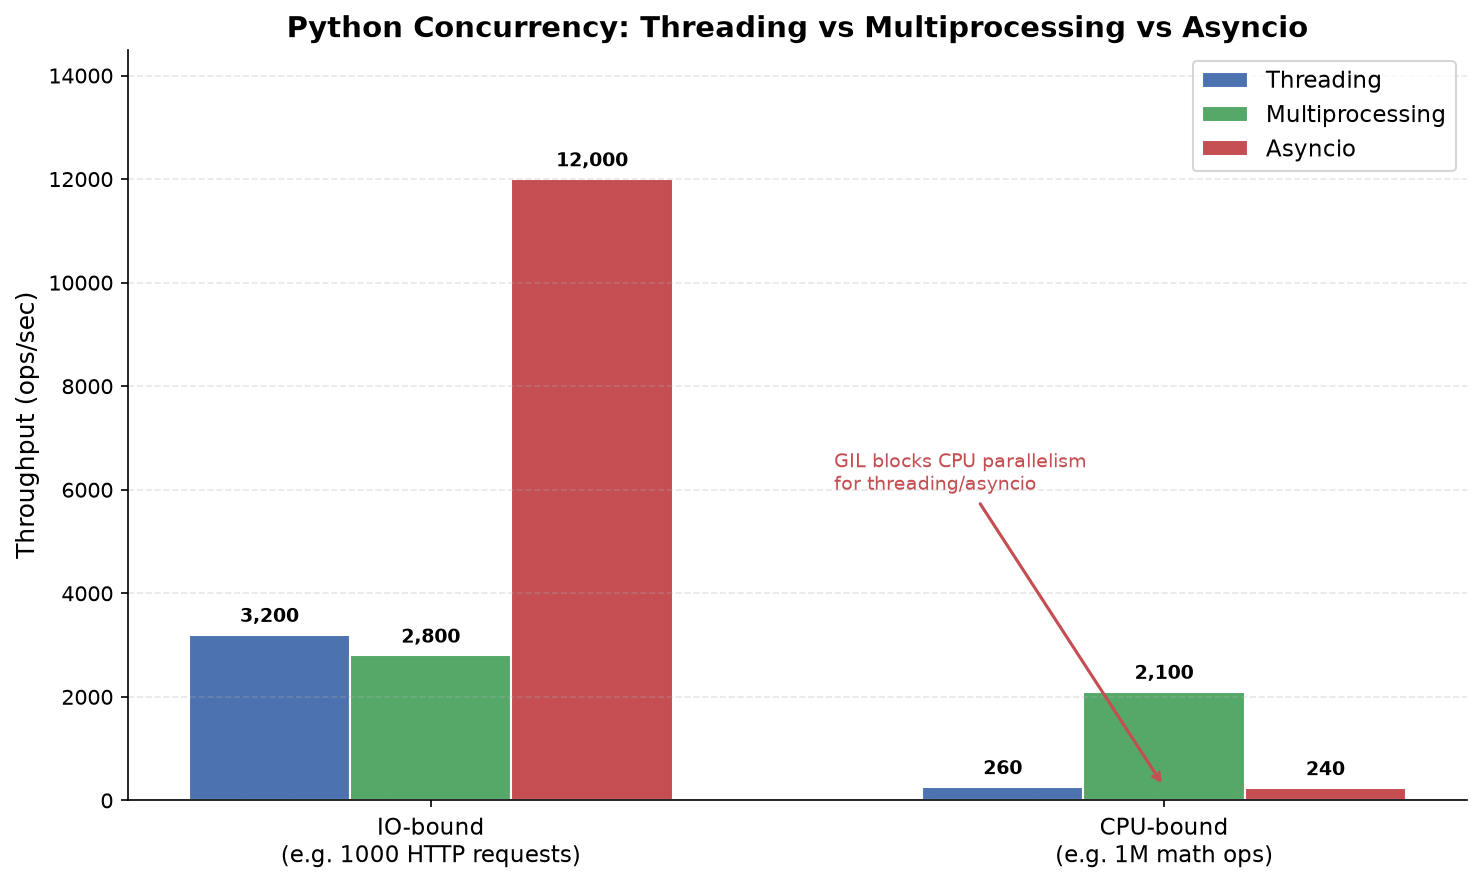
从图中可以清晰看到:对于 IO 密集型任务,asyncio 凭借极低的切换开销遥遥领先;对于 CPU 密集型任务,只有 multiprocessing 能突破 GIL 限制实现真正的并行加速。
代码示例:concurrent.futures 统一接口
Section titled “代码示例:concurrent.futures 统一接口”Python 标准库的 concurrent.futures 提供了线程池和进程池的统一接口,是日常并发编程的首选:
import timeimport requestsfrom concurrent.futures import ThreadPoolExecutor, ProcessPoolExecutor, as_completed
# ============================================================# 场景一:IO 密集——并发下载 100 个网页(用线程池)# ============================================================def fetch_url(url: str) -> tuple[str, int]:    """下载单个 URL,返回 (URL, 状态码)。"""    resp = requests.get(url, timeout=10)    return url, resp.status_code
urls = [f"https://httpbin.org/delay/{i % 3}" for i in range(50)]
# 串行下载(基准)start = time.perf_counter()results_serial = [fetch_url(u) for u in urls]serial_time = time.perf_counter() - startprint(f"串行下载 50 个 URL: {serial_time:.2f}s")
# 并发下载(线程池)start = time.perf_counter()with ThreadPoolExecutor(max_workers=20) as executor:    futures = {executor.submit(fetch_url, u): u for u in urls}    results_thread = [f.result() for f in as_completed(futures)]thread_time = time.perf_counter() - startprint(f"线程池并发下载 50 个 URL: {thread_time:.2f}s "      f"(加速比: {serial_time / thread_time:.1f}x)")
# ============================================================# 场景二:CPU 密集——并行计算大量数值(用进程池)# ============================================================def cpu_intensive_task(n: int) -> int:    """计算素数个数——纯 CPU 计算。"""    count = 0    for i in range(2, n):        if all(i % j != 0 for j in range(2, int(i ** 0.5) + 1)):            count += 1    return count
tasks = [500_000] * 8  # 8 个相同的计算任务
# 串行计算start = time.perf_counter()serial_results = [cpu_intensive_task(n) for n in tasks]serial_cpu_time = time.perf_counter() - startprint(f"\n串行 CPU 计算 8 个任务: {serial_cpu_time:.2f}s")
# 多进程并行start = time.perf_counter()with ProcessPoolExecutor() as executor: # 默认使用 CPU 核心数 parallel_results = list(executor.map(cpu_intensive_task, tasks))parallel_cpu_time = time.perf_counter() - startprint(f"多进程并行 8 个任务: {parallel_cpu_time:.2f}s " f"(加速比: {serial_cpu_time / parallel_cpu_time:.1f}x)")# 典型结果:4 核机器上加速比约 3.5x(接近线性加速)关键区别:如果把上面的 CPU 密集任务换成
ThreadPoolExecutor,你会发现加速比接近 1.0x(甚至更慢)——因为 GIL 让线程无法并行执行 Python 字节码,线程只是”轮流”跑在一个核心上。这就是为什么 CPU 密集任务必须用多进程。
Python 3.13+ 的 Free-Threading 实验
Section titled “Python 3.13+ 的 Free-Threading 实验”2024 年 10 月发布的 Python 3.13 引入了实验性的 free-threading(自由线程,即无 GIL 模式)构建选项。这是 PEP 703 提出的重大变革:通过引入偏向锁(biased locking)和新的内存管理机制,使得多个线程可以真正并行执行 Python 代码。
# 安装 free-threading 版本(实验性,2026 年前不建议生产使用)# 需要从源码编译,或使用 python-build-standalone 的 free-threading 构建python3.13t --version  # 注意 't' 后缀表示 free-threading 构建
# 验证 GIL 是否禁用python3.13t -c "import sys; print(sys._is_gil_enabled())"# False 表示 GIL 已禁用| 阶段 | 版本 | GIL 状态 | 状态 |
|---|---|---|---|
| 现状 | Python 3.12 及以下 | 始终启用 GIL | 稳定 |
| 实验期 | Python 3.13(2024.10) | 可选禁用(实验构建) | 早期实验 |
| 推进期 | Python 3.14(2025.10) | 改进稳定性、性能 | 测试可用 |
| 成熟期 | Python 3.15+(2026+) | 目标:默认无 GIL | 路线图 |
对 AI 工程的影响:free-threading 成熟后,多线程训练数据预处理、多模型推理等 CPU 密集场景将不再需要多进程的沉重开销。NumPy、PyTorch 等 C 扩展本身已经不受 GIL 影响(它们在 C 层释放 GIL),但纯 Python 层的数据增强逻辑目前仍受 GIL 约束。
Async / Asyncio:事件循环驱动的并发
Section titled “Async / Asyncio:事件循环驱动的并发”事件循环:单线程内的”任务调度器”
Section titled “事件循环:单线程内的”任务调度器””asyncio 的核心是事件循环(event loop)——一个不断检查”哪些任务准备好了”的调度器。与多线程的区别在于:线程的切换由操作系统抢占式调度,而协程(coroutine)的切换由程序自己协作式调度,切换开销极低(纳秒级 vs 线程的微秒级)。
协程 vs 线程的核心区别:线程由 OS 内核调度,切换时需要保存/恢复寄存器、页表等(开销约 1–10μs);协程在用户空间切换,只需保存 Python 栈帧(开销约 100ns)。在处理 10,000 个并发连接时,1 万个线程的内存开销约为 10 GB(每个线程默认栈 1 MB),而 1 万个协程仅需约 100 MB。
async/await 语法
Section titled “async/await 语法”import asyncioimport aiohttp # 异步 HTTP 客户端库:pip install aiohttp
async def fetch_json(session: aiohttp.ClientSession, url: str) -> dict: """异步获取 JSON 数据。遇到网络 IO 时自动让出控制权。""" async with session.get(url) as response: return await response.json()
async def fetch_all(urls: list[str]) -> list[dict]: """并发获取多个 URL 的数据——所有请求几乎同时发出。""" async with aiohttp.ClientSession() as session: # asyncio.gather:并发执行多个协程,等待全部完成 tasks = [fetch_json(session, url) for url in urls] results = await asyncio.gather(*tasks) return results
# 运行事件循环urls = [ "https://httpbin.org/json", "https://httpbin.org/json", "https://httpbin.org/json",]data = asyncio.run(fetch_all(urls)) # asyncio.run 创建并关闭事件循环print(f"获取了 {len(data)} 条数据")asyncio.TaskGroup(Python 3.11+)
Section titled “asyncio.TaskGroup(Python 3.11+)”TaskGroup 是 Python 3.11 引入的更安全的并发原语,取代了直接使用 asyncio.gather 的模式:
async def fetch_all_safe(urls: list[str]) -> list[dict]:    """使用 TaskGroup——如果一个任务失败,其余任务会被自动取消。"""    results: list[dict] = []
    async with aiohttp.ClientSession() as session:        async with asyncio.TaskGroup() as tg:  # 结构化并发            tasks = [tg.create_task(fetch_json(session, url)) for url in urls]        # 退出 with 块时,所有任务已完成(或抛出 ExceptionGroup)        results = [t.result() for t in tasks]
return results结构化并发(Structured Concurrency)的核心思想:并发任务必须有明确的生命周期边界——进入
async with块时启动,退出时必须全部完成或全部取消。这避免了”遗漏的协程”在后台默默运行导致的资源泄漏。
何时该用 asyncio(何时该用线程)
Section titled “何时该用 asyncio(何时该用线程)”| 信号 | 推荐方案 |
|---|---|
| 高并发网络请求(1000+ 连接) | asyncio——协程开销最低 |
调用已有同步库(如 requests、boto3) | 线程池——不需要改写已有代码 |
| 混合 IO + CPU | asyncio + ProcessPoolExecutor(loop.run_in_executor) |
| 团队不熟悉 async 语法 | 线程池——更简单,async 的传染性(async “infection”)会导致整个调用链都要 async |
async 的”传染性”:一旦某个函数标记为
async,所有调用它的函数也必须async,层层蔓延。这是 async 编程最大的工程成本。在大型项目中,通常会在架构层面明确划分 async 边界(如 Web 层全 async,业务逻辑层同步)。
Logging:结构化日志与 loguru
Section titled “Logging:结构化日志与 loguru”标准库 logging 的四大组件
Section titled “标准库 logging 的四大组件”Python 内置的 logging 库设计良好但配置繁琐,理解其四大组件是基础:
import loggingimport sys
# 标准库 logging 的基础配置(生产环境通常用 dictConfig)logger = logging.getLogger("my_app")logger.setLevel(logging.DEBUG)
# 控制台 Handlerconsole_handler = logging.StreamHandler(sys.stdout)console_handler.setLevel(logging.INFO)
# 文件 Handler(带轮转)from logging.handlers import RotatingFileHandlerfile_handler = RotatingFileHandler(    "app.log", maxBytes=10 * 1024 * 1024, backupCount=5  # 10MB 轮转,保留 5 个)
# 格式化器formatter = logging.Formatter(    "%(asctime)s | %(name)s | %(levelname)s | %(message)s")console_handler.setFormatter(formatter)file_handler.setFormatter(formatter)
logger.addHandler(console_handler)logger.addHandler(file_handler)
logger.info("服务启动完成")logger.warning("缓存命中率低于 50%%")logger.error("数据库连接失败", exc_info=True)  # exc_info=True 记录异常堆栈
结构化日志:为什么 JSON 是生产标配
Section titled “结构化日志:为什么 JSON 是生产标配”传统的文本日志(如 2025-01-15 INFO User logged in)对人友好,但对机器不友好。在生产环境中,日志通常被采集到 ELK(Elasticsearch + Logstash + Kibana)、Loki 或 CloudWatch 等系统,需要能被精确搜索和聚合。
结构化日志(structured logging)将每条日志输出为 JSON 对象,每个字段都可独立查询:
import jsonimport logging
class JSONFormatter(logging.Formatter):    """自定义 JSON 格式化器——生产环境推荐。"""
    def format(self, record: logging.LogRecord) -> str:        log_data = {            "timestamp": self.formatTime(record),            "level": record.levelname,            "logger": record.name,            "message": record.getMessage(),            "module": record.module,            "line": record.lineno,        }        # 附加额外字段(通过 extra 参数传入)        if hasattr(record, "user_id"):            log_data["user_id"] = record.user_id        if hasattr(record, "request_id"):            log_data["request_id"] = record.request_id        if record.exc_info:            log_data["exception"] = self.formatException(record.exc_info)        return json.dumps(log_data, ensure_ascii=False)
# 使用json_handler = logging.StreamHandler()json_handler.setFormatter(JSONFormatter())logger = logging.getLogger("api")logger.addHandler(json_handler)
# 可以附加结构化字段logger.info("用户登录", extra={"user_id": 42, "request_id": "req-abc-123"})# 输出: {"timestamp": "...", "level": "INFO", "message": "用户登录", "user_id": 42, "request_id": "req-abc-123", ...}
loguru:零配置的日志体验
Section titled “loguru:零配置的日志体验”loguru 是一个第三方日志库,核心理念是”开箱即用”——不需要配置 Handler/Formatter,一行代码就能用:
# pip install logurufrom loguru import logger
# 零配置直接使用logger.info("Hello from loguru!")logger.warning("这是警告")logger.error("这是错误")
# 自动带颜色、时间、模块名、行号、函数名# 2025-01-15 10:30:45.123 | INFO     | __main__:<module>:3 - Hello from loguru!
# === Sink 机制:灵活的日志输出目标 ===logger.add("app.log", rotation="10 MB", retention="7 days", compression="zip")# rotation: 文件达到 10 MB 自动轮转# retention: 保留 7 天的日志# compression: 旧日志自动压缩为 zip
# 输出到远程服务(如 Logtail、Datadog)logger.add(    "https://logs.example.com/ingest",    format="{message}",  # 自定义格式    level="ERROR",       # 只推送 ERROR 及以上    serialize=True,      # 序列化为 JSON)
# 异常记录——自动捕获完整堆栈和变量值@logger.catch  # 装饰器:自动捕获异常并记录详细堆栈def risky_function():    return 1 / 0
# 结构化日志——loguru 的 .bind() 方法logger.bind(user_id=42, action="login").info("用户操作")# 输出包含 user_id 和 action 字段,便于后续过滤
loguru vs logging 取舍:如果项目从零开始且团队不大,loguru 大幅减少配置样板代码。但如果项目需要与第三方库的日志体系整合(如 uvicorn、celery 都用标准 logging),混用两套日志系统会增加复杂度。大型项目通常还是用标准 logging + JSON formatter。
类型注解与静态检查
Section titled “类型注解与静态检查”PEP 484 类型注解语法
Section titled “PEP 484 类型注解语法”Python 是动态类型语言,但 PEP 484(2014 年提出)引入了类型注解(type hints)——它们不影响运行时行为,但可以被静态分析工具(mypy、pyright)用来在编码阶段发现类型错误。
from typing import Optional, Union, Literal, Callable, Any
# 基本类型注解def greet(name: str, times: int = 1) -> str:    return f"Hello {name}! " * times
# 容器类型(Python 3.9+ 支持小写泛型,无需 typing.List)def process(items: list[int]) -> dict[str, float]:    return {str(i): float(i) for i in items}
# Optional 和 Uniondef find_user(user_id: int) -> Optional[dict]:  # 等价于 dict | None    ...
# Python 3.10+ 的 X | Y 语法(推荐)def parse(value: int | str | None) -> float:    ...
# Literal 类型:限定为特定值def set_mode(mode: Literal["train", "eval", "infer"]) -> None:    ...
# Callable 类型:函数签名from collections.abc import Callabledef apply(func: Callable[[int, int], int], a: int, b: int) -> int:    return func(a, b)
Generic、Protocol 与 TypeVar:高级类型工具
Section titled “Generic、Protocol 与 TypeVar:高级类型工具”from typing import TypeVar, Generic, Protocol
# === TypeVar:泛型类型变量 ===T = TypeVar("T")
def first(items: list[T]) -> T: # 输入输出类型一致 return items[0]
# === Generic:自定义泛型类 ===class Stack(Generic[T]): """类型安全的栈——push 和 pop 的元素类型一致。""" def __init__(self) -> None: self._items: list[T] = []
def push(self, item: T) -> None: self._items.append(item)
def pop(self) -> T: return self._items.pop()
# 使用时指定具体类型int_stack: Stack[int] = Stack()int_stack.push(42)value = int_stack.pop() # mypy 推断 value: int
# === Protocol:结构化子类型(鸭子类型的静态版本)===class Closeable(Protocol): """任何有 close() 方法的类型都符合此 Protocol。""" def close(self) -> None: ...
def cleanup(resource: Closeable) -> None: resource.close() # 不需要继承,只要有 close 方法即可
class FileResource: def close(self) -> None: print("文件已关闭")
cleanup(FileResource()) # 类型检查通过!Protocol vs ABC:传统的 ABC(Abstract Base Class)要求显式继承(
class FileResource(Closeable)),而 Protocol 只要求结构匹配(鸭子类型)。Protocol 更灵活,特别适合为已有第三方库定义接口。
mypy 与 pyright:静态类型检查
Section titled “mypy 与 pyright:静态类型检查”# 安装pip install mypy# 或使用更快的 pyright(微软出品,VS Code Pylance 底层)npm install -g pyright
# 检查单个文件mypy my_script.py
# 检查整个项目(配置在 mypy.ini 或 pyproject.toml)mypy .
# pyright(速度更快,类型推断更智能)pyright my_script.py项目级配置示例(pyproject.toml):
[tool.mypy]python_version = "3.12"strict = true              # 开启严格模式(最严格的类型检查)warn_return_any = true     # 警告返回 Any 类型的函数disallow_untyped_defs = true  # 禁止未注解的函数定义
[[tool.mypy.overrides]]module = "tests.*"disallow_untyped_defs = false  # 测试代码可以不注解
运行时类型检查:typeguard 与 Pydantic
Section titled “运行时类型检查:typeguard 与 Pydantic”mypy/pyright 是静态检查——它们在代码运行前分析类型。但有些类型信息到运行时才能确定(如反序列化 JSON 后的数据),这时需要运行时检查:
# pip install typeguardfrom typeguard import typechecked
@typecheckeddef process_scores(scores: list[int]) -> float:    """运行时会检查参数类型,不匹配则抛出 TypeError。"""    return sum(scores) / len(scores)
process_scores([90, 85, 92])  # 正常process_scores([90, "85", 92])  # TypeError: 类型不匹配
# 对于数据验证场景,Pydantic 是更好的选择(同时做转换和验证)from pydantic import BaseModel
class ScoreReport(BaseModel):    student: str    scores: list[int]
# Pydantic 会尝试将字符串 "85" 转换为 int,转换失败才报错report = ScoreReport(student="Alice", scores=[90, "85", 92])print(report.scores)  # [90, 85, 92]——自动类型转换
实践要点速查
Section titled “实践要点速查”并发模型选择决策树
Section titled “并发模型选择决策树”常见陷阱与最佳实践
Section titled “常见陷阱与最佳实践”陷阱 1:在 async 函数中调用同步阻塞 IO
# ❌ 错误:requests 是同步库,会阻塞整个事件循环async def bad_fetch(url):    import requests    return requests.get(url).json()  # 阻塞!其他协程全部卡住
# ✅ 正确:用 aiohttp 或 httpx 的异步模式async def good_fetch(url):    async with aiohttp.ClientSession() as session:        async with session.get(url) as resp:            return await resp.json()
# ✅ 妥协:用 run_in_executor 将同步调用放入线程池async def acceptable_fetch(url):    import requests    loop = asyncio.get_event_loop()    return await loop.run_in_executor(None, lambda: requests.get(url).json())
陷阱 2:多进程共享状态
# ❌ 错误:multiprocessing 中全局变量不会共享shared_counter = 0def increment():    global shared_counter    shared_counter += 1  # 每个进程有自己的副本,不会累加
# ✅ 正确:使用 Manager 提供的进程安全共享对象from multiprocessing import Manager, Process
with Manager() as manager:    shared_counter = manager.Value("i", 0)    lock = manager.Lock()
    def safe_increment(counter, lock):        with lock:            counter.value += 1
    processes = [Process(target=safe_increment, args=(shared_counter, lock))                 for _ in range(100)]    for p in processes: p.start()    for p in processes: p.join()    print(shared_counter.value)  # 100
陷阱 3:Pydantic v1 → v2 的静默行为变化
# Pydantic v1 中,字段默认值使用可变对象(如 list)时,会被所有实例共享# Pydantic v2 修复了这个问题,但一些旧的校验器行为发生了变化
# v1: @validator → v2: @field_validator(注意装饰器名字和用法变化)# v1: .dict() → v2: .model_dump()# v1: .parse_obj() → v2: .model_validate()# v1: Config 类 → v2: model_config 字典# 迁移时务必运行 pytest 全量测试
2025–2026 最新进展
Section titled “2025–2026 最新进展”Pydantic v2 生态全面成熟
Section titled “Pydantic v2 生态全面成熟”截至 2025 年中,FastAPI 0.110+、LangChain 0.2+、OpenAI Python SDK 1.x、Hugging Face Transformers 4.40+ 已全面适配 Pydantic v2。Pydantic 团队在 2025 年持续优化 pydantic-core 的性能,特别是在联合类型(Union)验证和大型嵌套模型场景下的速度。预计 v2 系列在 2026 年趋于稳定,新功能聚焦于 JSON Schema 生成和 OpenAPI 集成。
Python 3.13 Free-Threading 进入实用测试期
Section titled “Python 3.13 Free-Threading 进入实用测试期”Python 3.13(2024.10)和即将发布的 3.14(2025.10)持续推进 free-threading 的稳定性。截至 2025 年中,NumPy、PyTorch、Pillow 等核心库已开始在 free-threading 构建上进行测试。预计 3.15(2026 年)将提供性能接近 GIL 模式的 free-threading 构建,届时 AI 数据预处理管线将获得显著的多线程加速。
类型系统:PEP 695 类型参数语法
Section titled “类型系统:PEP 695 类型参数语法”Python 3.12 的 PEP 695 引入了全新的泛型定义语法,告别了 TypeVar + Generic 的繁琐写法:
# Python 3.12+ 的新语法(更简洁)class Stack[T]:           # 直接在类名后声明类型参数    def push(self, item: T) -> None: ...
def first[T](items: list[T]) -> T:  # 函数泛型也简化了    return items[0]
# type 语句定义类型别名(替代 TypeAlias)type Vector = list[float]type Matrix = list[Vector]
pyright 和 mypy 已全面支持新语法。到 2025–2026 年,新项目应优先使用 PEP 695 语法。
structured-concurrency 提案推进
Section titled “structured-concurrency 提案推进”PEP 768(2025 年草案)正在讨论为 asyncio 引入更完善的结构化并发支持,有望在 Python 3.14/3.15 中落地。这将使 TaskGroup 模式更加健壮,并与 Trio 和 AnyIO 等库的设计理念进一步统一。
| 术语 | 英文 | 解释 |
|---|---|---|
| 全局解释器锁 | GIL (Global Interpreter Lock) | CPython 中的互斥锁,同一时刻只允许一个线程执行 Python 字节码 |
| 自由线程 | Free-Threading | Python 3.13+ 的实验特性,可禁用 GIL 实现真正的多线程并行 |
| 事件循环 | Event Loop | asyncio 的核心调度器,不断检查并执行就绪的协程任务 |
| 协程 | Coroutine | 可在特定点挂起和恢复的函数,由事件循环调度执行 |
| 结构化并发 | Structured Concurrency | 并发任务有明确生命周期边界的编程范式,如 TaskGroup |
| 数据验证 | Data Validation | 在数据进入系统时检查其类型、格式和约束的过程 |
| 序列化 | Serialization | 将内存中的对象转换为可存储/传输的格式(如 JSON)的过程 |
| 引用计数 | Reference Counting | CPython 的内存管理机制,跟踪指向对象的引用数量 |
| 静态类型检查 | Static Type Checking | 在代码运行前分析类型正确性的工具,如 mypy、pyright |
| 类型注解 | Type Hints | PEP 484 定义的语法,为函数参数和返回值标注类型 |
| 协议 | Protocol | PEP 544 定义的结构化子类型,基于方法签名而非继承 |
| 类型变量 | TypeVar | 泛型编程中的类型占位符,用于表示”某种类型” |
| 结构化日志 | Structured Logging | 输出为 JSON 等机器可读格式的日志,便于搜索和聚合 |
| 日志轮转 | Log Rotation | 日志文件达到一定大小后自动创建新文件的机制 |
| 竞态条件 | Race Condition | 多线程/进程并发访问共享资源时导致的不确定行为 |
| 偏向锁 | Biased Locking | 一种锁优化策略,假设锁大多被同一线程持有,减少同步开销 |
- 官方文档:
- Pydantic v2 文档 — 完整的 v2 迁移指南和 API 参考
- Python asyncio 文档 — 标准库异步编程参考
- PEP 703 — Making the GIL Optional in CPython
- PEP 695 — Type Parameter Syntax
- 进阶阅读:
- FastAPI 官方文档 — 深入理解 Pydantic 与 Web 框架的结合,详见 AI 后端开发
- loguru GitHub — 零配置日志库的完整文档
- mypy 官方文档 — 类型检查器的使用手册
- 系列导航:本页是 AI 工程开发系列的第一篇。后续 AI 后端开发 将深入 FastAPI 构建推理服务,数据库与中间件 涵盖 Redis、消息队列等工程实践,MLOps 实践 讨论模型部署与监控。如需复习 Python 基础,请阅读 工程开发基础。