
激活函数
激活函数为神经网络引入非线性——没有它,不管堆叠多少层,整个网络等价于一个线性变换(矩阵连乘还是矩阵)。本页系统讲解从 Sigmoid 到现代 GELU/SiLU/Mish/SwiGLU 的激活函数谱系。前置阅读:梯度下降与优化器、损失函数。
线性坍缩的严格数学证明
Section titled “线性坍缩的严格数学证明”对于两层无激活函数的全连接网络,设第一层权重为 、偏置 ,第二层权重为 、偏置 ,输入 :
其中 ,。无论堆叠多少层,都可以合并成 。这意味着:
- 参数空间没有变大(N 层的权重本质上只用一个矩阵就能表示)
- 表达能力不增加(无论多少层,仍然只能表示线性映射)
- 深度没有意义(无法利用层次化抽象来降低复杂度)
只要在层间插入任意非线性激活函数 (如 ),上述合并就不再成立:
这就是激活函数在数学上的根本作用——阻断线性变换的可合并性,使网络深度真正发挥作用。
把激活函数想象成神经元的”触发开关”——它决定一个神经元在什么条件下”激活”(输出非零值)、以什么方式激活:
- Sigmoid= 温和的开关。把任意实数压到 (0, 1) 区间,像”概率旋钮”。但输入稍大或稍小梯度就近乎为零——这就是梯度消失(Vanishing Gradient:反向传播——即从损失向输出层逐层求导回传梯度——过程中,激活函数导数过小导致梯度逐层指数衰减,深层网络几乎学不动)。
- Tanh= 零中心的 Sigmoid。输出范围 (-1, 1),梯度比 Sigmoid 稍强(原点处导数为 1),但两端仍有消失问题。
- ReLU= 硬开关。正数原样通过、负数直接归零——简单、快、梯度不会消失(正区间梯度恒为 1)。缺点是”死亡 ReLU”(Dying ReLU:一旦某个神经元持续输出负数,梯度永远为 0,参数再也不会更新,相当于这个神经元永久”死亡”)。
- Leaky ReLU / PReLU= 给死亡 ReLU 留一条缝。负数不是归零而是乘一个小斜率(如 0.01),保证梯度不为零。PReLU 把斜率也设为可学习参数(反向传播时会自动调整)。
- GELU= 平滑版 ReLU。在 0 附近用高斯函数做平滑过渡(而非硬切),BERT/GPT 等 Transformer 的标配。
- SiLU / Swish= x * sigmoid(x)。Google 通过神经架构搜索(NAS:用机器学习自动搜索最优结构)发现的自适应激活函数,YOLOv8 等现代模型在用。
- Mish= x * tanh(softplus(x))。比 Swish 更平滑一点,在部分检测模型上有微小提升。
- SwiGLU= SiLU 门控的 GLU 变体。将 FFN 中的激活函数升级为门控机制(一条路径过 SiLU 激活,另一条路直通,两条逐元素相乘),LLaMA 2/3、PaLM、Mistral 等现代大语言模型的 FFN 标配。
为什么需要激活函数
Section titled “为什么需要激活函数”一个不加激活函数的全连接层只是线性变换:y = Wx + b。即使堆叠 N 层:
多次线性变换的复合仍然是线性变换,整个网络等价于一层。激活函数在层与层之间插入非线性,使网络能够拟合任意复杂的函数(万能逼近定理)。
Sigmoid
Section titled “Sigmoid”导数为 ,最大值仅 (在 时),这意味着反向传播时每经过一层梯度至少缩水 75%。深层网络中梯度指数衰减,即”梯度消失”。此外输出恒为正(非零均值),会导致下一层权重的梯度恒同号,更新路径呈锯齿形。现代深层网络很少在隐藏层用 Sigmoid,主要用于二分类输出层(输出概率)。
曲线特征:Sigmoid 曲线呈 S 形(Sigmoid 意即 “S-shaped”),值域为 ,在 处输出 。两端渐近线分别为 ( 趋向负无穷)和 ( 趋向正无穷),当输入绝对值大于 4 时曲线几乎水平——这正是梯度消失的直观来源。
import numpy as npimport matplotlib.pyplot as plt
x = np.linspace(-5, 5, 200)y = 1 / (1 + np.exp(-x))    # Sigmoid 函数
plt.figure(figsize=(8, 4))plt.plot(x, y, linewidth=2, label='Sigmoid')plt.axhline(0.5, color='gray', linestyle='--', alpha=0.5)  # 标记 y=0.5plt.axvline(0, color='gray', linestyle='--', alpha=0.5)    # 标记 x=0plt.xlabel('x')plt.ylabel('σ(x)')plt.title('Sigmoid 激活函数曲线')plt.legend()plt.grid(True, alpha=0.3)plt.savefig('sigmoid.png', dpi=150)plt.show()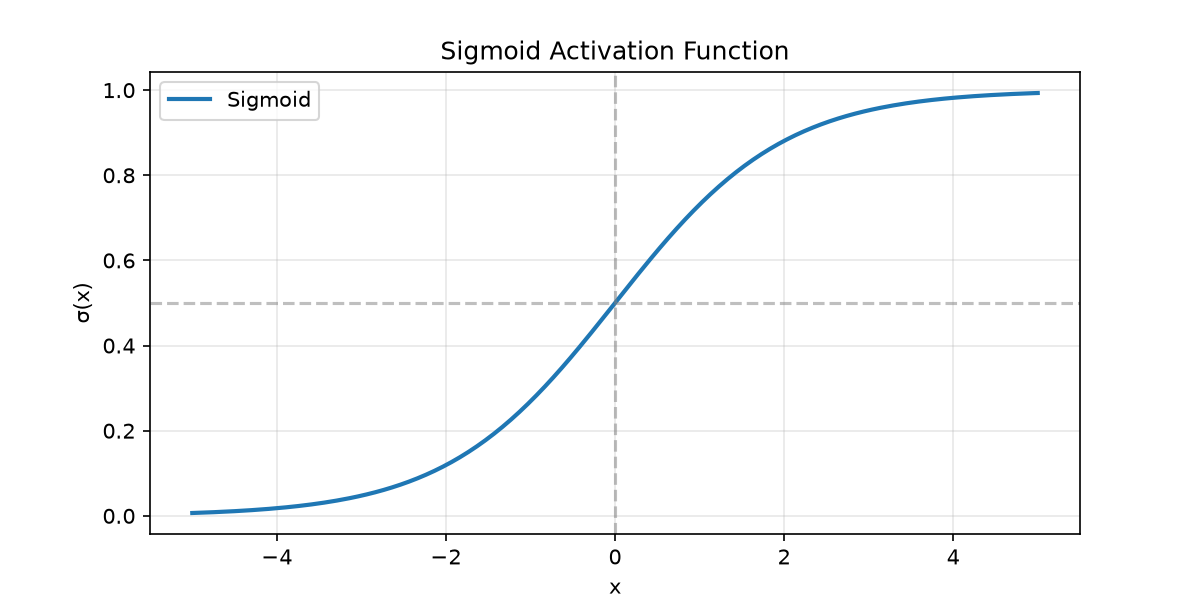
是零中心化的 Sigmoid(),导数最大值为 (在 时),比 Sigmoid 好,但两端仍有梯度消失问题。RNN / LSTM 中仍在用(如 LSTM 的门控)。
曲线特征:Tanh 曲线同样呈 S 形,但值域为 (-1, 1),在 x=0 处输出 0(零中心化)。两端渐近线分别为 y=-1 和 y=1,曲线通过原点且关于原点中心对称。与 Sigmoid 相比,Tanh 的斜率更陡、在原点处导数为 1(Sigmoid 仅 0.25),因此梯度传播效率更高。
import numpy as npimport matplotlib.pyplot as plt
x = np.linspace(-5, 5, 200)y = np.tanh(x)              # Tanh 函数
plt.figure(figsize=(8, 4))plt.plot(x, y, linewidth=2, color='orange', label='Tanh')plt.axhline(0, color='gray', linestyle='--', alpha=0.5)plt.axvline(0, color='gray', linestyle='--', alpha=0.5)plt.xlabel('x')plt.ylabel('tanh(x)')plt.title('Tanh 激活函数曲线')plt.legend()plt.grid(True, alpha=0.3)plt.savefig('tanh.png', dpi=150)plt.show()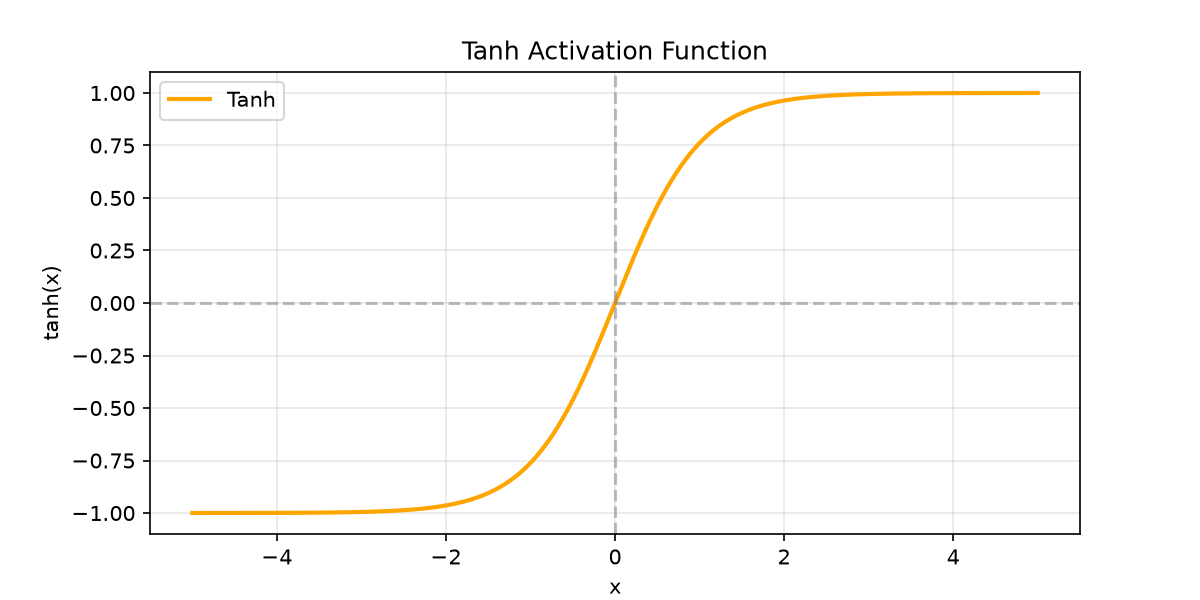
ReLU(Rectified Linear Unit)
Section titled “ReLU(Rectified Linear Unit)”正区间梯度恒为 1(梯度不消失!)、计算极快(只需一个 max 操作)。引入了网络的稀疏激活(负数输出 0),有正则化效果。缺点是”死亡 ReLU”问题:如果某个神经元的输入持续为负,梯度恒为 0,参数不再更新。此外 ReLU 不是零中心化(输出恒非负)。ReLU 是 CNN 训练的默认激活函数。
曲线特征:ReLU 曲线在 x 小于 0 时恒为 0(水平线),在 x 大于 0 时 y=x(斜率为 1 的直线),在原点处形成一个硬折角。值域为 [0, +∞)。这个硬折角虽不可导,但实践中用次梯度(subgradient)处理即可,不影响训练。
import numpy as npimport matplotlib.pyplot as plt
x = np.linspace(-5, 5, 200)y = np.maximum(0, x)       # ReLU 函数
plt.figure(figsize=(8, 4))plt.plot(x, y, linewidth=2, color='green', label='ReLU')plt.axhline(0, color='gray', linestyle='--', alpha=0.5)plt.axvline(0, color='gray', linestyle='--', alpha=0.5)plt.xlabel('x')plt.ylabel('ReLU(x)')plt.title('ReLU 激活函数曲线')plt.legend()plt.grid(True, alpha=0.3)plt.savefig('relu.png', dpi=150)plt.show()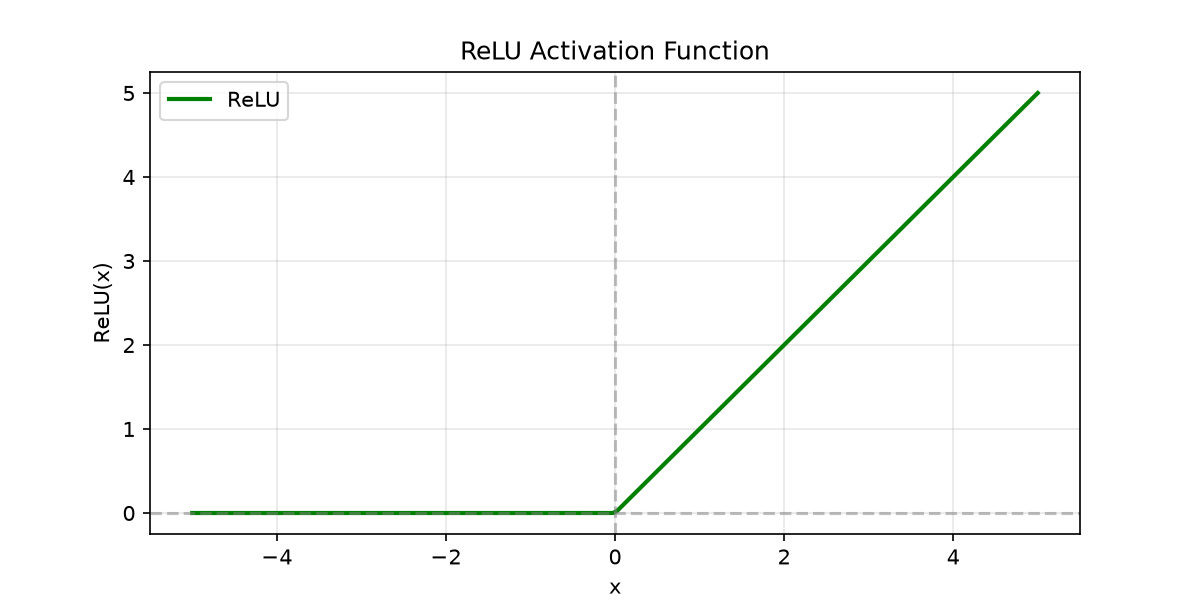
Leaky ReLU / PReLU
Section titled “Leaky ReLU / PReLU”负区间引入一个小斜率 α,保证梯度非零,解决死亡 ReLU。PReLU(Parametric ReLU)把 α 也作为可学习参数,让网络自己决定负区间的斜率。在图像分类等任务上有微小提升。
曲线特征:Leaky ReLU 曲线在 x 大于 0 时与 ReLU 完全一致(y=x),在 x 小于 0 时不再水平归零,而是一条斜率为 α(如 0.01)的略微下倾的直线。值域为 (-∞, +∞)。负区间的微弱斜率让”死亡”神经元仍能保留非零梯度,从而有机会恢复更新。
import numpy as npimport matplotlib.pyplot as plt
alpha = 0.01x = np.linspace(-5, 5, 200)y = np.where(x >= 0, x, alpha * x)   # Leaky ReLU 函数
plt.figure(figsize=(8, 4))plt.plot(x, y, linewidth=2, color='red', label=f'Leaky ReLU (α={alpha})')plt.axhline(0, color='gray', linestyle='--', alpha=0.5)plt.axvline(0, color='gray', linestyle='--', alpha=0.5)plt.xlabel('x')plt.ylabel('LeakyReLU(x)')plt.title('Leaky ReLU 激活函数曲线')plt.legend()plt.grid(True, alpha=0.3)plt.savefig('leaky_relu.png', dpi=150)plt.show()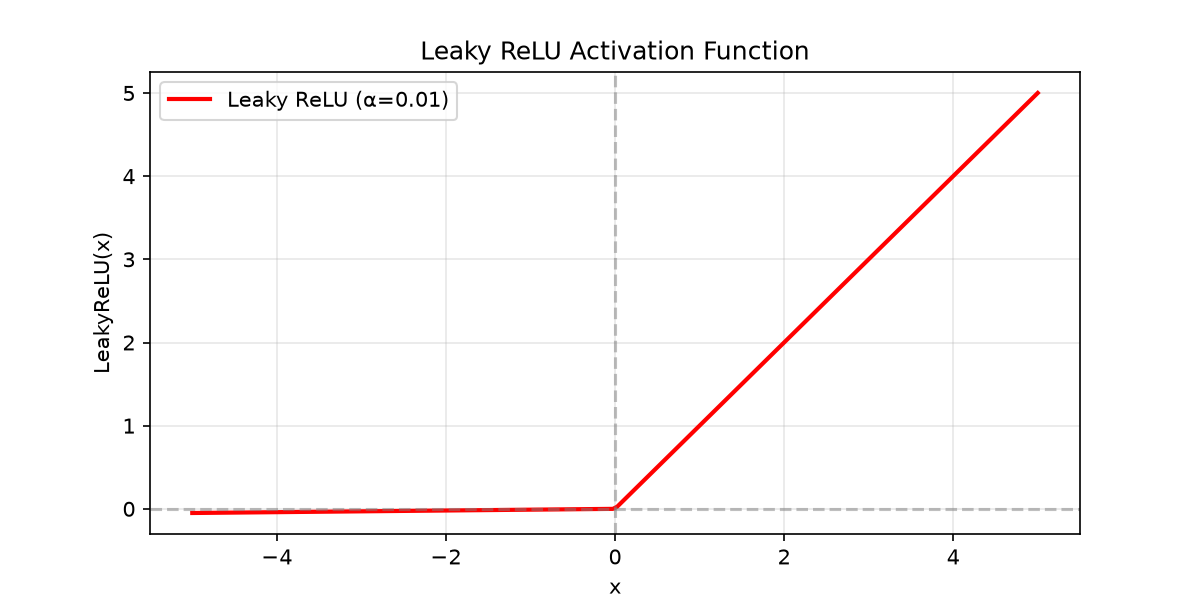
GELU(Gaussian Error Linear Unit)
Section titled “GELU(Gaussian Error Linear Unit)”直觉:x 越大,通过的概率越高(Φ(x) 越接近 1);x 越小(越负),被丢弃的概率越高。与 ReLU 的硬截断不同,GELU 在 0 附近做概率性的平滑过渡,保留了少量负值信息。GELU 是 BERT、GPT 系列等所有主流 Transformer 模型的默认激活函数。
曲线特征:GELU 曲线整体形状接近 ReLU,但在原点附近不是硬折角而是平滑的 S 形过渡。在 x 略小于 0 的区域(约 -0.17 附近)曲线有一个很浅的负值”凹陷”(最小值约为 -0.17),保留了少量负值信息。x 大于 1 时曲线迅速趋近于 y=x。处处可导,曲率平滑,这也是 Transformer 偏好它的原因之一。
import numpy as npimport matplotlib.pyplot as plt
x = np.linspace(-5, 5, 200)# GELU 的 tanh 近似公式(实践中最常用)y = 0.5 * x * (1 + np.tanh(np.sqrt(2 / np.pi) * (x + 0.044715 * x**3)))
plt.figure(figsize=(8, 4))plt.plot(x, y, linewidth=2, color='blue', label='GELU')plt.axhline(0, color='gray', linestyle='--', alpha=0.5)plt.axvline(0, color='gray', linestyle='--', alpha=0.5)plt.xlabel('x')plt.ylabel('GELU(x)')plt.title('GELU 激活函数曲线')plt.legend()plt.grid(True, alpha=0.3)plt.savefig('gelu.png', dpi=150)plt.show()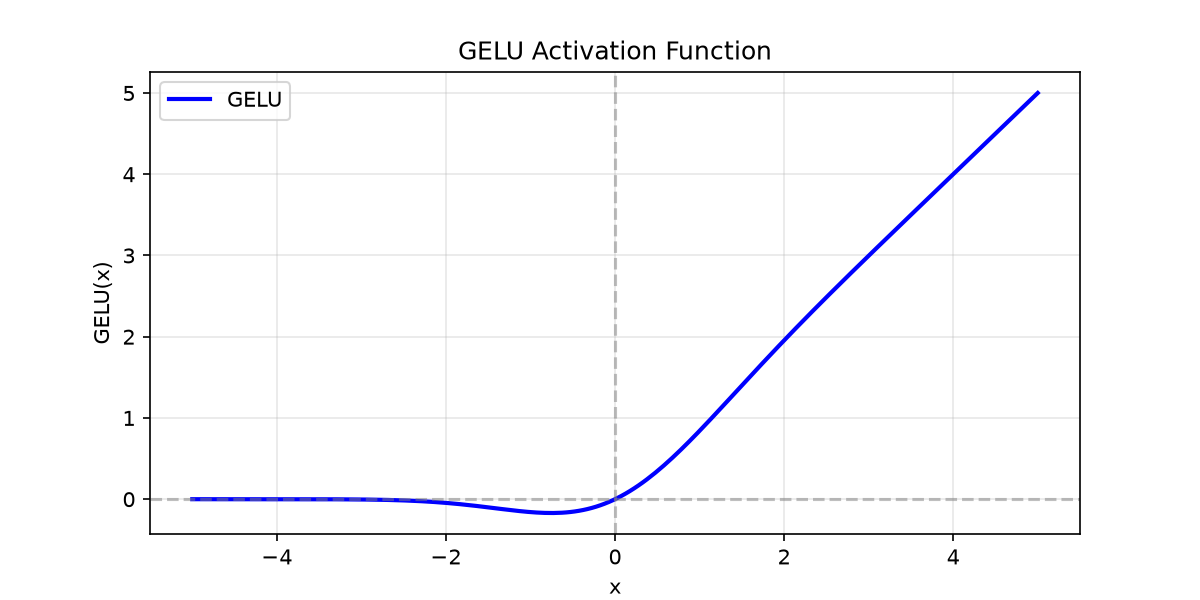
SiLU / Swish
Section titled “SiLU / Swish”Google 通过神经网络搜索发现的自适应激活函数。在 x 大于 0 时接近 ReLU 的行为,但 x 小于 0 时不像 ReLU 那样硬截断到零,而是有一个小的负值”凹陷”。这种非单调性使其在某些任务上优于 ReLU。YOLOv8、EfficientNet 等现代模型大量使用。
曲线特征:SiLU 曲线在 x 大于 0 时与 ReLU 几乎重合(趋近 y=x),但在 x 小于 0 的区域不归零,而是在约 x=-1.28 处达到最小值(约 -0.28),形成一个明显的下凹”波谷”。函数是非单调的:先随 x 减小而下降到谷底,再随 x 继续减小而回升趋近于 0。这种非单调平滑特性被认为有助于信息流动。
import numpy as npimport matplotlib.pyplot as plt
x = np.linspace(-5, 5, 200)y = x / (1 + np.exp(-x))   # SiLU = x * sigmoid(x)
plt.figure(figsize=(8, 4))plt.plot(x, y, linewidth=2, color='purple', label='SiLU (Swish)')plt.axhline(0, color='gray', linestyle='--', alpha=0.5)plt.axvline(0, color='gray', linestyle='--', alpha=0.5)plt.xlabel('x')plt.ylabel('SiLU(x)')plt.title('SiLU / Swish 激活函数曲线')plt.legend()plt.grid(True, alpha=0.3)plt.savefig('silu.png', dpi=150)plt.show()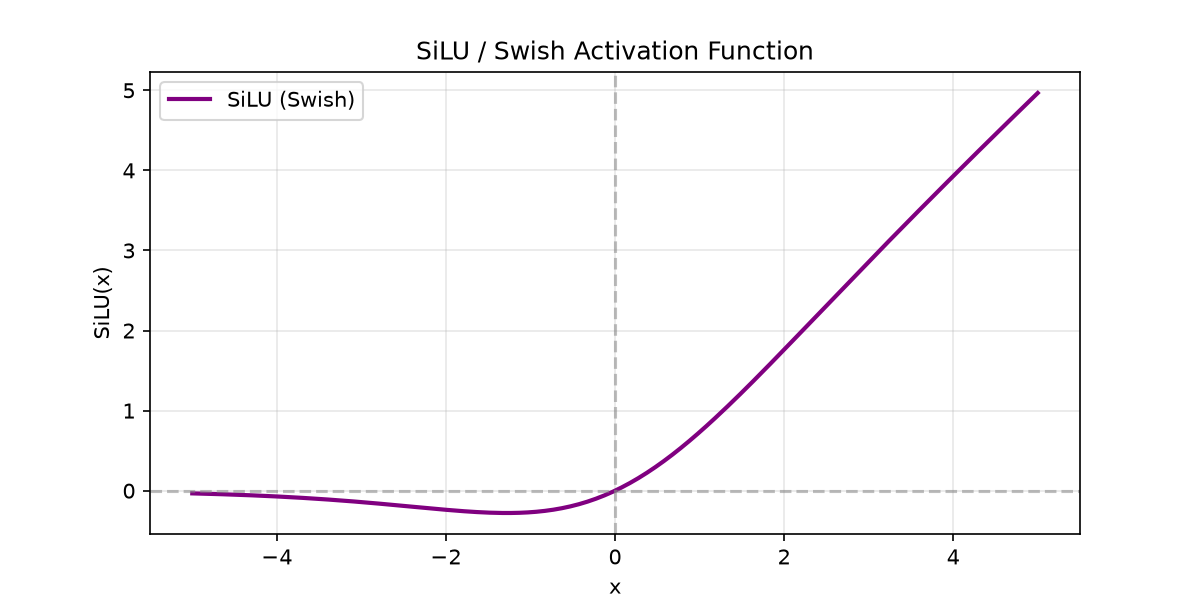
比 Swish 更平滑(处处可导且导数平滑),在 YOLOv4 等检测模型上报告了比 Swish 略好的性能。计算代价略高(需要 tanh + softplus),提升幅度通常很小。
曲线特征:Mish 曲线形状与 SiLU 非常相似——同样是非单调函数,x 大于 0 时趋近线性,x 小于 0 时有下凹波谷。但由于外层多套了一个 tanh(softplus(x)),波谷更浅(最小值约 -0.31,在 x≈-1.19 处),曲线整体比 SiLU 更”圆润”平滑,尤其在谷底和趋近零的尾部过渡更和缓。
import numpy as npimport matplotlib.pyplot as plt
x = np.linspace(-5, 5, 200)# Mish = x * tanh(ln(1 + e^x)) = x * tanh(softplus(x))y = x * np.tanh(np.log1p(np.exp(x)))
plt.figure(figsize=(8, 4))plt.plot(x, y, linewidth=2, color='teal', label='Mish')plt.axhline(0, color='gray', linestyle='--', alpha=0.5)plt.axvline(0, color='gray', linestyle='--', alpha=0.5)plt.xlabel('x')plt.ylabel('Mish(x)')plt.title('Mish 激活函数曲线')plt.legend()plt.grid(True, alpha=0.3)plt.savefig('mish.png', dpi=150)plt.show()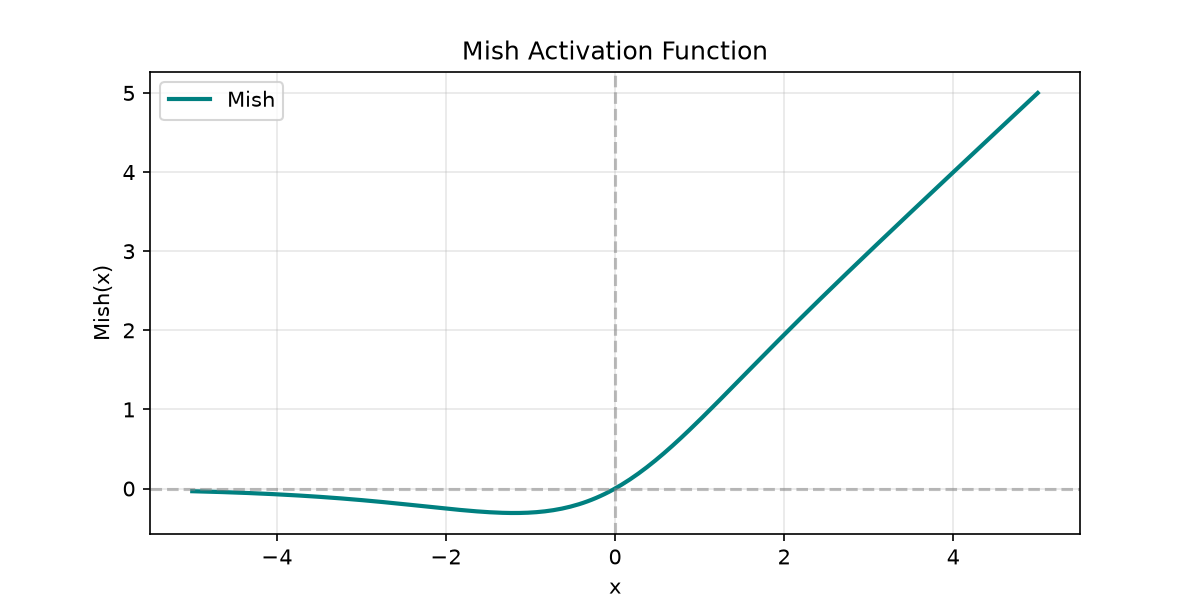
激活函数谱系与特性
Section titled “激活函数谱系与特性”激活函数曲线行为对比
Section titled “激活函数曲线行为对比”PyTorch 中的激活函数
Section titled “PyTorch 中的激活函数”import torchimport torch.nn as nnimport torch.nn.functional as F
x = torch.randn(4, 8) # 模拟某层的输出
# 方式一:用 nn 模块(适合写在网络定义里)acts = { "ReLU": nn.ReLU(), "LeakyReLU": nn.LeakyReLU(0.01), "GELU": nn.GELU(), "SiLU": nn.SiLU(), "Sigmoid": nn.Sigmoid(), "Tanh": nn.Tanh(), "Mish": nn.Mish(),}for name, act in acts.items(): out = act(x) print(f"{name:12s} 均值={out.mean():.3f} 范围=[{out.min():.3f}, {out.max():.3f}]")
# 方式二:函数式接口(适合临时调用)y = F.gelu(x, approximate='tanh') # 用 tanh 近似加速 GELU用 numpy 打印各激活函数关键值
Section titled “用 numpy 打印各激活函数关键值”import numpy as np
x = np.linspace(-6, 6, 200)
# 各激活函数定义sigmoid = 1 / (1 + np.exp(-x))tanh = np.tanh(x)relu = np.maximum(0, x)gelu = 0.5 * x * (1 + np.tanh(np.sqrt(2 / np.pi) * (x + 0.044715 * x**3)))silu = x * (1 / (1 + np.exp(-x)))
# 打印 x=0 和 x=-2 处的值,对比行为for name, y in [("Sigmoid", sigmoid), ("ReLU", relu), ("GELU", gelu), ("SiLU", silu)]: idx0 = 100 # x≈0 的索引 print(f"{name:8s} f(0)={y[idx0]:.3f}")所有激活函数曲线对比(一张图)
Section titled “所有激活函数曲线对比(一张图)”把七个激活函数画在同一张图上,可以直观对比它们的形状差异——值域范围、负区间行为、平滑程度一目了然。
import numpy as npimport matplotlib.pyplot as plt
x = np.linspace(-5, 5, 200)
# 计算所有激活函数的输出sigmoid = 1 / (1 + np.exp(-x))tanh = np.tanh(x)relu = np.maximum(0, x)leaky_relu = np.where(x >= 0, x, 0.01 * x)gelu = 0.5 * x * (1 + np.tanh(np.sqrt(2 / np.pi) * (x + 0.044715 * x**3)))silu = x / (1 + np.exp(-x))mish = x * np.tanh(np.log1p(np.exp(x)))
# 所有激活函数曲线对比plt.figure(figsize=(10, 6))plt.plot(x, sigmoid, label='Sigmoid')plt.plot(x, tanh, label='Tanh')plt.plot(x, relu, label='ReLU')plt.plot(x, leaky_relu, label='Leaky ReLU')plt.plot(x, gelu, label='GELU')plt.plot(x, silu, label='SiLU')plt.plot(x, mish, label='Mish')plt.axhline(0, color='gray', linestyle='--', alpha=0.3)plt.axvline(0, color='gray', linestyle='--', alpha=0.3)plt.ylim(-1.5, 5)          # 限制纵轴范围,让负区间的细节可见plt.xlabel('x')plt.ylabel('f(x)')plt.title('激活函数曲线对比')plt.legend(loc='upper left')plt.grid(True, alpha=0.3)plt.savefig('activation_functions.png', dpi=150)plt.show()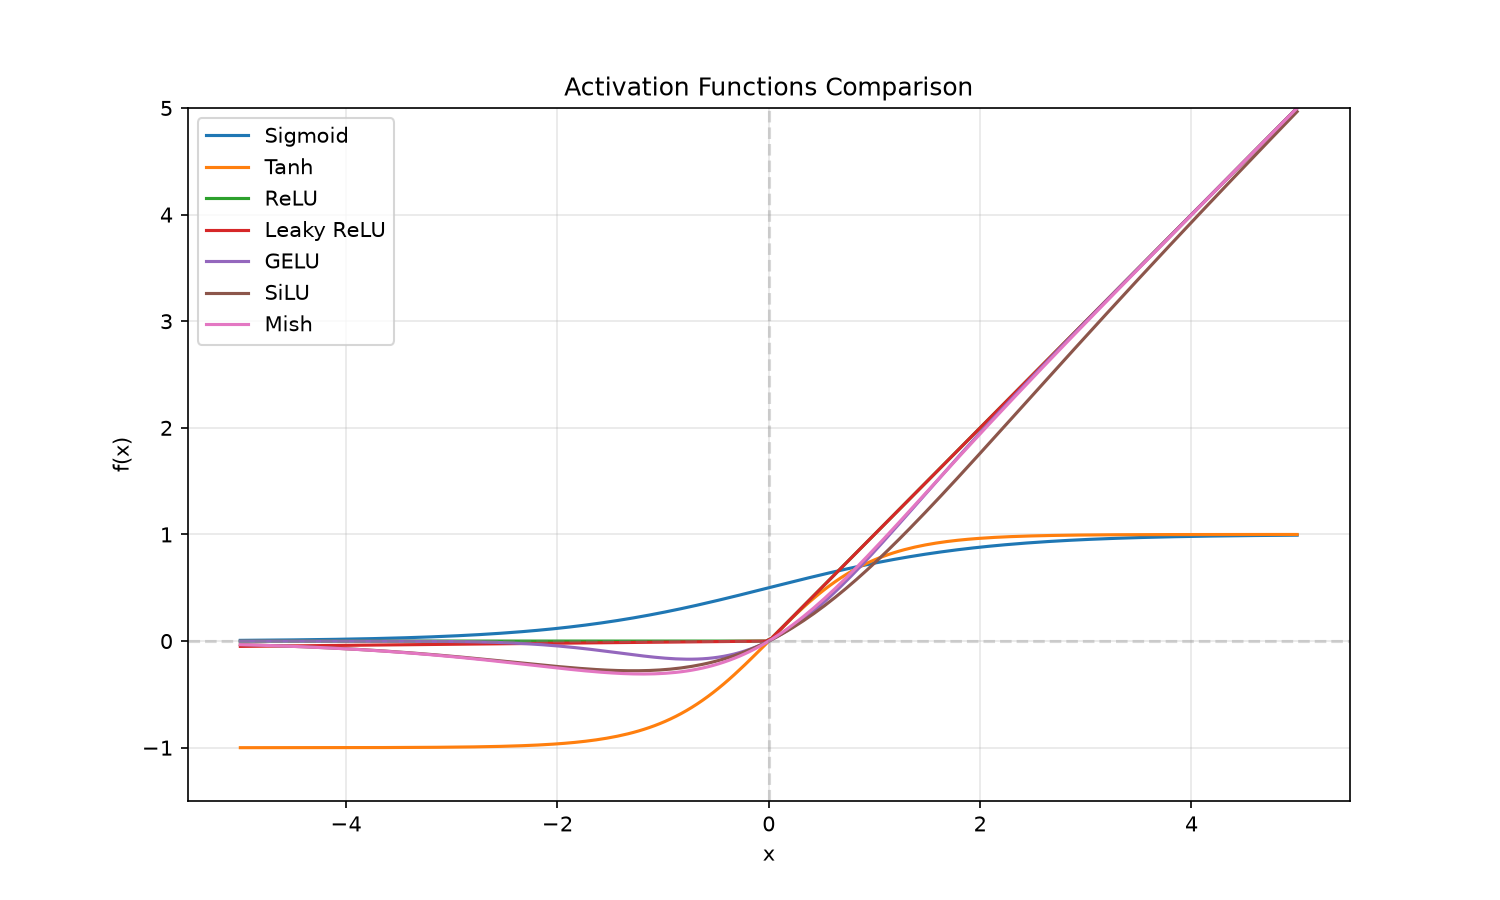
从对比图可以看出几个关键差异:Sigmoid 和 Tanh 在两端趋于水平(梯度消失);ReLU 和 Leaky ReLU 在原点有明显的硬折角;GELU、SiLU、Mish 在负区间有平滑的下凹波谷且处处可导——这正是现代 Transformer 模型偏好它们的原因。
- 隐藏层默认用 ReLU:CNN、MLP 的第一选择。简单、快、梯度不消失。如果效果不理想再试 GELU / SiLU。
- Transformer 必须用 GELU(或 SiLU):BERT、GPT、LLaMA 等所有主流 Transformer 都用 GELU 或其变体。原始论文中 GELU 略优于 ReLU。
- 输出层的激活函数由任务决定:二分类用 Sigmoid、多分类用 Softmax、回归用恒等(不激活)。
- Sigmoid / Tanh 只在特殊位置用:LSTM 门控用 Sigmoid、注意力分数归一化用 Softmax。隐藏层不要用——梯度消失。
- Leaky ReLU 的斜率 α 通常取 0.01:增大(如 0.1)不一定是好事。PReLU 让 α 可学习,在大规模图像分类上有微小优势。
- 不要过度调激活函数:激活函数选择对最终性能的影响通常远小于学习率、正则化和数据质量。先用 ReLU 跑通基线,再考虑替换。
- CNN 图像分类:ResNet / VGG 用 ReLU,EfficientNet 用 SiLU。详见CNN 卷积神经网络。
- Transformer / 大语言模型:BERT / GPT / LLaMA 全部用 GELU 或 SiLU。详见Transformer 架构。
- YOLO 系列目标检测:YOLOv5 用 Leaky ReLU,YOLOv8 用 SiLU。详见目标检测与 YOLO。
- RNN / LSTM:门控用 Sigmoid(输出 0-1 的门控信号)、候选状态用 Tanh(输出 -1 到 1)。详见RNN 与序列模型。
- 生成模型:GAN 的判别器用 Leaky ReLU、扩散模型的 U-Net 用 SiLU。详见扩散模型。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| torch.nn | Python | PyTorch 激活函数模块:ReLU、GELU、SiLU、Mish、LeakyReLU、PReLU 等 |
| torch.nn.functional | Python | 函数式接口,灵活插入任意位置 |
| tf.keras.activations | Python | TensorFlow / Keras 激活函数模块 |
| numpy | Python | 手动实现激活函数曲线,便于理解和可视化 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 激活函数 | Activation Function | 为神经网络引入非线性的函数,没有它多层网络等价于一层 |
| 梯度消失 | Vanishing Gradient | 激活函数导数过小,反向传播时梯度逐层衰减至接近零,深层网络无法训练 |
| 死亡 ReLU | Dying ReLU | ReLU 神经元持续接收负输入,梯度恒为零,参数永远不再更新 |
| 零中心化 | Zero-Centered | 输出均值约为零(如 Tanh),有助于梯度方向多样化,收敛更快 |
| 稀疏激活 | Sparse Activation | ReLU 使部分神经元输出为零,产生稀疏表示,有一定正则化效果 |
| GELU | Gaussian Error Linear Unit | 基于高斯分布的平滑 ReLU,Transformer 的标配激活函数 |
| SiLU / Swish | SiLU / Swish | x * sigmoid(x),非单调平滑激活函数,用于 YOLOv8 / EfficientNet |
| PReLU | Parametric ReLU | Leaky ReLU 的参数化版本,负区间斜率可学习 |
- Nair & Hinton,「Rectified Linear Units Improve Restricted Boltzmann Machines」(ICML 2010):ReLU 在深度学习中的开创性应用论文,如今 ReLU 已成为隐藏层的默认选择。
- Hendrycks & Gimpel,「Gaussian Error Linear Units (GELU)」(2016):GELU 原始论文,提出用高斯累积分布函数替代 ReLU 的硬截断。
- Ramachandran et al.,「Searching for Activation Functions」(2017):Swish/SiLU 的发现论文,Google 用自动搜索技术找到 x·sigmoid(x)。
- Misra,「Mish: A Self Regularized Non-Monotonic Activation Function」(BMVC 2020):Mish 激活函数论文,在各基准上有微小提升。
- Goodfellow et al.,「Deep Learning」第 6 章:系统讲解激活函数的数学性质和梯度行为。