
图像分割
图像分割(Segmentation)是深度学习 CNN 分支下与图像分类、目标检测(见 目标检测与 YOLO)并列的计算机视觉任务,目标是为每个像素赋予类别或实例标签。本页介绍两个标志性架构:U-Net(语义分割)与 Mask R-CNN(实例分割),并延伸到最新的分割大模型(SAM 2)。
如果目标检测是”画方框框住物体”,那图像分割就是**“用画笔精确涂出物体的轮廓”**——细到每一个像素。
两种分割任务的直觉:
- 语义分割(Semantic Segmentation)= 给每个像素贴标签:图里有 3 只猫 2 只狗,语义分割把所有猫的像素标成”猫”、所有狗的像素标成”狗”——不区分”这是哪只猫”,只关心”这块像素属于什么类别”。
- 实例分割(Instance Segmentation)= 既贴标签又数个数:不仅知道每个像素属于”猫”还是”狗”,还能区分”这是第 1 只猫”和”这是第 2 只猫”——每个物体实例都有自己的独立掩码。
此外还有更精细的:
- 全景分割(Panoptic Segmentation)= 语义 + 实例的统一:将背景类(天空、道路等”stuff”)做语义分割,将前景物体(人、车等”things”)做实例分割,合二为一形成一张完整的分割图——每个像素既有类别标签又有实例编号。
语义分割 vs 实例分割
Section titled “语义分割 vs 实例分割”传统图像分割
Section titled “传统图像分割”在深度学习分割模型(U-Net、Mask R-CNN)出现之前,图像分割已经积累了数十年的经典算法。这些传统方法至今仍在医学图像和工业场景中被广泛使用——它们无需训练数据、可解释性强、计算量小,在某些场景下依然是首选。详见传统计算机视觉。
| 方法 | 核心思路 | 典型场景 |
|---|---|---|
| 阈值分割 | 按灰度阈值将像素分为前景/背景——最简单快速的分割方式 | 工业质检(缺陷 vs 正常区域) |
| Otsu(大津法) | 自动计算最佳阈值(最大化类间方差),无需手动选阈值 | 医学图像二值化、文档扫描 |
| 分水岭(Watershed) | 把灰度图视为地形,“洪水”从局部最低点上涨,汇聚处形成边界 | 细胞分割、重叠物体分离 |
| 区域生长(Region Growing) | 从种子点出发,将相似灰度/纹理的相邻像素逐步并入同一区域 | 医学 CT/MRI 中器官轮廓提取 |
| GraphCut | 将像素建模为图的节点,用最大流/最小割优化全局能量函数 | 交互式抠图(Photoshop 魔术橡皮擦的前身) |
为什么传统方法仍在使用? 深度学习分割需要大量标注数据(每个像素都要标注),而医学和工业场景中标注极其昂贵(需专业医生或工程师)。传统方法无需训练、即开即用,在简单的二值分割(如工业零件缺陷检测、细胞前景提取)中效率极高。OpenCV 的
cv2.threshold()、cv2.watershed()等函数至今仍是高频调用。
U-Net:编码器-解码器 + 跳跃连接
Section titled “U-Net:编码器-解码器 + 跳跃连接”U-Net 形状像字母”U”:左半边(编码器)逐步下采样提取特征、缩小分辨率;右半边(解码器)逐步上采样恢复分辨率。关键是跳跃连接——把编码器中对应层的精细特征直接拼接到解码器,避免上采样后细节丢失。
直觉:编码器像”压缩总结”(丢了细节但抓住要点),解码器像”按总结还原图像”。跳跃连接相当于”编码时留的便签”,帮解码器把丢掉的细节找回来。
U-Net 的数据流详解
Section titled “U-Net 的数据流详解”以原始 U-Net(用于 512x512 生物医学图像)为例,数据流如下:
编码器路径(下采样):  572x572x1 → [Conv3x3×2 + Conv3x3×2] → 568x568x64            → MaxPool 2x2            → 284x284x64            → [Conv3x3×2]            → 280x280x128            → MaxPool 2x2            → 140x140x128            → [Conv3x3×2]            → 136x136x256            → MaxPool 2x2            → 68x68x256            → [Conv3x3×2]            → 64x64x512            → MaxPool 2x2            → 32x32x512            → [Conv3x3×2]            → 28x28x1024  ← 瓶颈层(最低分辨率,最高语义)
解码器路径(上采样):  28x28x1024 → UpConv 2x2              → 56x56x512             → 跳跃连接拼接(裁剪后)   → 56x56x1024             → [Conv3x3×2]            → 52x52x512             → UpConv 2x2              → 104x104x256             → 跳跃连接拼接             → 104x104x512             → ...(对称结构)...             → 最终 Conv1x1            → 388x388x2(输出掩码)
通道数的变化规律:编码器中每下采样一次,通道翻倍(64 → 128 → 256 → 512 → 1024);解码器中每上采样一次,通道减半。这种”分辨率降、通道升”的设计与 ResNet 等 CNN 架构一脉相承。
跳跃连接的作用
Section titled “跳跃连接的作用”跳跃连接(Skip Connection,也叫 Shortcut Connection)将编码器中相同分辨率层的特征拼接到解码器。为什么需要它?
- 下采样的代价:每次 MaxPool 都会丢失空间细节(如精确的边缘位置),只保留语义信息(“这里是细胞核”)。
- 上采样的局限:转置卷积(Transposed Convolution)虽然能放大分辨率,但只能从低分辨率特征”猜”细节,恢复的边缘通常模糊。
- 跳跃连接补全细节:编码器对应层的高分辨率特征包含精确的边缘和纹理信息,拼接到解码器后,解码器可以在”语义指导”下精确还原边界。
这和 ResNet 的残差连接虽然都叫 Skip Connection,但操作不同:ResNet 是相加(F(x) + x),U-Net 是拼接(concat[F(x), x])——因为编码器和解码器在同一分辨率层提取的是不同类型的特征,相加会混淆,拼接则保留了两路信息。
DeepLab 系列:空洞卷积 + ASPP
Section titled “DeepLab 系列:空洞卷积 + ASPP”DeepLab 是语义分割的另一条重要技术路线(与 U-Net 并列),由 Google 团队从 2014 年持续发展至 2018 年。核心创新:
- 空洞卷积(Atrous/Dilated Convolution):在卷积核的元素之间插入”空洞”(零),在不增加参数量和计算量的前提下扩大感受野(Receptive Field,即一个输出像素能看到多大范围的输入)。例如 3x3 卷积加 dilation=2 后,等效感受野变成 5x5,但参数量仍为 9 个。
- ASPP(Atrous Spatial Pyramid Pooling):用不同 dilation rate(如 6, 12, 18)的空洞卷积并行处理特征,再拼接结果——让网络在多个尺度上同时捕获上下文信息。
DeepLabV3+(2018)在 ASPP 之后加了decoder模块,结合了 U-Net 式的跳跃连接,融合了两条路线的优点。
Mask R-CNN 流程
Section titled “Mask R-CNN 流程”Mask R-CNN 在 Faster R-CNN 基础上增加一个并行的掩码预测分支——在检测到物体(框 + 类别)的同时,额外为每个物体预测一个像素级掩码:
RoIAlign 的关键改进
Section titled “RoIAlign 的关键改进”Faster R-CNN 使用 RoIPool 将不同大小的候选区域映射为固定大小(如 7x7),但 RoIPool 会做量化取整(将浮点坐标截断为整数),导致特征图与原始图像之间存在 像素级错位——这对检测(框级精度)影响不大,但对掩码(像素级精度)是致命的。
Mask R-CNN 提出 RoIAlign:用双线性插值在浮点坐标处精确采样特征值,完全消除量化误差。这一改进看似微小,但对掩码精度的提升非常显著。
掩码分支的结构
Section titled “掩码分支的结构”掩码分支是一个小型 FCN(全卷积网络):对每个 RoIAlign 后的 14x14x256 特征图,经过 4 个连续的 3x3 卷积(256 通道)、1 个反卷积(上采样到 28x28)、最后 1x1 卷积输出。每个类别有独立的掩码通道——C 个类别就有 C 个输出掩码,取对应类别的掩码作为最终结果。
损失函数与评估指标
Section titled “损失函数与评估指标”常用损失函数
Section titled “常用损失函数”分割任务的损失函数设计至关重要,尤其是处理类别不均衡(前景小、背景大)的场景。
1. 像素级交叉熵(Pixel-wise Cross-Entropy)
最基础的损失函数,对每个像素独立计算交叉熵:
- 是像素总数, 是类别数
- 是第 个像素属于类别 的真实标签(0 或 1)
- 是模型预测的第 个像素属于类别 的概率
问题:当前景占 1%、背景占 99% 时,模型全预测背景也能得到 99% 准确率,损失很低但完全没有学到分割。
2. Dice Loss
Dice Loss 基于 Dice 系数(衡量两个集合重叠度的指标),直接优化预测掩码与真实掩码的相似度:
- 是第 个像素的预测概率
- 是第 个像素的真实标签
- Dice 系数对前景大小不敏感——即使前景只有 10 个像素,只要预测对了就能得到高分数
Dice Loss 天然缓解类别不均衡问题,是医学图像分割的标配。
3. Focal Loss
Focal Loss(Lin et al., 2017)通过降低”容易分类”样本的权重,让模型聚焦于”难”样本:
- 是模型对正确类别的预测概率
- (focusing parameter,通常设为 2):当 接近 1(容易样本)时, 接近 0,该样本的损失被大幅降低
- (平衡因子):进一步平衡正负样本权重
Focal Loss 最初是为目标检测提出的(RetinaNet),但在分割任务中同样有效——大量背景像素是”容易样本”,Focal Loss 让模型不被它们淹没。
4. 混合损失(Dice + CE)
实践中常用 Dice Loss 和交叉熵的加权和:
CE 提供逐像素的稳定梯度,Dice 缓解类别不均衡——二者互补效果通常最好。
| 指标 | 定义 | 适用场景 |
|---|---|---|
| IoU (Intersection over Union) | ,交集除以并集,也叫 Jaccard Index | 分割的标准评估指标,mIoU 是各类 IoU 的平均 |
| Dice 系数 | ,与 IoU 单调相关 | 医学图像分割常用 |
| Pixel Accuracy | 正确像素 / 总像素 | 简单直观,但受类别不均衡影响大 |
| mIoU (mean IoU) | 各类别 IoU 的平均值 | 语义分割的核心指标(PASCAL VOC、Cityscapes 等) |
IoU 与 Dice 的换算关系:,二者单调正相关。
分割模型 IoU 对比
Section titled “分割模型 IoU 对比”下面对比 FCN、U-Net、DeepLabV3+ 三种经典分割模型在 Cityscapes、PASCAL VOC 和医学数据集上的 mIoU 表现(数据为示意性近似值):
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
# --- Data ---models = ["FCN", "U-Net", "DeepLabV3+"]datasets = ["Cityscapes", "PASCAL VOC", "Medical"]
# mIoU scores (mock but realistic)scores = {    "FCN":        [65, 67, 70],    "U-Net":      [72, 71, 82],    "DeepLabV3+": [78, 82, 76],}
x = np.arange(len(datasets))width = 0.22
# --- Plot ---fig, ax = plt.subplots(figsize=(9, 5.5))
colors = ["#4C72B0", "#55A868", "#C44E52"]
for i, (model, vals) in enumerate(scores.items()):    offset = (i - 1) * width    bars = ax.bar(        x + offset, vals, width,        label=model, color=colors[i],        edgecolor="white", linewidth=0.8, zorder=3,    )    # value labels on top of bars    for bar in bars:        h = bar.get_height()        ax.text(            bar.get_x() + bar.get_width() / 2, h + 0.6,            f"{h}", ha="center", va="bottom",            fontsize=9, fontweight="bold",        )
ax.set_xticks(x)ax.set_xticklabels(datasets, fontsize=11)ax.set_ylabel("mIoU (%)", fontsize=11)ax.set_ylim(55, 90)ax.set_yticks(np.arange(55, 91, 5))
ax.set_title(    "Segmentation Model IoU Comparison Across Datasets",    fontsize=12, fontweight="bold", pad=14,)
ax.legend(    title="Model", title_fontsize=10,    fontsize=10, loc="upper left",    frameon=True, fancybox=True, shadow=False,)
ax.yaxis.grid(True, linestyle="--", alpha=0.4, zorder=0)ax.set_axisbelow(True)ax.spines["top"].set_visible(False)ax.spines["right"].set_visible(False)
fig.tight_layout()fig.savefig(    "segmentation-iou-comparison.png",    dpi=180, bbox_inches="tight", facecolor="white",)plt.close(fig)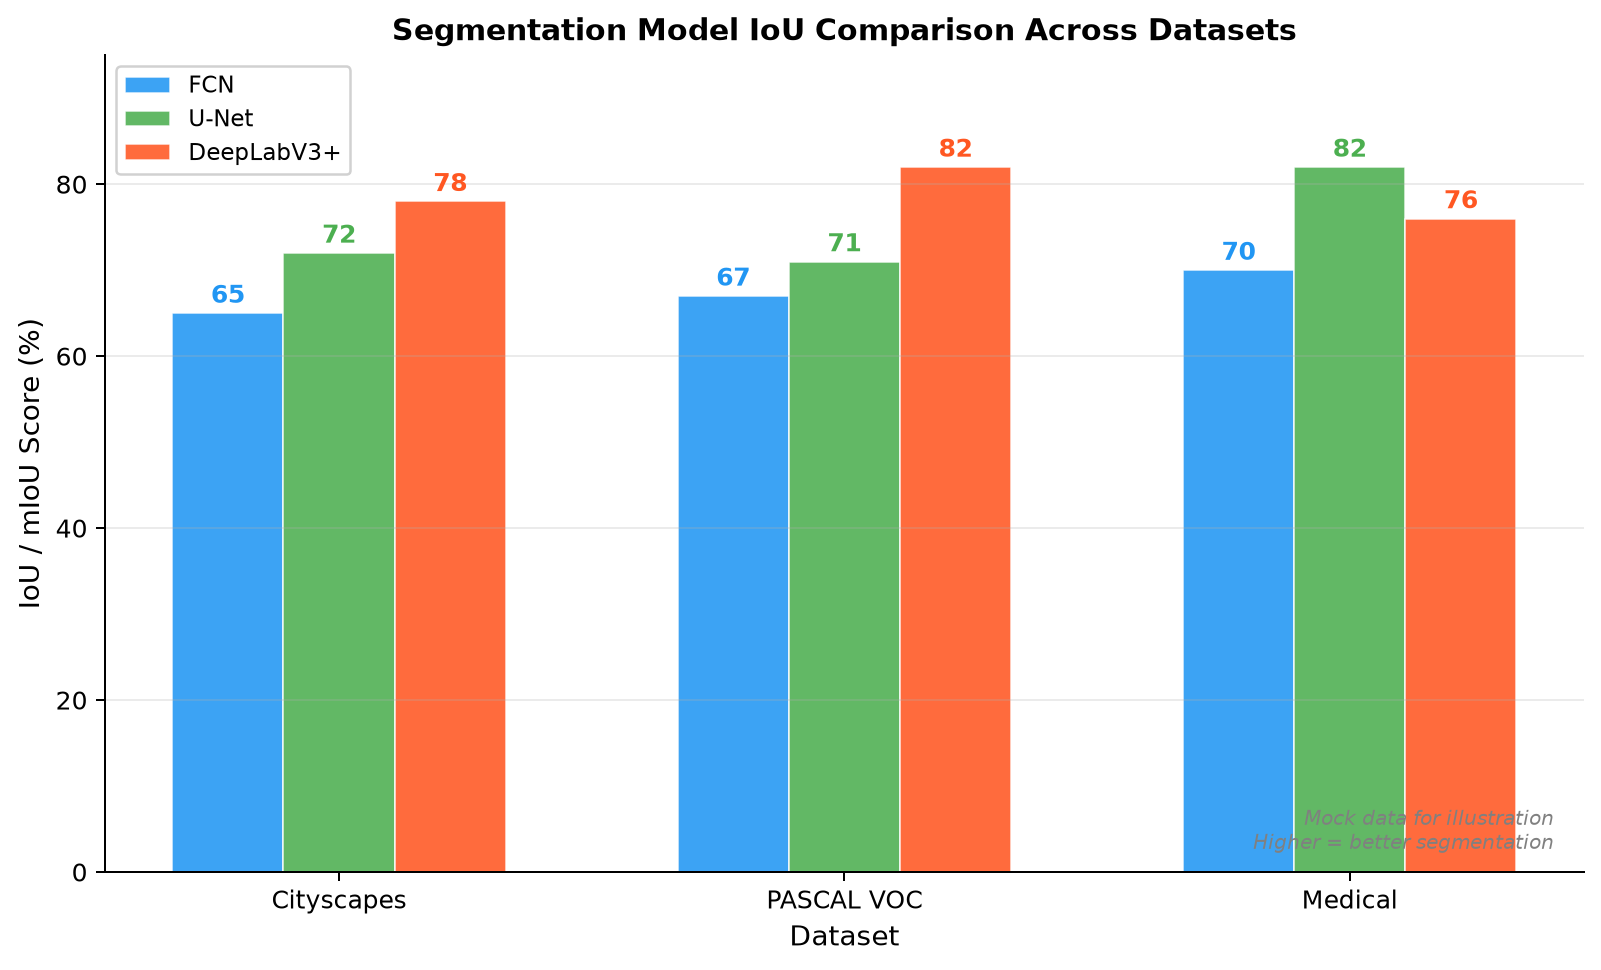
分割模型 IoU 对比
Section titled “分割模型 IoU 对比”下图以分组柱状图对比 FCN、U-Net、DeepLabV3+ 在三个典型数据集上的 IoU/mIoU 得分,直观展示不同架构的分割精度差异。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
np.random.seed(42)
models = ["FCN", "U-Net", "DeepLabV3+"]datasets = ["Cityscapes", "PASCAL VOC", "Medical"]scores = {    "FCN":        [65, 67, 70],    "U-Net":      [72, 71, 82],    "DeepLabV3+": [78, 82, 76],}colors = ["#2196F3", "#4CAF50", "#FF5722"]
x = np.arange(len(datasets))width = 0.22
fig, ax = plt.subplots(figsize=(9, 5.5))for i, model in enumerate(models):    offset = (i - 1) * width    bars = ax.bar(x + offset, scores[model], width, label=model,                  color=colors[i], edgecolor="white", alpha=0.88)    for bar, val in zip(bars, scores[model]):        ax.text(bar.get_x() + bar.get_width() / 2, bar.get_height() + 0.5,                f"{val}", ha="center", fontsize=10, fontweight="bold")
ax.set_xlabel("Dataset")ax.set_ylabel("IoU / mIoU Score (%)")ax.set_title("Segmentation Model IoU Comparison Across Datasets",             fontsize=12, fontweight="bold")ax.set_xticks(x)ax.set_xticklabels(datasets)ax.set_ylim(0, 95)ax.legend(fontsize=9)ax.grid(axis="y", alpha=0.25)plt.tight_layout()plt.savefig("segmentation-iou-comparison.png", dpi=180,            bbox_inches="tight", facecolor="white")
动手实践:U-Net 概念代码
Section titled “动手实践:U-Net 概念代码”import torchimport torch.nn as nn
# 最小化 U-Net(仅展示核心结构:下采样→上采样+跳跃连接)class MiniUNet(nn.Module): def __init__(self, in_ch=1, out_ch=1): super().__init__() # 编码器:逐步下采样 self.enc1 = nn.Sequential(nn.Conv2d(in_ch, 16, 3, padding=1), nn.ReLU()) self.pool = nn.MaxPool2d(2) self.enc2 = nn.Sequential(nn.Conv2d(16, 32, 3, padding=1), nn.ReLU()) # 解码器:逐步上采样 self.up2 = nn.ConvTranspose2d(32, 16, 2, stride=2) self.dec1 = nn.Sequential(nn.Conv2d(32, 16, 3, padding=1), nn.ReLU()) # 32=拼接后 self.out = nn.Conv2d(16, out_ch, 1) # 1×1 卷积输出掩码
def forward(self, x): e1 = self.enc1(x) # 跳跃连接:保存编码器特征 e2 = self.enc2(self.pool(e1)) d2 = self.up2(e2) d1 = self.dec1(torch.cat([d2, e1], dim=1)) # 拼接跳跃连接特征 return self.out(d1) # 输出:每像素的分割概率
model = MiniUNet()print(model)U-Net 训练代码(含 Dice Loss)
Section titled “U-Net 训练代码(含 Dice Loss)”import torchimport torch.nn as nnimport torch.nn.functional as F
class DoubleConv(nn.Module): """U-Net 的基本单元:两次 (Conv3x3 → BN → ReLU)""" def __init__(self, in_ch, out_ch): super().__init__() self.conv = nn.Sequential( nn.Conv2d(in_ch, out_ch, 3, padding=1, bias=False), nn.BatchNorm2d(out_ch), nn.ReLU(inplace=True), nn.Conv2d(out_ch, out_ch, 3, padding=1, bias=False), nn.BatchNorm2d(out_ch), nn.ReLU(inplace=True), ) def forward(self, x): return self.conv(x)
class UNet(nn.Module): def __init__(self, in_ch=3, out_ch=1, features=[64, 128, 256, 512]): super().__init__() self.downs = nn.ModuleList() self.ups = nn.ModuleList() self.pool = nn.MaxPool2d(2) # 编码器 for f in features: self.downs.append(DoubleConv(in_ch, f)) in_ch = f # 解码器 for f in reversed(features): self.ups.append(nn.ConvTranspose2d(f * 2, f, 2, stride=2)) self.ups.append(DoubleConv(f * 2, f)) self.bottleneck = DoubleConv(features[-1], features[-1] * 2) self.out_conv = nn.Conv2d(features[0], out_ch, 1)
def forward(self, x): skip = [] for down in self.downs: x = down(x) skip.append(x) x = self.pool(x) x = self.bottleneck(x) skip = skip[::-1] for i in range(0, len(self.ups), 2): x = self.ups[i](x) # 上采样 x = torch.cat([x, skip[i // 2]], dim=1) # 跳跃连接拼接 x = self.ups[i + 1](x) # 双卷积 return self.out_conv(x)
# Dice Loss 实现def dice_loss(pred, target, smooth=1e-6): """pred: (B, 1, H, W) sigmoid 后的概率, target: (B, 1, H, W) 二值标签""" pred = torch.sigmoid(pred) intersection = (pred * target).sum(dim=(2, 3)) union = pred.sum(dim=(2, 3)) + target.sum(dim=(2, 3)) dice = (2.0 * intersection + smooth) / (union + smooth) return 1.0 - dice.mean()
# 混合损失:BCE + Dicedef bce_dice_loss(pred, target): bce = F.binary_cross_entropy_with_logits(pred, target) return bce + dice_loss(pred)
model = UNet(in_ch=3, out_ch=1)x = torch.randn(2, 3, 256, 256)out = model(x)print(f"输入: {x.shape} → 输出: {out.shape}") # (2,1,256,256)分割任务的数据增强需要同时对图像和掩码做相同的几何变换——如果旋转了图像但没旋转掩码,标签就全错了。
常用增强(用 Albumentations 库最方便):
- 几何变换:水平/垂直翻转、随机旋转(-15°~15°)、随机缩放裁剪(Scale: 0.8-1.2)
- 弹性形变(Elastic Deformation):模拟生物组织的自然形变,U-Net 原始论文中就使用了这一技巧,对医学分割效果显著
- 颜色抖动:亮度、对比度、饱和度、色调微调(仅对图像,掩码不变)
- CutMix / MixUp:也可用于分割,但需要将标签图按相同方式混合
import albumentations as A
transform = A.Compose([    A.HorizontalFlip(p=0.5),    A.RandomRotate90(p=0.5),    A.ElasticTransform(p=0.3, alpha=120, sigma=120 * 0.05),    A.RandomBrightnessContrast(p=0.3),    A.Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225]),])# 同时变换图像和掩码augmented = transform(image=img, mask=mask)
编码器预训练
Section titled “编码器预训练”U-Net 的编码器部分本质就是普通 CNN 分类器(如 ResNet-34/50)的前半部分。因此可以用 ImageNet 预训练的 ResNet 权重初始化编码器——这在 segmentation_models_pytorch 库中只需一行:
import segmentation_models_pytorch as smp
model = smp.Unet(    encoder_name="resnet34",    encoder_weights="imagenet",  # 加载 ImageNet 预训练权重    in_channels=3,    classes=1,)
预训练编码器通常比从头训练提升 3-5 个 mIoU 百分点,在数据量小时差距更大。
- 差异化学习率:编码器(预训练)用较小学习率(如 1e-4),从头训练的解码器用较大学习率(如 1e-3)。PyTorch 中通过参数分组实现。
- Cosine Annealing + Warmup:前 5 个 epoch 线性预热,之后余弦退火。这是分割任务最常用的调度策略。
- TTA(Test-Time Augmentation):对输入图像做多种增强(翻转、旋转),分别推理后取平均——提升精度但增加推理时间。
- CRF(条件随机场):对模型输出的概率图做 CRF 后处理,利用图像底层特征(颜色、边缘)精修分割边界。DeepLab 系列大量使用 CRF 后处理。
- 模型集成:训练多个模型,对输出做平均或投票。
最新进展(2024-2025)
Section titled “最新进展(2024-2025)”SAM 2:分割一切大模型
Section titled “SAM 2:分割一切大模型”2024 年 4 月,Meta 发布了 Segment Anything Model 2(SAM 2)——首个统一图像和视频分割的基础大模型。SAM 2 的关键特性:
- 提示式分割(Promptable Segmentation):通过点击、框选、或文本提示指定要分割的目标,模型输出对应掩码——不需要针对新任务重新训练。
- 视频分割能力:SAM 2 将图像视为单帧视频,在视频上可以跨帧追踪物体掩码——即使物体被遮挡后重新出现也能持续追踪。
- 零样本泛化:在 SAM 2 上从未见过的场景(医学影像、卫星图、工业缺陷)中,也能通过点击快速生成分割掩码。
- 架构:图像编码器(基于 视觉 Transformer)+ 提示编码器 + 轻量掩码解码器 + 记忆模块(跨帧记忆库,用于视频)。
SAM 2 的出现正在改变分割领域的工作流程:传统方式是为每个新任务标注大量数据并从头训练模型;SAM 2 方式是直接在预训练模型上通过交互式提示获得分割结果,或只用少量数据微调(fine-tune)。
实时分割模型
Section titled “实时分割模型”移动端和实时场景推动了轻量级分割模型的发展:
- MobileSeg / EfficientSeg(2023-2024):使用轻量 backbone(MobileNetV3、EfficientNet)和高效解码器,在移动 GPU 上达到 30+ FPS。
- Fast-SCNN(Semantic Segmentation):专门为高分辨率实时语义分割设计(如自动驾驶 1024x2048 输入),在 Cityscapes 上达到 120+ FPS。
Transformer 在分割中的应用
Section titled “Transformer 在分割中的应用”2024-2025 年的 SOTA 分割模型已经全面转向 Transformer 架构:
- Mask2Former(Cheng et al., 2022):基于 Transformer Decoder 的通用分割架构,用 masked attention 替代标准 attention,在语义/实例/全景分割三个任务上同时达到 SOTA。
- SegFormer(Xie et al., 2022):轻量级 Transformer 分割模型,无需位置编码即支持任意分辨率输入。
- DINOv2 + 线性头(2023-2024):Meta 的 DINOv2 自监督视觉大模型作为特征提取器,仅接一个简单的线性分类头就能在多个分割基准上达到 SOTA——证明了强大的视觉特征表示比复杂的任务头更重要。
3D 医学分割
Section titled “3D 医学分割”医学图像通常是 3D 体数据(CT、MRI),催生了 3D 分割专用架构:
- V-Net / 3D U-Net:将 U-Net 的 2D 卷积替换为 3D 卷积,直接在体数据上端到端分割。
- nnU-Net(Isensee et al.,2018-2024):“无需任何新架构”的自适应框架——根据数据集特性自动配置 U-Net 的超参数(patch 大小、网络深度等),在数十个医学分割数据集上持续取得 SOTA 或接近 SOTA 的成绩。nnU-Net 的哲学是:正确的训练策略和预处理比花哨的架构更重要。
- 输出是概率图:分割模型的输出是每个像素属于各类别的概率,用
sigmoid(二分类)或softmax(多分类)激活。 - 损失函数选择:常用 Dice Loss 或 Focal Loss,因为前景/背景像素极度不均衡(一张医学图像中病灶可能只占 1%)——普通交叉熵会让模型直接全预测背景。实践推荐混合损失(Dice + CE)。
- U-Net 不止用于分割:它是 Stable Diffusion 等扩散模型的骨干网络(CV 架构向生成模型渗透的典型交叉点,见 扩散模型)。
- 实例分割要检测能力:Mask R-CNN 需要 RPN 做检测,训练和推理都比纯语义分割复杂,标注成本也更高(每个实例独立掩码)。
- 编码器预训练至关重要:始终用 ImageNet 预训练权重初始化编码器(通过
segmentation_models_pytorch或mmseg),比从头训练提升显著。 - 输入分辨率:分割对分辨率敏感——分辨率太低会丢失小物体。训练时常用 256x256 或 512x512 的 patch,推理时可以对大图滑窗预测后拼接。
- 先试 SAM 2:面对新分割任务时,先用 SAM 2 做交互式分割看看效果——如果 SAM 2 已经足够好,可以省去大量标注和训练成本。
- 医学图像分割:联影智能、推想科技用 U-Net 在 CT 中自动勾画肿瘤轮廓和器官边界,医生据此制定放疗计划,勾画效率提升数倍。nnU-Net 在 BraTS(脑肿瘤分割)、KiTS(肾脏肿瘤分割)等竞赛中持续领先。
- 自动驾驶可行驶区域:特斯拉、地平线用语义分割实时区分道路、车道线、人行道与障碍物,为路径规划提供像素级环境理解。Cityscapes 是该领域最常用的基准数据集。
- 图像编辑:Adobe Photoshop 的”选择主体”、手机相机的人像背景虚化,背后都是分割模型在精确区分前景与背景的像素边界。SAM 2 让交互式抠图变得前所未有的流畅。
- 遥感与地理信息:SpaceNet 竞赛中用语义分割从卫星图提取建筑轮廓、道路网络和植被覆盖,服务于城市规划和灾害快速评估。
- 视频分割与特效:SAM 2 的视频分割能力让”一键去除视频中的人物”或”给视频中的特定物体上色”变得可行——这在影视后期中具有巨大价值。
- 农业与植物科学:用语义分割识别作物叶片病害区域、果实计数、杂草检测——精确到每片叶子的像素级别。
- U-Net(Ronneberger et al., MICCAI 2015,弗莱堡大学):编码器-解码器 U 形结构 + 跳跃连接,生物医学分割事实标准;同时是 Stable Diffusion 等扩散模型的骨干网络。
- Mask R-CNN(He et al., ICCV 2017 最佳论文):Faster R-CNN + 掩码分支 + RoIAlign,实例分割;横跨检测与分割两个任务。
- DeepLabV3+(Chen et al., ECCV 2018):空洞卷积 + ASPP + encoder-decoder,语义分割另一重要路线。
- SAM 2(Meta AI, 2024):统一图像和视频的提示式分割基础大模型,零样本泛化能力开创了分割新范式。
- Mask2Former(Cheng et al., CVPR 2022):基于 Transformer 的通用分割架构,语义/实例/全景三任务统一。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| SAM 2 (segment-anything-2) | Python | Meta 开源的通用分割大模型,支持交互式分割和零样本分割,覆盖图像和视频 |
| MMSegmentation | Python | 商汤开源的分割工具箱,内置 U-Net/DeepLab/Mask2Former 等主流模型 |
| Detectron2 | Python | Meta 开源库,提供 Mask R-CNN 等实例分割的高质量实现 |
| segmentation_models_pytorch | Python | 简洁的 PyTorch 分割库,一行加载 U-Net/DeepLabV3+/FPN + 预训练编码器 |
| torchvision | Python | PyTorch 官方库,提供 Mask R-CNN/DeepLabV3 预训练模型 |
| MONAI | Python | 医学影像分析专用库,内置 U-Net/3D 变体与医学数据预处理工具 |
| nnU-Net | Python | 自适应医学分割框架,自动配置超参数,持续 SOTA |
| Albumentations | Python | 高效的图像增强库,支持同时变换图像和掩码 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 语义分割 | Semantic Segmentation | 为每个像素分配类别标签,不区分同类的不同实例 |
| 实例分割 | Instance Segmentation | 既能逐像素分类又能区分同类不同实例的分割任务 |
| 全景分割 | Panoptic Segmentation | 统一语义分割(背景)和实例分割(前景)的分割范式 |
| 编码器-解码器 | Encoder-Decoder | 先逐步下采样提取特征、再逐步上采样恢复分辨率的结构 |
| 跳跃连接 | Skip Connection | 把编码器层的精细特征直接拼接到解码器,防止细节丢失 |
| 全卷积网络 | FCN (Fully Convolutional Network) | 用卷积替代全连接层实现端到端像素级预测的首个分割架构 |
| 空洞卷积 | Atrous / Dilated Convolution | 卷积核元素间插入空洞以扩大感受野,不增加参数量 |
| 感受野 | Receptive Field | 一个输出像素对应的输入图像区域大小 |
| Dice 系数 | Dice Coefficient | 衡量预测掩码与真实掩码重叠度的指标,常用于类别不均衡场景 |
| IoU | Intersection over Union | 交集除以并集,分割任务的核心评估指标(也叫 Jaccard Index) |
| 转置卷积 | Transposed Convolution | 可学习的上采样操作,将低分辨率特征图放大到高分辨率 |
| Focal Loss | Focal Loss | 降低易分类样本权重的损失函数,处理类别不均衡问题 |
| RoIAlign | RoIAlign | 用双线性插值精确对齐候选区域特征,消除量化误差 |
- FCN(Long, Shelhamer & Darrell, CVPR 2015):首个用全卷积网络做端到端语义分割的工作,是 U-Net 的概念前身。
- U-Net(Ronneberger et al., MICCAI 2015):编码器-解码器 U 形结构 + 跳跃连接,至今仍是医学分割标配。
- DeepLab 系列(Chen et al., 2014–2018):空洞卷积(atrous convolution)+ ASPP 模块,语义分割另一重要路线。
- Mask R-CNN(He et al., ICCV 2017):实例分割里程碑,RoIAlign 是关键创新。
- Focal Loss / RetinaNet(Lin et al., ICCV 2017):提出 Focal Loss 处理类别不均衡,虽为检测设计但广泛用于分割。
- SAM 2(Meta AI, 2024):统一图像和视频分割的基础大模型,标志着分割进入”提示式 + 零样本”时代。
- nnU-Net(Isensee et al., Nature Methods 2021):自适应医学分割框架,证明了训练策略和预处理的重要性。
- Mask2Former(Cheng et al., CVPR 2022):基于 Transformer 的通用分割架构,当前 SOTA 基线之一。