
评估指标全览
训练出一个模型只是第一步——怎么判断它好不好才是更难的问题,选错指标会得出完全错误的结论。本页系统梳理 AI 各领域的评估指标:分类(Precision/Recall/F1)、目标检测(IoU/mAP/PR 曲线)、LLM 文本生成(Perplexity/BLEU/ROUGE/BERTScore)、RAG(RAGAS)与 Agent(任务完成率/工具调用准确率)。传统的分类指标在 模型评估与指标 已有完整论述,本页聚焦检测、生成式与智能体评估这两个快速演进的领域。前置阅读:模型评估与指标、损失函数。
评估指标要回答一个最根本的问题:你的模型在真实任务上”够不够好”。不同任务对”好”的定义截然不同:
- 分类= 考试对了几道题。但”对题率”(准确率)在类别不平衡时会骗人——99% 是正常邮件时全猜正常就有 99% 准确率。
- 检测= 不光要认对,还要框准。框偏了等于认错——所以有 IoU 衡量”框的重合度”。
- LLM 生成= 作文题没有唯一正确答案。不能简单对/错,要衡量”像不像参考答案”(BLEU/ROUGE)或”语义是否相近”(BERTScore)。
- RAG= 开卷考试,要同时考”答案对不对”和”有没有真的翻书”(faithfulness,是否忠于检索到的资料)。
- Agent= 综合实训,要考”任务完成了没”和”工具用对了没”,还要看”走的路径合不合理”(轨迹评估)。
指标选择决定优化方向。模型会朝你衡量的方向去优化——如果用准确率优化欺诈检测,模型会倾向于全部预测”非欺诈”。选对指标,模型才会学对。
一、分类指标
Section titled “一、分类指标”分类指标的基础是混淆矩阵(Confusion Matrix)——它把所有预测结果按”真实类别 × 预测类别”分解成四个象限(二分类)或 网格( 类)。详见 模型评估 的完整推导,这里做必要回顾。
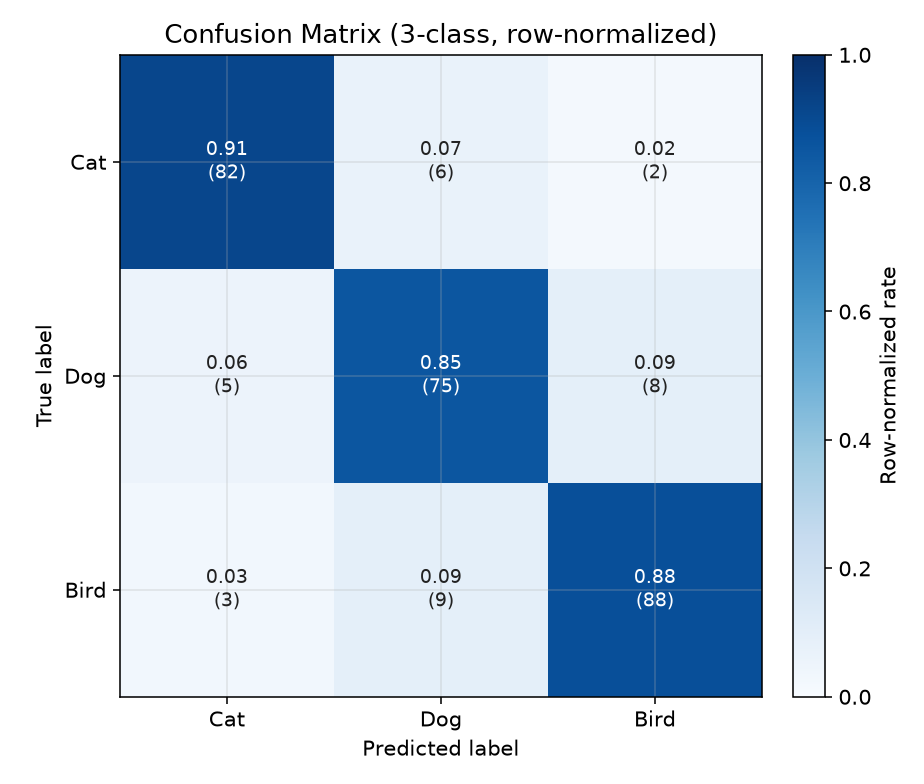
对角线(深色)是预测正确的比例,非对角线是混淆方向——比如”狗”被误判成”鸟”的比例越高,说明模型在这两类间越容易混淆。
四个基本量(二分类)
Section titled “四个基本量(二分类)”| 术语 | 含义 | 俗称 |
|---|---|---|
| TP(True Positive,真正例) | 预测正、实际正 | 命中 |
| FP(False Positive,假正例) | 预测正、实际负 | 误报(假阳性) |
| FN(False Negative,假反例) | 预测负、实际正 | 漏报(假阴性) |
| TN(True Negative,真反例) | 预测负、实际负 | 正确拒绝 |
Precision 与 Recall
Section titled “Precision 与 Recall”
- Precision(精确率/查准率):预测为正的里,实际有多少是正。回答”我说它是正例,可信吗?”
- Recall(召回率/查全率):实际为正的里,被找出了多少。回答”真正的正例,我漏了多少?”
二者是跷跷板:阈值越低,Recall 越高(抓得多),但 Precision 越低(误报多);阈值越高则相反。
F1 是 Precision 与 Recall 的调和平均(Harmonic Mean),在二者之间取平衡:
为什么用调和平均而非算术平均?调和平均对两个值中的较小值更敏感——Precision=0.99、Recall=0.01 时,算术平均 = 0.50(看似不差),调和平均 = 0.0198(暴露问题)。F1 惩罚”偏科”。
更一般地, 用一个权重 控制 Recall 的相对重要性:
更看重 Recall(如医疗筛查,宁可误报不漏报), 更看重 Precision(如垃圾邮件,宁可漏报不误报)。
二、目标检测指标
Section titled “二、目标检测指标”目标检测(Object Detection)比分类更复杂——不仅要识别类别,还要预测边界框(Bounding Box)。代表模型见 YOLO 目标检测、CNN。检测评估的核心是衡量”框得准不准”和”综合表现好不好”。
IoU(Intersection over Union)
Section titled “IoU(Intersection over Union)”IoU 衡量预测框 与真实框 的重合度:
- IoU = 1:完全重合。
- IoU = 0:完全不重合。
- IoU ≥ 0.5:通常视为”检测正确”(PASCAL VOC 标准);COCO 用 IoU ∈ [0.5, 0.95] 的多个阈值取平均,更严格。
判定一个检测是否算 TP:需要同时满足(1)类别正确;(2)与某真实框的 IoU ≥ 阈值。如果一个真实框被多个预测框命中,只算置信度最高的那个为 TP,其余算 FP(重复检测);未被任何预测框命中的真实框对应 FN(漏检)。
PR 曲线与 AP
Section titled “PR 曲线与 AP”调整检测器的置信度阈值,会得到不同 (Precision, Recall) 点,连起来就是 PR 曲线(Precision-Recall Curve)。
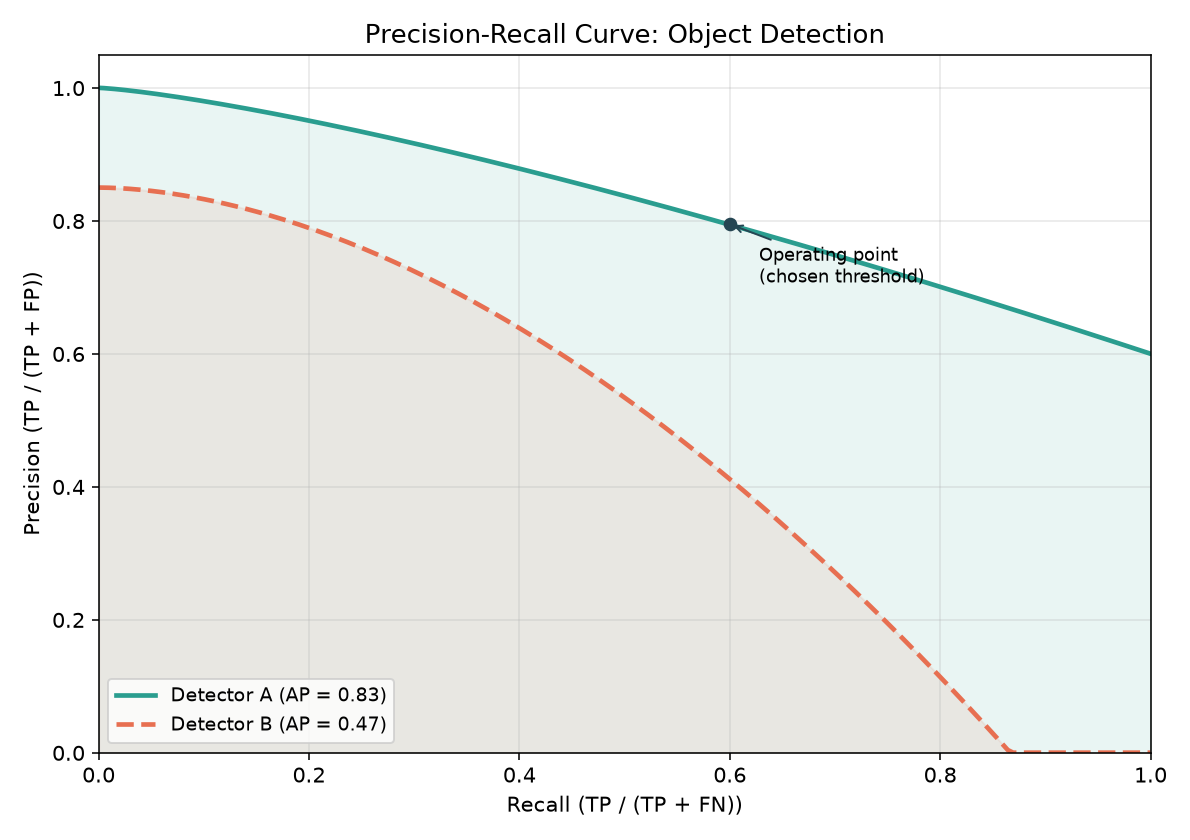
**AP(Average Precision,平均精度)**是 PR 曲线下的面积:
AP 越接近 1 越好。**mAP(mean AP)**是所有类别 AP 的平均。两个常见口径:
- mAP@0.5(PASCAL VOC 口径):IoU 阈值固定 0.5 时各类 AP 的平均。较宽松。
- mAP@[0.5:0.95](COCO 口径):IoU 从 0.5 到 0.95 步长 0.05 共 10 个阈值,每个算 mAP 再平均。更严格,更贴近”框得很准”的要求。
# 用 torchmetrics 算 mAP(简化)from torchmetrics.detection.mean_ap import MeanAveragePrecision
metric = MeanAveragePrecision(iou_type="bbox")  # 默认算 COCO 口径 mAP@[.5:.95]preds = [{"boxes": torch.tensor([[10,10,50,50]]), "scores": torch.tensor([0.9]),          "labels": torch.tensor([1])}]target = [{"boxes": torch.tensor([[12,12,52,52]]), "labels": torch.tensor([1])}]metric.update(preds, target)print(metric.compute())   # {'map': ..., 'map_50': ...}
三、漏报率与误报率在工业场景的重要性
Section titled “三、漏报率与误报率在工业场景的重要性”学术上常看 Precision/Recall,工业部署中**漏报率(FNR)与误报率(FPR)**更直观地对应业务代价:
漏报(False Negative)的代价往往远高于误报(False Positive),这决定了很多工业场景的阈值选择:
| 场景 | 漏报代价 | 误报代价 | 倾向 |
|---|---|---|---|
| 癌症筛查 | 漏诊 → 错过治疗时机,危及生命 | 误报 → 复检,焦虑 + 成本 | 宁误报不漏报(低阈值、高 Recall) |
| 自动驾驶行人检测 | 漏检 → 车祸,致命 | 误报 → 误刹车,体验差 | 极度避免漏报 |
| 欺诈/入侵检测 | 漏报 → 资金/数据损失 | 误报 → 人工复核成本 | 宁误报不漏报 |
| 垃圾邮件过滤 | 漏报 → 收到垃圾邮件(轻微) | 误报 → 正常邮件被误删(严重) | 宁漏报不误报(高阈值、高 Precision) |
ROC 曲线(Receiver Operating Characteristic)以 FPR 为横轴、TPR(= Recall)为纵轴,AUC-ROC 衡量模型在不同阈值下的整体区分能力。但在类别极不平衡(如欺诈 0.01%)时,PR 曲线比 ROC 更敏感、更有信息量——ROC 在这种情况下会虚高。详见 模型评估 的 ROC vs PR 对比。
工业部署的经验:先根据业务确定”可接受的漏报率/误报率”,再在该约束下最大化另一指标。阈值不是从指标算出来的,是从业务代价反推出来的。
四、LLM 评估指标
Section titled “四、LLM 评估指标”大语言模型生成的是自由文本,没有唯一正确答案,传统分类指标失效。评估 LLM 需要专门的指标。基础的困惑度、BLEU、ROUGE 在 模型评估 已有介绍,这里补充原理与新增指标。
Perplexity(困惑度)
Section titled “Perplexity(困惑度)”Perplexity 衡量语言模型对一段文本的”惊讶程度”——越低说明模型越觉得这段文本”自然”。它是平均负对数似然的指数:
其中 是模型在给定前文时对下一个 token 的预测概率。直觉:PPL = 意味着模型在每个位置”平均在 个等概率词之间犹豫”。PPL 越低,模型越确定、文本越符合模型预期。
局限:PPL 只能衡量”语言建模”质量,不能衡量”回答对不对""有没有幻觉”。一个 PPL 很低的模型可能流畅地胡说八道。PPL 主要用于预训练阶段监控,不用于下游任务评估。
BLEU(双语评估替补)
Section titled “BLEU(双语评估替补)”BLEU(Bilingual Evaluation Understudy)是机器翻译的经典指标,衡量生成文本与参考文本的 n-gram 重合度:
- :n-gram 精度(生成文本中 n-gram 出现在参考文本里的比例)。通常 ,权重 。
- BP(Brevity Penalty,短句惩罚):惩罚过短的生成(避免只输出几个高精度词就刷分):,其中 是参考长度, 是生成长度。
BLEU 取值 0–1(或 0–100),越高越好。局限:只看字面 n-gram 重合,不捕捉语义;同义词替换会得分很低;对参考文本数量敏感。主要用于翻译,不适合开放对话。
ROUGE(面向召回的评估)
Section titled “ROUGE(面向召回的评估)”ROUGE(Recall-Oriented Understudy for Gisting Evaluation)是文本摘要的经典指标,与 BLEU 互补——侧重召回(参考文本里的内容有没有被生成出来):
- ROUGE-N:参考文本与生成文本的 n-gram 召回率。最常用 ROUGE-1(词级)、ROUGE-2(二元词组级)。
- ROUGE-L:基于最长公共子序列(LCS, Longest Common Subsequence)。。ROUGE-L 对词序敏感,能捕捉句子结构相似性。
from evaluate import load # HuggingFace evaluate 库rouge = load("rouge")scores = rouge.compute(predictions=["the cat sat on the mat"], references=["the cat is on the mat"])# {'rouge1': ..., 'rouge2': ..., 'rougeL': ...}BERTScore:语义级相似
Section titled “BERTScore:语义级相似”BLEU/ROUGE 只看字面重合,“开心”与”快乐”会被判为完全不同。BERTScore 用预训练模型(如 BERT)的嵌入计算生成与参考的语义相似度:
- 用 BERT 编码生成句和参考句,得到每个 token 的上下文向量。
- 对生成句的每个 token,在参考句中找余弦相似度最大的 token(greedy 匹配),得到 Precision;反向得 Recall;再算 F1。
BERTScore 能识别同义表达,比 BLEU/ROUGE 更贴合人类判断,已成为生成式任务(翻译、摘要、对话)的主流辅助指标。
2025–2026 的 LLM 评估范式
Section titled “2025–2026 的 LLM 评估范式”- LLM-as-Judge:用更强的模型(GPT-4 / Claude)给被评估模型的输出打分,按”帮助性、准确性、安全性”等维度评 1–5 分。优点是可扩展、成本低;缺点是 Judge 模型有自身偏见(如偏好冗长、偏好自己风格)。详见 模型评估 的 LLM-as-Judge 章节。
- 成对比较与 Elo Rating:让两个模型对同一问题作答,人类或 Judge 模型选更好的,用 Elo(或 Bradley-Terry 模型)算排名。Chatbot Arena 是最权威的 LLM 排行榜。
- LLM-free / 基于参考的指标复兴:因 LLM-as-Judge 的可复现性与成本问题,社区重新重视 ROUGE、BERTScore、n-gram 类指标作为廉价、可复现的基线。
五、RAG 评估:RAGAS
Section titled “五、RAG 评估:RAGAS”RAG(Retrieval-Augmented Generation,检索增强生成)系统有两道关:检索对不对和生成对不对。RAGAS(Retrieval-Augmented Generation Assessment)是专为 RAG 设计的评估框架,从”检索质量”和”生成质量”两端给出指标。
三大核心指标
Section titled “三大核心指标”1. Faithfulness(忠实度)——生成答案是否忠于检索到的上下文(不编造)。
把答案拆成若干陈述(statement),逐条判断能否被检索上下文支持:
Faithfulness 低 = 答案里有检索资料没说的内容 = 幻觉。这是 RAG 最关键的指标。
2. Answer Relevancy(答案相关性)——答案是否切题(针对用户问题回答)。
用 LLM 从答案反向生成若干”可能的问题”,算这些生成问题与原始问题的语义相似度:
相关性低 = 答非所问或啰嗦跑题。
3. Context Precision(上下文精度)——检索回来的上下文里,相关的排在前面吗?
衡量检索结果排序的质量,类似检索中的 Precision@k / NDCG:
其中 表示第 条检索结果是否相关。Context Precision 低 = 相关文档排在后面(或没检索到)= 检索器需优化。
from ragas import evaluatefrom ragas.metrics import faithfulness, answer_relevancy, context_precisionfrom datasets import Dataset
data = Dataset.from_dict({    "question": ["GPT-4 是哪一年发布的?"],    "answer": ["GPT-4 于 2023 年 3 月发布。"],    "contexts": [["OpenAI 于 2023 年 3 月发布了 GPT-4。"]],    "ground_truth": ["2023 年 3 月"],})result = evaluate(data, metrics=[faithfulness, answer_relevancy, context_precision])print(result)   # {'faithfulness': 1.0, 'answer_relevancy': ..., 'context_precision': ...}
RAG 评估的工程意义:Faithfulness 和 Context Precision 把”RAG 出错”拆成了”检索错”还是”生成错”两个可定位的故障——前者改 embedding/召回策略,后者改 prompt/生成模型。这种指标即诊断的特性是 RAGAS 的核心价值。
补充指标:Context Recall(相关上下文是否都被检索到,针对有 ground-truth 的场景)、Answer Correctness(答案与标准答案的吻合度,结合语义与事实)。
六、Agent 评估
Section titled “六、Agent 评估”LLM Agent(智能体)能调用工具、规划多步、与环境交互——评估远比单轮问答复杂。Agent 评估从三个层面展开:最终结果、工具使用、行动轨迹。
1. 任务完成率(Task Success Rate)
Section titled “1. 任务完成率(Task Success Rate)”最直接的指标:任务有没有完成。需要一个判定器(ground-truth 答案、断言测试或 LLM-as-Judge)判断 Agent 的最终输出是否达成目标。
这是 Agent 评估的”准确率”。但同样的成功率背后,路径可能差很多——5 步完成和 50 步完成体验截然不同。
2. 工具调用准确率(Tool Call Accuracy)
Section titled “2. 工具调用准确率(Tool Call Accuracy)”Agent 调对工具了吗?参数传对了吗?按工具调用的对错评估:
- 工具选择准确率:该调 A 工具时调了 A 的比例。
- 参数准确率:调用工具时传入参数正确的比例。
- 调用次数:是否过度调用(冗余)或调用不足。
# 简化示例:评估 Agent 的工具调用序列def tool_accuracy(predictions, references):    correct = sum(p == r for p, r in zip(predictions, references))    return correct / len(references)
pred_calls = ["search", "calculator", "summarize"]true_calls = ["search", "calculator", "answer"]print(tool_accuracy(pred_calls, true_calls))   # 0.67
3. 轨迹评估(Trajectory Evaluation)
Section titled “3. 轨迹评估(Trajectory Evaluation)”不只看结果,还看走的路对不对。一条好的轨迹应该:步骤合理、无冗余、无死循环、遵循规范。常用度量:
- 轨迹精确匹配(Exact Match):Agent 的动作序列与专家示范(reference trajectory)完全一致的比例。过于严格,很少单独用。
- 轨迹效率:实际步数 / 最短步数,衡量是否绕路。
- 无效动作率:失败/被拒绝/重复的工具调用占比。
- 基于 LLM 的轨迹评分:让 Judge 模型看完整轨迹,按”规划合理性""是否遵循 SOP""有无幻觉”打分。
| 指标 | 衡量什么 | 典型用途 |
|---|---|---|
| 任务完成率 | 最终结果对不对 | 总体能力,Agent benchmark 主指标 |
| 工具调用准确率 | 工具用对没 | 评估 function calling 能力 |
| 轨迹效率 | 步数是否经济 | 评估规划与成本 |
| 无效动作率 | 是否乱调工具/死循环 | 评估稳定性与鲁棒性 |
| 轨迹合理性(LLM 评分) | 整条路径合不合理 | 综合质量,替代人工评审 |
代表性 Agent Benchmark
Section titled “代表性 Agent Benchmark”- AgentBench / GAIA / SWE-bench:多任务 Agent 能力评测。其中 SWE-bench(软件工程任务,让 Agent 修 GitHub issue)是 2024–2025 年最被看重的代码 Agent 基准。
- ToolBench / API-Bank:专门评估工具调用能力。
- WebArena / VisualWebArena:让 Agent 操作真实网页(浏览器自动化)完成任务的沙箱评测。
- τ-bench(Tau-bench):多轮工具调用与策略遵循的精细评测。
评估方法论的共性陷阱
Section titled “评估方法论的共性陷阱”- 数据污染(Contamination):评估集混入了训练数据,模型”背答案”导致虚高。大模型时代尤其严重——网上的 benchmark 答案大概率进了预训练语料。需用私有/动态生成的评估集。
- 指标与目标错配:用 BLEU 评估对话(对话不该逐字匹配参考)、用准确率评估欺诈检测(不平衡)。永远先问”这个指标对应我的真实目标吗”。
- 单点评估:只报一个阈值下的 Precision/Recall 会误导。PR 曲线和 mAP 给出全貌。
- 过拟合评估集:反复在同一个测试集上调参/选模型,等于把它当成验证集用了,性能虚高。需要留出 untouched 的最终测试集。
- 人类评估的金标准地位:对生成式任务,自动指标(BLEU/ROUGE/BERTScore)都只是人类判断的近似。最终决策级评估仍需人工评审或成对比较。
2025-2026 最新进展
Section titled “2025-2026 最新进展”- LLM-as-Judge 成为生成式评估标配,但伴随”偏好模型校准""Judge 偏见校正""自一致性”等改进,社区推出更鲁棒的 Judge 协议(如 Chatbot Arena 的 Bradly-Terry + Elo)。
- RAG 评估工业化:RAGAS、TruLens、DeepEval、LangSmith 形成完整的 RAG 可观测栈,把 faithfulness/context precision 等指标接入 CI/CD,持续监控线上 RAG 质量。
- 动态与对抗性基准:为对抗”benchmark 刷榜”和污染,社区推出动态生成、不断更新的评测(如 LiveBench、Dynabench),让模型无法预先记忆答案。
- Agent 评估走向真实任务:SWE-bench Verified、SWE-bench Multimodal、τ-bench 等推动 Agent 评估从”玩具任务”转向真实软件/客服/操作场景,2026 年多模态 Agent 评估成为热点。
- 过程奖励模型(PRM):用于评估与引导 Agent 的中间步骤而非仅最终结果,OpenAI 的 o1/RM、DeepSeek-R1 的推理链评估均采用此类思路。
- 多模态评估:CLIPScore 之外,出现针对 VLM(视觉语言模型)幻觉(如 POPE、MMHal-Bench)、图文一致性(如 T2I-CompBench)的专项指标。
- 开源评估平台:OpenCompass、lm-eval-harness、LightEval 等提供统一的评测框架,整合上百个 benchmark,降低”自评”的偏差与成本。
- 模型评估与指标——分类指标、ROC/PR、交叉验证、LLM-as-Judge 的系统推导。
- 损失函数——Focal Loss 等与难例评估相关的损失。
- 句向量与 Embedding——BERTScore、检索评估背后的语义相似度。
- YOLO 目标检测——mAP 在检测器中的应用。
- RAGAS 文档(
docs.ragas.io):RAG 评估指标的最新实现与论文。 - SWE-bench(
github.com/princeton-nlp/SWE-bench):代码 Agent 评估的事实标准。 - OpenCompass / lm-eval-harness:大模型统一评测框架。