
无监督学习
本页是无监督学习(Unsupervised Learning)的概览导航页。无监督学习没有”标准答案”,目标是让数据自己说话——发现数据内部的结构。它的两大核心任务是聚类(把相似的样本归为一组)和降维(把高维数据压缩到低维)。此外,自监督学习(Self-Supervised Learning)作为近年来最突破性的范式,正在模糊”有监督”与”无监督”的边界——它从无标签数据中自动构造监督信号,已成为大模型预训练的基石。
- 聚类:将数据自动分组的完整技术链路(K-means、层次聚类、DBSCAN、GMM、谱聚类等)详见聚类分析。
- 降维:将高维数据映射到低维空间(PCA、t-SNE、UMAP、自编码器、LDA 等)的完整技术链路详见降维技术。
同属”无监督信号”范畴、但按方法论横切划分的概率图模型见概率图模型与半监督学习。
无监督学习的四大经典方法,各自的直觉一句话总结:
- K-means = 把数据分成 K 团:随机撒 K 个种子,每个数据点归到最近的种子,然后种子移动到它那团数据的重心,重复直到稳定。就像磁铁吸引铁屑一样自然成团。详细原理(EM 视角、数学推导、参数选择)见聚类分析。
- PCA = 找最佳拍照角度:高维数据是一个立体物体,PCA 要找一个角度,让投影到低维的影子”信息量最大”(方差最大)。就像拍照找角度——从正面拍比从顶部拍能看到更多细节。
- DBSCAN = 看人群密度:人多的地方自然形成一团(簇),孤立的零星人就是噪声。不需要预先指定簇数,还能发现任意形状的簇。详细原理(核心点/边界点/噪声点)见聚类分析。
- t-SNE = 弹性地图:把高维点之间用弹簧连着,拉到 2D 平面上让局部结构尽量保持。专门用于可视化。
聚类方法众多,怎么选?看数据形状:球形簇用 K-means,不规则形状用 DBSCAN,需要概率解释用 GMM,需要可视化层级用层次聚类。完整的算法对比和选型建议见聚类分析。
无监督学习的理论定位
Section titled “无监督学习的理论定位”在机器学习的三大范式中,无监督学习独树一帜:
| 范式 | 训练数据 | 目标 | 典型方法 |
|---|---|---|---|
| 监督学习 | (有标签) | 学习 | 分类、回归 |
| 无监督学习 | (无标签) | 发现数据内部结构 | 聚类、降维、密度估计 |
| 自监督学习 | → 自动构造 | 从数据自身构造监督信号 | 掩码语言建模、对比学习 |
无监督学习的核心假设是:数据中存在固有的结构(簇、流形、因子),算法的任务是把这个结构揭示出来。这与监督学习有本质区别——监督学习优化的是”预测标签的准确性”,无监督学习优化的是”对数据分布的理解程度”。
从信息论角度看,无监督学习可以理解为对数据分布 建模或近似:
- 聚类假设 是混合分布 ,目标是推断每个样本属于哪个成分。
- 降维假设高维数据 实际由低维隐变量 ()生成,即 ,目标是恢复 。
- 密度估计直接建模 ,如核密度估计(KDE)、归一化流(Normalizing Flows)。
聚类还是降维?
Section titled “聚类还是降维?”两大任务选哪个,取决于你想用数据干什么:
K-means 迭代过程
Section titled “K-means 迭代过程”K-means 通过交替执行”分配”和”更新”两步收敛:
这本质上是 EM 算法的特例——E 步分配、M 步更新中心。完整数学推导和 EM 视角见聚类分析。
K-means 的数学目标是最小化簇内平方和(Within-Cluster Sum of Squares, WCSS),也叫 inertia:
其中 是簇 的质心(centroid,即簇内所有点的均值位置)。这个问题是 NP-hard 的,K-means 算法是一种贪心近似——保证收敛到局部最优,但不保证全局最优。
PCA 降维流程
Section titled “PCA 降维流程”PCA 通过特征值分解找到信息量最大的投影方向:
PCA 的数学直觉:给定中心化后的数据矩阵 ,PCA 求协方差矩阵 的特征值分解 。取前 个最大特征值对应的特征向量 ,投影 即为降维结果。第 个主成分的解释方差比为:
其中 是第 大的特征值。这个比值告诉你:第 个主成分保留了多少原始数据的信息量。取前 个主成分的累积解释方差比 通常应达到 85%-95%,才认为降维没有丢失太多信息。
算法对比总览
Section titled “算法对比总览”聚类算法对比
Section titled “聚类算法对比”| 算法 | 核心思想 | 簇形状 | 需指定簇数 | 噪声处理 | 复杂度 | 适用场景 |
|---|---|---|---|---|---|---|
| K-means | 最小化簇内方差 | 球形 | ✅ K | ❌ 每点必须归簇 | 大规模、簇近似球形 | |
| 层次聚类 | 自底向上/自顶向下合并/分裂 | 任意 | ❌ 后切 dendrogram | ❌ | 中小规模、需要层级结构 | |
| DBSCAN | 基于密度连通性 | 任意形状 | ❌ 自动 | ✅ 标记噪声 | 不规则形状、含噪声 | |
| HDBSCAN | DBSCAN + 层级密度 | 任意形状 | ❌ 自动 | ✅ 更稳健 | 密度不均的真实数据 | |
| GMM | 假设数据为高斯混合 | 椭球 | ✅ K | ❌ 软分配(概率) | 需要概率/不确定度 | |
| 谱聚类 | 图分割 + 特征分解 | 任意 | ✅ K | ❌ | 非凸形状、图数据 |
选型直觉:先看数据量和簇形状。大数据 + 球形 → K-means;不规则形状 + 噪声 → DBSCAN/HDBSCAN;需要概率 → GMM;需要层级结构 → 层次聚类;图像分割/图数据 → 谱聚类。不确定就先试 K-means(最快),再看 DBSCAN(最鲁棒)。
降维算法对比
Section titled “降维算法对比”| 算法 | 类型 | 保留信息 | 有无 transform | 速度 | 适用场景 |
|---|---|---|---|---|---|
| PCA | 线性 | 全局方差 | ✅ 可 transform 新数据 | 快 | 特征压缩、去噪、预处理 |
| LDA | 线性(监督) | 类间可分性 | ✅ | 快 | 有标签的分类预处理 |
| t-SNE | 非线性 | 局部邻域 | ❌ 仅可视化 | 慢 | 高维数据可视化 |
| UMAP | 非线性 | 局部 + 全局 | ✅ 可 transform | 中 | 可视化 + 通用降维 |
| 自编码器 | 非线性 | 重建误差 | ✅ | 中(需训练) | 复杂非线性降维、去噪 |
| PaCMAP | 非线性 | 局部 + 全局 + 中距 | ✅ | 中 | 2020 提出,兼顾局部/全局结构 |
K-means 聚类
Section titled “K-means 聚类”from sklearn.cluster import KMeansfrom sklearn.datasets import make_blobs
# 生成 3 簇模拟数据(无标签)X, _ = make_blobs(n_samples=300, centers=3, random_state=42)
# K-means 聚类kmeans = KMeans(n_clusters=3, random_state=42, n_init=10)labels = kmeans.fit_predict(X)
print(f"聚类中心坐标:\n{kmeans.cluster_centers_.round(1)}")print(f"簇内平方和(inertia): {kmeans.inertia_:.2f}")# inertia 越小说明簇内越紧凑更多算法(DBSCAN、GMM、层次聚类、谱聚类)的代码对比见聚类分析。
PCA 降维
Section titled “PCA 降维”from sklearn.decomposition import PCAfrom sklearn.datasets import make_blobs
# 生成高维数据(10 维,3 簇)X, _ = make_blobs(n_samples=300, centers=3, n_features=10, random_state=42)
# 降到 2 维(用于可视化)pca = PCA(n_components=2)X_reduced = pca.fit_transform(X)
print(f"降维前: {X.shape} → 降维后: {X_reduced.shape}")print(f"各主成分解释方差比: {pca.explained_variance_ratio_.round(3)}")print(f"前 2 维保留的信息量: {pca.explained_variance_ratio_.sum():.1%}")聚类完整流程:选 K → 聚类 → 评估 → 预测新样本
Section titled “聚类完整流程:选 K → 聚类 → 评估 → 预测新样本”把无监督学习跑成一条完整链路——不只是画个图,还要能评估质量、预测新样本属于哪个簇:
from sklearn.cluster import KMeansfrom sklearn.datasets import make_blobsfrom sklearn.preprocessing import StandardScalerfrom sklearn.metrics import silhouette_score
# 第 1 步:生成 3 簇模拟数据并标准化(K-means 基于距离,必须标准化)X, _ = make_blobs(n_samples=300, centers=3, random_state=42)X = StandardScaler().fit_transform(X)
# 第 2 步:肘部法则选 K——看 inertia(簇内平方和)的拐点for k in range(2, 7):    km = KMeans(n_clusters=k, random_state=42, n_init=10)    km.fit(X)    print(f"K={k}: inertia={km.inertia_:.1f}")# 输出示例: K=3 之后下降明显变缓 → 拐点即肘部,选 K=3
# 第 3 步:用选定的 K 聚类kmeans = KMeans(n_clusters=3, random_state=42, n_init=10)labels = kmeans.fit_predict(X)
# 第 4 步:轮廓系数评估聚类质量(范围 -1 到 1,越大越好)print(f"轮廓系数: {silhouette_score(X, labels):.3f}")
# 第 5 步:预测新样本属于哪个簇(相当于业务中的"新用户归群")new_sample = [[0.4, -0.2]]   # 一个新样本的 2 个特征print(f"新样本所属簇: {kmeans.predict(new_sample)[0]}")
K-means 与 DBSCAN 对比演示
Section titled “K-means 与 DBSCAN 对比演示”from sklearn.cluster import KMeans, DBSCANfrom sklearn.datasets import make_moons # 月牙形数据from sklearn.preprocessing import StandardScalerimport matplotlib.pyplot as plt
# 生成月牙形数据——K-means 的"克星"X, _ = make_moons(n_samples=300, noise=0.05, random_state=42)X = StandardScaler().fit_transform(X)
fig, axes = plt.subplots(1, 2, figsize=(12, 5))
# K-means:强制分成 2 个球簇,完全无法处理月牙形km = KMeans(n_clusters=2, random_state=42, n_init=10)axes[0].scatter(X[:, 0], X[:, 1], c=km.fit_predict(X), cmap='Set1')axes[0].set_title("K-means:无法处理非球形簇")
# DBSCAN:基于密度,能正确识别两个月牙db = DBSCAN(eps=0.3, min_samples=5)axes[1].scatter(X[:, 0], X[:, 1], c=db.fit_predict(X), cmap='Set1')axes[1].set_title("DBSCAN:正确识别任意形状")
plt.tight_layout()plt.savefig("kmeans_vs_dbscan.png", dpi=150)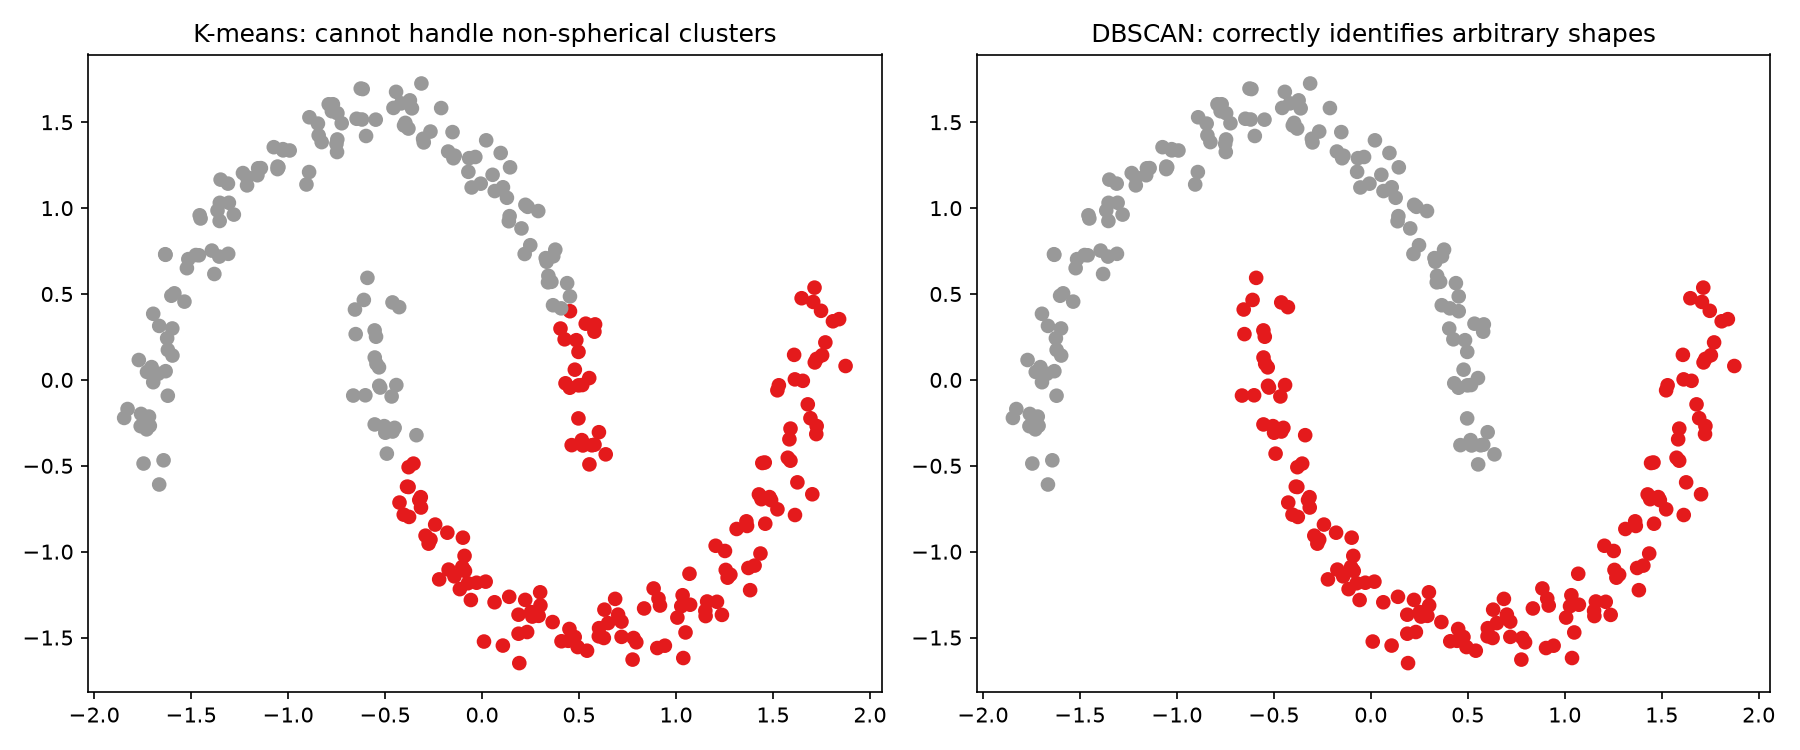
关键启示:K-means 的”球簇假设”不是小瑕疵——在真实数据中,簇的形状往往远比球形复杂。遇到不理想的聚类结果时,首先检查的应该是算法假设是否与数据形状匹配。
聚类评估指标
Section titled “聚类评估指标”无监督学习没有”标准答案”,如何评估聚类质量?主要有两类指标:
内部评估(不需要真实标签)
Section titled “内部评估(不需要真实标签)”| 指标 | 公式直觉 | 取值范围 | 越大/越小越好 |
|---|---|---|---|
| 轮廓系数 (Silhouette) | ,=簇内平均距离,=最近簇间平均距离 | 越大越好(>0.5 为好) | |
| Davies-Bouldin | 各簇间”相似度”的均值 | 越小越好 | |
| Calinski-Harabasz | 簇间方差 / 簇内方差之比 | 越大越好 | |
| Inertia (WCSS) | 簇内平方和 | 越小越好(但随 K 下降) |
轮廓系数是最常用的——它同时考虑了簇内紧密度()和簇间分离度(),直观意义是:如果样本离自己簇很近、离最近的其他簇很远,分数就接近 1。
外部评估(有真实标签但训练时不用)
Section titled “外部评估(有真实标签但训练时不用)”| 指标 | 说明 |
|---|---|
| Adjusted Rand Index (ARI) | 衡量两种划分的一致性,考虑随机修正 |
| Normalized Mutual Information (NMI) | 基于信息论,衡量两种划分共享的信息量 |
| V-measure | 聚类的同质性和完整性的调和平均 |
自监督学习:无监督的”新纪元”
Section titled “自监督学习:无监督的”新纪元””自监督学习(Self-Supervised Learning, SSL)是近年来 AI 领域最重大的范式转变之一。它巧妙地解决了无监督学习缺乏监督信号的困境:从数据本身自动构造”伪标签”,从而利用强大的监督学习框架。
核心思想:从数据中”免费”获取监督信号
Section titled “核心思想:从数据中”免费”获取监督信号”传统监督学习: 人工标注 → (x, y) → 训练模型 ← 标注成本高传统无监督学习: 只有 x → 发现结构 ← 效果有限自监督学习: 自动变换 → (x', 伪标签) → 训练 ← 标注免费!三大主流方法
Section titled “三大主流方法”1. 掩码建模(Masked Modeling)
Section titled “1. 掩码建模(Masked Modeling)”直觉:把数据的一部分”挖掉”,让模型预测被挖掉的部分。
- NLP:BERT 将句子中 15% 的 token 用
[MASK]替换,模型预测原始 token。这就是让模型做”完形填空”。 - 视觉:MAE(Masked Autoencoder)将图像 75% 的 patch 遮盖,模型重建被遮盖区域。这迫使模型理解图像的全局语义而非局部纹理。
- 音频:wav2vec 2.0 / HuBERT 对原始波形的一部分做掩码,模型预测量化后的离散表示。
数学形式(以掩码语言建模为例):
其中 是被掩码的位置集合, 是未被掩码的上下文。
2. 对比学习(Contrastive Learning)
Section titled “2. 对比学习(Contrastive Learning)”直觉:让”相似”的样本在表示空间中靠近,“不相似”的样本远离。
核心思想用 InfoNCE 损失表达:
其中 是查询样本的表示, 是正样本(同一图像的不同增强), 是负样本(不同图像), 是温度参数, 是相似度函数(通常用余弦相似度)。
- SimCLR:同一图像做两次不同的数据增强(裁剪、颜色变换),作为正样本对;batch 内其他图像作为负样本。
- CLIP:图像-文本对作为正样本,batch 内不匹配的图文对作为负样本。学习到的联合空间支持零样本分类(zero-shot classification)。
- MoCo:用动量编码器维护一个大规模负样本队列,突破 batch size 限制。
3. 非对比/蒸馏方法
Section titled “3. 非对比/蒸馏方法”直觉:不需要负样本,让两个”视图”的表示互相蒸馏。
- BYOL(Bootstrap Your Own Latent):一个在线网络预测目标网络的表示,目标网络用 EMA(指数移动平均)更新。神奇的是——不需要负样本也能学到有用表征!
- DINO / DINOv2(Meta):Vision Transformer 的自监督方法,学生网络学习匹配教师网络的输出分布。DINOv2 (2023) 在大规模未标注数据上训练,生成的通用视觉表征可以直接用于下游任务而无需微调。
自监督学习 2024-2025 趋势
Section titled “自监督学习 2024-2025 趋势”| 趋势 | 代表工作 | 核心贡献 |
|---|---|---|
| 多模态自监督 | CLIP、ImageBind、LanguageBind | 统一图像/音频/文本/视频/IMU 等多模态表示空间 |
| 视觉基础模型 | DINOv2、SAM/SAM 2 | 在 10 亿+ 未标注图像上训练,零样本分割、深度估计 |
| 统一架构 | BEiT-3、OmniBERT | 用统一掩码建模同时处理视觉和语言 |
| 音频自监督 | wav2vec 2.0、HuBERT、MMS | 跨 1000+ 语言的语音表征学习 |
| 视频自监督 | VideoMAE V2、InternVideo | 时序信息 + 空间信息联合学习 |
| LLM 本质就是自监督 | GPT、LLaMA、Qwen | 自回归下一 token 预测是最成功的自监督代理任务 |
💡 大语言模型(LLM)本身就是自监督学习的最大成功。GPT 的训练目标——预测下一个 token——本质上就是一个自监督代理任务:输入是海量无标注文本,“标签”就是文本的下一个词,完全从数据中自动获得,无需人工标注。这意味着无监督/自监督学习不再只是”辅助”——它已经是当前 AI 的主流训练范式。
自监督 vs 传统无监督:关键区别
Section titled “自监督 vs 传统无监督:关键区别”| 维度 | 传统无监督 | 自监督学习 |
|---|---|---|
| 监督信号 | 无(直接发现结构) | 自动构造(代理任务) |
| 训练框架 | 无梯度信号或变分推断 | 标准监督学习(交叉熵等) |
| 表征质量 | 中等 | 接近甚至超越有监督预训练 |
| 可扩展性 | 有限 | 极强(数据越多越好) |
| 典型产出 | 簇分配、低维坐标 | 可迁移的通用表征 |
- K-means 要先标准化数据:因为它基于欧氏距离,大量纲特征会主导聚类结果。更多 K-means 调优技巧(选 K、评估指标)见聚类分析。
- K-means 需要手动指定 K:可以用”肘部法则”(elbow method)或轮廓系数(silhouette score)来选 K。
- K-means 只能发现球形簇:对环形、月牙形等不规则形状的数据,换用 DBSCAN 或 HDBSCAN。
- PCA 降维前也要标准化,否则大量纲特征会主导主成分方向。用
StandardScaler或MinMaxScaler。 - t-SNE 仅用于可视化:它的目的是把高维数据”画”到 2D/3D 平面上看结构,不适合作为后续建模的降维手段(没有
transform接口)。需要降维 + 建模时用 UMAP 或 PCA。 - UMAP > t-SNE 的场景:UMAP 既保留局部结构又保留全局结构,速度快,且可对新数据做
transform,是 2020 年后高维可视化的首选。 - 聚类前先看数据分布:用 PCA 或 UMAP 降到 2D 画散点图,目测簇的形状和数量,再选算法。
- 自监督预训练的数据量决定上限:少量数据(< 1 万样本)做自监督通常不如直接有监督训练;只有数据量足够大(10 万+)时自监督才能发挥优势。
- K-means → 用户分群:电商平台用 K-means 根据消费金额、购买频次、品类偏好等特征将用户分为”高价值用户”、“价格敏感型”等群体,支撑精准营销和差异化运营。更多聚类应用见聚类分析。
- DBSCAN → 异常检测:密度聚类天然把孤立点标记为噪声,与异常检测密切相关。
- PCA → 数据可视化与特征压缩:将几十上百维特征降到 2–3 维用于可视化;或在建模前压缩特征维度、去除噪声加速训练——人脸识别中的 Eigenface 就是 PCA 的经典应用。
- t-SNE / UMAP → 高维数据可视化:将深度学习模型提取的高维 embedding 投影到 2D 平面,直观查看样本是否按语义聚类——TensorBoard Embedding Projector 的核心可视化工具。
- 自监督 → LLM 预训练:GPT、LLaMA 等大语言模型使用自回归下一 token 预测进行预训练——本质上就是自监督学习。详见语言模型演进。
- 自监督 → 视觉基础模型:DINOv2、SAM 等视觉基础模型用自监督方法在大规模无标注图像上训练,生成可迁移的通用视觉表征。
- 自编码器 → 降噪与异常检测:训练自编码器重建正常数据,输入异常数据时重建误差骤增,用于工业缺陷检测、信用卡欺诈检测。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| scikit-learn | Python | 提供 KMeans、DBSCAN、AgglomerativeClustering、PCA、t-SNE 等聚类降维算法 |
| SciPy(scipy.cluster) | Python | SciPy 的层次聚类模块,提供 linkage、fcluster 等经典函数 |
| hdbscan | Python | 基于 HDBSCAN 的密度聚类库,DBSCAN 的改进版,自动选择最优簇数 |
| umap-learn | Python | UMAP 降维库,比 t-SNE 更快且更好地保留全局结构 |
| pacmap | Python | PaCMAP 降维库,兼顾局部和全局结构,适合大规模可视化 |
| torch / transformers | Python | 自监督预训练框架(MAE、SimCLR、BERT 等均基于 PyTorch) |
| 术语 | 英文 | 解释 |
|---|---|---|
| 聚类 | Clustering | 在无标签数据下将相似样本归为一组的无监督任务 |
| 质心 | Centroid | 一个簇内所有样本的均值中心点,K-means 迭代更新的对象 |
| 肘部法则 | Elbow Method | 绘制簇内平方和随 K 的变化曲线,在”肘部”拐点选择 K |
| 轮廓系数 | Silhouette Score | 衡量聚类质量的指标,结合簇内紧密度与簇间分离度 |
| 降维 | Dimensionality Reduction | 将高维数据映射到低维空间,同时尽量保留原始信息 |
| 解释方差比 | Explained Variance Ratio | PCA 中各主成分保留的原始数据方差比例 |
| 流形学习 | Manifold Learning | 假设高维数据位于低维流形上的非线性降维方法(如 t-SNE、UMAP) |
| 自监督学习 | Self-Supervised Learning (SSL) | 从无标签数据中自动构造监督信号进行训练的范式 |
| 代理任务 | Pretext Task | 自监督学习中自动设计的辅助任务(如掩码预测、对比),用于学习有用表征 |
| 对比学习 | Contrastive Learning | 拉近正样本对、推远负样本对的自监督方法 |
| 掩码建模 | Masked Modeling | 遮盖数据一部分让模型预测的自监督方法(BERT、MAE) |
| InfoNCE 损失 | InfoNCE Loss | 对比学习中常用的损失函数,基于噪声对比估计 |
- 聚类谱系:K-means(Lloyd 1957 提出、1982 发表;MacQueen 1967 命名)为划分式代表;层次聚类(Ward 1963);DBSCAN(1996,密度式,可发现任意形状簇);GMM + EM 算法(Dempster, Laird, Rubin 1977)为模型式代表。完整的算法详解、数学推导、代码对比见聚类分析。
- 降维谱系:PCA(Pearson 1901 / Hotelling 1933,本质是矩阵分解);t-SNE(van der Maaten & Hinton 2008,可视化/流形学习);UMAP(McInnes 2018,比 t-SNE 更快更好);PaCMAP(Wang et al. 2020,兼顾局部/全局结构)。
- 自监督学习里程碑:
- NLP:Word2Vec (2013) → ELMo (2018) → BERT (2018, 掩码语言建模) → GPT 系列 (自回归预训练)。
- 视觉:SimCLR (2020, 对比学习) → BYOL (2020, 非对比) → MAE (2021, 掩码图像建模) → DINOv2 (2023, 大规模视觉基础模型) → SAM 2 (2024, 零样本分割)。
- 音频:wav2vec 2.0 (2020) → HuBERT (2021) → MMS (2023, 1000+ 语言)。
- 分类争议:PCA、t-SNE 无”训练/预测”过程,严格说是统计/可视化方法而非”学习”,但教科书均放在无监督学习章节。自监督学习虽然训练时有”伪标签”,但因其不依赖人工标注,通常也归入广义的无监督学习范畴。