
3D 视觉与机器人
3D 视觉是机器人从”看到二维像素”到”理解三维空间”的关键飞跃。传统的 2D 视觉只能处理图像平面上的颜色与纹理信息,而 3D 视觉引入了深度 (Depth) 维度,使得机器人能够感知物体的大小、距离、朝向以及在空间中的位姿 (Pose)。对于工业场景中的机械臂抓取、自主导航、质量检测等任务,3D 视觉是不可或缺的基础能力。
本页聚焦于 3D 视觉与机器人感知中的核心算法链路——从相机标定到位姿估计,从 RGB-D 传感到多传感器融合,从坐标变换到 ROS 通信框架。如果你对深度估计的深度学习方法感兴趣,可以先阅读 深度估计 了解单目深度预测的神经网络方法;本页更侧重于经典几何方法与工程实践。在系统层面,这些技术最终会被集成到完整的 工业 AI 系统 中。
理解 3D 视觉的关键,是抓住一条主线:现实世界中的三维点,经过相机投射后变成二维像素;反过来,从二维像素恢复三维信息,就是 3D 视觉算法的核心任务。
这条链路的前半段(世界→图像)由相机模型和标定解决;后半段(图像→世界→机器人)则是 PnP、深度重建、坐标变换等算法的舞台。
针孔相机模型 (Pinhole Camera Model)
Section titled “针孔相机模型 (Pinhole Camera Model)”针孔相机模型 (Pinhole Model) 是最基础也是最常用的相机成像模型。它将相机简化为一个理想的针孔:光线穿过一个极小的孔,在背后的像平面上形成倒立的图像。
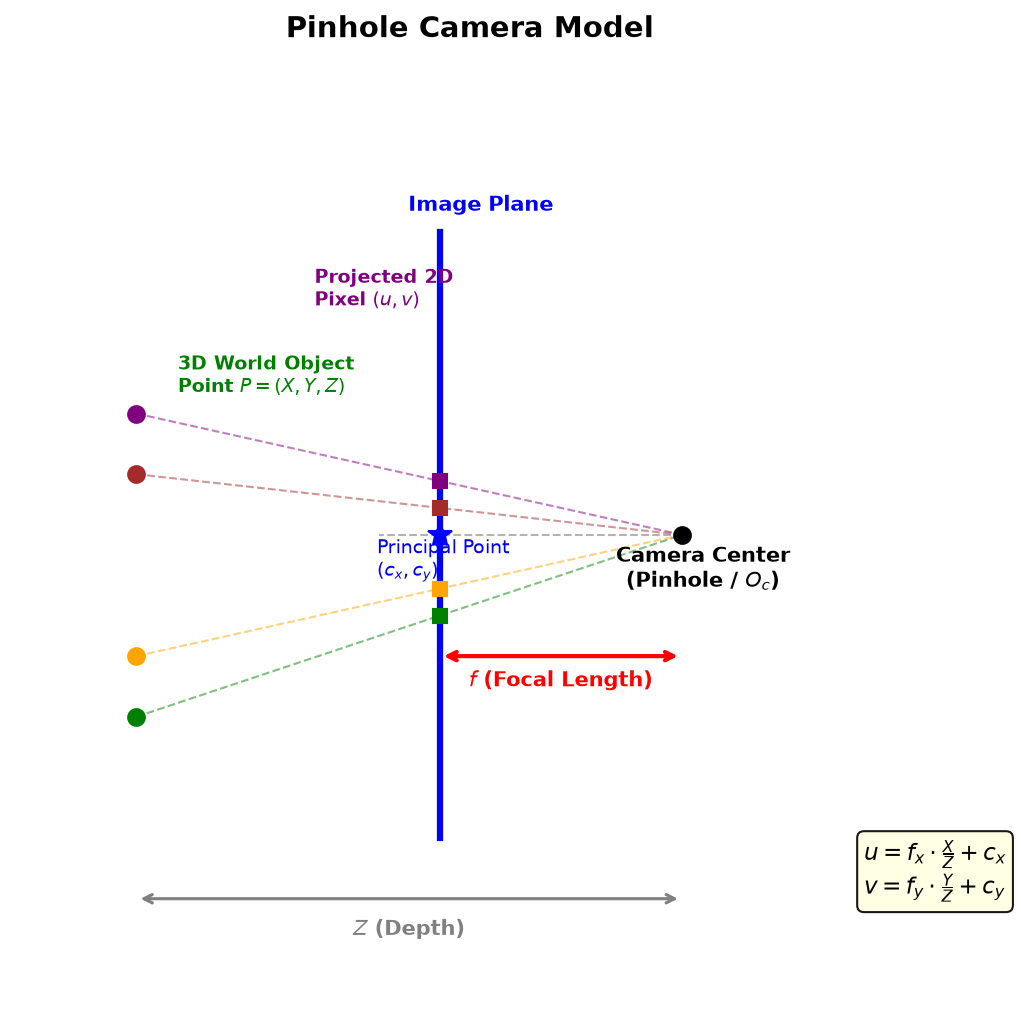
在针孔模型下,三维空间中的点 投影到图像平面上的像素坐标 由以下公式描述:
其中 是以像素为单位的焦距 (Focal Length), 是主点 (Principal Point)——即光轴与像平面的交点,通常接近图像中心。用矩阵形式表示:
矩阵 称为相机内参矩阵 (Intrinsic Matrix),它只与相机本身有关,不随相机移动而变化。
💡 关键区分:内参 (Intrinsic) 描述的是相机内部的光学特性(焦距、主点、畸变),出厂后基本固定;外参 (Extrinsic) 描述的是相机在世界坐标系中的位置和朝向(旋转 和平移 ),每次相机移动都会变化。
张正友标定法 (Zhang’s Method)
Section titled “张正友标定法 (Zhang’s Method)”张正友标定法 (Zhang’s Method) 是目前最广泛使用的相机标定方法,由张正友于 2000 年提出。它使用一块打印的棋盘格标定板 (Chessboard),从不同角度拍摄多张照片(通常 10-20 张),通过检测棋盘格角点的像素坐标和已知的物理坐标,求解内参矩阵 和畸变系数。
畸变校正 (Distortion Correction)
Section titled “畸变校正 (Distortion Correction)”实际镜头并非理想针孔,存在两类主要畸变:
| 畸变类型 | 英文 | 系数 | 特征 |
|---|---|---|---|
| 径向畸变 | Radial Distortion | 直线变弯曲,鱼眼效果 | |
| 切向畸变 | Tangential Distortion | 图像平面与镜头不平行导致 |
径向畸变的数学模型:
其中 是像素到主点的距离。
OpenCV 标定代码示例
Section titled “OpenCV 标定代码示例”import cv2import numpy as npimport glob
# --- Step 1: 准备棋盘格的 3D 世界坐标 ---# 假设棋盘格内角点为 9x6,每个格子的物理尺寸为 25mmchessboard_size = (9, 6) # (内角点列数, 内角点行数)square_size = 0.025 # 每个格子的边长(米)
# 生成理想棋盘格角点的世界坐标 (Z=0 平面上)objp = np.zeros((chessboard_size[0] * chessboard_size[1], 3), np.float32)objp[:, :2] = np.mgrid[0:chessboard_size[0], 0:chessboard_size[1]].T.reshape(-1, 2)objp *= square_size # 乘以物理尺寸
objpoints = [] # 3D 世界坐标imgpoints = [] # 2D 图像像素坐标
# --- Step 2: 读取标定图像并检测角点 ---images = glob.glob('calibration_images/*.jpg')criteria = (cv2.TERM_CRITERIA_EPS + cv2.TERM_CRITERIA_MAX_ITER, 30, 0.001)
for fname in images: img = cv2.imread(fname) gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
# 棋盘格角点检测 ret, corners = cv2.findChessboardCorners(gray, chessboard_size, None)
if ret: objpoints.append(objp) # 亚像素级角点精化,提高精度 corners_refined = cv2.cornerSubPix(gray, corners, (11, 11), (-1, -1), criteria) imgpoints.append(corners_refined)
print(f"成功检测 {len(objpoints)} 张标定图像")
# --- Step 3: 执行标定 ---ret, K, dist, rvecs, tvecs = cv2.calibrateCamera( objpoints, imgpoints, gray.shape[::-1], None, None)
print("=== 标定结果 ===")print(f"内参矩阵 K:\n{K}")print(f"焦距: fx={K[0,0]:.2f}, fy={K[1,1]:.2f}")print(f"主点: cx={K[0,2]:.2f}, cy={K[1,2]:.2f}")print(f"畸变系数 [k1, k2, p1, p2, k3]: {dist.ravel()}")
# --- Step 4: 去畸变 ---img = cv2.imread(images[0])undistorted = cv2.undistort(img, K, dist, None, K)cv2.imwrite('undistorted.jpg', undistorted)💡 标定质量检查:标定后应计算重投影误差 (Reprojection Error)——将 3D 点重新投影到图像上,与检测到的角点比较。优秀标定的平均误差应小于 0.5 像素。
PnP(Perspective-n-Point)
Section titled “PnP(Perspective-n-Point)”PnP (Perspective-n-Point) 是 3D 视觉中最核心的位姿估计问题之一:已知一组 3D 点在世界坐标系中的坐标 ,以及它们在图像上的 2D 投影 ,求解相机的旋转矩阵 和平移向量 。
简单来说,PnP 回答的问题是:“我的相机(或物体)相对于已知标志物在哪里、朝哪个方向?”
| 算法 | 全称 | 特点 | 最少点数 |
|---|---|---|---|
| EPnP | Efficient PnP | 速度快,稳定性好,工业界最常用 | 4 |
| DLS | Direct Least-Squares | 对噪声鲁棒 | 4 |
| UPnP | Universal PnP | 可同时估计焦距 | 4 |
| P3P | Perspective-3-Point | 经典解析解,需第 4 点消歧 | 3+1 |
solvePnP 代码示例:机械臂抓取定位
Section titled “solvePnP 代码示例:机械臂抓取定位”import cv2import numpy as np
# === 场景:机械臂需要抓取一个已知尺寸的零件 ===# 已知零件上 4 个标记点的物理坐标(零件坐标系,单位:米)object_points = np.array([ [0.00, 0.00, 0.00], # 左上角标记 [0.10, 0.00, 0.00], # 右上角标记 [0.10, 0.08, 0.00], # 右下角标记 [0.00, 0.08, 0.00], # 左下角标记], dtype=np.float64)
# 在相机图像中检测到的对应像素坐标image_points = np.array([ [320, 240], [420, 245], [418, 340], [315, 335],], dtype=np.float64)
# 相机内参(来自标定)K = np.array([ [800.0, 0.0, 320.0], [ 0.0, 800.0, 240.0], [ 0.0, 0.0, 1.0],], dtype=np.float64)
# 畸变系数(来自标定,此处假设无畸变)dist_coeffs = np.zeros((5, 1), dtype=np.float64)
# === 使用 EPnP 求解相机位姿 ===success, rvec, tvec = cv2.solvePnP( object_points, image_points, K, dist_coeffs, flags=cv2.SOLVEPNP_EPNP)
if success: # 将旋转向量转换为旋转矩阵 R, _ = cv2.Rodrigues(rvec) print("零件相对于相机的位姿:") print(f" 平移 t = [{tvec[0,0]:.4f}, {tvec[1,0]:.4f}, {tvec[2,0]:.4f}] 米") print(f" 旋转矩阵 R:\n{R}")
# 将位姿转换为 4x4 齐次变换矩阵 T = np.eye(4) T[:3, :3] = R T[:3, 3] = tvec.ravel() print(f" 齐次变换矩阵 T:\n{T}")Homography(单应性矩阵)
Section titled “Homography(单应性矩阵)”单应性矩阵 (Homography Matrix) 描述的是两个平面之间的投影变换关系。给定一个平面上的点 和另一个平面上对应点 ,它们之间的关系为:
是一个 矩阵(8 个自由度),只需 4 对非共线的对应点即可求解。
import cv2import numpy as np
# === 应用:透视矫正(将倾斜拍摄的文档拉平)===src_pts = np.array([[120, 80], [520, 50], [580, 400], [100, 420]], dtype=np.float32)dst_pts = np.array([[0, 0], [600, 0], [600, 800], [0, 800]], dtype=np.float32)
# 4 点求 HomographyH, _ = cv2.findHomography(src_pts, dst_pts)
# 应用透视变换img = cv2.imread('slanted_document.jpg')corrected = cv2.warpPerspective(img, H, (600, 800))cv2.imwrite('corrected_document.jpg', corrected)
💡 常见应用:透视矫正 (Document Scanning)、图像拼接 (Image Stitching)、AR 标记定位 (ArUco / AprilTag)、车牌识别预处理。
RGB-D 相机
Section titled “RGB-D 相机”深度感知原理
Section titled “深度感知原理”RGB-D 相机(又称深度相机)能同时输出彩色图像 (RGB) 和深度图 (Depth Map)。深度图中每个像素的值代表该点到相机的物理距离(通常以毫米为单位)。目前主流的深度感知技术有三种:
| 技术 | 英文全称 | 代表产品 | 原理 | 有效范围 |
|---|---|---|---|---|
| 结构光 | Structured Light | Kinect v1, RealSense F200 | 投射已知红外图案,根据变形推算深度 | 0.5–5 m |
| 飞行时间 | Time of Flight (ToF) | Kinect v2, RealSense L515 | 测量光脉冲往返时间 | 0.5–10 m |
| 双目立体视觉 | Stereo Vision | RealSense D435, ZED | 两摄像头视差 (Disparity) 计算深度 | 1–20 m |
ToF 的深度计算公式:
其中 为光速, 为光脉冲往返时间。
点云 (Point Cloud) 生成
Section titled “点云 (Point Cloud) 生成”有了深度图后,可以将每个像素 反投影回 3D 空间,生成点云 (Point Cloud):
# === 从深度图 + 内参生成点云 ===def depth_to_pointcloud(depth_map, K):    """    将深度图转换为 3D 点云    depth_map: (H, W) 深度图,单位毫米    K: 3x3 内参矩阵    """    h, w = depth_map.shape    fx, fy = K[0, 0], K[1, 1]    cx, cy = K[0, 2], K[1, 2]
    # 生成像素坐标网格    u, v = np.meshgrid(np.arange(w), np.arange(h))
    # 反投影    z = depth_map.astype(np.float64) / 1000.0  # mm -> m    x = (u - cx) * z / fx    y = (v - cy) * z / fy
    # 过滤无效深度(depth=0 通常是无效值)    valid = z > 0    points = np.stack([x[valid], y[valid], z[valid]], axis=-1)    return points
# point_cloud = depth_to_pointcloud(depth, K)# print(f"生成 {len(point_cloud)} 个有效 3D 点")
Intel RealSense SDK (pyrealsense2) 示例
Section titled “Intel RealSense SDK (pyrealsense2) 示例”import pyrealsense2 as rsimport numpy as npimport cv2
# === 配置 RealSense 管道 ===pipeline = rs.pipeline()config = rs.config()config.enable_stream(rs.stream.depth, 640, 480, rs.format.z16, 30) # 深度流config.enable_stream(rs.stream.color, 640, 480, rs.format.bgr8, 30) # 彩色流
pipeline.start(config)
try: while True: frames = pipeline.wait_for_frames() depth_frame = frames.get_depth_frame() color_frame = frames.get_color_frame()
if not depth_frame or not color_frame: continue
# 转换为 numpy 数组 depth_image = np.asanyarray(depth_frame.get_data()) color_image = np.asanyarray(color_frame.get_data())
# 深度图可视化(伪彩色) depth_colormap = cv2.applyColorMap( cv2.convertScaleAbs(depth_image, alpha=0.03), cv2.COLORMAP_JET )
# 读取中心点深度 center_dist = depth_frame.get_distance(320, 240) print(f"中心点距离: {center_dist:.3f} m")
cv2.imshow('RGB', color_image) cv2.imshow('Depth', depth_colormap) if cv2.waitKey(1) & 0xFF == ord('q'): breakfinally: pipeline.stop() cv2.destroyAllWindows()ROS / ROS2 通信框架
Section titled “ROS / ROS2 通信框架”ROS (Robot Operating System) 是目前机器人领域最广泛使用的中间件框架。它本身不是操作系统,而是运行在 Linux 之上的一组通信协议和工具集,提供了进程间通信、硬件抽象、包管理、可视化等功能。
核心通信模型
Section titled “核心通信模型”ROS 有四种核心通信机制:
| 机制 | 模式 | 特点 | 典型用途 |
|---|---|---|---|
| Topic (话题) | 发布/订阅 (Pub/Sub) | 异步、连续、多对多 | 传感器数据流、控制指令 |
| Service (服务) | 请求/响应 (Req/Res) | 同步、一次性 | 查询状态、触发快照 |
| Action (动作) | 目标/反馈/结果 | 异步、长时、可取消 | 自主导航、机械臂运动规划 |
| Parameter (参数) | 全局变量 | 启动时加载、运行时可改 | 配置参数、PID 增益 |
TF 坐标变换树 (Transform Tree)
Section titled “TF 坐标变换树 (Transform Tree)”TF (Transform Library) 是 ROS 中管理多坐标系间变换关系的核心组件。它维护一棵坐标变换树 (Transform Tree),自动处理坐标系之间的链式变换:
每个箭头代表一个刚体变换 ,TF 树实时广播各坐标系之间的关系,任何节点都可以查询”坐标系 A 下的点在坐标系 B 中的坐标是什么”。
ROS2 vs ROS1 关键区别
Section titled “ROS2 vs ROS1 关键区别”| 特性 | ROS1 | ROS2 |
|---|---|---|
| 中间件 | 自研 TCPROS | DDS (Data Distribution Service) |
| 实时性 | 不支持硬实时 | 支持 QoS (Quality of Service) 配置 |
| Master 节点 | 需要 roscore 中心节点 | 去中心化,无 Master |
| 安全性 | 无认证机制 | 支持 DDS-Security |
| 多机器人 | 困难 | 原生支持 |
| 操作系统 | 主要 Linux | Linux / Windows / RTOS |
| 生命周期管理 | 无 | 有节点生命周期 (Node Lifecycle) |
💡 DDS (Data Distribution Service) 是 OMG 标准的分布式发布/订阅中间件,ROS2 基于它实现了去中心化通信,支持 QoS 策略(可靠性、持久性、 deadline),更适合工业级实时机器人系统。
齐次变换矩阵
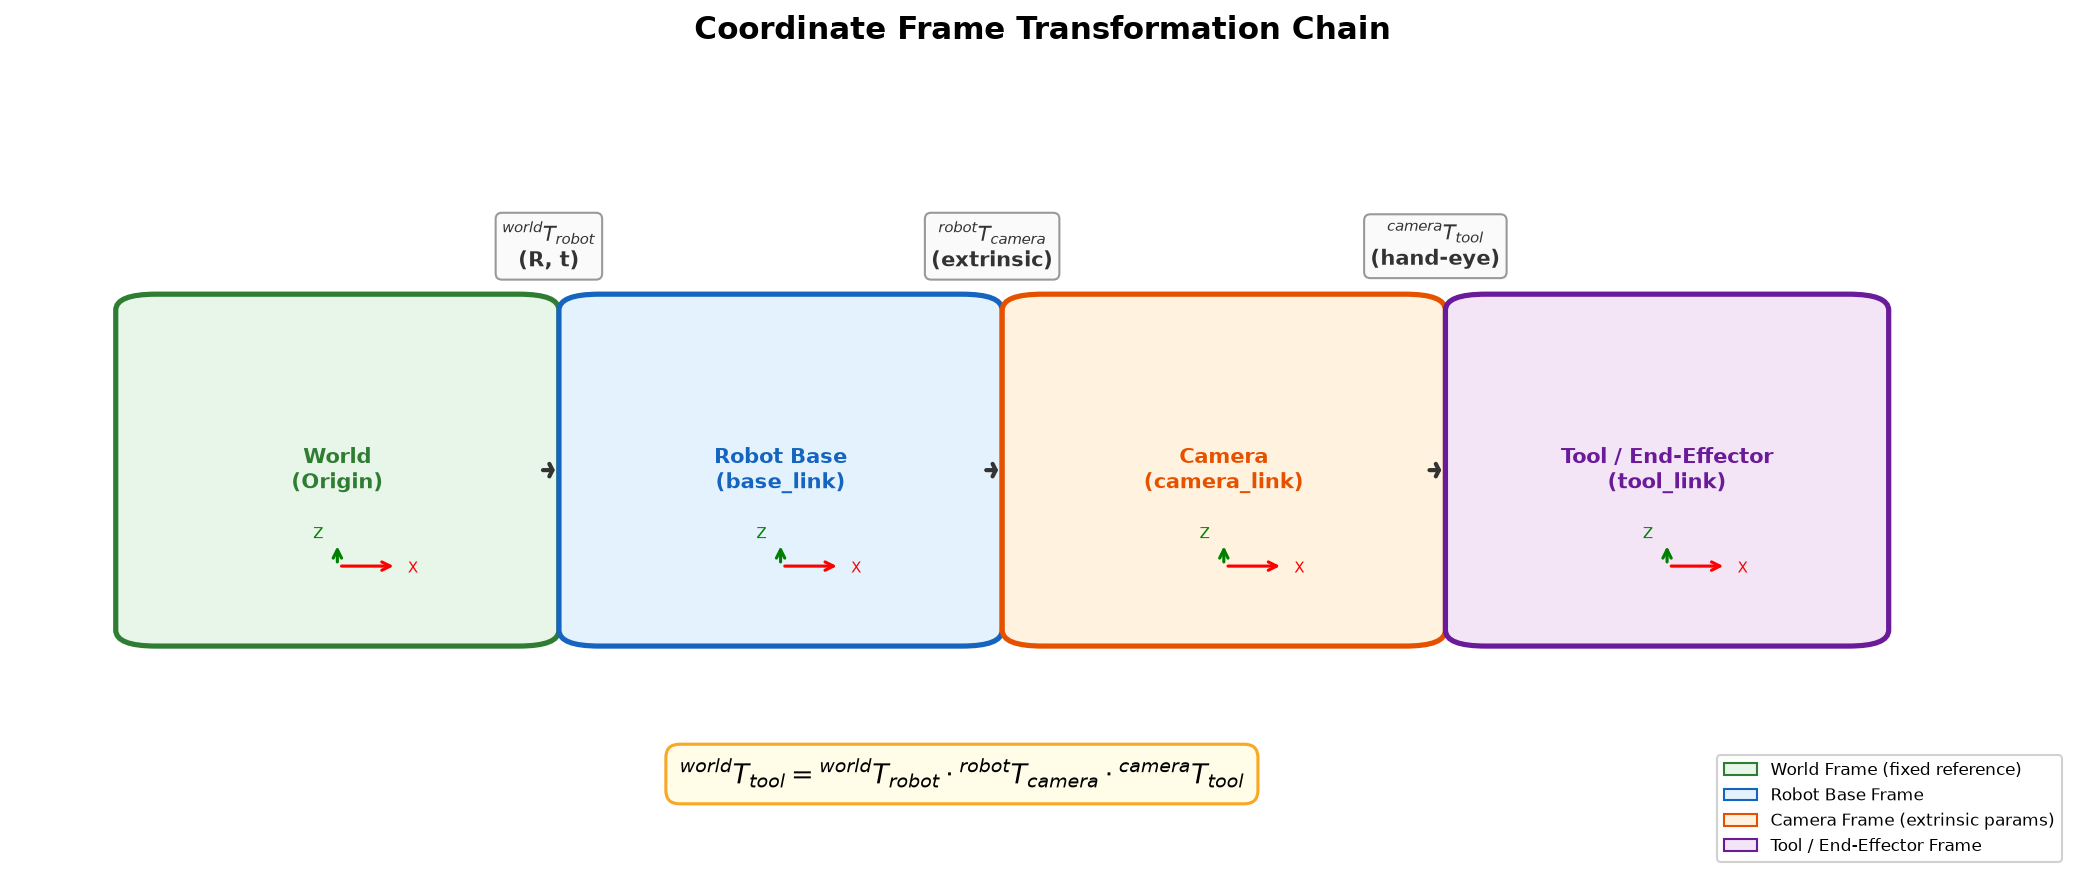
Section titled “齐次变换矩阵”在机器人系统中,同一个点在不同坐标系下有不同的坐标。使用齐次变换矩阵 (Homogeneous Transformation Matrix) 可以将旋转和平移统一为一个 矩阵:
将一个点 从坐标系 B 变换到坐标系 A:
当坐标变换经过多个中间坐标系时,变换矩阵可以链式相乘:
import numpy as np
def make_transform(R, t):    """构建 4x4 齐次变换矩阵"""    T = np.eye(4)    T[:3, :3] = R    T[:3, 3] = t    return T
def rot_z(angle_deg):    """绕 Z 轴旋转的 3x3 旋转矩阵"""    theta = np.radians(angle_deg)    return np.array([        [np.cos(theta), -np.sin(theta), 0],        [np.sin(theta),  np.cos(theta), 0],        [0,              0,             1],    ])
# 示例:计算末端工具在世界坐标系中的位姿
# 1. 机器人基座在世界的位姿T_world_robot = make_transform(rot_z(45), [2.0, 1.0, 0.0])
# 2. 相机在机器人上的安装位姿(手眼标定结果)T_robot_camera = make_transform(rot_z(-90), [0.3, 0.0, 0.5])
# 3. 工具(夹爪)在相机视野中的位姿(PnP 求解)T_camera_tool = make_transform(np.eye(3), [0.5, -0.1, 0.8])
# 链式相乘:得到工具在世界坐标系的最终位姿T_world_tool = T_world_robot @ T_robot_camera @ T_camera_toolprint(f"末端工具在世界坐标系中的位置: {T_world_tool[:3, 3]}")print(f"末端工具的旋转矩阵:\n{T_world_tool[:3, :3]}")
⚠️ 注意矩阵乘法顺序:变换矩阵的乘法是不可交换的。。链式乘法中,右边的变换先执行。务必按从左到右”父→子”的顺序相乘。
Sensor Fusion(传感器融合)
Section titled “Sensor Fusion(传感器融合)”卡尔曼滤波 (Kalman Filter)
Section titled “卡尔曼滤波 (Kalman Filter)”卡尔曼滤波 (Kalman Filter, KF) 是最经典的传感器融合算法,用于从含有噪声的多源观测中最优估计系统状态。它有两个核心步骤:
Step 1 — 预测 (Predict):根据系统运动模型预测下一时刻的状态和不确定度:
其中 是状态转移矩阵, 是估计不确定度的协方差, 是过程噪声协方差。
Step 2 — 更新 (Update):用新观测数据修正预测值:
其中 是卡尔曼增益 (Kalman Gain),决定了观测与预测之间的信任权重。
import numpy as np
class KalmanFilter1D:    """一维卡尔曼滤波器:融合位置估计"""    def __init__(self, process_var, measure_var, est_init):        self.Q = process_var    # 过程噪声方差(运动模型不确定性)        self.R = measure_var    # 测量噪声方差(传感器精度)        self.x = est_init       # 状态估计        self.P = 1.0            # 估计不确定度
    def update(self, measurement):        """预测 + 更新"""        # Predict        self.P = self.P + self.Q
        # Update        K = self.P / (self.P + self.R)   # 卡尔曼增益        self.x = self.x + K * (measurement - self.x)        self.P = (1 - K) * self.P        return self.x
# 示例:融合相机(高噪声)和激光雷达(低噪声)的距离测量kf = KalmanFilter1D(process_var=0.01, measure_var=0.1, est_init=0.0)
# 模拟 10 个时刻的传感器读数camera_readings = [1.05, 0.98, 1.02, 0.99, 1.03, 1.01, 0.97, 1.04, 1.00, 1.02]lidar_readings  = [1.001, 1.002, 0.999, 1.000, 1.001, 1.002, 0.998, 1.001, 1.000, 1.001]
for cam, lidar in zip(camera_readings, lidar_readings):    fused = kf.update(lidar)  # 用高精度传感器更新    print(f"相机: {cam:.3f}, 激光雷达: {lidar:.3f}, 融合估计: {fused:.4f}")
扩展卡尔曼滤波 (EKF)
Section titled “扩展卡尔曼滤波 (EKF)”标准卡尔曼滤波假设系统是线性的。但实际机器人运动(如转弯、旋转)往往是非线性的。扩展卡尔曼滤波 (Extended Kalman Filter, EKF) 通过对非线性模型做一阶泰勒展开(雅可比矩阵线性化),将问题转化为近似的线性问题:
EKF 广泛应用于 SLAM (Simultaneous Localization and Mapping)、GPS/IMU 融合导航等场景。
💡 多传感器融合策略:相机提供丰富的纹理和语义信息但深度精度差;激光雷达 (LiDAR) 提供精确的 3D 点云但缺乏颜色;IMU 提供高频运动估计但存在累积漂移。三者互补——相机+LiDAR 用于建图定位,IMU 填充高频运动间隙。
2025–2026 最新进展
Section titled “2025–2026 最新进展”神经辐射场与 3D 高斯溅射 (NeRF & 3DGS)
Section titled “神经辐射场与 3D 高斯溅射 (NeRF & 3DGS)”NeRF (Neural Radiance Field) 和 3D Gaussian Splatting (3DGS) 将 3D 重建从传统几何方法推进到了神经表征时代。2024–2025 年间,3DGS 因其实时渲染能力(100+ FPS)成为机器人仿真环境构建的热门方案,被广泛用于训练数据生成和 Sim-to-Real 迁移。
基础模型驱动的 3D 感知
Section titled “基础模型驱动的 3D 感知”SAM (Segment Anything Model) 的 3D 扩展版本(如 SAM3D、OpenScene)实现了零样本 3D 场景理解——无需针对新场景重新训练即可分割和识别 3D 点云中的物体。这大幅降低了工业部署的定制化成本。
端到端视觉运动策略
Section titled “端到端视觉运动策略”受 Vision-Language-Action (VLA) 模型(如 Google RT-2、Octo、OpenVLA)驱动,2025 年出现了从RGB 图像直接到机器人动作的端到端策略,绕过了传统”感知→规划→控制”的分步管线。但这些方法在精确位姿控制方面仍不及经典几何方法。
ROS2 的工业普及
Section titled “ROS2 的工业普及”ROS2 在 2025 年已成为新工业机器人项目的默认选择。DDS 中间件的 QoS 保障使其满足工业实时性要求,Apollo、Autoliv 等公司已在量产系统中采用。ROS2 Jazzy Jalisco(2024 LTS)和 2025 年的 Rolling 版本进一步强化了对实时以太网 (EtherCAT) 的支持。
- 标定是第一性原理:所有 3D 视觉算法的精度上限取决于标定质量。工业场景建议每 3-6 个月重新标定一次,更换镜头或相机后必须立即重标。
- 手眼标定 (Hand-Eye Calibration):当相机安装在机械臂上(眼在手上, Eye-in-Hand)时,需要额外标定相机与机械臂末端的固定变换关系。OpenCV 的
cv2.calibrateHandEye()提供了完整接口。- 深度图的有效范围:结构光相机的有效深度通常在 0.5–5 m,超出范围深度值为 0 或噪声极大。点云生成时务必过滤无效点。
- TF 树的频率:TF 广播频率建议不低于 30 Hz,否则下游节点可能查询到过时的变换。使用
tf2_ros.TransformListener而非手动管理变换缓存。- 单位统一:工业代码中最常见的 bug 是单位混淆——深度图以毫米为单位,但很多算法要求米。务必在数据进入算法前统一转换单位。
| 术语 | 英文 | 释义 |
|---|---|---|
| 针孔模型 | Pinhole Model | 将相机简化为理想针孔的成像模型 |
| 内参矩阵 | Intrinsic Matrix (K) | 描述相机内部光学特性的 3×3 矩阵(焦距、主点) |
| 外参 | Extrinsic Parameters | 相机在世界坐标系中的旋转 R 和平移 t |
| 焦距 | Focal Length () | 以像素为单位的相机光学焦距 |
| 主点 | Principal Point () | 光轴与像平面的交点 |
| 径向畸变 | Radial Distortion () | 镜头弯曲导致的直线变弯 |
| 切向畸变 | Tangential Distortion () | 镜头与传感器不平行导致的偏移 |
| 张正友标定法 | Zhang’s Method | 使用棋盘格的平面标定方法 |
| PnP | Perspective-n-Point | 已知 3D 点与 2D 投影求位姿 |
| 单应性矩阵 | Homography Matrix (H) | 平面到平面的 3×3 投影变换矩阵 |
| 深度图 | Depth Map | 每个像素存储深度值的图像 |
| 点云 | Point Cloud | 3D 点的集合,通常为 (x,y,z) + 可选颜色 |
| 结构光 | Structured Light | 投射已知图案,根据变形推算深度 |
| 飞行时间 | Time of Flight (ToF) | 测量光脉冲往返时间计算距离 |
| 视差 | Disparity | 立体视觉中同一点在左右图的像素差 |
| 齐次变换矩阵 | Homogeneous Transform Matrix (T) | 统一表示旋转和平移的 4×4 矩阵 |
| 卡尔曼滤波 | Kalman Filter (KF) | 线性高斯系统的最优状态估计器 |
| 扩展卡尔曼滤波 | Extended Kalman Filter (EKF) | 通过雅可比线性化处理非线性系统的 KF |
| 卡尔曼增益 | Kalman Gain (K) | 观测与预测之间的信任权重 |
| TF 变换树 | Transform Tree | ROS 中管理多坐标系间变换关系的数据结构 |
| DDS | Data Distribution Service | ROS2 使用的分布式发布/订阅中间件标准 |
| 手眼标定 | Hand-Eye Calibration | 标定相机与机械臂末端坐标系关系 |
| SLAM | Simultaneous Localization and Mapping | 同步定位与建图 |
| NeRF | Neural Radiance Field | 用神经网络表征 3D 场景的辐射场方法 |
| 3DGS | 3D Gaussian Splatting | 用 3D 高斯椭球体表征场景的可实时渲染方法 |
-
相机标定与几何
- 深度估计(深度学习方法) — 单目深度预测的神经网络方法
- OpenCV 官方文档:Camera Calibration
- Zhang, Z. (2000). A Flexible New Technique for Camera Calibration. IEEE TPAMI.
-
RGB-D 与 3D 传感
- Intel RealSense SDK 文档:https://dev.intelrealsense.com/docs
- Khoshelham & Elberink (2012). Accuracy and Resolution of Kinect Depth Data.
-
ROS / ROS2
-
传感器融合与状态估计
- Thrun, Burgard, Fox. Probabilistic Robotics. (经典教材,涵盖 KF/EKF/粒子滤波)
- Python 工程进阶 — 本站的 Python 科学计算工具链实践
- 工业 AI 系统 — 上述技术如何集成为完整工业系统
-
前沿方向
- Mildenhall et al. (2020). NeRF: Representing Scenes as Neural Radiance Fields.
- Kerbl et al. (2023). 3D Gaussian Splatting for Real-Time Radiance Field Rendering.
- 生成式 AI 与多模态 — 视觉-语言模型在 3D 场景理解中的应用