
嵌入模型
嵌入模型(Embedding Model)把文字、图像等现实世界的信息转换为数学向量,让计算机能够计算”语义相似度”。它是 RAG 检索增强生成和向量数据库的基础引擎——没有嵌入,就没有语义搜索。本页梳理从词嵌入到句子嵌入、再到多模态嵌入的完整技术谱系,涵盖 2025 年最新的 BGE-M3、Matryoshka 表示学习、ColBERT 延迟交互模型等前沿进展。
嵌入 = 给每个概念一个”语义坐标”。
想象一个”意义空间”:king 在坐标 (1, 0.8, …),queen 在 (1, 0.8, …) 附近,而 apple 在完全不同的方向。意思越接近,坐标越接近;意思无关,坐标相隔很远。
- One-Hot 编码(稀疏表示):词汇表有 5 万个词,每个词用 5 万维向量表示,只有一维是 1 其余全是 0。“猫”和”狗”的 one-hot 向量正交(相似度为 0)——完全看不出它们有任何关系。这就像用一万个开关表示一万个物品,每个物品独占一个开关。
- 词嵌入(稠密表示):把每个词压缩成几百维的稠密向量,每一维代表某种隐含的语义维度。“猫”和”狗”的向量非常接近,因为它们都是宠物、都有毛、都能跑——含义被”分布式”地编码在所有维度上。这就像 GPS 坐标——经纬度只有两个数,但精确定位了现实位置。
- 句子嵌入:从”词的坐标”升级到”整句话的坐标”。“我喜欢猫”和”我爱小猫”的句子向量非常接近,虽然用词不同,但意思一样。
嵌入的核心哲学:分布式表示(Distributed Representation)。不再用一维对应一个概念,而是用所有维度共同表示含义——维度之间协同编码,信息密度远高于 one-hot。
词嵌入的理论根源:分布式假设
Section titled “词嵌入的理论根源:分布式假设”词嵌入并非凭空出现,它的理论基础可以追溯到 20 世纪 50 年代语言学中的分布式假设(Distributional Hypothesis):
“You shall know a word by the company it keeps.” —— J.R. Firth, 1957
分布式假设的核心命题是:频繁出现在相似上下文中的词,具有相似的含义。这一思想由 Zellig Harris(1954)和 J.R. Firth(1957)独立提出,成为统计语义学的基石。例如”猫”和”狗”都会出现在”我养了一只___""___在叫”这样的上下文中,因此它们语义相关。
在 word2vec 之前,NLP 社区已经基于这一假说发展出多种方法:TF-IDF(词频-逆文档频率,衡量词的重要性)、LSA(潜在语义分析,对词-文档矩阵做 SVD 分解)、PLSA/LDA(概率主题模型)。这些方法都是”计数型”——统计共现次数再做矩阵分解。word2vec 的革命性在于将问题转化为”预测型”——用神经网络学习上下文预测能力,权重矩阵即为词向量。
word2vec:Skip-gram 目标函数详解
Section titled “word2vec:Skip-gram 目标函数详解”word2vec(Google, Mikolov et al. 2013)的两种训练方式:
- CBOW(连续词袋 Continuous Bag-of-Words):用上下文词预测中心词。输入”the cat ___ on the mat”,预测空格处是”sits”。
- Skip-gram:用中心词预测上下文词。输入”cat”,预测它周围可能出现”sits""on""mat”等词。Skip-gram 在罕见词上表现更好,是实践中的首选。
Skip-gram 的目标函数可以这样理解:给定中心词 和它窗口内的上下文词 ,我们希望最大化对数似然:
对所有 和窗口内的 ()。
其中 是语料长度, 是上下文窗口大小。核心是条件概率 ,用词向量的点积经 softmax 计算:
对词汇表中所有 求和。
这里 是中心词(输入)的嵌入向量, 是上下文词(输出)的嵌入向量, 是词汇表大小。注意每个词有两套向量——输入向量(输入层权重)和输出向量(输出层权重),最终通常只保留输入向量作为词嵌入。
问题在于:分母要对整个词汇表(通常 5 万~30 万词)求和,每个训练样本都要遍历所有词——计算量极其庞大。这就是 word2vec 必须做优化的根本原因。
负采样:让训练变得可行
Section titled “负采样:让训练变得可行”负采样(Negative Sampling) 是解决上述计算瓶颈的关键技巧。它不遍历整个词汇表计算 softmax,而是把多分类问题转化为二分类:给定中心词,判断一个候选词是”真正的上下文词”(正样本)还是”随机采样的噪声词”(负样本)。
第一项为正样本项,第二项是对 个负样本 求和的负样本项。
其中 σ 是 sigmoid 函数,k 是负样本数(通常 5~20),P_n(w) ∝ freq(w)^0.75 是一种对高频词做轻微惩罚的噪声分布。直觉上:模型要给真正的上下文词打高分(sigmoid 输出接近 1),给随机噪声词打低分(sigmoid 输出接近 0)。
负采样把每步从 O(W)(遍历词汇表)降到 O(k)(只看 k 个负样本),k 通常取 5~15,速度提升数千倍。另一种替代方案层次 Softmax(Hierarchical Softmax) 用霍夫曼树把计算量降到 O(log W),但在实践中负采样更常用、效果更好。
向量算术:king − man + woman ≈ queen
Section titled “向量算术:king − man + woman ≈ queen”word2vec 训练出的向量最令人惊叹的性质是线性类比(Linear Analogy):
几何解释:在嵌入空间中,语义关系对应着大致平行的向量。“国王→女王”的位移方向(即 vec("女王") - vec("国王"))编码了”性别转换”这个语义维度,与”男人→女人”的位移方向高度一致。因此从”国王”出发,减去”男人”(去掉男性属性),加上”女人”(加上女性属性),就落在了”女王”附近。
更深层的原因在于:word2vec 的训练目标使得共现上下文相似的词向量相近,而上下文模式中的线性组合关系(如”国王”与”女王”在王室相关上下文中的分布差异,恰好对应”男人”与”女人”在性别相关上下文中的分布差异)被编码为近似线性的向量位移。
GloVe(Stanford, Pennington et al. 2014)则从另一个角度出发:利用全局的词共现矩阵(哪些词经常一起出现),通过矩阵分解学习嵌入。word2vec 是局部上下文窗口(滑窗预测),GloVe 是全局统计(共现矩阵分解)——两者效果接近,但 GloVe 的数学推导更优雅,显式优化共现比例的对数。
句子嵌入:从词向量到句向量
Section titled “句子嵌入:从词向量到句向量”词嵌入只表示单个词,但实际应用需要表示整句话。最朴素的办法是把句中所有词的向量取平均——但这样丢失了词序和语法结构(“狗咬人”和”人咬狗”的平均向量完全一样)。早期方法如 SIF(Smooth Inverse Frequency) 通过加权平均 + 去除主成分来改善,但仍无法捕捉深层语义。
Sentence-BERT:孪生网络架构
Section titled “Sentence-BERT:孪生网络架构”Sentence-BERT(Reimers & Gurevych, EMNLP 2019)的突破在于:用预训练的 BERT 编码句子,通过**孪生网络(Siamese Network)**结构 + **池化(Pooling)**得到固定长度的句子向量,再用对比学习微调。
孪生网络的核心:两个共享权重的 BERT 编码器分别处理句子 A 和句子 B,输出各自的向量。因为是同一个编码器(权重共享),语义相似的句子会得到相近的向量。关键创新是让 BERT 的输出可直接用余弦相似度比较——原始 BERT 直接拼接两个句子做分类,无法高效计算相似度,不适合语义搜索场景。
池化策略比较
Section titled “池化策略比较”BERT 对每个 token 输出一个向量(如 512 个 token → 512 个 768 维向量),需要”压缩”成单个句子向量。三种主流池化策略:
| 池化策略 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| [CLS] pooling | 取特殊 [CLS] token 的输出向量 | BERT 预训练时 [CLS] 已聚合全局信息 | 效果常不如 Mean pooling |
| Mean pooling | 对所有 token 向量取平均 | 最稳定、最常用,效果通常最好 | 对噪声 token 敏感 |
| Max pooling | 对每个维度取所有 token 的最大值 | 捕捉最显著的特征 | 可能丢失细粒度信息 |
实践中 Mean pooling 是最稳妥的默认选择,绝大多数现代模型(BGE、E5、GTE)都采用 Mean pooling。
对比学习:InfoNCE 损失
Section titled “对比学习:InfoNCE 损失”现代嵌入模型几乎都用**对比学习(Contrastive Learning)**训练。核心思想:
- 取一个锚点句子(anchor),如”一只猫坐在垫子上”。
- 构造正样本(positive):语义相同的改写,如”小猫趴在地毯上”。
- 构造负样本(negative):语义无关的句子,如”今天股市大涨”。
- 训练目标:拉近 anchor 和 positive 的向量,推远 anchor 和 negative 的向量。
最核心的损失函数是 InfoNCE(Info Noise-Contrastive Estimation),也叫 NT-Xent(Normalized Temperature-scaled Cross Entropy):
其中 z_i 是锚点向量,z_j+ 是正样本向量,z_k− 是负样本向量,sim 是相似度函数(通常用余弦相似度),τ 是温度系数(Temperature)(控制分布的尖锐程度,通常取 0.01~0.05),N 是负样本数量。
直觉上:InfoNCE 是一个 N+1 类的分类问题——模型要从 1 个正样本和 N 个负样本中”识别”出正确的正样本。N 越大(负样本越多),任务越难,学到的嵌入判别力越强——这也是为什么大厂训练嵌入模型要用超大 batch size(数千甚至数万)来增加负样本数量。
困难负样本挖掘
Section titled “困难负样本挖掘”随机采样的负样本往往”太简单”(与锚点语义差异太大),模型学不到细粒度的区分。困难负样本挖掘(Hard Negative Mining) 专门找”看起来很像但实际不匹配”的样本:
- BM25 困难负样本:用 BM25 关键词检索召回的文档——它们在词汇上相似但语义上不一定匹配,是极好的困难负样本。
- 语义困难负样本:用当前模型的嵌入向量找最相似但不匹配的文档。
- 混合策略:研究表明正负样本比例 1:4
1:7(1 个正样本配 47 个困难负样本)效果最佳。
困难负样本挖掘是 BGE、E5 等 SOTA 模型的关键训练技巧,能显著提升检索精度。
指令微调嵌入(Instruction-Tuned Embedding)
Section titled “指令微调嵌入(Instruction-Tuned Embedding)”最新的嵌入模型(如 E5-instruct、BGE-instruct)引入了**指令(Instruction)**概念:嵌入时给模型一个任务指令,如”检索与查询相关的段落”或”找出语义相似的句子”。同一个句子在不同指令下生成不同向量——适配不同任务(检索 vs 分类 vs 聚类)。例如 BGE 要求查询加特定前缀”为这个句子生成表示用于检索相关文章:“,效果提升明显,别漏了。
2025 年嵌入模型全景
Section titled “2025 年嵌入模型全景”MTEB 排行榜与评估
Section titled “MTEB 排行榜与评估”MTEB(Massive Text Embedding Benchmark) 是目前最权威的嵌入模型综合评估基准,涵盖 8 大类任务:
| 任务类别 | 评估内容 | 典型数据集 |
|---|---|---|
| 检索(Retrieval) | 给定查询,从大量文档中召回最相关的 | MS MARCO, BEIR, MIRACL |
| 重排(Reranking) | 对候选文档对重新排序 | AskUbuntu, StackOverflow |
| 分类(Classification) | 用嵌入做文本分类 | SST2, AmazonReviews |
| 聚类(Clustering) | 用嵌入做文本聚类 | Wiki, Reddit |
| 句子相似度(STS) | 判断两句话的语义相似程度 | STS12-STS22, BIOSSES |
| 配对分类(Pair Classification) | 判断两句话是否是复述 | Sprint, Twitter |
| 摘要(Summarization) | 评估摘要与原文的一致性 | SummEval |
MTEB 排行榜是嵌入模型选型的权威参考——但要注意,排行榜分数不等于实际 RAG 效果。实际场景中的查询分布、文档领域、语言比例都与 MTEB 测试集不同,选型时务必在自己的数据集上做 A/B 测试。详见 MTEB 排行榜。
主流模型对比
Section titled “主流模型对比”| 模型 | 来源 | 维度 | 最大 token | 特点 |
|---|---|---|---|---|
| BGE-M3 | 智源 BAAI | 1024 | 8192 | 多功能(稠密+稀疏+多向量)、多语言、长文本 |
| BGE-large/en/zh | 智源 BAAI | 1024 | 512 | 中文效果顶尖,开源可商用 |
| GTE-Qwen2 | 阿里巴巴 | 可变 | 32768 | 基于 LLM 的嵌入,超长上下文 |
| E5-mistral | 微软 | 4096 | 4096 | 基于 Mistral-7B,指令微调,MTEB 顶级 |
| NV-Embed-v2 | NVIDIA | 4096 | 32768 | MTEB 排行榜顶级,潜在注意力机制 |
| Voyage-3 / Voyage-3-large | Voyage AI | 1024 | 32000 | 专注 RAG 场景优化,商用 API |
| OpenAI text-embedding-3-large | OpenAI | 3072 | 8192 | 闭源 API,支持维度截断 |
| OpenAI text-embedding-3-small | OpenAI | 1536 | 8192 | 商用 API 入门,性价比高 |
| Cohere Embed v4 | Cohere | 1536 | 8192 | 多语言、多模态支持 |
| Jina-embeddings-v3 | Jina AI | 1024 | 8192 | 长文本检索,任务感知(LoRA) |
| stella | Stephan Tual | 可变 | 8192 | 开源英文 SOTA,社区训练 |
选型经验法则:中文优先 BGE-M3 / GTE-Qwen2;英文开源优先 E5-mistral / NV-Embed / stella;商用 API 优先 Voyage-3 或 OpenAI text-embedding-3。务必在自己的业务数据上验证,不要迷信排行榜。
BGE-M3:一个模型三种检索
Section titled “BGE-M3:一个模型三种检索”BGE-M3(BAAI, 2024)是 2024-2025 年最重要的开源嵌入模型之一。名称中三个 M 代表 Multi-functionality(多功能)、Multi-linguality(多语言)、Multi-granularity(多粒度)。核心创新是一个模型同时输出三种表示:
三种表示各有优势,可以单独使用,也可以加权融合:
- 稠密向量(Dense):1024 维,捕捉整体语义相似度,适合语义搜索。
- 稀疏向量(Sparse):每个词输出一个权重,类似神经网络版的 BM25(关键词匹配),擅长精确匹配专有名词、代码、产品型号。
- 多向量(Multi-Vector):保留 token 级别嵌入,做 ColBERT 式的延迟交互,精度最高。
BGE-M3 支持超过 100 种语言、最大 8192 token 输入(远超传统嵌入的 512),在 MTEB 多语言排行榜上长期名列前茅。它的”一模型三路输出”设计让你不必在稠密检索和稀疏检索之间二选一,而可以用一个模型同时获得语义搜索和关键词匹配的能力。
Matryoshka 表示学习
Section titled “Matryoshka 表示学习”Matryoshka Representation Learning(MRL,套娃表示学习) 由 OpenAI 在 2022 年提出,其核心思想极其优雅:训练嵌入模型时,让它同时在多个维度截断下都保持高质量。
原理:嵌套式表示
Section titled “原理:嵌套式表示”名字来自俄罗斯套娃(Matryoshka doll)——大的套娃里套着小的。MRL 训练的向量也是如此:前 8 维已经包含了粗粒度语义信息,前 32 维更精细,前 256 维更精细……直到完整的 768 维或 3072 维。
具体做法是在训练时同时优化多个截断维度:
其中 {8, 16, 32, ...} 是一组截断维度,z_{1:m} 表示只取前 m 维,w_m 是每个维度的权重。模型同时学习”用 8 维也能做检索”和”用 768 维做精确检索”,因此前 m 维不是随机子空间,而是按信息重要性排序的。
实践:截断维度与质量权衡
Section titled “实践:截断维度与质量权衡”训练完成后,你可以直接截断向量维度(只取前 N 维),无需重新训练:
| 截断维度 | 相对于完整维度的性能 | 存储节省 | 适用场景 |
|---|---|---|---|
| 768(完整) | 100% | 基准 | 精确检索、最终重排 |
| 256 | ~98% | 3 倍 | 大规模向量库主检索 |
| 128 | ~96% | 6 倍 | 初筛过滤、粗召回 |
| 64 | ~92% | 12 倍 | 极大规模、边缘部署 |
| 32 | ~85% | 24 倍 | 原型验证、极低延迟 |
(上表为示意比例,实际损失因模型和任务而异。)
两阶段检索策略:用截断向量(如 256 维)做快速粗召回,得到 Top-100 候选;再用完整维度(768 维)做精排,选出 Top-10。这样既兼顾了速度又保留了精度。OpenAI text-embedding-3-large 原生支持 MRL——你可以直接指定 dimensions 参数(如 256、512、1536、3072),API 返回截断后的向量。
注意:截断后向量需要重新做 L2 归一化(因为截断改变了向量长度),否则余弦相似度计算会出错。
延迟交互模型:ColBERT
Section titled “延迟交互模型:ColBERT”传统的双编码器(Bi-Encoder)将每个文本压缩成一个向量,速度快但可能丢失细节。ColBERT(Contextualized Late Interaction over BERT) 提出了另一种范式:保留 token 级别的嵌入,在查询时再做细粒度匹配。
Token 级嵌入与 MaxSim
Section titled “Token 级嵌入与 MaxSim”ColBERT 对查询(query)和文档(document)分别生成 token 级的嵌入矩阵(而非单个向量)。查询有 L_q 个 token 向量,文档有 L_d 个 token 向量。相关性分数用 MaxSim 操作计算:
对查询中每个 token ,取文档中最相似的 token 。
直觉上:对查询中的每个 token(如”猫”),在文档中找到最相似的 token(如”小猫""宠物""动物”),取最大相似度;然后把所有查询 token 的最大相似度加起来。这比”一句话压成一个向量再比较”粒度细得多——能够捕捉到”文档里提到了查询中的每个关键概念”这种细粒度匹配。
ColBERT v2 与实践选择
Section titled “ColBERT v2 与实践选择”ColBERT v2(Khattab & Zaharia, 2022)在 v1 基础上做了关键优化:
- 残差压缩(Residual Compression):将 token 嵌入量化为更紧凑的位表示,存储空间减少 10 倍以上。
- 位图索引(Bitmap Indexing):加速 MaxSim 的在线计算,使 ColBERT 在大规模检索中变得可行。
- PLAID 引擎:后续优化的检索引擎,进一步将查询延迟降到数十毫秒级。
何时用 ColBERT vs Bi-Encoder:
| 特性 | Bi-Encoder(双编码器) | ColBERT(延迟交互) |
|---|---|---|
| 表示形式 | 每文本 1 个向量 | 每文本 N 个 token 向量 |
| 存储成本 | 低 | 高(约 50~100 倍) |
| 查询速度 | 极快 | 较慢 |
| 精度 | 好 | 更好(细粒度匹配) |
| 适用场景 | 大规模召回(百万级文档) | 小规模精排、高精度场景 |
实践中常见 Bi-Encoder 召回 + ColBERT 精排的级联架构,详见重排序和检索方法。
CLIP:图文共享向量空间
Section titled “CLIP:图文共享向量空间”CLIP(Contrastive Language-Image Pre-training,OpenAI 2021) 把文本和图像映射到同一个向量空间,是多模态嵌入的奠基之作。架构包含两个编码器:
- 图像编码器:Vision Transformer(ViT),将图片切分为 16×16 的 patch 序列,用 Transformer 编码成一个向量。
- 文本编码器:标准 Transformer,将描述文字编码成一个向量。
- 对比学习训练:一个 batch 包含 N 张图和 N 条文本(图-文一一对应),目标是让正确配对的图-文向量靠近、错误配对的远离——本质就是图像版的 InfoNCE。
CLIP 用 4 亿对图文对训练,训练后可以直接用文本搜图、用图搜文、甚至做零样本图像分类(把分类任务转化为”哪段文本描述与图片最相似”)。
SigLIP:改进的对比学习
Section titled “SigLIP:改进的对比学习”SigLIP(Google, 2023)对 CLIP 的对比学习做了关键改进:将 softmax 损失换成独立的 sigmoid 损失。CLIP 的 softmax 要求 batch 内所有样本做归一化计算,batch 越大计算越复杂;而 sigmoid 对每个图-文对独立判断”匹配/不匹配”,不依赖 batch 内其他样本。这一改进使得:
- 更大的 batch size 可行(不需要全局归一化)。
- 训练更稳定,尤其在小数据集上。
- 效果更好,在零样本分类和检索任务上超过 CLIP。
SigLIP 已成为 2024-2025 年多模态 LLM(如 PaliGemma、LLaVA 系列后继模型)的首选视觉编码器。
2025 年:统一多模态嵌入
Section titled “2025 年:统一多模态嵌入”2025 年的趋势是从”专门的多模态编码器”走向统一嵌入模型(Universal Embedding)——一个模型同时处理文本、图像、音频甚至视频:
- CLIP / SigLIP 变体:图文检索的标准基座。
- AudioCLIP / LAION-CLAP:将音频也纳入共享向量空间,支持”用文字描述搜音频”。
- InternVideo / VideoCLIP:视频嵌入,支持”以文搜视频""以视频搜视频”。
- ImageBind(Meta):用图像作为”锚点”,将文本、图像、音频、深度图、热成像、IMU 传感器数据等 6 种模态绑定到同一向量空间——不需要所有模态两两配对训练,只需各自与图像对齐。
统一嵌入模型使得”用文字搜视频片段""用一段音频找相似风格的音乐”等跨模态搜索成为可能。实际产品中,Cohere Embed v4 已开始支持图文混合嵌入,Jina clip v2 则提供高质量的中英图文检索能力。
嵌入维度选择
Section titled “嵌入维度选择”| 维度 | 典型模型 | 适用场景 |
|---|---|---|
| 384 | all-MiniLM-L6-v2 | 原型验证、资源受限 |
| 768 | BGE-base、E5-base | 平衡效果与效率,生产常用 |
| 1024 | BGE-large、BGE-M3、GTE-large | 追求更高精度 |
| 1536 | OpenAI text-embedding-3-small | 商用 API 入门 |
| 3072 | OpenAI text-embedding-3-large | 最高精度,存储成本高 |
| 4096 | E5-mistral、NV-Embed | 基于 LLM 的嵌入,精度极高 |
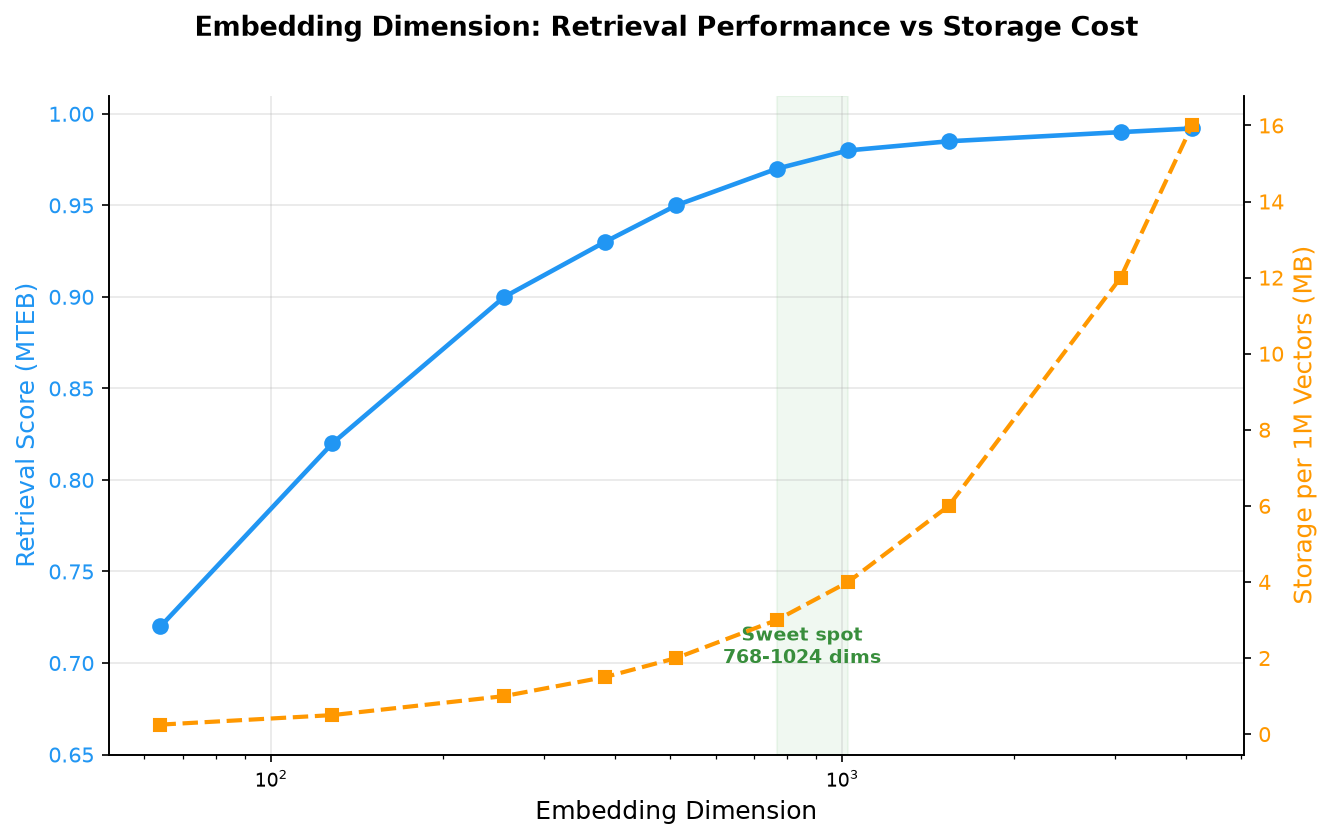
维度越高信息越丰富,但存储和检索成本也越高(向量数据库内存随维度线性增长)。一般 RAG 检索用 768-1024 维即可;配合 Matryoshka 截断,高维模型也可以在低维下高效运行。
两个嵌入向量的相似度最常用**余弦相似度(Cosine Similarity)**衡量:
值域 [-1, 1],越接近 1 表示方向越一致(语义越相似)。不关心向量长度,只关心方向——这正是语义比较所需要的。
如果预先对向量做 L2 归一化(使 |A| = |B| = 1),则余弦相似度退化为点积(Dot Product),计算更快——大多数向量数据库默认做归一化,直接用点积即可。
生产实践最佳实践
Section titled “生产实践最佳实践”批处理与缓存
Section titled “批处理与缓存”- 批量嵌入:几乎所有嵌入模型和 API 都支持批量推理。逐条调用 API 会产生巨大的网络开销,应积攒到 100~1000 条一批统一提交。本地推理时,GPU 的并行优势也要求批量处理才能发挥。
- 缓存嵌入结果:文档嵌入是昂贵操作(尤其调用外部 API),应将结果持久化缓存。文档内容不变则嵌入不变——用文档内容的哈希值(如 MD5/SHA256)作为缓存 key,避免重复计算。
- 增量更新:知识库新增文档时只需嵌入新文档,无需全量重建。设计好文档 ID 与向量的映射关系。
维度选择与索引类型
Section titled “维度选择与索引类型”向量检索引擎的**近似最近邻(ANN, Approximate Nearest Neighbor)**索引主要有两大流派:
| 索引类型 | 原理 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| HNSW(分层可导航小世界图) | 构建多层近邻图,从顶层粗导航到底层精搜 | 查询速度快、召回率高、无需训练 | 内存占用大、构建慢 | 中小规模库(1000 万以下)、低延迟首选 |
| IVF(倒排文件) | K-means 聚类后只搜索最近的几个簇 | 内存效率高、构建快 | 需要训练、召回率依赖参数调优 | 大规模库(1000 万以上)、内存受限 |
| IVF-PQ(IVF + 乘积量化) | IVF 基础上对向量做压缩编码 | 内存占用极低 | 有精度损失 | 超大规模、资源极受限 |
| Flat(暴力搜索) | 不做任何近似,计算所有距离 | 100% 精确 | 速度慢、不可扩展 | 小库(10 万以下)、精确基准 |
经验法则:默认从 HNSW 开始(M=16, ef_construction=200),效果不满足时再调参。百万级以上文档考虑 IVF,亿级考虑 IVF-PQ。详见向量数据库。
详细的索引选型和调参策略,推荐参考 ANN Benchmarks 上的实测对比。
最大输入长度与分块
Section titled “最大输入长度与分块”嵌入模型通常限制 512 token 左右(BGE-M3、GTE-Qwen2 等新模型支持 8192+ token),长文档需先**分块(Chunking)**再嵌入。分块策略直接影响检索质量——详见 RAG 的分块策略章节。
用 sentence-transformers 生成嵌入并计算相似度
Section titled “用 sentence-transformers 生成嵌入并计算相似度”from sentence_transformers import SentenceTransformer, util
# 加载中文友好的嵌入模型(BGE-base,768 维)model = SentenceTransformer("BAAI/bge-base-zh-v1.5")
# 待比较的句子sentences = ["我喜欢猫", "我爱小猫", "今天股市大涨"]embeddings = model.encode(sentences) # 生成嵌入向量
# 计算余弦相似度(0~1,越大越相似)sim_0_1 = util.cos_sim(embeddings[0], embeddings[1]).item()sim_0_2 = util.cos_sim(embeddings[0], embeddings[2]).item()print(f"'我喜欢猫' vs '我爱小猫': {sim_0_1:.3f}") # ≈ 0.85(语义相近)print(f"'我喜欢猫' vs '今天股市大涨': {sim_0_2:.3f}") # ≈ 0.30(语义无关)Matryoshka 维度截断示例
Section titled “Matryoshka 维度截断示例”import torchfrom sentence_transformers import SentenceTransformer
model = SentenceTransformer("BAAI/bge-base-zh-v1.5") # 768 维emb = model.encode(["如何训练猫使用猫砂盆"], normalize_embeddings=True)
# 截断到 256 维(取前 256 维),然后重新归一化for dim in [768, 512, 256, 128, 64]: truncated = emb[:, :dim] truncated = torch.nn.functional.normalize( torch.tensor(truncated), p=2, dim=1 ) print(f"{dim:4d} 维向量: 前 5 个值 = {truncated[0, :5].tolist()}")BGE-M3 多功能检索示例
Section titled “BGE-M3 多功能检索示例”from FlagEmbedding import BGEM3FlagModel
model = BGEM3FlagModel("BAAI/bge-m3", use_fp16=True)queries = ["如何训练猫"]documents = ["训练小猫使用猫砂盆的方法", "今日股市行情", "猫粮推荐"]
# 同时获取稠密、稀疏、多向量分数scores = model.compute_score( model.encode(queries)["embeddings"], model.encode(documents)["embeddings"],)print(scores) # 输出 dense_score, sparse_score, colbert_score实践要点总结
Section titled “实践要点总结”- 模型选型看语言:中文场景优先 BGE-M3(智源)、GTE-Qwen2(阿里),英文场景优先 E5-mistral、NV-Embed、stella。MTEB 排行榜是参考但不是唯一标准。
- 归一化向量:存储前对嵌入做 L2 归一化(使向量长度为 1),这样余弦相似度退化为点积,计算更快——大多数向量数据库默认做归一化。
- 维度与成本的权衡:3072 维的存储和检索成本是 768 维的 4 倍。配合 Matryoshka 截断,可以两阶段检索(低维粗召 + 高维精排)兼顾速度与精度。
- 异步批量嵌入:建库阶段对数万文档做嵌入很耗时,应批量处理并缓存结果,避免重复计算。
- 注意最大输入长度:嵌入模型通常限制 512 token 左右,长文档需先分块再嵌入——详见 RAG 的分块策略。
- 指令前缀:部分模型(如 BGE)要求查询加特定前缀(如”为这个句子生成表示用于检索相关文章:”),效果提升明显,别漏了。
- 别忽略稀疏检索:纯稠密嵌入对精确匹配(产品型号、代码、人名)较弱,BGE-M3 的稀疏向量或 BM25 混合检索能弥补这一短板——详见检索方法。
- RAG 语义检索:把知识库文档嵌入向量后,用户提问时用嵌入向量检索最相关段落——所有 RAG 产品的核心。详见 RAG 检索增强生成。
- 语义搜索:搜索”如何提升销量”时能找到写着”提高营业额的方法”的文档——理解意思而不只是匹配关键词。
- 推荐系统:把用户兴趣和商品描述都嵌入,推荐向量最相似的商品——淘宝、美团的语义推荐引擎。
- 文本去重:在海量文档中找出语义重复的内容——新闻聚合去重、论文查重、爬虫数据清洗。
- 聚类分析:把嵌入向量送入 K-means 等算法,自动发现文档的主题分组。
- 以图搜图 / 以文搜图:用 CLIP / SigLIP 嵌入打通文本和图像,Pinterest 的相似图片推荐、电商的拍照购物都基于此。
- 跨模态搜索:统一嵌入模型让”用文字搜视频片段""用音频找相似音乐”成为可能——短视频平台的内容推荐已开始采用。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| sentence-transformers | Python | 最流行的句子嵌入库,内置 SBERT、E5、BGE 等数百个预训练模型 |
| HuggingFace Transformers | Python | 提供底层 Transformer 模型,可自行加载和微调嵌入模型 |
| OpenAI Embeddings API | REST | text-embedding-3-small / large,闭源商用嵌入服务,支持 MRL 维度截断 |
| Cohere Embed | REST | 多语言多模态嵌入 API(Embed v4 支持图文) |
| Voyage AI | REST | 专注 RAG 场景优化的嵌入 API(Voyage-3 系列) |
| FlagEmbedding | Python | 智源 BGE 系列官方库,支持 BGE-M3 多功能检索和微调 |
| CLIP / SigLIP / open_clip | Python | 多模态图文嵌入模型,图文共享向量空间 |
| gensim | Python | 经典词嵌入库,提供 word2vec、GloVe、fastText 训练接口 |
| rerankers / ColBERT | Python | 延迟交互检索库,ColBERT v2 及 PLAID 引擎 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 稠密向量 | Dense Vector | 每一维都有非零值的低维向量(如 768 维),是嵌入的表示形式 |
| 稀疏表示 | Sparse Representation | 如 one-hot 编码或 BM25 词频向量,绝大多数维度为零 |
| 余弦相似度 | Cosine Similarity | 衡量两向量方向一致性的指标,值域 -1 到 1,越大越相似 |
| 嵌入空间 | Embedding Space | 所有嵌入向量构成的高维空间,语义相近的内容向量也相近 |
| 对比学习 | Contrastive Learning | 通过拉近正样本、推远负样本来训练嵌入的方法 |
| InfoNCE | InfoNCE Loss | 对比学习的核心损失函数,从正负样本中识别正确配对 |
| 负采样 | Negative Sampling | word2vec 的加速技巧,用随机噪声词代替遍历整个词汇表 |
| 指令微调嵌入 | Instruction-Tuned Embedding | 嵌入时加入任务指令,使同一文本在不同任务下生成不同向量 |
| 分布式表示 | Distributed Representation | 信息分布在所有维度上而非集中在一维的表示方式 |
| 分布式假设 | Distributional Hypothesis | 上下文相似的词具有相似含义,是嵌入的理论基础 |
| Matryoshka 表示学习 | MRL | 训练嵌入在多个维度截断下都保持高质量的方法 |
| 延迟交互 | Late Interaction | 保留 token 级嵌入到查询时再做细粒度匹配,ColBERT 的核心机制 |
| MaxSim | MaxSim Operation | ColBERT 的核心操作,对查询每个 token 取文档中最相似 token 的分数 |
| 孪生网络 | Siamese Network | 两个共享权重的编码器分别处理输入对,Sentence-BERT 的架构 |
| 池化 | Pooling | 将 token 级向量压缩为句子级向量的操作(CLS / Mean / Max) |
| 困难负样本 | Hard Negative | 与锚点表面相似但实际不匹配的样本,能提升嵌入判别力 |
| Top-K 检索 | Top-K Retrieval | 返回相似度最高的 K 个结果,是语义搜索的标准操作 |
| 多模态嵌入 | Multimodal Embedding | 将文本、图像、音频等不同模态映射到同一向量空间 |
| MTEB | Massive Text Embedding Benchmark | 涵盖 8 大类任务的综合嵌入评估基准,选型权威参考 |
- 分布式假设:Zellig Harris, “Distributional Structure” (Word, 1954);J.R. Firth, “A synopsis of linguistic theory” (1957)——嵌入理论的语言学根源。
- word2vec:Mikolov et al., “Efficient Estimation of Word Representations in Vector Space” (ICLR 2013),词嵌入的开山之作,提出 Skip-gram 和 CBOW。
- 负采样:Mikolov et al., “Distributed Representations of Words and Phrases and their Compositionality” (NeurIPS 2013),提出负采样和层次 softmax 优化。
- GloVe:Pennington, Socher, Manning, “GloVe: Global Vectors for Word Representation” (EMNLP 2014),利用全局词共现矩阵的词嵌入方法。
- Sentence-BERT:Reimers & Gurevych, “Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks” (EMNLP 2019),句子嵌入里程碑,sentence-transformers 的基础。
- InfoNCE:Oord et al., “Representation Learning with Contrastive Predictive Coding” (2018),对比学习损失函数的奠基之作。
- E5:Wang et al., “Text Embeddings by Weakly-Supervised Contrastive Pre-training” (2022),微软的对比学习文本嵌入。
- BGE / C-Pack:Xiao et al., “C-Pack: Packged Resources To Advance General Chinese Embedding” (2023),智源的中英文嵌入模型,MTEB 中文榜首。
- BGE-M3:Chen et al., “M3-Embedding: Multi-Lingual, Multi-Functionality, Multi-Granularity Text Embeddings Through Self-Knowledge Distillation” (2024),一模型三功能的统一检索嵌入。
- Matryoshka 表示学习:Kusupati et al., “Matryoshka Representation Learning” (NeurIPS 2022),多维度截断的嵌入训练方法。
- ColBERT:Khattab & Zaharia, “ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT” (SIGIR 2020),延迟交互检索的开创之作。
- ColBERT v2:Santhanam et al., “ColBERTv2: Effective and Efficient Retrieval via Lightweight Late Interaction” (NAACL 2022),ColBERT 的压缩与加速优化。
- CLIP:Radford et al., “Learning Transferable Visual Models From Natural Language Supervision” (ICML 2021),OpenAI 多模态对比学习,图文共享向量空间的奠基之作。
- SigLIP:Zhai et al., “Sigmoid Loss for Language Image Pre-Training” (ICCV 2023),Google 改进的图文对比学习,用 sigmoid 替代 softmax。
- ImageBind:Girdhar et al., “ImageBind: One Embedding Space To Bind Them All” (CVPR 2023),Meta 的六模态统一嵌入。
- NV-Embed:Lee et al., “NV-Embed: Improved Techniques for Training LLMs as Generalist Embedding Models” (2024),NVIDIA 的 MTEB 顶级嵌入模型。
- MTEB 排行榜:Muennighoff et al., “MTEB: Massive Text Embedding Benchmark” (EACL 2023),综合评估嵌入模型在 8 类任务上的表现,是选型的权威参考。详见 HuggingFace MTEB Leaderboard。