
反向传播详解
反向传播(Backpropagation,简称 backprop)是训练深度神经网络的核心算法——它用微积分中的链式法则高效计算损失函数对每个参数的梯度,让梯度下降成为可能。自 1986 年 Rumelhart、Hinton 和 Williams 在 Nature 上发表里程碑论文以来,反向传播一直是深度学习几乎不可替代的训练引擎;今天的 PyTorch、TensorFlow、JAX 等所有主流框架,其自动微分(Automatic Differentiation,即”自动求导”)底层都依赖它。
本页从计算图出发,逐步推导前向传播与反向传播的完整数学过程,再讲解 PyTorch 自动微分引擎的原理与实战。前置阅读:梯度下降与优化器、线性代数基础、数值优化与数学基础。
反向传播的本质就是链式法则的工业级自动化。
想象一家工厂的生产流水线(前向传播):原材料(输入数据)经过一道道工序(网络层),逐步加工成成品(预测结果)。质检员发现成品有缺陷(损失值),需要追究每一道工序的责任——到底哪一步出了问题、责任多大?
- 前向传播(Forward Pass)= 原材料从流水线起点流到终点,每一步记录中间产品(激活值,即每层运算后的输出)。这里的”记录”至关重要:反向传播要复用这些中间值来算梯度。
- 反向传播(Backward Pass)= 质检报告从终点逆流回起点,逐级追问”你这步对最终误差贡献了多少?“,由此算出每道工序的改进方向(梯度,即参数应该朝哪个方向调整)。
- 梯度下降(Gradient Descent)= 根据责任大小调整每道工序的参数,让下次生产的产品更合格。
为什么不能”暴力”算梯度?
Section titled “为什么不能”暴力”算梯度?”假设你想知道参数 对损失 的影响,最原始的办法是数值微分:给 加一个小扰动 ,重新跑一次前向传播看 变了多少,近似 。
问题在于:网络有数百万甚至数十亿参数,数值微分需要对每个参数各做一次前向传播,总代价是 次前向传播( 是参数总数)。一个 70B 参数的模型跑一次前向就要数秒, 次根本不现实。
而反向传播只需一次前向 + 一次反向,总共两次遍历,就能算出所有参数的梯度——计算量大约只有两次前向传播。这正是反向传播高效的根本原因,也是深度学习能扩展到千亿参数的关键。
一句话总结:前向传播算结果,反向传播算责任,梯度下降改参数。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
# Simulate gradient norms across layers in a 20-layer sigmoid networknp.random.seed(42)steps = np.arange(0, 200)layer_depths = ["Layer 1\n(shallow)", "Layer 5", "Layer 10", "Layer 15", "Layer 20\n(deep)"]colors = ["#e91e63", "#FF9800", "#FFC107", "#8BC34A", "#2196F3"]
fig, ax = plt.subplots(figsize=(9, 5.5))fig.patch.set_facecolor("white")
for i, (depth, color) in enumerate(zip(layer_depths, colors)):    decay = 0.25 ** (i * 4)  # sigmoid gradient vanishes exponentially with depth    base_grad = 0.5 * decay    grad_norm = base_grad * np.exp(-steps / 300) + base_grad * 0.1 * np.random.randn(len(steps))    grad_norm = np.maximum(grad_norm, 0)    ax.plot(steps, grad_norm, linewidth=1.5, label=depth, color=color, alpha=0.8)
ax.set_yscale("log")ax.set_xlabel("Training Step", fontsize=11, fontweight="bold")ax.set_ylabel("Gradient L2 Norm (log scale)", fontsize=11, fontweight="bold")ax.set_title("Gradient Norm Across Layers: Vanishing Gradient in Deep Networks", fontsize=12, fontweight="bold")ax.legend(fontsize=8, loc="upper right")ax.grid(True, alpha=0.2, linestyle="--", which="both")ax.set_ylim(1e-14, 1)ax.axhspan(1e-12, 1e-8, alpha=0.05, color="red")ax.text(180, 1e-10, "Vanishing\nGradient\nZone", fontsize=8, color="red", ha="center", va="center")
plt.tight_layout()plt.savefig("/mnt/kvm_ata-Netac_SSD_480GB_AA000000000000000904-part1/proj/docs/img/generated/backprop-gradient-flow.png",            dpi=180, bbox_inches="tight", facecolor="white")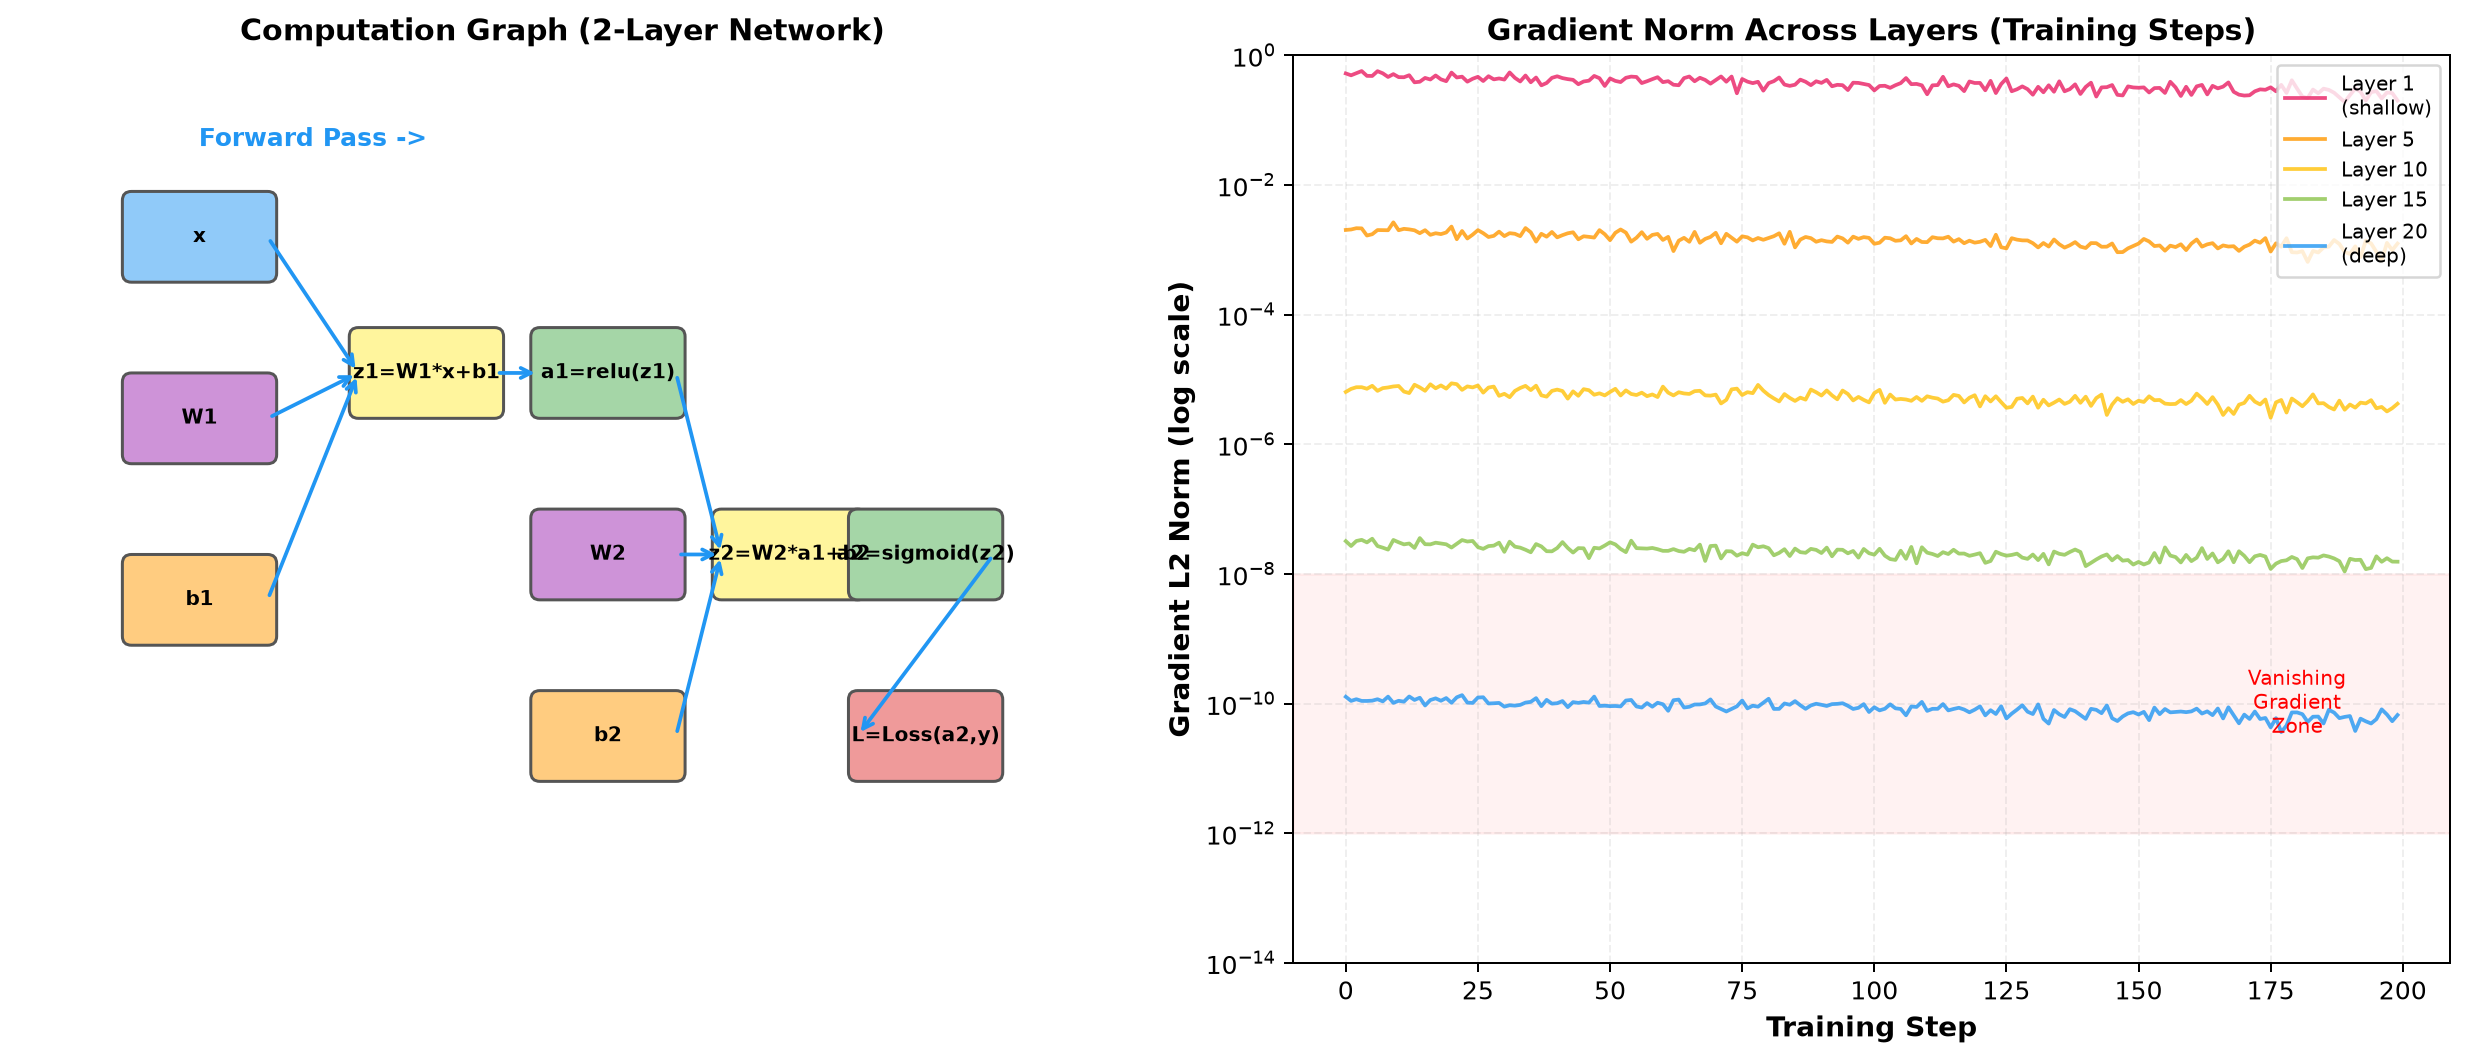
反向传播在计算图(Computational Graph)上执行。计算图是一种有向无环图(DAG),每个节点代表一个运算(加、乘、激活函数等),边表示数据流动方向。把复杂的神经网络拆解成计算图后,每个节点只需要处理自己那一步的”局部求导”,整个网络的梯度就能通过链式法则拼起来。
以一个最简单的单层网络为例。设某一层有:输入 ,权重 ,偏置 ,输出 ,最终损失 ,其中 是真实标签。画成计算图:
x ──┐ ├──(×)── z ──┐w ──┘ ├──(+)── s ──(relu)── a ──(Loss)── L b ────────────────────── y ────────┘即:,,,。
从输入到输出逐节点计算,每个节点保存自己的输出值和输入值,供反向传播使用:
为什么要保存中间值? 因为反向传播计算梯度时需要用到前向传播中的输入值。例如 ,需要用到 ;,需要用到 。这就是为什么训练神经网络比推理(只做前向传播)消耗更多内存——需要保存整条计算路径的中间结果。这也是后面要讨论的激活检查点(Activation Checkpointing)技术要解决的问题。
反向传播:链式法则逐步推导
Section titled “反向传播:链式法则逐步推导”反向传播从损失 出发,逐节点倒退,计算 对每个变量的偏导数(梯度)。核心是链式法则:
链式法则(Chain Rule):如果 且 ,则 。
推广到多元函数:如果 ,则 。
下面逐步推导。
第一步:穿过损失节点——计算
这取决于具体的损失函数。对于 MSE 损失(均方误差):
对于交叉熵损失配合 softmax 输出,梯度恰好简化为 (这种简洁性是 softmax + 交叉熵成为分类标配的原因之一,详见损失函数)。
第二步:穿过 ReLU 节点——计算
ReLU(修正线性单元,一种激活函数 )的导数是一个分段函数:
因此:
直观理解:ReLU 在正区间原样传递梯度(导数为 1),在负区间直接阻断(导数为 0)。这种”不衰减也不放大”的特性是 ReLU 能缓解梯度消失的关键原因。
第三步:穿过加法节点——计算 和
加法 的偏导:,。所以:
直观理解:加法节点是”梯度分配器”——它把上游梯度原样复制给每个输入,不做任何缩放。
第四步:穿过乘法节点——计算 和
乘法 的偏导:,。所以:
直观理解:乘法节点是”梯度交换器”——对某个输入的梯度 = 上游梯度 × 另一个输入的值。如果 很大,则 的梯度也很大( 的微小变化会被放大);反之亦然。
通用规则:局部梯度 × 上游梯度
Section titled “通用规则:局部梯度 × 上游梯度”对于任意节点 ,反向传播只需一个公式:
即”上游梯度 × 局部梯度”。每个节点只需知道自己的局部导数 ,不需要知道整个网络的结构——这就是模块化的优势,也是 PyTorch 自动微分引擎的设计基础。你可以在框架中定义任意自定义层,只要提供前向传播和局部导数(反向传播),框架就能自动将其接入整个计算图。
多层网络的矩阵形式
Section titled “多层网络的矩阵形式”实际神经网络用矩阵运算表示。对于全连接层(Fully Connected Layer,也叫线性层):
其中 是权重矩阵, 是输入, 是偏置, 是激活函数。给定上游梯度 ,反向传播的矩阵推导为:
注意 是一个外积(Outer Product),每个权重的梯度等于”上游传来的误差信号 × 对应位置的输入值”。这个矩阵公式就是反向传播在所有主流框架中的实际计算形式——GPU 通过高度优化的矩阵乘法(GEMM)来执行。
为什么反向传播是 次而非 次前向传播? 因为矩阵形式下, 一次矩阵运算就同时算出了该层所有权重( 个参数)的梯度。每一层都是如此,全部层的梯度只需一次从后到前的遍历。
批量处理(Mini-batch)
Section titled “批量处理(Mini-batch)”实际训练不会逐样本算梯度,而是用小批量(Mini-batch)——同时处理 个样本。此时 ,前向传播和反向传播的矩阵形式不变,梯度变为 个样本梯度的平均:
批量处理让 GPU 的矩阵运算单元(Tensor Core)能充分发挥并行能力,是现代训练效率的基础。
前向与反向传播
Section titled “前向与反向传播”计算图上的反向传播规则
Section titled “计算图上的反向传播规则”单节点反向传播流程(通用模式)
Section titled “单节点反向传播流程(通用模式)”示例 1:PyTorch 自动反向传播
Section titled “示例 1:PyTorch 自动反向传播”import torch
# 构建计算图:y = relu(w * x + b),目标值 3.0x = torch.tensor(2.0)w = torch.tensor(1.5, requires_grad=True) # requires_grad=True 告诉 PyTorch 追踪该张量的梯度b = torch.tensor(0.5, requires_grad=True)
# 前向传播(每步自动记录到计算图)z = w * x # z = 3.0a = torch.relu(z) # a = 3.0(z>0,relu 不截断)loss = 0.5 * (a - 3.0) ** 2 # loss = 0.0
# 反向传播:一行代码自动算出所有梯度loss.backward()print(f"dL/dw = {w.grad}") # 梯度自动计算,结果 = 0.0(因为 loss=0 时梯度为 0)print(f"dL/db = {b.grad}") # PyTorch 沿计算图反向递推
# 手动梯度下降一步(实际中用 optimizer.step() 自动完成)lr = 0.01w.data -= lr * w.gradb.data -= lr * b.gradw.grad.zero_() # 清空梯度,否则下次 backward() 会累加b.grad.zero_()为什么需要
zero_grad()? PyTorch 的梯度默认是累加的(.grad += new_grad),这是为了支持梯度累积(Gradient Accumulation)——在显存不够时,把一个大 batch 拆成多个小 batch 累计梯度再更新。但如果不需要这个行为,必须在每次backward()前清零,否则梯度会越来越大。
示例 2:NumPy 手写两层网络的反向传播
Section titled “示例 2:NumPy 手写两层网络的反向传播”这个例子帮助你从底层理解反向传播到底在做什么——没有任何自动微分引擎,纯手工链式法则。
import numpy as np
# 两层网络: input(3) → hidden(4, relu) → output(1, sigmoid)np.random.seed(42)X = np.random.randn(3, 1)                        # 输入 (3×1)Y = np.array([[1.0]])                             # 目标 (1×1)W1 = np.random.randn(4, 3) * 0.5                  # 第一层权重 (4×3)W2 = np.random.randn(1, 4) * 0.5                  # 第二层权重 (1×4)
# ========== 前向传播 ==========Z1 = W1 @ X                                       # 线性变换 (4×1)A1 = np.maximum(0, Z1)                            # ReLU 激活 (4×1)Z2 = W2 @ A1                                      # 线性变换 (1×1)A2 = 1 / (1 + np.exp(-Z2))                        # Sigmoid 激活 (1×1)
# 二元交叉熵损失(Binary Cross-Entropy,用于二分类)eps = 1e-8loss = -np.mean(Y * np.log(A2 + eps) + (1 - Y) * np.log(1 - A2 + eps))
# ========== 反向传播(链式法则逐层求导)==========# 输出层梯度:sigmoid + 交叉熵的合并导数恰好是 (A2 - Y)dA2 = (A2 - Y)                                    # dL/dA2 (1×1)dW2 = dA2 @ A1.T                                  # dL/dW2 = dL/dZ2 · A1ᵀ (1×4)
# 穿过 W2 传回隐藏层,再穿过 ReLUdA1 = W2.T @ dA2                                  # dL/dA1 (4×1)dZ1 = dA1 * (Z1 > 0)                              # ReLU 的导数:正区间为 1,否则为 0 (4×1)dW1 = dZ1 @ X.T                                   # dL/dW1 = dL/dZ1 · Xᵀ (4×3)
# ========== 梯度下降更新 ==========lr = 0.1W1 -= lr * dW1W2 -= lr * dW2
print(f"Loss: {loss:.4f}")print(f"W1 grad shape: {dW1.shape}, W2 grad shape: {dW2.shape}")
示例 3:完整的训练循环
Section titled “示例 3:完整的训练循环”将前向、反向、更新组合成一个完整的训练循环,这是所有深度学习训练的标准范式:
import torchimport torch.nn as nn
# 简单的两层网络model = nn.Sequential(    nn.Linear(10, 64),    nn.ReLU(),    nn.Linear(64, 1),    nn.Sigmoid(),)
criterion = nn.BCELoss()                          # 二元交叉熵损失optimizer = torch.optim.SGD(model.parameters(), lr=0.01)
# 模拟数据X = torch.randn(100, 10)                          # 100 个样本,每个 10 维Y = torch.randint(0, 2, (100, 1)).float()         # 随机标签
# 标准训练循环(每个 epoch 遍历一次全部数据)for epoch in range(50):    # 1. 前向传播:输入数据,得到预测值    pred = model(X)    loss = criterion(pred, Y)
    # 2. 反向传播:计算所有参数的梯度    optimizer.zero_grad()                         # 清空上一步的残余梯度    loss.backward()                               # 自动反向传播!
    # 3. 参数更新:沿梯度反方向走一步    optimizer.step()
if epoch % 10 == 0: print(f"Epoch {epoch}, Loss: {loss.item():.4f}")这三步——前向、反向、更新——就是深度学习训练的”心跳”。无论模型是简单的 MLP 还是千亿的 GPT,训练循环的结构都是这个三步曲的变体。大规模训练只是在此基础上增加了分布式并行、混合精度、梯度累积等加速手段,详见分布式训练和混合精度训练。
自动微分引擎的原理
Section titled “自动微分引擎的原理”PyTorch 的动态计算图
Section titled “PyTorch 的动态计算图”PyTorch 采用动态计算图(Dynamic Computational Graph)——每次前向传播时实时构建计算图,backward() 后立即销毁。这叫”Define-by-Run”,好处是:
- 可以用 Python 的
if/for/while控制流,计算图随代码执行动态变化 - 调试方便:可以在任何地方打断点检查张量值
- 支持动态结构(如变长序列、条件计算)
代价是每次前向传播都要重新构建计算图,优化空间不如静态图(TensorFlow 1.x 的 “Define-and-Run” 模式)。但 PyTorch 2.0 引入的 torch.compile 通过 JIT 编译部分弥补了这个差距。
Autograd 的内部机制
Section titled “Autograd 的内部机制”PyTorch 的自动微分引擎叫 Autograd,核心机制如下:
- 前向传播时:每个
requires_grad=True的张量都有一个.grad_fn属性,指向创建它的函数(如MulBackward0、AddBackward0)。这些grad_fn组成反向传播的”路线图”。 - 调用
.backward()时:从loss开始,沿着grad_fn链表逆序遍历,在每个节点执行forward操作对应的backward函数,将上游梯度乘以局部梯度,得到下游梯度。 - 梯度累积:同一个叶子节点(leaf tensor,即用户直接创建的
requires_grad=True张量)被多次使用时,来自不同路径的梯度会相加(多路径链式法则:)。
import torch
# 验证梯度累积:x 同时用于两条路径x = torch.tensor(3.0, requires_grad=True)y = x * 2        # 路径 1z = x * x        # 路径 2loss = y + z     # loss = 2x + x²
loss.backward()print(f"x.grad = {x.grad}")  # dL/dx = 2 + 2x = 2 + 6 = 8.0# 两条路径的梯度 2(来自 y)和 6(来自 z)自动相加
自定义自动微分函数
Section titled “自定义自动微分函数”当内置操作不够用时,可以通过继承 torch.autograd.Function 定义自定义的前向传播和反向传播:
from torch.autograd import Function
class MyReLU(Function):    @staticmethod    def forward(ctx, input):        ctx.save_for_backward(input)              # 保存前向输入,供反向使用        return input.clamp(min=0)                 # 前向:ReLU
    @staticmethod    def backward(ctx, grad_output):        input, = ctx.saved_tensors                # 取回前向保存的值        grad_input = grad_output.clone()        grad_input[input < 0] = 0                 # 反向:ReLU 的导数(正区间为 1)        return grad_input
# 使用:my_relu = MyReLU.apply这展示了反向传播的模块化本质:你只需要告诉框架”前向怎么算”和”局部导数怎么算”,框架负责链式法则的传递。
梯度问题的深度分析
Section titled “梯度问题的深度分析”问题:Sigmoid 和 Tanh 激活函数的导数最大值分别只有 0.25 和 1.0。当网络有很多层时,反向传播每经过一层,梯度就要乘以一个小于 1 的数:
连乘 个 0.25 就是 ——20 层网络中梯度衰减到 ,浅层参数几乎收不到学习信号。这是 1990 年代到 2000 年代深度学习”寒冬”的核心技术原因之一。
解决方案:
- ReLU 及其变体(Leaky ReLU、GELU、SwiGLU):导数为 0 或 1,不衰减梯度。详见激活函数。
- 残差连接(Residual Connection / Skip Connection):ResNet 引入的 ,梯度可以跳过非线性层直接传播。详见 ResNet。
- Layer Normalization(层归一化):每层归一化激活值分布,间接稳定梯度流。
- 合理的权重初始化:让前向激活值和反向梯度的方差都保持在 1 附近(如 Xavier/He 初始化)。详见权重初始化。
问题:RNN(循环神经网络)中权重矩阵在时间维度上反复相乘,当特征值大于 1 时,梯度指数增长,导致 NaN(Not a Number,数值溢出)。
连乘 个大于 1 的矩阵,梯度爆炸。
解决方案:
- 梯度裁剪(Gradient Clipping):当梯度范数超过阈值时按比例缩小:
其中 是预设阈值。详见RNN 与序列模型。
- 门控机制(LSTM/GRU):通过遗忘门、输入门控制信息流,缓解梯度爆炸/消失。
- Layer Normalization:同样有助于稳定训练。
梯度检查点(Activation Checkpointing / Gradient Checkpointing)
Section titled “梯度检查点(Activation Checkpointing / Gradient Checkpointing)”训练大型模型时,前向传播需要保存大量中间激活值(供反向传播使用),这些激活值是显存的主要消耗来源。梯度检查点技术只保存部分层的激活值,其余的在反向传播时重新计算:
| 策略 | 显存 | 计算量 | 适用场景 |
|---|---|---|---|
| 保存所有激活 | 小模型 | ||
| 梯度检查点 | 大模型,显存不足 |
这是一种”以计算换显存”的权衡,是训练百亿参数以上模型的标准技术。详见分布式训练。
- 梯度消失:sigmoid/tanh 的导数最大值分别是 0.25 和 1,多层网络反向传播时梯度逐层衰减,深层几乎学不到东西。这是 ReLU(导数为 0 或 1)取代 sigmoid 的主要原因。详见激活函数。
- 梯度爆炸:RNN 中权重反复相乘,梯度指数增长导致 NaN。用梯度裁剪(gradient clipping)限制梯度范数。详见RNN 与序列模型。
requires_grad和计算图:PyTorch 中只有requires_grad=True的张量才会被追踪梯度。调用.backward()后计算图被释放(默认),再次backward()会报错——需要retain_graph=True才能复用。detach()和torch.no_grad():detach()把张量从计算图分离(不再追踪梯度),torch.no_grad()上下文管理器暂停梯度追踪。推理和评估时务必用后者,节省内存并加速。- 梯度累积(Gradient Accumulation):显存不够时,可以把大 batch 拆成多个小 batch,每次只做前向+反向但不更新参数,累积几步梯度后再统一更新。等效于用更大的 batch size 训练。
- 混合精度训练:前向传播用 FP16/BF16 加速、反向传播自动缩放梯度防止下溢,是现代大模型训练的标配。详见混合精度训练。
- 检查梯度正确性:用
torch.autograd.gradcheck做数值梯度检验——用有限差分法验证自动微分结果是否正确,开发自定义层时必备。原理是对每个参数手动做数值微分 ,与 autograd 的结果对比。 - 高阶导数:PyTorch 和 JAX 都支持高阶导数(梯度的梯度),用于元学习(MAML)、物理信息神经网络(PINN)等场景。JAX 的函数式风格让
grad(grad(f))非常自然。
- 所有深度学习训练:PyTorch 的
loss.backward()和 TensorFlow 的GradientTape内部执行的就是反向传播。详见梯度下降与优化器。 - Transformer 训练:自注意力机制(Self-Attention)的反向传播需要处理 softmax 和矩阵乘法的梯度链,是 GPT/BERT 训练的计算核心。一个关键优化是 Flash Attention 算法,它融合了前向和反向传播中 softmax 相关的多个操作,大幅减少显存读写。详见Transformer 架构和Flash Attention。
- CNN 训练:卷积层的反向传播等价于反卷积(转置卷积),ReLU 的反向传播只需掩码。详见卷积神经网络。
- 神经网络可解释性:Grad-CAM 等方法用反向传播提取梯度,生成显著性图(saliency map)解释模型关注了图像的哪些区域。
- 对抗样本生成:FGSM(快速梯度符号法,Fast Gradient Sign Method)用反向传播计算输入的梯度(而非参数梯度),沿梯度符号方向扰动输入来欺骗模型。这是对抗训练(Adversarial Training)的基础。
- 元学习(Meta-Learning):MAML(Model-Agnostic Meta-Learning)需要在梯度上再算梯度(二阶导数),即”通过反向传播的反向传播”来学习如何快速适应新任务。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| torch.autograd | Python | PyTorch 自动微分引擎,动态计算图,loss.backward() 一行搞定 |
| TensorFlow GradientTape | Python | TensorFlow 2.x 的自动微分 API,在 tape 上下文中记录前向操作 |
JAX grad | Python | 函数式自动微分,grad(f) 返回 f 的梯度函数,支持高阶导数和 vmap 批量求导 |
| autograd | Python | 经典自动微分库(HIPS),JAX 的前身,NumPy 接口 |
| MicroGrad | Python | Karpathy 写的教学级自动微分引擎(约 100 行),理解反向传播的最佳读物 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 反向传播 | Backpropagation | 用链式法则反向计算损失对每个参数梯度的算法 |
| 计算图 | Computational Graph | 用有向无环图表示运算和数据依赖关系 |
| 前向传播 | Forward Pass | 输入数据经网络逐层计算到输出的过程 |
| 链式法则 | Chain Rule | 复合函数求导法则: |
| 局部梯度 | Local Gradient | 当前节点输出对输入的偏导数 |
| 上游梯度 | Upstream Gradient | 从损失传到当前节点的梯度 |
| 动态计算图 | Dynamic Graph | 每次前向传播时构建计算图(PyTorch 模式),灵活易调试 |
| 静态计算图 | Static Graph | 先定义计算图再执行(TensorFlow 1.x 模式),利于全局优化 |
| 自动微分 | Automatic Differentiation | 自动计算精确梯度的技术,反向模式即反向传播 |
| 梯度消失 | Vanishing Gradient | 深层网络梯度逐层衰减至零,导致浅层无法学习 |
| 梯度爆炸 | Exploding Gradient | 深层网络梯度指数增长,导致参数更新发散 |
| 梯度累积 | Gradient Accumulation | 多次小 batch 的梯度累加后再更新,等效于更大 batch size |
| 激活检查点 | Activation Checkpointing | 只保存部分激活值,其余反向时重算,以计算换显存 |
- Rumelhart, Hinton & Williams,「Learning Representations by Back-propagating Errors」(Nature 1986):反向传播的里程碑论文,让多层神经网络训练变得可行,深度学习的奠基工作之一。
- Karpathy,「MicroGrad: a tiny autograd engine」:约 100 行 Python 实现完整的自动微分引擎,是理解反向传播实现细节的最佳教学资源(GitHub 开源)。
- Goodfellow, Bengio & Courville,「Deep Learning」第 6 章:深度学习圣经中对反向传播的计算图推导和链式法则讲解最为系统。
- Baydin et al.,「Automatic Differentiation in Machine Learning: a Survey」(JMLR 2018):自动微分综述,梳理前向模式与反向模式的区别,以及与数值微分、符号微分的关系。
- Paske et al.,「Automatic Differentiation in PyTorch」(2017):PyTorch autograd 的白皮书,解释动态计算图的设计哲学与实现。
2025-2026 年最新进展
Section titled “2025-2026 年最新进展”反向传播自 1986 年提出至今近 40 年,其核心算法本身没有变化——链式法则不会过时。但围绕反向传播的工程实现、内存优化、替代方案在 2025-2026 年有显著进展。
反向传播的内存瓶颈与低秩梯度投影(GaLore)
Section titled “反向传播的内存瓶颈与低秩梯度投影(GaLore)”随着模型规模扩展到千亿甚至万亿参数,反向传播需要存储的梯度和优化器状态成为显存的主要瓶颈。一个 70B 参数的模型,仅 Adam 优化器状态就需要约 1.1 TB 显存(FP32 精度)。
2024-2025 年,GaLore(Gradient Low-Rank Projection) 成为热门技术:它不存储完整的梯度矩阵,而是将梯度投影到低秩子空间中,将优化器状态的内存从 降低到 ( 是秩,通常远小于维度)。与 LoRA(低秩微调)不同,GaLore 不改变模型结构,只改变梯度在优化器中的表示方式,因此可以用于预训练而非仅限微调。这使得在单张 24GB 消费级 GPU 上预训练 7B 模型成为可能。
torch.compile 与图优化
Section titled “torch.compile 与图优化”PyTorch 2.x 引入的 torch.compile(底层使用 TorchDynamo + Triton 编译器)在 2025 年趋于成熟。它将 Python 动态计算图编译为优化的静态图,对反向传播的优化包括:
- 算子融合(Operator Fusion):将多个逐元素操作(如
ReLU + 偏置加法 + 损失计算)合并为单个 GPU kernel,减少显存读写。反向传播中,激活函数的导数计算可以与相邻的矩阵乘法融合。 - 自动激活检查点:编译器自动分析计算图,决定哪些中间值值得保存、哪些适合重算。
- 生成优化的反向传播 kernel:使用 OpenAI 的 Triton 语言为每个前向操作生成对应的、特定于 GPU 架构的反向传播 kernel,避免 Python 解释器开销。
在 2025 年的基准测试中,torch.compile 对训练循环的端到端加速通常在 1.3x-2.5x,对纯反向传播部分可达 3x 以上。
Triton 与手写反向传播 kernel
Section titled “Triton 与手写反向传播 kernel”Triton(OpenAI 开发的 GPU kernel 编程语言)在 2025 年成为编写高性能反向传播 kernel 的首选工具。Flash Attention v2/v3、Megatron-LM 的张量并行通信、DeepSpeed 的 Zero 优化器,其核心 kernel 大量用 Triton 重写。相比直接写 CUDA C++,Triton 的抽象层级更高(类似 Python),但性能接近手写 CUDA。
一个典型应用是融合反向传播 kernel:将 softmax 反向 + 矩阵乘法梯度计算 + dropout 反向融合成一个 kernel,避免中间结果落回显存,这在 Transformer 训练中可节省 30-50% 的反向传播时间。
替代方案的前沿探索
Section titled “替代方案的前沿探索”尽管反向传播是绝对主流,学术界一直在探索生物上更合理的学习算法。真正的生物神经元不执行反向传播——大脑中没有”全局损失函数”和”精确梯度传递”。
- Forward-Forward Algorithm(FF):由 Geoffrey Hinton 在 2022 年底提出,FF 用两个前向传播(正样本 + 负样本)替代前向+反向,避免了反向传播的非局部梯度传递。到 2025 年,FF 在小规模任务上取得了一些进展,但在 ImageNet 等大规模任务上仍远不如反向传播,目前更多是理论探索。
- Equilibrium Propagation(平衡传播):基于循环网络的能量模型,在收敛状态附近用局部信号近似全局梯度。2025 年有研究将其扩展到现代 Transformer 架构,但训练效率仍远低于反向传播。
- Predictive Coding(预测编码):每个神经元层预测下一层的输入,用预测误差作为学习信号。这种方案天然支持局部计算(每层只需与相邻层通信),被认为是大脑皮层可能的计算原理之一。2025 年的研究开始将预测编码与大型语言模型结合。
截至 2026 年,反向传播在工程效率上的优势依然碾压所有替代方案,但这些探索为理解生物学习机制和设计新型神经形态芯片(Neuromorphic Chip)提供了重要启发。
硬件协同设计
Section titled “硬件协同设计”2025 年,NVIDIA H100/H200 GPU 和 Google TPU v5/v6 的设计越来越围绕反向传播的内存瓶颈优化:
- HBM3e 高带宽显存:2025 年量产的 HBM3e 提供 1.2 TB/s 以上带宽,缓解反向传播时读取激活值和写入梯度的内存墙问题。
- 稀疏梯度加速:硬件支持 2:4 结构化稀疏(Structured Sparsity),反向传播时只计算非零位置的梯度,理论翻倍计算密度。
- FP8 训练:H100 原生支持 FP8(8 位浮点)前向和反向传播,将激活值存储减半、梯度计算翻倍。2025 年,FP8 训练在 LLM 预训练中被广泛采用,精度损失已可忽略。
这些硬件进步意味着,反向传播——这个 40 年前的算法——在未来几年仍将是深度学习训练的核心。创新不在于替代它,而在于让它在新的硬件上跑得更快、更省内存。