
DeepSpeed 与 FSDP
DeepSpeed 与 PyTorch FSDP 是当前训练超大语言模型时最核心的两套”显存省着花”分布式方案——它们让百亿乃至万亿参数的模型能在有限 GPU 上跑起来。
可以把训练大模型想象成一群厨师(GPU)合力做一桌满汉全席(一个大模型)。最朴素的”数据并行”做法是:每个厨师都备齐全套食材(完整模型副本),各做一桌相同的菜,最后互相核对账本(梯度 AllReduce 同步)。问题是——食材(参数、梯度、优化器状态)太多,单个厨师的灶台(显存)根本摆不下。
ZeRO(Zero Redundancy Optimizer,零冗余优化器)和 FSDP 的思路是:凭什么每个厨师都要备齐全套食材? 把调料(优化器状态)、半成品(梯度)、甚至主料(参数)分给不同厨师保管,谁需要谁再去借(All-Gather 聚合)。这样每个人灶台上只放一小部分,整体就能放下远超单卡容量的模型。
换一个更”计算机”的角度来理解:纯数据并行是一种”复制冗余换通信简单”的策略——每个 GPU 持有完整模型副本,所以反向传播后只需一次 AllReduce 即可对齐梯度。代价是 张卡上存了 份一模一样的模型,冗余系数为 。ZeRO 的本质就是把这份冗余系数从 压到 ,把”存的冗余”换成”通信的次数”。用存储换通信、用带宽换容量,这就是所有分片方案的底层逻辑。
分布式训练的显存瓶颈
Section titled “分布式训练的显存瓶颈”在纯数据并行(Data Parallelism, DP,每张 GPU 持有完整模型副本、处理不同数据、反向传播后用 AllReduce 同步梯度的并行范式)中,每个 GPU 都持有完整的模型副本,各自处理不同的数据批次,反向传播后用 AllReduce(一种集合通信原语,把所有 GPU 上的张量逐元素求和后广播回每个 GPU)同步梯度。显存占用主要来自三部分:
- 模型参数(Parameters, ):以 fp16(半精度浮点数,16 位 = 2 字节)训练 10B 参数模型约需 20 GB。
- 梯度(Gradients, ):与参数同形状,fp16 同样约 20 GB。
- 优化器状态(Optimizer States):Adam(自适应矩估计优化器,为每个参数维护独立的动量和方差)需要为每个参数维护动量(momentum,历史梯度的指数滑动平均)和方差(variance,历史梯度平方的指数滑动平均),通常以 fp32(单精度浮点数,32 位 = 4 字节)存储。
逐步推导:10B 模型到底要多少显存?
Section titled “逐步推导:10B 模型到底要多少显存?”设模型参数量为 (10B),采用混合精度训练(Mixed Precision,前向/反向用 fp16,主权重和优化器状态用 fp32)。逐项计算:
这就是 ZeRO 原论文里著名的 “12 × Psi 字节” 经验公式(fp32 主权重 + 动量 + 方差各 4 字节 = 12 字节/参数,再叠加 fp16 的参数与梯度各 2 字节):
- = 优化器状态份数(Adam 的 :动量 + 方差,加上 fp32 主权重)
A100 是 80 GB,H100 是 80 GB,单卡 160 GB 显然放不下——这就是大模型训练的核心瓶颈。值得注意的是,优化器状态(120 GB)占了总显存的 75%,但它本身不参与前向/反向计算,纯粹是”记账用的”。ZeRO 的突破口正在于此。
ZeRO 三阶段分片
Section titled “ZeRO 三阶段分片”DeepSpeed 提出的 ZeRO(Zero Redundancy Optimizer)按阶段逐步消除冗余。三阶段的本质是把上面那 160 GB 里”冗余存储”的部分逐一切片。
ZeRO-1:优化器状态分片(Pos)
Section titled “ZeRO-1:优化器状态分片(Pos)”把 Adam 的动量 、方差 和 fp32 主权重按 GPU 切成 份,每个 GPU 只保存 。
更新流程也相应改变:
Step 1: 各 GPU 用 AllReduce 把 fp16 梯度同步为完整梯度 ∇L(通信量 ≈ 2×Psi 字节)Step 2: 每个 GPU 只更新自己负责的 1/N 段参数: theta_shard -= lr × m_shard / (sqrt(v_shard) + eps)Step 3: All-Gather 把更新后的参数段广播给所有 GPU(通信量 ≈ 2×Psi 字节)总通信量与纯 DP 相同(一次 AllReduce + 一次 All-Gather 的数据量与一次 AllReduce 在同一量级),但显存从 160 GB 降到约 20 + 20 + 15 = 55 GB。
ZeRO-2:加梯度分片(Pos+g)
Section titled “ZeRO-2:加梯度分片(Pos+g)”在 ZeRO-1 基础上,反向传播产生的梯度也不完整保存,而是用 Reduce-Scatter(先对梯度求和再切片分发,每个 GPU 只拿到自己负责参数段的聚合梯度)替代 AllReduce:
反向传播到第 i 层时: Step 1: 计算第 i 层梯度 grad_i(每卡都有自己的 grad_i) Step 2: Reduce-Scatter: 对所有 GPU 的 grad_i 求和并切片 → 每个 GPU 只保留自己负责的那 1/N 段(其余立即释放) Step 3: 后续层用"不完整"的参数也能正常算(ZeRO-3 才需要参数分片)梯度显存从 降到 :
通信量与纯数据并行完全相当(Reduce-Scatter + All-Gather 的总数据量 = AllReduce 的数据量),是性价比最高的一档。
ZeRO-3:加参数分片(Pos+g+p)
Section titled “ZeRO-3:加参数分片(Pos+g+p)”连模型参数本身也分片。前向和反向传播过程中,按需通过 All-Gather 动态聚合当前层所需的完整参数,算完立即释放(unmaterialize)。这是最省显存的方案。
层前向计算:  Step 1: All-Gather 当前层的完整参数 W_layer(通信量 ≈ 该层参数大小)  Step 2: forward: y = f(x, W_layer)  Step 3: 立即释放 W_layer,只保留分片 W_layer_shard
层反向计算:  Step 1: All-Gather 重新获取 W_layer  Step 2: backward: 计算 ∂L/∂W_layer 和 ∂L/∂x  Step 3: Reduce-Scatter 把 ∂L/∂W_layer 分片并丢弃完整版本  Step 4: 释放 W_layer
参数显存从 降到 :
代价是通信量最大(约比 ZeRO-2 多 50% 左右),因为每层前向/反向都要 All-Gather 参数。
直觉上,ZeRO 的三个阶段是在”显存”和”通信”之间做权衡:分片越彻底,显存越省,但 All-Gather 次数越多。下图是三阶段显存与通信量的对比:
ZeRO-3 的数学总结
Section titled “ZeRO-3 的数学总结”把三阶段合起来,ZeRO 单卡显存可写成统一公式:
当 时,ZeRO-3 的单卡显存趋近于 0(理论上),这就是 ZeRO 论文标题”Training Trillion Parameter Models”的底气。
ZeRO 三阶段显存对比可视化
Section titled “ZeRO 三阶段显存对比可视化”下面的柱状图直观展示了在 8 张 GPU 上训练 10B 参数模型时,ZeRO 各阶段的单卡显存构成与总量变化——优化器状态从 120 GB 压到 15 GB 是最大的收益来源。
# ZeRO 三阶段显存对比(10B 模型, 8 GPUs, fp16)import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
stages = ["Pure DP", "ZeRO-1", "ZeRO-2", "ZeRO-3"]params    = [20, 20, 20, 2.5]    # fp16 模型参数grads     = [20, 20, 2.5, 2.5]   # fp16 梯度optimizer = [120, 15, 15, 15]    # fp32 优化器状态totals = [p + g + o for p, g, o in zip(params, grads, optimizer)]
x = np.arange(len(stages))fig, ax = plt.subplots(figsize=(9, 5.5))fig.patch.set_facecolor("white")
c = ["#42A5F5", "#FFA726", "#EF5350"]b1 = ax.bar(x, params, 0.55, label="Parameters (fp16)", color=c[0], alpha=0.9)b2 = ax.bar(x, grads, 0.55, bottom=params, label="Gradients (fp16)", color=c[1], alpha=0.9)b3 = ax.bar(x, optimizer, 0.55,            bottom=[p + g for p, g in zip(params, grads)],            label="Optimizer States (fp32)", color=c[2], alpha=0.9)
for bars, values in [(b1, params), (b2, grads), (b3, optimizer)]:    for bar, val in zip(bars, values):        if val >= 5:            ax.text(bar.get_x() + bar.get_width() / 2, bar.get_y() + val / 2,                    f"{val}", ha="center", va="center", fontsize=8,                    fontweight="bold", color="white")
for i, total in enumerate(totals):    ax.annotate(f"{total} GB", xy=(x[i], total), xytext=(0, 4),                textcoords="offset points", ha="center", va="bottom",                fontsize=10, fontweight="bold")
ax.set_xlabel("Parallelism Strategy", fontsize=12)ax.set_ylabel("Per-GPU Memory (GB)", fontsize=12)ax.set_title("ZeRO Stage Memory Comparison (10B Model, 8 GPUs, fp16)",             fontsize=12, fontweight="bold")ax.set_xticks(x)ax.set_xticklabels(stages, fontsize=11)ax.legend(fontsize=10, loc="upper right")ax.grid(axis="y", alpha=0.3)ax.spines["top"].set_visible(False)ax.spines["right"].set_visible(False)ax.axhline(y=80, color="#9E9E9E", linestyle=":", linewidth=1, alpha=0.7)ax.text(3.35, 82, "A100 80GB", fontsize=8, color="#9E9E9E", va="bottom")
fig.tight_layout()fig.savefig("deepspeed-zero-memory.png", dpi=180, bbox_inches="tight", facecolor="white")plt.close()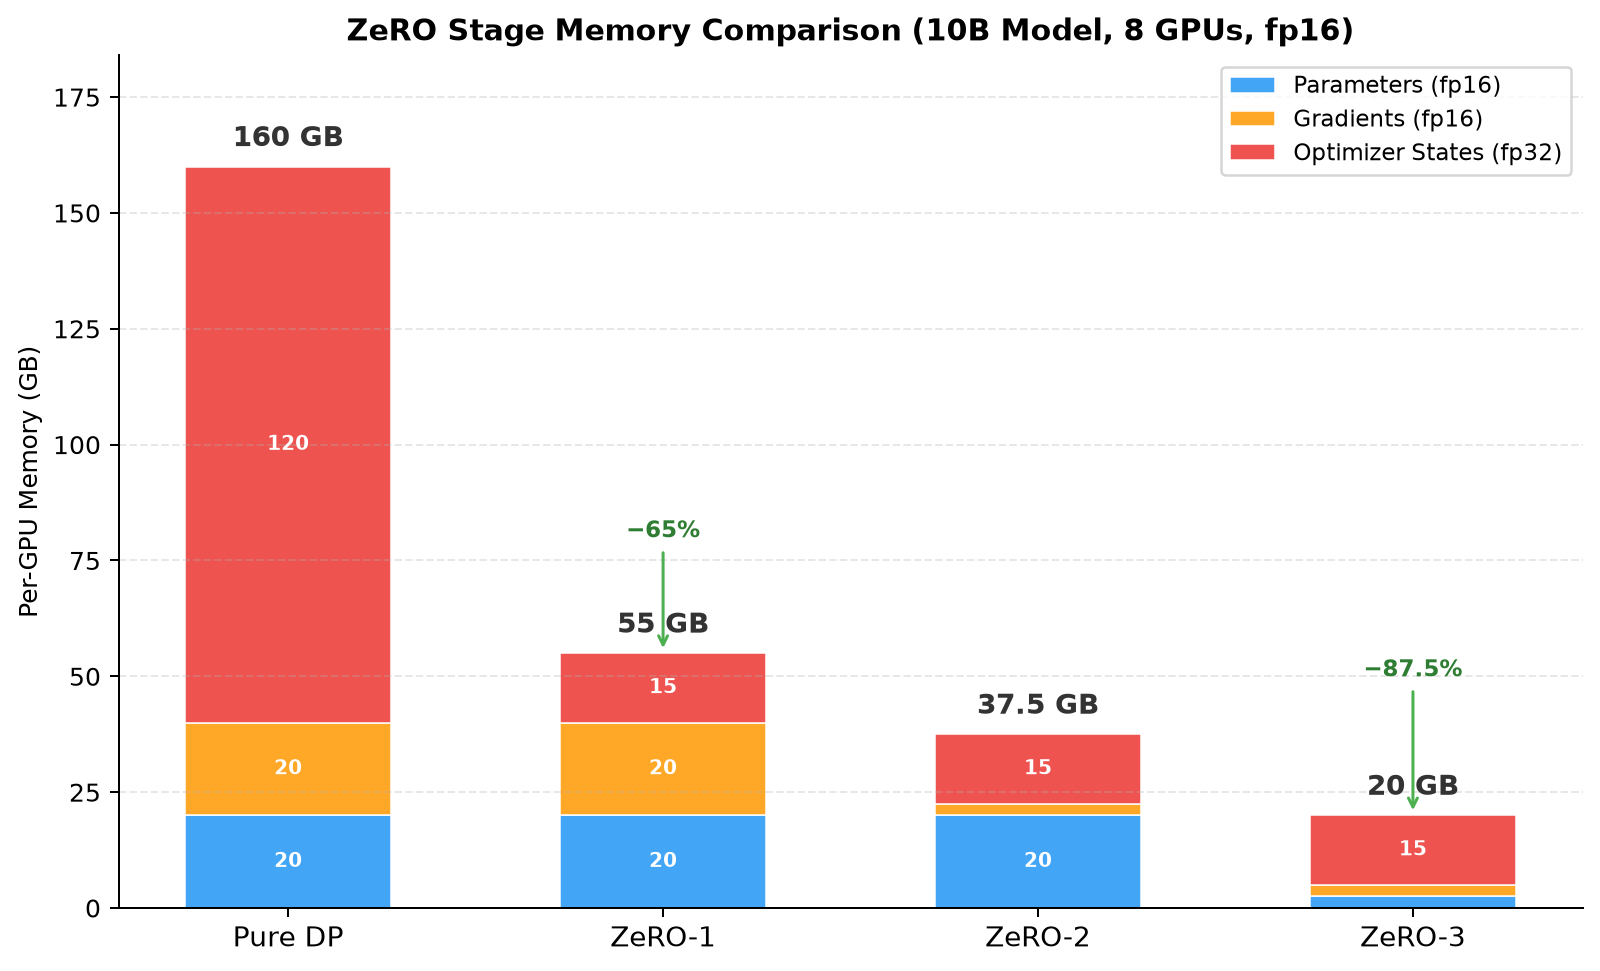
ZeRO 三阶段显存对比可视化
Section titled “ZeRO 三阶段显存对比可视化”下图以 10B 参数模型在 8 张 GPU 上训练为例,直观展示了 ZeRO 各阶段对每卡显存的分摊效果:
import matplotlibmatplotlib.use("Agg")
import matplotlib.pyplot as pltimport numpy as np
np.random.seed(42)
stages = ["Pure DP", "ZeRO-1", "ZeRO-2", "ZeRO-3"]params = [20, 20, 20, 2.5]grads = [20, 20, 2.5, 2.5]optim = [120, 15, 15, 15]
x = np.arange(len(stages))width = 0.55
fig, ax = plt.subplots(figsize=(9, 5.5))
# Stacked barsb1 = ax.bar(x, params, width, label="Parameters (fp16)", color="#42A5F5", edgecolor="white", linewidth=0.6)b2 = ax.bar(x, grads, width, bottom=params, label="Gradients (fp16)", color="#FFA726", edgecolor="white", linewidth=0.6)bottom_2 = np.array(params) + np.array(grads)b3 = ax.bar(x, optim, width, bottom=bottom_2, label="Optimizer States (fp32)", color="#EF5350", edgecolor="white", linewidth=0.6)
# Total labels on toptotals = np.array(params) + np.array(grads) + np.array(optim)for i, total in enumerate(totals):    ax.text(        i, total + 3,        f"{total:g} GB",        ha="center", va="bottom",        fontsize=11, fontweight="bold", color="#333",    )
# Segment labels inside bars (for segments large enough)for bars, vals, bottoms in [    (b1, params, [0] * 4),    (b2, grads, params),    (b3, optim, list(bottom_2)),]:    for bar, val, bot in zip(bars, vals, bottoms):        if val >= 5:            ax.text(                bar.get_x() + bar.get_width() / 2,                bot + val / 2,                f"{val:g}",                ha="center", va="center",                fontsize=8, color="white", fontweight="bold",            )
ax.set_xticks(x)ax.set_xticklabels(stages, fontsize=11)ax.set_ylabel("Per-GPU Memory (GB)", fontsize=10)ax.set_title("ZeRO Stage Memory Comparison (10B Model, 8 GPUs, fp16)", fontsize=12, fontweight="bold")ax.set_ylim(0, max(totals) * 1.15)ax.spines["top"].set_visible(False)ax.spines["right"].set_visible(False)ax.grid(axis="y", linestyle="--", alpha=0.3)ax.legend(loc="upper right", fontsize=9)
# Memory savings annotationsax.annotate(    "−65%", xy=(1, 55), xytext=(1, 80),    ha="center", fontsize=9, color="#2E7D32", fontweight="bold",    arrowprops=dict(arrowstyle="->", color="#4CAF50", lw=1.2),)ax.annotate(    "−87.5%", xy=(3, 20), xytext=(3, 50),    ha="center", fontsize=9, color="#2E7D32", fontweight="bold",    arrowprops=dict(arrowstyle="->", color="#4CAF50", lw=1.2),)
plt.tight_layout()plt.savefig(    "static/img/generated/deepspeed-zero-memory.png",    dpi=180,    bbox_inches="tight",    facecolor="white",)plt.close()
ZeRO-Offload:借 CPU 当仓库
Section titled “ZeRO-Offload:借 CPU 当仓库”当 GPU 显存仍不够时,ZeRO-Offload 把优化器状态(甚至部分参数)卸载到 CPU 内存,借助 PCIe(一种高速串行总线,CPU-GPU 间典型带宽 3264 GB/s)或 NVLink(NVIDIA 的高速 GPU 互连,带宽可达 300900 GB/s)在 CPU 和 GPU 之间搬运。
核心思路是利用一个观察:Adam 的参数更新是逐元素(element-wise)的,与 GPU 的矩阵运算(GEMM)优势无关,放 CPU 上算几乎不影响速度:
每个元素独立运算,无需矩阵乘法,CPU 完全胜任。这样 GPU 只管前向/反向(矩阵乘法密集),CPU 管优化器更新,两者重叠执行,PCIe 传输可以与 GPU 计算重叠隐藏掉。
进一步还有 ZeRO-Infinity,扩展到 NVMe SSD(非易失性固态硬盘,带宽约 3~7 GB/s),把参数、梯度、优化器状态、激活值全部可卸载到四级存储层级:GPU 显存 → GPU HBM → CPU 内存 → NVMe。
PyTorch FSDP:原生 ZeRO-3 等价方案
Section titled “PyTorch FSDP:原生 ZeRO-3 等价方案”PyTorch 官方推出的 FSDP(Fully Sharded Data Parallel,全分片数据并行) 在思想上等价于 ZeRO-3:参数、梯度、优化器状态全部分片。它使用 FlatParameter(把多个参数张量扁平化为一维连续缓冲区的技术)把多个参数张量拼成一维连续缓冲区,减少内核 launch(GPU 核函数启动开销,每次约 5~10 微秒)开销并提升通信效率。前向时 All-Gather 拼回完整参数,反向时再次 All-Gather 参数并执行 Reduce-Scatter 同步梯度。
FSDP 与 ZeRO-3 的关键区别在工程层面:
| 维度 | DeepSpeed ZeRO-3 | PyTorch FSDP |
|---|---|---|
| 实现语言 | C++/CUDA + Python 封装 | 纯 Python(基于 torch.distributed) |
| 参数管理 | 按参数列表管理 | 扁平化为 FlatParameter 一维缓冲区 |
| CPU Offload | 原生支持(ZeRO-Offload) | 原生支持(CPUOffload) |
| 混合精度 | 配置文件控制 | MixedPrecision policy 对象 |
| 与 torch.compile | 需适配 | 原生集成(PyTorch 2.0+) |
| 调试体验 | 黑盒较多 | 断点/堆栈友好,PyTorch 原生 |
FSDP 的优势在于它是 PyTorch 原生实现,与 torch.distributed、AMP(Automatic Mixed Precision,自动混合精度)、TensorBoard 等生态深度集成,配置简单,调试友好;DeepSpeed 的优势在于功能更全(Offload、3D 并行、调度器等)。
FSDP 的分片粒度与 FlatParameter
Section titled “FSDP 的分片粒度与 FlatParameter”FSDP 的一个核心优化是 FlatParameter。假设一个 Transformer block 有 100 个参数张量,朴素做法是每层参数单独做 All-Gather/Reduce-Scatter,共 100 次集合通信。FlatParameter 把这 100 个张量的数据区拼接成一个大的 1D 数组,只需一次 All-Gather 就把整组的参数全部拉回来:
# 概念示意(非真实 API)# 原始参数列表params = [W_q, b_q, W_k, b_k, W_v, b_v, W_o, b_o, ...]  # 100 个张量
# FSDP 扁平化后flat_param = torch.cat([p.view(-1) for p in params])  # 一维连续缓冲区# 分片:每张 GPU 只持有 flat_param 的 1/Nshard = flat_param.chunk(world_size)[rank]
# 前向时:一次 All-Gather 恢复完整 flat_param,再 unflatten 还原为各参数张量full_param = all_gather(shard)              # 单次大通信unflattened = unflatten(full_param, params)  # 还原为 W_q, b_q, ...
这样集合通信从”小而多”变成”大而少”,对带宽利用率更友好。
3D 并行:数据 + 流水线 + 张量
Section titled “3D 并行:数据 + 流水线 + 张量”当模型大到单卡连 ZeRO-3 都装不下时,需要把”切分”做到极致,这就是3D 并行——把三种正交的并行维度叠加。
- 数据并行(DP):同一模型副本处理不同数据,ZeRO/FSDP 在此维度分片。
- 流水线并行(Pipeline Parallelism, PP,按层把模型切到不同 GPU 上、微批次像流水线一样依次通过的并行方式):把模型按层切分,不同层放在不同 GPU 上,微批次像流水线一样流过。代表实现如 PipeDream、Megatron 的 interleaved schedule(交错调度,把流水线阶段进一步细分为多个虚拟阶段,减少 bubble)。
- 张量并行(Tensor Parallelism, TP,在单层内部把矩阵乘法切分到多 GPU 的并行方式):在单层内部把矩阵乘法切分到多 GPU。Megatron-LM(NVIDIA 开源的大模型并行训练框架)给出了经典做法:
- 对线性层
Y = XA,把权重矩阵 A 按列切分,各 GPU 算部分结果后 All-Gather 拼接(Column Parallel,列并行)。 - 或按行切分,各 GPU 算部分结果后 All-Reduce 求和(Row Parallel,行并行)。
- Transformer 的注意力 QKV 用列并行、输出投影用行并行,二者串联后只需一次 All-Reduce,通信开销最优。
- 对线性层
张量并行的数学推导
Section titled “张量并行的数学推导”以 Y = XA(输入 X 形状为 b×d,权重 A 形状为 d×h)为例,N 路张量并行:
列并行(Column Parallel): 把 A 按列切成 A = [A_1 | A_2 | ... | A_N],每块 A_i 形状为 d×(h/N):
行并行(Row Parallel): 把 A 按行切,同时 X 按列切,X = [X_1, X_2, ..., X_N],A = [A_1; A_2; ...; A_N]^T,A_i 形状为 (d/N)×h:
Megatron-LM 的巧妙之处在于:把注意力的 QKV 投影用列并行、输出投影用行并行,前者输出直接作为后者输入,中间无需任何通信,整组只在前者输入前和后者输出后各做一次集合通信:
Attention 前向(TP,N 路): 输入 X ──(列并行)──> [Q_i, K_i, V_i] ──> Attention_i ──(行并行)──> Y_i 无通信 | All-Reduce: Y = ΣY_i三者组合后,例如 DP=64、TP=8、PP=4 共 2048 张卡训练,是 GPT-3、LLaMA 等大模型的标准训练拓扑。
ZeRO++:量化通信压缩
Section titled “ZeRO++:量化通信压缩”ZeRO++(2023)在 ZeRO-3 基础上引入量化通信(Quantized Communication,用低精度整数表示浮点数以减少传输数据量的技术),把 All-Gather 和 Reduce-Scatter 的通信量减半甚至更多:
- 对参数分片用 int4/int8 量化后再传输,接收端反量化恢复。
- 对梯度采用特制的量化方案(QG-Specialization),在保持训练精度的前提下压缩 2× 以上。
这使得 ZeRO++ 在低带宽网络(如以太网多机训练)场景下比 ZeRO-3 快 2~3 倍。
下图更细致地展示了 ZeRO 三阶段分别切掉了什么:
下面是一个 PyTorch FSDP 的最小可用示例,展示如何包装一个 Transformer 模型并启动训练:
import torchimport torch.distributed as distfrom torch.distributed.fsdp import FullyShardedDataParallel as FSDPfrom torch.distributed.fsdp import ShardingStrategy, MixedPrecisionfrom transformers import AutoModelForCausalLM
# 1. 初始化分布式进程组(默认使用 nccl 后端)#    NCCL(NVIDIA Collective Communications Library)是 GPU 间集合通信的高性能库dist.init_process_group(backend="nccl")local_rank = int(torch.environ["LOCAL_RANK"])torch.cuda.set_device(local_rank)
# 2. 加载模型(每个进程都加载,FSDP 会自动分片)#    建议:用 device_map="cpu" 先加载到 CPU,再让 FSDP 均匀分片到各 GPU,#    避免每个进程都在自己的 GPU 上加载完整模型导致 OOMmodel = AutoModelForCausalLM.from_pretrained(    "meta-llama/Llama-2-7b-hf", torch_dtype=torch.bfloat16).cuda()
# 3. 混合精度策略:前向用 bf16,梯度汇总用 fp32#    bf16(bfloat16)与 fp16 一样占 2 字节,但指数位更多、动态范围更大,#    不易溢出,A100/H100 上优先使用mp_policy = MixedPrecision(    param_dtype=torch.bfloat16,   # 前向/反向计算精度    reduce_dtype=torch.float32,   # 梯度归约精度(高精度防数值误差)    buffer_dtype=torch.bfloat16,  # BN/缓冲区精度)
# 4. 用 FSDP 包装模型,等价于 ZeRO-3 全分片#    ShardingStrategy:#      FULL_SHARD   → ZeRO-3(参数+梯度+优化器全分片)#      SHARD_GRAD_OP → ZeRO-2(只分片梯度+优化器)#      NO_SHARD      → 纯 DP(不分片)model = FSDP(    model,    sharding_strategy=ShardingStrategy.FULL_SHARD,  # 即 ZeRO-3    mixed_precision=mp_policy,    device_id=local_rank,    # 5.(可选)激活检查点:前向重算换显存,训练慢约 20~30% 但大幅省显存    activation_checkpointing=True,    # 6.(可选)CPU Offload:优化器状态放 CPU,省显存但慢    # cpu_offload=CpuOffload(offload_params=False),  # False=只 offload 优化器)
# 7. 常规训练循环:与单卡写法完全一致#    FSDP 会在 loss.backward() 时自动处理 All-Gather 和 Reduce-Scatteroptimizer = torch.optim.AdamW(model.parameters(), lr=2e-5)for batch in train_loader:    loss = model(batch["input_ids"], labels=batch["labels"]).loss    loss.backward()        # FSDP 自动处理梯度分片同步    optimizer.step()    optimizer.zero_grad()
如果使用 DeepSpeed,则通过 JSON 配置文件指定 ZeRO 阶段,例如启用 ZeRO-2 只需在启动命令加 --deepspeed config.json,配置中写明 "zero_optimization" 下的 "stage": 2 即可,无需改动训练代码。
DeepSpeed ZeRO-3 配置示例
Section titled “DeepSpeed ZeRO-3 配置示例”下面是一个完整的 DeepSpeed ZeRO-3 + CPU Offload 配置文件,带详细注释:
{ "bf16": { "enabled": "auto" }, "zero_optimization": { "stage": 3, "overlap_comm": true, "contiguous_gradients": true, "sub_group_size": 1e9, "reduce_bucket_size": "auto", "stage3_prefetch_bucket_size": "auto", "stage3_param_persistence_threshold": "auto", "stage3_max_live_parameters": 1e9, "stage3_max_reuse_distance": 1e9, "stage3_gather_16bit_weights_on_model_save": true }, "zero3_save_16bit_model": true, "optimizer": { "type": "AdamW", "params": { "lr": "auto", "betas": "auto", "eps": "auto", "weight_decay": "auto" } }, "activation_checkpointing": { "partition_activations": true, "cpu_checkpointing": true, "contiguous_memory_optimization": true }}其中几个关键参数的含义:
overlap_comm:把 All-Gather/Reduce-Scatter 与计算重叠,隐藏通信延迟(类似 CPU 的指令流水线)。reduce_bucket_size:梯度按”桶”聚合后再通信,桶越大通信越少但占用显存越多。stage3_param_persistence_threshold:小于此阈值的参数不分片(小张量分片反而因通信开销得不偿失)。
用 numpy 模拟 ZeRO 分片过程
Section titled “用 numpy 模拟 ZeRO 分片过程”下面用 numpy 直观演示 ZeRO-3 的分片与 All-Gather 过程,帮助理解”分片后如何还原完整参数”:
import numpy as np
# 模拟 4 个 GPU,每个 GPU 持有模型参数的 1/4 分片world_size = 4full_param = np.random.randn(16).astype(np.float32)  # 假设这是一个层的 16 个参数
# ---- ZeRO-3 分片 ----# 每个 GPU 只保存 full_param 的 1/4shards = np.array_split(full_param, world_size)print("GPU 0 的分片:", shards[0])  # 4 个参数print("GPU 1 的分片:", shards[1])# ...
# ---- 模拟前向时的 All-Gather ----# 所有 GPU 把自己的分片发给大家,拼回完整参数gathered = np.concatenate(shards)print("All-Gather 后恢复:", gathered)print("与原始一致:", np.allclose(gathered, full_param))  # True
# ---- 模拟反向时的 Reduce-Scatter ----# 每个 GPU 算出完整梯度后,求和并切片分发grads_from_data = [np.random.randn(16).astype(np.float32) for _ in range(world_size)]# 等价于 4 个 GPU 各自处理不同 batch 算出的梯度summed_grad = sum(grads_from_data)  # AllReduce: 逐元素求和grad_shards = np.array_split(summed_grad, world_size)# Reduce-Scatter: 每个 GPU 只保留自己负责的梯度分片print("GPU 0 拿到的梯度分片:", grad_shards[0])
# ---- Adam 参数更新(逐元素,各 GPU 独立更新自己的分片)----lr, beta1, beta2, eps = 1e-3, 0.9, 0.999, 1e-8m_shard = np.zeros_like(grad_shards[0])v_shard = np.zeros_like(grad_shards[0])param_shard = shards[0].copy()
g = grad_shards[0]m_shard = beta1 * m_shard + (1 - beta1) * g            # 动量更新v_shard = beta2 * v_shard + (1 - beta2) * g ** 2        # 方差更新m_hat = m_shard / (1 - beta1)                            # 偏差修正v_hat = v_shard / (1 - beta2)param_shard -= lr * m_hat / (np.sqrt(v_hat) + eps)       # 参数更新print("更新后的参数分片:", param_shard)
这段代码展示了 ZeRO-3 的核心循环:分片存储 → All-Gather 恢复 → 计算梯度 → Reduce-Scatter 梯度 → 逐元素更新 → 回到分片存储。
- 先选 ZeRO-2 还是 ZeRO-3? 模型能装进显存就尽量用 ZeRO-2,通信开销更小;只有装不下才升级到 ZeRO-3/FSDP。一个实用经验法则:显存够用 ZeRO-2,显存不够先上 ZeRO-3 + 激活检查点,再不够上 CPU Offload。
- 混合精度与 FSDP 配合:
bf16比fp16数值更稳定,A100/H100 上优先用 bf16,配合reduce_dtype=fp32保证梯度归约精度。fp16 需要 loss scaling(损失缩放,放大 loss 以防小梯度变成零)而 bf16 不需要。 - 激活检查点(Activation Checkpointing,又称 Gradient Checkpointing):与 FSDP 叠加可进一步省显存——前向时只保存部分层的激活值,反向时重新计算被丢弃的激活值,用约 30% 的额外计算换大幅显存节省。
- 梯度累积:FSDP 下要做梯度累积(Gradient Accumulation,把大 batch 拆成多个小 micro-batch 累计梯度再更新)时,注意在累积步数内跳过
optimizer.step()和梯度同步,PyTorch 2.0+ 提供了model.no_sync()上下文管理器:
# 梯度累积示例:等效 batch = micro_batch × accumulation_stepsaccumulation_steps = 4optimizer.zero_grad()for i, batch in enumerate(train_loader): # 除最后一步外,跳过梯度同步(no_sync 内不做 Reduce-Scatter) is_last_micro_step = (i + 1) % accumulation_steps == 0 ctx = contextlib.nullcontext() if is_last_micro_step else model.no_sync() with ctx: loss = model(batch["input_ids"], labels=batch["labels"]).loss loss = loss / accumulation_steps # 缩放 loss 以匹配等效 batch loss.backward() if is_last_micro_step: optimizer.step() optimizer.zero_grad()- CPU Offload 慎用:ZeRO-Offload 把优化器状态放 CPU,能救命但显著拖慢训练,仅在显存极限边缘启用。当 PCIe 带宽成为瓶颈时(典型多机场景),Offload 可能比不 Offload 慢 2~3 倍。
- 监控通信开销:ZeRO-3/FSDP 的瓶颈往往在 All-Gather 带宽,多机训练时优先用 InfiniBand/NVLink,避免走以太网。可用
torch.prosumer或 NVIDIA Nsight Systems 分析通信占比。 - 加载大模型检查点:FSDP 训练保存的是分片后的 state dict,恢复时需要用
SHARDED_STATE_DICT格式,避免单卡加载 OOM。DeepSpeed 也提供了stage3_gather_16bit_weights_on_model_save来在保存时汇总完整权重。 - 从 ZeRO-2 迁移到 FSDP:HuggingFace Accelerate 提供了统一接口,切换时只需改一行配置,训练代码几乎不动。
- Microsoft DeepSpeed:BLOOM(176B)、Megatron-DeepSpeed 训练栈,是 ZeRO 系列论文的官方实现。
- PyTorch FSDP:Meta 训练 LLaMA 系列(7B~70B)的核心方案,也是
torchtitan预训练框架的默认并行策略。 - HuggingFace Trainer:内置 DeepSpeed 集成,一行
TrainingArguments(deepspeed=...)即可启用,是开源社区最常用的大模型训练入口。 - Megatron-LM / Megatron-DeepSpeed:NVIDIA 出品的张量并行 + 流水线并行框架,是 3D 并行的工业标杆。
- torchtune / torchtitan:PyTorch 官方轻量化大模型微调与预训练库,原生支持 FSDP 与张量并行。
- HuggingFace Accelerate:统一封装 FSDP、DeepSpeed、DDP,只需配置即可切换后端,大大降低使用门槛。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| DeepSpeed | Python/C++ | 微软出品,ZeRO 系列始祖,支持 Offload、3D 并行、稀疏注意力 |
| PyTorch FSDP | Python/C++ | PyTorch 原生 ZeRO-3 等价方案,与 AMP、CUDA Graph 深度集成 |
| Megatron-LM | Python | NVIDIA 张量并行/流水线并行参考实现,3D 并行基石 |
| HuggingFace Accelerate | Python | 统一封装 FSDP、DeepSpeed、DDP,配置即可切换后端 |
| torchtitan | Python | PyTorch 官方预训练参考库,展示 FSDP + TP 组合最佳实践 |
| Ray Train | Python | 分布式训练调度层,可在多节点上拉起 FSDP/DeepSpeed 进程组 |
最新进展(2025-2026)
Section titled “最新进展(2025-2026)”DeepSpeed 生态进展
Section titled “DeepSpeed 生态进展”DeepSpeed 在 2025-2026 年持续快速迭代,重点方向包括:
- Muon Optimizer 支持(2026/05):Muon(MomentUm + Orthogonalization)是一种新型优化器,通过对梯度矩阵做正交化后再更新,收敛速度显著快于 AdamW。DeepSpeed 率先在分布式训练框架中集成了 Muon,使得大模型预训练的 token 吞吐量提升。
- SDMA for ZeRO-3 Offload(2026/05):针对 AMD GPU(ROCm 平台)优化的 ZeRO-3 Offload 集合通信原语,缩小了 AMD 与 NVIDIA 在大模型训练通信效率上的差距。
- DeepSpeed Core API 更新(2025/12):引入了 PyTorch 风格的 backward 接口和低精度主权重(low-precision master states),把 fp32 主权重压缩为 fp16/bf16 甚至 int8,进一步减少优化器状态显存。配合
torch.compile可端到端编译训练图。 - SuperOffload(ASPLOS 2026):面向超级芯片(如 NVIDIA Grace Hopper、AMD MI300)的大规模 LLM 训练卸载引擎,利用芯片内 CPU-GPU 统一内存架构,实现近乎零开销的参数卸载。
- ZenFlow(2025/08):无停顿(stall-free)卸载引擎,通过异步更新(asynchronous updates)把 CPU/SSD 与 GPU 之间的数据搬运完全隐藏在计算背后,消除了传统 Offload 的等待。
- Arctic Long Sequence Training / ALST(2025/06):支持数百万 token 级别超长序列训练,突破了传统 Attention 对序列长度的限制,适用于整本书级别的上下文训练。
- DeepCompile(2025/04):引入编译器级别的分布式训练调度优化,自动分析计算图并生成最优的通信-计算重叠方案,减少手调并行策略的工作量。
PyTorch 生态进展
Section titled “PyTorch 生态进展”- FlexAttention(PyTorch 2.5,原型):灵活的注意力 API,用户用几行代码描述任意 Attention 变体(如 Sliding Window、ALiBi、Document Mask),底层自动编译为融合的 FlashAttention 核函数,无需手写 CUDA。
- cuDNN SDPA 后端:PyTorch 的
scaled_dot_product_attention接入 cuDNN 后端后,在 H100 上实测速度提升约 75%,使得 ZeRO/FSDP 训练的注意力层不再是瓶颈。 - Compiled Autograd 与 Regional Compilation:PyTorch 2.5+ 引入了编译后自动微分和区域编译,允许只编译模型的一部分(如跳过 FSDP 包装层),缓解了
torch.compile与 FSDP 交互时的重编译问题。 - torchtitan 持续演进:PyTorch 官方预训练参考框架,现已支持 FSDP + TP 组合、异步 tensor parallel,是学习 3D 并行最佳实践的首选代码库。
- PyTorch Monarch(2026):单控制器(single-controller)分布式训练编程模型,让用户像写单进程代码一样编排多 GPU,正扩展到 AMD GPU(ROCm)。
通信与精度优化
Section titled “通信与精度优化”- ZeRO++ 量化通信:ZeRO++ 论文(2023)提出的量化通信方案在 2025-2026 年被广泛集成到主流框架中,低带宽多机训练受益显著。
- HuggingFace Accelerate:持续简化 FSDP/DeepSpeed 的使用,新增了一键式配置向导和自动 ZeRO 阶段推荐。
- FP8 训练成熟:Meta 在 Llama 3 训练中使用了 FP8,NVIDIA H100/B200 对 FP8 有原生硬件支持,DeepSpeed 也在 2025/12 加入低精度主权重支持,ZeRO + FP8 的组合正成为下一代训练标配。
行业趋势总结
Section titled “行业趋势总结”2025-2026 年的核心趋势可以归纳为三条线:
- 通信最小化:从 ZeRO 到 ZeRO++ 到 DeepCompile,不断用编译器思维和量化技术压缩通信量。
- 存储层级下沉:从 GPU 显存 → CPU 内存 → NVMe SSD,SuperOffload 和 ZenFlow 让卸载几乎”免费”。
- 精度下沉:从 fp32 → fp16/bf16 → fp8 → fp4,低精度训练正从研究走向生产。
| 术语 | 英文 | 解释 |
|---|---|---|
| 数据并行 | Data Parallelism (DP) | 每张 GPU 持有完整模型副本,处理不同数据,梯度 AllReduce 同步 |
| 零冗余优化器 | ZeRO (Zero Redundancy Optimizer) | DeepSpeed 提出的渐进式分片方案,分三阶段消除冗余 |
| 优化器状态分片 | Optimizer State Partitioning (Pos) | ZeRO-1,把 Adam 动量与方差切片到各 GPU |
| 全分片数据并行 | Fully Sharded Data Parallel (FSDP) | PyTorch 原生的 ZeRO-3 等价实现 |
| 全收集 | All-Gather | 把各 GPU 上的分片聚合为完整张量,ZeRO-3 前向反向时频繁调用 |
| 减少分散 | Reduce-Scatter | 先 AllReduce 求和再切片分发,ZeRO-2 同步梯度的核心算子 |
| 流水线并行 | Pipeline Parallelism (PP) | 按层把模型切到不同 GPU,微批次流水通过 |
| 张量并行 | Tensor Parallelism (TP) | 单层内矩阵乘法按列或行切分到多 GPU,Megatron-LM 的核心 |
| 卸载 | Offload | 把优化器状态或参数搬到 CPU 内存甚至 NVMe,缓解显存压力 |
| 扁平参数 | FlatParameter | FSDP 把多个参数张量拼成一维连续缓冲区,降低内核开销 |
| 激活检查点 | Activation Checkpointing | 前向只存部分激活值,反向时重算,用计算换显存 |
| 混合精度 | Mixed Precision (AMP) | 前向用 fp16/bf16 计算,主权重用 fp32,兼顾速度与精度 |
| 量化通信 | Quantized Communication | 用低精度整数传输浮点数,减少通信带宽需求(ZeRO++) |
| 梯度累积 | Gradient Accumulation | 把大 batch 拆成多个小 micro-batch 累计梯度再更新 |
| 损失缩放 | Loss Scaling | fp16 训练时放大 loss 防止小梯度下溢为零的技术 |
- 论文:Smith 等,《DeepSpeed: Extreme-scale training for everyone》(2021),以及 Rajbhandari 等,《ZeRO: Memory Optimizations Toward Training Trillion Parameter Models》(NeurIPS 2020)。
- 论文:Xu 等,《PyTorch FSDP: Experiences on Scaling Fully Sharded Data Parallel》(VLDB 2023)。
- 论文:Shoeybi 等,《Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism》(2019),张量并行奠基之作。
- 论文:Rajbhandari 等,《ZeRO-Offload: Democratizing Billion-Scale Model Training》(USENIX ATC 2021),CPU Offload 的系统性论述。
- 论文:Wang 等,《ZeRO++: A Lightweight and Efficient Zero Redundancy Optimizer for Large Model Training》(2023),量化通信压缩。
- 论文:Ren 等,《SuperOffload: Unleashing Large-Scale LLM Training on Superchips》(ASPLOS 2026),超级芯片卸载引擎。
- 论文:DeepSpeed 团队,《ZenFlow: Stall-Free Offloading for LLM Training》(2025),无停顿卸载。
- 论文:DeepSpeed 团队,《DeepCompile: Compiler Optimization for Distributed Training》(2025),编译器级训练调度。
- 论文:DeepSpeed 团队,《Arctic Long Sequence Training (ALST)》(2025),超长序列训练。
- 项目:torchtitan(PyTorch 官方预训练参考库)https://github.com/pytorch/torchtitan ,展示 FSDP + TP + PP 最佳实践。
- 项目:HuggingFace Accelerate https://huggingface.co/docs/accelerate ,统一封装 FSDP/DeepSpeed/DDP。
- 官方文档:DeepSpeed 文档站 https://www.deepspeed.ai ,PyTorch FSDP 教程 https://pytorch.org/tutorials/intermediate/FSDP_tutorial.html 。
- 相关章节:分布式训练基础、混合精度训练、梯度下降、PyTorch 入门指南、预训练架构、语言模型演进、Transformer。