
EM算法与变分推断
EM 算法是含隐变量的概率模型的核心推断方法,而变分推断则把它推广到大规模、复杂概率模型的近似推断。本页从高斯混合模型出发,讲透 EM 三步循环,再延伸到变分推断 ELBO 与 LDA、VAE 的联系,最后覆盖 2025-2026 年的前沿进展。前置阅读:数值优化与数学基础、概率图模型与半监督。
想象你在两个城市之间调查居民收入分布,但数据里没有标注每个人属于哪个城市——这就是”含隐变量”(latent variable,即不可直接观测的隐藏因素)。你手上有观测到的收入数据(),但没有每个人的城市标签(隐变量 )。怎么估计两个城市的收入分布参数?
- E 步(Expectation,期望)= 猜标签。用当前参数估计,算出每个人属于每个城市的概率(“软标签”,soft label——不是非此即彼的 0/1,而是一个概率值)。比如这个人月入 2 万,更可能属于城市 A(概率 0.8)而非城市 B(概率 0.2)。
- M 步(Maximization,最大化)= 更新参数。拿着这些软标签重新计算两个城市的均值和方差——就像加权平均,权重就是上一步的概率。
- 循环= 猜完标签就更新参数,更新完参数再重新猜标签,如此反复,直到收敛(converge,即参数不再显著变化)。
类比:你在黑暗中拼拼图,先根据已有拼好的部分猜剩余碎片的大致位置(E 步),再根据猜出的位置调整整体画面(M 步),越拼越准。
**变分推断(Variational Inference, VI)**则是当模型太复杂、E 步算不出来时的替代策略:不再精确计算隐变量的分布,而是用一个简单的分布(如高斯)去”逼近”(approximate)真实的后验分布(posterior,即给定观测后隐变量的条件概率分布),把推断问题转化成优化问题。
为什么需要 EM?一个具体的动机
Section titled “为什么需要 EM?一个具体的动机”假设你有一组一维数据,看起来有两个峰(双峰分布),你想用两个高斯分布的混合来建模。你知道模型的形式是:
其中 是混合权重。如果直接用 Gradient Descent 最大化对数似然 ,你需要同时优化 5 个参数(),且对数里面有求和,梯度表达式很复杂。更关键的是,你不知道每个数据点属于哪个高斯分量——这个”归属”信息如果已知,参数估计就是简单的加权统计。
EM 的巧妙之处在于:把一个困难的优化问题,拆成两个简单的子问题交替求解。这和坐标下降(coordinate descent)的思想类似——一次只优化一部分变量,交替进行。
从对数似然到 ELBO:完整推导
Section titled “从对数似然到 ELBO:完整推导”设观测变量 ,隐变量 ,模型参数 。目标是最大化对数似然(log-likelihood,衡量模型对观测数据的拟合程度):
由于 里面有对 的求和(边缘化,marginalization,即把隐变量所有可能的取值加起来),直接优化通常很困难。EM 的关键操作是引入任意分布 ,将上式恒等变形:
这一步什么都没改变——乘以 ,再利用 (因为 是概率分布)。但现在可以利用 Jensen 不等式了。
Jensen 不等式:关键工具
Section titled “Jensen 不等式:关键工具”Jensen 不等式说:对于凹函数(concave function,如 ),有 。因为 是凹函数,所以方向反过来:
直观理解 Jensen 不等式:想象你有一个凸函数 (如 ),在两点 的中点处,函数值 一定小于等于函数值的平均 。对于凹函数(如 ),方向相反。
右边就是证据下界(Evidence Lower Bound, ELBO):
展开后可以写成更直观的形式:
或者用 KL 散度(Kullback-Leibler divergence,衡量两个分布差异的非对称度量,值越小越相似)来分解:
由于 ,ELBO 确实是对数似然的下界。等号成立当且仅当 ,即 恰好是真实后验。
EM 的两步:让下界变紧,再让它变大
Section titled “EM 的两步:让下界变紧,再让它变大”E 步(固定 ,优化 ):让 ,此时 ,ELBO 等于 ,下界变紧。这一步是在”填平”对数似然和下界之间的差距。
M 步(固定 ,优化 ):在新的 下,最大化 ELBO 等价于最大化完整数据对数似然的期望:
这一步会提高 ELBO。由于 E 步已经让 ELBO ,而 M 步让 ELBO 变大,所以新的 。
一句话总结:E 步让下界变紧(贴近真实对数似然),M 步推高下界(改善模型)。两者交替,对数似然单调不减。
EM 算法最重要的理论性质是:每一步迭代都保证对数似然单调不减,即 。
证明思路很简单:
- E 步后,(下界变紧)。
- M 步找到 使得 。
- 又因为 (ELBO 总是下界),所以 。
但注意:EM 只保证收敛到局部最优(local optimum),不一定是全局最优。在高维空间中,局部最优的个数可能随维度指数增长。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
np.random.seed(42)# Generate 1D GMM data: two clustersX = np.concatenate([np.random.randn(300) * 1.0 - 3, np.random.randn(300) * 0.5 + 3])
# EM for 1D two-Gaussian mixturemu1, mu2 = X.min(), X.max()var1, var2 = X.var(), X.var()pi1 = 0.5log_likelihoods, mus1, mus2 = [], [mu1], [mu2]
for iteration in range(50):    # E-step    log_r1 = np.log(pi1) - 0.5 * np.log(2 * np.pi * var1) - (X - mu1)**2 / (2 * var1)    log_r2 = np.log(1 - pi1) - 0.5 * np.log(2 * np.pi * var2) - (X - mu2)**2 / (2 * var2)    log_norm = np.logaddexp(log_r1, log_r2)    gamma1 = np.exp(log_r1 - log_norm)    # M-step    N1 = gamma1.sum()    mu1 = (gamma1 * X).sum() / N1    mu2 = ((1 - gamma1) * X).sum() / (len(X) - N1)    var1 = (gamma1 * (X - mu1)**2).sum() / N1    var2 = ((1 - gamma1) * (X - mu2)**2).sum() / (len(X) - N1)    pi1 = N1 / len(X)    ll = log_norm.sum()    log_likelihoods.append(ll); mus1.append(mu1); mus2.append(mu2)    if iteration > 0 and abs(log_likelihoods[-1] - log_likelihoods[-2]) < 1e-6:        break
iters = np.arange(1, len(log_likelihoods) + 1)fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5))fig.patch.set_facecolor("white")
ax1.plot(iters, log_likelihoods, "o-", color="#2196F3", linewidth=2.5, markersize=6)ax1.set_xlabel("EM Iteration", fontweight="bold"); ax1.set_ylabel("Log-Likelihood", fontweight="bold")ax1.set_title("EM Convergence: Log-Likelihood (GMM)", fontweight="bold")ax1.grid(True, alpha=0.2, linestyle="--")
ax2.plot(range(len(mus1)), mus1, "o-", color="#e91e63", linewidth=2, markersize=5, label="mu_1")ax2.plot(range(len(mus2)), mus2, "s-", color="#FF9800", linewidth=2, markersize=5, label="mu_2")ax2.axhline(y=-3, color="#e91e63", linestyle="--", alpha=0.3)ax2.axhline(y=3, color="#FF9800", linestyle="--", alpha=0.3)ax2.set_xlabel("EM Iteration", fontweight="bold"); ax2.set_ylabel("Estimated Mean", fontweight="bold")ax2.set_title("Parameter Convergence: Cluster Means", fontweight="bold")ax2.legend(); ax2.grid(True, alpha=0.2, linestyle="--")
plt.tight_layout()plt.savefig("/mnt/kvm_ata-Netac_SSD_480GB_AA000000000000000904-part1/proj/docs/img/generated/em-convergence-curve.png",            dpi=180, bbox_inches="tight", facecolor="white")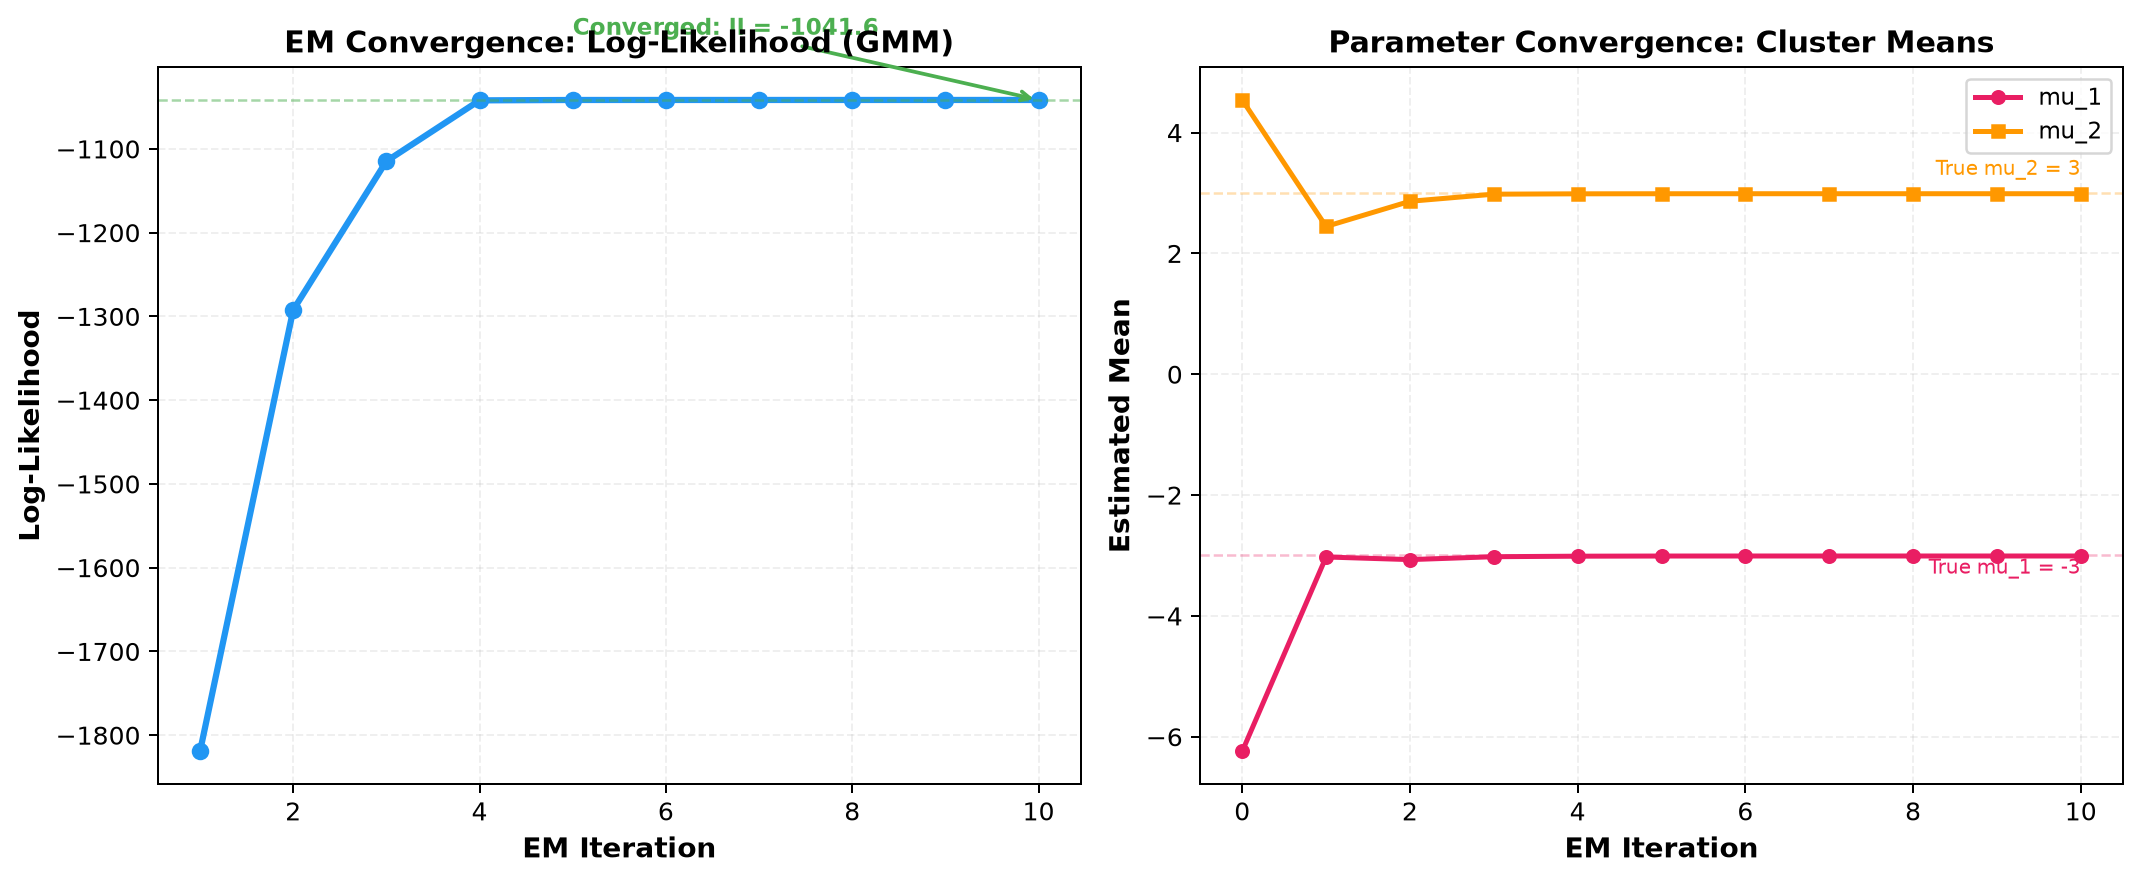
EM 的最大化-最大化视角
Section titled “EM 的最大化-最大化视角”Neal & Hinton (1999) 提出了一个优雅的等价视角:把 EM 看成对 函数的交替最大化(coordinate ascent on ):
其中 是 的熵(entropy,衡量分布的不确定性)。
- E 步:固定 ,对 最大化 → 得到 。
- M 步:固定 ,对 最大化 → 更新参数。
这个视角揭示了一个重要的事实:EM 本质上是在函数空间( 的空间)和参数空间( 的空间)上做坐标上升。变分推断正是放松了 E 步——不再要求 精确等于后验,而是限制在一个简单的分布族中。
高斯混合模型(GMM)完整推导
Section titled “高斯混合模型(GMM)完整推导”K 个高斯分量的混合(mixture,即多个概率分布按权重叠加),参数包括每个分量的权重 、均值 、协方差 。完整数据对数似然为:
其中 是指示变量(indicator variable),表示样本 是否属于分量 。
E 步:计算责任度
Section titled “E 步:计算责任度”在给定当前参数 的条件下,隐变量 的后验分布为:
这个 被称为责任度(responsibility),表示在当前模型下,样本 由分量 生成的概率。它是 的后验期望:。
为什么叫”责任度”:可以理解为分量 对生成数据点 “负有多大责任”。所有分量的责任度之和为 1。
M 步:加权更新参数
Section titled “M 步:加权更新参数”将 代入 函数并对各参数求导令其为零,得到闭式更新:
直观理解 M 步:如果你把 看作样本 属于簇 的”隶属度”(类似模糊集合),那么 M 步就是在做模糊加权统计——当责任度退化为 0/1 硬标签时,公式就变成了普通的均值和方差。
GMM 与 K-Means 的关系
Section titled “GMM 与 K-Means 的关系”K-Means 可以看作 GMM 的一个极限特例:当所有分量的协方差 (各向同性且相同),且 时:
- E 步的责任度退化为硬分配(hard assignment):
- M 步退化为普通均值更新。
这就是为什么 K-Means 常被用来为 GMM 提供初始化——它提供了一个”粗略的硬聚类”作为起点。
变分推断:从精确到近似
Section titled “变分推断:从精确到近似”当后验 本身算不出来时(比如 LDA 中隐主题的精确后验涉及大量组合求和),变分推断引入一个简单的参数化分布 ( 是变分参数),通过最小化 KL 散度来逼近真实后验:
由于真实后验 含有未知的归一化常数 ,直接优化 KL 散度不可行。但利用前面的分解:
因为 不依赖于 ,所以最小化 KL 散度等价于最大化 ELBO:
最大化 ELBO 同时做了两件事:
- 重构项 :让 偏向能很好解释数据的隐变量配置(数据拟合)。
- 熵项 :鼓励 不要太集中,保持多样性(正则化)。
平均场假设(Mean-Field)
Section titled “平均场假设(Mean-Field)”为了让 可优化,通常假设各隐变量相互独立:
这被称为平均场假设(mean-field assumption)。在此假设下,可以推导出每个因子的最优解满足:
其中 表示所有其他因子。这意味着每个因子的最优分布只依赖于其他因子的期望——于是可以交替更新每个因子,形成类似 EM 的迭代。
通俗理解平均场:假设班上每个同学的成绩互不影响,然后逐个同学估算”在其他同学成绩已知的情况下,我的成绩最可能是什么”——重复这个过程直到所有人的估计稳定。
坐标上升变分推断(CAVI)
Section titled “坐标上升变分推断(CAVI)”平均场假设下,标准算法是坐标上升变分推断(Coordinate Ascent Variational Inference, CAVI):
初始化所有变分参数 λ_j重复: 对每个因子 j = 1, ..., M: 更新 q_j:q_j*(Z_j) ∝ exp(E_{q_{-j}}[log p(X, Z)]) 计算 ELBO直到 ELBO 收敛每一步更新都保证 ELBO 不减,因此 CAVI 收敛到 ELBO 的局部最优。
随机变分推断(SVI):大规模数据的突破
Section titled “随机变分推断(SVI):大规模数据的突破”Hoffman et al. (2013) 的随机变分推断(Stochastic Variational Inference)将随机梯度下降(SGD)引入变分推断。核心思想:每次只随机采样一小批数据(mini-batch)来更新变分参数,从而在亿级文档上也能训练 LDA 主题模型。这是将变分推断从学术研究推向大规模工业应用的关键里程碑。
VAE:深度学习时代的变分推断
Section titled “VAE:深度学习时代的变分推断”变分自编码器(Variational Autoencoder, VAE)将变分推断与神经网络结合:
- 编码器(Encoder / Inference Network):,用神经网络输出 和 ,代替传统的 CAVI 逐样本优化。这被称为摊销推断(amortized inference)——用一次前向传播代替逐个数据点的迭代优化。
- 解码器(Decoder / Generative Network):,从隐变量生成数据。
VAE 的损失函数就是负 ELBO:
详细内容见变分自编码器。
EM 算法流程
Section titled “EM 算法流程”EM 如何逐步提升对数似然
Section titled “EM 如何逐步提升对数似然”EM vs 变分推断 vs VAE
Section titled “EM vs 变分推断 vs VAE”sklearn 高斯混合模型(GMM)聚类
Section titled “sklearn 高斯混合模型(GMM)聚类”from sklearn.mixture import GaussianMixturefrom sklearn.datasets import make_blobsimport numpy as np
# 生成两个簇的模拟数据(无标签)X, _ = make_blobs(n_samples=300, centers=2, cluster_std=1.5, random_state=42)
# 拟合 GMM:EM 算法自动估计两个高斯分量的参数# n_components=K 指定分量数;max_iter 控制 EM 最大迭代次数gmm = GaussianMixture(n_components=2, max_iter=100, random_state=42)gmm.fit(X) # 内部执行 EM 迭代
# 查看估计的参数print("均值:", gmm.means_.round(2)) # 每个分量的中心print("权重:", gmm.weights_.round(2)) # 每个分量的占比print("协方差:", gmm.covariances_.round(2)) # 每个分量的协方差矩阵print("迭代次数:", gmm.n_iter_) # EM 迭代了几轮labels = gmm.predict(X) # 硬标签(取责任度最大的分量)proba = gmm.predict_proba(X).round(2) # 软标签(责任度矩阵)numpy 手写 EM 完整实现(一维双高斯)
Section titled “numpy 手写 EM 完整实现(一维双高斯)”下面是一维双高斯混合的完整 EM 实现,包含所有参数(均值、方差、权重)的更新:
import numpy as np
def em_1d_two_gaussians(X, n_iters=100, tol=1e-6):    """    一维双高斯混合的 EM 算法完整实现。    X: 一维观测数据,shape (N,)    """    N = len(X)
    # --- 初始化参数 ---    mu1, mu2 = X.min(), X.max()        # 均值初始化为数据两端    var1, var2 = X.var(), X.var()       # 方差初始化为数据全局方差    pi1 = 0.5                           # 混合权重(分量1的占比)
    log_likelihood_old = -np.inf
    for iteration in range(n_iters):        # ========== E 步:计算责任度 ==========        # 在当前参数下,每个样本属于分量1的概率        # 使用 log-sum-exp 技巧避免数值溢出        log_r1 = np.log(pi1) - 0.5 * np.log(2 * np.pi * var1) - (X - mu1)**2 / (2 * var1)        log_r2 = np.log(1 - pi1) - 0.5 * np.log(2 * np.pi * var2) - (X - mu2)**2 / (2 * var2)
        # softmax 得到责任度(log-sum-exp 技巧)        log_norm = np.logaddexp(log_r1, log_r2)  # 分母的 log        gamma1 = np.exp(log_r1 - log_norm)        # P(z=1|x) —— 分量1的责任度        gamma2 = np.exp(log_r2 - log_norm)        # P(z=2|x) —— 分量2的责任度
        # ========== M 步:加权更新参数 ==========        N1 = gamma1.sum()  # 分量1的有效样本数        N2 = gamma2.sum()
        mu1 = (gamma1 * X).sum() / N1       # 加权均值        mu2 = (gamma2 * X).sum() / N2        var1 = (gamma1 * (X - mu1)**2).sum() / N1   # 加权方差        var2 = (gamma2 * (X - mu2)**2).sum() / N2        pi1 = N1 / N                               # 新权重
        # ========== 计算对数似然,检查收敛 ==========        log_likelihood = log_norm.sum()  # 对数似然 = sum of log p(x_i)        if abs(log_likelihood - log_likelihood_old) < tol:            print(f"在第 {iteration+1} 次迭代收敛")            break        log_likelihood_old = log_likelihood
    return mu1, mu2, var1, var2, pi1
# --- 测试 ---np.random.seed(42)X = np.concatenate([np.random.randn(200) * 1.0 - 3,  # 簇1: 均值=-3, 标准差=1                    np.random.randn(200) * 0.5 + 3])  # 簇2: 均值=+3, 标准差=0.5
mu1, mu2, var1, var2, pi1 = em_1d_two_gaussians(X)print(f"分量1: μ={mu1:.3f}, σ²={var1:.3f}, π={pi1:.3f}")  # ≈ -3.0, 1.0, 0.5print(f"分量2: μ={mu2:.3f}, σ²={var2:.3f}, π={1-pi1:.3f}")  # ≈ +3.0, 0.25, 0.5
PyTorch 实现 VAE 中的 ELBO 优化
Section titled “PyTorch 实现 VAE 中的 ELBO 优化”以下代码展示了 VAE 如何用 PyTorch 自动微分来优化 ELBO,体现变分推断与深度学习的结合:
import torchimport torch.nn as nn
class VAE(nn.Module):    """最简 VAE:编码器+解码器,用 ELBO 训练。"""    def __init__(self, input_dim=784, hidden_dim=400, latent_dim=20):        super().__init__()
        # 编码器:q_φ(z|x) = N(μ(x), σ²(x))        # 用神经网络从数据 x 映射到隐变量分布的参数 μ 和 σ        self.encoder = nn.Sequential(            nn.Linear(input_dim, hidden_dim),            nn.ReLU(),        )        self.fc_mu = nn.Linear(hidden_dim, latent_dim)       # 输出均值 μ        self.fc_logvar = nn.Linear(hidden_dim, latent_dim)    # 输出 log σ²
        # 解码器:p_θ(x|z)        # 从隐变量 z 重构数据 x        self.decoder = nn.Sequential(            nn.Linear(latent_dim, hidden_dim),            nn.ReLU(),            nn.Linear(hidden_dim, input_dim),            nn.Sigmoid(),        )
    def reparameterize(self, mu, logvar):        """重参数化技巧(Reparameterization Trick):        z = μ + σ * ε, 其中 ε ~ N(0, I)        使梯度能通过随机采样操作反向传播——这是 VAE 训练的关键。"""        std = torch.exp(0.5 * logvar)        eps = torch.randn_like(std)        return mu + eps * std
    def forward(self, x):        h = self.encoder(x)        mu = self.fc_mu(h)        logvar = self.fc_logvar(h)        z = self.reparameterize(mu, logvar)   # 从 q(z|x) 采样隐变量        x_recon = self.decoder(z)              # 重构        return x_recon, mu, logvar
    def loss_function(self, x, x_recon, mu, logvar):        """ELBO 的负数 = 重构损失 + KL 散度正则项。"""        # 重构项:E_q[log p(x|z)],用 BCE 近似(伯努利解码器)        recon_loss = nn.functional.binary_cross_entropy(            x_recon, x, reduction='sum'        )        # KL 散度项:KL[N(μ,σ²) || N(0,1)] 的解析解        # 当先验是标准正态时,KL 有闭式表达:        # KL = -0.5 * Σ(1 + log σ² - μ² - σ²)        kl_div = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp())
        return recon_loss + kl_div  # 负 ELBO
# --- 训练循环 ---# vae = VAE()# optimizer = torch.optim.Adam(vae.parameters(), lr=1e-3)# for epoch in range(epochs):# for batch in dataloader:# x_recon, mu, logvar = vae(batch)# loss = vae.loss_function(batch, x_recon, mu, logvar)# optimizer.zero_grad()# loss.backward() # PyTorch 自动计算 ELBO 对 φ, θ 的梯度# optimizer.step()重参数化技巧为什么重要:直接从 采样无法反向传播梯度(采样操作不可微)。重参数化把随机性”外移”到一个独立噪声 ,使 成为 的确定性函数,梯度可以正常传播。这是 Kingma & Welling (2014) 的核心贡献之一。
- EM 只收敛到局部最优:初始化对结果影响很大,实践中通常多次随机初始化取最优(sklearn GMM 的
n_init参数控制重复次数,默认为 1,建议调大)。 - K 值选择:用 BIC(Bayesian Information Criterion,贝叶斯信息准则,在拟合优度和模型复杂度间做权衡)或 AIC 选择最优分量数 K——sklearn GMM 自带
.bic(X)方法,选 BIC 最小的 K。BayesianGaussianMixture可以自动推断 K。 - K-Means 是 GMM 的特例:当假设每个分量协方差相等且趋于零时,GMM 的 E 步退化为硬分配(K-Means)。所以 K-Means 常被用来为 GMM 提供初始化。
- 变分推断适合大规模:当数据量很大(如 LDA 主题模型处理数百万文档),变分推断比 MCMC(Markov Chain Monte Carlo,马尔可夫链蒙特卡洛,一种精确的随机采样方法)更快——前者用随机梯度上升可逐批更新,后者需要大量采样且每次需要遍历全部数据。详见蒙特卡洛方法与 MCMC。
- ELBO 中的 KL 散度项:VAE 训练时如果重构损失下降但生成质量差,往往是 KL 项权重过大导致后验坍缩(posterior collapse)——所有隐变量被忽略, 退化为先验 ,模型失去表达能力。解决方法包括 KL 退火(annealing,训练初期逐步增加 KL 权重)、β-VAE(降低 KL 权重)、或使用更强的解码器。
- 数值稳定性:E 步计算责任度时涉及指数运算,容易数值溢出(上溢/下溢),需用 log-sum-exp 技巧稳定计算:,其中 。
- 协方差奇异性:GMM 的 M 步可能产生奇异协方差矩阵(某个分量坍缩到单个数据点,方差为零),导致 E 步出现除零。sklearn 的
reg_covar参数(默认 )在协方差对角线上加一个小常数来缓解。 - 收敛判断:监控对数似然 的变化,当 (如 )时停止。不要用参数变化来判断收敛——参数可能在小范围震荡但对数似然已稳定。
- 高斯混合聚类:sklearn
GaussianMixture用于无监督聚类,可给出软标签(每个样本属于各簇的概率),比 K-Means 更灵活——能处理椭圆形簇和不同大小的簇。详见聚类算法。 - 隐马尔可夫模型训练:语音识别中的 HMM(Hidden Markov Model,隐马尔可夫模型,用于建模时序数据)用 EM(即 Baum-Welch 算法)估计状态转移与发射概率。E 步用前向-后向算法(forward-backward algorithm)高效计算。详见语音识别。
- LDA 主题模型:变分推断是 LDA(Latent Dirichlet Allocation,潜在狄利克雷分配)的标准训练方法,从海量文本中发现潜在主题。scikit-learn 的
LatentDirichletAllocation即用变分 EM。 - VAE 生成模型:变分自编码器用神经网络参数化变分分布,实现图像生成、数据压缩、半监督学习。详见变分自编码器。
- 缺失数据填补:医学统计中含缺失值的数据集,用 EM 迭代估计缺失值的期望并更新模型参数。这是 EM 最初被设计的场景(Dempster et al., 1977 论文标题就是 “Incomplete Data”)。
- 医学影像重建:PET(正电子发射断层扫描)和 CT(计算机断层扫描)中,使用有序子集 EM(Ordered Subset EM, OSEM)加速重建,每次只用一部分投影数据更新。
- 金融风险管理:处理含缺失值或删失数据(censored data,只知道值在某范围但不知确切值)的风险模型参数估计。
EM 算法的变体与加速
Section titled “EM 算法的变体与加速”EM 的标准形式虽然优雅,但收敛速度可能较慢(特别是当分量高度重叠时)。研究者提出了多种变体:
| 变体 | 全称 | 核心改进 | 适用场景 |
|---|---|---|---|
| EM | Expectation-Maximization | 标准 E-M 交替 | 后验可解析的简单模型 |
| GEM | Generalized EM | M 步只要求 增大而非最大化 | M 步无闭式解时 |
| ECM | Expectation Conditional Maximization | M 步拆成多个条件最大化子步 | 参数维度高、联合优化难 |
| ECME | ECM Either | 部分子步直接优化 而非 | 加速收敛 |
| PX-EM | Parameter-Expanded EM | 引入冗余参数”协方差校正”加速 | 提供与 EM 相同的收敛点但更快 |
| α-EM | Alpha-EM | 用 α-log 似然比替代 log 似然 | 无需梯度,收敛更快 |
| OSEM | Ordered Subset EM | 每次只用部分数据子集 | 医学影像重建等大数据场景 |
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| sklearn.mixture | Python | GaussianMixture(EM 拟合)、BayesianGaussianMixture(变分贝叶斯,自动选 K) |
| sklearn.decomposition | Python | LatentDirichletAllocation(变分 EM 训练 LDA 主题模型) |
| PyMC | Python | 概率编程框架,内置变分推断(ADVI)和 MCMC 采样 |
| Pyro / NumPyro | Python | Uber/Google 的概率编程库,支持变分推断与 HMC,基于 PyTorch/JAX |
| Edward2 / TensorFlow Probability | Python | Google 的概率编程库,支持变分推断与概率层 |
| gensim | Python | LDA 主题模型的高效实现(在线变分推断) |
| numpyro | Python | 基于 JAX 的概率编程,GPU 加速变分推断 |
| BlackJAX | Python | JAX 上的 MCMC 和变分推断库 |
| 术语 | 英文 | 解释 |
|---|---|---|
| EM 算法 | Expectation-Maximization | 含隐变量模型的迭代优化方法,交替执行 E 步和 M 步 |
| 隐变量 | Latent Variable | 不可直接观测的变量(如聚类标签、主题、隐状态) |
| 期望步 | E-Step | 固定参数,计算隐变量后验分布或责任度 |
| 最大化步 | M-Step | 固定后验,更新参数使完整数据对数似然期望最大化 |
| 责任度 | Responsibility | GMM 中样本 属于分量 的后验概率,即软标签 |
| 证据下界 | ELBO | 对数似然的下界,变分推断的优化目标 |
| 变分推断 | Variational Inference | 用简单分布族逼近后验,将推断转化为优化的方法 |
| 平均场 | Mean-Field | 假设隐变量相互独立的变分假设,使更新可解析求解 |
| KL 散度 | KL Divergence | 衡量两个分布差异的非对称度量,VI 通过最小化它逼近后验 |
| 后验坍缩 | Posterior Collapse | VAE 中隐变量后验退化为先验,模型忽略隐变量的问题 |
| Baum-Welch | Baum-Welch | EM 在 HMM 上的特例,用前向-后向算法完成 E 步 |
| 摊销推断 | Amortized Inference | 用神经网络一次前向传播推断所有样本的后验参数(VAE 的核心) |
| 重参数化 | Reparameterization | 将随机采样改写为确定性函数+独立噪声,使梯度可反向传播 |
| log-sum-exp | Log-Sum-Exp | 数值稳定的计算技巧,防止指数运算溢出 |
| CAVI | Coordinate Ascent VI | 逐因子交替优化的变分推断算法 |
| SVI | Stochastic Variational Inference | 用随机梯度下降的变分推断,支持大规模数据 |
2025-2026 前沿进展
Section titled “2025-2026 前沿进展”扩散模型与变分推断的统一视角
Section titled “扩散模型与变分推断的统一视角”2023-2025 年间,学术界对扩散模型(Diffusion Models)和变分推断的关系有了更深入的理解。扩散模型的训练目标可以被解释为一种特殊的 ELBO:
- 连续时间 VAE 视角:扩散模型可以看作一个有无限层隐变量的层级 VAE(hierarchical VAE),每层对应一个去噪步骤。ELBO 分解为一系列去噪匹配项。
- 分数匹配(Score Matching)与 ELBO 的等价性:去噪分数匹配损失 与 ELBO 的关系在 2024-2025 年得到了更精确的刻画(如 Song et al. 的统一框架)。
- Flow Matching:2024-2025 年兴起的 Flow Matching(Lipman et al., 2023)可以看作连续归一化流(Continuous Normalizing Flows)的变分推断框架,提供比传统 ELBO 更灵活的训练目标。
这些进展使得 EM/VI 的理论基础成为理解现代生成模型(扩散模型、Flow Matching、一致性模型)的统一语言。
大语言模型与变分推断
Section titled “大语言模型与变分推断”2024-2025 年的研究开始将变分推断引入大语言模型(LLM)的推理过程:
- LLM 的不确定性量化:通过在 LLM 的输出分布上做变分推断,估计模型预测的不确定性(如 Bayesian Neural Networks 的思想应用于 Transformer)。这对 LLM 的可靠性和幻觉检测有重要意义。
- 变分 RLHF:有研究将变分推断与 RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)结合,用 ELBO 来统一奖励建模和策略优化,提供更稳定的训练动态。
- 推理时变分推断:利用 LLM 的 in-context learning 能力,在推理时做”摊销变分推断”——让 LLM 本身作为变分族 ,通过提示词工程来逼近复杂后验。
自动微分变分推断的成熟
Section titled “自动微分变分推断的成熟”ADVI(Automatic Differentiation Variational Inference)从 2016 年提出以来,在 2024-2025 年进入了成熟阶段:
- JAX 生态:NumPyro 和 BlackJAX 等基于 JAX 的库实现了 GPU/TPU 加速的变分推断,使得之前需要数小时训练的概率模型可以在分钟级别完成。
- 正常izing flows(归一化流)的普及:用可逆神经网络参数化 ,突破平均场假设的限制,显著提高变分近似的质量。2024-2025 年出现了更高效的结构(如 Coupling Flows、Residual Flows)。
- ** Stein 变分梯度下降(SVGD)**:一种介于变分推断和 MCMC 之间的方法,用粒子群逼近后验,2024-2025 年在大规模贝叶斯深度学习中得到广泛应用。
EM 的可扩展性与理论新进展
Section titled “EM 的可扩展性与理论新进展”- 分布式 EM:针对超大规模数据集的分布式 EM 实现(如 Spark MLlib 的 GMM),2024-2025 年在分布式优化理论上有新突破,包括更紧的收敛速率保证和通信效率优化。
- 非参数 EM:结合 Dirichlet Process(狄利克雷过程)的非参数贝叶斯方法,自动推断分量数 K,无需手动指定。2025 年在计算效率上有改进。
- EM 的全局最优保证:在高斯混合模型上,2020-2025 年的理论工作(如 spectral methods 与 EM 结合)给出了在某些正则条件下 EM 能收敛到全局最优的理论保证,弥补了传统 EM 只保证局部最优的缺陷。
隐变量模型在科学发现中的应用
Section titled “隐变量模型在科学发现中的应用”2025 年,基于 EM 和变分推断的隐变量模型在科学领域展现出新的应用价值:
- 单细胞基因组学:用变分推断处理 scRNA-seq(单细胞 RNA 测序)数据中的 dropout(零膨胀)问题,模型如 scVI(single-cell Variational Inference)已成为该领域的标准工具。
- 蛋白质结构预测中的不确定性:AlphaFold 等模型的成功催生了将变分推断引入蛋白质结构预测的研究,用以量化预测的置信度。
- 天文学中的混合模型:星系分类、暗物质检测等领域大量使用 EM 算法处理混合分布数据。
- Dempster, Laird & Rubin,「Maximum Likelihood from Incomplete Data via the EM Algorithm」(1977):EM 算法的奠基论文,引用量 6 万+,统计学习领域里程碑。
- Wu, C. F. Jeff,「On the Convergence Properties of the EM Algorithm」(1983):修正了原始论文的收敛性证明,是理解 EM 理论保证的必读文献。
- Neal & Hinton,「A View of the EM Algorithm that Justifies Incremental, Sparse, and Other Variants」(1999):提出 EM 的最大化-最大化视角,深刻影响了后续变分推断的发展。
- Bishop,「Pattern Recognition and Machine Learning」第 9 章:PRML 圣经中对 EM 和变分推断的推导最为详尽清晰,含 GMM 完整推导。
- Blei, Kucukelbir & McAuliffe,「Variational Inference: A Review for Statisticians」(JASA 2017):变分推断的现代综述,从统计视角清晰梳理 VI 原理与应用。
- Hoffman et al.,「Stochastic Variational Inference」(JMLR 2013):将随机梯度引入变分推断,使 LDA 能在亿级文档上训练——大规模 VI 的里程碑。
- Kingma & Welling,「Auto-Encoding Variational Bayes」(ICLR 2014):VAE 论文,将变分推断与深度学习结合,开创深度生成模型方向。
- Lipman et al.,「Flow Matching for Generative Modeling」(ICLR 2023):Flow Matching 框架,与变分推断和扩散模型有深刻联系。
- Song et al.,「Score-Based Generative Modeling through Stochastic Differential Equations」(ICLR 2021):将扩散模型统一在 SDE 框架下,与 ELBO 建立精确联系。
- Lopez et al.,「Discovering invariance units in neural population activity with Gaussian mixtures」(Nature Neuroscience, 2025):2025 年最新应用案例,展示 GMM + EM 在神经科学发现中的威力。