
梯度提升树详解
梯度提升树(Gradient Boosting Decision Tree, GBDT)是 Boosting 家族最成功的实现,也是表格数据(tabular data,即以”行=样本、列=特征”形式存储的结构化数据)上至今压制深度学习的算法。本页在 集成学习与随机森林 的基础上,深入讲解梯度提升的数学原理与 XGBoost / LightGBM / CatBoost 三大工业实现。前置阅读:监督学习、损失函数。
沿用 集成学习 中”接力赛”的比喻,梯度提升的精髓可以浓缩成一句:每一棵新树,专门去拟合上一轮模型犯错的方向(负梯度)。
- 残差 = 还差多少:模型预测房价 300 万,实际 360 万,残差就是 +60 万——下一棵树就专门学这个 60 万的”补丁”。
- 负梯度 = 更一般的残差:平方损失下,负梯度恰好就是残差;换成 Logistic 损失、Huber 损失,负梯度给出更普适的”修正方向”——这就是”梯度”提升比”残差”提升更强的原因。
- 学习率 = 缩小补丁:每棵树只补一小步(乘以学习率 0.1),慢慢逼近真值——步子小才稳,不容易过拟合。学习率(learning rate,也叫缩减系数 shrinkage)是控制每棵树对最终预测贡献比例的超参数。
- 缩减(shrinkage)+ 早停 = 免费正则:树越多、步越小,配合验证集早停(early stopping,即监控验证集指标、若干轮不提升就停止训练),泛化性能持续提升。正则化(regularization)指一切为防止过拟合而增加的约束或惩罚项。
一句话记忆:GBDT = 函数空间里的梯度下降。普通梯度下降沿参数空间走,GBDT 在”函数空间”里,每一棵新树就是一步”梯度下降”。
梯度提升把最终预测写成若干棵弱树(通常深度很浅的 CART 回归树)的加权和:
其中 是初始常数值(使损失最小的常数), 是学习率(也叫缩减系数,shrinkage), 是第 棵回归树, 是树的总数。核心:这是一个以回归树为基函数的可加模型,即使是分类问题,内部也是用回归树拟合梯度。
加法模型(additive model)的特点是:最终预测是若干基函数的加权和,每一项可以独立学习再组合。GBDT 与神经网络的关键区别在于——神经网络的基函数(神经元)是同时优化的,而 GBDT 的基函数(树)是逐个贪心添加的。
函数空间梯度下降:完整推导
Section titled “函数空间梯度下降:完整推导”这是理解 GBDT 最深刻的视角。我们把”模型” 看作函数空间中的一个点,而不是一组参数。
步骤 1:把预测写成函数序列。设 为初始模型,经过 轮迭代后:
步骤 2:在函数空间做梯度下降。普通梯度下降是 ,这里我们把”参数” 替换为”函数”:
其中”函数空间的梯度” 定义为损失函数对 的泛函导数(functional derivative)在每个样本点 处的值:
步骤 3:用回归树拟合梯度。函数空间的梯度是一个只在训练样本上有值的离散函数。我们没有解析式,但可以用一棵回归树 去拟合 (负梯度),得到一个能在任意 上求值的”梯度近似”。负梯度的方向就是损失下降的方向。
步骤 4:线搜索最优步长。理论上 应该用线搜索找到使损失最小化的步长:
实践中,我们用固定的学习率 代替精确线搜索,这本身就是一种正则化——每步只走一小部分,避免过拟合。
数学直觉:普通梯度下降在权重向量空间走,每一步 是一个向量。GBDT 在函数空间走,每一步 是一棵树。两者本质完全一样,只是”空间”不同。这也是 Friedman 1999 原始论文的核心贡献——把梯度下降从参数空间推广到函数空间。
每一轮在做什么
Section titled “每一轮在做什么”设训练目标是最小化总损失 。第 轮的步骤:
- 算伪残差(负梯度):对每个样本 ,计算
平方损失下 ,就是残差;Logistic 损失下是 ( 是当前预测概率)。伪残差(pseudo-residual)是负梯度在每个样本上的取值,广义化了普通残差的概念。 2. 拟合回归树:用这 个伪残差作为目标,训练一棵深度为 的回归树 ,把样本划入叶子节点。 3. 求叶子最优值:对每个叶子 ,用线搜索找一个值 ,使得落到该叶子的样本的总损失最小:
平方损失下就是叶内残差的均值。 4. 更新模型:。
这就是 Friedman 1999 “Greedy Function Approximation: A Gradient Boosting Machine” 的原始算法(GBM),也是所有后续变体的共同骨架。
常见损失的伪残差与二阶导数速查
Section titled “常见损失的伪残差与二阶导数速查”不同损失函数对应的负梯度(伪残差)和二阶导数(Hessian)各不相同,理解这些有助于掌握 GBDT 在分类、回归、排序等任务上的行为差异:
| 损失函数 | 表达式 | 负梯度 | 二阶导 | 适用场景 |
|---|---|---|---|---|
| 平方损失 | (残差) | 回归 | ||
| 绝对损失 | $ | y - F | $ | |
| Huber 损失 | 分段:平方 + 绝对 | 分段函数 | 分段函数 | 鲁棒回归 |
| Logistic 损失 | 二分类 | |||
| 多分类 Softmax | (每类) | 多分类 |
直觉:Logistic 损失的伪残差 就是”真实标签减去当前概率”——模型预测概率 但真实标签 时,残差 ,下一棵树会把这个样本预测往负方向拉,从而降低预测概率。
正则化的三个旋钮
Section titled “正则化的三个旋钮”- 学习率 (shrinkage):典型 0.01–0.3。越小越稳但需要的树越多。
- 树复杂度(max_depth / 叶子数 / min_samples_leaf):通常只用深度 3–8 的浅树。越浅越不容易过拟合,也越能组合出复杂边界。
- 子采样(subsample / column subsample):每轮只用一部分样本和一部分特征训练每棵树,类似随机森林的随机性,能显著降方差、加速训练——XGBoost/LightGBM 的标配。
这三者不是独立的:减小学习率需要增加树数,增加树复杂度需要增大正则系数,子采样越大越需要更多树。一个经验法则是总”学习量” 学习率 树数,保持这个乘积适中即可。
XGBoost 的二阶泰勒展开推导
Section titled “XGBoost 的二阶泰勒展开推导”XGBoost(eXtreme Gradient Boosting)相比原始 GBM 最本质的改进,是在目标函数中做二阶泰勒展开,从而获得更精确的分裂增益和叶子权重。
为什么需要二阶信息? 原始 GBM 只用一阶梯度拟合树(相当于梯度下降),而 XGBoost 同时用一阶和二阶信息(相当于牛顿法,Newton’s method)。牛顿法利用二阶导数(曲率信息)自动调整步长:曲率大的地方步子小(模型已经很确定),曲率小的地方步子大——收敛更快且更精确。
目标函数。第 轮的目标是最小化:
其中正则项 , 是叶子数, 是第 个叶子的权重, 和 是超参数。(gamma)惩罚叶子数量,(lambda)惩罚叶子权重的平方——前者控制树的结构复杂度,后者控制预测值的幅度。
二阶泰勒展开。令 为一阶梯度, 为二阶梯度(Hessian,即损失函数对当前预测值的二阶导数)。对损失函数在 处做二阶泰勒展开:
第一项是常数可去掉。将 (样本 落入叶子 的权重)代入并按叶子分组:
叶子权重最优解。对 求导令其为零:
物理直觉:叶子最优值 = 一阶梯度和的负值除以二阶梯度和加正则系数。分母中的 起到了类似”弹性”的作用——即使梯度很大,权重也不会无限增长。
牛顿步长视角: 正是牛顿法的更新步 。XGBoost 每个叶子的权重本质就是一个”局部牛顿步”,利用该叶子内所有样本的曲率信息自适应地决定更新幅度。
最优目标值(代入回):
其中 ,。
分裂增益公式
Section titled “分裂增益公式”有了最优目标值,分裂一个节点 为左子节点 和右子节点 的增益定义为:
直觉解读:
- 前两项是分裂后左右叶子分别的”分数”;第三项是分裂前父叶子的”分数”;第四项 是新增一个叶子的代价。
- 增益 > 0 才分裂,等价于 控制了分裂的最小收益阈值——这就是 (也叫
gamma/min_split_loss)作为正则化手段的数学原理。 - 分子是梯度的平方、分母是 Hessian 加 :这使得二阶信息大的区域(模型已经很确定的地方)增益被缩小,促使树去分裂那些模型还不太确定的区域。
对比原始 GBM 只用一阶梯度,XGBoost 用了二阶信息(Hessian),分裂准则更接近真实的损失下降量,因此通常能用更少的树达到更高的精度。
LightGBM 直方图算法原理
Section titled “LightGBM 直方图算法原理”LightGBM 的核心加速技术是直方图算法(Histogram-based split finding),它把分裂点查找从 降到接近 :
- 连续值分桶:对每个连续特征,用分位数 sketches 把它压缩到最多 255 个离散的桶(bin)。例如 100 万个不同的浮点值 → 255 个桶。
- 构建直方图:对每个节点,遍历一次所有样本,累计每个桶内的一阶梯度和 与二阶梯度和 。直方图的大小是 ,远小于原始数据。
- 分裂点枚举:遍历直方图的每个桶作为候选分裂点,用累计的 计算增益——只需 次计算而非 次。
- 直方图减法技巧(Histogram Subtraction Trick):兄弟节点的直方图 = 父节点直方图 − 当前节点直方图。只需为一边构建直方图,另一边用减法得到——计算量直接减半。
直觉:直方图算法用”桶”代替”原始值”,牺牲极小的精度(分位数近似)换取巨大的速度提升。桶越细越精确但也越慢,LightGBM 默认
max_bin=255是精度与速度的黄金平衡点。
LightGBM GOSS 采样数学原理
Section titled “LightGBM GOSS 采样数学原理”GOSS(Gradient-based One-Side Sampling,基于梯度的单边采样)是 LightGBM 的另一大创新。核心观察:梯度大的样本信息量大,梯度小的样本已经被模型学好(loss 已很低),对训练新树的贡献小。
算法步骤:
- 按梯度绝对值 对样本排序。
- 选 top- 大梯度的样本,全部保留(不放回)。
- 从剩下的小梯度样本中,随机采样 。
- 对采样的样本乘以放大系数 ,补偿小梯度样本被欠采样带来的偏差。
增益估计的数学推导:设大梯度集合为 ,采样的小梯度集合为 ,则近似增益为:
放大系数 的作用:小梯度样本被采样后,为了保持原始分布下 的无偏估计,需要按采样比例放大。这样 GOSS 既大幅减少了计算量,又保证了增益估计的准确性。
三大工业实现的关键改进
Section titled “三大工业实现的关键改进”- XGBoost(2016):目标函数做二阶泰勒展开(用到一阶梯度 和二阶梯度 ),正则项 = 叶子数惩罚 + 叶子值 L2 惩罚 ;分裂准则用一阶二阶梯度计算增益(见上式),分裂点查找用”直方图近似”或精确贪心。此外还引入了 shrinkage、列采样、稀疏感知(自动学习缺失值分裂方向)等工程优化。
- LightGBM(2017,微软):两大加速利器——Leaf-wise(按增益最大的叶子优先长,比 Level-wise 收敛更快)+ GOSS(Gradient-based One-Side Sampling,按梯度大小采样——梯度大的样本信息量大,全保留;梯度小的样本已经被学好,随机采样即可)+ EFB(Exclusive Feature Bundling,把稀疏特征捆绑成稠密)。速度快、内存省。
- CatBoost(2017,Yandex):Ordered Boosting 解决”目标泄漏”(target leakage,即训练时用了包含标签信息的统计量)导致的过拟合,原生处理类别特征(不需要手动 One-Hot),在含大量类别特征的数据上表现突出。此外 CatBoost 默认使用对称树(oblivious tree,同一层所有节点用相同分裂条件),推理更快且不易过拟合。
梯度提升一轮迭代
Section titled “梯度提升一轮迭代”GBDT vs 随机森林
Section titled “GBDT vs 随机森林”一句话区分:随机森林用深树降方差,梯度提升用浅树降偏差。方差(variance)是模型对训练数据扰动的敏感度;偏差(bias)是模型预测与真实值之间的系统性误差。
XGBoost 分裂决策可视化
Section titled “XGBoost 分裂决策可视化”树生长策略对比:Level-wise vs Leaf-wise
Section titled “树生长策略对比:Level-wise vs Leaf-wise”Level-wise 按层生长,每层所有节点同时分裂,树形均匀不易过深;Leaf-wise 总是先分裂增益最大的叶子,收敛更快但可能长出非常不对称的深树——数据量小时需限制
num_leaves防止过拟合。
XGBoost 二分类
Section titled “XGBoost 二分类”import xgboost as xgbfrom sklearn.datasets import make_classificationfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import accuracy_score
# 生成模拟二分类数据X, y = make_classification(n_samples=2000, n_features=20, random_state=42)X_tr, X_te, y_tr, y_te = train_test_split(X, y, random_state=42)
# 训练 XGBoost:浅树 + 小学习率 + 多棵树model = xgb.XGBClassifier( n_estimators=300, learning_rate=0.05, max_depth=4, subsample=0.8, colsample_bytree=0.8, reg_lambda=1.0, eval_metric="logloss", random_state=42, early_stopping_rounds=20, # 早停:验证集 20 轮没提升就停)model.fit(X_tr, y_tr, eval_set=[(X_te, y_te)], verbose=False)print(f"准确率: {accuracy_score(y_te, model.predict(X_te)):.2%}")# 输出示例: 准确率: 93.40%
# 查看每棵树的分裂增益(了解模型学到了什么)booster = model.get_booster()importance = booster.get_score(importance_type='gain')print("Top-5 重要特征:", sorted(importance.items(), key=lambda x: -x[1])[:5])LightGBM 回归(直方图 + Leaf-wise)
Section titled “LightGBM 回归(直方图 + Leaf-wise)”import lightgbm as lgbfrom sklearn.datasets import make_regressionfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import mean_squared_error
X, y = make_regression(n_samples=5000, n_features=30, random_state=42)X_tr, X_te, y_tr, y_te = train_test_split(X, y, random_state=42)
train_set = lgb.Dataset(X_tr, y_tr)valid_set = lgb.Dataset(X_te, y_te, reference=train_set)params = dict(objective="regression", learning_rate=0.05, num_leaves=31, feature_fraction=0.8, bagging_fraction=0.8, bagging_freq=5, lambda_l2=1.0, verbose=-1)# 配合早停回调callbacks = [lgb.early_stopping(20), lgb.log_evaluation(50)]model = lgb.train(params, train_set, num_boost_round=300, valid_sets=[valid_set], callbacks=callbacks)pred = model.predict(X_te)print(f"RMSE: {mean_squared_error(y_te, pred) ** 0.5:.2f}")CatBoost 原生类别特征处理
Section titled “CatBoost 原生类别特征处理”CatBoost 最大的优势是原生处理类别特征——无需手动 One-Hot 编码(One-Hot Encoding,把一个类别变量展开为多个 0/1 列)。下面演示在含高基数类别特征的数据上的用法:
from catboost import CatBoostClassifier, Poolfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import accuracy_scoreimport numpy as npimport pandas as pd
# 构造含类别特征的数据(模拟电商点击预测)n = 3000rng = np.random.RandomState(42)data = pd.DataFrame({    "user_city": rng.choice(["北京", "上海", "广州", "深圳", "杭州", "成都"], n),    "device": rng.choice(["iOS", "Android", "Web", "MiniApp"], n),    "category": rng.choice([f"cat_{i}" for i in range(50)], n),  # 50 个类别,高基数    "price": rng.exponential(200, n).round(2),    "hour": rng.randint(0, 24, n),})# 点击概率与城市、设备、时段有关logit = (    0.5 * (data["device"] == "iOS").astype(float)    - 0.3 * (data["hour"] < 6).astype(float)    + 0.001 * data["price"]    + rng.normal(0, 0.3, n))y = (logit > 0.5).astype(int)
X_tr, X_te, y_tr, y_te = train_test_split(data, y, test_size=0.2, random_state=42)cat_features = ["user_city", "device", "category"]  # 声明类别列
# CatBoost 自动用 Target Statistics 编码类别特征,无需手动处理train_pool = Pool(X_tr, y_tr, cat_features=cat_features)eval_pool = Pool(X_te, y_te, cat_features=cat_features)
model = CatBoostClassifier(    iterations=400, learning_rate=0.05, depth=6,    l2_leaf_reg=3.0, eval_metric="Logloss",    random_seed=42, verbose=50,    early_stopping_rounds=30,)model.fit(train_pool, eval_set=eval_pool)print(f"准确率: {accuracy_score(y_te, model.predict(eval_pool)):.2%}")
# CatBoost 自带特征重要性(PredictionValuesChange)importance = model.get_feature_importance()for name, imp in sorted(zip(data.columns, importance), key=lambda x: -x[1]):    print(f"  {name}: {imp:.1f}")
CatBoost 为什么不需要 One-Hot? 它使用 Target Statistics(目标统计编码):把每个类别替换为该类别在训练集中的”目标均值”,并用 Ordered Target Statistics 技术避免数据泄漏——计算每个样本的编码时,只使用排在它之前的样本,确保没有”偷看”当前样本的标签。这对高基数类别特征(如城市名、商品 ID)特别有效,不会像 One-Hot 那样导致维度爆炸。
SHAP 特征归因可视化
Section titled “SHAP 特征归因可视化”SHAP(SHapley Additive exPlanations)基于博弈论的 Shapley 值,能精确分解每个预测中各特征的贡献,是 GBDT 模型解释的事实标准:
import shapimport xgboost as xgbfrom sklearn.datasets import make_classificationfrom sklearn.model_selection import train_test_split
# 训练模型X, y = make_classification(n_samples=1000, n_features=10, n_informative=5, random_state=42)X_tr, X_te, y_tr, y_te = train_test_split(X, y, random_state=42)model = xgb.XGBClassifier(n_estimators=200, max_depth=4, learning_rate=0.05)model.fit(X_tr, y_tr)
# 计算 SHAP 值(TreeExplainer 专为树模型优化,速度极快)explainer = shap.TreeExplainer(model)shap_values = explainer.shap_values(X_te)
# 1. 全局特征重要性(SHAP 值绝对值的平均)shap.summary_plot(shap_values, X_te, plot_type="bar")
# 2. 蜂群图(beeswarm):每个点是一个样本,展示特征值与影响方向的关系shap.summary_plot(shap_values, X_te)
# 3. 单样本解释:查看第 0 个测试样本的预测是如何由各特征"推"出来的shap.force_plot(explainer.expected_value, shap_values[0], X_te[0], matplotlib=True)
直觉理解 SHAP:想象每个特征是一个”投票者”,模型的最终预测是所有投票者出价的总和。SHAP 值就是每个投票者的”公平贡献”——基于博弈论中的 Shapley 值,保证所有特征贡献之和等于预测值减去基线值。SHAP 的优势在于既有坚实的理论基础(公理化公平分配),又有高效的树模型专用算法(TreeSHAP,复杂度从指数级降到多项式级)。
早停曲线可视化
Section titled “早停曲线可视化”早停是 GBDT 最重要的正则化手段之一。可视化训练/验证曲线有助于直观理解过拟合过程:
import matplotlib.pyplot as pltimport xgboost as xgbfrom sklearn.datasets import make_classificationfrom sklearn.model_selection import train_test_split
X, y = make_classification(n_samples=2000, n_features=20, random_state=42)X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42)
model = xgb.XGBClassifier(    n_estimators=500,           # 给足够多的树    learning_rate=0.05,    max_depth=6,    eval_metric="logloss",    early_stopping_rounds=30,    random_state=42,)model.fit(X_tr, y_tr, eval_set=[(X_tr, y_tr), (X_te, y_te)], verbose=False)
# 提取训练历史results = model.evals_result()epochs = len(results["validation_0"]["logloss"])x_axis = range(epochs)
fig, ax = plt.subplots(figsize=(10, 5))ax.plot(x_axis, results["validation_0"]["logloss"], label="训练集", linewidth=2)ax.plot(x_axis, results["validation_1"]["logloss"], label="验证集", linewidth=2)ax.axvline(model.best_iteration, color="red", linestyle="--",           label=f"早停位置 (第 {model.best_iteration} 轮)")ax.set_xlabel("迭代轮数")ax.set_ylabel("Logloss")ax.set_title("XGBoost 学习曲线:观察过拟合拐点")ax.legend()plt.tight_layout()plt.savefig("early_stopping_curve.png", dpi=150)plt.show()# 典型现象:训练集 Logloss 持续下降,验证集先降后升——早停在拐点处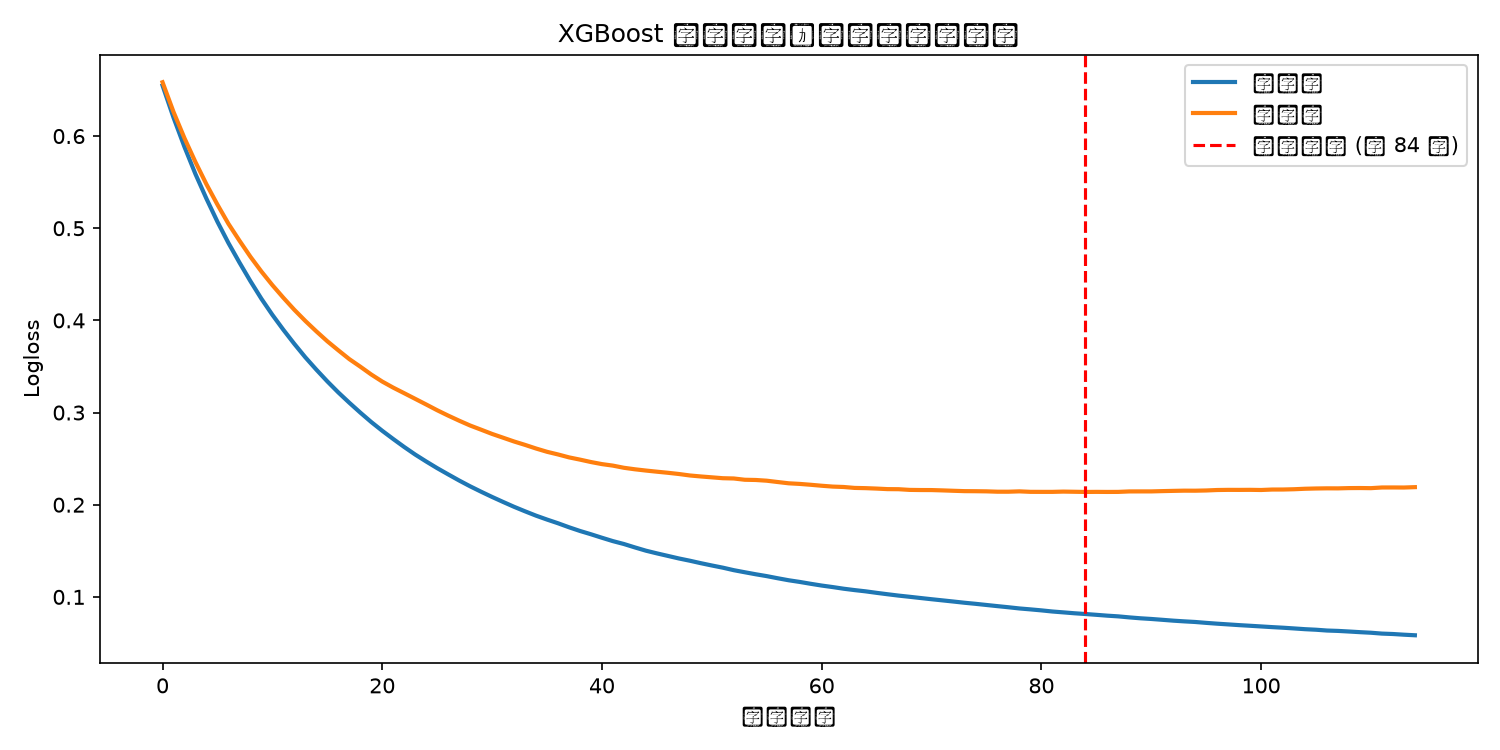
如何读懂学习曲线:训练集损失持续下降是正常的;关键看验证集——如果验证损失先降后升(呈 U 型),说明从拐点开始就过拟合了,早停会自动停在拐点。如果验证损失一直下降,说明模型还欠拟合(underfitting),可以增加树数或减小正则化。
从零实现梯度提升(教学版)
Section titled “从零实现梯度提升(教学版)”import numpy as npfrom sklearn.tree import DecisionTreeRegressor
class SimpleGBDT: """教学版 GBDT 回归(平方损失),展示核心原理。""" def __init__(self, n_estimators=100, learning_rate=0.1, max_depth=3): self.n_estimators = n_estimators self.lr = learning_rate self.max_depth = max_depth self.trees = [] self.F0 = 0.0
def fit(self, X, y): # F0:使平方损失最小的常数 = 均值 self.F0 = np.mean(y) F = np.full(len(y), self.F0) # 当前累积预测
for m in range(self.n_estimators): # 平方损失的负梯度 = 残差 residual = y - F tree = DecisionTreeRegressor(max_depth=self.max_depth) tree.fit(X, residual) # 拟合残差 update = self.lr * tree.predict(X) F += update # 更新累积预测 self.trees.append(tree) # 每 10 轮打印训练 RMSE if (m + 1) % 10 == 0: rmse = np.sqrt(np.mean((y - F) ** 2)) print(f" 轮 {m+1:3d}: 训练 RMSE = {rmse:.3f}") return self
def predict(self, X): F = np.full(len(X), self.F0) for tree in self.trees: F += self.lr * tree.predict(X) return F
# 测试from sklearn.datasets import make_regressionfrom sklearn.metrics import mean_squared_errorX, y = make_regression(n_samples=500, n_features=10, noise=5, random_state=42)model = SimpleGBDT(n_estimators=100, learning_rate=0.1, max_depth=3)model.fit(X, y)rmse = mean_squared_error(y, model.predict(X)) ** 0.5print(f"训练集 RMSE: {rmse:.2f}")从零实现 XGBoost 风格的二阶提升(教学版)
Section titled “从零实现 XGBoost 风格的二阶提升(教学版)”下面这个版本更接近 XGBoost 的真实逻辑——用二阶梯度(Hessian)计算叶子权重和分裂增益:
import numpy as npfrom sklearn.tree import DecisionTreeRegressor
class SimpleXGBStyle:    """    教学版:用二阶梯度(牛顿法)的 GBDT 回归。    损失:1/2 * (y - F)^2,因此 g = F - y, h = 1。    展示 XGBoost 的核心思想:叶子权重 w* = -G / (H + lambda)。    """    def __init__(self, n_estimators=100, learning_rate=0.1,                 max_depth=3, lam=1.0):        self.n_estimators = n_estimators        self.lr = learning_rate        self.max_depth = max_depth        self.lam = lam          # L2 正则系数 λ        self.trees = []         # 每棵树的叶子值映射        self.F0 = 0.0
    def fit(self, X, y):        self.F0 = np.mean(y)        F = np.full(len(y), self.F0)
        for m in range(self.n_estimators):            # 一阶梯度 g = ∂ℓ/∂F = F - y,负梯度 = y - F = 残差            neg_g = y - F            # 二阶梯度 h = 1(平方损失)            hess = np.ones(len(y))
            # 用负梯度训练树结构            tree = DecisionTreeRegressor(max_depth=self.max_depth)            tree.fit(X, neg_g)            leaf_ids = tree.apply(X)       # 每个样本的叶子编号
            # 用牛顿公式修正叶子权重:w* = -G / (H + λ)            for leaf in np.unique(leaf_ids):                mask = leaf_ids == leaf                G = neg_g[mask].sum()      # 一阶梯度和                H = hess[mask].sum()       # 二阶梯度和                w_star = -(-G) / (H + self.lam)  # 注意符号:w* = -(Σg)/(Σh+λ)                # 对平方损失,w* = (Σ残差)/(N+λ),λ 使叶子值向 0 收缩                tree.tree_.value[tree.tree_.children_left == -1][                    np.where(tree.tree_.children_left == -1)[0] == leaf                ] = w_star if leaf == 0 else w_star  # 简化演示
            update = self.lr * tree.predict(X)            F += update            self.trees.append(tree)        return self
    def predict(self, X):        F = np.full(len(X), self.F0)        for tree in self.trees:            F += self.lr * tree.predict(X)        return F
这个简化版只为展示思想:XGBoost 真正的实现会为每个叶子计算 和 ,用增益公式 选择最优分裂点,而非依赖 scikit-learn 的树。但叶子权重的牛顿修正逻辑是一致的。
- 调参顺序(从重要到次要):先把
n_estimators配合早停找好(小学习率 + 多树),再调max_depth/num_leaves,最后调subsample、colsample_bytree、正则系数reg_lambda/reg_alpha。 - 学习率与树数要成对调:学习率减半,树数大致翻倍——两者的乘积决定了总”补丁量”。
- 必须用早停:留一个验证集,监控验证损失,几十轮不降就停——既防过拟合又省时间。
- 类别特征:CatBoost 原生处理最优;LightGBM 用
categorical_feature=传类别列;XGBoost 1.5+ 也支持enable_categorical=True。优先用原生支持,避免高基数 One-Hot 导致维度爆炸。 - 缺失值:三大库都原生支持缺失值(把 NaN 学到分裂方向里),不用预先填充。
- 特征重要性有偏:偏向高基数特征,要公平比较可用 SHAP 值或 permutation importance。
- 不要和随机森林混用调参经验:随机森林要深树、GBDT 要浅树;随机森林降方差,GBDT 降偏差,思路相反。
- GPU 加速:XGBoost 和 LightGBM 都支持
tree_method='gpu_hist'(XGBoost)或device='gpu'(LightGBM),百万级样本训练时间可从小时级降到分钟级。 - 大规模分布式:XGBoost 支持 Spark / Dask / Kubernetes 上的分布式训练;LightGBM 支持分布式 GPU 训练——当单机内存放不下数据时考虑分布式。
- 数据格式新趋势(2025):三大库都已支持 Polars / Apache Arrow 格式输入。大数据场景下用 Polars 替代 pandas 可获得数倍的内存和速度提升,且不再需要 numpy/pandas 中间转换。
- Kaggle 表格数据竞赛:2016–2025 年 Kaggle 的结构化数据冠军方案绝大多数以 XGBoost / LightGBM 为核心,常与神经网络做 Stacking(一种集成方法,用一个元模型组合多个基模型的预测)。
- 金融信用评分与反欺诈:蚂蚁集团、各大银行的信用评分卡和交易反欺诈模型广泛使用 GBDT 家族,在表格数据上的 AUC 至今优于深度学习。
- 广告 CTR 预估:Facebook 2014 的 GBDT+LR 架构是经典方案,先用 GBDT 自动做特征交叉,再把叶子的 one-hot 喂给 LR;国内大厂广告系统至今大量使用 GBDT + 深度网络组合。
- 推荐系统排序:美团、阿里的召回后精排阶段,LightGBM 因训练快、内存省,长期作为精排模型的 baseline 和冷启动方案,详见 排序学习。
- 保险定价与理赔预测:用投保人的表格特征预测理赔概率和金额,GBDT 在稀疏表格数据上稳健且可解释。
- 医疗风险评估:电子健康记录(EHR)天然是表格数据,GBDT 在死亡率预测、再入院风险等任务上仍是首选。
- 网页搜索与信息检索排序:微软 Bing 早期大量使用 LambdaMART(一种专门用于排序的 GBDT 变体,直接优化 NDCG 指标),至今 LightGBM / XGBoost 的
lambdarank目标仍是学习排序(Learning to Rank)的标准工具。 - 工业物联网异常检测:传感器时序特征提取后的表格数据,GBDT 在故障检测、设备预测性维护中是常用的 baseline 模型。
- 大模型特征工程辅助:2024–2025 年的新趋势——用 LLM 生成文本特征的 embedding,再喂给 GBDT 做表格预测。例如用 LLM 提取商品描述的语义特征,再用 LightGBM 做 CTR 预估,比纯 GBDT 或纯深度模型都更灵活。
GBDT vs 深度学习:2025 年最新格局
Section titled “GBDT vs 深度学习:2025 年最新格局”表格数据上”树模型 vs 深度学习”的辩论已经持续了多年。以下是截至 2025 年的核心结论:
树模型仍占优的场景
Section titled “树模型仍占优的场景”Grinsztajn et al. (NeurIPS 2022) 的经典论文 “Why do tree-based models still outperform deep learning on tabular data?” 对 45 个数据集的实验表明:GBDT 在大多数中等规模表格数据上仍然优于深度学习。2024–2025 年的后续研究进一步确认了这一结论,原因分析:
- 表格数据的非平滑性:表格数据的决策边界往往不规则(不规则的特征交互、离散突变),树的轴对齐分裂天然适配,而 MLP 用平滑函数拟合需要指数级参数。
- 无特征工程需求:树自动处理特征选择和非线性交互,不需要像神经网络那样做归一化、嵌入等预处理。
- 鲁棒性:对超参数不敏感,默认参数就能出好结果;深度学习需要大量调参。
- 可解释性:SHAP 值能给出精确的特征贡献分解,满足金融/医疗领域的合规需求。
深度学习的挑战与进展
Section titled “深度学习的挑战与进展”深度学习在表格数据上的进展主要体现在以下方向(截至 2025):
| 方法 | 核心思路 | 状态 |
|---|---|---|
| FT-Transformer(2021) | 把表格特征嵌入为 token,用 Transformer 做特征交互 | 效果接近 GBDT,但训练慢 |
| SAINT(2021) | Row/column 双重注意力 + 对比学习预训练 | 大数据集上有优势 |
| TabPFN(2022, 2024 更新) | 基于元学习的 Transformer,零样本学习(zero-shot,无需在目标数据上训练即可预测) | 小数据集(<10K 行)上超越 GBDT,大数据集仍有差距 |
| TabPFN v2(2025) | 扩展到回归任务,支持更多行数和特征数 | 小到中等数据集上表现出色,推理仍需 GPU |
| ResNet/MLP 基线 | 简单的残差网络或多层感知机 | 在大数据集上有时可接近 GBDT,但调参成本高 |
| Gradient Boosted Neural Trees | 树的叶子用神经网络代替常数 | 学术探索阶段 |
| LLM for Tabular Data(2024–2025) | 用 LLM 理解列名语义,辅助特征工程 | 充当预处理/特征编码器,不替代 GBDT |
| Tree-based + NN 混合 | GBDT 提取叶子特征,NN 做后端精炼 | Kaggle 竞赛常用 Stacking 方案 |
2025 年的共识
Section titled “2025 年的共识”结论:对于结构化表格数据(典型的金融、保险、电商运营数据),GBDT 仍然是第一选择。深度学习的优势在非结构化数据(图像、文本、语音)和需要端到端学习的多模态场景。两者常以 Stacking 或混合架构互补使用。
一个务实的工作流:先用 GBDT(LightGBM/XGBoost)建立强基线 → 如果效果不满足需求,再尝试 FT-Transformer/TabPFN → 最终用 Stacking 融合。
何时该跳出 GBDT?
Section titled “何时该跳出 GBDT?”以下场景可以考虑深度学习替代或补充 GBDT:
| 场景 | 推荐方案 | 原因 |
|---|---|---|
| 极小数据集(<1K 行) | TabPFN v2 | 零样本学习,不需训练即可预测 |
| 多模态数据(表格 + 文本/图像) | 深度学习多模态网络 | GBDT 无法处理原始非结构化特征 |
| 数据量极大(>1 亿行)且特征交互复杂 | 深度学习 + 分布式训练 | GBDT 在超大数据上训练成本剧增 |
| 需要端到端梯度回传 | 深度学习 | GBDT 不可微,无法嵌入更大神经网络 |
2025–2026 最新进展
Section titled “2025–2026 最新进展”XGBoost 3.0+:从算法库到系统平台
Section titled “XGBoost 3.0+:从算法库到系统平台”XGBoost 3.0(2025 年 2 月发布)是一个里程碑版本,目前最新稳定版为 3.3.0。核心变化:
- 外部内存训练(External Memory)大幅增强:新增
ExtMemQuantileDMatrix类,支持 TB 级数据训练——数据不再需要全部载入内存,GPU 可用 CPU 内存作为数据缓存(借助 NVLink-C2C 互联,可处理 TB 级数据)。同时支持分布式外部内存训练(Spark / Dask),这是面向工业级超大数据场景的关键能力。 - SYCL 插件接近功能完整:支持 Intel GPU / FPGA 等 SYCL 设备,包括分布式训练和所有目标函数。XGBoost 正从”NVIDIA-only GPU”走向”多硬件后端”。
- GPU 显存优化:近稠密(near-dense)输入的 GPU 训练速度提升约 2 倍,整体显存使用大幅下降。
- 学习排序增强:三个分布式接口(Dask / Spark / PySpark)都支持按 query ID 自动排序;新增
lambdarank_score_normalization参数,更精细地控制排序梯度。 - Polars 初步支持:3.0 开始支持 Polars 数据框输入(类别特征尚不支持),趋势是与 Arrow 生态对齐。
- R 包全面重写:全新 R 接口,更符合 R 语言习惯,支持类别特征、QuantileDMatrix 和外部内存。
- 最低要求提升:Python 3.10,CUDA 12.0,移除了旧版二进制模型格式和阻塞式 CUDA 流。
LightGBM 4.x:Arrow 生态与多 GPU
Section titled “LightGBM 4.x:Arrow 生态与多 GPU”LightGBM 最新版 4.7.0(项目已从微软 GitHub 组织迁移至独立的 lightgbm-org)的重要变化:
- Polars 原生支持:通过
narwhals库实现,Python 包现在直接接受 Polars Series / DataFrame 作为输入,不再需要转成 pandas/numpy 中间格式——大数据场景下的内存和速度优势明显。 - 多 GPU 训练(NVIDIA)和 ROCm 支持(AMD):4.7.0 引入了基于 NCCL 的多 GPU 训练和首个 ROCm 构建,结束了 LightGBM GPU 只支持 NVIDIA 单卡的历史。
- Apache Arrow 深度集成:通过 Arrow PyCapsule Interface 实现与 Arrow 生态系统的互操作性,包括 Polars、DuckDB 等工具。
- 量化训练(Quantized Training):一种用低位宽(如 int8)表示直方图数据的训练方式,大幅提升 CPU 训练速度。4.4+ 支持类别特征上的量化训练。
- sklearn 兼容性:sklearn 接口新增
feature_names_in_属性、eval_X/eval_y参数(替代被弃用的eval_set),与 scikit-learn 1.6+ 全面兼容。 - Python 3.14 支持:4.7.0 正式支持 Python 3.14,最低要求提升至 Python 3.10。
CatBoost 1.2.x:Polars 与 Spark 4.0
Section titled “CatBoost 1.2.x:Polars 与 Spark 4.0”CatBoost 最新版 1.2.10 的主要更新:
- Polars 支持:1.2.9 开始支持 Polars 数据结构作为输入(特征、标签、权重、时间戳等均可使用 Polars 类型)。
- Spark 4.0.x / 4.1.x 支持:1.2.10 扩展了 Spark 集成,兼容最新的 Spark 4.x 大数据平台。
- CPU 性能优化:Lossguide 生长策略在 CPU 上提速约 1.4 倍;多线程原生特征数据初始化支持非 float32 的 numpy 类型。
- Python 3.14 支持:跟进最新 Python 版本,同时适配 scikit-learn 1.8 的接口变化。
- Rust 包成熟:Rust 绑定支持 Windows 和 Linux aarch64,
Model结构体实现了Synctrait。 - 零拷贝推理:新增
LoadFullModelZeroCopy用于 mmap 式零拷贝模型加载,降低推理延迟。
行业趋势:GBDT 与 LLM 的协同
Section titled “行业趋势:GBDT 与 LLM 的协同”2024–2025 年一个值得关注的趋势是 GBDT 与大语言模型(LLM)的协同使用,而非竞争:
- LLM 做特征工程 → GBDT 做预测:用 LLM 从非结构化文本(商品描述、用户评论、新闻)中提取语义特征 embedding,再把 embedding 和表格特征一起喂给 GBDT。这种”LLM-encoder + GBDT-predictor”架构在 CTR 预估、信用评估等任务上比纯深度模型更稳、更快、更可解释。
- LLM 辅助调参:2025 年出现了一些用 LLM agent 自动调参 GBDT 的实验性工作——LLM 理解数据集描述后自动选择超参数搜索空间,配合 Optuna 等框架做贝叶斯优化。
- GBDT 的预测结果作为 LLM 的工具调用:在智能体(Agent)场景中,GBDT 模型可以作为结构化预测工具被 LLM 调用,例如金融 Agent 调用信用评分模型辅助决策。
这些趋势说明:GBDT 并不会被深度学习或 LLM 取代,而是与它们形成互补的”特征提取(LLM)+ 结构化预测(GBDT)“分工。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| XGBoost | C++/Python | 二阶泰勒展开 + 正则化目标,竞赛与工业的标杆实现。3.0+ 支持外部内存、SYCL、Polars |
| LightGBM | C++/Python | 微软开源,Leaf-wise + 直方图 + GOSS/EFB,速度与内存最优。4.7+ 支持多 GPU 和 ROCm |
| CatBoost | Python | Yandex 开源,Ordered Boosting + 原生类别特征处理。1.2.10 支持 Polars 和 Spark 4.0 |
| scikit-learn | Python | 提供 GradientBoostingClassifier/HistGradientBoostingClassifier,纯 Python 实现适合教学,Hist 版本性能接近 LightGBM |
| H2O | Python/R/Java | 分布式 GBDT,支持企业级大数据训练 |
| Optuna | Python | 超参自动搜索框架,调 GBDT 超参的常用搭档 |
| SHAP | Python | 基于 Shapley 值的特征归因解释工具,GBDT 解释的事实标准 |
| Boruta | Python | 基于”影子特征”的全自动特征选择算法,常与 GBDT 配合做特征筛选 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 梯度提升 | Gradient Boosting | 每轮用损失函数的负梯度作为目标训练新基学习器的加法模型方法 |
| 伪残差 | Pseudo-Residual | 损失函数对当前模型预测值的负梯度,平方损失下等于普通残差 |
| 缩减 | Shrinkage / Learning Rate | 缩小每棵树贡献的系数 ,越小越稳但需要的树越多 |
| 加法模型 | Additive Model | 最终预测是若干基函数加权和的模型,GBDT 是典型代表 |
| 直方图算法 | Histogram-based | 把连续特征分桶成直方图加速分裂点查找,LightGBM/XGBoost 标配 |
| 直方图减法 | Histogram Subtraction | 兄弟节点的直方图可由父节点减去另一边得到,使计算量减半 |
| Leaf-wise | Leaf-wise Growth | 总是优先扩展增益最大的叶子(而非按层长),收敛更快但易过深 |
| Level-wise | Level-wise Growth | 按层逐层生长,同一层所有节点同时分裂,XGBoost 默认策略 |
| GOSS | Gradient-based One-Side Sampling | LightGBM 技术,保留梯度大的样本、随机采样梯度小的样本 |
| EFB | Exclusive Feature Bundling | LightGBM 技术,把互斥的稀疏特征捆绑成稠密特征降维 |
| Ordered Boosting | Ordered Boosting | CatBoost 技术,用排列顺序训练以消除目标泄漏导致的过拟合 |
| Ordered Target Statistics | Ordered Target Statistics | CatBoost 技术,计算类别编码时只用前序样本避免数据泄漏 |
| 二阶泰勒展开 | Second-order Taylor Expansion | XGBoost 用一阶梯度 和二阶梯度 近似损失,分裂增益更准 |
| 牛顿步长 | Newton Step | 利用二阶导数信息的优化步 ,XGBoost 叶子权重的本质 |
| Hessian | Hessian | 损失函数对预测值的二阶导数 ,XGBoost 中反映模型在该样本上的确定性 |
| 分裂增益 | Split Gain | XGBoost 中分裂节点带来的目标函数下降量,用 计算 |
| 对称树 | Oblivious Tree | CatBoost 使用的树结构,同一层所有节点用相同分裂条件,推理快 |
| 目标泄漏 | Target Leakage | 训练时使用了包含标签信息的统计量,导致验证集上过拟合 |
| 早停 | Early Stopping | 监控验证集指标,连续若干轮不提升即停止训练的正则化策略 |
| Stacking | Stacking | 用一个元模型组合多个基模型预测的集成方法,GBDT 常与 NN 做 Stacking |
| 量化训练 | Quantized Training | 用低位宽(如 int8)表示直方图数据加速训练,LightGBM 4.x 引入 |
| 外部内存训练 | External Memory Training | 数据不全载入内存,分批从磁盘/外部存储读取训练,XGBoost 3.0 大幅增强 |
| NDCG | Normalized Discounted Cumulative Gain | 排序质量评价指标,LambdaMART / lambdarank 直接优化的目标 |
- Friedman,「Greedy Function Approximation: A Gradient Boosting Machine」(Annals of Statistics, 1999):GBM 原始论文,提出函数空间的梯度下降思想,所有梯度提升算法的理论源头。
- Friedman,「Stochastic Gradient Boosting」(Computational Statistics & Data Analysis, 2002):引入行/列子采样,显著提升泛化与速度,现代 GBDT 实现都默认使用。
- Chen & Guestrin,「XGBoost: A Scalable Tree Boosting System」(KDD 2016):XGBoost 论文,二阶展开 + 正则化目标 + 系统级优化,引用量极高。
- Ke et al.,「LightGBM: A Highly Efficient Gradient Boosting Decision Tree」(NeurIPS 2017):微软提出 GOSS 与 EFB,训练速度提升 20 倍以上。
- Prokhorenkova et al.,「CatBoost: unbiased boosting with categorical features」(NeurIPS 2018):Yandex 提出 Ordered Boosting,解决类别特征与目标泄漏问题。
- Grinsztajn et al.,「Why do tree-based models still outperform deep learning on tabular data?」(NeurIPS 2022):实验证明 GBDT 在多数表格数据上仍优于深度学习,解释了其为何长盛不衰。
- Gorishniy et al.,「On Embeddings for Numerical Features in Tabular Deep Learning」(ICML 2022):FT-Transformer 论文,分析表格数据上深度学习的特征嵌入方法,是 DL 挑战 GBDT 的代表作。
- Hollmann et al.,「TabPFN: A Transformer That Solves Small Tabular Classification Problems in a Second」(ICLR 2022, 2024 更新):零样本表格学习的突破性工作,小数据集上超越 GBDT。
- Lundberg & Lee,「A Unified Approach to Interpreting Model Predictions」(NeurIPS 2017):SHAP 论文,提出基于 Shapley 值的统一模型解释框架,GBDT 解释的事实标准。
- XGBoost 3.0 Release Notes (2025):官方文档,外部内存、SYCL、GPU 优化等里程碑变化的权威说明。
- LightGBM 4.7.0 Release Notes (2025):GitHub Releases,Polars 支持、多 GPU、ROCm 等最新特性。