
LLM 微调技术
本页介绍 LLM 应用生态中让通用模型变成领域专家的关键技术——LLM 微调(Fine-tuning):在已有大模型基础上用领域数据继续训练,使其适配特定任务或风格。它是 LLM 应用生态概览中的”专业培训”层,和 RAG 互补——RAG 是”翻书”,微调是”内化知识”。本页覆盖完整的微调流程:从 SFT 数据准备、LoRA 原理与数学直觉、QLoRA/DoRA/GaLore 等 PEFT 新方法、偏好对齐(DPO/RLHF/GRPO)、训练基础设施(DeepSpeed/FSDP)、评估与灾难性遗忘,到 2025 年推理模型蒸馏与函数调用微调的新趋势。更深入的 PEFT 方法对比见 PEFT 参数高效微调全景,对齐技术细节见 AI 安全对齐技术 与 RLHF 与 LLM 训练。
预训练 = 上大学读万卷书,微调 = 入职培训学专业技能,对齐 = 师傅手把手教规矩。
- 全参微调(Full Fine-tuning):把模型所有参数都重新训练——效果好但代价极高,需要庞大 GPU 算力和显存,一般人玩不起。
- PEFT(参数高效微调):只调一小部分参数,其余冻结。效果接近全参微调,但成本低一个数量级。LoRA 是最流行的 PEFT 方法。
- LoRA(低秩适配):不改变原始权重,而是在旁边加一个”小补丁”(低秩矩阵),只训练这个小补丁——补丁参数量通常是原模型的 0.1%-1%。
- QLoRA:在 LoRA 基础上把原始权重量化到 4-bit,一张消费级显卡就能微调大模型。
- SFT(监督微调):用”指令→回答”对的数据监督训练,教模型按期望格式和能力回答。
- 偏好对齐(Preference Alignment):SFT 之后用人类/AI 偏好数据进一步校准,让模型回答”更好、更安全、更符合期望”——典型方法有 RLHF、DPO、GRPO。
微调全景:从原始模型到上线
Section titled “微调全景:从原始模型到上线”一个完整的 LLM 微调项目通常遵循下面的流水线。注意”微调”在狭义上特指 SFT,但在工程语境中常涵盖从 SFT 到对齐再到评估的整条链路。
下面按这条链路逐段展开。
SFT 数据准备
Section titled “SFT 数据准备”SFT(Supervised Fine-Tuning,监督微调)是微调的第一步,也是决定效果上限的关键环节。业界有一句经验之谈:“数据决定了下限,算法决定了上限”——再好的训练算法也救不了脏数据。
主流的 SFT 数据有两大类格式:
1. 指令格式(Instruction Format)
最简单的形式,适合单轮任务:
{ "instruction": "把下面这段话翻译成英文", "input": "今天天气真好", "output": "The weather is nice today."}2. 对话格式(ChatML / 多轮对话)
现代模型普遍采用 ChatML(Chat Markup Language,OpenAI 提出的对话标记语言)或类似的 <|im_start|> / <|im_end|> 结构来组织多轮对话:
{ "messages": [ {"role": "system", "content": "你是一个有帮助的助手。"}, {"role": "user", "content": "解释什么是梯度下降"}, {"role": "assistant", "content": "梯度下降是一种优化算法……"} ]}不同基座模型有不同的对话模板(chat template)——Llama 用 [INST]...[/INST],Qwen 用 <|im_start|>,DeepSeek 又有自己的格式。用错模板是微调失败最常见的坑之一:模型在训练时看到的 token 序列和推理时不一致,导致效果骤降。HuggingFace 的 apply_chat_template 方法会自动处理这件事,务必调用它而不是手拼字符串。
数据质量决定成败
Section titled “数据质量决定成败”高质量 SFT 数据的几条经验法则:
- 质量 > 数量:LIMA 论文证明仅 1000 条人工精心撰写的高质量样本就能微调出很强的对话模型。反之,十万条低质量自动生成数据反而会让模型学坏。一般来说,500-5000 条精标数据足以让模型学会一个新任务的格式与风格。
- 多样性(Diversity):指令的句式、长度、任务类型要尽量分散。如果 80% 样本都是”请总结以下文章”,模型会变成只会做摘要的单功能机器。
- 去重与去污染:重复样本会让模型过拟合特定表达;还要剔除与评测集(benchmark)重合的数据,否则评测分数虚高。
- 难度梯度:混合简单和困难样本。全是简单样本模型学不到深度,全是困难样本模型容易放弃(loss 不下降)。
课程学习(Curriculum Learning)
Section titled “课程学习(Curriculum Learning)”课程学习借鉴人类学习的思路——先易后难。具体做法是给训练数据标注难度等级,按从易到难的顺序喂给模型,而不是随机打乱。直觉上,这能让模型先建立基础模式再挑战复杂样本,收敛更稳。实践中效果因任务而异,对代码生成、数学推理这类有明确难度梯度的任务收益更明显。HuggingFace Trainer 可以通过自定义 DataCollator 或对数据集预排序来实现课程顺序。
LoRA 深入:为什么低秩有效
Section titled “LoRA 深入:为什么低秩有效”LoRA 是当前最主流的 PEFT 方法。这里展开它的数学原理,理解了原理才能正确调参。更全面的方法对比见 PEFT 参数高效微调全景。
核心假设:权重更新是低秩的
Section titled “核心假设:权重更新是低秩的”LoRA 的论文提出了一个关键经验观察:预训练大模型在下游任务上的权重更新量 是低秩的——即这个更新可以由少量维度近似表达,并没有用到矩阵的全部”自由度”。这和”奥卡姆剃刀”精神一致:模型适应一个新任务通常只需要在少数几个方向上做调整。
数学形式:W = W₀ + BA
Section titled “数学形式:W = W₀ + BA”记某一层的原始权重矩阵为 (形状 )。全参微调会学一个完整的更新矩阵 (同样 )。LoRA 把这个更新分解为两个小矩阵的乘积:
其中:
- B 形状为 (“上行投影”)
- A 形状为 (“下行投影”)
- r 是秩(rank),满足
- (alpha) 是缩放系数,用 解耦秩与学习率
训练时冻结 ,只训练 B 和 A。
参数量对比:原始权重有 个参数;LoRA 只需 个。以 、 为例:全量是约 1678 万参数,LoRA 只要约 6.5 万,缩减 250 多倍。
初始化技巧:A 用随机高斯初始化,B 初始化为零——保证训练开始时 ,模型输出和原始模型完全一致,然后随着训练逐步”长出”更新。这个设计很巧妙:它让 LoRA 一开始是”透明的”,不会破坏预训练知识。
秩 r 如何选择
Section titled “秩 r 如何选择”r 是 LoRA 最重要的超参数,它控制补丁的”表达能力”:
| r 取值 | 适用场景 | 特点 |
|---|---|---|
| 4 - 8 | 风格迁移、轻量任务、单领域 | 参数最少,最不容易过拟合,训练快 |
| 16 - 32 | 多任务、中等复杂度领域(最常用) | 效果与成本的良好平衡 |
| 64 - 128 | 跨领域、注入大量新知识、数学/代码 | 容量大但参数多,需更多数据防止过拟合 |
经验上 r 不是越大越好——r 过大而数据不足时,补丁会”记住”训练数据的噪声,泛化变差。多数任务 是个安全起点。
目标模块选择(target_modules)
Section titled “目标模块选择(target_modules)”LoRA 可以加在 Transformer 的任何线性层上。选择哪些层直接影响效果与参数量:
- 最小配置
["q_proj", "v_proj"]:只对注意力的 Query 和 Value 加 LoRA,是 LoRA 原论文的默认,参数最少。 - 推荐配置
["q_proj", "k_proj", "v_proj", "o_proj"]:覆盖全部注意力投影,效果更好,参数略多。 - 全量配置(含 FFN)
["q_proj","k_proj","v_proj","o_proj","gate_proj","up_proj","down_proj"]:再加上前馈网络(FFN, Feed-Forward Network)的三个线性层。2024 年后的实践普遍推荐这种”all-linear”配置——因为注入新知识主要发生在 FFN 层,只调注意力往往不够。代价是参数量增加 3-5 倍,但效果提升明显。
# 现代 LoRA 推荐配置:覆盖所有线性层lora_config = LoraConfig( r=16, lora_alpha=32, # 通常设为 r 的 2 倍 lora_dropout=0.05, target_modules=[ "q_proj", "k_proj", "v_proj", "o_proj", # 注意力 "gate_proj", "up_proj", "down_proj", # FFN ], task_type="CAUSAL_LM",)超越 LoRA:QLoRA、DoRA、GaLore
Section titled “超越 LoRA:QLoRA、DoRA、GaLore”LoRA 之后涌现了一批改进方法,各有侧重。下面是最重要的几个,完整对比见 PEFT 参数高效微调全景。
QLoRA:让单卡微调大模型成为可能
Section titled “QLoRA:让单卡微调大模型成为可能”QLoRA(Quantized LoRA)在 LoRA 基础上把基座权重量化到 4-bit,从而把显存占用压到原来的 1/4,再在上面训练 LoRA 补丁(补丁本身仍用 fp16/bf16 高精度训练)。它首次让单张 48GB 显卡能微调 65B 参数的模型。QLoRA 有两个关键创新:
- NF4(NormalFloat 4-bit)量化:一种为正态分布权重量身设计的数据类型。由于大模型权重基本服从正态分布,NF4 的量化分位点对齐正态分布的分位数,信息损失比均匀量化(如 INT4)更小。
- 双重量化(Double Quantization):量化过程本身会产生一组缩放因子(scaling factor),这些因子也要占显存。双重量化把这组缩放因子再量化一次(从 fp32 量化到 8-bit),进一步省下约 0.4 bit/参数的显存。听起来微不足道,但在 70B 模型上能省出几十 GB。
- 分页优化器(Paged Optimizer):用 NVIDIA 的统一内存(unified memory)把优化器状态在 GPU 显存和 CPU 内存之间按需换页,避免显存峰值溢出导致 OOM(Out Of Memory,显存不足崩溃)。
QLoRA 的权衡:量化会带来少量精度损失(通常 benchmark 下降 1-2%),但换来 4 倍以上的显存节省,对消费级硬件极其友好。生产环境中如果显存够用,优先用 LoRA + bf16;显存紧张时 QLoRA 是首选。
DoRA(Weight-Decomposed Low-Rank Adaptation,2024)
Section titled “DoRA(Weight-Decomposed Low-Rank Adaptation,2024)”DoRA 把权重矩阵分解为**方向(direction)和大小(magnitude)**两部分:只对”方向”做低秩更新,对”大小”单独学一个标量缩放。直觉上,LoRA 用同一个低秩补丁同时改变方向和大小,而 DoRA 把两者解耦后各自优化,更新更精细。论文报告在相同参数量下 DoRA 效果优于 LoRA,尤其在大 rank 和知识密集任务上。代价是训练略慢、合并逻辑稍复杂。
GaLore(Gradient Low-Rank Projection,2024)
Section titled “GaLore(Gradient Low-Rank Projection,2024)”GaLore 走了另一条路:它不分解权重,而是分解梯度——把梯度投影到一个低秩子空间里再更新,从而大幅减少优化器状态的显存。它的独特优势是支持全参微调:不需要冻结原始权重,却能把 AdamW 的优化器状态显存降到接近 LoRA 的水平。这对需要全参微调但显存有限的场景(如训练中小模型或长上下文)非常有价值。
其他值得关注的 PEFT 方法
Section titled “其他值得关注的 PEFT 方法”- PiSSA(2024):用 SVD 分解原始权重本身(而非随机初始化 LoRA 补丁),把主成分留给可训练部分、残差冻结,理论上比标准 LoRA 容量利用率更高。
- LoRA +(2024):给 A 和 B 设置不同的学习率(B 的学习率远大于 A),论文证明这能显著加速收敛。
- rsLoRA:修改缩放系数为 ,让大 rank 训练更稳定。
偏好对齐流程:SFT → DPO/RLHF → 部署
Section titled “偏好对齐流程:SFT → DPO/RLHF → 部署”SFT 教会模型”怎么回答”,但对齐教它”回答得多好”。一个模型可以格式正确、语法无误,却仍然啰嗦、回避问题、或给出不安全的建议。偏好对齐用”好坏对比”数据来校准这种偏好。
为什么需要单独的对齐阶段
Section titled “为什么需要单独的对齐阶段”SFT 的数据是”标准答案”,每个问题只有一个 gold answer。但真实世界里很多问题没有唯一正确答案,而是有”更好的回答”和”更差的回答”。偏好对齐用 (prompt, chosen_response, rejected_response) 三元组来训练——告诉模型”在同样的 prompt 下,chosen 比 rejected 更好”,从而把模型的输出分布推向人类偏好。
DPO:跳过奖励模型的对齐方法
Section titled “DPO:跳过奖励模型的对齐方法”DPO(Direct Preference Optimization,直接偏好优化) 是 2023 年提出、2024 年迅速成为主流的对齐方法。传统的 RLHF 需要先训练一个奖励模型(Reward Model),再用 PPO 等强化学习算法优化——流程长、训练不稳、超参敏感。DPO 的洞察是:可以从偏好数据直接推导出最优策略,绕过显式的奖励模型。
DPO 的损失函数(简化形式):
直觉解释:
- 是正在训练的策略(policy,即模型), 是 SFT 后的参考模型(reference model,冻结不动)。
- 是偏好(chosen/winning)回答, 是被拒(rejected/losing)回答。
- 损失鼓励模型相对参考模型,更多提升 chosen 的概率、压低 rejected 的概率。
- 是温度系数: 大则约束强、模型不敢偏离参考模型太远; 小则模型可以大幅改变行为。典型取值 0.1-0.5。
- 外层的 sigmoid 把差异压到 ,再用负对数似然作为损失。
这个公式看起来复杂,但本质是一个**对比学习(contrastive learning)**目标:拉近好回答、推远坏回答,且都以参考模型为锚点。相比 RLHF 的 PPO,DPO 不需要训练奖励模型、不需要在线采样、训练稳定得多,代码也简单一大截。这就是为什么 2024-2025 年大量开源模型(Zephyr、Tulu、Qwen 对齐版)都采用 DPO 或其变体。
DPO 的数据需求:每个样本需要一对”好/坏”回答。这比 SFT 的单一答案更贵,但可以批量制造——常用做法是让 SFT 模型对同一 prompt 采样多个回答,再用人工或一个强模型(如 GPT-4)做偏好排序(这种方法称为 RLAIF,AI 反馈强化学习)。
RLHF vs DPO vs GRPO 对比
Section titled “RLHF vs DPO vs GRPO 对比”| 方法 | 是否需要奖励模型 | 训练稳定性 | 在线采样 | 典型用途 | 代表模型 |
|---|---|---|---|---|---|
| RLHF (PPO) | 是(单独训练 RM) | 较差,超参敏感 | 是(训练中采样) | 对齐质量天花板最高 | InstructGPT, GPT-4 |
| DPO | 否(隐式推导) | 好,接近 SFT | 否(离线数据) | 主流开源对齐 | Zephyr, Tulu |
| GRPO | 否(组内相对奖励) | 好,适合推理任务 | 是(组采样) | 推理模型对齐 | DeepSeek R1 |
GRPO:面向推理模型的新选择
Section titled “GRPO:面向推理模型的新选择”GRPO(Group Relative Policy Optimization,组相对策略优化) 是 DeepSeek 在 R1 训练中提出的强化学习方法,2025 年随 R1 开源后迅速流行。它针对推理(reasoning)任务设计:对一个 prompt 采样一组(group)回答,用组内的相对排名作为奖励信号,省去了训练单独的价值模型(value model)。对数学、代码这类有客观正误的任务,GRPO 用规则验证(如代码能否通过测试、数学答案是否正确)作为奖励,不需要人工标注偏好,这让大规模推理能力训练变得可行。详见 推理模型技术 与 RLHF 与 LLM 训练。
训练基础设施
Section titled “训练基础设施”微调大模型绕不开 GPU 显存和分布式训练。下面讲清两件事:显存到底花在哪里,以及主流的分布式方案。
显存账本:钱都花在哪了
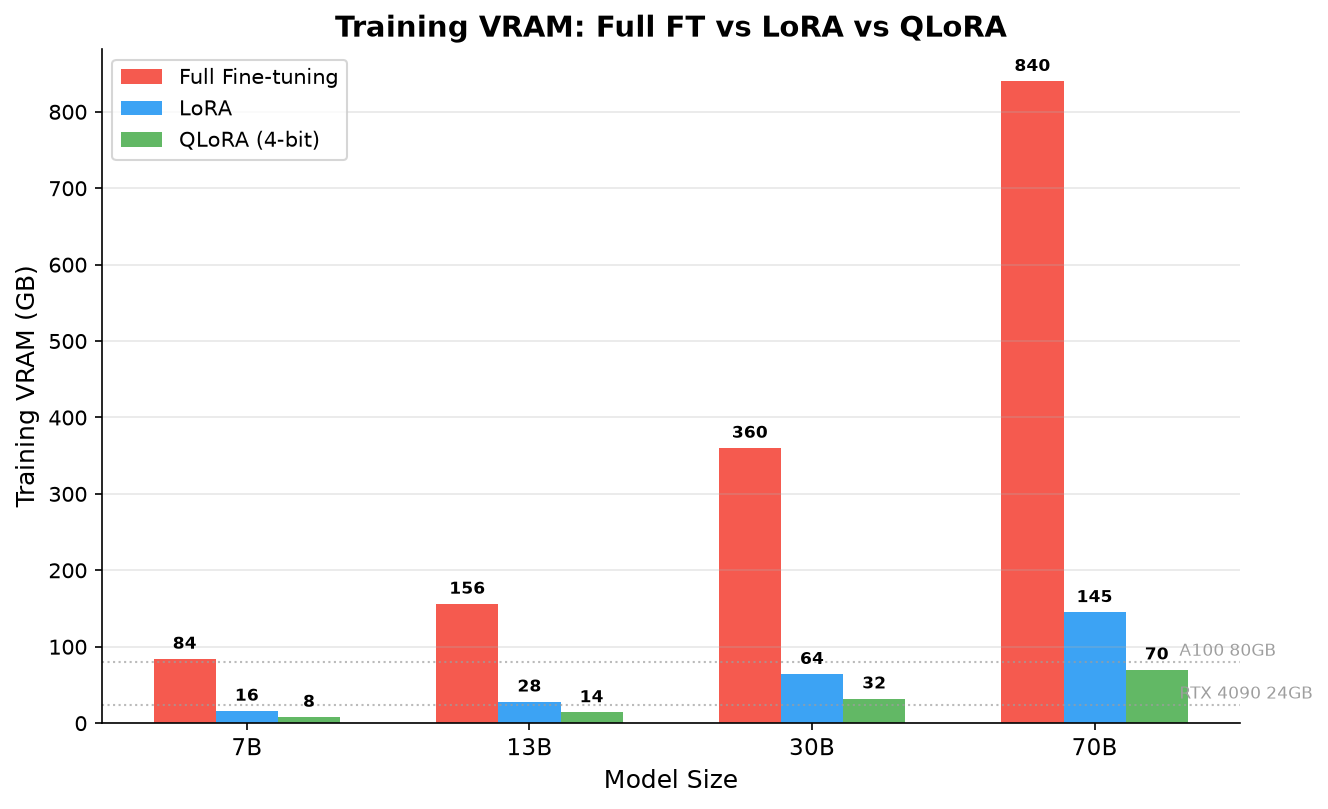
Section titled “显存账本:钱都花在哪了”训练一个模型,显存主要被四部分吃掉。以 70B 参数、bf16、AdamW 优化器为例:
| 组成 | 大小(相对参数量) | 70B 模型实际占用 |
|---|---|---|
| 模型权重(bf16,2 bytes/param) | 2× | 140 GB |
| 梯度(bf16) | 2× | 140 GB |
| AdamW 一阶动量 m(fp32) | 4× | 280 GB |
| AdamW 二阶动量 v(fp32) | 4× | 280 GB |
| 合计 | 12× | ≈ 840 GB |
也就是说,全参微调一个 70B 模型需要约 840GB 显存——11 张 80GB 的 H100。加上激活值(activations,前向中间结果),还要更多。这就是为什么全参微调极其昂贵,而 PEFT(只训练 0.1% 参数)能把优化器状态和梯度几乎归零,显存骤降到几十 GB。
QLoRA 进一步把模型权重量化到 4-bit(0.5 bytes/param),70B 模型权重从 140GB 压到 35GB,加上小 LoRA 补丁,单张 80GB 显卡就能微调。
DeepSpeed ZeRO:分而治之
Section titled “DeepSpeed ZeRO:分而治之”DeepSpeed 的 ZeRO(Zero Redundancy Optimizer,零冗余优化器) 是全参微调的主力工具。它把训练状态在多张 GPU 之间切分,消除冗余:
- ZeRO-1:只切分优化器状态(Adam 的 m/v)。节省适中,通信开销小。
- ZeRO-2:切分优化器状态 + 梯度。多数 N 卡场景的甜点配置。
- ZeRO-3:切分优化器 + 梯度 + 模型权重。最省显存(70B 模型几张卡就能跑全参),但每次前向/反向都要跨卡聚合权重,通信开销最大。
经验法则:显存够用就停在 ZeRO-2;显存不够再上 ZeRO-3。
FSDP:PyTorch 原生方案
Section titled “FSDP:PyTorch 原生方案”FSDP(Fully Sharded Data Parallel,全分片数据并行) 是 PyTorch 2.x 内置的分布式训练方案,思路和 ZeRO-3 几乎一致(切分权重+梯度+优化器),但它是 PyTorch 原生 API,和 transformers、accelerate 集成更紧密,配置更简单。2024-2025 年的新项目越来越多从 DeepSpeed 迁移到 FSDP,因为后者不需要写复杂的 JSON 配置、调试更直观。
多 GPU 训练快速对照
Section titled “多 GPU 训练快速对照”| 场景 | 推荐方案 | 显存效率 | 配置难度 |
|---|---|---|---|
| 单卡,PEFT | QLoRA / LoRA | 高 | 低 |
| 多卡,PEFT | DDP(数据并行) | 中 | 低 |
| 多卡,全参微调 | FSDP 或 DeepSpeed ZeRO-2/3 | 高 | 中 |
| 多机多卡,全参 | DeepSpeed ZeRO-3 + 混合精度 | 最高 | 高 |
微调中的评估
Section titled “微调中的评估”训练不能”训完就上线”,必须建立评估闭环。
三层评估体系
Section titled “三层评估体系”-
训练/验证损失曲线(Loss Curve) 监控 training loss 和 validation loss 的走势。健康曲线的特征:两者同步下降,validation loss 平滑收敛。危险信号是 validation loss 开始反弹而 training loss 继续下降——这是过拟合(overfitting,模型记住训练数据而非学到规律)的典型表现。一旦看到反弹就该早停(early stopping)。
-
Benchmark 自动评测 在标准测试集上跑自动指标:
- 通用能力:MMLU(多任务知识)、BBH(推理)、HumanEval(代码)
- 中文能力:C-Eval、CMMLU
- 领域专用:医学用 MedQA、法律用法考题库 要在微调前后都跑同一套 benchmark,确认微调让目标任务提升的同时没有把通用能力搞垮(见下文灾难性遗忘)。
-
人工 / A/B 评测 Benchmark 覆盖有限,真实体验要看人工盲评或线上 A/B 测试。常用做法:让微调模型和基座模型对同一批真实 prompt 各生成回答,由人工或 GPT-4 做”盲选”(不知道哪个是哪个),统计胜率。这是最终上线决策的依据。
评估检查清单(Eval Checklist)
Section titled “评估检查清单(Eval Checklist)”- 微调前后跑同一套 benchmark,确认目标任务提升、通用能力未明显下降
- 验证 loss 曲线没有过拟合拐点
- 人工盲评胜率 > 基座模型
- 测试与训练数据无泄漏(去重检查)
- 对安全相关 prompt 做红队测试(见 AI 安全对齐技术)
灾难性遗忘(Catastrophic Forgetting) 指模型在学习新任务/新数据时,把预训练阶段学到的旧知识”忘掉”的现象。典型表现:用医疗数据微调后,模型医疗问答变强了,但让它写代码、做翻译却明显退步——它把”医疗”和”通用能力”当成了零和博弈。
为什么会发生
Section titled “为什么会发生”神经网络的参数是共享的——所有知识存在同一组权重里。新数据驱动梯度更新时,会改写那些原本编码旧知识的参数,于是旧能力被覆盖。全参微调因为更新所有参数,遗忘最严重;PEFT 只更新小补丁,原权重冻结,天然有保护作用。
| 策略 | 原理 | 适用场景 |
|---|---|---|
| 混入通用数据 | 在领域数据中掺入 10-30% 通用对话/指令数据,让模型”边学新边复习旧” | 所有微调场景,强烈推荐 |
| 使用 PEFT (LoRA/QLoRA) | 冻结原权重,只训练小补丁,原知识物理隔离 | 显存允许时首选 |
| 降低学习率 + 少 epoch | 减缓更新幅度,避免粗暴覆盖 | 全参微调时尤其重要 |
| 弹性权重 consolidation (EWC) | 对重要参数施加正则惩罚,限制其大幅变动 | 研究性质,工程中少见 |
| 多 LoRA 切换 | 为不同任务训练不同 LoRA,推理时按需加载,互不干扰 | 多任务服务化场景 |
实践中最有效的组合是 “LoRA + 混入通用数据”——简单、稳定、成本低。
2025 趋势
Section titled “2025 趋势”趋势一:微调推理模型(DeepSeek R1 蒸馏)
Section titled “趋势一:微调推理模型(DeepSeek R1 蒸馏)”2025 年 DeepSeek 开源 R1 推理模型后,社区掀起了一波**推理能力蒸馏(distillation)**热潮:把 R1(671B 大模型)在数学/代码上的”思考过程”(chain-of-thought 长链推理)作为 SFT 数据,去微调小模型(7B/14B/32B 的 Qwen、Llama),让小模型也获得强推理能力。DeepSeek 官方发布的 R1-Distill 系列证明:用 80 万条高质量推理轨迹做 SFT,一个 7B 模型的数学能力可以逼近甚至超越 GPT-4 级别。
这改变了微调的游戏规则——不再只是教小模型”格式”,而是把大模型的”思维方式”迁移过去。关键技术点:
- 数据是带推理过程的
(问题, 长思考过程, 最终答案),而非直接(问题, 答案)。 - 用 R1 生成思考轨迹时要做拒绝采样(rejection sampling)——只保留最终答案正确的轨迹,过滤掉”想错了”的样本。
- 小模型学的是推理的”套路”而非死记答案,因此泛化到没见过的题目上仍有效。
详见 推理模型技术。
趋势二:GRPO 成为 RLHF 的替代
Section titled “趋势二:GRPO 成为 RLHF 的替代”如前所述,GRPO 用组内相对排名作为奖励,跳过价值模型,特别适合有客观验证器的推理任务。2025 年大量社区项目(Open-R1、TRL 的 GRPO 训练器、verl 框架)都内置了 GRPO 支持,让普通团队也能复现 R1 式的推理能力训练。GRPO 的意义在于:它让强化学习重新成为”普通团队能用得起”的对齐工具——之前 PPO 的工程门槛把大多数人挡在了门外。
趋势三:函数调用微调(Function Calling Fine-tuning)
Section titled “趋势三:函数调用微调(Function Calling Fine-tuning)”随着 Agent 应用爆发,让模型可靠地输出结构化函数调用(function call)成了刚需。2025 年的主流做法是用大量 (用户请求, 工具定义, 正确的函数调用 JSON) 数据做 SFT,让模型学会在合适时机调用工具、传正确参数。Qwen、Llama 等模型都提供了官方的 function calling 微调数据格式。这一方向和 MCP 与工具调用、Agent 模式 紧密相关。
趋势四:Unsloth 让消费级微调更快更省
Section titled “趋势四:Unsloth 让消费级微调更快更省”Unsloth 是 2024 年开源、2025 年持续迭代的微调加速库。它通过手写 Triton kernel、优化 autograd、减少内存拷贝,把 LoRA/QLoRA 微调速度提升 2-5 倍、显存省 60-80%,且 API 和 HuggingFace transformers / trl 完全兼容——几行代码就能替换。在一张 24GB 的 RTX 4090 上,Unsloth 能用 QLoRA 微调 7B-14B 模型,把微调从”服务器专属”推向”个人开发者可用”。它对 Llama、Qwen、DeepSeek、Gemma 等主流模型都有专门优化。
完整 LoRA SFT 训练脚本
Section titled “完整 LoRA SFT 训练脚本”下面是一个接近生产可用的 LoRA SFT 脚本,用 HuggingFace 生态(transformers + peft + trl):
# train_lora_sft.py —— 用 LoRA 微调一个 7B 模型import torchfrom datasets import load_datasetfrom transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArgumentsfrom peft import LoraConfig, get_peft_model, prepare_model_for_kbit_trainingfrom trl import SFTTrainer, SFTConfig
# 1. 加载 tokenizer 和基座模型(用 bf16,避免 fp16 的溢出问题)model_id = "Qwen/Qwen2.5-7B-Instruct"tokenizer = AutoTokenizer.from_pretrained(model_id)tokenizer.pad_token = tokenizer.eos_token  # 多数基座没有 pad token,需手动设
model = AutoModelForCausalLM.from_pretrained(    model_id,    torch_dtype=torch.bfloat16,    device_map="auto",          # 自动分配到多卡    attn_implementation="sdpa", # 用 PyTorch SDPA 注意力,比 eager 快)
# 2. 配置 LoRA(全线性层 + r=16,2025 年推荐配置)lora_config = LoraConfig(    r=16,    lora_alpha=32,    lora_dropout=0.05,    bias="none",    target_modules=[        "q_proj", "k_proj", "v_proj", "o_proj",        "gate_proj", "up_proj", "down_proj",    ],    task_type="CAUSAL_LM",)model = get_peft_model(model, lora_config)model.print_trainable_parameters()  # 应显示约 0.5%-1%
# 3. 加载并预处理数据(用 chat template 自动套对话格式)dataset = load_dataset("json", data_files="my_sft_data.jsonl", split="train")
def format_example(example):    text = tokenizer.apply_chat_template(        example["messages"], tokenize=False, add_generation_prompt=False    )    return {"text": text}dataset = dataset.map(format_example, remove_columns=dataset.column_names)
# 4. 训练training_args = SFTConfig(    output_dir="./qwen-lora-output",    num_train_epochs=3,    per_device_train_batch_size=4,    gradient_accumulation_steps=4,  # 等效 batch_size=16    learning_rate=2e-4,             # LoRA 通常用 1e-4 ~ 5e-4,比全参高一个数量级    warmup_ratio=0.05,    lr_scheduler_type="cosine",    bf16=True,    logging_steps=10,    save_strategy="epoch",    gradient_checkpointing=True,    # 用算力换显存,省 30-50% 显存)
trainer = SFTTrainer( model=model, train_dataset=dataset, args=training_args,)trainer.train()trainer.save_model("./qwen-lora-final") # 只存 LoRA 权重,约几十 MB关键参数解释:
learning_rate=2e-4:LoRA 的学习率比全参微调(通常 1e-5 ~ 5e-5)高一个数量级,因为只训练少量参数、需要更大的步长。gradient_accumulation_steps:小显存用小 batch + 累积多次梯度来模拟大 batch,等效 batch size =per_device_batch × accumulation × num_gpus。gradient_checkpointing=True:丢弃前向中间结果、反向时重算,用约 20% 算力换 30-50% 显存,显存紧张时必开。
DPO 训练配置
Section titled “DPO 训练配置”SFT 之后的 DPO 阶段,用 trl 的 DPOTrainer:
# train_dpo.py —— SFT 后的偏好对齐from datasets import load_datasetfrom transformers import AutoModelForCausalLM, AutoTokenizerfrom trl import DPOTrainer, DPOConfig
# 参考模型 = SFT 后的模型;策略模型也是它的一份拷贝,会被训练model_id = "./qwen-lora-merged"  # SFT 后合并的模型model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype=torch.bfloat16)ref_model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype=torch.bfloat16)tokenizer = AutoTokenizer.from_pretrained(model_id)
# 偏好数据格式:每条包含 prompt + chosen + rejecteddataset = load_dataset("json", data_files="preference_data.jsonl", split="train")
dpo_config = DPOConfig(    output_dir="./dpo-output",    num_train_epochs=1,           # DPO 通常 1-2 epoch 就够,多了容易过拟合    per_device_train_batch_size=2,    gradient_accumulation_steps=8,    learning_rate=5e-7,           # DPO 学习率要很小,1e-7 ~ 1e-6    beta=0.1,                     # KL 约束强度,0.1 是常用起点    bf16=True,    gradient_checkpointing=True,)
trainer = DPOTrainer(    model=model,    ref_model=ref_model,    args=dpo_config,    train_dataset=dataset,    processing_class=tokenizer,)trainer.train()
DPO 学习率极小(5e-7):因为 DPO 是在 SFT 模型基础上做精细微调,学习率一大就会把 SFT 学到的东西冲掉。这是新手最常踩的坑——用 SFT 的学习率跑 DPO 会直接把模型训崩。
偏好数据 preference_data.jsonl 的格式:
{"prompt": "解释量子纠缠", "chosen": "量子纠缠是……(高质量回答)", "rejected": "我不知道(低质量回答)"}| 阶段 | 学习率范围 | 说明 |
|---|---|---|
| 全参微调(SFT) | 1e-5 ~ 5e-5 | 太大会破坏预训练权重 |
| LoRA / QLoRA(SFT) | 1e-4 ~ 5e-4 | 比全参高一个数量级,因为只训练少量参数 |
| DPO 偏好对齐 | 1e-7 ~ 1e-6 | 极小,避免破坏 SFT 成果;用 SFT 的学习率会训崩 |
| GRPO 强化学习 | 1e-6 ~ 5e-6 | 配合 KL 约束,参考 R1 训练设置 |
调参口诀:从保守值(小学习率、3 epoch、cosine 衰减)起步,观察前 100 步 loss 是否正常下降;不下降就调大学习率,震荡就调小。
数据规模指南
Section titled “数据规模指南”| 任务类型 | 建议数据量 | 说明 |
|---|---|---|
| 风格 / 格式适配 | 500 - 2000 条 | 让模型学会输出格式,少量高质量数据即可 |
| 单领域垂直微调 | 5000 - 20000 条 | 如医疗问答、客服话术 |
| 多任务通用增强 | 50000+ 条 | 需要 epoch 更少(1-2)防过拟合 |
| 推理能力蒸馏 | 80000+ 条 | R1 蒸馏级别,配合 GRPO 效果更好 |
数据量的边际效应:从 0 到 5000 条,效果提升明显;从 5 万到 50 万条,提升放缓。先把 5000 条数据做到极致质量,比堆 50 万条脏数据更划算。
微调前自检清单
Section titled “微调前自检清单”开始训练前过一遍这个清单,能避开 80% 的坑:
- 对话模板正确:用
tokenizer.apply_chat_template而非手拼字符串,确认训练和推理格式一致 - 数据已清洗:去重、去空、去过长样本、过滤低质量输出
- 训练/评测无泄漏:评测集和训练集没有重合样本
- mask 掉 prompt 的 loss:只对 assistant 的回答计算损失,不对 user 输入算(
SFTTrainer默认会处理,但自定义数据集要确认) - 基座选对:用 Instruct 版(已对齐)做领域微调,用 Base 版(未对齐)才需要从 SFT 做起
- 显存预估:先跑 10 步确认不 OOM,再开完整训练
训练后自检清单
Section titled “训练后自检清单”- Loss 曲线正常收敛,验证集没有反弹
- Benchmark:目标任务提升,通用能力未明显下降
- 人工盲评胜率优于基座
- 安全红队测试通过
- 推理测试:合并 LoRA 权重后,用真实推理框架(vLLM/SGLang)跑通
- 领域专用模型:通用模型不懂医疗术语或法律条文,用领域数据微调后准确率大幅提升——医疗问诊、法律咨询、金融分析等垂直场景的标配做法。
- 个性化助手:微调让模型学习特定用户/企业的沟通风格和知识偏好——比如客服 AI 学习品牌话术和产品知识。
- 风格定制:用特定作者/风格的数据微调,让 LLM 模仿特定写作风格——文案生成、小说续写、品牌内容创作。
- 企业私有模型:在开源基座(Llama、Qwen)上用内部数据微调,模型完全私有部署——金融、政务等数据敏感行业的首选方案。
- 推理能力增强:用 R1 等推理模型的输出做蒸馏微调,让 7B-14B 小模型获得接近大模型的数学/代码推理能力——性价比极高的”能力下放”。
- 函数调用 / Agent:微调让模型可靠地输出结构化工具调用 JSON,是构建 Agent 应用的关键一环。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| HuggingFace PEFT | Python | 参数高效微调工具库,提供 LoRA / QLoRA / DoRA / Adapter 等方法 |
| TRL | Python | HuggingFace 的 Transformer 强化学习库,提供 SFT / DPO / GRPO / PPO 训练器 |
| Unsloth | Python | 2024-2025 流行的加速库,LoRA 微调快 2-5 倍、省 60-80% 显存,消费级显卡友好 |
| Axolotl | Python | 声明式微调工具,YAML 配置即可训练,支持多种模型和方法,社区活跃 |
| LLaMA-Factory | Python | 中文社区流行的 WebUI 微调工具,零代码拖拽式训练 |
| DeepSpeed | Python | 微软的大规模分布式训练框架,支持 ZeRO 优化的全参微调 |
| FSDP (PyTorch) | Python | PyTorch 2.x 原生全分片数据并行,配置比 DeepSpeed 简单 |
| verl | Python | 字节跳动的强化学习训练框架,内置 GRPO,适合复现 R1 式训练 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 全参微调 | Full Fine-tuning | 更新模型所有参数的传统微调方式,效果最好但成本最高 |
| 参数高效微调 | PEFT (Parameter-Efficient Fine-Tuning) | 只训练少量参数的微调方法统称,含 LoRA / DoRA / Adapter 等 |
| 低秩适配 | LoRA (Low-Rank Adaptation) | 冻结原权重、只训练低秩补丁矩阵 B·A 的 PEFT 方法 |
| 量化低秩适配 | QLoRA (Quantized LoRA) | 将基座权重量化到 4-bit 再做 LoRA,单卡可微调大模型 |
| NF4 | NormalFloat 4-bit | QLoRA 使用的一种为正态分布权重设计的 4-bit 数据类型 |
| 双重量化 | Double Quantization | 对量化缩放因子再做一次量化,进一步节省显存 |
| 监督微调 | SFT (Supervised Fine-Tuning) | 用指令-回答对数据监督训练模型的方法 |
| 指令数据 | Instruction Data | 格式为”指令→期望输出”的微调训练数据 |
| 偏好对齐 | Preference Alignment | 用好坏对比数据校准模型输出偏好的训练阶段 |
| 直接偏好优化 | DPO (Direct Preference Optimization) | 跳过奖励模型、直接从偏好数据优化策略的对齐方法 |
| 人类反馈强化学习 | RLHF (Reinforcement Learning from Human Feedback) | 用人类偏好训练奖励模型、再用 RL 优化的传统对齐范式 |
| 组相对策略优化 | GRPO (Group Relative Policy Optimization) | 用组内相对排名作为奖励的 RL 方法,DeepSeek R1 采用 |
| 适配器 | Adapter | 在模型层间插入的小型可训练模块,PEFT 的早期形式 |
| 秩 | Rank | LoRA 低秩矩阵的维度 r,通常取 8-64,决定补丁的表达能力 |
| 灾难性遗忘 | Catastrophic Forgetting | 微调新任务时丢失预训练旧知识的现象 |
| 课程学习 | Curriculum Learning | 按由易到难的顺序喂训练数据,借鉴人类学习过程 |
| 零冗余优化器 | ZeRO (Zero Redundancy Optimizer) | DeepSpeed 的分布式训练优化,分阶段切分优化器/梯度/权重 |
| 全分片数据并行 | FSDP (Fully Sharded Data Parallel) | PyTorch 原生的全分片分布式训练方案 |
| 蒸馏 | Distillation | 用大模型的输出(含推理过程)训练小模型,迁移能力 |
| 梯度检查点 | Gradient Checkpointing | 用重算前向结果换取显存节省的技术 |
- LoRA:Hu et al., “LoRA: Low-Rank Adaptation of Large Language Models”(2021),微软出品,证明大模型权重更新是低秩的——只需训练小补丁即可达到接近全参微调的效果。
- QLoRA:Dettmers et al., “QLoRA: Efficient Finetuning of Quantized LLMs”(2023),在 4-bit 量化基座上做 LoRA,首次让单张 48GB 显卡能微调 65B 模型,改变了微调的门槛。
- DPO:Rafailov et al., “Direct Preference Optimization: Your Language Model is Secretly a Reward Model”(2023),斯坦福出品,推导出跳过奖励模型的对齐方法,2024 年起成为开源对齐主流。
- DoRA:Liu et al., “DoRA: Weight-Decomposed Low-Rank Adaptation”(2024),把权重分解为方向和大小分别优化,在同等参数量下优于 LoRA。
- GaLore:Zhao et al., “GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection”(2024),分解梯度而非权重,支持全参微调下的显存优化。
- DeepSeek R1:DeepSeek-AI, “DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning”(2025),用 GRPO 训练出开源推理模型,并开源蒸馏小模型,掀起推理能力蒸馏热潮。
- GRPO:DeepSeek-AI, “DeepSeekMath”(2024),首次提出 Group Relative Policy Optimization,面向数学推理的 RL 方法。
- LIMA:Zhou et al., “LIMA: Less Is More for Alignment”(2023),证明仅 1000 条高质量数据即可对齐,强调数据质量优于数量。
- RLHF 与对齐:微调后的模型还需要对齐人类偏好,详见RLHF 与 LLM 训练与AI 安全对齐技术。
- PEFT 方法全景:更多 PEFT 方法(DoRA、PiSSA、Prefix-Tuning 等)的深入对比见PEFT 参数高效微调全景。
- 推理模型:关于推理模型(o1、R1)的蒸馏与训练,详见推理模型技术。
- 推理部署:微调完的模型如何高效部署,见LLM 推理优化与解码策略。