
集成学习与随机森林
本页介绍集成学习(Ensemble Learning)——传统机器学习分类树中的横切维度之一:它不是与监督/无监督互斥的类别,而是一种”如何组合多个学习器”的元方法,实践中以树集成(随机森林、GBDT 家族)最为成功。
什么是集成学习? 简单说就是”不要只靠一个模型,而是把多个模型组合起来用”。就像看病时不只找一个医生,而是组织多科室会诊——每个模型都有自己的盲区,组合起来就能互相补位,得到更可靠的结论。
集成学习的核心思想:一个臭皮匠不行,但一群臭皮匠凑在一起,可能比诸葛亮还厉害。三条分支各有各的”凑法”:
- Bagging = 三个臭皮匠,投票凑诸葛亮:用有放回采样(bootstrap)生成很多份不同的训练集,每份训练一棵树,最后投票/平均。关键是让树之间互相独立,独立才能互补。
- Boosting = 从错误中学习,接力赛:后一棵树专门补前一棵树的”漏洞”,一棒接一棒越做越准。关键是聚焦错误样本,不是独立而是互补。
- Stacking = 请专家评审团:多个不同类型的模型各自预测,再用一个”元模型”学习如何组合它们的意见。
Bagging(Bootstrap Aggregating 的缩写,中文叫”自助聚合法”)——核心机制是对训练数据做有放回抽样(bootstrap),“有放回”意味着同一条数据可能被抽中多次、也可能一次都没被抽中。这样每棵树看到的训练集略有不同,学到的规律也就不一样。
Boosting(中文叫”提升法”)——与 Bagging 的”各练各的”不同,Boosting 是接力式训练:第 1 个模型做完,把做错的样本”标记”出来,第 2 个模型重点学这些难样本;第 2 个做完再把仍做错的传给第 3 个……如此传递,整体精度逐步提升。
Bagging vs Boosting 流程对比
Section titled “Bagging vs Boosting 流程对比”一句话区分:Bagging 的树各自独立(降低方差),Boosting 的树逐个纠错(降低偏差)。
方差(Variance) 指的是模型对训练数据变化的敏感程度——高方差意味着换一批训练数据,模型预测就大幅变化(典型的过拟合症状)。偏差(Bias) 指的是模型预测的系统性偏离——高偏差意味着模型太简单,连训练数据中的规律都学不到(典型的欠拟合症状)。
偏差-方差分解:误差从哪里来?
Section titled “偏差-方差分解:误差从哪里来?”为什么 Bagging 和 Boosting 的”药效”不同?这取决于它们分别作用于误差的哪个成分:
这也解释了实践中的选择:模型严重欠拟合(偏差大)→ 优先试 Boosting;模型容易过拟合(方差大,如深决策树)→ 优先试 Bagging / 随机森林。
偏差-方差分解的数学推导
Section titled “偏差-方差分解的数学推导”为什么总误差恰好等于”偏差² + 方差 + 不可约噪声”?这并非经验总结,而是有严格证明的数学定理。以回归任务为例,设真实关系为 ,其中 是均值为零、方差为 的随机噪声(代表数据本身固有的不确定性,任何模型都无法消除)。模型在训练集 上学得 ,对其在所有可能的等规模训练集上取期望 :
第一步:拆解平方误差的期望
展开平方,利用 且 与 独立:
第二步:对应到三个概念
| 项 | 含义 | 直觉 |
|---|---|---|
| 偏差²(Bias²) | 所有训练集学到的模型的”平均预测”离真相有多远——模型能力的上限 | |
| 方差(Variance) | 单个训练集学到的模型相比”平均模型”波动有多大——对数据变化的敏感度 | |
| 噪声(Irreducible Error) | 数据本身的不确定性,任何方法都无法消除 |
直觉:想象你在打靶。靶心是真实规律 。你每次用一个训练集训练一个模型,弹着点就是 。偏差是弹着点群中心偏离靶心的距离——偏离越大说明你瞄准出了系统性问题;方差是弹着点的散布范围——散得越开说明每次训练的结果越不稳定;噪声是靶本身在晃动——你再厉害也管不了。
这个分解解释了集成学习的本质:Bagging 通过平均多个模型来压缩”散布”(降方差),Boosting 通过迭代纠错来移动”中心”(降偏差),各有各的战场。
随机森林分类(Bagging 代表)
Section titled “随机森林分类(Bagging 代表)”from sklearn.ensemble import RandomForestClassifierfrom sklearn.datasets import make_classificationfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import accuracy_score
# 生成模拟数据X, y = make_classification(n_samples=500, n_features=10, random_state=42)X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42)
# 随机森林:100 棵决策树投票rf = RandomForestClassifier(n_estimators=100, random_state=42)rf.fit(X_train, y_train)print(f"准确率: {accuracy_score(y_test, rf.predict(X_test)):.2%}")# 输出示例: 准确率: 92.80%
# 查看特征重要性for name, imp in zip(range(10), rf.feature_importances_): print(f" 特征 {name}: {imp:.3f}")梯度提升树分类(Boosting 代表)
Section titled “梯度提升树分类(Boosting 代表)”from sklearn.ensemble import GradientBoostingClassifierfrom sklearn.datasets import make_classificationfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import accuracy_score
X, y = make_classification(n_samples=500, n_features=10, random_state=42)X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42)
# GBDT:逐棵树拟合前一轮的残差gbdt = GradientBoostingClassifier( n_estimators=100, # 树的数量 learning_rate=0.1, # 学习率(缩小每棵树的贡献) max_depth=3, # 每棵树深度 random_state=42,)gbdt.fit(X_train, y_train)print(f"准确率: {accuracy_score(y_test, gbdt.predict(X_test)):.2%}")# 输出示例: 准确率: 93.60%随机森林进阶:OOB 误差 + 特征重要性
Section titled “随机森林进阶:OOB 误差 + 特征重要性”from sklearn.datasets import load_winefrom sklearn.ensemble import RandomForestClassifierfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import accuracy_score
# 加载葡萄酒数据集(3 分类,13 个特征)X, y = load_wine(return_X_y=True)X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42)
# 训练随机森林:100 棵树,每棵最多看 √13≈3 个特征rf = RandomForestClassifier(n_estimators=100, max_features="sqrt", oob_score=True, random_state=42)rf.fit(X_train, y_train)
# 评估——准确率 + OOB 误差(不用测试集也能估误差)print(f"测试集准确率: {accuracy_score(y_test, rf.predict(X_test)):.2%}")print(f"OOB 误差估计: {1 - rf.oob_score_:.2%}")# 输出示例: 测试集准确率: 100.00% OOB 误差估计: 3.37%
# 特征重要性(随机森林自带,可直接做特征筛选)top3 = sorted(zip(load_wine().feature_names, rf.feature_importances_), key=lambda x: -x[1])[:3]for name, imp in top3: print(f" {name}: {imp:.3f}")OOB 误差曲线:树的数量选多少才够?
Section titled “OOB 误差曲线:树的数量选多少才够?”下面的实验展示 OOB 误差如何随树的数量变化——帮助你直观判断”加到多少棵树就够了”:
import matplotlib.pyplot as pltfrom sklearn.ensemble import RandomForestClassifier, RandomForestRegressorfrom collections import OrderedDictfrom sklearn.datasets import make_classification
# 生成一个稍具挑战性的二分类数据集X, y = make_classification(n_samples=800, n_features=25, n_informative=10,                           n_redundant=5, random_state=42)
# 测试不同的 min_samples_leaf,观察 OOB 误差随树数收敛ensemble_clfs = [    ("min_samples_leaf=1", RandomForestClassifier(min_samples_leaf=1, oob_score=True,                                                   max_features="sqrt", random_state=42)),    ("min_samples_leaf=5", RandomForestClassifier(min_samples_leaf=5, oob_score=True,                                                   max_features="sqrt", random_state=42)),]
error_rate = OrderedDict((label, []) for label, _ in ensemble_clfs)
# 逐步增加树的数量:从 15 到 300,每轮加 15 棵for label, clf in ensemble_clfs:    for i in range(15, 301, 15):        clf.set_params(n_estimators=i, warm_start=True)  # warm_start 在已有树基础上继续添加        clf.fit(X, y)        oob_error = 1 - clf.oob_score_        error_rate[label].append((i, oob_error))
# 绘制曲线for label, clf_err in error_rate.items():    xs, ys = zip(*clf_err)    plt.plot(xs, ys, label=label)
plt.xlabel("树的数量 (n_estimators)")plt.ylabel("OOB 误差")plt.title("OOB 误差随树数量的收敛曲线")plt.legend()plt.tight_layout()plt.savefig("oob_curve.png", dpi=150)plt.show()# 典型结果:曲线在 100-150 棵后趋于平台,再增加树收益极小。# min_samples_leaf=5 的曲线更平滑(单棵树方差更低),但下限可能略高(偏差略大)。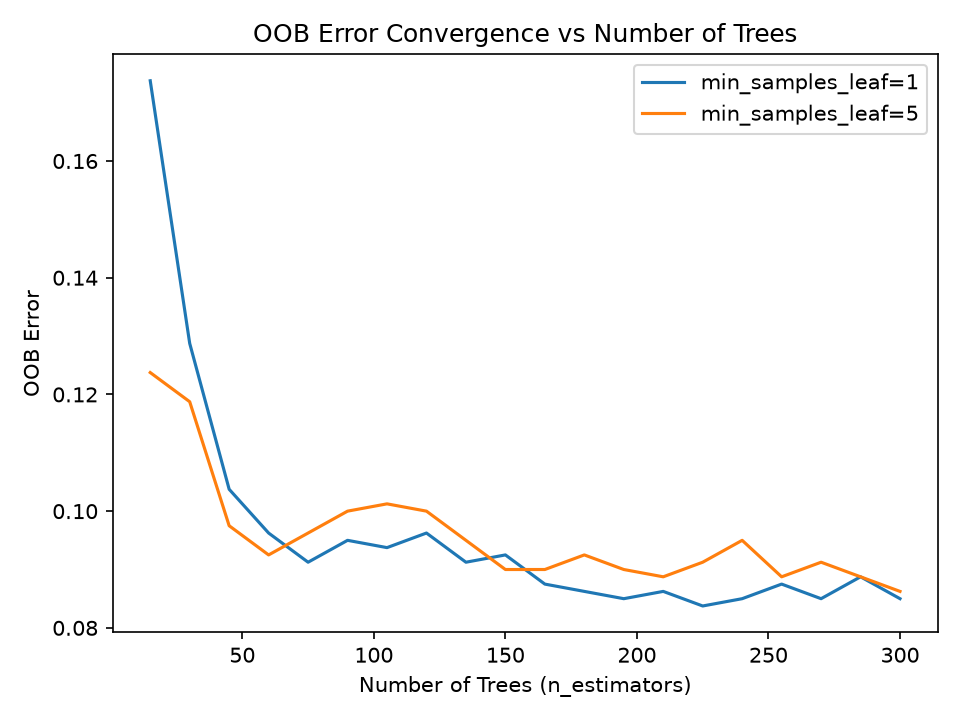
如何解读 OOB 曲线:如果曲线在某个树数后几乎变平,说明再加树只是”浪费时间而不会更准”;如果曲线仍在持续下降,说明树还不够多。这是选择
n_estimators最省心的可视化方法——不需要划分验证集。
偏差-方差分解实验
Section titled “偏差-方差分解实验”下面的代码用实验方法直观展示单棵决策树(高方差)vs 随机森林(低方差)的差异,帮助理解前面推导的数学公式:
import numpy as npfrom sklearn.tree import DecisionTreeRegressorfrom sklearn.ensemble import RandomForestRegressor, GradientBoostingRegressor
# 真实函数:y = sin(x) + 微小噪声def true_function(x):    return np.sin(x)
rng = np.random.RandomState(42)n_models = 100      # 模拟 100 个不同的训练集n_samples = 50      # 每个训练集 50 个样本
# 在 [0, 2π] 上取 200 个测试点,观察模型的预测波动X_test = np.linspace(0, 2 * np.pi, 200).reshape(-1, 1)
predictions_tree = []       # 单棵决策树的预测predictions_rf = []         # 随机森林的预测
for _ in range(n_models):    # 每次从不同随机种子采样 → 模拟不同的训练集 D    X_train = np.sort(rng.uniform(0, 2 * np.pi, n_samples)).reshape(-1, 1)    y_train = true_function(X_train.ravel()) + rng.normal(0, 0.2, n_samples)
    # 单棵深决策树(高方差,对训练数据极敏感)    tree = DecisionTreeRegressor(max_depth=10, random_state=rng.randint(10000))    tree.fit(X_train, y_train)    predictions_tree.append(tree.predict(X_test))
    # 随机森林(100 棵树平均 → 低方差)    rf = RandomForestRegressor(n_estimators=100, max_depth=10, random_state=rng.randint(10000))    rf.fit(X_train, y_train)    predictions_rf.append(rf.predict(X_test))
predictions_tree = np.array(predictions_tree)  # shape: (100, 200)predictions_rf = np.array(predictions_rf)
# 计算方差(对 100 个模型在每个测试点上的预测求方差)var_tree = predictions_tree.var(axis=0).mean()var_rf = predictions_rf.var(axis=0).mean()
# 计算偏差²(100 个模型的平均预测 vs 真实函数)bias_tree = ((predictions_tree.mean(axis=0) - true_function(X_test.ravel())) ** 2).mean()bias_rf = ((predictions_rf.mean(axis=0) - true_function(X_test.ravel())) ** 2).mean()
print(f"单棵决策树 → 偏差²: {bias_tree:.4f}, 方差: {var_tree:.4f}")print(f"随机森林 → 偏差²: {bias_rf:.4f}, 方差: {var_rf:.4f}")# 典型输出:# 单棵决策树 → 偏差²: ~0.005, 方差: ~0.08# 随机森林 → 偏差²: ~0.005, 方差: ~0.02# 偏差几乎不变,方差降低 ~4 倍——这就是 Bagging 降方差的可视化验证。实验结论:随机森林的偏差²与单棵树几乎相同(因为每棵树都是同构的深决策树),但方差大幅降低——这就是 Bagging/随机森林的核心价值。这个实验把前面抽象的数学公式变成了可以”摸到”的数字。
完整流程:交叉验证调参 + 预测新样本
Section titled “完整流程:交叉验证调参 + 预测新样本”真实项目中”训练即终点”远远不够——先用交叉验证调好参数,再对测试集做最终评估,最后对新样本做预测:
from sklearn.datasets import load_winefrom sklearn.model_selection import train_test_split, GridSearchCVfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.metrics import accuracy_score
# 第 1 步:加载数据并划分(注意此时测试集完全冻结,不参与调参)X, y = load_wine(return_X_y=True)X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
# 第 2 步:网格搜索 + 5 折交叉验证找最优超参数param_grid = {    "n_estimators": [50, 100, 200],   # 树的数量(越多方差越低,但边际递减)    "max_depth": [None, 5, 10],       # 树深度(None 表示不限制,更容易过拟合)    "max_features": ["sqrt"],         # 分裂时随机看 sqrt(特征数) 个特征}search = GridSearchCV(    RandomForestClassifier(random_state=42),    param_grid, cv=5, scoring="accuracy", n_jobs=-1,)search.fit(X_train, y_train)
# 第 3 步:查看最优参数 + 交叉验证得分 + 测试集最终评估print(f"最优参数: {search.best_params_}")print(f"5 折交叉验证准确率: {search.best_score_:.2%}")print(f"测试集准确率: {accuracy_score(y_test, search.predict(X_test)):.2%}")
# 第 4 步:预测新样本(一条新酒的 13 个特征值)new_sample = [[13.2, 2.4, 2.1, 18.5, 96, 2.1, 2.1, 0.3, 1.2, 5.2, 1.0, 3.1, 600]]label = load_wine().target_names[search.predict(new_sample)[0]]print(f"新样本预测类别: {label}")
Stacking 完整示例:异质模型组合
Section titled “Stacking 完整示例:异质模型组合”Stacking(堆叠)是集成学习三大分支中最灵活的一种——它不要求基模型同构,反而鼓励多样性。下面的完整示例展示如何用逻辑回归、随机森林和 GBDT 三个风格迥异的模型组成一个”评审团”,再用逻辑回归做”主席”来综合决策:
from sklearn.datasets import load_breast_cancerfrom sklearn.model_selection import train_test_split, StratifiedKFold, cross_val_predictfrom sklearn.linear_model import LogisticRegressionfrom sklearn.ensemble import RandomForestClassifier, GradientBoostingClassifierfrom sklearn.metrics import accuracy_score, roc_auc_scoreimport numpy as np
# 加载乳腺癌数据集(二分类,30 个特征)X, y = load_breast_cancer(return_X_y=True)X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# 第 1 步:定义 3 个风格不同的基模型(Level-0 模型)base_models = {    "LR":  LogisticRegression(max_iter=5000, random_state=42),   # 线性模型    "RF":  RandomForestClassifier(n_estimators=100, random_state=42),  # Bagging    "GBDT": GradientBoostingClassifier(n_estimators=100, random_state=42),  # Boosting}
# 第 2 步:用交叉验证生成"元特征"(Level-1 输入)# 关键:不能直接用基模型在训练集上的预测值做元特征(那样会过拟合)。#       必须用 cross_val_predict 做交叉验证预测——每条样本的预测来自"没见过它"的模型。kf = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)meta_features_train = np.column_stack([    cross_val_predict(model, X_train, y_train, cv=kf, method="predict_proba")[:, 1]    for model in base_models.values()])
# 第 3 步:训练元模型(Level-1 模型)——学习如何最优地组合三个基模型meta_model = LogisticRegression(max_iter=5000, random_state=42)meta_model.fit(meta_features_train, y_train)print(f"元模型交叉验证 AUC: "      f"{roc_auc_score(y_train, meta_model.predict_proba(meta_features_train)[:, 1]):.4f}")
# 第 4 步:在全量训练集上重新训练基模型,然后在测试集上生成元特征meta_features_test = np.column_stack([    model.fit(X_train, y_train).predict_proba(X_test)[:, 1]  # .fit() 返回 self    for model in base_models.values()])
# 第 5 步:评估——对比每个基模型单独 vs Stacking 的效果print("\n基模型单独表现:")for name, model in base_models.items():    acc = accuracy_score(y_test, model.predict(X_test))    print(f"  {name:5s}: {acc:.2%}")
stacking_acc = accuracy_score(y_test, meta_model.predict(meta_features_test))print(f"\nStacking 组合后: {stacking_acc:.2%}")# 典型输出:Stacking 通常与最好的基模型持平或略优,# 但当不同基模型各有擅长时(如 LR 擅长线性可分、RF 擅长非线性交互),# Stacking 能捕获"何时该信谁"的模式,提升更为明显。
Stacking 为什么需要交叉验证生成元特征? 如果直接用基模型在训练集上的预测(
model.fit(X_train).predict(X_train))作为元模型的输入,基模型已经”见过”训练集,预测会过于乐观——元模型会学到虚假的模式,导致过拟合。用交叉验证预测(cross_val_predict)保证每条样本的预测来自”没见过它”的模型,这才是诚实的预测。
Stacking 的适用场景:当你的不同模型各有强项时——例如线性模型擅长捕捉线性关系、树模型擅长非线性交互、最近邻擅长局部模式——Stacking 能让”合适的模型在合适的样本上发言”,效果通常优于任何单一模型。
三条分支速览
Section titled “三条分支速览”| 分支 | 思想 | 代表算法 | 年份/提出者 |
|---|---|---|---|
| Bagging | bootstrap 自助采样并行训练,投票/平均降方差 | Bagging;随机森林 | Breiman 1996;Breiman 2001 |
| Boosting | 串行训练,每轮聚焦前轮错分样本,加法模型 | AdaBoost → GBDT → XGBoost/LightGBM/CatBoost | Freund & Schapire 1997;Friedman 2001;2016–2018 |
| Stacking | 用元学习器组合多个异质基学习器的输出 | Stacked Generalization | Wolpert 1992 |
随机森林的精确定位
Section titled “随机森林的精确定位”随机森林 = 集成学习 → bagging 分支 → 以 CART 决策树为基学习器,并叠加”每个分裂节点随机选特征子集”的随机子空间思想(后者源自 Ho 1995/1998 的 Random Subspace Method)。Breiman 2001 论文 “Random Forests”(Machine Learning 45:5–32)即自述为 “bagging + random feature selection”。
分类争议:主流(Breiman 原论文、ESL、周志华教材、Wikipedia)将其归为 bagging 的扩展;少数文献强调随机子空间的独立贡献,视为”bagging 与 random subspace 的结合”。
Bagging + 随机特征选择流程
Section titled “Bagging + 随机特征选择流程”随机森林的两份随机性(样本扰动 + 特征扰动)确保每棵树”犯不同的错”,平均之后错误互相抵消——方差大幅降低:
分类任务默认每棵树在分裂时只考虑 个特征,回归任务考虑
特征数 / 3个——这就是”随机子空间”思想。
Bagging 的理论基础:大数定律
Section titled “Bagging 的理论基础:大数定律”为什么 Bagging 能降方差?这背后是大数定律(Law of Large Numbers)的直接体现。
假设有 棵独立同分布的决策树 ,每棵树的方差为 。Bagging 的预测是 棵树的平均:
如果树之间完全独立,平均后的方差为:
越大方差越小——这就是”多棵树平均比单棵树更稳定”的数学基础。然而实际上树之间并不完全独立(因为 bootstrap 样本有重叠),它们之间存在正相关系数 ()。此时:
推导过程:设 棵树两两之间的相关系数均为 (即 ),根据方差的线性性质:
化简后得到:
- 第一项 是树之间的共享方差,无法通过增加树数量消除——这是 Bagging 降方差的”天花板”。
- 第二项随 趋近于 0——增加树只能消除非共享部分。
数学直觉:这两个公式揭示了 Bagging 的极限。当树数 时,方差不会降到 0,而是停在 。相关性 越高,天花板越高——这就是为什么随机森林要在 Bagging 基础上额外引入随机特征选择。
随机森林的关键创新:通过随机特征选择进一步降低树之间的相关性 。每棵树不仅看到不同的数据子集(bootstrap),还在每个分裂点只考虑随机选出的特征子集——迫使树做出不同的分裂决策, 更小,Bagging 的降方差效果更强。
直觉:Bagging 降方差的极限受限于树之间的相关性。随机森林 = Bagging + 随机特征选择,目的就是把 压下来。极端情况 意味着每棵树完全独立,平均的方差可以无限缩小。
OOB 估计的理论基础
Section titled “OOB 估计的理论基础”OOB(Out-of-Bag,袋外)误差是随机森林最优雅的特性之一——不需要划分验证集就能得到几乎无偏的泛化误差估计。它的理论基础来自 bootstrap 采样的概率性质。
推导:为什么约 37% 的样本不在 bootstrap 样本中?
从 条样本中有放回地抽取 次,某一条特定样本从未被抽中的概率为:
当 时:
所以约有 36.8%()的样本不在这棵树的 bootstrap 样本中——这些就是 OOB 样本。反过来说,每棵树只用了约 63.2%()的训练数据。
关键洞察:每棵树的 OOB 样本对那棵树而言就是”从未见过”的数据——天然等价于一个独立的测试集。随机森林把每棵树在其 OOB 样本上的预测汇总起来,就得到了无需划分验证集的泛化误差估计。
OOB 误差估计的计算过程:
- 对每棵树 ,用其 bootstrap 样本训练,用其 OOB 样本评估——得到 的 OOB 预测。
- 对每条训练样本 :它只被约 37% 的树”没见过”。把所有”没见过”它的树组成一个子森林,用这个子森林对 做投票/平均——这就是 的 OOB 预测。
- 用全部训练样本的 OOB 预测与真实标签计算误差,就是最终的 OOB 误差估计。
实践价值:在小数据集上,划分验证集会严重减少训练数据。OOB 估计让你在用全部数据训练的同时获得近似的泛化误差——这在数据量有限时尤为珍贵。研究表明,OOB 误差与独立的测试集误差非常接近,是无偏估计。
Boosting 的理论基础:前向分布算法
Section titled “Boosting 的理论基础:前向分布算法”Boosting 的数学框架是 Friedman, Hastie & Tibshirani (2000) 提出的前向分布算法(Forward Stagewise Additive Modeling)。
Boosting 模型是一个加法模型(Additive Model)——多个基学习器的加权求和:
其中 是第 轮的弱学习器(如决策树), 是其权重。前向分布算法不一次性优化所有参数,而是贪心地逐轮添加:
每轮选择使损失 最小化的 和 。
“贪心”的含义:前向分布算法不会回头修改已训练好的 ,每轮只在当前模型基础上添加一个新学习器。这像搭积木——放好一块就不动了,再往上叠下一块。虽然不是全局最优,但实践证明效果非常好。
AdaBoost 的推导
Section titled “AdaBoost 的推导”AdaBoost 使用指数损失函数 ()。第 轮的目标:
化简后可得(令 为样本权重):
令 为加权错误率,对 求导得最优权重:
这就是 AdaBoost 经典公式——错误率越低的弱学习器权重越大。
直觉解读:如果某个弱学习器的错误率 (即比随机猜好一点),则 。错误率越低, 越大——“说得更准的弱学习器在最终投票时话语权更大”。而错误率恰好等于 0.5 时 ,这个弱学习器的话语权为零。这保证 Boosting 只会纳入有用的学习器。
GBDT:梯度提升
Section titled “GBDT:梯度提升”GBDT(Gradient Boosting Decision Tree)的突破性在于将前向分布算法推广到任意可微损失函数。每轮不再拟合原始标签,而是拟合前一轮的负梯度(Negative Gradient):
对于平方损失 ,负梯度恰好是残差 ——所以”GBDT 拟合残差”只是平方损失的特例。换成 Huber 损失(更抗离群值)、Logistic 损失(分类任务)就自动适配,只需改变梯度计算。
为什么叫”梯度”提升? 在函数空间中做梯度下降——每轮的负梯度告诉你”当前模型在哪些样本上误差大、该往什么方向调”,然后训练一棵决策树去拟合这个”调整方向”。这与神经网络中用梯度下降优化权重本质相同,只不过这里的”参数”是整棵决策树。
XGBoost 的关键改进:将损失函数二阶泰勒展开,使用一阶导数 和二阶导数 (Hessian)来更精确地优化目标函数,并加入正则化项 ( 是叶子数, 是叶子权重)防止过拟合。
二阶展开的优势:只用一阶导数(梯度)好比在黑暗中只知道”往前走”;用二阶导数(Hessian)就好比同时知道了”脚下的坡度变化”——能更准确地判断该走多远,收敛更快。这就是 XGBoost 比传统 GBDT 更快更准的核心原因之一。
GBDT 正则化:为什么需要 Shrinkage(学习率)
Section titled “GBDT 正则化:为什么需要 Shrinkage(学习率)”GBDT 中每棵树的贡献被乘以一个学习率 (也叫 shrinkage):
这看起来只是”缩小每一步的步长”,为什么如此重要?
直觉:想象你在大雾中下山找谷底。如果每步跨很大(),你可能在谷底旁边来回横跳而过拟合;如果每步跨很小(),你走得更慢(需要更多棵树),但每步都谨慎试探,最终停的位置更接近真正的谷底。小的学习率 + 更多的树 = 更好的泛化——这是 GBDT 调参的核心经验法则。
随机森林特征重要性原理
Section titled “随机森林特征重要性原理”随机森林的 feature_importances_(也叫 Gini 重要性 或 MDI, Mean Decrease Impurity)来自以下计算:
方法一:不纯度减少(MDI)
Section titled “方法一:不纯度减少(MDI)”在决策树中,每次节点分裂会带来不纯度下降(Impurity Decrease)。对于分类任务,不纯度通常用 Gini 不纯度衡量:
其中 是节点 中第 类的样本比例。Gini 值越小,节点越”纯净”。
Gini 不纯度的直觉:如果一个节点里 100% 的样本都是同一类,(完全纯净);如果各类样本均匀混合, 接近最大值(最混乱)。决策树的目标就是通过分裂让子节点越来越”纯净”。
每次用特征 在节点 做分裂,不纯度减少量为:
其中 是分裂后的左右子节点, 是样本数。
随机森林的特征重要性 = 该特征在所有树的所有节点上 的加权平均(权重是该节点的样本占比)。
MDI 的偏差问题:不纯度减少对高基数特征(取值很多的连续特征或高基数类别特征)有偏好——取值越多,越容易找到”完美”的分裂点, 虚高。scikit-learn 2023+ 版本已修复部分偏差。
方法二:排列重要性(Permutation Importance)
Section titled “方法二:排列重要性(Permutation Importance)”更公正的方法:训练好模型后,将特征 的值在验证集上随机打乱(破坏该特征与标签的关系),看模型性能下降多少:
性能下降越多说明该特征越重要。这种方法模型无关(可用于任何模型),且不受高基数偏差影响。
实践建议:用 Permutation Importance 替代 MDI 做特征选择——更公正。还可结合 SHAP 值(Shapley Additive Explanations,基于博弈论的特征贡献分解方法)做更精细的分析,详见自动化与可解释性。
- 随机森林几乎不需要调参,开箱即用,是表格数据的首选 baseline。
n_estimators(树的数量):100~500 通常够用,越多越好但边际递减。“太少”比”太多”危险——树不够多,方差根本没降下来。max_features:减小它 → 树之间差异更大 → 方差更低但偏差升高。分类默认sqrt、回归默认1/3是经验值,先试默认再调。- OOB 误差是免费赠品:bootstrap 采样每棵树只用到约 63% 的样本,剩下 37%(out-of-bag)天然可做验证。设
oob_score=True即可,不需要额外划分验证集。 - 特征重要性可用于特征筛选,但对高基数(取值多)特征有偏——建议用 Permutation Importance 替代。
- 短板:不擅长高维稀疏数据(文本 TF-IDF),也无法外推——回归任务的预测值不会超出训练集 y 的范围。
- GBDT 通常比随机森林更准,但需要调
learning_rate和n_estimators,且容易过拟合——这两个参数要配合调(学习率小则树要多)。 - 调参绝不能用测试集:用
GridSearchCV(网格搜索 + K 折交叉验证)在训练集上调参,参数定稿后才用测试集做最终评估,否则测试集就”脏”了。 - 表格数据竞赛中,LightGBM / XGBoost 是首选工具,比 sklearn 的
GradientBoostingClassifier快一个数量级。 - 样本量 < 1000 时,简单的模型(逻辑回归、单棵决策树)可能反而更好,集成模型容易过拟合。
- Stacking 的黄金法则:基模型要有多样性。如果三个基模型都是随机森林(只改了随机种子),Stacking 几乎不会有提升——它们犯的错太相似了。理想的组合是”线性模型 + 树模型 + kNN”这种风格互补的模型。
- 随机森林 → 特征重要性分析:随机森林内置的 feature importance 可直接告诉你”哪些特征对预测贡献最大”,被广泛用于数据探索和特征筛选,是数据科学家的日常工具。
- 随机森林 → 风险评估:保险业用随机森林根据投保人年龄、病史、职业等数十个特征预测理赔风险,模型鲁棒且几乎不需要调参。
- 随机森林 → 银行信用评分:基于客户收入、负债、还款历史等数百个特征预测违约概率,模型可解释性强且对缺失值容忍度高,是消费金融风控的常见基线方案。
- 随机森林 → 生态物种分布建模:根据气候、海拔、植被等环境变量预测某物种的地理分布范围,生态学工具 MaxEnt 的核心思想与之同源,广泛用于保护区规划和入侵物种监测。
- 随机森林 → 电商用户购买预测:用用户浏览时长、加购行为、历史订单等表格特征预测点击后是否转化,随机森林在结构化表格数据上表现稳健、调参简单,常作为点击率模型的 baseline。
- 随机森林 → 医疗风险因素筛选:利用随机森林的特征重要性排序,从上千个临床指标中筛出与疾病最相关的几个关键变量,辅助流行病学研究找到高危因素。
- 随机森林 → 遥感图像分类:在卫星遥感领域,随机森林是土地覆盖分类(区分林地、农田、水体、城市等)的经典方法——遥感特征(光谱波段、纹理指数、地形数据)天然是表格结构,随机森林对噪声鲁棒且能处理高维特征。
- GBDT/XGBoost → Kaggle 竞赛王者:XGBoost 在 2016–2018 年间的 Kaggle 表格数据竞赛中近乎垄断,是结构化数据任务的首选算法。
- GBDT/XGBoost → 金融风控:蚂蚁集团、各大银行用 GBDT 家族构建信用评分和反欺诈模型,表格数据上的精度至今优于深度学习。
- GBDT/XGBoost → 广告 CTR 预估:Facebook 2014 年的 GBDT+LR 方案是广告点击率预估的经典架构,至今仍有团队用 XGBoost 做特征交叉后再喂给深度模型。
- LightGBM → 工业级推荐系统:微软开源的 LightGBM 因训练速度快、内存占用低,被美团、阿里等大厂用于推荐系统的排序模型,日处理数十亿条样本。
- CatBoost → 类别特征密集场景:Yandex 的 CatBoost 内置类别特征编码(无需手动 One-Hot),在电商商品推荐、用户画像分析等类别变量密集的场景中表现出色。
- Stacking → 竞赛中的最后冲刺:在 Kaggle 等竞赛中,当单个模型已到瓶颈时,Stacking 多个风格不同的强模型(XGBoost + LightGBM + 神经网络)往往能再挤出 0.1%-0.5% 的提升——在排行榜前列这足以拉开名次。
- 随机森林 → 工业物联网异常检测:在智能制造中,用传感器时序统计特征(均值、方差、峰值频率等)训练随机森林检测设备异常状态。相比深度学习方法,随机森林部署简单、推理快、可解释,适合边缘设备上的实时监控。
2025-2026 前沿进展
Section titled “2025-2026 前沿进展”梯度提升树仍然是表格数据之王
Section titled “梯度提升树仍然是表格数据之王”Grinsztajn et al. (NeurIPS 2022) 的经典研究”树模型仍优于深度学习”持续被验证。2024-2025 年多项独立复现实验确认了这一结论:在中小规模(< 1000 万样本)表格数据上,XGBoost/LightGBM/CatBoost 仍然是性价比最高的选择。核心原因在于树模型对表格数据的两个天然优势——对特征尺度不敏感(不需要归一化)和能自动学习不规则的特征交互(深度学习需要精心设计网络才能做到)。
为什么深度学习在表格数据上打不过树模型? 关键在于表格数据的”不规则性”——表格特征之间的交互往往是非对称的、非平滑的(如”年龄>60 且 之前有过理赔”这种逻辑组合),决策树天然擅长表达这种不规则的决策边界,而神经网络倾向学习平滑函数。此外,表格数据常见的不规则缺失值、类别变量混合等,对树模型的预处理要求也更低。
TabPFN 与表格基础模型
Section titled “TabPFN 与表格基础模型”2022 年提出、2024-2025 年持续改进的 TabPFN(Tabular Pre-trained Foundation Network)是表格数据的 In-Context Learning 方案——在小数据集(< 10000 行)上不训练即预测,部分场景超越 GBDT。2025 年发布的 TabPFN v2 将支持的数据集规模扩展到 10000 行以上,并显著改善了对回归任务和类别不平衡数据的支持。
它展示了”表格基础模型”的可能性:像 LLM 一样预训练大量合成表格数据,推理时对新数据集”零训练”直接预测。但在百万级以上样本的大数据集上,GBDT 仍占绝对优势。TabPFN 代表了一种新范式——值得密切关注但尚未全面替代传统方法。
XGBoost / LightGBM 生态演进
Section titled “XGBoost / LightGBM 生态演进”- XGBoost 3.0(2024-2025):大幅优化了 GPU 训练管线,引入了更高效的 Arrow 数据格式支持,使大数据集的 IO 瓶颈显著降低。此外,新的近似树分裂算法在分布式训练中减少通信开销,多机扩展性提升。
- LightGBM 4.x(2024-2025):持续优化 Leaf-wise 生长策略和 GOSS(Gradient-based One-Side Sampling)采样算法。新增了对 CUDA 上的类别特征原生支持,以及更灵活的早停策略(支持多指标同时监控)。
- CatBoost 2024-2025:强化了 Ordered Boosting 的理论保证,并在 GPU 训练中引入了新的直方图压缩技术,类别特征密集场景下训练速度进一步提升。
GBDT 硬件加速
Section titled “GBDT 硬件加速”NVIDIA 的 cuML(RAPIDS 生态)提供了 GPU 加速的随机森林;XGBoost 和 LightGBM 均支持 GPU 训练,2024-2025 年的优化使单 GPU 上百万级样本训练时间从小时级降至分钟级。2025 年还出现了多 GPU 分布式 GBDT 的工业方案(如 NVIDIA 的 fil forest inference library),推理阶段在 GPU 上每秒可完成数百万次预测,满足实时广告竞价的延迟要求。
LLM + 树模型混合
Section titled “LLM + 树模型混合”2024-2025 年出现了用大语言模型自动做表格特征工程(如自动生成交叉特征、自动编写 SQL 聚合),再将结果喂给 GBDT 的工作流。代表性工作包括 Google Research 的 DSB(Deep Search Boosting)和多个 Kaggle 获胜方案,它们利用 LLM 的领域知识弥补了纯树模型在特征工程上的人工瓶颈。
典型范式:LLM 分析表格列的语义含义 → 自动生成交叉特征和聚合统计量 → GBDT 训练。在某些领域(如保险理赔预测)取得了相比人工特征工程 + GBDT 3-5% 的精度提升。
AutoML 与自动化 Stacking
Section titled “AutoML 与自动化 Stacking”- AutoGluon-Tabular:2024-2025 年迭代到 1.x 版本,能在合理时间内自动尝试多种模型(XGBoost/LightGBM/CatBoost/RF/NN)并做多层 Stacking,多项基准测试中超过人工调参。其核心创新是”多层 Stacking + 在重复数据子集上训练”的集成策略,在精度和训练时间之间提供了可配置的权衡。
- SHAP 生态深化:TreeSHAP 算法的时间复杂度优化使其能高效处理大规模树模型,2025 年已成为金融风控和医疗 AI 领域可解释性分析的事实标准。新的 FastTreeSHAP 等变体进一步将计算时间降低了 1-2 个数量级。
随机森林理论新进展
Section titled “随机森林理论新进展”2024-2025 年的学术研究重新关注了随机森林的统计理论。代表性工作包括对随机森林一致性(consistency,即样本量趋于无穷时预测收敛于真实函数)的更简洁证明,以及对 Mondrian Forest(一种支持在线学习的随机森林变体)在流式数据上的理论分析。这些工作为随机森林的”开箱即用且不容易过拟合”这一经验现象提供了更坚实的理论支撑。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| scikit-learn | Python | 提供 RandomForest、GradientBoosting、AdaBoost、VotingClassifier 等集成算法 |
| XGBoost | C++/Python | 高性能梯度提升树库,内置正则化提升泛化能力,竞赛与工业标配 |
| LightGBM | C++/Python | 微软开源的梯度提升树,Leaf-wise 生长 + 直方图算法大幅加速训练 |
| CatBoost | Python | Yandex 开发的梯度提升树,内置类别特征处理与 Ordered Boosting 防偏 |
| mlxtend | Python | 提供 StackingClassifier 等集成学习辅助工具与可视化功能 |
| ranger | R / C++ | 高性能随机森林实现,专为大数据集设计,R 生态中速度最快的随机森林库 |
| h2o | Python / R / Java | 分布式机器学习平台,内置分布式随机森林(Distributed Random Forest),支持企业级大数据训练 |
| AutoGluon-Tabular | Python | 自动化表格学习框架,自动堆叠多种模型(GBDT/RF/NN),多项基准中超越人工调参 |
| RAPIDS cuML | Python/CUDA | GPU 加速的随机森林和 GBDT,适合百万级以上样本规模 |
| TabPFN | Python | 表格数据基础模型,在小数据集(< 10000 行)上零训练直接预测,2025 年持续迭代 |
| 术语 | 英文 | 解释 |
|---|---|---|
| Bagging | Bootstrap Aggregating | 有放回采样并行训练多个基学习器后投票/平均,以降低方差 |
| Boosting | Boosting | 串行训练,每轮聚焦前一轮的错分样本,逐步降低偏差 |
| Stacking | Stacked Generalization | 用一个元学习器组合多个异质基学习器的预测结果 |
| 弱学习器 | Weak Learner | 略好于随机猜测的基础模型,是集成方法的基本构件 |
| 偏差-方差权衡 | Bias-Variance Tradeoff | 模型总误差来自偏差(欠拟合)和方差(过拟合)的此消彼长 |
| 袋外误差 | OOB Error (Out-of-Bag) | Bagging 中未被采样的样本(袋外样本)可用于无需验证集的内部评估 |
| 自助采样 | Bootstrap Sampling | 有放回地从训练集中抽取与原集等大小的样本,使每棵树看到的训练数据略有不同 |
| 特征重要性 | Feature Importance | 衍生自树模型的结构信息,衡量每个特征对预测的贡献程度,常用于特征筛选 |
| 不纯度减少 | Mean Decrease Impurity (MDI) | 基于节点分裂带来的 Gini/方差下降量计算的特征重要性 |
| 排列重要性 | Permutation Importance | 打乱某特征值后观察模型性能下降程度来评估特征重要性,模型无关 |
| 随机子空间 | Random Subspace | 每次节点分裂只从全部特征中随机选取一个子集来寻找最优划分,降低树之间的相关性 |
| 前向分布算法 | Forward Stagewise Additive Modeling | Boosting 的数学框架:逐轮贪心添加弱学习器到加法模型中 |
| 加法模型 | Additive Model | 多个基学习器加权求和的模型形式,Boosting 的数学基础 |
| 决策树 | Decision Tree | 通过一系列规则对数据进行递归划分的树形模型,是随机森林的基本构建单元 |
| 梯度提升 | Gradient Boosting | 每轮拟合当前模型损失函数的负梯度(类似函数空间中的梯度下降),GBDT 的核心机制 |
| Shrinkage | Learning Rate / Shrinkage | 缩小每棵树贡献的乘数因子(通常 0.01-0.1),小 shrinkage + 多棵树 = 更好泛化 |
| Hessian | Hessian | 损失函数的二阶导数,XGBoost 利用它做更精确的目标函数近似,加速收敛 |
- 决策树谱系:CLS(Hunt, 1960s)→ ID3(Quinlan, 1986,信息增益)→ C4.5(1993,增益率)→ CART(Breiman 等, 1984,Gini 不纯度 + 剪枝)。
- Bagging:Breiman 1996 提出 bootstrap aggregating,随机森林的理论基础。
- 随机森林诞生:随机决策森林前身(Ho, 1995, “Random Decision Forests”)+ 随机子空间方法(Ho, 1998)→ Breiman 2001 “Random Forests”(Machine Learning 45:5–32)集大成。“Random Forests”是 Breiman 与 Adele Cutler 的注册商标。
- Boosting 理论:Friedman, Hastie & Tibshirani, “Additive Logistic Regression: a Statistical View of Boosting” (Annals of Statistics, 2000),前向分布算法与 AdaBoost 的统计学解释。
- GBDT:Friedman, “Greedy Function Approximation: A Gradient Boosting Machine” (Annals of Statistics, 2001),梯度提升树的奠基论文。
- XGBoost:Chen & Guestrin, “XGBoost: A Scalable Tree Boosting System” (KDD 2016),引入二阶导数和正则化。
- LightGBM:Ke et al., “LightGBM: A Highly Efficient Gradient Boosting Decision Tree” (NeurIPS 2017),提出 GOSS 采样和 EFB 直方图。
- CatBoost:Prokhorenkova et al., “CatBoost: unbiased boosting with categorical features” (NeurIPS 2018),Ordered Boosting 理论。
- 表格数据深度学习 vs 树模型:Grinsztajn, Heydari & Oyallon, “Why do tree-based models still outperform deep learning on tabular data?” (NeurIPS 2022)——近年来被引用最多的表格学习基准研究。
- TabPFN:Hollmann et al., “TabPFN: A Transformer That Solves Small Tabular Classification Problems in a Second” (ICLR 2023),表格基础模型的开创性工作。
- 特征重要性:Breiman, “Random Forests” (Machine Learning, 2001) 中提出 MDI;Altmann et al., “Permutation Importance: a Corrected Feature Importance Measure” (Bioinformatics, 2010),排列重要性的理论分析。
- SHAP:Lundberg et al., “From local explanations to global understanding with explainable AI for trees” (Nature Machine Intelligence, 2020),TreeSHAP 算法。
- 现状:表格数据任务的强基线,与 XGBoost / LightGBM 一起统治表格类竞赛与工业场景。
- 一个常被忽视的事实:XGBoost/LightGBM 这类梯度提升树在表格数据上至今仍常胜深度学习(Grinsztajn et al., NeurIPS 2022),传统 ML 并未过时。
- Stacking 的经典出处:Wolpert, “Stacked Generalization”(Neural Networks, 1992)。