
MLOps 实践
传统软件工程有 DevOps 来保障代码的持续集成与交付,而机器学习项目多了一个独特的维度——模型会漂移、数据会变化。一个在离线测试集上表现优异的模型,上线几周后可能因为用户行为变化、数据分布偏移而悄悄退化。MLOps(Machine Learning Operations)就是为了解决这类问题而诞生的工程体系,它将 ML 开发(experimentation)与运维(operations)打通,覆盖从实验跟踪、版本管理、CI/CD 到监控反馈的全生命周期。
本页是 engineering/ 分类的核心实践页,假设你已掌握 工程基础 中的 Docker、Git、Shell 等技能。内容上与 Python 工程进阶 和 AI 后端服务 互补——后两者聚焦”怎么写好服务代码”,本页聚焦”怎么让模型从笔记本走向生产线,并持续保持质量”。如果你对模型训练本身感兴趣,可以参考 PyTorch 指南。
MLOps 的本质是在传统 DevOps 之上增加三个 ML 特有的控制环:
- 数据版本化——代码用 Git 管理,数据也必须可追溯。训练数据变了,模型行为就变了。
- 实验跟踪——一次模型训练涉及几十组超参数组合,哪组最好?指标必须自动记录,而非写在散落的笔记本上。
- 持续监控——上线后持续检测预测质量与数据分布的漂移,一旦超标就触发再训练(retraining)。
💡 一个经验法则:模型开发的终点不是上线,而是上线后的第一个月。如果没有监控体系,你根本不知道线上模型何时开始退化。
1. MLflow——实验跟踪、模型注册与模型服务
Section titled “1. MLflow——实验跟踪、模型注册与模型服务”MLflow 是目前最主流的开源 MLOps 平台,由 Databricks 发起,提供四大核心组件:
| 组件 | 功能 | 典型场景 |
|---|---|---|
| Tracking | 记录训练实验的参数、指标、artifact(模型文件、图表等) | 比较不同超参数组合的效果 |
| Model Registry | 模型版本管理与阶段管理(Staging → Production → Archived) | 审批流程、模型回滚 |
| Models | 标准化模型打包格式(MLmodel 文件) | 跨框架统一接口 |
| Model Serving | 一键启动模型推理服务 | 快速原型验证 |
1.1 MLflow Tracking——记录每一次实验
Section titled “1.1 MLflow Tracking——记录每一次实验”Tracking 的核心概念是 Run(一次训练执行)。每个 Run 记录三类信息:
- Parameters:超参数(如
learning_rate=0.001) - Metrics:评估指标(如
accuracy=0.92),支持逐步记录以绘制训练曲线 - Artifacts:任意文件(模型权重、混淆矩阵图、配置文件)
import mlflowimport mlflow.sklearnfrom sklearn.ensemble import GradientBoostingClassifierfrom sklearn.metrics import accuracy_score, f1_scorefrom sklearn.model_selection import train_test_split
# 设置 tracking server(本地或远程均可)mlflow.set_tracking_uri("http://localhost:5000")mlflow.set_experiment("fraud-detection-v2")
# 自动记录 sklearn 的参数和模型mlflow.sklearn.autolog()
# 将一次训练包裹在 start_run 上下文中with mlflow.start_run(run_name="gbm_baseline"):    # --- 也可以手动 log 参数 ---    params = {        "n_estimators": 200,        "max_depth": 5,        "learning_rate": 0.1,    }
    model = GradientBoostingClassifier(**params)    model.fit(X_train, y_train)
    preds = model.predict(X_test)    acc = accuracy_score(y_test, preds)    f1 = f1_score(y_test, preds)
    # 手动记录指标(autolog 通常已覆盖,这里展示显式 API)    mlflow.log_metric("test_accuracy", acc)    mlflow.log_metric("test_f1", f1)
    # 记录自定义 artifact,如特征重要性图    mlflow.log_artifact("feature_importance.png")
    print(f"Run ID: {mlflow.active_run().info.run_id}")    print(f"Accuracy: {acc:.4f}, F1: {f1:.4f}")
💡 使用
mlflow.autolog()可以自动捕获主流框架(PyTorch、TensorFlow、XGBoost、LightGBM 等)的参数和指标,减少样板代码。但对于自定义训练循环(如 PyTorch 手写 loop),仍需手动log_metric。
1.2 MLflow Model Registry——模型注册中心
Section titled “1.2 MLflow Model Registry——模型注册中心”训练完成后,模型需要进入注册中心(Registry)进行统一管理。每个模型在 Registry 中是一个 Registered Model,拥有多个 Version,每个 Version 处于一个 Stage:
| Stage | 含义 |
|---|---|
None | 刚注册,尚未进入任何阶段 |
Staging | 已通过基础测试,等待线上验证 |
Production | 正在为线上用户提供服务 |
Archived | 已下线,保留用于回溯 |
from mlflow.tracking import MlflowClient
client = MlflowClient()
# 将某个 run 的模型注册为 Registered Model(首次注册会自动创建)result = mlflow.register_model(    model_uri="runs:/<RUN_ID>/model",    name="fraud-detection-xgb",)print(f"Registered version: {result.version}")
# 将版本 3 从 None 转换到 Stagingclient.transition_model_version_stage(    name="fraud-detection-xgb",    version=3,    stage="Staging",)
# 验证通过后,升级到 Productionclient.transition_model_version_stage(    name="fraud-detection-xgb",    version=3,    stage="Production",    archive_existing_versions=True,  # 自动将旧的 Production 版本归档)
1.3 MLflow Model Serving——快速部署
Section titled “1.3 MLflow Model Serving——快速部署”# 启动 MLflow tracking server(通常部署在团队共享服务器上)mlflow server \ --backend-store-uri postgresql://user:pass@db/mlflow \ --default-artifact-root s3://my-bucket/mlflow-artifacts \ --host 0.0.0.0 \ --port 5000
# 将 Production 阶段的模型一键部署为 REST API 服务mlflow models serve \ -m models:/fraud-detection-xgb/Production \ -p 6000 \ --host 0.0.0.0
# 测试推理curl -X POST http://localhost:6000/invocations \ -H "Content-Type: application/json" \ -d '{"dataframe_split": {"columns": ["amount", "hour", "merchant_id"], "data": [[150.0, 14, 42]]}}'⚠️ MLflow 内置的 serving server 适合开发和中小流量场景。生产环境高并发推荐使用 AI 后端服务 中介绍的 FastAPI + Triton / BentoML 方案。
2. 模型版本管理
Section titled “2. 模型版本管理”2.1 Model Registry 的阶段转换与审批
Section titled “2.1 Model Registry 的阶段转换与审批”模型版本管理不同于代码版本管理(Git)。代码关心”这行代码是什么时候写的”,模型版本管理关心”这个版本的模型是否被批准上线”。
典型的审批流程:
- 数据科学家提交训练代码 → CI 触发自动训练 → 新版本注册为
None - 自动化评估通过(指标达标)→ 自动转到
Staging - Staging 环境影子验证(shadow deployment)3 天 → 人工审批
- 审批通过 → 转到
Production,旧版本自动归档 - 若线上异常 → 一键回滚到归档版本
2.2 模型血缘(Model Lineage)
Section titled “2.2 模型血缘(Model Lineage)”模型血缘记录”这个模型是从哪个数据版本、哪份代码、哪组超参数训练出来的”。MLflow 自动关联 run 的 Git commit、参数和数据路径,使每个 Production 模型完全可追溯。
| 维度 | Git(代码版本管理) | MLflow Registry(模型版本管理) |
|---|---|---|
| 管理对象 | 源代码文本 | 训练产出的二进制模型文件 |
| 版本触发 | 手动 commit / merge | 训练完成后自动注册 |
| 审批机制 | Pull Request review | Stage 转换 + 审批流 |
| 回滚方式 | git revert | Stage 切换到旧版本 |
| 核心关注 | 代码逻辑正确性 | 模型在特定数据上的表现 |
3. 数据版本管理(DVC)
Section titled “3. 数据版本管理(DVC)”3.1 为什么数据也需要版本管理
Section titled “3.1 为什么数据也需要版本管理”Git 擅长管理文本代码,但不适合管理 GB 级甚至 TB 级的数据文件——Git 仓库会膨胀到无法克隆。然而数据是模型的输入,如果数据发生了变化(新增样本、特征工程修改、标注修正),模型的输出就会不同。没有数据版本管理,就无法复现一次训练实验。
DVC(Data Version Control)就是解决这个问题的工具。
3.2 DVC 的工作原理
Section titled “3.2 DVC 的工作原理”DVC 采用 Git 存储元数据 + 远程存储实际数据 的分离策略:
- Git 仓库:存储
.dvc文件(小型 meta 文件,记录数据的 hash 和远程路径) - 远程存储(S3、GCS、NFS、SSH 等):存储实际的大文件
# 初始化 DVC(在已有 Git 仓库中执行)dvc init
# 添加数据文件(生成 data.csv.dvc 元文件,实际数据移到 .dvc/cache)dvc add data/raw/train.csv
# 提交元文件到 Gitgit add data/raw/train.csv.dvc .gitignoregit commit -m "feat: add training data v1"
# 配置远程存储dvc remote add -d storage s3://my-bucket/dvc-storage
# 将数据推送到远程存储dvc push
# --- 场景:同事 clone 了仓库,需要拉取数据 ---git clone https://github.com/team/project.gitdvc pull    # 从远程存储下载 .dvc 文件指向的数据
# --- 场景:切换到历史版本的数据 ---git checkout v1.0dvc checkout   # 将工作目录的数据文件恢复到 v1.0 版本
💡
.dvc文件的内容类似:Git 只追踪这个小文件,实际数据存在远程,因此仓库始终保持轻量。
3.3 数据血缘(Data Lineage)
Section titled “3.3 数据血缘(Data Lineage)”数据血缘追踪数据从原始采集到最终用于训练的全链路变换。DVC 通过 pipeline(dvc.yaml)定义数据加工流水线:
# dvc.yaml — 声明数据加工流水线stages: preprocess: cmd: python src/preprocess.py --input data/raw/train.csv --output data/processed/train.parquet deps: - data/raw/train.csv - src/preprocess.py outs: - data/processed/train.parquet train: cmd: python src/train.py --data data/processed/train.parquet --model models/xgb.pkl deps: - data/processed/train.parquet - src/train.py outs: - models/xgb.pkl# 自动按依赖关系执行整个流水线(类似 Makefile)dvc repro # 如果 raw/train.csv 没变,直接跳过
# 查看数据血缘 DAGdvc dag这样,任何一层输入数据发生变化,DVC 会自动知道下游需要重新执行,形成完整的数据血缘追溯链。
4. 监控——模型漂移、数据质量与推理延迟
Section titled “4. 监控——模型漂移、数据质量与推理延迟”上线只是开始,持续监控才是 MLOps 最核心的运维价值。监控分为三个层次:
4.1 Concept Drift vs Data Drift
Section titled “4.1 Concept Drift vs Data Drift”| 类型 | 定义 | 典型原因 | 检测方法 |
|---|---|---|---|
| Data Drift(数据漂移 / 协变量偏移) | 特征分布 发生变化,但 $P(Y | X)$ 不变 | 用户群体变化、季节性波动 |
| Concept Drift(概念漂移) | $P(Y | X)$ 发生变化,即特征与标签的关系变了 | 市场结构变化、疫情等黑天鹅事件 |
数学上:
💡 一个形象类比:Data Drift 是”考题的难度分布变了”,Concept Drift 是”标准答案变了”。前者可以用统计方法直接检测,后者通常只能通过预测准确率下降来间接发现。
4.2 PSI(Population Stability Index)——数据漂移的量化指标
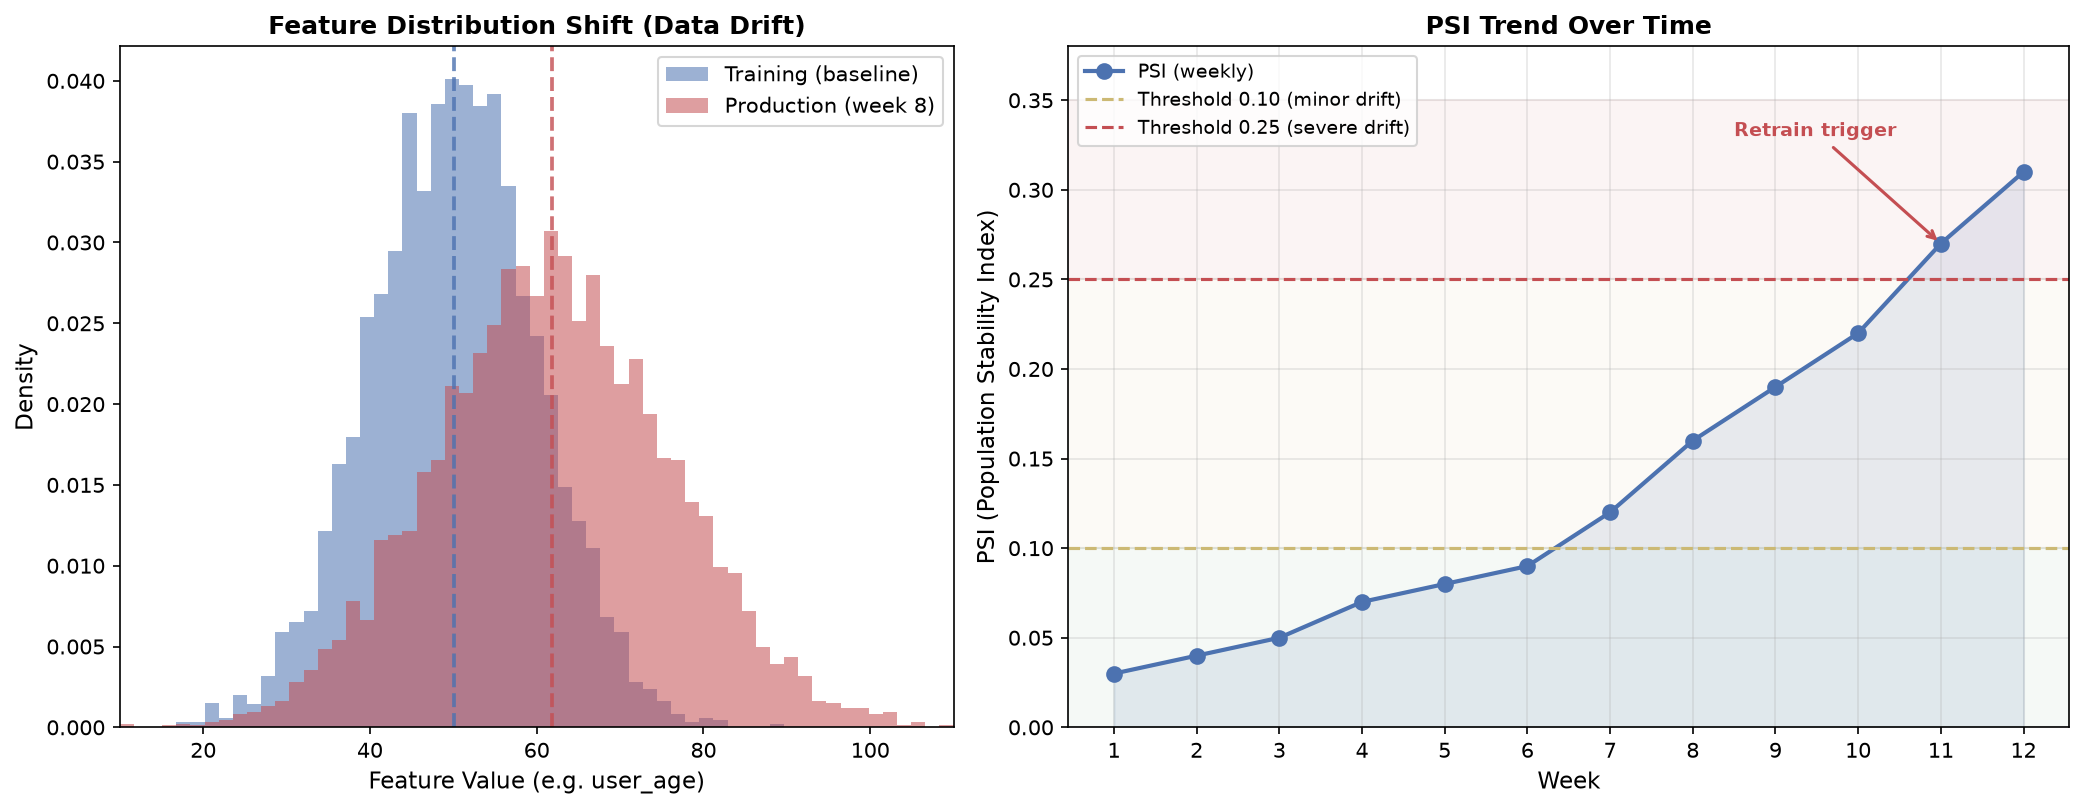
Section titled “4.2 PSI(Population Stability Index)——数据漂移的量化指标”PSI 衡量两个分布之间的稳定性,广泛用于金融风控和推荐系统中检测特征漂移。计算公式:
其中 和 分别是训练集和生产环境中第 个分箱的样本占比。判定标准:
| PSI 范围 | 漂移程度 | 建议动作 |
|---|---|---|
< 0.1 | 几乎无漂移 | 正常运行 |
0.1 – 0.25 | 轻度漂移 | 关注并加强监控频率 |
> 0.25 | 严重漂移 | 触发再训练 |
下图直观展示了特征分布随时间的偏移及对应的 PSI 变化趋势:
import numpy as npimport pandas as pd
def calculate_psi(expected: np.ndarray, actual: np.ndarray, buckets: int = 10) -> float:    """计算 PSI(Population Stability Index)。
    Args:        expected: 训练(基线)分布的特征值        actual:   生产环境当前的特征值        buckets:  分箱数量
    Returns:        PSI 值,越小表示分布越稳定    """    # 以训练分布的分位数作为分箱边界,确保每箱样本量大致均匀    breakpoints = np.percentile(expected, np.linspace(0, 100, buckets + 1))    breakpoints[0] = -np.inf    breakpoints[-1] = np.inf
    expected_pct = np.histogram(expected, bins=breakpoints)[0] / len(expected)    actual_pct = np.histogram(actual, bins=breakpoints)[0] / len(actual)
    # 避免除零和 log(0):给每箱一个极小下限    epsilon = 1e-6    expected_pct = np.clip(expected_pct, epsilon, None)    actual_pct = np.clip(actual_pct, epsilon, None)
    psi = np.sum((actual_pct - expected_pct) * np.log(actual_pct / expected_pct))    return float(psi)
# 示例:训练集 vs 第 8 周线上数据np.random.seed(42)baseline = np.random.normal(50, 10, 50000)current  = np.random.normal(62, 14, 50000)
psi = calculate_psi(baseline, current)print(f"PSI = {psi:.4f}")  # PSI = 0.31+ → 严重漂移,需触发再训练
4.3 数据 Schema 校验
Section titled “4.3 数据 Schema 校验”除了分布漂移,还要监控数据本身的完整性:字段是否缺失、类型是否正确、值域是否合理。Great Expectations 和 Pandera 是常用工具:
import pandera as paimport pandas as pd
# 定义数据 schema 约束schema = pa.DataFrameSchema({    "user_id":    pa.Column(int,    nullable=False, unique=True),    "age":        pa.Column(int,    checks=pa.Check.in_range(0, 150)),    "amount":     pa.Column(float,  checks=pa.Check.gt(0)),    "signup_date": pa.Column(pa.DateTime),})
# 每次批量推理前自动校验try:    schema.validate(production_batch, lazy=True)except pa.errors.SchemaErrors as err:    alert_ops_team(err.failure_cases)  # 触发告警
4.4 推理延迟监控
Section titled “4.4 推理延迟监控”模型推理的延迟直接影响用户体验。关键指标是 分位数延迟(quantile latency):
| 指标 | 含义 | 关注点 |
|---|---|---|
| p50 | 中位数延迟 | 整体基线水平 |
| p95 | 95 分位延迟 | 大部分用户的体验上限 |
| p99 | 99 分位延迟 | 尾部延迟(tail latency),长尾用户体验 |
# 使用 Prometheus + Grafana 监控推理延迟分布# 典型告警规则(PromQL):p99 延迟超过 500ms 持续 5 分钟- alert: HighInferenceLatency expr: histogram_quantile(0.99, rate(inference_latency_bucket[5m])) > 0.5 for: 5m labels: severity: warning annotations: summary: "Model inference p99 latency above 500ms"💡 关于延迟指标的时间序列分析与预测,可以参考 时间序列分析。
5. CI/CD——ML 流水线自动化
Section titled “5. CI/CD——ML 流水线自动化”ML 的 CI/CD 比传统软件复杂:除了跑测试,还需要下载训练数据、可能需要 GPU runner、还要注册和部署模型。
5.1 GitHub Actions 示例
Section titled “5.1 GitHub Actions 示例”name: ML Training Pipeline
on: push: branches: [main] paths: - 'src/**' - 'data/**' - 'dvc.yaml' workflow_dispatch: # 允许手动触发
jobs: train-and-deploy: runs-on: ubuntu-latest steps: - uses: actions/checkout@v4
- name: Set up Python uses: actions/setup-python@v5 with: python-version: '3.11'
- name: Install dependencies run: | pip install -r requirements.txt pip install dvc mlflow
- name: Pull data from DVC remote env: AWS_ACCESS_KEY_ID: ${{ secrets.AWS_KEY }} AWS_SECRET_ACCESS_KEY: ${{ secrets.AWS_SECRET }} run: dvc pull
- name: Run training env: MLFLOW_TRACKING_URI: ${{ secrets.MLFLOW_URI }} run: | dvc repro train # 获取本次训练的 run id echo "RUN_ID=$(cat outputs/latest_run_id.txt)" >> $GITHUB_ENV
- name: Evaluate model quality run: | python scripts/evaluate.py --run-id ${{ env.RUN_ID }} --threshold 0.90 # 如果准确率低于 0.90,脚本会以非零退出码失败,流水线中止
- name: Register model to MLflow if: success() run: | python scripts/register_model.py \ --run-id ${{ env.RUN_ID }} \ --name fraud-detection-xgb \ --stage Staging
- name: Deploy to staging server if: success() run: | ssh deploy@staging.internal "bash ~/deploy.sh fraud-detection-xgb Staging"5.2 ML CI 的特殊性
Section titled “5.2 ML CI 的特殊性”| 方面 | 传统软件 CI | ML CI |
|---|---|---|
| 运行环境 | CPU 即可 | 可能需要 GPU runner(自建或云服务) |
| 数据依赖 | 无 | 需要从 DVC remote / S3 下载数据 |
| 执行时间 | 秒~分钟 | 可能数十分钟甚至数小时 |
| 通过标准 | 测试用例通过 | 指标达到阈值(accuracy > X) |
| 非确定性 | 确定性 | 随机种子 / GPU 浮点差异可能导致结果波动 |
⚠️ GPU runner 的成本远高于 CPU runner。实践中通常将 CI 拆分:代码检查和单元测试用 CPU runner(快速反馈),完整训练和评估用 GPU runner(合并到 main 后触发)。
6. 模型更新策略
Section titled “6. 模型更新策略”模型训练完成并通过验证后,如何安全地将新版本推送到线上?以下是四种主流策略:
| 策略 | 机制 | 流量切换 | 适用场景 | 回滚速度 |
|---|---|---|---|---|
| 蓝绿部署 (Blue-Green) | 两套环境并行,瞬间全量切换 | 0% → 100% | 版本质量高信心足、低风险更新 | 极快(切回 Blue) |
| 金丝雀发布 (Canary) | 逐步增加新版本流量比例 | 5% → 25% → 50% → 100% | 不确定新版本稳定性、需要观察 | 快(调回流量比例) |
| A/B 测试 | 按用户分桶长期并行对比 | 各 50%(持续) | 需要量化对比业务指标(点击率、转化率) | 不需要回滚,选优者 |
| 影子模式 (Shadow) | 新版本只推理,结果不影响用户 | 0%(仅记录) | 大改版、零风险验证 | 无需回滚(从未上线) |
💡 实践中常组合使用:先用影子模式验证无误,再走金丝雀逐步放量,全量切换即蓝绿部署,同时用 A/B 测试量化收益。
6.1 各策略详细说明
Section titled “6.1 各策略详细说明”蓝绿部署(Blue-Green Deployment):准备两套完全相同的环境(Blue 和 Green),线上流量始终指向其中一套。部署新版本时,先部署到另一套环境并验证,然后一次性将流量全部切换。优点是切换瞬间完成、回滚只需切回;缺点是需要双倍资源,且切换瞬间如果新版本有 bug,所有用户都会受影响。
金丝雀发布(Canary Release):名字来源于矿工曾用金丝雀检测瓦斯——先用一小部分流量”试探”。新版本先承接 5% 的流量,观察一段时间(小时或天级别)确认无异常,再逐步扩大到 25% → 50% → 100%。任何阶段发现异常,立即将流量切回旧版本。
A/B 测试:不是一次性发布,而是持续将用户随机分桶(如按 user_id 取模),不同桶看到不同版本的模型,持续收集业务指标(如推荐系统的点击率 CTR)。经过统计显著性检验后,选择表现更好的版本。与 时间序列分析 结合可以检测指标的季节性波动对实验的干扰。
影子模式(Shadow Deployment):新版本与旧版本同时接收线上请求并行推理,但只返回旧版本的结果给用户。新版本的预测结果被记录下来,离线与旧版本对比。这是零风险策略——即使新版本完全错误也不影响用户——适合大模型架构变更、推理框架迁移等高风险场景。
MLOps 全生命周期流水线
Section titled “MLOps 全生命周期流水线”将上述所有组件串联起来,一个完整的 MLOps 生命周期如下:
| 术语 | 英文 | 释义 |
|---|---|---|
| 模型漂移 | Model Drift | 线上模型性能随时间下降的现象,由数据或概念变化引起 |
| 数据漂移 | Data Drift / Covariate Shift | 特征分布 变化但 $P(Y |
| 概念漂移 | Concept Drift | 特征与标签的映射关系 $P(Y |
| PSI | Population Stability Index | 衡量两个分布稳定性的指标,>0.25 表示严重漂移 |
| 模型血缘 | Model Lineage | 模型与训练数据、代码、超参数之间的可追溯关系 |
| 数据血缘 | Data Lineage | 数据从原始到最终消费的全链路变换追踪 |
| 分位数延迟 | Quantile Latency | 延迟的统计分位数,如 p99 表示 99% 的请求延迟低于此值 |
| 金丝雀发布 | Canary Release | 先将少量流量导到新版本,逐步扩量的发布策略 |
| 影子部署 | Shadow Deployment | 新版本只推理不返回结果,用于零风险验证 |
| 蓝绿部署 | Blue-Green Deployment | 双环境并行,瞬时全量切换的部署策略 |
| 模型注册中心 | Model Registry | 统一管理模型版本和阶段(Staging/Production)的系统 |
| artifact | Artifact | 实验中产生的任意文件(模型权重、图表、配置等) |
| Run | Run | MLflow 中一次训练执行的记录单元 |
| DVC | Data Version Control | 基于 Git 元数据 + 远程存储的数据版本管理工具 |
| 再训练 | Retraining | 使用新数据重新训练模型以应对漂移 |
- 官方文档
- MLflow 官方文档 — 实验跟踪、模型注册、部署的全套指南
- DVC 官方文档 — 数据版本管理与流水线定义
- Google MLOps 白皮书 — MLOps 成熟度模型
- 相关页面
- 工程基础 — Docker、Git、Shell 等 MLOps 底层技能
- AI 后端服务 — 高并发模型推理服务架构(FastAPI、Triton)
- Python 工程进阶 — 训练代码的工程化最佳实践
- 时间序列分析 — 监控指标的季节性分析与异常检测
- 数据库与中间件 — 特征存储与消息队列在 MLOps 中的应用
- 开源生态
- Prefect / Airflow — ML 工作流编排调度
- Evidently AI — 开源模型漂移检测报告工具
- Weights & Biases — MLflow 的主流商业替代品
- Kubeflow — Kubernetes 原生的 ML 平台