
时序预测专题
本页是时间序列预测的进阶专题,聚焦于模型实现、评估方法和工程实践。基础概念(ARIMA 原理、STL 分解、平稳性检验、时序基础模型等)已在时间序列分析中系统介绍,此处不再重复——本页侧重动手实现与模型对比方法论。前置阅读:时间序列分析、RNN 与序列模型、Transformer 架构。
与 时间序列分析 的关系:那篇是”百科全书式”的全面介绍,覆盖经典统计到时序基础模型的完整谱系;本篇是”实战手册”,重点在于代码实现、评估方法论和模型选择的工程决策。
时间序列预测的工程核心不在于”用最复杂的模型”,而在于:建立正确的基线 → 选择合适的评估方法 → 系统性地对比多种方案。很多团队在时间序列项目上失败,不是因为模型不够先进,而是因为评估方法有数据泄露、基线不合理、或指标选择不当。
三大要点的直觉:
- 基线优先 = 永远从最简单的模型开始:朴素基线(Naive,“明天等于今天”)和季节朴素基线(Seasonal Naive,“下个月等于去年同月”)虽然简单得可笑,但它们是衡量一切复杂模型是否”值回票价”的标尺。如果你的 LSTM 还打不过朴素基线,说明模型在过拟合噪声而非学习模式。
- 评估重于建模 = 方向不对,越努力越错:时间序列评估最容易犯的错误是数据泄露(Data Leakage)——用未来信息预测过去。普通随机交叉验证在时序中是致命错误,必须用时序专用的滚动窗口评估。
- 模型对比 = 控制变量、公平比较:不同模型在不同数据集上表现可能完全反转。一个公平的对比实验需要统一的数据划分、统一的评估指标、足够的重复次数。
为什么普通交叉验证不能用?
Section titled “为什么普通交叉验证不能用?”普通 k-fold 交叉验证会随机打乱数据——训练集里可能包含时间上比测试集更晚的数据。在时间序列中,这意味着”用未来预测过去”,在现实中是不可能的。时序评估必须保证训练数据严格早于测试数据。
滚动窗口评估(Rolling Forecast)
Section titled “滚动窗口评估(Rolling Forecast)”最标准的时序评估方法是滚动窗口(Rolling Window / Walk-Forward Validation):
每轮评估后,将测试窗口的数据加入训练集,窗口向前滑动,模拟”真实场景中不断获得新数据”的过程。
扩展窗口 vs 滑动窗口:上图展示的是扩展窗口(Expanding Window)——训练集越来越大。另一种是固定大小滑动窗口(Sliding Window)——训练集大小固定,随时间向前滑动,适合数据分布随时间漂移(Concept Drift)的场景。
时间序列评估有自己的一套指标体系,每个指标关注的误差维度不同:
1. MAE(Mean Absolute Error,平均绝对误差)
最直观的误差指标——预测值与真实值之间的平均绝对差距。单位与原始数据相同,便于理解。对异常值不敏感(不像 MSE 那样惩罚大误差)。
2. RMSE(Root Mean Squared Error,均方根误差)
对大误差更敏感(因为平方放大了偏差)——如果你的业务中”偶尔的大偏差”代价很高(如电力负荷预测中的极端低估),优先关注 RMSE。
3. MAPE(Mean Absolute Percentage Error,平均绝对百分比误差)
百分比误差,不受数据量纲影响,适合跨数据集比较。致命缺点:当 时不可用;且当 很小时会被过度放大,导致指标不稳定。
4. sMAPE(Symmetric MAPE,对称 MAPE)
缓解 MAPE 的不对称性(MAPE 对高估和低估的惩罚不对称)。分母同时包含真实值和预测值,避免了 接近零时的爆炸。取值范围 [0%, 200%]。
5. MASE(Mean Absolute Scaled Error,平均绝对缩放误差)
将模型的 MAE 除以朴素基线(“上一步值作为当前预测”)的 MAE。 表示模型比朴素基线好; 表示还不如”瞎猜上一步值”。这是 Hyndman 推荐的首选指标——它无单位、有明确的基线参照、且不会因 失效。
指标选择建议:报告结果时,至少给出 MAE(直观)和 MASE(与基线对比)。如果业务关心大误差,加上 RMSE。避免只报告 MAPE——它在 接近零时极不稳定。
ARIMA 完整示例(statsmodels)
Section titled “ARIMA 完整示例(statsmodels)”import numpy as npimport pandas as pdfrom statsmodels.tsa.arima.model import ARIMAfrom statsmodels.tsa.stattools import adfullerfrom sklearn.metrics import mean_absolute_error
# === 1. 生成模拟数据(趋势 + 季节性 + 噪声) ===np.random.seed(42)n = 150t = np.arange(n)data = 20 + 0.3 * t + 8 * np.sin(2 * np.pi * t / 12) + np.random.randn(n) * 2ts = pd.Series(data, index=pd.date_range('2020-01-01', periods=n, freq='M'))
# === 2. 滚动窗口评估 ===train_size = 120horizon = 12 # 每轮预测 12 步train = ts[:train_size]test = ts[train_size:train_size + horizon]
# === 3. 平稳性检验 ===adf_result = adfuller(train)print(f"ADF p-value: {adf_result[1]:.4f}")# 如果 p > 0.05,需要差分(d=1 或更高)
# === 4. 拟合 ARIMA(2,1,1) ===model = ARIMA(train, order=(2, 1, 1))fitted = model.fit()print(fitted.summary())
# === 5. 预测与评估 ===forecast = fitted.forecast(steps=horizon)mae = mean_absolute_error(test, forecast)print(f"ARIMA MAE: {mae:.3f}")
# === 6. 朴素基线对比 ===naive_forecast = np.full(horizon, train.iloc[-1])naive_mae = mean_absolute_error(test, naive_forecast)print(f"Naive Baseline MAE: {naive_mae:.3f}")print(f"MASE: {mae / naive_mae:.3f}") # <1 表示优于朴素基线LSTM 预测器(PyTorch)
Section titled “LSTM 预测器(PyTorch)”import torchimport torch.nn as nnimport numpy as np
class LSTMForecaster(nn.Module): """单变量 LSTM 预测器:用过去 seq_len 步预测未来 horizon 步""" def __init__(self, input_size=1, hidden_size=64, num_layers=2, horizon=12): super().__init__() self.lstm = nn.LSTM(input_size, hidden_size, num_layers, batch_first=True, dropout=0.1) self.fc = nn.Linear(hidden_size, horizon) self.horizon = horizon
def forward(self, x): # x: (batch, seq_len, input_size) out, (h_n, c_n) = self.lstm(x) # 取最后一个时间步的输出 out = out[:, -1, :] # (batch, hidden_size) pred = self.fc(out) # (batch, horizon) return pred
def make_sequences(data, seq_len, horizon): """将一维时序数据切分为 (输入序列, 目标序列) 对""" X, Y = [], [] for i in range(len(data) - seq_len - horizon + 1): X.append(data[i:i + seq_len]) Y.append(data[i + seq_len:i + seq_len + horizon]) return np.array(X), np.array(Y)
# === 训练流程 ===# 1. 数据标准化(关键!LSTM 对尺度敏感)# scaler = StandardScaler()# data_scaled = scaler.fit_transform(data.reshape(-1, 1)).flatten()
# 2. 构建序列# X, Y = make_sequences(data_scaled, seq_len=24, horizon=12)# X = torch.FloatTensor(X).unsqueeze(-1) # (N, 24, 1)# Y = torch.FloatTensor(Y) # (N, 12)
# 3. 训练循环# model = LSTMForecaster(input_size=1, hidden_size=64, horizon=12)# optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)# criterion = nn.MSELoss()# for epoch in range(100):# pred = model(X)# loss = criterion(pred, Y)# optimizer.zero_grad()# loss.backward()# optimizer.step()
# 4. 预测时记得反标准化# pred_scaled = model(X_test)# pred = scaler.inverse_transform(pred_scaled.detach().numpy())LSTM 时序预测的关键工程细节:
- 必须标准化输入数据(如 StandardScaler / MinMaxScaler),否则 LSTM 训练不稳定。
- 标准化只能用训练集的统计量——如果用了全量数据的均值/方差就构成了数据泄露。
- Early Stopping 防止过拟合——时序数据比表格数据更容易过拟合。
- 多步预测的两种策略:直接多步输出(LSTM 最后一个全连接层输出 horizon 个值)vs 自回归(预测一步、再喂回去预测下一步)。前者训练简单但误差不累积;后者适合长 horizon 但误差会累积传播。
Prophet 完整示例
Section titled “Prophet 完整示例”import pandas as pdfrom prophet import Prophetfrom sklearn.metrics import mean_absolute_errorimport numpy as np
# 生成数据np.random.seed(42)n = 150dates = pd.date_range('2020-01-01', periods=n, freq='M')y = 20 + 0.3 * np.arange(n) + 8 * np.sin(2 * np.pi * np.arange(n) / 12) + np.random.randn(n) * 2df = pd.DataFrame({'ds': dates, 'y': y})
train = df[:120]test = df[120:132]
# Prophet 擅长处理节假日和变点(changepoint)m = Prophet( yearly_seasonality=True, weekly_seasonality=False, daily_seasonality=False, changepoint_prior_scale=0.05, # 值越大越灵活(容易过拟合) seasonality_prior_scale=10.0,)m.fit(train)
# 预测future = m.make_future_dataframe(periods=12, freq='M')forecast = m.predict(future)pred = forecast['yhat'][120:132]
mae = mean_absolute_error(test['y'], pred)print(f"Prophet MAE: {mae:.3f}")
# Prophet 输出预测区间(概率预测)# forecast['yhat_lower'] / forecast['yhat_upper'] = 80% 置信区间时序基础模型零样本预测(Chronos)
Section titled “时序基础模型零样本预测(Chronos)”"""Amazon Chronos:将时间序列"分词"为离散 token,用预训练语言模型做自回归预测——无需训练即可零样本预测。"""# pip install chronos-forecasting# import torch# from chronos import ChronosPipeline
# pipeline = ChronosPipeline.from_pretrained(# "amazon/chronos-t5-small", # 也有 base/large 版本# device_map="cpu",# torch_dtype=torch.float32,# )
# # 输入历史数据(一维数组)# context = torch.tensor(your_historical_data)
# # 零样本预测(无需训练!)# forecast = pipeline.predict(context, prediction_length=12)
# # forecast: (num_samples, prediction_length) —— 概率预测# forecast_median = np.median(forecast[0].numpy(), axis=0)# forecast_low = np.percentile(forecast[0].numpy(), 10, axis=0)# forecast_high = np.percentile(forecast[0].numpy(), 90, axis=0)模型对比实验
Section titled “模型对比实验”以下是不同模型在同一合成数据集上的预测效果对比。数据包含线性趋势 + 年度季节性 + 随机噪声:
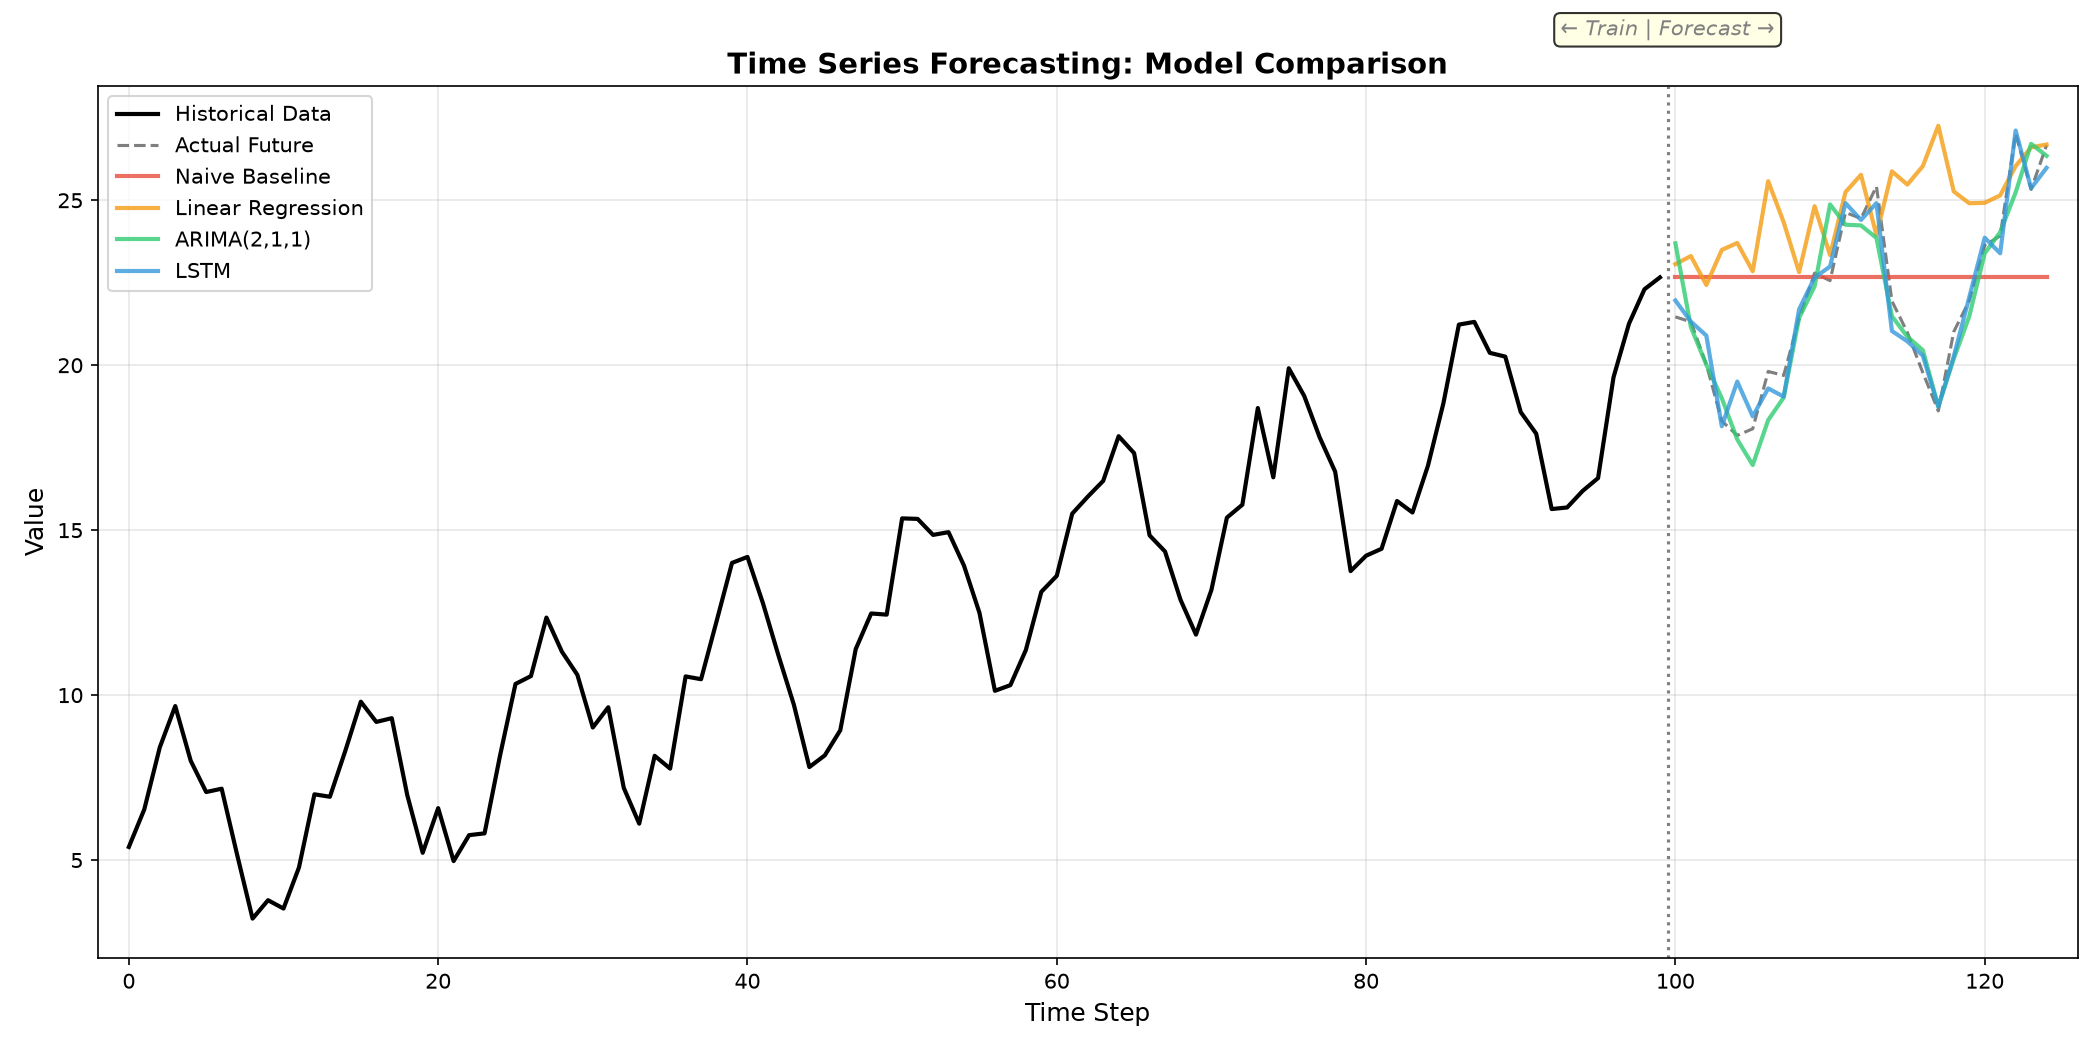
上图解读:朴素基线(红色)完全忽略了趋势和季节性,预测为常数——这是最差的基线。线性回归(橙色)捕捉到趋势但忽略了季节性。ARIMA(绿色)同时捕捉到趋势和季节性,效果最好。LSTM(蓝色)接近真实值但有轻微波动。关键启示:模型越复杂不一定越好——关键在于模型能否捕捉数据中的核心模式(趋势 + 季节性)。
公平对比的工程清单
Section titled “公平对比的工程清单”| 要点 | 说明 |
|---|---|
| 统一数据划分 | 所有模型使用完全相同的训练/测试集划分 |
| 统一评估指标 | 至少报告 MAE + MASE,避免只选对自己有利的指标 |
| 多轮评估 | 用滚动窗口做多轮评估,取平均 ± 标准差 |
| 统计显著性 | 模型间差异小时,做 Diebold-Mariano 检验确认差异是否显著 |
| 超参数公平 | 每个模型都做超参数搜索,不能只给复杂模型调参 |
| 计算成本对比 | 精度相近时,推理延迟和训练成本可能是决定因素 |
原理补充:ARIMA 的数学细节
Section titled “原理补充:ARIMA 的数学细节”ARIMA(p, d, q) 模型的完整表达式。先对原始序列 做 阶差分得到平稳序列 :
然后在 上拟合 ARMA(p, q) 模型:
其中:
- 是自回归系数(AR 部分),编码”过去值对当前值的线性影响”
- 是移动平均系数(MA 部分),编码”过去预测误差对当前值的修正”
- 是白噪声——均值为零、方差恒定、不自相关的随机扰动
用后移算子 ()可以更简洁地表示:
其中 是 AR 特征多项式, 是 MA 特征多项式。
参数选择的经验法则:
- 用 ADF 检验确定差分阶数 :差分到 ADF p < 0.05(平稳)为止
- 用 PACF(偏自相关函数) 截尾位置确定 :PACF 在 lag 后截尾(突然变为零)
- 用 ACF(自相关函数) 截尾位置确定 :ACF 在 lag 后截尾
- 实践中更推荐用
auto_arima(pmdarima 库)自动搜索,按 AIC/BIC 排序
- 永远先建基线:朴素基线(
y_hat = y[-1])和季节朴素基线(y_hat = y[-season])只需一行代码,但能避免大量无效工作——如果你的复杂模型打不过它们,说明方向有问题。 - 标准化用训练集统计量:这是时序中最常见的隐蔽数据泄露。LSTM、Transformer 等需要标准化的模型,必须只用训练集的 mean/std 做标准化。
- 时序交叉验证:永远用
TimeSeriesSplit或滚动窗口评估,绝不能用普通随机交叉验证。sklearn.model_selection.TimeSeriesSplit提供了开箱即用的实现。 - 多步预测策略:短 horizon(1-3 步)用直接预测即可;长 horizon 优先考虑直接多步输出或 DirRec 策略(每步单独训练模型 + 自回归喂回),自回归策略虽简单但误差会累积。
- 概率预测:在风险管理和决策场景中,预测区间比点预测更有价值。Prophet、Chronos 原生支持概率预测;ARIMA 可以用残差分位数估计区间;深度学习方法用 MC Dropout 或分位数损失。
- 概念漂移(Concept Drift):如果数据分布随时间变化(如疫情前后的出行数据),固定训练的模型会逐渐失效。解决方案:定期重训练、滑动窗口训练(只用最近 N 个月)、或在线学习。
- 外生变量:如果有强相关的外生变量(如温度对电力负荷的影响),优先用 ARIMAX / SARIMAX / 多变量 LSTM。但注意:预测时也需要预测外生变量本身,如果外生变量本身难预测,反而引入新的不确定性。
最新进展(2024-2025)
Section titled “最新进展(2024-2025)”- 时序基础模型爆发:TimesFM(Google, 200M 参数)、Chronos(Amazon, 基于 T5)、Moirai(Salesforce, 支持多变量 + 概率预测)、TimeGPT(Nixtla, 商业 API)——这些模型在海量时序数据上预训练,可以直接在新数据集上零样本预测,大幅降低了时序预测的工程门槛。2025 年的趋势是从零样本走向少量微调(Few-shot Fine-tuning),在特定领域(金融、能源、零售)上进一步提升精度。
- AOT(Amazon, 2024):Autoregressive Olmo-based Time-series forecaster——用 LLM 架构统一处理时序和文本,可以接受自然语言描述作为上下文信息。
- Timer(2024):生成式预训练时序 Transformer,在大规模时序数据上预训练,通过微调适配下游任务。
- PatchTST 持续引领:将时间序列切分为 patch 再做注意力(借鉴 ViT 思想)的方案在 2024-2025 年被广泛验证有效,成为 Transformer 时序预测的事实标准架构。
- iTransformer(ICLR 2024):反转注意力维度——在变量维度而非时间维度做注意力。看似简单的改变却在多个基准上大幅提升,说明时序 Transformer 的很多”创新”可能是在解决错误的问题。
- TabPFN-TS(2025):将表格数据的 TabPFN 思路引入时序——用预训练 Transformer 在上下文学习(In-Context Learning)方式做时序预测,无需梯度更新。
- 销量预测 → 零售/电商:预测未来 1-4 周各 SKU 销量,指导备货和库存管理。Prophet + 节假日效应是零售场景的经典方案。
- 电力负荷预测 → 能源:预测未来 24-72 小时各区域用电量。ARIMAX(加入温度作为外生变量)和 LSTM 是常用方案。
- 金融预测 → 量化交易/风险管理:股价、汇率、波动率预测。深度学习在高频交易中有一定优势,但长期预测受有效市场假说限制。
- 需求预测 → 供应链:预测各仓库未来需求,优化物流调度。时序基础模型(TimesFM / Chronos)的零样本能力特别适合”大量 SKU、每个 SKU 数据量少”的长尾场景。
- AIOps → 运维:服务器 CPU/内存/带宽预测、异常检测。LSTM 和 Transformer 用于预测正常基线,偏离基线则触发告警。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| statsmodels | Python | ARIMA / SARIMAX / 指数平滑 / STL 分解 / ADF 检验 |
| pmdarima | Python | auto_arima 自动参数搜索 |
| Prophet | Python | Facebook 开源,擅长业务预测 + 节假日效应 |
| NeuralProphet | Python | Prophet 的神经网络增强版 |
| darts | Python | 统一接口覆盖 ARIMA → Transformer 全谱方法,推荐入门 |
| sktime | Python | 基于 scikit-learn API 的时序工具库 |
| gluonts | Python | Amazon 开源的概率时序预测框架(Gaussian Process / DeepAR / Transformer) |
| neuralforecast | Python | Nixtla 的深度学习时序预测库(NBEATS / NHITS / TFT / PatchTST) |
| Chronos | Python | Amazon 时序基础模型,零样本预测 |
| TimesFM | Python | Google 时序基础模型,零样本预测 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 滚动窗口评估 | Rolling Forecast / Walk-Forward | 训练集随时间扩展,模拟真实预测场景的评估方法 |
| 数据泄露 | Data Leakage | 训练时使用了预测时不该知道的信息(如未来数据) |
| 概率预测 | Probabilistic Forecasting | 输出预测分布(区间)而非单一点估计 |
| 分位数损失 | Quantile Loss / Pinball Loss | 用于训练分位数预测模型的非对称损失函数 |
| 概念漂移 | Concept Drift | 数据分布随时间变化,导致模型逐渐失效 |
| 外生变量 | Exogenous Variable | 影响目标变量但不受其影响的外部输入变量 |
| 朴素基线 | Naive Baseline | 最简单的预测方法(如”明天等于今天”),作为模型评估的基准 |
| MASE | Mean Absolute Scaled Error | 相对于朴素基线的缩放误差,推荐的首选评估指标 |
| 自回归策略 | Autoregressive Strategy | 预测一步后将预测值喂回模型预测下一步的多步预测策略 |
- 基础理论:时间序列分析——本站对时间序列的全面介绍,覆盖 ARIMA、STL 分解、时序基础模型等。
- ARIMA 经典教材:Hyndman & Athanasopoulos,《Forecasting: Principles and Practice》(3rd ed., 2021, 免费在线)——时序预测的最佳入门书,配有 R 代码。
- Prophet 论文:Taylor & Letham 2018 “Forecasting at Scale”(PeerJ)——Prophet 的设计理念:可调、可解释、对业务数据友好。
- PatchTST:Nie et al. ICLR 2023 “A Time Series is Worth 64 Words”——把 ViT 的 patch 思路引入时序,成为 Transformer 时序预测的标准架构。
- iTransformer:Liu et al. ICLR 2024 “iTransformer: Inverted Transformers are Effective for Time Series Forecasting”——反转注意力维度的简洁创新。
- Chronos:Ansari et al. 2024 “Chronos: Learning the Language of Time Series”(Amazon)——用语言模型做时序预测的巧妙方法。
- 深度学习基础:RNN 与序列模型 和 Transformer 架构 是理解 LSTM 和 Transformer 时序模型的必要前置知识。