
Flash Attention
Flash Attention 是一种 IO 感知的注意力计算方法,通过分块(tiling)、在线 softmax(online softmax)和重计算(recomputation)三大技术,在不改变注意力数学结果的前提下,把 GPU 高带宽内存(HBM)的读写量从二次方级降到线性级,让长序列训练和推理都大幅加速。它是当今所有主流大模型训练与推理的标配。前置阅读可参考混合精度训练、分布式训练;推理侧的更多加速手段见推理优化。
先用一个生活化的比喻理解它的本质。
标准注意力像”把整仓库的货搬到办公桌上再算”。 假设你是一个极其心算快速的会计(GPU 算力),但货物(数据)都存在几公里外的仓库(HBM)。标准做法是:叫卡车把 N×N 的整张注意力分数矩阵全拉到办公桌(SRAM 片上缓存),算完 softmax 再把结果装车运回仓库。你算得飞快,但大部分时间都花在等卡车上——算力闲置,IO 成了瓶颈。
Flash Attention 像”流水线分块处理”。 你不再等整张矩阵到齐,而是让卡车每次只运一小批货物(Q、K、V 分块)到桌上。每来一块,你立刻在桌上算完、更新好中间结果,只把最终汇总的输出装车运回仓库。中间那个巨大的 N×N 矩阵从头到尾就没离开过桌面、也没进过仓库——你的心算速度终于被充分利用,卡车也不再排长队。
一句话总结:Flash Attention 不是让你算得更少,而是让你搬得更少。 计算量(FLOP 数)几乎不变,但 HBM 的读写次数大幅下降——而在现代 GPU 上,搬运数据远比计算昂贵。
标准注意力的问题
Section titled “标准注意力的问题”标准注意力的计算公式是:
其中 Q、K、V 的形状都是 (N, d),N 是序列长度,d 是每个注意力头的维度。关键问题出在中间的分数矩阵 S = Q * K^T:它的大小是 N×N。
当 N 较小(比如 512)时,N×N = 26 万个元素,不算什么。但当序列增长到 N = 8192、32768 甚至十万级时,这个矩阵以二次方膨胀:N 翻倍,矩阵大 4 倍。以 N = 32768 为例,单是这一个注意力头的分数矩阵就要存超过 10 亿个浮点数。
但内存还不是最致命的。更严重的是IO 瓶颈:标准实现中,这个巨大的中间矩阵 S 要写入 GPU 的 HBM(高带宽内存),紧接着 softmax 又要从 HBM 读回它,归一化后再写回去,最后再读出来和 V 相乘。一来一回,HBM 被反复读写 N×N 规模的数据。而现代 GPU 的计算单元(Tensor Core)速度远超内存带宽——以 H100 为例,算力约 1000 TFLOPS(FP16),而 HBM 带宽约 3 TB/s。换句话说,GPU 计算单元大部分时间在干等数据搬完。计算其实很快,慢在搬数据。
IO 感知的核心理念
Section titled “IO 感知的核心理念”Flash Attention 的核心洞察来自一篇经典的 GPU 性能模型论文(Ivanov et al.):减少 IO 比减少计算更有效。
Flash Attention 的 FLOP 数与标准注意力基本相同(甚至略多一点,因为重计算),但它把 HBM 的读写量大幅压缩。由于 GPU 计算远快于内存搬运,省下的 IO 时间远超多算的那点开销。这就像一条流水线上,你宁可让工人多拧两颗螺丝(多算),也别让他多跑两趟仓库(多搬)。
Tiling(分块)
Section titled “Tiling(分块)”分块是减少 IO 的直接手段。GPU 上有两种存储:
- HBM(高带宽内存):容量大(几十 GB),但带宽相对有限,离计算单元远。
- SRAM(片上高速缓存):容量小(每个 SM 约几百 KB),但带宽极高,紧挨着计算单元。
Flash Attention 的做法是:把 Q、K、V 沿序列维度切成小块(block,通常几十到一百多个 token),每次只把一小块 Q 和若干块 K、V 从 HBM 加载到 SRAM。在 SRAM 内部完成这一小块的所有计算(矩阵乘、softmax、与 V 相乘),只把最终输出的一小块写回 HBM。那个巨大的 N×N 分数矩阵全程只在 SRAM 中以分块形式短暂存在,从不落盘到 HBM。
这样一来,HBM 的读写量从 O(N²) 级降到了 O(N² * d / M),其中 M 是 SRAM 的大小——实际上接近线性级。
Tiling 的 IO 复杂度推导
Section titled “Tiling 的 IO 复杂度推导”为什么是 O(N²d / M)?我们可以一步步推导。
标准注意力的 IO 量:Q 和 K 相乘得到 N×N 的分数矩阵 S,它被写入 HBM 再读回来,仅这一步就至少要读写 N² 个元素。加上 Q、K、V 的读入和输出写入,总量为:
当 N >> d 时(长序列正是如此),N² 占主导。
Flash Attention 的分块 IO 量:把 Q 分成大小为 B_r 行的块(沿 N 维切),K、V 分成大小为 B_c 列的块。为了让 Q_block × K_block^T 能装进 SRAM(大小为 M),需要满足 B_r · B_c + B_r · d + B_c · d ≤ M。选择 B_r ≈ B_c ≈ M / d(这是使每块尽可能大的合理选择)。
- Q 的分块数 = N / B_r ≈ N·d / M
- K、V 的分块数 = N / B_c ≈ N·d / M
对每个 Q 块,需要遍历所有 K、V 块,所以从 HBM 加载的总量为:
每块 Q 的 IO:加载 + 所有 K、V 块()+ 写出
所有 Q 块合计:
代入 B_r ≈ M/d:
关键结论:IO 量从 O(N²) 变成了 O(N²d/M)。由于 M(SRAM 大小,约 100KB–1MB)远大于 d(通常 64–128),因子 d/M 是一个很小的数(比如 64/100000 ≈ 0.0006),所以实际 IO 量远低于标准注意力。
类比理解:想象你在看一本 N 页的书,要做一个 N×N 的交叉引用表。标准做法是把整张表(N²)画在一张巨大的纸上(HBM),每画一格就要在巨幅纸上来回走动。分块做法是每次只拿一小叠纸(B_r 页),对照全书(N 页)逐批画完,每次在桌上(SRAM)画一小块就完成,巨幅纸根本不存在。桌子越大(M 越大),每叠拿的页越多,走的趟数越少。
Online Softmax(在线 softmax)
Section titled “Online Softmax(在线 softmax)”分块带来一个数学难题:softmax 需要先遍历一整行求最大值(用于数值稳定),再遍历一次求指数和(分母),最后做归一化——标准实现是两遍遍历。但在分块流式处理中,K、V 是一块一块进来的,每一块的分数算出来后就要立刻归一化并乘以 V 累加,你根本没有”一整行”可用。
Flash Attention 用了一个巧妙的数学技巧叫在线 softmax(也叫 streaming softmax / numerically stable streaming softmax)。核心思想是:维护两个随分块流入不断更新的统计量——当前已见到的最大值 m,以及归一化后的指数和 l。每来一个新的 K 块:
- 算出当前块的局部分数和局部最大值。
- 用新最大值修正之前累加的结果(因为全局最大值可能被新块刷新,之前算的指数要按比例缩放)。
- 更新全局最大值 m 和指数和 l,并把当前块的 softmax 结果累加到输出。
整个过程只需一遍流式遍历,数学上与标准 softmax 完全等价,而且数值稳定(始终减去当前最大值避免指数溢出)。这是 Flash Attention 能在分块中算出精确 softmax 的关键。
Online Softmax 的完整数学推导
Section titled “Online Softmax 的完整数学推导”为了彻底理解”为什么分块累加能得到精确 softmax”,我们需要严格推导。以下是逐步过程。
目标:给定一个长度为 N 的向量 x = [x₁, x₂, …, x_N],计算 softmax(x)_i = e^(x_i) / Σ_j e^(x_j)。但数据是分块流入的,我们只能逐块处理。
数值稳定的标准 softmax(两遍):
第一遍:找全局最大值
第二遍:求和并归一化
Online softmax(一遍,流式):
假设前 k 个元素已经处理完,我们维护两个统计量:
- m:已见元素的全局最大值
- l:已见元素的归一化指数和,即
l = Σ_{j=1}^{k} e^(x_j - m)
现在第 (k+1) 个元素到来,记这一步输入的子集为”新块”,其局部最大值为 m_new_block,局部和为 l_new_block = Σ_{j∈新块} e^(x_j - m_new_block)。
步骤 1:更新全局最大值
步骤 2:修正旧统计量
因为全局最大值从 m_old 变成了 m_new,之前算的指数基线变了。旧和 l_old 是以 m_old 为基准算的:
要把它换成以 m_new 为基准:
步骤 3:修正新块统计量
同理,新块的 l_new_block 是以 m_new_block 为基准算的:
步骤 4:合并
这就是 Flash Attention 论文中的核心递推公式:
步骤 5:输出累加
注意力输出也需要同步修正。设旧输出为 O_old(以 m_old 为基),当前块的注意力权重乘 V 得到 P_block,则:
正确性证明(为什么一遍遍历与两遍等价):
最终 m_N = max(x₁, …, x_N) = 标准方法的全局最大值。最终 l_N 按递推展开:
这正是标准 softmax 的分母。因此 softmax_i = e^(x_i - m_N) / l_N 与标准方法完全一致。关键在于每次合并时都正确地对旧的指数做了缩放修正(乘以 e^(m_old - m_new)),所以累加值始终以当前全局最大值为基,数值始终稳定。
直观理解:想象你在登山,记录沿途每座山的高度(x 值)。每遇到一座新山,你可能发现它比你之前以为的最高峰还高——于是你的”参照系”(最大值 m)变了,之前记录的所有高度差(相对旧参照系的
e^(x_i - m_old))需要换算到新参照系(乘以e^(m_old - m_new))。这就像换了一把尺子,旧读数需要等比缩放。只要每次换尺子时都做正确的换算,最终结果就和”先找到最高峰再一次性算”完全一样。
Recomputation(重计算)
Section titled “Recomputation(重计算)”反向传播需要前向时的注意力分数矩阵 S 来计算梯度。但 Flash Attention 为了省内存,根本没把那个巨大的 N×N 矩阵存下来。怎么办?
答案是重计算:反向传播时,重新把 Q、K、V 的分块加载到 SRAM,把前向的分块计算再做一遍,当场算出需要的中间值用于梯度计算。这看似多花了一倍计算量(FLOP 增加),但省下了存储和读写 N×N 矩阵的巨量 HBM 带宽。在现代 GPU 上,这个权衡非常划算——总体反而更快。这也是 Flash Attention 能把激活内存也降到 O(N) 的原因(标准注意力激活内存是 O(N²),因为要存 S)。
反向传播梯度推导
Section titled “反向传播梯度推导”为了理解为什么重计算是可行的,以及反向传播到底需要哪些中间量,我们来推导注意力的梯度。
设前向计算为(简化记号,省略 1/√d 缩放):
反向传播时,给定上游梯度 dO(损失对 O 的偏导),我们需要求 dQ、dK、dV。分三步链式求导:
第一步:dP 和 dV
对 P 求梯度时注意 softmax 的雅可比矩阵特性(softmax 输出之间有耦合):
其中 dO_ij_ref 表示把 dO 的第 j 列(对应 V 的第 j 维)与 P 的对应行做运算。更紧凑地写成矩阵形式:
其中 dP = dO · V^T(P 对 O 的贡献是 O = P·V,所以 dP = dO · V^T)。
第二步:dS 到 dQ、dK
关键观察:反向传播需要 S(或 P)、V、K、Q 这些中间量。标准实现把 P(即 softmax(S),N×N)存到 HBM 供反向使用。Flash Attention 不存 P,而是在反向时重新从 HBM 读取 Q、K、V 分块,在 SRAM 内重算 S 和 P,然后直接在片上完成上面的梯度计算。
由于 Q、K、V 本身就是模型参数/激活(无论如何都要存),重计算不需要额外存储任何 N×N 矩阵。多出的 FLOP 仅为一遍前向的分块矩阵乘(O(N²d)),而这部分计算在现代 GPU 的 Tensor Core 上非常快——远比读写 N×N 矩阵划算。
类比:想象你做一道复杂的数学题(前向),中间有张大草稿纸(N×N 矩阵)。标准做法是把草稿纸存起来,检查(反向)时翻出来用。Flash Attention 的做法是扔掉草稿纸,检查时拿原始题面(Q、K、V)重新演算一遍——费点脑力(算力),但不用维护一个巨大的文件柜(HBM 存储)。
Flash Attention v1(2022)
Section titled “Flash Attention v1(2022)”Tri Dao 与 Ashish Vaswani 等人在 2022 年提出(论文「FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness」)。首次把 tiling + online softmax + recomputation 三者整合成一个 IO 感知的精确注意力内核。关键特性:
- 精确:数学结果与标准注意力完全一致,不是近似(区别于 Linformer/Performer 等近似注意力)。
- 在 GPT-2 训练上比 PyTorch 标准实现快约 3 倍,长序列(如序列长度 4096)加速更明显。
- 省内存:激活内存从 O(N²) 降到 O(N),使训练超长序列成为可能。
Flash Attention v2(2023)
Section titled “Flash Attention v2(2023)”2023 年 Tri Dao 推出 v2(论文「FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning」)。主要改进:
- 更好的并行度:v1 主要沿批大小和注意力头数并行,当序列很长但头数不够多时 GPU 利用率低。v2 增加了沿序列维度的并行(把 Q 的分块分给不同线程块),长序列下 GPU 利用率显著提升。
- 减少非矩阵乘法运算:重写了 softmax 等辅助计算的分配方式,让计算尽量落在高效的矩阵乘(GEMM)上。
- 整体比 v1 再快约 2 倍,训练和推理都受益。
Flash Attention v3(2024)
Section titled “Flash Attention v3(2024)”2024 年 Tri Dao 与 NVIDIA 合作推出 v3(论文「FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-Precision」),专门针对 H100 GPU 优化:
- 异步数据搬运(async copy):利用 H100 的 TMA(Tensor Memory Accelerator,H100 GPU 上的专用异步数据搬运单元,可以在后台把张量从 HBM 搬到 SRAM 而不占用计算资源)和 warp-specialized(专用线程组)异步流水线,让数据从 HBM 到 SRAM 的搬运与计算重叠,进一步掩盖 IO 延迟。
- FP8 低精度:支持 FP8(8 位浮点)计算,配合 H100 的 FP8 Tensor Core,吞吐再翻倍。
- 在 H100 上 FP16 达到约 75% 的峰值算力利用率,FP8 下接近 1.2 PFLOPS——逼近硬件极限。
与标准注意力的对比
Section titled “与标准注意力的对比”| 维度 | 标准注意力 | Flash Attention |
|---|---|---|
| 计算量(FLOP) | O(N² * d) | 几乎相同(略多,因重计算) |
| HBM 读写量 | O(N² + N*d) | O(N² * d / M),约线性级 |
| 激活内存 | O(N²)(存 N×N 分数矩阵) | O(N)(不存完整分数矩阵) |
| 结果 | 精确 | 精确(数学等价) |
| 瓶颈类型 | IO 密集(等内存) | 计算密集(充分利用算力) |
| 长序列扩展性 | 内存爆炸 | 线性内存,可扩到十万级 token |
简言之:标准注意力”算得快但搬得慢”,Flash Attention”搬得少所以总体快”。两者最终数值结果完全一致。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
seq_lens = np.array([512, 1024, 2048, 4096, 8192, 16384, 32768])d = 64  # head dimension
# Standard: O(N^2) score matrix stored in HBMstd_mem = (seq_lens**2 + seq_lens * d * 4) * 2 / (1024**2)  # FP16# Flash: O(N) — no score matrixflash_mem = (seq_lens * d * 5) * 2 / (1024**2)
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(13, 5))fig.patch.set_facecolor("white")
width = 0.35; x = np.arange(len(seq_lens))ax1.bar(x - width/2, std_mem, width, label="Standard Attention", color="#e91e63", edgecolor="white")ax1.bar(x + width/2, flash_mem, width, label="Flash Attention", color="#2196F3", edgecolor="white")ax1.set_xticks(x)ax1.set_xticklabels([f"{s//1000}K" if s >= 1000 else str(s) for s in seq_lens])ax1.set_xlabel("Sequence Length (tokens)", fontweight="bold")ax1.set_ylabel("Activation Memory (MB, per head, FP16)", fontweight="bold")ax1.set_title("Memory: O(N^2) vs O(N)", fontweight="bold")ax1.legend(); ax1.grid(axis="y", alpha=0.2, linestyle="--")
ratio = std_mem / np.maximum(flash_mem, 0.001)ax2.plot(seq_lens, ratio, "o-", color="#4CAF50", linewidth=2.5, markersize=8)ax2.fill_between(seq_lens, ratio, alpha=0.08, color="#4CAF50")for s, r in zip(seq_lens, ratio):    ax2.annotate(f"{r:.0f}x", xy=(s, r), xytext=(0, 12), textcoords="offset points",                 ha="center", fontsize=9, fontweight="bold", color="#4CAF50")ax2.set_xlabel("Sequence Length (tokens)", fontweight="bold")ax2.set_ylabel("Memory Reduction Factor (x)", fontweight="bold")ax2.set_title("Flash Attention Memory Savings", fontweight="bold")ax2.set_xscale("log", base=2); ax2.grid(True, alpha=0.2, linestyle="--", which="both")
plt.tight_layout()plt.savefig("/mnt/kvm_ata-Netac_SSD_480GB_AA000000000000000904-part1/proj/docs/img/generated/flash-attention-memory.png",            dpi=180, bbox_inches="tight", facecolor="white")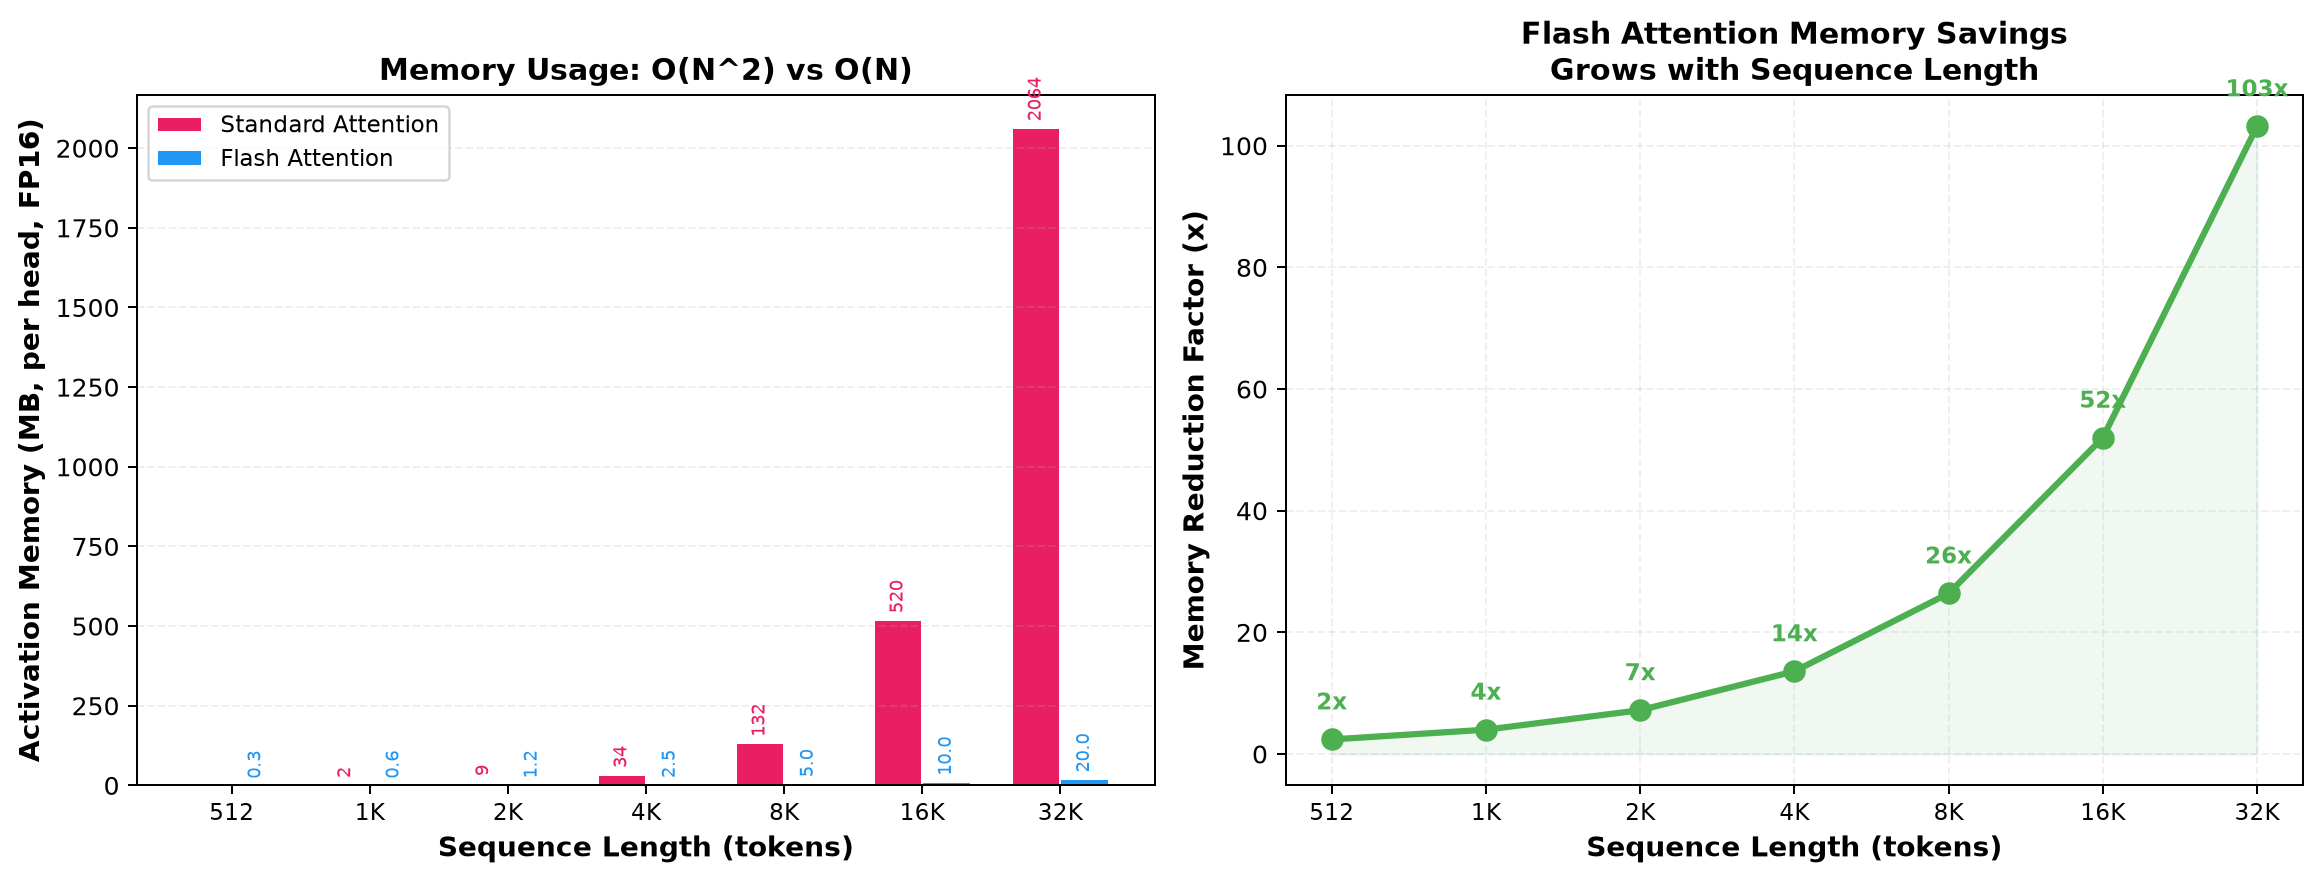
最新进展(2024–2025)
Section titled “最新进展(2024–2025)”Flash Attention 的核心思想——IO 感知的分块注意力——已经成为一个技术家族,衍生出许多新方向。以下是 2024–2025 年最重要的进展。
FlexAttention:灵活注意力 API
Section titled “FlexAttention:灵活注意力 API”FlexAttention 是 PyTorch 2.5+(2024 年底)引入的灵活注意力 API。它的动机是:Flash Attention 虽然快,但它是一个”黑盒”kernel,你只能用它预定义的几种模式(标准、因果掩码等)。如果你需要自定义注意力模式(比如文档级掩码、滑动窗口 + 全局 token 混合、交错注意力等),就只能退回到慢速的标准实现。
FlexAttention 让用户用几行代码定义一个 score_mod 函数来修改注意力分数(比如”在某些位置加上一个偏置或掩码”),PyTorch 编译器会自动把这个自定义逻辑编译成接近 Flash Attention 性能的 kernel。它本质上把 Flash Attention 的 tiling + online softmax 基础设施”开放”给了用户自定义。
# FlexAttention 示例:自定义滑动窗口注意力from torch.nn.attention.flex_attention import flex_attention, create_block_mask
def sliding_window(b, h, q_idx, kv_idx):    return torch.where(torch.abs(q_idx - kv_idx) <= 1024, 0.0, float("-inf"))
block_mask = create_block_mask(sliding_window, B, H, Q_LEN, KV_LEN)out = flex_attention(q, k, v, block_mask=block_mask)# 编译后性能接近原生 Flash Attention
适用场景:需要非标准注意力模式的研究(如长文档、多模态、稀疏模式),同时不想牺牲 Flash 级性能。
Ring Attention / Strip Attention:跨 GPU 分块
Section titled “Ring Attention / Strip Attention:跨 GPU 分块”标准 Flash Attention 把序列分块放在单卡的 SRAM 中处理。但当序列极长(百万级 token)时,单卡放不下完整的 K、V——需要跨多张 GPU 分布。
Ring Attention(UC Berkeley, 2023–2024)的做法是:把 Q、K、V 分布在多张 GPU 上,GPU 之间组成一个环形(ring)。每张 GPU 持有一段 K、V,计算自己那段 Q 与所有 K、V 块的注意力。K、V 块在环上以流水线方式逐卡传递(类似环形 all-reduce),每张 GPU 收到一块 K、V 就在本地算完一块,与 Flash Attention 的分块逻辑无缝结合。
Strip Attention 是类似思路的变体,把序列条带化分布在多设备上,进一步优化通信模式。
效果:可以将上下文窗口扩展到百万级 token(如 1M–7M),远超单卡极限。这也是 LLM 长上下文训练的关键基础设施之一。
FlashInfer 与推理场景优化
Section titled “FlashInfer 与推理场景优化”FlashInfer 是一个专门面向 LLM 推理场景的 kernel 库(由 UC Berkeley 等开发)。训练时所有序列长度一致、批量规整;但推理时(尤其是服务端)情况复杂得多:
- Prefill 阶段:长 prompt 一次性处理(计算密集)
- Decode 阶段:每次只生成一个 token,但 KV 缓存(KV cache,即历史 token 的 K、V 张量)不断增长
- 批量变长:同一批请求的序列长度差异很大,且有 padding 浪费
FlashInfer 针对这些推理特有场景做了深度优化:KV 缓存感知的注意力 kernel(避免缓存碎片化)、变长 batch 的高效打包、prefill/decode 混合调度等。vLLM、SGLang 等推理引擎已集成 FlashInfer。更多推理优化技术见推理优化。
Native Sparse Attention(NSA)
Section titled “Native Sparse Attention(NSA)”Native Sparse Attention 是 DeepSeek 在 2025 年提出的稀疏注意力方案。动机:即使有 Flash Attention,百万级 token 的注意力计算量仍然是 O(N²),训练成本极高。NSA 通过一个可学习的稀疏选择机制,让模型在训练中自动学会”哪些 token 值得关注”,只计算最重要的部分注意力,从而把有效复杂度降到近 O(N·log N) 级别。
NSA 的创新在于”native”——稀疏选择机制是端到端可训练的(不像传统稀疏注意力需要手工定义稀疏模式),且与 Flash Attention 的分块基础设施兼容。在长文本基准测试上,NSA 在大幅降低计算量的同时保持了接近全注意力的性能。
H100 / B100 / B200 上的持续优化
Section titled “H100 / B100 / B200 上的持续优化”Flash Attention 的实现持续跟进最新硬件:
- H100(Hopper 架构):Flash Attention v3 利用 TMA 异步搬运 + WGMMA(Warp Group Matrix Multiply-Accumulate,Hopper 的异步矩阵乘指令)+ FP8,把注意力推向硬件峰值。
- B100 / B200(Blackwell 架构,2024–2025):新一代 GPU 引入了更快的 Tensor Core、第二代 TMA、以及第二代 Transformer Engine。Flash Attention 正在适配 Blackwell 的新特性,包括更高效的 FP4(4 位浮点)注意力和改进的异步流水线深度。Tri Dao 团队和 NVIDIA 持续合作推动 kernel 在新硬件上的极限性能。
总体趋势:Flash Attention 已从”一个巧妙的算法”演变为”一个与硬件协同设计的持续工程”——每个新一代 GPU 都会催生新的注意力 kernel 优化。
Flash Attention 分块处理流程
Section titled “Flash Attention 分块处理流程”下图展示数据在 HBM 与 SRAM 之间的流动。注意那个巨大的 N×N 分数矩阵从不落盘到 HBM。
标准 vs Flash Attention 对比
Section titled “标准 vs Flash Attention 对比”以下展示在 PyTorch 中调用 Flash Attention,并与标准 scaled_dot_product_attention 对比。需要安装 flash-attn(pip install flash-attn)。
import torch# PyTorch 2.0+ 内置 SDPA,底层会自动调度 Flash Attentionfrom torch.nn.functional import scaled_dot_product_attention as sdpa
B, H, N, D = 2, 8, 4096, 64          # 批大小、头数、序列长度、每头维度q = k = v = torch.randn(B, H, N, D, device="cuda", dtype=torch.float16)
# 标准注意力(显式实现,仅作对照,不推荐实际使用)attn = q.transpose(2, 3) @ k          # (B,H,N,N) 巨大中间矩阵attn = attn.softmax(dim=-1)           # 两遍遍历 softmaxout_std = attn @ v                    # 中间矩阵全程在 HBM 读写
# Flash Attention(推荐):SDPA 会自动选择 FlashAttention 后端out_flash = sdpa(q, k, v, is_causal=False)   # 数学结果与上面一致print(torch.allclose(out_std, out_flash, atol=1e-3))  # 约 True
从头实现 Online Softmax(NumPy)
Section titled “从头实现 Online Softmax(NumPy)”以下用 NumPy 从零实现 online softmax,帮助你理解分块流式计算的核心逻辑。这个例子把一个长向量的 softmax 分成多块逐步处理,最终结果与标准 softmax 完全一致。
import numpy as np
def standard_softmax(x):    """标准 softmax:两遍遍历(先找 max,再归一化)"""    m = np.max(x)    exp_x = np.exp(x - m)        # 减去 max 保证数值稳定    return exp_x / np.sum(exp_x)
def online_softmax_single_block(m_old, l_old, o_old, x_block, v_block):    """    用 online softmax 处理一个新块。    参数:        m_old: float, 之前所有块的 (标量) 最大值        l_old: float, 之前所有块的归一化指数和        o_old: (d,) 之前所有块累加的输出(尚未除以 l_old 的形式)        x_block: (B,) 当前块的分数        v_block: (B, d) 当前块的 V    返回:        m_new, l_new, o_new    """    # 当前块的局部最大值和局部指数和    m_block = np.max(x_block)    exp_block = np.exp(x_block - m_block)    l_block = np.sum(exp_block)
    # 更新全局最大值    m_new = max(m_old, m_block)
    # 修正旧统计量:换到新基线 m_new    #   旧的 e^{x - m_old} 要变成 e^{x - m_new},差一个 e^{m_old - m_new}    correction_old = np.exp(m_old - m_new)    correction_new = np.exp(m_block - m_new)
    # 合并指数和    l_new = correction_old * l_old + correction_new * l_block
    # 合并输出:旧的 o 要乘 correction_old,新的贡献 = exp_block^corrected @ v_block    p_block = exp_block * correction_new       # (B,) 当前块修正后的权重    o_new = correction_old * l_old * o_old + p_block @ v_block    # 注意:o_new 是"未归一化"的累加结果,最终输出要除以 l_new
    return m_new, l_new, o_new
# ---- 验证:分块 online softmax == 标准 softmax ----np.random.seed(42)N, d = 1024, 64                        # 序列长度 1024,每个 token 64 维B = 128                                # 每块 128 个 tokenx = np.random.randn(N).astype(np.float32) * 5    # 模拟注意力分数v = np.random.randn(N, d).astype(np.float32)
# 标准做法(一次性)m_full = np.max(x)exp_full = np.exp(x - m_full)l_full = np.sum(exp_full)o_standard = (exp_full / l_full) @ v   # (d,)
# Online softmax(分块)m_running = -np.infl_running = 0.0o_running = np.zeros(d, dtype=np.float32)
for start in range(0, N, B):    end = start + B    x_block = x[start:end]    v_block = v[start:end]    m_running, l_running, o_running = online_softmax_single_block(        m_running, l_running, o_running, x_block, v_block    )
o_online = o_running / l_running       # 最终归一化
print("最大误差:", np.max(np.abs(o_standard - o_online)))  # ~1e-6,数值一致
基准测试:标准注意力 vs Flash Attention
Section titled “基准测试:标准注意力 vs Flash Attention”以下脚本对比标准注意力和 Flash Attention 在不同序列长度下的速度和内存。
"""基准测试:标准注意力 vs Flash Attention需要:PyTorch 2.0+ 和 CUDA GPU"""import torchimport time
def standard_attention(q, k, v):    """标准注意力:显式构造 N×N 矩阵"""    scale = q.shape[-1] ** -0.5    attn = torch.matmul(q, k.transpose(-2, -1)) * scale  # (B, H, N, N)    attn = attn.softmax(dim=-1)    return torch.matmul(attn, v)
def benchmark(fn, q, k, v, warmup=3, repeats=10):    """计时函数,返回平均时间(毫秒)"""    for _ in range(warmup):        out = fn(q, k, v)    torch.cuda.synchronize()    start = time.time()    for _ in range(repeats):        out = fn(q, k, v)    torch.cuda.synchronize()    return (time.time() - start) / repeats * 1000  # 转毫秒
B, H, D = 1, 8, 64for N in [1024, 4096, 8192, 16384]:    q = torch.randn(B, H, N, D, device="cuda", dtype=torch.float16)    k = v = q
    # 峰值显存    torch.cuda.reset_peak_memory_stats()    out_std = standard_attention(q, k, v)    mem_std = torch.cuda.max_memory_allocated() / 1024**2  # MB
    torch.cuda.reset_peak_memory_stats()    out_flash = torch.nn.functional.scaled_dot_product_attention(q, k, v)    mem_flash = torch.cuda.max_memory_allocated() / 1024**2
    t_std = benchmark(standard_attention, q, k, v)    t_flash = benchmark(        torch.nn.functional.scaled_dot_product_attention, q, k, v    )
    print(f"N={N:6d} | 标准: {t_std:8.1f}ms  {mem_std:6.0f}MB | "          f"Flash: {t_flash:8.1f}ms  {mem_flash:6.0f}MB | "          f"加速: {t_std/t_flash:.1f}x  省显存: {mem_std/mem_flash:.1f}x")    # 预期:N 越大,Flash 的速度和内存优势越明显
变长序列(varlen)示例
Section titled “变长序列(varlen)示例”推理服务中,一个 batch 内的请求序列长度各不相同。如果用 padding 对齐到最长序列,短序列会浪费大量计算。flash-attn 库提供了 flash_attn_varlen_func,可以把多个变长序列紧凑打包(pack)成一个一维序列,配合 cu_seqlens 累积偏移量来界定每条序列的边界。
"""变长序列 Flash Attention 示例需要:pip install flash-attn"""import torchfrom flash_attn import flash_attn_varlen_func
# 模拟一个 batch 中 3 条长度不同的序列seq_lens = [128, 512, 64]total_len = sum(seq_lens)  # 704,紧凑打包,无 padding
# 累积偏移量(cumulative sequence lengths),标记每条序列的起止位置# 格式:[0, len1, len1+len2, len1+len2+len3],首尾各一个 0cu_seqlens_q = torch.tensor([0, 128, 640, 704], dtype=torch.int32, device="cuda")cu_seqlens_k = cu_seqlens_q.clone()  # Q 和 K 长度相同
max_seqlen_q = max(seq_lens)  # 512max_seqlen_k = max(seq_lens)
num_heads = 8head_dim = 64
# 布局:(total_len, num_heads, head_dim) —— 注意是 3D,没有 batch 维q = torch.randn(total_len, num_heads, head_dim, device="cuda", dtype=torch.float16)k = v = q
# varlen 版本:自动按 cu_seqlens 切分,各序列独立计算注意力,互不 attendout = flash_attn_varlen_func(    q, k, v,    cu_seqlens_q=cu_seqlens_q,    cu_seqlens_k=cu_seqlens_k,    max_seqlen_q=max_seqlen_q,    max_seqlen_k=max_seqlen_k,    causal=True,  # 每条序列内部做因果掩码)# out.shape == (704, 8, 64),与输入一一对应
# 对比:如果用 padding 对齐到 512,要算 3×512=1536 个位置# 用 varlen 只算 704 个位置,节省约 54% 的计算量- 优先用 PyTorch 内置的 SDPA:
torch.nn.functional.scaled_dot_product_attention从 PyTorch 2.0 起会根据输入形状、精度、硬件自动选择 Flash Attention v2/v3 后端,无需手动安装flash-attn,一行代码即可享受加速。 - 需要 FP8 或 H100 极限性能时再用
flash-attn库:Tri Dao 的独立flash-attn包提供 v3 的 FP8、异步流水线等最前沿特性,适合追求极致吞吐的推理服务。安装较重(需编译),按需引入。 - 注意因果掩码(causal mask):自回归解码时要传
is_causal=True,Flash Attention 内部会用分块上三角跳过来实现因果掩码,比外挂掩码矩阵更省内存也更省算。 - 配合长上下文模型:Flash Attention 把激活内存降到线性级,是训练和推理十万级 token 上下文的前提。长上下文场景务必确认所用框架确实启用了 Flash Attention,否则会因 OOM 失败。更多上下文工程技巧见上下文工程。
- 注意输入张量布局:
flash-attn库要求(B, S, H, D)布局且头数在前或后需对应不同函数(flash_attn_func/flash_attn_varlen_func),变长序列用 varlen 版本打包,避免 padding 浪费算力。 - 与混合精度和分布式配合:Flash Attention 原生支持 FP16/BF16,与混合精度训练、分布式训练无缝组合,是大模型训练栈的标准组件。
- 所有主流 LLM 的训练与推理:GPT-4、LLaMA、Qwen、Claude、Gemini 等几乎所有大模型的预训练、微调和推理服务都默认使用 Flash Attention——它已经是 Transformer 注意力的事实标准实现。
- 长文本处理:十万级 token 上下文(如 128K 上下文窗口)的训练与推理,依赖 Flash Attention 的线性内存才不至于 OOM。
- 多模态大模型:图像/视频 token 序列极长(一张高分辨率图可能上千 token),Flash Attention 让多模态注意力的开销可控。详见多模态大模型。
- 扩散模型中的注意力:Stable Diffusion 等在空间注意力层同样受益于 Flash Attention,降低高分辨率生成的显存占用。
- 推理加速服务:vLLM、TensorRT-LLM、SGLang 等推理引擎都内置 Flash Attention 作为核心注意力 kernel。详见推理优化。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| flash-attn | Python | Tri Dao 官方 Flash Attention 库,提供 v1/v2/v3,支持 FP8 与变长序列 |
| torch SDPA | Python | PyTorch 2.0+ 内置 scaled_dot_product_attention,自动调度 Flash Attention 后端 |
| xformers | Python | Meta 的高效 Transformer 算子库,提供 memory_efficient_attention(Flash 风格) |
| Triton | Python | OpenAI 的 GPU kernel DSL,Flash Attention v2 的参考实现即用 Triton 编写 |
| FlashInfer | Python | 面向大模型推理的 kernel 库,集成 Flash Attention 并针对 KV 缓存场景优化 |
| TransformerEngine | Python | NVIDIA 的 Transformer 训练库,内置 Flash Attention v3 的 FP8 支持 |
| 术语 | 英文 | 解释 |
|---|---|---|
| IO 感知 | IO-aware | 算法设计时显式考虑内存读写开销,而不仅是计算量 |
| 高带宽内存 | HBM (High Bandwidth Memory) | GPU 主显存,容量大但带宽相对计算单元有限,是 IO 瓶颈所在 |
| 片上高速缓存 | SRAM | GPU 流多处理器(SM)内部的片上缓存,带宽极高但容量小 |
| 分块 | Tiling | 把大矩阵切成小块逐块处理,使每块能装进 SRAM 在片上算完 |
| 在线 softmax | Online Softmax | 流式计算 softmax 的技巧,一遍遍历即可完成,支持分块累加 |
| 重计算 | Recomputation | 反向传播时不存中间激活,而是重新前向计算,用算力换内存带宽 |
| 精确注意力 | Exact Attention | 结果与标准注意力数学完全一致,区别于 Linformer/Performer 等近似方法 |
| 异步数据搬运 | Async Copy / TMA | 利用硬件单元在后台搬运数据,与计算重叠,掩盖 IO 延迟 |
| 因果掩码 | Causal Mask | 自回归模型中屏蔽未来 token 的注意力掩码,Flash Attention 内部以分块跳过实现 |
| 线性内存 | Linear Memory | 内存占用随序列长度线性增长而非二次方增长 |
- Dao, Fu, Ermon, Rudra & Ré,「FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness」(NeurIPS 2022):Flash Attention v1 原始论文,首次提出 tiling + online softmax + recomputation 三件套,奠定精确 IO 感知注意力的范式。
- Dao,「FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning」(2023):v2 论文,改进沿序列维度的并行度和非矩阵乘运算分配,比 v1 再快约 2 倍。
- Shah, Bikshandi, Zhang & Dao,「FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-Precision」(2024):v3 论文,针对 H100 用异步搬运和 FP8 把注意力推向硬件峰值,理解前沿 GPU 优化的必读。
- Ivanov et al.,「Data Movement is All You Need: A Case Study on Optimizing Attention」(2021):从 IO 角度系统分析注意力瓶颈的论文,Flash Attention 的思想源头之一,帮助理解”为什么减少 IO 比减少计算更重要”。
- PyTorch Team,「FlexAttention: The Flexibility of PyTorch with the Performance of FlashAttention」(2024):PyTorch 2.5+ 引入 FlexAttention API 的官方博客与技术说明,展示如何用
score_mod自定义注意力模式同时保持 Flash 级性能,适合需要非标准注意力模式的研究者。 - Liu et al.,「Ring Attention with Block Sequence Parallelism for Near-Infinite Context」(ICLR 2024):Ring Attention 论文,把 Flash Attention 的分块逻辑扩展到多 GPU 环形通信,实现百万级 token 上下文训练,是长序列分布式训练的重要基础。
- Ye et al.,「FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving」(2024):FlashInfer 论文,聚焦 LLM 推理场景的注意力 kernel 优化(KV 缓存感知、变长 batch、prefill/decode 混合调度),是推理引擎高性能注意力的关键参考。
- DeepSeek-AI,「Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention」(2025):Native Sparse Attention(NSA)论文,提出端到端可训练的稀疏注意力机制,将有效复杂度降至近 O(N·log N),在大幅降低长文本计算量的同时保持接近全注意力的性能。
- Milakov et al.,「Recurrence is Not All You Need: Content-Strip Attention」(2024):Strip Attention 论文,把序列条带化分布在多设备上以突破单卡序列长度限制,与 Ring Attention 互为补充的分布式长序列注意力方案。
- NVIDIA,「Transformer Engine」(持续更新, 2024–2025):NVIDIA 的 Transformer Engine 库文档与更新日志,记录了 Flash Attention 在 Hopper(H100)和 Blackwell(B100/B200)架构上的持续优化,包括 FP8/FP4 支持和异步流水线改进,适合追踪硬件协同设计的最新进展。