
LLM 推理优化
本页介绍大语言模型(LLM)部署的关键环节——推理优化:如何让数十亿参数的模型在实际服务中跑得更快、更省、更稳。它不属于模型训练本身,而是生成式 AI 落地的”最后一公里”,与扩散模型、LLM 演进等训练侧话题互补。
📌 深入阅读:本页面向初学者,侧重直觉理解与工程全景。如果你已经熟悉基础概念,想了解 Flash Attention 的分块计算原理、PagedAttention 的块表实现细节、以及量化算法的数学推导,请跳转到 LLM 推理优化技术全景。
把 LLM 推理想象成一支物流车队:
- 裸模型推理 = 一辆超级跑车送货:跑得快,但一次只能拉一单,99% 的马力闲置——GPU 利用率极低。
- 量化(Quantization)= 把货物压缩打包:FP16 的货物用 INT4 箱子装,体积缩到 1/4,油耗(显存)大幅下降,轻微损失精度。
- KV-Cache = 快递员记住已经走过的路:生成每个新 token 时,不用重算之前所有 token 的中间结果,直接查缓存——这就是自回归生成能”快”的根本。
- 批处理(Batching)= 拼车:把多个用户的请求凑成一车一起送,吞吐量成倍提升。难点在于请求长度不一、随时有新请求加入。
- 投机解码(Speculative Decoding)= 副驾驶先猜路线:用一个小模型快速”猜”几个 token,大模型一次性验证,对的直接用——以小博大,成段加速。
推理优化的本质就是:用各种工程手段,把那辆孤零零的跑车,变成一支高效协同、满载运行的车队。
为什么推理这么难
Section titled “为什么推理这么难”训练一个 LLM 已经很贵了,但训练只发生一次;推理却要在模型上线后每天执行数十亿次,累积成本远超训练。推理优化之所以是一门独立的工程学科,根源在于三个结构性矛盾。
LLM 生成文本的方式是**自回归(autoregressive)**的:每次只生成一个 token,生成第 N 个 token 必须等第 N-1 个 token 确定后才能开始。这就像写字只能一个字一个字地写,而不是一整句话同时写出来。
这意味着生成 1000 个 token 需要串行执行 1000 次模型前向传播(forward pass)。GPU 天生擅长并行计算,但自回归把这个过程变成了串行——GPU 的并行算力大量浪费。
更隐蔽也更致命的问题是内存墙(memory wall):GPU 的计算速度增长远快于显存带宽(memory bandwidth)。
- 一张 A100 GPU 的算力约 312 TFLOPS(FP16),即每秒可做 312 万亿次浮点运算。
- 但它的显存带宽只有 2 TB/s,即每秒只能从显存读取 2 万亿字节。
这意味着:只要每次计算需要从显存搬运的数据足够多,瓶颈就不是”算得不够快”,而是”数据搬得不够快”。
计算受限 vs 访存受限
Section titled “计算受限 vs 访存受限”理解推理性能的关键概念是算术强度(arithmetic intensity):每读取 1 字节数据,能做多少次浮点运算。单位是 FLOPS/Byte。
- 当算术强度高(大量计算 / 少量数据搬运),瓶颈是算力——这叫计算受限(compute-bound)。
- 当算术强度低(少量计算 / 大量数据搬运),瓶颈是带宽——这叫访存受限(memory-bound)。
| 阶段 | 数据搬运 | 计算 | 算术强度 | 瓶颈类型 |
|---|---|---|---|---|
| 训练(大 batch) | 中等 | 极高 | 高 | 计算受限 |
| 推理 Prefill | 中等 | 高 | 中等~高 | 偏计算受限 |
| 推理 Decode(batch=1) | 极高 | 极低 | 极低 | 访存受限 |
推理的 Decode 阶段是元凶:每生成一个 token,都要把整个模型的权重(几十 GB)和所有历史 token 的 KV Cache 从显存搬进计算单元,却只做一次矩阵乘法。算术强度极低,GPU 算力闲置率可达 90% 以上。
💡 一句话总结:推理的主要敌人不是”算力不够”,而是”数据搬运不够快”。绝大多数推理优化都在解决这一个问题。
推理的两个阶段:Prefill 与 Decode
Section titled “推理的两个阶段:Prefill 与 Decode”一次完整的 LLM 推理请求分为两个阶段,它们的性能特征截然不同:
Prefill(预填充)阶段
Section titled “Prefill(预填充)阶段”用户输入一段 prompt(比如 500 个 token),模型需要一次性并行处理所有输入 token,计算出它们的 KV Cache。这是一次性的大批量矩阵乘法——GPU 的强项,算力利用率很高。
- 特点:计算密集型(compute-bound),GPU 算力接近跑满。
- 时间:与 prompt 长度成正比,通常几十毫秒到几秒。
- 用户感知:这就是 TTFT(Time To First Token,首词元延迟)的主要来源——“发送消息后多久才看到第一个字”。
Decode(解码)阶段
Section titled “Decode(解码)阶段”Prompt 处理完后,模型开始逐个生成输出 token。每一步只处理一个新 token,但需要读取之前所有 token 的 KV Cache 来做注意力计算。
- 特点:访存密集型(memory-bound),GPU 算力大量闲置。
- 时间:与输出长度成正比,每个 token 几毫秒到几十毫秒。
- 用户感知:这就是生成速度(tokens/second)——“字一个一个蹦出来的快慢”。
💡 为什么 Decode 是访存瓶颈?生成一个 token 需要读取全部模型权重(7B 模型 FP16 约 14GB)来做前向传播,但只产生一个 token 的输出(几个字节)。算术强度 ≈ 1 FLOP/Byte,远低于 GPU 的平衡点。
绝大多数推理优化——KV Cache 管理、连续批处理、量化、投机解码——本质上都在解决 Decode 阶段的访存瓶颈。理解这一点,后面的技术就串起来了。
KV Cache 深入
Section titled “KV Cache 深入”KV Cache 是 LLM 推理最重要的数据结构,理解它的体积和行为是理解推理优化的前提。
Transformer 的注意力机制中,每个 token 需要和之前所有 token 计算注意力分数。这需要用到每个历史 token 的 Key 和 Value 向量。KV Cache 就是把每一步算出的 K、V 存下来,下一步直接复用,避免重算。
没有 KV Cache,生成第 1000 个 token 时要重算前 999 个 token 的注意力,计算量随序列长度二次增长()。有了 KV Cache,每步只需处理新 token,降为线性()。
体积到底有多大——真实计算
Section titled “体积到底有多大——真实计算”KV Cache 的体积公式:
其中 是因为 Key 和 Value 各一份。
以 Llama-2-7B 为例(FP16 精度,):
| 参数 | 值 |
|---|---|
| 层数(layers) | 32 |
| KV 头数(kv_heads) | 32(标准 MHA) |
| 每头维度(head_dim) | 128 |
| 每元素字节数(FP16) | 2 |
单个 token 的 KV Cache:
不同序列长度下的 KV Cache 总量():
| 序列长度 | KV Cache 大小 | 对比模型权重(14GB) |
|---|---|---|
| 512 tokens | 256 MB | 1.8% |
| 4K tokens | 2 GB | 14% |
| 32K tokens | 16 GB | 114% ← 超过权重! |
| 128K tokens | 64 GB | 457% |
可以看到一个惊人的事实:当上下文足够长时,KV Cache 的体积会超过模型权重本身,成为显存的主要消耗者。这也是为什么长上下文推理(如 128K、1M tokens)如此困难。
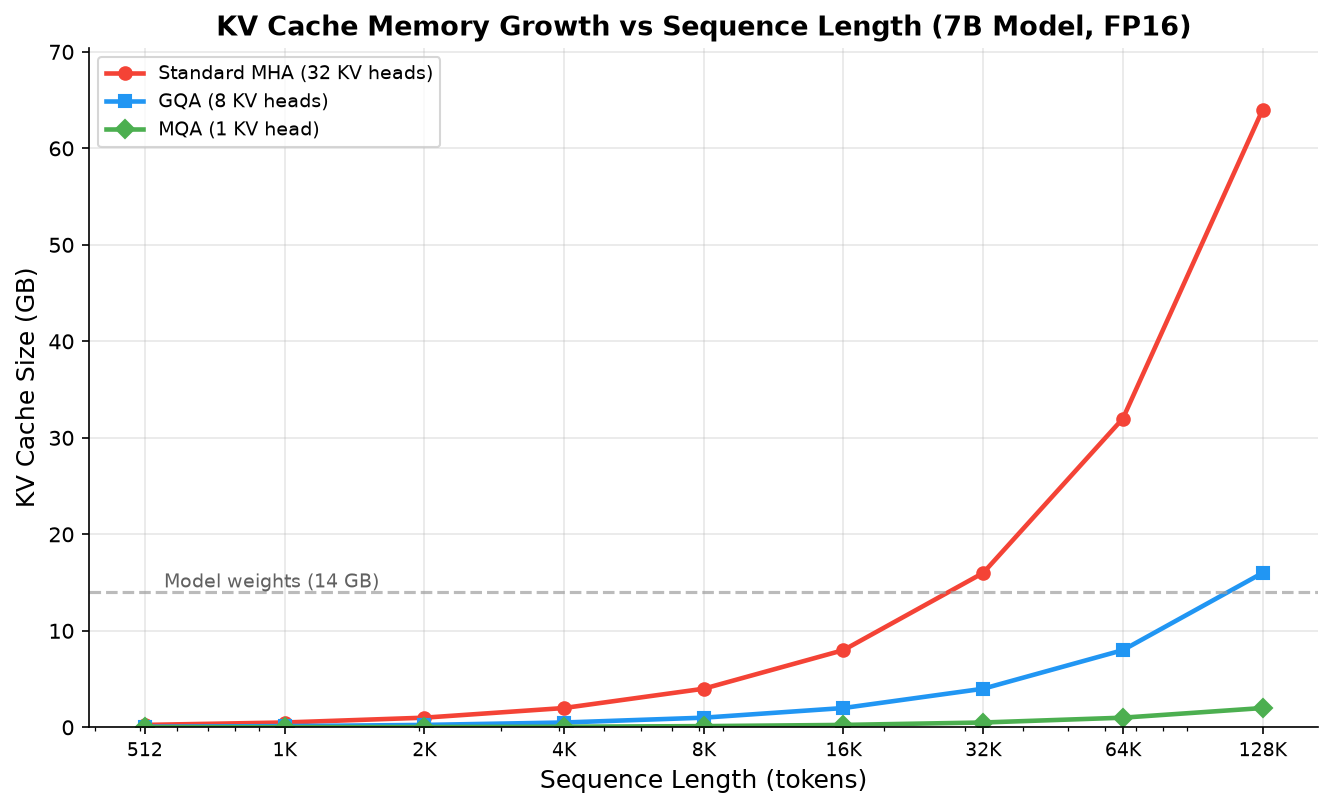
💡 GQA 的救场:Llama-2-70B 和大多数 2024-2025 年的新模型(如 Llama 系列、Qwen 系列)使用 GQA(Grouped-Query Attention) 或 MQA(Multi-Query Attention),让多个 Query 头共享同一组 KV 头,把 从 32 降到 8 甚至 1,KV Cache 直接缩小 4-32 倍。这是架构层面对 KV Cache 的根本优化。
PagedAttention:分页管理
Section titled “PagedAttention:分页管理”传统做法为每个请求预分配最大长度的连续显存(如预分配 2048 token 的空间),导致大量浪费和碎片——就像给每个快递员预订一辆最大号卡车,不管今天有几个包裹。vLLM 的 PagedAttention 借鉴操作系统的虚拟内存分页机制,把 KV Cache 切成固定大小的”页”(block),按需分配、共享与回收:
PagedAttention 让 vLLM 的有效吞吐比传统方案高 2-4 倍,是当代推理引擎的标配。其内部实现细节(块表映射、copy-on-write 共享等)见 推理优化技术全景。
量化(Quantization)是把模型权重和/或激活值从高精度浮点数(FP16/FP32)压缩到低精度整数(INT8/INT4)或低精度浮点(FP8)的技术。它是最直接有效的降本手段。
精度格式对比
Section titled “精度格式对比”| 格式 | 每元素字节 | 7B 模型权重大小 | 精度 | 典型场景 |
|---|---|---|---|---|
| FP32 | 4 bytes | 28 GB | 最高 | 训练(推理极少用) |
| FP16 / BF16 | 2 bytes | 14 GB | 高 | 标准推理 |
| FP8 | 1 byte | 7 GB | 高(NVIDIA H100 原生支持) | 2024+ 高端 GPU 推理 |
| INT8 | 1 byte | 7 GB | 中高 | 成熟量化,精度损失极小 |
| INT4 | 0.5 bytes | 3.5 GB | 中(掉 1-3 个评测点) | 边缘部署、成本优先 |
主流量化方案
Section titled “主流量化方案”2024-2025 年,训练后量化(Post-Training Quantization, PTQ)形成三大主流方案:
- GPTQ:基于二阶信息(Hessian 矩阵近似)逐层最小化量化误差的算法。把权重量化到 4-bit,精度损失小,适合服务端 GPU。需要 GPU 上跑量化校准过程。
- AWQ(Activation-aware Weight Quantization):核心洞察是——并非所有权重同等重要,激活幅度大的通道对应的权重更敏感。AWQ 给这些”重要通道”更高保护(per-channel scaling),在 4-bit 下保持出色精度。推理速度快、效果稳健,是 2024-2025 年服务端部署最流行的量化方案。
- GGUF(原 GGML):llama.cpp 生态的量化格式,支持多种位宽(如
Q4_K_M、Q5_K_M、Q8_0),并支持 CPU 与 GPU 混合推理——部分层放 GPU、其余放 CPU。它是边缘和消费级硬件部署的事实标准。详见 小模型与端侧部署。
精度-质量权衡
Section titled “精度-质量权衡”量化不是免费的:位宽越低,显存和带宽越省,但模型质量也会下降。以下是大致的实测规律(基于 Llama-2-7B 在 MMLU 等基准上的表现):
| 量化方案 | 相对 FP16 的质量保留 | 显存节省 | 推理加速 |
|---|---|---|---|
| INT8(GPTQ/AWQ) | ~99% | 50% | 1.5-2× |
| INT4(AWQ) | ~96-98% | 75% | 2-4× |
| INT4(GPTQ) | ~95-97% | 75% | 2-3× |
| FP8(NVIDIA) | ~99% | 50% | 1.5-2× |
💡 实用建议:多数应用 INT4(AWQ)的精度损失在可接受范围内,性价比最高。如果对精度敏感(如代码生成、数学推理),退到 INT8 或 FP8。如果还有余力,可以用 QLoRA 在量化模型上微调,补偿精度损失。
批处理(Batching)是把多个推理请求凑成一批同时计算的技术。因为 GPU 的并行计算能力远超单个请求所需,把多个请求的矩阵运算拼在一起,可以让 GPU 一次算完,吞吐量成倍提升。
静态批处理(Static Batching)
Section titled “静态批处理(Static Batching)”最简单的做法:攒够 N 个请求后一起提交,等全部生成完再返回。问题在于请求长度参差不齐——一个 10 token 的短回复和一个 500 token 的长回复在一批,短的要等长的完才能返回,GPU 大量时间在空转。
动态批处理(Dynamic Batching)
Section titled “动态批处理(Dynamic Batching)”允许新请求动态加入当前批次,在请求级别做调度。比静态好,但仍然以”请求”为粒度——一个请求的 500 个 token 必须串行执行完才能释放位置。
连续批处理(Continuous Batching)
Section titled “连续批处理(Continuous Batching)”当前最优方案(也叫 iteration-level batching):把调度粒度从”请求”细化到单个 token。每个 decode 步(生成一个 token)都重新组批——已完成的请求立即移出,空出的位置给新请求:
连续批处理配合 PagedAttention(按需分配 KV Cache),让 vLLM 等引擎的吞吐量接近理论峰值。这是 2023 年以来推理服务领域最重要的工程突破。
Decode 阶段每步只生成一个 token,大模型每次前向只处理一个 token,算力利用率极低。投机解码(Speculative Decoding)的思路是:用一个小而快的 draft 模型(草稿模型)先快速猜出 K 个候选 token,再让大模型对这 K 个候选做一次并行前向验证——大模型一次前向能同时处理 K 个 token,算力利用率大幅提高。
关键性质:投机解码是无损的——最终输出分布与大模型单独解码完全一致。验证阶段的数学设计保证了这一点:被拒绝的位置会按照大模型的概率分布重新采样。
接受率与加速比
Section titled “接受率与加速比”- 接受率(acceptance rate):小模型猜的 token 中被大模型接受的比例。小模型与大模型越”相似”,接受率越高。
- 典型接受率 60-80%,对应 2-3× 的端到端加速。接受率低于 40% 时,draft 模型的开销反而拖慢整体。
2024-2025 年的新进展
Section titled “2024-2025 年的新进展”投机解码在 2024-2025 年从学术概念走向工业标配,主要进展包括:
- Medusa:不用单独的 draft 模型,而是给大模型本身添加多个”预测头”,每个头并行预测未来的一个 token。配合树状注意力(tree attention)一次性验证多个候选路径。简化了系统复杂度。
- EAGLE / EAGLE-2:用大模型倒数第二层的**隐藏状态(hidden state)**作为 draft 模型的输入(而非 token embedding),大幅提升接受率。EAGLE-2 引入动态 draft 树,根据上下文概率自适应调整猜测策略,实测接受率可达 80-90%。
- EAGLE-3(2025):改进 draft 模型架构,减少与大模型的表征差异,进一步提升加速比。
- n-gram 投机:最轻量的方案——不用任何 draft 模型,直接用 n-gram 匹配从上下文中找候选 token。对代码生成等重复性高的任务效果出奇地好,且零额外显存。
- 框架集成:vLLM、TGI、TensorRT-LLM 都已原生支持投机解码,2025 年的开箱即用程度远超 2023 年。
服务框架对比(2025 年格局)
Section titled “服务框架对比(2025 年格局)”2025 年的 LLM 推理引擎已经从”百家争鸣”走向几个成熟的方案。选择哪个框架,取决于你的硬件、规模和部署场景。
| 框架 | 定位 | 核心优势 | 典型场景 | 硬件支持 |
|---|---|---|---|---|
| vLLM | 开源高吞吐引擎 | PagedAttention + 连续批处理,社区最活跃,支持投机解码、FP8、前缀缓存 | API 服务、私有部署 | NVIDIA / AMD |
| SGLang | 新一代推理引擎 | RadixAttention(前缀树式 KV Cache 复用),结构化生成极快,2025 年性能比肩 vLLM | 多轮对话、结构化输出(JSON)、Agent | NVIDIA |
| TensorRT-LLM | NVIDIA 官方引擎 | 对 A100/H100/H200 极致优化,FP8 原生支持,Inflight Batching | 追求极致延迟/吞吐的 NVIDIA 环境 | 仅 NVIDIA |
| TGI | HuggingFace 推理服务 | 与 HF 生态深度集成,支持多种量化与投机解码 | HF 模型快速上线 | NVIDIA / AMD |
| llama.cpp | 轻量推理框架 | 纯 C++,GGUF 量化,CPU/GPU 混合,零依赖 | 边缘部署、消费级硬件、离线 | CPU / GPU 全平台 |
💡 2025 年选型建议:
SGLang 是 2024-2025 年最受关注的新引擎。它的 RadixAttention 用基数树(radix tree)管理 KV Cache,让多轮对话和共享前缀的场景自动复用已计算的 KV,减少重复 prefill。在 Agent 和 RAG 等多轮、多请求共享上下文的场景下,加速效果尤为突出。
推理优化的最终目标是降本。以下是 2024-2025 年的真实价格参考,帮助你建立量级感。
主流 API 定价对比
Section titled “主流 API 定价对比”| 提供商 / 模型 | 输入价格($/1M tokens) | 输出价格($/1M tokens) | 备注 |
|---|---|---|---|
| OpenAI GPT-4o | 2.50 | 10.00 | 旗舰多模态模型 |
| OpenAI GPT-4o-mini | 0.15 | 0.60 | 轻量级,性价比极高 |
| Claude 3.5 Sonnet | 3.00 | 15.00 | 擅长代码与推理 |
| DeepSeek V3 | 0.27 | 1.10 | 2025 年最具性价比的开源模型 API |
| Google Gemini 2.0 Flash | 0.10 | 0.40 | 低延迟、高吞吐 |
| 自建 Llama-3.1-70B(估算) | 0.30-0.80 | 0.60-1.50 | 取决于 GPU 利用率与批量规模 |
💡 趋势:从 2023 年到 2025 年,同等能力模型的 API 价格下降了 10-50 倍。这背后正是推理优化技术(PagedAttention、连续批处理、FP8、投机解码)的大规模工程化。
优化如何降低成本
Section titled “优化如何降低成本”假设你用 vLLM 在一张 A100(80GB)上部署 Llama-3-70B(FP8 量化):
- 不优化(逐请求推理):吞吐约 500 tokens/s,成本约 $3/1M tokens
- 开连续批处理:吞吐约 2000 tokens/s,成本降到 $0.75/1M tokens
- 再叠加投机解码:吞吐约 4000 tokens/s,成本降到 $0.38/1M tokens
- 再叠加前缀缓存(共享 system prompt):对多轮对话场景再提升 30-50%
每一层优化都在摊薄固定的 GPU 成本,让单位 token 的服务成本越来越低。
并非所有场景都能依赖云端 API——隐私(医疗、金融)、离线(无网络)、低延迟(实时翻译)等需求推动 LLM 走向终端设备。
llama.cpp 与 GGUF
Section titled “llama.cpp 与 GGUF”llama.cpp 是纯 C++ 实现的轻量推理框架,不依赖 PyTorch 或 CUDA,可以在任何有 CPU 的设备上运行 LLM。它的量化格式 GGUF 支持多种位宽:
| GGUF 量化 | 位宽 | 7B 模型大小 | 适用场景 |
|---|---|---|---|
| Q8_0 | 8-bit | ~7 GB | 追求精度,RAM 充足 |
| Q5_K_M | 5-bit | ~4.8 GB | 精度与体积的平衡点 |
| Q4_K_M | 4-bit | ~4.1 GB | 最常用,精度损失可接受 |
| Q3_K_M | 3-bit | ~3.3 GB | 极限压缩,质量下降明显 |
llama.cpp 支持 GPU offload:把部分计算层放到 GPU(如果有的话)、其余留在 CPU,自动适配混合硬件。这让它既能跑在高性能工作站上,也能跑在纯 CPU 的树莓派上。详见 小模型与端侧部署。
Apple Intelligence
Section titled “Apple Intelligence”2024 年 Apple 推出的 Apple Intelligence 是端侧 LLM 部署的标杆案例:
- 模型规模约 3B 参数(量化后),常驻设备,不依赖云端。
- 运行在 Apple Silicon 的 Neural Engine(NPU) 上,针对低功耗推理优化。
- 复杂查询(需要更大模型)通过 Private Cloud Compute 在 Apple 自建的隐私云端完成——服务器不持久存储用户数据,可被第三方审计验证。
- 这套架构证明了:经过量化、蒸馏、架构剪枝的小模型,配合专用 NPU 硬件,可以在手机上实现实用的 AI 体验。
端侧部署的 2025 年趋势
Section titled “端侧部署的 2025 年趋势”- 模型小型化:Phi-3-mini(3.8B)、Gemma-2-2B、Qwen2.5-1.5B 等高质量小模型让手机端跑 LLM 成为现实。详见 小模型与端侧部署。
- 专用硬件:高通 Snapdragon 8 Gen 3 的 Hexagon NPU、Apple Neural Engine、Intel NPU 都在为端侧推理提供算力基础。
- 混合架构:简单请求端侧处理、复杂请求云端处理,兼顾隐私、延迟和能力——这是 2025 年消费级 AI 产品的主流架构。
用 vLLM 启动 OpenAI 兼容服务
Section titled “用 vLLM 启动 OpenAI 兼容服务”vLLM 内置 OpenAI 兼容的 API 服务器,一行命令即可启动高性能推理服务:
# 启动 vLLM 服务(自动启用 PagedAttention + 连续批处理)vllm serve meta-llama/Meta-Llama-3.1-8B-Instruct \ --port 8000 \ --gpu-memory-utilization 0.9 \ --max-model-len 8192 \ --dtype auto启动后,用标准 OpenAI SDK 访问,无需改任何业务代码:
from openai import OpenAI
client = OpenAI(base_url="http://localhost:8000/v1", api_key="dummy")
resp = client.chat.completions.create(    model="meta-llama/Meta-Llama-3.1-8B-Instruct",    messages=[{"role": "user", "content": "用三句话解释什么是 Transformer。"}],    temperature=0.7,    max_tokens=200,)print(resp.choices[0].message.content)
用 llama.cpp 本地推理(GPU offload)
Section titled “用 llama.cpp 本地推理(GPU offload)”# 下载 GGUF 量化模型(Q4_K_M,4-bit)# 从 huggingface.co 下载如 Qwen2.5-7B-Instruct-Q4_K_M.gguf
# 用 llama.cpp 的 server 模式启动(把 99 层放到 GPU)./llama-server \ --model Qwen2.5-7B-Instruct-Q4_K_M.gguf \ --n-gpu-layers 99 \ --ctx-size 4096 \ --port 8080from openai import OpenAI
# llama.cpp 的 server 模式同样兼容 OpenAI APIclient = OpenAI(base_url="http://localhost:8080/v1", api_key="dummy")
resp = client.chat.completions.create( model="Qwen2.5-7B-Instruct", messages=[{"role": "user", "content": "写一个 Python 快速排序。"}],)print(resp.choices[0].message.content)推理成本估算脚本
Section titled “推理成本估算脚本”"""估算自建推理服务的成本,帮助你做 build-vs-buy 决策。"""
def estimate_cost( gpu_hourly_cost: float, # GPU 租用价格 ($/hour) throughput: float, # 引擎吞吐量 (tokens/second) utilization: float, # 平均利用率 (0-1)) -> float: """返回每百万 token 的服务成本 ($/1M tokens)。""" tokens_per_hour = throughput * 3600 * utilization cost_per_million = gpu_hourly_cost / (tokens_per_hour / 1_000_000) return cost_per_million
# 示例:A100 80GB ($2.5/h),vLLM 吞吐 4000 tokens/s,利用率 70%cost = estimate_cost( gpu_hourly_cost=2.5, throughput=4000, utilization=0.7,)print(f"自建成本: ${cost:.2f} / 1M tokens")# 输出: 自建成本: $0.31 / 1M tokens
# 对比 GPT-4o-mini 的 $0.60/1M input tokensprint(f"对比 GPT-4o-mini: 自建便宜 {0.60/cost:.1f}x")# 输出: 对比 GPT-4o-mini: 自建便宜 1.9x推理优化技术全景
Section titled “推理优化技术全景”- ChatGPT / Claude 规模化服务:OpenAI、Anthropic 每天处理数亿次请求,背后依赖 PagedAttention、连续批处理、投机解码、FP8 等技术叠加,将 GPU 利用率拉到极限——推理成本直接决定产品能否盈利。
- Ollama / llama.cpp 本地部署:在个人笔记本上跑 7B-70B 模型,依靠 INT4 量化(GGUF 格式)把显存需求压到消费级显卡甚至纯 CPU 即可运行——隐私敏感场景(医疗、金融)的首选。
- 边缘设备推理:手机端(如 Apple Intelligence 使用 ~3B 模型)、车机端用量化 + 蒸馏后的小模型做实时语音助手和文案生成,延迟 < 100ms 级别。
- 成本优化:云端团队通过 KV-Cache 复用(prefix caching)、投机解码、FP8 量化等技术,在不改模型精度的前提下将推理 API 单价降低 50%+,是 SaaS 定价的竞争力来源。
- 长文档与 RAG:128K+ 上下文场景下,KV Cache 管理和 Flash Attention 是必需,支撑 RAG 与代码库级理解。详见 推理优化技术全景。
| 术语 | 英文 | 解释 |
|---|---|---|
| KV-Cache | Key-Value Cache | 自回归生成时缓存历史 token 的注意力键值对,避免重复计算 |
| 量化 | Quantization | 将模型权重从 FP16 压缩到 INT8/INT4/FP8 等低精度,减少显存与带宽 |
| 投机解码 | Speculative Decoding | 用小模型草拟 token、大模型并行验证的加速技术,输出无损 |
| 批处理 | Batching | 将多个推理请求打包成一批同时计算,提升 GPU 利用率 |
| 连续批处理 | Continuous Batching | 逐 token 动态组批,请求完成即移出、新请求随时加入 |
| PagedAttention | PagedAttention | 将 KV-Cache 分页管理(类 OS 虚拟内存),消除显存碎片 |
| Flash Attention | Flash Attention | 分块计算注意力、减少显存读写的 IO 感知注意力实现 |
| 吞吐量 | Throughput | 单位时间处理的 token 或请求数,衡量”多快能干活” |
| 首词元延迟 | TTFT (Time To First Token) | 从请求发出到第一个 token 返回的延迟,衡量”多快有响应” |
| 算术强度 | Arithmetic Intensity | 每字节内存搬运能做多少次浮点运算,决定瓶颈是算力还是带宽 |
| 访存受限 | Memory-Bound | 性能瓶颈在显存带宽而非算力,decode 阶段的典型状态 |
| GQA / MQA | Grouped/Multi-Query Attention | 多个 Query 头共享 KV 头,减少 KV Cache 体积 |
| GPTQ / AWQ | GPTQ / AWQ | 两种主流训练后权重量化算法,INT4 量化效果好、速度快 |
| GGUF | GGUF | llama.cpp 生态的量化格式,支持多种位宽与 CPU/GPU 混合 |
| Prefill / Decode | Prefill / Decode | 推理的两个阶段:前者并行处理输入(计算密集),后者逐 token 生成(访存密集) |
| EAGLE / Medusa | EAGLE / Medusa | 2024-2025 年投机解码的改进方案,提升 draft 接受率 |
- vLLM / PagedAttention:Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention”, SOSP 2023。提出分页式 KV-Cache,是当前几乎所有高性能推理引擎的基础。
- 投机解码:Leviathan et al., “Fast Inference from Transformers via Speculative Decoding”, 2023。小模型猜 + 大模型验的经典框架。
- Medusa:Cai et al., “Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads”, 2024。多头并行预测的投机解码改进。
- EAGLE:Li et al., “EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty”, ICML 2024。基于隐藏状态的 draft 模型,接受率领先。
- GPTQ 量化:Frantar et al., “GPTQ: Accurate Post-Training Quantization for GPT”, ICLR 2023。INT4 权重量化主流方案。
- AWQ 量化:Lin et al., “AWQ: Activation-aware Weight Quantization”, MLSys 2024。基于激活感知的量化方法,广泛用于边缘部署。
- Flash Attention:Dao et al., “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness”, NeurIPS 2022。IO 感知注意力的奠基工作。
- 相关页面:推理优化技术全景(深入版)、小模型与端侧部署、解码策略与采样、Llama 系列、模型选择。