
AutoML 与可解释 AI
本页介绍传统机器学习的两大工程化方向——AutoML(自动机器学习)与可解释 AI(XAI):前者让机器自动完成”选模型、调参数、做特征”的全流程,后者为黑箱模型装上”解释器”。它们是传统机器学习概览的实用延伸,也是 ML 在金融、医疗等高合规行业落地的前提。
- AutoML = 把数据科学家的工作自动化。传统 ML 流程需要人工完成:特征工程 → 选算法 → 调超参 → 模型集成。AutoML 用搜索算法(贝叶斯优化、进化算法、甚至神经架构搜索)自动完成这些步骤——你丢进去一堆数据,它吐出一个训练好的高精度模型。像请了一个”24 小时不休息的初级数据科学家”。
- 可解释 AI = 给黑箱装一个”翻译器”。随机森林、神经网络等复杂模型就像黑箱——输入数据、输出预测,但为什么这么预测?人类看不懂。可解释 AI(SHAP、LIME)的核心思路是:事后追问——“这个预测中,每个特征贡献了多少分?“把黑箱决策拆解成人类可读的特征贡献,让模型从”它说了算”变成”它说给你听为什么”。
两者常常配合:AutoML 负责把精度拉满,可解释 AI 负责让结果可审核、可合规。
为什么这两者总是成对出现? 在真实业务场景中(如银行风控、医疗诊断),一个”精度极高但无法解释”的模型往往无法通过监管审批。可解释性正逐渐从”加分项”变为”准入门槛”——欧盟《人工智能法案》(EU AI Act, 2024 年生效)明确要求高风险 AI 系统必须具备透明性和可解释性。因此,现代 ML 工程的标准范式正在变成 AutoML + XAI:自动化追精度,可解释性保合规。
AutoML 全流程
Section titled “AutoML 全流程”SHAP 解释流程
Section titled “SHAP 解释流程”深入原理:贝叶斯优化
Section titled “深入原理:贝叶斯优化”贝叶斯优化(Bayesian Optimization)是 AutoML 超参搜索的核心引擎。理解它,需要先理解一个更广泛的问题:如何高效地优化一个昂贵的黑盒函数?
超参优化的目标是找到一组超参 ,使得验证集上的损失最小:
其中 表示”用超参 训练模型后在验证集上得到的损失”。问题在于:每评估一次 都需要完整训练一个模型,可能耗时数分钟甚至数小时。网格搜索(Grid Search)和随机搜索(Random Search)浪费大量评估在不好的区域上。
核心思路:用代理模型”猜”下一次该试哪里
Section titled “核心思路:用代理模型”猜”下一次该试哪里”贝叶斯优化的核心思想是:维护一个廉价的”代理模型”(Surrogate Model)来近似真实的目标函数,然后用一个”采集函数”(Acquisition Function)决定下一个最值得尝试的超参组合。
1. 高斯过程(Gaussian Process, GP)
Section titled “1. 高斯过程(Gaussian Process, GP)”代理模型通常选择高斯过程——它不仅预测目标函数的值,还预测不确定性(方差)。直觉上,GP 像是一张”热力图”:
- 在已经评估过的超参附近,GP 的预测很确定(方差小)
- 在从未尝试的区域,GP 的预测很不确定(方差大)
形式化地说,GP 是一个定义在函数空间上的概率分布:对任意有限的超参集合 ,对应的函数值 服从多元正态分布:
其中 是均值函数(常设为 0), 是核函数(Kernel Function)——它度量两个超参点之间的相似度。最常用的是 RBF 核(径向基函数核):
其中 是长度尺度(length scale)参数: 越大,函数越平滑; 越小,函数变化越剧烈。
一句话直觉:核函数相当于说”相似的超参大概率有相似的表现”——如果学习率 0.01 效果好,那 0.011 大概率也不错。这让 GP 能从少量已知点推理出整个超参空间的全貌。
2. 采集函数(Acquisition Function)
Section titled “2. 采集函数(Acquisition Function)”有了 GP 给出的”预测均值 “和”不确定性 “,采集函数决定下一个尝试点。它要在**利用(Exploitation)和探索(Exploration)**之间做权衡:
- 利用:在已知好的区域附近继续深挖( 低 = 损失低 = 好)
- 探索:去不确定的区域碰碰运气( 高 = 说不定有惊喜)
最经典的采集函数是期望改进(Expected Improvement, EI):
直觉是:“相比目前最好的结果 ,这个点预期能改进多少?“EI 自动平衡了探索与利用——在不确定性大的地方,即使均值一般,也可能有大幅改进的机会;在已知好区域,均值低本身就能贡献改进。
为什么不用网格搜索? 假设有 5 个超参,每个 10 个候选值,网格搜索需要 万次评估——每次评估要训练一个模型,根本不现实。贝叶斯优化通常只需 50-200 次评估就能逼近最优,效率提升数千倍。
深入原理:Shapley 值的博弈论基础
Section titled “深入原理:Shapley 值的博弈论基础”SHAP 的理论基础来自博弈论中的 Shapley 值(Shapley Value)——由诺贝尔经济学奖得主 Lloyd Shapley 于 1953 年提出。
问题设定:如何公平分配收益?
Section titled “问题设定:如何公平分配收益?”想象一个合作博弈: 个玩家组队完成任务,获得了总收益 。问题是如何公平地把收益分配给每个玩家?有些玩家单独贡献大,有些只在特定组合下才有用。
Shapley 给出了一个惊人的答案:每个玩家的公平贡献 = 它在所有可能加入顺序中的**边际贡献(Marginal Contribution)**的平均值。
玩家 的 Shapley 值定义为:
其中:
- 是全部玩家的集合,
- 是 中不含 的任意子集(“联盟”)
- 是联盟 的收益
- 就是玩家 加入联盟 时的边际贡献
- 前面的阶乘权重 是让所有加入顺序等概率出现的组合权重
从博弈论到机器学习
Section titled “从博弈论到机器学习”SHAP 的天才之处在于把这个框架映射到 ML 上:
| 博弈论 | 机器学习解释 |
|---|---|
| 玩家 | 特征 (如”收入”、“年龄”) |
| 联盟 | 特征子集 |
| 收益 | 模型只用特征子集 时的预测值 |
| 玩家 的 Shapley 值 | 特征 对当前预测的贡献 |
Shapley 值的四条公理
Section titled “Shapley 值的四条公理”Shapley 值是唯一满足以下四条公平性公理的分配方案——这保证了它在数学上的”最公平”:
- 效率性(Efficiency):所有特征的贡献之和 = 模型预测值与基准值之差。即 。
- 对称性(Symmetry):如果两个特征在模型中的角色完全等价,它们的贡献相同。
- 虚拟性(Dummy):如果一个特征对预测毫无影响(加入任何联盟都不改变收益),它的贡献为零。
- 可加性(Additivity):如果训练了两个模型,合并后的特征贡献等于各自贡献之和。
为什么 SHAP 比传统特征重要性更好? 传统基于树模型的特征重要性只统计”该特征被用于分裂的次数/增益”,是粗略的全局指标。SHAP 则有严格的博弈论公理保证,既有全局解释(所有样本的平均贡献),又有局部解释(单条样本的特征拆解),两者完全一致。
计算挑战与近似
Section titled “计算挑战与近似”精确计算 Shapley 值需要遍历所有 个特征子集——当 时就是约 100 万次,实际不可行。SHAP 库针对不同模型提供了高效近似:
- TreeSHAP(2019 年由 Lundberg 等提出):利用树结构的递归特性,把复杂度从 降到 (=树数量,=叶子数,=树深度),让树模型解释从”不可行”变为”毫秒级”。
- DeepSHAP:利用 DeepLIFT 的反向传播思想,为深度网络提供近似 SHAP 值。
- KernelSHAP:通用的模型无关方法,通过局部加权线性回归近似,但较慢。
1. SHAP 解释模型预测(完整流程)
Section titled “1. SHAP 解释模型预测(完整流程)”import shapimport matplotlib.pyplot as pltfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.datasets import load_breast_cancerfrom sklearn.model_selection import train_test_split
# 加载数据并训练模型data = load_breast_cancer()X, y = data.data, data.targetfeature_names = data.feature_namesX_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=42)
clf = RandomForestClassifier(n_estimators=100, random_state=42)clf.fit(X_tr, y_tr)print(f"测试集准确率: {clf.score(X_te, y_te):.4f}")
# ---- 全局解释:哪些特征对模型最重要? ----explainer = shap.TreeExplainer(clf) # TreeExplainer 专为树模型优化shap_values = explainer.shap_values(X_te)
# 全局特征重要性图(所有样本的平均 |SHAP| 贡献)shap.summary_plot(shap_values[:, :, 1], X_te, feature_names=feature_names, show=False)plt.title("全局特征重要性 — 乳腺癌分类")plt.tight_layout()plt.savefig("shap_global.png", dpi=150)
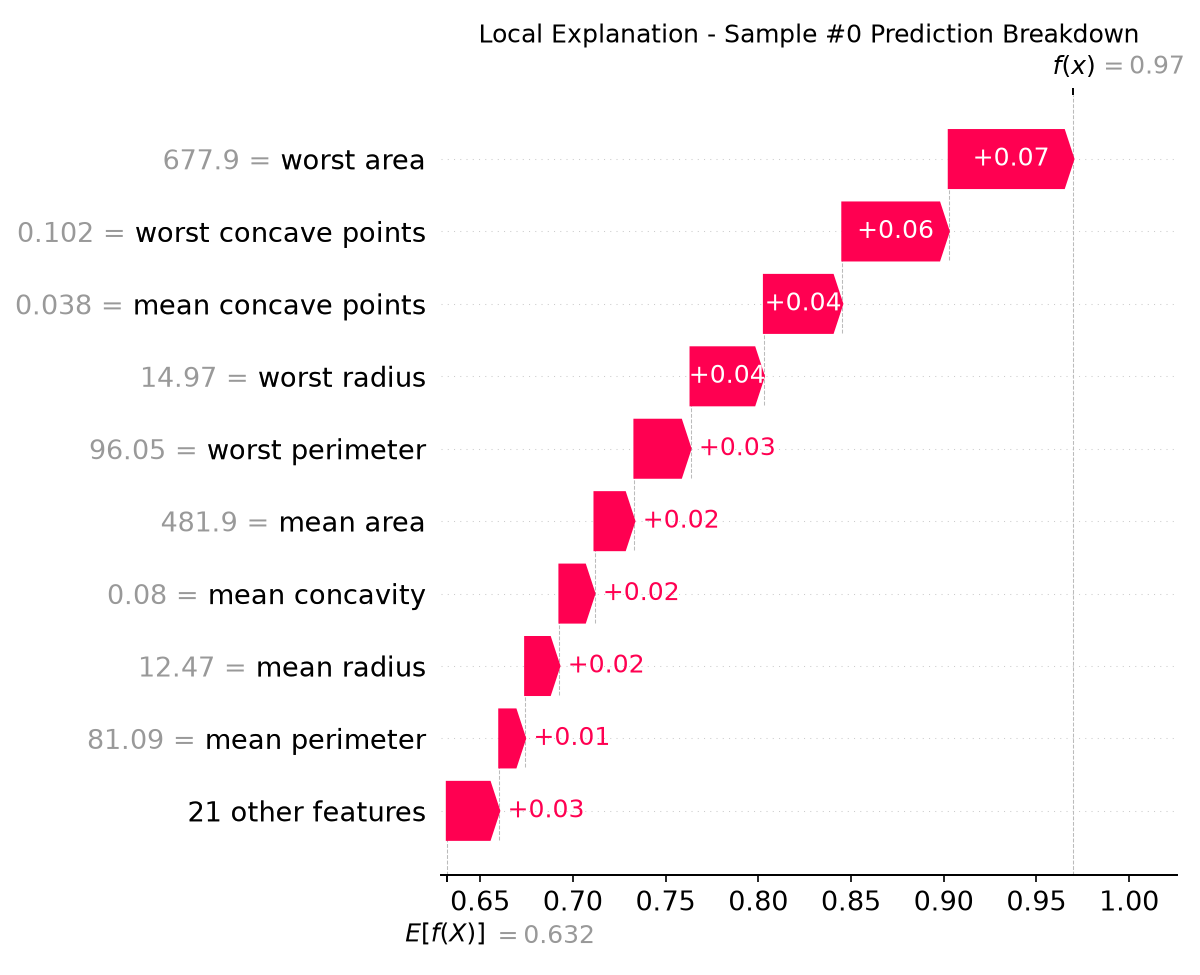
# ---- 局部解释:某一条具体样本为什么被判为恶性? ----sample_idx = 0 # 解释第一个测试样本shap.waterfall_plot( shap.Explanation( values=shap_values[sample_idx, :, 1], base_values=explainer.expected_value[1], data=X_te[sample_idx], feature_names=feature_names, ), show=False,)plt.title(f"局部解释 — 样本 #{sample_idx} 的预测拆解")plt.tight_layout()plt.savefig("shap_local.png", dpi=150)
# ---- 力图(Force Plot):最直观的单样本解释 ----shap.force_plot( explainer.expected_value[1], shap_values[sample_idx, :, 1], X_te[sample_idx], feature_names=feature_names, matplotlib=True,)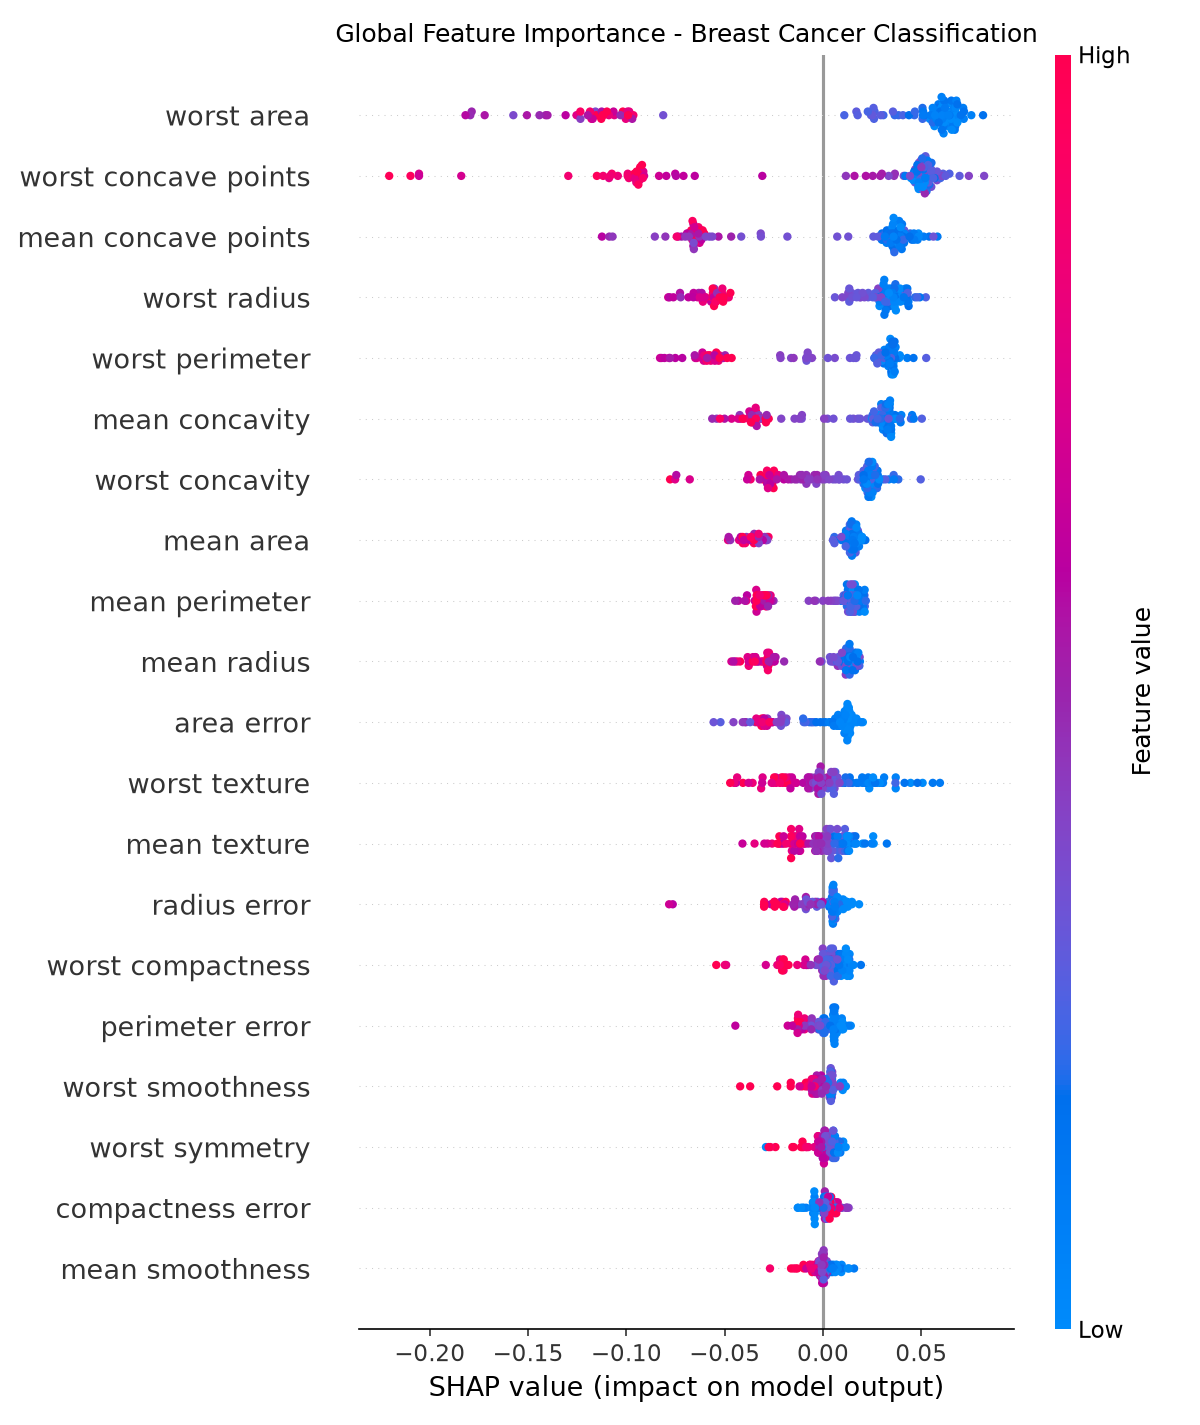
代码解读:
TreeExplainer比KernelExplainer快数百倍——它直接遍历每棵树的决策路径来计算精确 Shapley 值,而非通用近似。summary_plot给出全局视图:每个点是一个样本,横轴是 SHAP 值(正=推向恶性预测,负=推向良性),颜色代表特征值高低。waterfall_plot给出局部视图:从基准值(base value,即训练集平均预测概率)出发,逐个特征加减贡献值,最终到达该样本的实际预测——像瀑布图一样一目了然。
2. AutoML 全流程(FLAML)
Section titled “2. AutoML 全流程(FLAML)”from flaml import AutoMLfrom sklearn.datasets import fetch_california_housingfrom sklearn.model_selection import train_test_split
# 加载加州房价回归数据集X, y = fetch_california_housing(return_X_y=True)X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=42)
automl = AutoML()automl.fit( X_train=X_tr, y_train=y_tr, task="regression", # 回归任务 time_budget=60, # 60 秒预算(实际生产可用 1-2 小时) metric="r2", # 优化 R² 指标 estimator_list=["lgbm", "xgboost", "rf", "extra_tree", "catboost"], log_file_name="automl.log",)
print(f"最优模型: {automl.best_estimator}")print(f"最优超参: {automl.best_config}")print(f"验证集 R²: {1 - automl.best_loss:.4f}")
# 用最优模型在测试集上评估from sklearn.metrics import r2_scorey_pred = automl.predict(X_te)print(f"测试集 R²: {r2_score(y_te, y_pred):.4f}")3. 贝叶斯优化手动调参(Optuna)
Section titled “3. 贝叶斯优化手动调参(Optuna)”当你不想全自动、而是想精细控制搜索空间时,Optuna 是最流行的选择:
import optunafrom sklearn.ensemble import RandomForestClassifierfrom sklearn.model_selection import cross_val_scorefrom sklearn.datasets import load_breast_cancer
X, y = load_breast_cancer(return_X_y=True)
def objective(trial):    """定义一次超参评估:Optuna 会自动调用此函数,用贝叶斯优化选下一组超参"""    n_estimators = trial.suggest_int("n_estimators", 50, 300)    max_depth = trial.suggest_int("max_depth", 3, 20)    min_samples_split = trial.suggest_float("min_samples_split", 0.01, 0.1)
    clf = RandomForestClassifier(        n_estimators=n_estimators,        max_depth=max_depth,        min_samples_split=min_samples_split,        random_state=42,    )    # 5 折交叉验证的平均准确率作为目标值    scores = cross_val_score(clf, X, y, cv=5, scoring="accuracy")    return scores.mean()
# TPE(Tree-structured Parzen Estimator)是 Optuna 默认的贝叶斯优化算法study = optuna.create_study(direction="maximize", sampler=optuna.samplers.TPESampler(seed=42))study.optimize(objective, n_trials=50, show_progress_bar=True)
print(f"最优准确率: {study.best_value:.4f}")print(f"最优超参: {study.best_params}")
# 可视化超参搜索过程import optuna.visualization as visfig = vis.plot_optimization_history(study)     # 搜索历史:看是否收敛fig.write_html("optuna_history.html")fig2 = vis.plot_param_importances(study)        # 哪个超参对精度影响最大fig2.write_html("optuna_importance.html")
TPE vs 高斯过程:Optuna 默认使用 TPE(Tree-structured Parzen Estimator)而非 GP 作为代理模型。TPE 的优势在于天然支持条件超参(如”选了 SVM 才需要调 C 参数”),且在高维搜索空间中更稳健。两者都是贝叶斯优化的变体,核心思想一致。
4. InterpretML:训练一个天生可解释的模型
Section titled “4. InterpretML:训练一个天生可解释的模型”除了”事后解释”,另一条路是直接使用天生可解释的模型。微软的 InterpretML 提供了 EBM(Explainable Boosting Machine)——一种精度接近 XGBoost 但完全透明的模型:
from interpret.glassbox import ExplainableBoostingClassifierfrom interpret import showfrom sklearn.model_selection import train_test_splitfrom sklearn.datasets import load_breast_cancer
X, y = load_breast_cancer(return_X_y=True)X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=42)
# EBM 是一种广义加性模型(GAM)的现代增强版ebm = ExplainableBoostingClassifier(random_state=42)ebm.fit(X_tr, y_tr)
# 全局解释:每个特征的贡献函数(可直接看出"特征值如何影响预测")ebm_global = ebm.explain_global()show(ebm_global)  # 启动交互式仪表板
# 局部解释:某条样本的预测拆解ebm_local = ebm.explain_local(X_te[:5], y_te[:5])show(ebm_local)
EBM 的妙处:它是广义加性模型 ,每个特征有一个独立的贡献函数 ——你可以精确画出”年龄=35 对预测的贡献是 +0.12”。这种模型在金融风控中极受欢迎,因为监管可以直接审计每个特征的贡献函数。
2025-2026 最新进展
Section titled “2025-2026 最新进展”AutoML 方向
Section titled “AutoML 方向”- AutoGluon 1.x / Tabular:亚马逊的 AutoGluon 持续领跑表格数据 AutoML 基准测试。其核心创新是多层堆叠集成(Multi-layer Stacking)——自动构建 2-3 层模型堆叠(第一层 diverse base models,第二层用轻量元学习器融合),配合重复 bagging,精度常常超过精心调参的单一模型。2024-2025 年新增了与大模型结合的能力:可用 LLM 自动理解列名语义并生成特征描述。
- FLAML 2.x:微软的 FLAML 引入了 -cost-frugal optimization(WFO),同时优化精度和计算成本。它不再只追求”最高精度”,而是回答”在给定的计算预算下,性价比最高的方案是什么”——这对云上按量付费的场景非常重要。
- auto-sklearn 2.0:引入了自动选择搜索策略的能力——根据数据集特征(样本数、特征数、类型)自动决定用贝叶斯优化还是随机搜索,并在成功配置间做 meta-learning 热启动。
- LLM 驱动的 AutoML:2024-2025 年的一个新趋势是用大语言模型(LLM)来做数据科学全流程自动化。例如 Stanford 的 DS-Agent、Google 的 GEMS 等研究项目用 LLM 理解数据集语义、自动选择特征工程策略、甚至生成定制化模型代码。这模糊了”AutoML”和”AI 数据科学家”的边界。
可解释 AI 方向
Section titled “可解释 AI 方向”- LLM 的机械可解释性(Mechanistic Interpretability):这是 2023-2025 年最火热的 XAI 方向。以 Anthropic(Claude 背后的公司)为代表,研究者用**稀疏自编码器(Sparse Autoencoder, SAE)**从大语言模型的内部激活中提取出人类可理解的”概念”(如”欺骗”、“拒绝”、“代码”等)。Anthropic 2024 年发表的”Scaling Monosemanticity”从 Claude 3 的中间层提取了数百万个可解释的特征,是迈向”读懂神经网络内部”的里程碑。Google DeepMind 随后发布了 Gemma Scope,对 Gemma 2 模型的每一层都公开了预训练的 SAE,让研究者可以直接探测模型内部。
- SHAP 生态扩展:SHAP 库持续扩展对新模型架构的支持。2024 年新增了对 LightGBM 原生叶子路径的加速解释、对 Transformer 注意力的 SHAP 近似解释,以及更好的自然语言处理(NLP)模型解释工具(基于 occlusion 和 gradient 的混合方法)。
- 因果可解释性(Causal XAI):传统 SHAP 只回答”特征对预测的贡献”,但不区分因果关系和相关关系。2024-2025 年的研究热点是把因果推断(Causal Inference)引入 XAI——用**因果图(Causal Graph)**约束 SHAP 的特征归因,避免”冬天卖冰淇淋→溺水率上升”这类误导性解释。代表方法包括 Asymmetric SHAP 和 Causal Forests。
- XAI 的法规驱动:欧盟《人工智能法案》(EU AI Act)于 2024 年 8 月正式生效,要求高风险 AI 系统(信贷、医疗、招聘等)必须提供透明性和人类监督机制。这直接推动了银行、保险公司把 SHAP/LIME 解释嵌入到生产系统的 API 中——每次模型决策都会自动生成一份”解释报告”存档。
金融:信贷审批的可解释闭环
Section titled “金融:信贷审批的可解释闭环”银行用复杂模型做贷款审批后,监管要求必须向客户说明”为什么被拒”。SHAP 把拒绝原因拆解为”负债收入比过高贡献 +0.4、近半年逾期记录贡献 +0.3、信用历史不足贡献 +0.15”,满足 GDPR / 央行征信的可解释合规要求。部分银行更进一步——在客户 APP 中直接展示 SHAP 力图,让客户直观看到”改善哪些指标可以获批”,形成可解释 → 可行动的闭环。
医疗:辅助诊断的信任建立
Section titled “医疗:辅助诊断的信任建立”AI 辅助诊断肿瘤时,医生不能只看”恶性概率 87%“,需要知道模型重点看了哪些病理特征——LIME / SHAP 高亮关键影像区域和指标(如”细胞核周长”、“纹理均匀度”),让医生理解 AI 的决策依据。2024 年的研究表明,当 AI 系统附带 SHAP 解释时,医生的采纳率提高了 15-25%——可解释性直接转化为临床信任和实际应用。
竞赛:AutoML 作为基线
Section titled “竞赛:AutoML 作为基线”Kaggle、天池等数据科学竞赛中,参赛者大量使用 AutoGluon、H2O AutoML 做基线方案——几行代码就能在表格数据上达到排行榜前 10% 的精度,再在此基础上手动优化。在 2023-2024 年的多个 Kaggle 表格数据竞赛中,AutoGluon 甚至直接拿到排行榜前 3 名,引发了”传统特征工程是否还有必要”的行业讨论。
风控:模型审计与上市审批
Section titled “风控:模型审计与上市审批”金融、保险行业模型上线前需通过模型风险审计。SHAP 的全局特征重要性 + 局部样本解释,是监管报告中”模型可解释性”章节的标准工具。在美国,OCC(货币监理署)和 FRB(美联储)的模型风险管理指南(SR 11-7)虽然未强制指定具体技术,但审查中 SHAP 报告已成为事实标准。
制造业:预测性维护的根因分析
Section titled “制造业:预测性维护的根因分析”工厂设备预测性维护模型预测”某台机器未来 7 天故障概率 78%“——但维修工程师需要知道为什么。SHAP 把预测拆解为”振动频率异常贡献 +0.5、油温偏高贡献 +0.2、运行小时数超标贡献 +0.08”,帮助工程师直接定位到需要检修的部件,而非笼统地”全机检查”。
内容安全:LLM 拒绝行为的可解释性
Section titled “内容安全:LLM 拒绝行为的可解释性”大语言模型的安全对齐(Alignment)训练会让模型拒绝有害请求。但模型有时会”误伤”——拒绝合理的请求。2024-2025 年,用机械可解释性方法(如 Anthropic 的 SAE 特征探测)来定位模型中哪些神经元激活导致拒绝,已成为 LLM 安全研究的标准手段,帮助工程师精准调优而不是盲目 retrain。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| SHAP | Python | 基于 Shapley 值的统一解释框架,支持树模型/深度学习/通用模型 |
| LIME | Python | 局部近似解释,在单样本邻域拟合可解释代理模型 |
| Captum | Python | PyTorch 官方可解释性库,支持 Integrated Gradients、DeepLIFT、注意力分析等 |
| auto-sklearn | Python | 基于 scikit-learn 的 AutoML 工具,自动模型选择 + 超参优化 + 集成 |
| FLAML | Python | 微软开发的轻量快速 AutoML 库,搜索效率高 |
| AutoGluon | Python | 亚马逊开发的多模态 AutoML,表格数据精度业界领先 |
| H2O AutoML | Java/Python | 企业级 AutoML 平台,支持大规模分布式训练 |
| Optuna | Python | 通用超参优化框架(TPE 贝叶斯优化),常用于手动调参自动化 |
| InterpretML | Python | 微软开源的可解释机器学习工具包,集成 EBMs 与 SHAP/LIME |
| transformer-lens | Python | 专注于 Transformer 的机械可解释性工具,支持逆向工程主流 LLM |
| Dalex / DrWhy | Python/R | 面向模型审计的 XAI 工具套件,支持 SHAP、CP profile 等 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 自动机器学习 | AutoML | 自动完成特征工程、模型选择、超参优化与集成的全流程 |
| 神经架构搜索 | Neural Architecture Search (NAS) | 自动搜索神经网络结构(层数、连接方式等) |
| 超参优化 | Hyperparameter Optimization (HPO) | 自动搜索学习率、树深度等超参数的最优取值 |
| 贝叶斯优化 | Bayesian Optimization | 基于概率代理模型(如 GP/TPE)的高效黑盒优化方法,AutoML 核心算法 |
| 高斯过程 | Gaussian Process (GP) | 定义在函数空间上的概率分布,既预测均值也预测不确定性,是贝叶斯优化的标准代理模型 |
| 采集函数 | Acquisition Function | 贝叶斯优化中决定下一次评估位置的函数(如 EI、UCB),平衡探索与利用 |
| Shapley 值 | Shapley Value | 博弈论中唯一满足四条公平性公理的收益分配方案,SHAP 的数学基础 |
| SHAP 值 | SHAP Value | 基于 Shapley 值博弈论的特征贡献度量,加性一致 |
| LIME | LIME | Local Interpretable Model-agnostic Explanations,局部代理模型解释 |
| 机械可解释性 | Mechanistic Interpretability | 通过逆向工程神经网络内部机制来理解模型行为,2024-2025 年 XAI 前沿方向 |
| 稀疏自编码器 | Sparse Autoencoder (SAE) | 从神经网络密集激活中提取稀疏、可解释特征的无监督方法 |
| 特征重要性 | Feature Importance | 衡量各特征对模型预测贡献大小的指标 |
| 局部/全局解释 | Local / Global Explanation | 局部解释单条样本;全局解释整个模型行为 |
| 可解释性 | Interpretability | 人类理解模型决策原因的程度 |
| 广义加性模型 | Generalized Additive Model (GAM) | 形如 的可解释模型,每个特征的贡献可独立查看 |
- SHAP:Lundberg & Lee, “A Unified Approach to Interpreting Model Predictions”, NeurIPS 2017. 将 Shapley 值博弈论引入模型解释,统一了 LIME/DeepLIFT 等方法。
- TreeSHAP:Lundberg et al., “From local explanations to global understanding with explainable AI for trees”, Nature Machine Intelligence 2020. TreeSHAP 算法的完整论文,含全局-局部一致性证明。
- LIME:Ribeiro et al., “Why Should I Trust You?: Explaining the Predictions of Any Classifier”, KDD 2016. 局部代理模型解释的开山之作。
- Auto-sklearn:Feurer et al., “Efficient and Robust Automated Machine Learning”, NeurIPS 2015. 基于 meta-learning + 贝叶斯优化的 AutoML 经典实现。
- H2O AutoML:Gijsbers, “An Open Source AutoML Benchmark”, 2019. 系统对比主流 AutoML 工具的基准工作。
- Shapley 原始论文:Lloyd S. Shapley, “A Value for n-Person Games”, 1953. 博弈论 Shapley 值的奠基性工作(Shapley 因此获 2012 年诺贝尔经济学奖)。
前沿方向(2024-2025)
Section titled “前沿方向(2024-2025)”- 机械可解释性:Anthropic, “Scaling Monosemanticity”, 2024. 用稀疏自编码器从 Claude 3 中提取数百万可解释特征。Templeton et al.
- Gemma Scope:Google DeepMind, “Gemma Scope: Open Sparse Autoencoders Everywhere All At Once on Gemma 2”, 2024. 对 Gemma 2 每层公开预训练 SAE 的开源工作。
- AutoGluon:Erickson et al., “AutoGluon-Tabular: Robust and Accurate AutoML for Structured Data”, 2020(持续更新至今)。表格数据 AutoML 的 SOTA 工具。
- 因果 XAI:Heskes et al., “Causal Shapley Values: Exploiting Causal Knowledge to Explain Model Predictions”, 2023. 将因果图约束引入 SHAP 的开创性工作。