
LLM 模型部署
本页系统讲解大语言模型(Large Language Model, LLM)从训练完成到生产推理上线的全流程技术栈——从自回归生成的核心瓶颈出发,深入 KV Cache 显存管理、PagedAttention、Continuous Batching 等关键原理,再到 vLLM、SGLang、TensorRT-LLM、llama.cpp、Ollama 等主流推理引擎的实践指南,最后覆盖 Speculative Decoding、MLA、FlashAttention-3 等 2025–2026 前沿进展。它是 Transformer 架构 与 注意力机制 的工程延伸。关于通用量化原理见 量化与加速,GPU 硬件基础与多卡通信见 GPU 与多卡基础,CV 模型部署的对比见 CV 模型部署。
LLM 部署的核心挑战与传统深度学习模型截然不同。传统 CV/NLP 模型(如 ResNet、BERT)的推理是一次前向传播——输入固定长度,输出固定长度,计算量可预测。而 LLM 推理是自回归生成(Autoregressive Generation)——每次只生成一个 token,每生成一个 token 都要把之前所有 token 重新过一遍注意力,且生成长度事先未知。
这带来了三个根本性差异:
- 显存瓶颈取代算力瓶颈:推理时每一步都要用到之前所有 token 的 Key/Value 向量(即 KV Cache)。序列越长,KV Cache 越大——一个 70B 模型在 batch size 32、序列长度 4096 时,仅 KV Cache 就要消耗近 80 GB 显存,超过模型权重本身。
- 请求长度不均导致资源浪费:一个请求生成 10 个 token,另一个生成 2000 个 token。传统 Static Batching 必须等最长的请求完成才能释放槽位——短请求提前完成后,它的 GPU 算力就闲置了。
- Prefill 与 Decode 两阶段计算密度悬殊:Prefill 阶段(处理 prompt)是计算密集型(compute-bound),可以充分利用 GPU 并行;Decode 阶段(逐 token 生成)是显存带宽密集型(memory-bound),每次只算一个 token,GPU 计算单元大量闲置。
一句话总结:LLM 部署的本质是——在有限的 GPU 显存中,高效管理 KV Cache,同时服务尽可能多的并发请求,同时把 prefill 的计算延迟和 decode 的带宽瓶颈都压到最低。
LLM 推理 vs 传统模型推理对比
Section titled “LLM 推理 vs 传统模型推理对比”| 维度 | 传统模型(ResNet / BERT) | LLM(GPT / LLaMA) |
|---|---|---|
| 输出长度 | 固定(如 1000 类概率) | 动态(逐 token 生成,长度不可预测) |
| 计算模式 | 单次前向传播 | 自回归迭代(数十到数千步) |
| 显存瓶颈 | 模型权重 + 激活值 | KV Cache(随序列长度线性增长) |
| 瓶颈类型 | 计算密集(compute-bound) | Decode 阶段为带宽密集(memory-bound) |
| Batch 策略 | Static Batching 即可 | 需要 Continuous Batching 才高效 |
| 量化需求 | 可选(FP16 通常够用) | 几乎必需(INT8 / INT4 / AWQ / GPTQ) |
| 延迟来源 | 模型深度 × 单次前向 | Prefill 时间 + Decode 步数 × 每步延迟 |
Transformer 自注意力回顾
Section titled “Transformer 自注意力回顾”LLM 推理的底层计算就是 Transformer 的自注意力。给定输入序列 ,自注意力通过三个权重矩阵 生成 Query、Key、Value:
缩放点积注意力(Scaled Dot-Product Attention):
在自回归生成中,第 步生成 token 时,需要计算新的 Query 与所有历史 token 的 Key 做点积。这正是 KV Cache 存在的原因——如果不缓存历史 K/V,每步都要重新计算所有历史 token 的 K/V,计算量随步数二次增长。
更详细的 Transformer 推导见 Transformer 架构 与 注意力机制。
KV Cache:显存计算公式
Section titled “KV Cache:显存计算公式”KV Cache 存储的是每一层、每一个历史 token 的 Key 和 Value 向量。对于一个 层、注意力头维度 、注意力头数 (合并后 KV 维度为 )的模型,KV Cache 的显存占用为:
其中:
- 2:Key 和 Value 各一份
- :Transformer 层数
- :序列长度(已生成的 token 数)
- :每层的 KV 维度(GQA/MQA 下会缩小)
- :batch size
- :FP16 为 2 字节,FP32 为 4 字节
以 Llama-3-70B 为例(,,GQA 8 组 KV 头),FP16 下单个请求序列长度 4096 的 KV Cache:
batch size 32 时仅 KV Cache 就需要 GB——比模型权重本身(70B × 2B = 140 GB FP16,INT4 量化后约 35 GB)还大。这就是为什么 KV Cache 管理是 LLM 掃理引擎的核心技术。
GQA / MQA 如何减小 KV Cache? Grouped-Query Attention(GQA)让多个 Query 头共享一组 KV 头,Multi-Query Attention(MQA)更极端——所有 Query 头共享一组 KV。Llama-3-70B 用 GQA 将 KV 头数从 64 减到 8,KV Cache 直接缩小 8 倍。详见 注意力机制。
Prefill vs Decode:两阶段计算
Section titled “Prefill vs Decode:两阶段计算”LLM 推理分为两个截然不同的阶段:
Prefill 阶段(处理 prompt):
- 输入整个 prompt(可能数千 token),一次性并行计算
- 计算密集型(compute-bound):大量 GEMM 运算,GPU 计算单元利用率接近 100%
- 生成第一个 token(Time To First Token, TTFT)
- 计算量:( = prompt 长度, = 模型参数量)
Decode 阶段(逐 token 生成):
- 每步只输入 1 个 token,用 KV Cache 避免重算历史
- 显存带宽密集型(memory-bound):每步都要把整个模型权重和 KV Cache 从显存读到计算单元,但只算 1 个 token
- GPU 计算单元利用率可能只有 1-5%
- 每步计算量:(与序列长度无关,但每步都要读全部权重)
其中 为 prompt 长度, 为生成 token 数, 为模型参数量。
为什么 Decode 是 memory-bound? Decode 每步需要从 HBM 读取全部模型权重( 字节),但只产生 FLOPs 的有效计算。算术强度(arithmetic intensity)极低,远低于 GPU 的 roofline 拐点。增加 batch size 可以分摊权重读取成本、提高计算密度——这是 Continuous Batching 能大幅提升吞吐的根本原因。
PagedAttention:虚拟内存类比
Section titled “PagedAttention:虚拟内存类比”vLLM 的核心创新 PagedAttention 借鉴了操作系统的**虚拟内存(Virtual Memory)与分页(Paging)**机制来解决 KV Cache 的显存碎片问题。
传统方式的问题:每个请求预分配一块连续显存存放 KV Cache(按最大序列长度预留)。这导致:
- 内部碎片(Internal Fragmentation):请求实际生成 100 token,但预留了 2048 token 的空间——浪费 95%。
- 外部碎片(External Fragmentation):不同请求的 KV Cache 块大小不一,释放后留下零散空间,无法容纳新的大请求。
实测中,传统方式下 KV Cache 的显存利用率只有 20-40%。
PagedAttention 的方案:
将 KV Cache 划分为固定大小的块(block)——每个块存放固定数量 token(如 16 个)的 K/V。逻辑上连续的序列,物理上可以分散在不连续的块中,通过**块表(Block Table)**映射。
优势:
- 显存利用率从 ~20-40% 提升到 ~96%+:按需分配块,几乎没有浪费。
- 支持 Beam Search / Parallel Sampling:多个候选序列可以共享公共前缀的物理块(Copy-on-Write 机制),无需复制。
- 消除外部碎片:固定大小的块天然没有外部碎片问题。
Continuous Batching vs Static Batching
Section titled “Continuous Batching vs Static Batching”Static Batching(传统方式):把多个请求组成一个 batch,一起 prefill,一起 decode。问题在于——不同请求的生成长度不同,短请求完成后必须等待同 batch 中最长的请求完成,才能一起返回。等待期间,已完成请求占用的 GPU 算力和显存完全闲置。
Request A: [================] (已完成,等待中...)Request B: [============================] (最长)Request C: [==========] (已完成,等待中...) ↑ ↑ ↑ A,C 完成但无法退出 只有 B 还在算 B 完成后 batch 才结束Continuous Batching(又称 Iteration-Level Batching):不再以”完整请求”为调度单位,而是以单步 decode 迭代为单位。每一步:
- 检查当前 batch 中哪些请求已完成(遇到 EOS 或达到 max_tokens)——已完成的立即移出 batch,释放显存。
- 从等待队列中取新请求加入 batch——新请求先做 prefill,然后和现有请求一起 decode。
- 所有活跃请求一起执行一步 decode。
Step 1: [A, B, C] all decodeStep 2: [A, B, C] all decode → C finishes, D joinsStep 3: [A, B, D] all decode → A finishes, E joinsStep 4: [B, D, E] all decode这样 GPU 始终满载,请求随到随服务(无需等当前 batch 结束),吞吐量提升 2-4 倍。
延迟 / 吞吐 / 显存的数学建模
Section titled “延迟 / 吞吐 / 显存的数学建模”LLM 服务有三个核心指标:
1. Time To First Token(TTFT)——首 token 延迟,主要由 Prefill 决定:
其中 为 prompt 长度, 为参数量, 为 GPU 数量, 为单卡算力(FLOPS), 为排队延迟。
2. Time Per Output Token(TPOT)——每 token 生成延迟(Decode 阶段):
其中 为 GPU 算力, 为 GPU 显存带宽。由于 Decode 是 memory-bound,TPOT 通常由第二项(显存带宽)决定。
3. 吞吐量(Throughput)——每秒生成 token 总数:
其中 为并发 batch size。增大 可以分摊权重读取成本、提升吞吐,但受限于显存容量——KV Cache 随 batch 线性增长。
关键洞察:LLM 服务的延迟和吞吐之间存在根本性的权衡。降低 TPOT(更多并行)需要更大 batch size,但更大 batch 消耗更多显存(KV Cache),从而限制了最大并发。选择合适的推理引擎和量化方案,本质上是在这个三角中寻找最优点。
部署方案选型决策树
Section titled “部署方案选型决策树”推理引擎详解
Section titled “推理引擎详解”vLLM 是目前最流行的开源 LLM 推理引擎,由 UC Berkeley 团队开发。核心创新是 PagedAttention——将 KV Cache 分块管理,显存利用率从约 20-40% 提升到 96% 以上,吞吐量比 HuggingFace Transformers 高 14-24 倍。
核心特性:
- PagedAttention KV Cache 管理
- Continuous Batching(Iteration-Level Scheduling)
- 支持 Tensor Parallelism(多卡推理)
- 兼容 OpenAI API Server
- 支持绝大多数主流模型(Llama、Qwen、Mistral、DeepSeek、Gemma 等)
安装与离线批量推理:
pip install vllmfrom vllm import LLM, SamplingParams
# 加载模型(自动使用单卡或多卡 Tensor Parallelism)llm = LLM( model="meta-llama/Meta-Llama-3-8B-Instruct", tensor_parallel_size=1, # GPU 数量 dtype="half", # FP16 gpu_memory_utilization=0.9, # 最多使用 90% 显存 max_model_len=4096, # 最大上下文长度)
# 定义采样参数sampling_params = SamplingParams( temperature=0.8, top_p=0.95, max_tokens=512,)
# 批量推理(vLLM 内部自动 Continuous Batching)prompts = [ "请用三句话解释什么是 Transformer 架构。", "写一个 Python 快速排序的实现。", "比较 Redis 和 Memcached 的区别。",]outputs = llm.generate(prompts, sampling_params)
for output in outputs: prompt = output.prompt generated = output.outputs[0].text print(f"Prompt: {prompt[:50]}...") print(f"Generated: {generated}\n{'='*60}")启动 OpenAI 兼容 API 服务器:
vllm serve meta-llama/Meta-Llama-3-8B-Instruct \ --tensor-parallel-size 2 \ --port 8000 \ --gpu-memory-utilization 0.9 \ --max-model-len 8192启动后即可用标准 OpenAI SDK 访问:
from openai import OpenAI
client = OpenAI(base_url="http://localhost:8000/v1", api_key="dummy")
response = client.chat.completions.create(    model="meta-llama/Meta-Llama-3-8B-Instruct",    messages=[        {"role": "system", "content": "你是一个专业的 AI 工程师。"},        {"role": "user", "content": "vLLM 的 PagedAttention 解决了什么问题?"},    ],    temperature=0.7,    max_tokens=512,)print(response.choices[0].message.content)
vLLM 的适用场景:需要高吞吐的云端 API 服务、支持绝大多数主流模型、社区活跃。如果你不确定选哪个引擎,vLLM 是最稳妥的默认选择。
SGLang
Section titled “SGLang”SGLang 是由 LMSYS 团队开发的推理引擎,核心创新是 RadixAttention(基数树注意力)和结构化生成加速。
RadixAttention 原理:
在多轮对话或 few-shot 场景中,不同请求往往共享公共的前缀(system prompt、few-shot 示例)。RadixAttention 用一棵**基数树(Radix Tree)**来自动识别和复用这些公共前缀的 KV Cache:
- 每个节点代表一个 token 序列片段,存储对应的 KV Cache。
- 新请求到来时,沿基数树匹配最长公共前缀——命中部分的 KV Cache 直接复用,无需重新计算 Prefill。
- 前缀未命中时,只对增量部分做 Prefill 计算。
对于多轮对话场景,RadixAttention 可以减少 50-80% 的重复 Prefill 计算。
结构化生成加速:SGLang 内置了 JSON、正则表达式约束生成,能保证输出符合指定 schema,且速度远快于在应用层反复重试的方式。
import sglang as sgl
# 定义结构化生成程序@sgl.functiondef extract_info(s, text):    s += "从以下文本中提取结构化信息:\n"    s += text + "\n\n"    s += "请输出 JSON 格式:\n"    s += sgl.gen(        "json_output",        max_tokens=256,        regex=r'\{"name":\s*"[^"]+",\s*"age":\s*\d+,\s*"city":\s*"[^"]+"\}',    )
# 启动引擎runtime = sgl.Runtime(model_path="meta-llama/Meta-Llama-3-8B-Instruct")
# 批量结构化提取texts = ["张三,28岁,住在北京。", "李四,35岁,住在上海。"]for text in texts:    result = extract_info.run(text=text, temperature=0.0)    print(result["json_output"])
SGLang 的适用场景:大量请求共享公共前缀(Agent / 多轮对话 / few-shot)、需要结构化输出(JSON / 工具调用)、需要复杂 prompt 编排。在这些场景下比 vLLM 更快。
Ollama
Section titled “Ollama”Ollama 是最流行的本地 LLM 运行工具,专为开发者和个人用户设计——一行命令即可在本地运行各种开源大模型,无需了解底层细节。
核心特点:
- 极简安装(macOS / Linux / Windows 原生安装包)
- 内置模型管理(自动下载、量化、版本管理)
- 基于 llama.cpp 的 GGUF 运行时,自动检测 GPU / CPU
- REST API 兼容 OpenAI 格式
- 支持 Modelfile 自定义模型(类似 Dockerfile)
安装与使用:
# macOS / Linuxcurl -fsSL https://ollama.com/install.sh | sh
# 拉取并运行模型ollama run llama3.1:8b          # 首次运行自动下载ollama run qwen2.5:7bollama run deepseek-r1:7bollama run phi-3:mini
# 查看已下载的模型ollama list
# 通过 API 调用curl http://localhost:11434/api/chat -d '{  "model": "llama3.1:8b",  "messages": [    {"role": "user", "content": "解释 KV Cache 是什么"}  ],  "stream": false}'
Modelfile 自定义模型:
# Modelfile — 类似 Dockerfile,定义自定义模型FROM llama3.1:8b
# 系统提示词SYSTEM """你是一个资深的 Python 开发工程师,回答简洁专业。"""
# 采样参数PARAMETER temperature 0.7PARAMETER top_p 0.9PARAMETER num_ctx 8192
# 停止词PARAMETER stop "</answer>"ollama create my-python-assistant -f Modelfileollama run my-python-assistantOllama 的适用场景:本地开发原型、个人使用、嵌入式应用的后端。不适合高并发生产环境(吞吐量远低于 vLLM)。
llama.cpp
Section titled “llama.cpp”llama.cpp 是 Georgi Gerganov 开源的纯 C/C++ LLM 推理库——最初为了在 MacBook 上跑 LLaMA 而诞生,现已成为 CPU / 边缘端 LLM 推理的事实标准。
核心特性:
- 纯 C/C++ 实现,零依赖(不需要 PyTorch / CUDA)
- 支持 CPU(AVX2 / AVX-512 / NEON)、GPU(CUDA / Metal / Vulkan / OpenCL)
- GGUF 格式:统一的模型文件格式,支持多种量化精度
- 内存高效:支持 mmap 加载,大模型可以超过物理内存用磁盘交换
- 被广泛集成:Ollama、LM Studio、Text Generation WebUI 等底层都基于 llama.cpp
GGUF 量化选项(常用):
| 量化级别 | 每权重比特 | 70B 模型大小 | 质量损失 | 适用场景 |
|---|---|---|---|---|
| Q8_0 | 8 bit | ~70 GB | 极小 | 有充足显存/内存时 |
| Q6_K | 6 bit | ~55 GB | 很小 | 质量优先 |
| Q5_K_M | 5 bit | ~48 GB | 小 | 质量与体积均衡 |
| Q4_K_M | 4 bit | ~40 GB | 可接受 | 推荐默认选择 |
| Q3_K_M | 3 bit | ~33 GB | 明显 | 极端资源受限 |
| Q2_K | 2 bit | ~26 GB | 较大 | 不推荐 |
使用示例:
# 编译(以 CUDA 为例)git clone https://github.com/ggerganov/llama.cppcd llama.cppmake GGML_CUDA=1 -j$(nproc)
# 编译(CPU only)make -j$(nproc)
# 下载 GGUF 模型(从 HuggingFace)wget https://huggingface.co/meta-llama/Meta-Llama-3-8B-Instruct-GGUF/resolve/main/Meta-Llama-3-8B-Instruct-Q4_K_M.gguf
# 命令行对话./llama-cli \    -m Meta-Llama-3-8B-Instruct-Q4_K_M.gguf \    -p "解释 PagedAttention 的原理" \    -n 512 \    --gpu-layers 99    # 尽可能多的层放到 GPU
# 启动 OpenAI 兼容 API 服务器./llama-server \    -m Meta-Llama-3-8B-Instruct-Q4_K_M.gguf \    --port 8080 \    --gpu-layers 99 \    -c 4096            # 上下文长度
# Python 绑定 (llama-cpp-python)from llama_cpp import Llama
llm = Llama( model_path="./Meta-Llama-3-8B-Instruct-Q4_K_M.gguf", n_gpu_layers=-1, # 全部放 GPU n_ctx=4096,)
response = llm.create_chat_completion( messages=[{"role": "user", "content": "什么是 Continuous Batching?"}], max_tokens=256, temperature=0.7,)print(response["choices"][0]["message"]["content"])llama.cpp 的适用场景:CPU 推理、Apple Silicon(Metal 加速)、资源受限设备、需要极致控制权的生产环境。Ollama 底层即基于 llama.cpp。
TensorRT-LLM
Section titled “TensorRT-LLM”TensorRT-LLM 是 NVIDIA 官方的 LLM 推理引擎,基于 TensorRT 深度学习推理框架构建。在 NVIDIA GPU 上通常能达到最高性能——深度集成 CUDA、NCCL、FP8 / INT8 计算、内核级优化。
核心特性:
- NVIDIA 官方维护,紧跟最新硬件特性(H100 / B200 / FP8)
- 自动内核融合(Kernel Fusion)、插件(Plugin)系统
- 支持 Tensor Parallelism + Pipeline Parallelism
- In-flight Batching(vLLM Continuous Batching 的 NVIDIA 实现)
- 支持 INT8 / INT4 Weight-Only Quantization、SmoothQuant、FP8
使用流程:
# 安装pip install tensorrt-llm
# 1. 将 HuggingFace 模型转换为 TensorRT 引擎python convert_checkpoint.py \    --model_dir meta-llama/Meta-Llama-3-8B-Instruct \    --output_dir ./llama3_8b_trt \    --dtype float16
# 2. 构建推理引擎trtllm-build \    --checkpoint_dir ./llama3_8b_trt \    --output_dir ./llama3_8b_engine \    --gemm_plugin float16 \    --max_batch_size 32 \    --max_input_len 2048 \    --max_output_len 512
# 3. 启动 Triton Inference Server(生产部署)# TensorRT-LLM 通常通过 NVIDIA Triton Inference Server 暴露服务
TensorRT-LLM 的适用场景:生产环境、NVIDIA GPU、追求极致性能(延迟 / 吞吐)。代价是:构建引擎过程复杂、对新模型支持有滞后(需等 NVIDIA 适配)、调试困难。如果 vLLM 已经满足需求,没必要上 TensorRT-LLM。
OpenAI 兼容 API 标准
Section titled “OpenAI 兼容 API 标准”几乎所有现代 LLM 推理引擎都支持 OpenAI Chat Completions API 格式作为统一接口——这意味着前端代码无需修改即可在不同后端之间切换。
标准端点:
| 端点 | 功能 |
|---|---|
POST /v1/chat/completions | 对话补全(最常用) |
POST /v1/completions | 文本补全(旧版) |
POST /v1/embeddings | 文本向量化 |
GET /v1/models | 列出可用模型 |
兼容 OpenAI API 的推理引擎:
| 引擎 | 兼容方式 | 特点 |
|---|---|---|
| vLLM | vllm serve 内置 | 开箱即用 |
| SGLang | python -m sglang.launch_server 内置 | 开箱即用 |
| TensorRT-LLM | 通过 Triton Inference Server | 需配置 |
| llama.cpp | llama-server 内置 | 轻量 |
| Ollama | http://localhost:11434/v1/ | 内置兼容层 |
| LiteLLM | 独立代理网关 | 统一 100+ 模型接口 |
# 同一段代码,只需改 base_url 即可切换后端from openai import OpenAI
# vLLM 后端client = OpenAI(base_url="http://localhost:8000/v1", api_key="dummy")
# Ollama 后端# client = OpenAI(base_url="http://localhost:11434/v1", api_key="dummy")
# OpenAI 官方# client = OpenAI()  # 默认 api.openai.com
response = client.chat.completions.create(    model="meta-llama/Meta-Llama-3-8B-Instruct",    messages=[{"role": "user", "content": "Hello!"}],)
Prefix Cache / Prompt Cache
Section titled “Prefix Cache / Prompt Cache”前缀缓存(Prefix Caching) 是一种在请求间复用公共前缀 KV Cache 的优化技术。当多个请求共享相同的 system prompt 或 few-shot 前缀时,只需计算一次 Prefill,后续请求直接复用缓存。
原理:
对于 个共享同一 system prompt(长度 )的请求,总 Prefill FLOPs 从 降低到 ( 为每个请求的独立前缀长度)。
各引擎支持情况:
| 引擎 | 前缀缓存 | 实现方式 |
|---|---|---|
| vLLM | --enable-prefix-caching | 基于块哈希自动匹配 |
| SGLang | 默认开启 | RadixAttention |
| TensorRT-LLM | 支持 | KV Cache Reuse |
| OpenAI API | prompt_cache_key 参数 | 服务端自动管理 |
# vLLM 启用前缀缓存vllm serve meta-llama/Meta-Llama-3-8B-Instruct \ --enable-prefix-caching效果参考:对于 Agent / 多轮对话场景(大量请求共享 system prompt),前缀缓存可以减少 50-80% 的 TTFT。OpenAI 官方 API 对缓存命中的 input token 价格打 5 折,成本节省非常可观。
模型规模与硬件匹配
Section titled “模型规模与硬件匹配”| 模型规模 | FP16 显存 | INT8 显存 | INT4 显存 | 推荐硬件 |
|---|---|---|---|---|
| 1-3B | 6-6 GB | 3-3 GB | 1-2 GB | 消费级 GPU / CPU |
| 7-8B | 14-16 GB | 7-8 GB | 4-5 GB | RTX 4090 / Mac M2+ |
| 13-14B | 26-28 GB | 13-14 GB | 7-8 GB | RTX 4090 / A10 |
| 30-34B | 60-68 GB | 30-34 GB | 16-20 GB | A100 40GB / 2× RTX 4090 |
| 70B | 140 GB | 70 GB | 35-40 GB | 2× A100 80GB / 4× A6000 |
| 175B+ | 350 GB+ | 175 GB+ | 90 GB+ | 4-8× H100 80GB |
经验法则:可用显存 ≈ 模型权重 + KV Cache + 激活值。KV Cache 随并发数和序列长度线性增长(见前文公式)。建议预留 20-30% 显存余量给 KV Cache 和框架开销。
推理引擎横向对比
Section titled “推理引擎横向对比”| 特性 | vLLM | SGLang | TensorRT-LLM | llama.cpp | Ollama |
|---|---|---|---|---|---|
| 定位 | 高性能服务端 | 结构化生成 / 前缀复用 | NVIDIA 极致性能 | CPU/边缘全平台 | 本地极简使用 |
| 吞吐 | ★★★★★ | ★★★★★ | ★★★★★+ | ★★★ | ★★ |
| 延迟 | ★★★★ | ★★★★ | ★★★★★ | ★★★ | ★★★ |
| 易用性 | ★★★★ | ★★★ | ★★ | ★★★ | ★★★★★ |
| 模型支持 | 极广 | 较广 | 需等待适配 | 极广(GGUF) | 较广 |
| 硬件支持 | NVIDIA / AMD | NVIDIA / AMD | NVIDIA only | 全平台 | 全平台 |
| 量化 | AWQ / GPTQ / FP8 | AWQ / GPTQ | INT8 / FP8 / AWQ | GGUF (Q2-Q8) | GGUF |
| 多卡 | TP | TP | TP + PP | 支持 | 自动 |
| API 兼容 | OpenAI | OpenAI | Triton | OpenAI | OpenAI |
| 前缀缓存 | 可选 | 默认(RadixAttention) | 支持 | - | - |
推理引擎吞吐量对比
Section titled “推理引擎吞吐量对比”下图直观展示了主流 LLM 推理引擎在相同硬件(单卡 A100)和模型(LLaMA-3-8B)下的吞吐量差异。可以看到,相比朴素 HuggingFace Transformers 推理,TensorRT-LLM 和 SGLang 等专用引擎可获得 10 倍以上的吞吐提升。
import matplotlibmatplotlib.use("Agg")
import matplotlib.pyplot as pltimport numpy as np
np.random.seed(42)
engines = ["HF Transformers", "TGI", "vLLM", "SGLang", "TensorRT-LLM"]throughput = [500, 4000, 6000, 7500, 8000]
colors = ["#6c757d", "#fd7e14", "#0d6efd", "#20c997", "#dc3545"]
fig, ax = plt.subplots(figsize=(9, 5.5))
bars = ax.bar(engines, throughput, color=colors, edgecolor="white", linewidth=0.8, width=0.6)
# Value labels on top of each barfor bar, value in zip(bars, throughput):    ax.text(        bar.get_x() + bar.get_width() / 2,        bar.get_height() + 150,        f"{value:,}",        ha="center",        va="bottom",        fontsize=11,        fontweight="bold",    )
ax.set_title(    "LLM Inference Engine Throughput Comparison (LLaMA-3-8B, A100)",    fontsize=12,    fontweight="bold",)ax.set_ylabel("Throughput (tokens/s)", fontsize=11)ax.set_xlabel("Inference Engine", fontsize=11)
ax.set_ylim(0, max(throughput) * 1.18)ax.yaxis.grid(True, linestyle="--", alpha=0.4)ax.set_axisbelow(True)
# Add a horizontal reference line for baselineax.axhline(y=throughput[0], color="#6c757d", linestyle=":", alpha=0.5, linewidth=1)ax.text(    len(engines) - 0.5,    throughput[0] + 100,    "Baseline (HF Transformers)",    fontsize=8,    color="#6c757d",    ha="right",    va="bottom",)
ax.tick_params(axis="x", labelsize=10)ax.tick_params(axis="y", labelsize=10)
plt.tight_layout()plt.savefig(    "llm-deployment-throughput.png",    dpi=180,    bbox_inches="tight",    facecolor="white",)plt.close()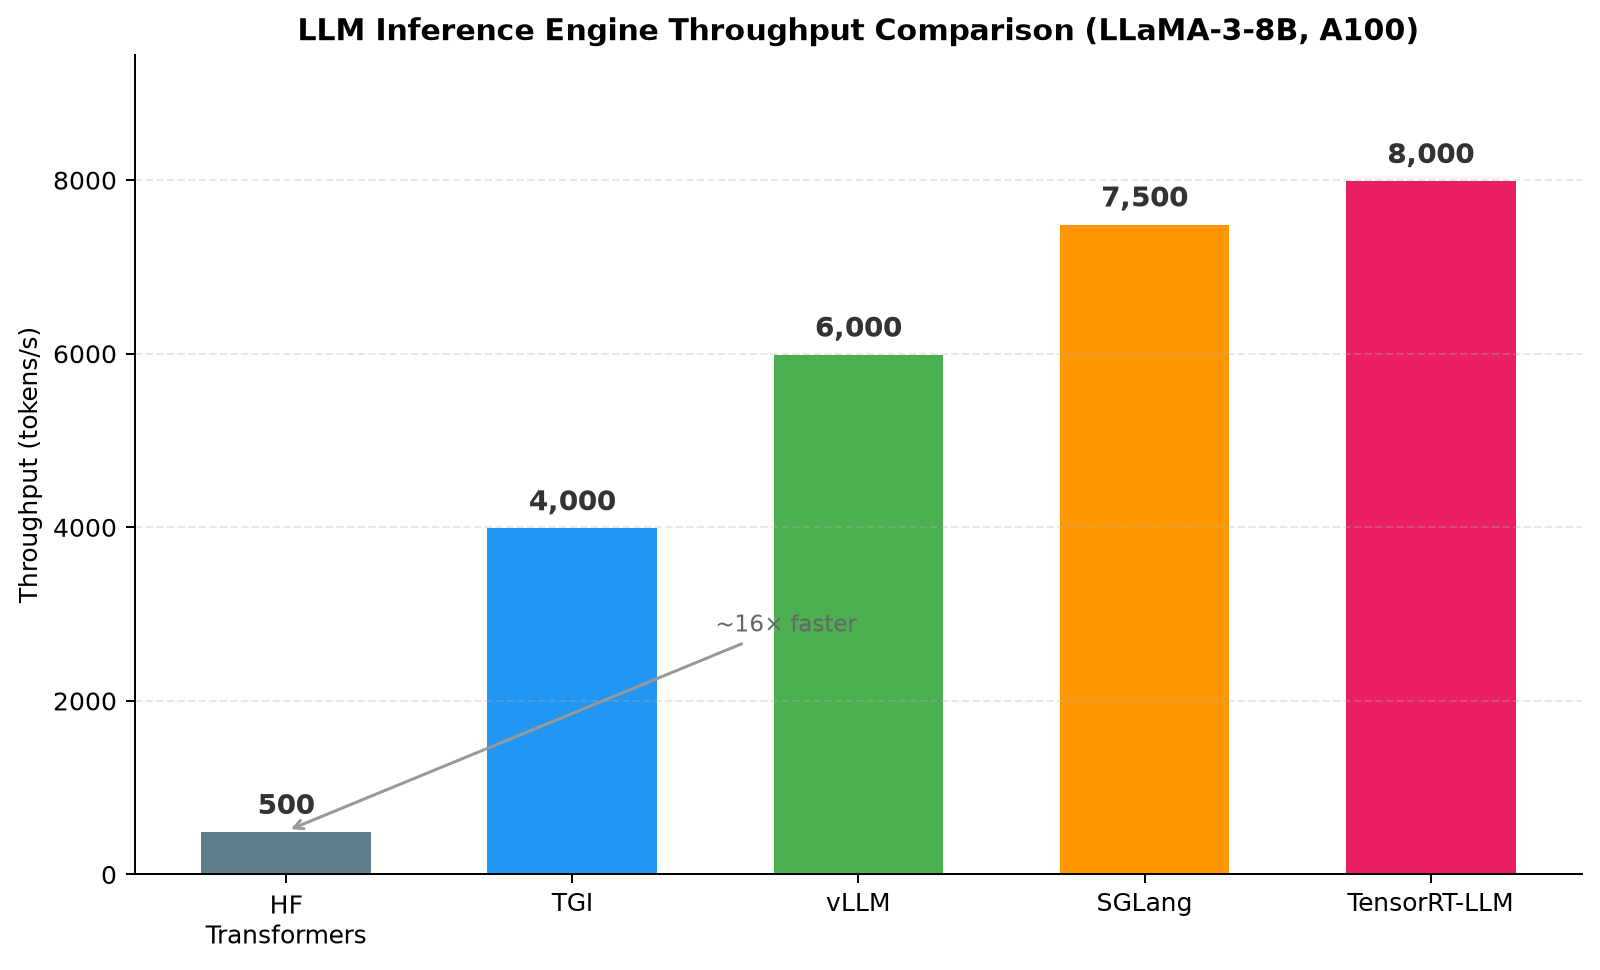
推理引擎吞吐量对比
Section titled “推理引擎吞吐量对比”下图以 LLaMA-3-8B 在单张 A100 上的推理吞吐量为例,直观对比了各主流推理引擎的性能差异(数值为模拟参考值):
import matplotlibmatplotlib.use("Agg")
import matplotlib.pyplot as pltimport numpy as np
np.random.seed(42)
engines = ["HF\nTransformers", "TGI", "vLLM", "SGLang", "TensorRT-LLM"]throughput = [500, 4000, 6000, 7500, 8000]
colors = ["#607D8B", "#2196F3", "#4CAF50", "#FF9800", "#E91E63"]
fig, ax = plt.subplots(figsize=(9, 5.5))
x = np.arange(len(engines))bars = ax.bar(x, throughput, color=colors, width=0.6, edgecolor="white", linewidth=0.8)
# Value labels on top of each barfor bar, val in zip(bars, throughput):    ax.text(        bar.get_x() + bar.get_width() / 2,        bar.get_height() + 120,        f"{val:,}",        ha="center", va="bottom",        fontsize=11, fontweight="bold", color="#333",    )
ax.set_xticks(x)ax.set_xticklabels(engines, fontsize=10)ax.set_ylabel("Throughput (tokens/s)", fontsize=10)ax.set_title(    "LLM Inference Engine Throughput Comparison (LLaMA-3-8B, A100)",    fontsize=12,    fontweight="bold",)ax.set_ylim(0, max(throughput) * 1.18)ax.spines["top"].set_visible(False)ax.spines["right"].set_visible(False)ax.grid(axis="y", linestyle="--", alpha=0.3)
# Annotation: vLLM is ~12× fasterax.annotate(    "~16× faster",    xy=(0, 500), xytext=(1.5, 2800),    fontsize=9, color="#666",    arrowprops=dict(arrowstyle="->", color="#999", lw=1.2),)
plt.tight_layout()plt.savefig(    "static/img/generated/llm-deployment-throughput.png",    dpi=180,    bbox_inches="tight",    facecolor="white",)plt.close()
采样参数调优
Section titled “采样参数调优”# 常用采样参数及其影响sampling_params = { # 温度:值越高输出越随机多样,越低越确定保守 "temperature": 0.7, # 0 = 贪心解码,1.0 = 默认,>1.0 = 更随机
# Top-P(核采样):从累积概率达到 P 的最小 token 集合中采样 "top_p": 0.9, # 0.1 = 非常保守,1.0 = 不过滤
# Top-K:只从概率最高的 K 个 token 中采样 "top_k": 50, # 1 = 贪心解码,50 = 常用值
# 重复惩罚:降低已出现 token 的概率 "repetition_penalty": 1.1, # 1.0 = 不惩罚,>1.0 = 惩罚重复
# 最大生成长度 "max_tokens": 512,}| 场景 | temperature | top_p | top_k | 说明 |
|---|---|---|---|---|
| 代码生成 | 0.0-0.2 | 0.9 | - | 确定性高,避免语法错误 |
| 事实问答 | 0.0-0.3 | 0.8 | - | 准确为先 |
| 创意写作 | 0.7-1.0 | 0.95 | 50 | 鼓励多样性 |
| 翻译 | 0.1-0.3 | 0.9 | - | 忠于原文 |
| 通用对话 | 0.5-0.7 | 0.9 | - | 平衡 |
temperature vs top_p:两者都控制随机性,但机制不同。temperature 是全局缩放(改变所有 token 的概率分布形状),top_p 是动态截断(直接过滤低概率 token)。实践中通常调一个即可,不建议同时大幅修改。OpenAI 官方建议:调了 temperature 就不要调 top_p。
2025–2026 最新进展
Section titled “2025–2026 最新进展”Speculative Decoding(推测解码)
Section titled “Speculative Decoding(推测解码)”核心思想:用一个小而快的**草稿模型(Draft Model)**先生成 个候选 token,再用大模型一次性验证(parallel verify)这些 token。大模型验证 个 token 只需一次前向传播(相当于生成 1 个 token 的延迟),如果草稿模型的准确率高,就能大幅降低端到端延迟。
数学直觉:假设草稿模型与目标模型的 token 分布完全一致(接受率 ),生成 个 token 只需 次大模型前向传播,加速 倍。实际中 ,有效加速约为:
其中 为草稿模型的相对计算开销。典型场景(, , )下可获得 2-3 倍 延迟降低。
主要方案:
| 方案 | 草稿来源 | 特点 |
|---|---|---|
| EAGLE / EAGLE-2 | 小型自回归头 | 目前最先进的自推测方案,接受率高 |
| Medusa | 多头并行预测 | 无需独立草稿模型,在目标模型上加 Medusa 头 |
| Lookahead Decoding | Jacobi 迭代 | 无需训练,纯算法加速 |
| Speculative Decoding (Leviathan 2023) | 独立小模型 | 经典方案,实现简单 |
vLLM 已原生支持 EAGLE 和 Medusa 推测解码。使用时需提供草稿模型路径,引擎自动处理验证逻辑。
MLA(Multi-head Latent Attention)
Section titled “MLA(Multi-head Latent Attention)”DeepSeek-V2 / V3 引入的 MLA(Multi-head Latent Attention) 是对 MHA / GQA / MQA 的进一步演进,核心目标是在保持注意力的同时,大幅压缩 KV Cache。
传统方式的 KV Cache 存储每个 token 的完整 K 和 V 向量。MLA 的思路是把 K/V 压缩到一个低秩的隐向量(latent vector)中,KV Cache 只存这个隐向量,推理时再动态还原为完整的 K/V。
DeepSeek-V2 将 KV 缓存压缩到每层仅 维(对比 Llama-3-70B 的 组),KV Cache 大小减少 93.3%。这让 DeepSeek 模型可以在相同显存下服务远更多的并发请求。
MLA 是 DeepSeek 系列的核心架构创新之一,也是 DeepSeek-V3 能以极低成本提供 API 服务的技术基础。详见 Transformer 架构 中关于注意力变体的讨论。
FlashAttention-3
Section titled “FlashAttention-3”FlashAttention-3 是 Tri Dao 团队为 NVIDIA Hopper 架构(H100)重新设计的注意力内核,相比 FlashAttention-2 性能再提升 1.5-2 倍。
三大优化:
- 异步化(Asynchrony):利用 H100 的 TMA(Tensor Memory Accelerator)和 WGMMA(Warpgroup Matrix Multiply-Accumulate),实现数据搬运和计算的真正重叠。
- FP8 支持:在 H100 上利用 FP8 Tensor Core,吞吐翻倍。
- 低精度因果掩码:在 decode 阶段利用 FP8 GEMM 同时保持数值精度。
| 版本 | GPU 架构 | 相对速度 | 特性 |
|---|---|---|---|
| FlashAttention-1 | A100 (Ampere) | 1× | 分块计算减少 HBM 读写 |
| FlashAttention-2 | A100 | ~2× | 更好的并行化、减少非 matmul 计算 |
| FlashAttention-3 | H100 (Hopper) | ~6-8× | 异步 + FP8 + WGMMA |
vLLM 0.5+ 已集成 FlashAttention-3(需 H100 GPU)。对于非 Hopper 架构 GPU,FlashAttention-2 仍然是最优选择。
多模态 LLM 部署
Section titled “多模态 LLM 部署”多模态 LLM(如 LLaVA、Qwen-VL、InternVL)在纯文本 LLM 之上增加了视觉编码器(Vision Encoder)和投影层。部署时需额外考虑:
- 图像预处理:图片需 resize / normalize / patch 化为视觉编码器输入格式。
- 视觉 token 对齐:图像被编码为数百到数千个视觉 token,拼接到文本 token 前面,显著增加 Prefill 计算量和 KV Cache。
- 动态分辨率:不同图片尺寸产生不同数量的视觉 token,batch 处理更复杂。
# vLLM 部署多模态模型from vllm import LLM, SamplingParams
llm = LLM(    model="llava-hf/llava-v1.6-mistral-7b-hf",    image_input_type="pixel_values",    image_token_id=32000,  # 模型配置中的 <image> token ID)
# 多模态推理from PIL import Imageimage = Image.open("chart.png")
# 需要通过 prompt 模板传入图片prompt = "<image>\n请描述这张图表的内容。"outputs = llm.generate(    {"prompt": prompt, "multi_modal_data": {"image": image}},    SamplingParams(max_tokens=256),)
端侧 LLM
Section titled “端侧 LLM”端侧 LLM(On-Device LLM)正在快速发展,目标是让数十亿参数模型直接在手机、平板上运行:
| 方案 | 平台 | 代表模型 | 模型大小 |
|---|---|---|---|
| Apple Foundation Models | iOS 18.1+ | Apple 3B | ~3B (INT4) |
| Google Gemini Nano | Android 14+ | Gemini Nano | ~3.25B |
| MLC-LLM | iOS / Android / Web | 各种开源模型 | 灵活 |
| llama.cpp | 全平台 | Llama / Qwen / Phi | 灵活 |
| MNN-LLM(阿里) | 移动端 | 各种开源模型 | 灵活 |
| ExecuTorch(Meta) | 移动端 | Llama / Phi | 灵活 |
端侧 LLM 的核心约束是内存(RAM)——手机通常只有 4-12 GB 可用 RAM,因此 INT4 量化(甚至 2 bit)是必需的。
# MLC-LLM 在手机上部署示例# 1. 转换模型为 MLC 格式# mlc_llm convert ./Llama-3-8B-Instruct --quantization q4f16_1
# 2. 编译为目标平台(如 iOS / Android)# mlc_llm compile ./Llama-3-8B-Instruct-q4f16_1 --target ios
# 3. 在 App 中通过 Swift / Kotlin SDK 调用
推理专用硬件
Section titled “推理专用硬件”2024-2025 年涌现了多种面向 LLM 推理的专用硬件:
| 硬件 | 厂商 | 核心特点 | 性能定位 |
|---|---|---|---|
| NVIDIA B200 | NVIDIA | Blackwell 架构,FP4,192 GB HBM3e | 单卡可跑 70B+,FP4 下 175B |
| NVIDIA GB200 NVL72 | NVIDIA | 72 颗 B200 组成的机架级系统 | 超大规模推理集群 |
| Groq LPU | Groq | 确定性数据流架构,极致带宽 | 单卡 decode 吞吐可达数百 tok/s |
| Cerebras WSE-3 | Cerebras | 晶圆级芯片,超大 SRAM | 无需分片,全模型在单芯片 |
| SambaNova SN40L | SambaNova | RDU(可重构数据流) | 三层存储架构 |
| AMD MI300X | AMD | 192 GB HBM3,对标 H100 | ROCm 生态,vLLM 已支持 |
| Cambricon 思元 | 寒武纪 | 国产 AI 芯片 | 国内替代方案 |
Groq LPU 的特殊之处:Groq 的 LPU(Language Processing Unit)采用确定性数据流架构——没有缓存层次、没有分支预测,通过编译器完全静态调度。这使得它在单请求 decode 延迟上远超 GPU(可以跑出 >500 tokens/s 的生成速度),但代价是芯片利用率在 batch 不饱和时较低,且生态远不如 CUDA 成熟。
LLM 部署的技术栈可以归纳为三个层次:
-
系统层优化——PagedAttention(KV Cache 分页管理)、Continuous Batching(迭代级批处理)、Prefix Caching(前缀复用)。这些是吞吐量的基础,vLLM / SGLang / TensorRT-LLM 都已实现。
-
模型层优化——量化(INT8 / INT4 / AWQ / GPTQ / FP8)、GQA / MQA / MLA(减小 KV Cache)、Speculative Decoding(推测解码降低延迟)。这些决定了单卡能跑多大模型、多快。
-
硬件层加速——FlashAttention-2/3(融合注意力内核)、推理专用芯片(B200 / Groq LPU / Cerebras)、多卡并行(TP / PP)。
选择推理引擎的核心逻辑:本地个人用 → Ollama;高并发服务 → vLLM;结构化/前缀复用 → SGLang;NVIDIA 极致性能 → TensorRT-LLM;CPU/边缘 → llama.cpp。
进一步学习:量化原理与精度权衡见 量化与加速;多卡通信(NVLink / PCIe / InfiniBand)与张量并行见 GPU 与多卡基础;CV 模型部署的对比见 CV 模型部署;Transformer 架构细节见 Transformer 架构。