
姿态估计
姿态估计(Pose Estimation)是定位图像或视频中人体关键点(关节、眼睛、耳朵等)位置的任务。它是动作识别、运动分析、AR 交互的基础技术。从 2016 年的 OpenPose 到今天的 MediaPipe 实时方案,姿态估计已从学术研究走向手机端实时运行。前置阅读:CNN 卷积网络、目标检测 YOLO。
把姿态估计想象成画火柴人:
- 2D 姿态估计 = 在照片上画火柴人——标出每个关节的二维坐标 (x, y),连成骨架。关节越准,火柴人越像真人。
- 3D 姿态估计 = 雕塑家捏泥人——不仅知道关节在画面上的位置,还知道离镜头多远 (x, y, z),还原出三维人体。
- 多人姿态估计 = 在拥挤的操场上给每个人画火柴人——先区分谁是谁,再分别画骨架。
关键点之间不是孤立的:知道肩膀和肘部的位置,手腕的位置大概率在延长线上——这种骨骼先验(Skeleton Prior)是姿态估计的核心线索。人体骨骼遵循运动学约束:骨骼长度恒定、关节角度有物理极限、相邻关键点的相对位置遵循人体拓扑结构。
2D 姿态估计的两大路线
Section titled “2D 姿态估计的两大路线”**热力图回归(Heatmap Regression)**是主流方法。对每个关键点,网络输出一张与原图分辨率相近(或下采样 1/4、1/2)的热力图,每个像素值表示”该关键点落在这里的概率”。最终关键点坐标取热力图峰值:
热力图回归流程:  输入图像 → CNN Backbone → 特征图 → 逐关键点 1×1 卷积 → K 张热力图
  关键点 k 的坐标:    (x_k, y_k) = argmax_{(x,y)} Heatmap_k(x, y)
  热力图目标 (Ground Truth) 生成:    以真实关键点 (x_k, y_k) 为中心,生成 2D 高斯分布:    GT(x, y) = exp(-((x - x_k)² + (y - y_k)²) / (2σ²))    σ 通常取 2-3 像素——越远离真实点,目标值越接近 0
  训练损失:    L = MSE(predicted_heatmap, GT_heatmap)    或 L = KL 散度 (predicted || GT)
优点是对遮挡和复杂姿态鲁棒(一个点模糊时热力图会弥散,取峰值仍可定位),缺点是需要输出多通道特征图,计算量大。
**直接坐标回归(Direct Regression)**直接让网络输出每个关键点的 (x, y) 坐标值。更简单更快,但精度通常不如热力图,且对遮挡不够鲁棒。MediaPipe 用的是这种路线——为了极致的速度。
两种路线的本质区别:热力图是空间分布建模(输出的是空间上的概率场),坐标回归是点估计(直接回归数值)。空间分布天然携带不确定性信息——热力图的双峰意味着”可能在这里也可能在那里”,而坐标回归只能输出一个确定值。
热力图后处理:Dark 解码
Section titled “热力图后处理:Dark 解码”直接用 argmax 取热力图峰值存在亚像素精度问题——输出的坐标只能在像素网格点上,精度被限制在 1 像素以内。Dark(Distribution-Aware Coordinate Representation)解码利用热力图峰值周围的分布做亚像素精细化:
Dark 解码原理:  设热力图峰值位置为 m,其相邻像素为 m-1 和 m+1
  修正后的坐标:    x_refined = m + 0.5 * (H(m-1) - H(m+1)) / (H(m-1) - 2*H(m) + H(m+1))
直觉: 峰值左边比右边"高"说明真实峰在 m 偏左 → 用二阶差分修正 效果: 在 COCO 基准上可提升 1-2 AP,几乎是免费的精度提升| 方法 | 核心创新 | 特点 |
|---|---|---|
| OpenPose | Part Affinity Field (PAF):学习关节之间的方向场来关联关键点到同一个人 | 多人姿态估计里程碑 |
| HRNet | 保持高分辨率特征不降采样,多分辨率并行融合 | 精度最高,2D 姿态 SOTA |
| MediaPipe | 轻量 CNN + 直接坐标回归,端到端实时 | 手机端 30fps,Google 出品 |
| HigherHRNet | 自底向上,高分辨率热力图 | 多人场景精度高 |
| Poseformer | Transformer 对时空序列建模 | 视频姿态估计 |
| DEKR | 逐关键点回归(Dense Regression),自底向上 | 多人 3D 姿态 |
| RTMPose | RTMDet 检测器 + 高效姿态网络 | 2023 年实时高精度方案 |
OpenPose 的 PAF(部件亲和场)
Section titled “OpenPose 的 PAF(部件亲和场)”OpenPose 是多人姿态估计的开创者。它的核心思想是 PAE/PAF(Part Affinity Field,部件亲和场):
-
检测所有关键点:用 CNN(VGG backbone)预测每个关节类型的热力图,得到全图所有关键点候选。
-
学习骨骼方向场:对每条骨骼(如肘→腕),训练一个 2D 向量场,表示该骨骼的方向和位置。
PAF 的数学定义:对骨骼 (j1 → j2),在骨骼覆盖的每个像素 p 上:L_c(p) = v (v 是从 j1 指向 j2 的单位向量)不在骨骼上的像素:L_c(p) = 0匹配分数:对候选关键点对 (d_j1, d_j2),沿连线积分:E = ∫_0^1 L_c(p(s)) · (d_j2 - d_j1) / ||d_j2 - d_j1|| dsp(s) = (1-s)·d_j1 + s·d_j2 是连线上的点E 越大 → 方向场与连线方向越一致 → 越可能属于同一个人 -
二分图匹配:用 PAF 方向场的一致性,把属于同一个人的关键点匹配成骨架——解决”哪个肘连哪个腕”的归属问题。对每种骨骼类型(如左肘→左腕)独立做二分图最大权匹配(Hungarian 算法)。
HRNet(高分辨率网络)
Section titled “HRNet(高分辨率网络)”传统 CNN(如 ResNet)不断降采样(224→112→56→28→14→7)再恢复,高分辨率信息在降采样过程中被丢失。对于姿态估计这种需要精确空间定位的任务,这是致命的。HRNet 的创新是并行多分辨率:
HRNet 架构:
  Stage 1: 单条高分辨率分支(1/4 分辨率)    │  Stage 2: 新增 1/8 分辨率分支(两条并行)    │ ←── 跨分辨率融合:多尺度→高分辨率,高分辨率→多尺度    │  Stage 3: 新增 1/16 分辨率分支(三条并行)    │ ←── 跨分辨率融合    │  Stage 4: 新增 1/32 分辨率分支(四条并行)    │ ←── 跨分辨率融合    │  输出: 从最高分辨率分支输出热力图
  跨分辨率融合方式:    低→高: 上采样(双线性插值)+ 1×1 卷积(调整通道数)    高→低: 3×3 卷积(stride=2 降采样)+ 通道调整    四条分支的特征图加在一起 → 每条分支都得到全尺度信息
HRNet 始终保持一条全分辨率分支,低分辨率分支提供语义信息,高分辨率分支保留空间细节——最终输出的热力图质量远超 ResNet 主干。HRNet 之后也成为语义分割、人脸对齐等密集预测任务的通用主干。
HRNet 的训练细节
Section titled “HRNet 的训练细节”训练配置 (HRNet-W32, COCO Keypoint): - Backbone: HRNet-W32(32 表示高分辨率分支的通道数) - 输入分辨率: 256 × 192(常见配置) - 数据增强: • 随机旋转 (±30°) • 随机缩放 (0.75 ~ 1.25) • 随机水平翻转 (注意左右关键点要交换!) • 随机颜色抖动 (亮度、对比度、饱和度) • 随机遮挡增强 (Random Erasing / Cutout) - 损失函数: OKS-based Loss OKS (Object Keypoint Similarity) 是姿态估计的标准评估指标: OKS = Σ exp(-d_i² / (2·s²·k_i²)) / Σ δ(v_i > 0) 其中 d_i 是预测关键点与真实点的欧氏距离,s 是目标尺度, k_i 是每个关键点类型的容忍常数(眼、鼻比肩、髋更难定位 → k 更小) - 优化器: Adam, lr=1e-3 - 学习率调度: Warmup (500 epoch) + Cosine Annealing - 训练: 210 epochs,batch_size=1283D 姿态估计
Section titled “3D 姿态估计”从 2D 提升到 3D 有两条路:
-
2D→3D 提升(Lifting-based):先用 2D 模型得到关键点坐标,再用一个小网络(MLP 或 Transformer)推断深度。代表方法如 PoseFormer、SimpleBaseline。优点是可以利用海量 2D 标注,缺点是 2D→3D 是病态问题(多个 3D 姿态可以投影到同一 2D)。
PoseFormer 的 3D 提升原理:输入: 连续 T 帧的 2D 关键点序列 (T × 17 × 2)→ 线性嵌入到高维空间 (T × 17 × D)→ Spatio-Temporal Transformer:空间注意力: 关键点之间互相注意(建模骨骼约束)时间注意力: 不同帧之间互相注意(利用时序平滑性)→ 输出: 中心帧的 3D 关键点 (17 × 3) -
直接 3D 回归:直接从图像回归 3D 坐标,需要 3D 标注数据(如 Human3.6M 数据集)。端到端但依赖昂贵的 3D MoCap 标注。
-
SMPL 人体模型:参数化人体模型(Skinned Multi-Person Linear model),用少量参数(姿态参数 72 维 = 24 个关节 × 3 轴旋转 + 体型参数 10 维)控制一个可微分的 3D 人体网格。可以恢复出完整人体表面,而不仅仅是关键点。
SMPL 参数:姿态参数 θ: 72 维 (24 个关节 × 3 轴旋转角度)控制关节弯曲——每个关节用一个轴角(Axis-Angle)表示体型参数 β: 10 维 (PCA 系数)控制高矮胖瘦——前几个主成分解释了大部分体型变化SMPL 前向过程:1. 用 θ 变换 24 个关节的朝向 → 得到 posed skeleton2. 用 posed skeleton 对蒙皮权重做线性混合蒙皮(LBS):v'_i = Σ_j w_j(v_i) · (R_j · (v_i - t_j) + t_j)w_j(v_i) 是顶点 v_i 受关节 j 影响的权重3. 输出: 6890 个顶点的人体网格 (Mesh)
手部姿态估计
Section titled “手部姿态估计”手部有 21 个关键点(每根手指 4 个关节 × 5 指 + 手腕)。手部姿态估计的特殊挑战:
- 手指细小:在普通分辨率图像中,一根手指只有几个像素宽,关键点间距极小。
- 自遮挡严重:不同视角下手指数互相遮挡,从正面看可能只看到掌心和指尖。
- 姿态空间大:手指组合的自由度极高(21 个关键点 × 3 维 = 63 维空间),难以完全覆盖训练。
MediaPipe Hand 和 FrankMocap 是常用方案。手部姿态是手势识别、手语翻译、AR 手部特效的基础。2023 年后,基于 Transformer 的手部姿态估计(如 HandFormer)在手物交互(Hand-Object Interaction)场景中取得显著进展。
将时序上的姿态序列送入时序模型(RNN/LSTM 或 Transformer),可以识别”走路""挥手""坐下”等动作。相比直接用 RGB 视频做动作识别,姿态序列更轻量且对背景不敏感。
基于姿态的动作识别流程: 输入: 视频帧序列 (T 帧) │ ├─ 逐帧姿态估计: 每帧得到 (17 或 25 个关键点 × 2D/3D 坐标) │ → 姿态序列 (T × K × 2) │ ├─ 时序建模: │ ├─ TCN (Temporal Convolutional Network): 时间维卷积 │ ├─ Transformer: 自注意力捕捉长程时序依赖 │ └─ ST-GCN (Spatio-Temporal Graph Convolutional Network): │ 把人体骨骼表示为图(关节=节点,骨骼=边) │ 在图上做时空卷积——天然适合骨骼拓扑 │ └─ 输出: 动作类别 (走路/跑步/跳跃/...)ST-GCN(Spatio-Temporal Graph Convolutional Network,时空图卷积网络)是骨骼动作识别的主流方法。它把人体骨骼定义为一个图(Graph):关节是节点,骨骼连接是边,在时空两个维度上做图卷积——空间维聚合相邻关节信息,时间维聚合相邻帧信息。
COCO 格式 17 个人体关键点:鼻、左眼、右眼、左耳、右耳、左肩、右肩、左肘、右肘、左腕、右腕、左髋、右髋、左膝、右膝、左踝、右踝。
关键点连通关系定义了人体骨骼拓扑:
COCO 骨骼连接 (17 个关键点之间的 19 条边):  面部:    鼻—左眼, 鼻—右眼, 左眼—左耳, 右眼—右耳  上肢左:  左肩—左肘, 左肘—左腕  上肢右:  右肩—右肘, 右肘—右腕  躯干:    左肩—右肩, 左肩—左髋, 右肩—右髋, 左髋—右髋  下肢左:  左髋—左膝, 左膝—左踝  下肢右:  右髋—右膝, 右膝—右踝
这些连接关系构成一个图(Graph),是 ST-GCN 等图卷积网络的输入拓扑
COCO 17 关键点骨架可视化
Section titled “COCO 17 关键点骨架可视化”下面用 matplotlib 绘制 COCO 17 个关键点及其骨骼连接,直观展示人体拓扑结构。不同颜色代表不同身体部位(面部、躯干、四肢),每个关键点标注了索引编号和名称。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as npfrom matplotlib.lines import Line2D
# ── COCO 17 keypoints (name, x, y) — a clean, realistic humanoid pose ──keypoints = {    "nose":            (0.50, 0.88),    "left_eye":        (0.46, 0.92),    "right_eye":       (0.54, 0.92),    "left_ear":        (0.40, 0.89),    "right_ear":       (0.60, 0.89),    "left_shoulder":   (0.34, 0.74),    "right_shoulder":  (0.66, 0.74),    "left_elbow":      (0.22, 0.58),    "right_elbow":     (0.78, 0.58),    "left_wrist":      (0.14, 0.42),    "right_wrist":     (0.86, 0.42),    "left_hip":        (0.40, 0.46),    "right_hip":       (0.60, 0.46),    "left_knee":       (0.37, 0.26),    "right_knee":      (0.63, 0.26),    "left_ankle":      (0.35, 0.06),    "right_ankle":     (0.65, 0.06),}
kp_names = [    "nose", "left_eye", "right_eye", "left_ear", "right_ear",    "left_shoulder", "right_shoulder", "left_elbow", "right_elbow",    "left_wrist", "right_wrist", "left_hip", "right_hip",    "left_knee", "right_knee", "left_ankle", "right_ankle",]
# ── COCO skeleton connections (index pairs) ──edges = [    (0, 1), (0, 2), (1, 3), (2, 4),         # face    (5, 6), (5, 7), (7, 9),                   # left arm    (6, 8), (8, 10),                          # right arm    (5, 11), (6, 12), (11, 12),               # torso    (11, 13), (13, 15),                       # left leg    (12, 14), (14, 16),                       # right leg]
# Color groups for body partsface_color, torso_color = "#E91E63", "#2196F3"left_arm_color, right_arm_color = "#4CAF50", "#FF9800"left_leg_color, right_leg_color = "#9C27B0", "#00BCD4"
edge_colors = {    (0,1): face_color, (0,2): face_color, (1,3): face_color, (2,4): face_color,    (5,6): torso_color, (5,11): torso_color, (6,12): torso_color, (11,12): torso_color,    (5,7): left_arm_color, (7,9): left_arm_color,    (6,8): right_arm_color, (8,10): right_arm_color,    (11,13): left_leg_color, (13,15): left_leg_color,    (12,14): right_leg_color, (14,16): right_leg_color,}kp_colors = [face_color]*5 + [torso_color]*2 + [left_arm_color, right_arm_color,    left_arm_color, right_arm_color, torso_color, torso_color,    left_leg_color, right_leg_color, left_leg_color, right_leg_color]
fig, ax = plt.subplots(figsize=(9, 5.5))ax.set_facecolor("#FAFAFA")
# Draw skeleton edgesfor (i, j) in edges:    x_vals = [keypoints[kp_names[i]][0], keypoints[kp_names[j]][0]]    y_vals = [keypoints[kp_names[i]][1], keypoints[kp_names[j]][1]]    ax.plot(x_vals, y_vals, color=edge_colors[(i, j)], linewidth=4,            solid_capstyle="round", zorder=1, alpha=0.85)
# Draw keypoints as circlesxs = [keypoints[n][0] for n in kp_names]ys = [keypoints[n][1] for n in kp_names]ax.scatter(xs, ys, c=kp_colors, s=180, zorder=2, edgecolors="white", linewidths=1.5)
# Label each keypointlabel_offsets = {    "nose":(0,-0.055),"left_eye":(0,0.035),"right_eye":(0,0.035),    "left_ear":(-0.055,0),"right_ear":(0.055,0),    "left_shoulder":(-0.055,0.025),"right_shoulder":(0.055,0.025),    "left_elbow":(-0.055,0),"right_elbow":(0.055,0),    "left_wrist":(-0.055,0),"right_wrist":(0.055,0),    "left_hip":(-0.055,0),"right_hip":(0.055,0),    "left_knee":(-0.055,0),"right_knee":(0.055,0),    "left_ankle":(-0.055,0),"right_ankle":(0.055,0),}for idx, name in enumerate(kp_names):    x, y = keypoints[name]    dx, dy = label_offsets[name]    ax.annotate(f"{idx}: {name}", (x+dx, y+dy), fontsize=7.5,                ha="center", va="center", fontstyle="italic", color="#333333")
# Legendlegend_elements = [    Line2D([0],[0], marker='o', color='w', markerfacecolor=face_color, markersize=10, label='Face'),    Line2D([0],[0], marker='o', color='w', markerfacecolor=torso_color, markersize=10, label='Torso'),    Line2D([0],[0], marker='o', color='w', markerfacecolor=left_arm_color, markersize=10, label='Left Arm'),    Line2D([0],[0], marker='o', color='w', markerfacecolor=right_arm_color, markersize=10, label='Right Arm'),    Line2D([0],[0], marker='o', color='w', markerfacecolor=left_leg_color, markersize=10, label='Left Leg'),    Line2D([0],[0], marker='o', color='w', markerfacecolor=right_leg_color, markersize=10, label='Right Leg'),]ax.legend(handles=legend_elements, loc='upper left', fontsize=8, framealpha=0.9, ncol=2)
ax.set_xlim(-0.05, 1.05); ax.set_ylim(-0.05, 1.05)ax.invert_yaxis(); ax.set_aspect('equal')ax.set_xlabel("X", fontsize=9); ax.set_ylabel("Y", fontsize=9)ax.set_title("COCO 17-Keypoint Human Skeleton Topology",             fontsize=12, fontweight="bold", pad=12)ax.grid(True, alpha=0.2, linestyle='--')plt.tight_layout()plt.savefig("pose-estimation-keypoints.png", dpi=180, bbox_inches="tight", facecolor="white")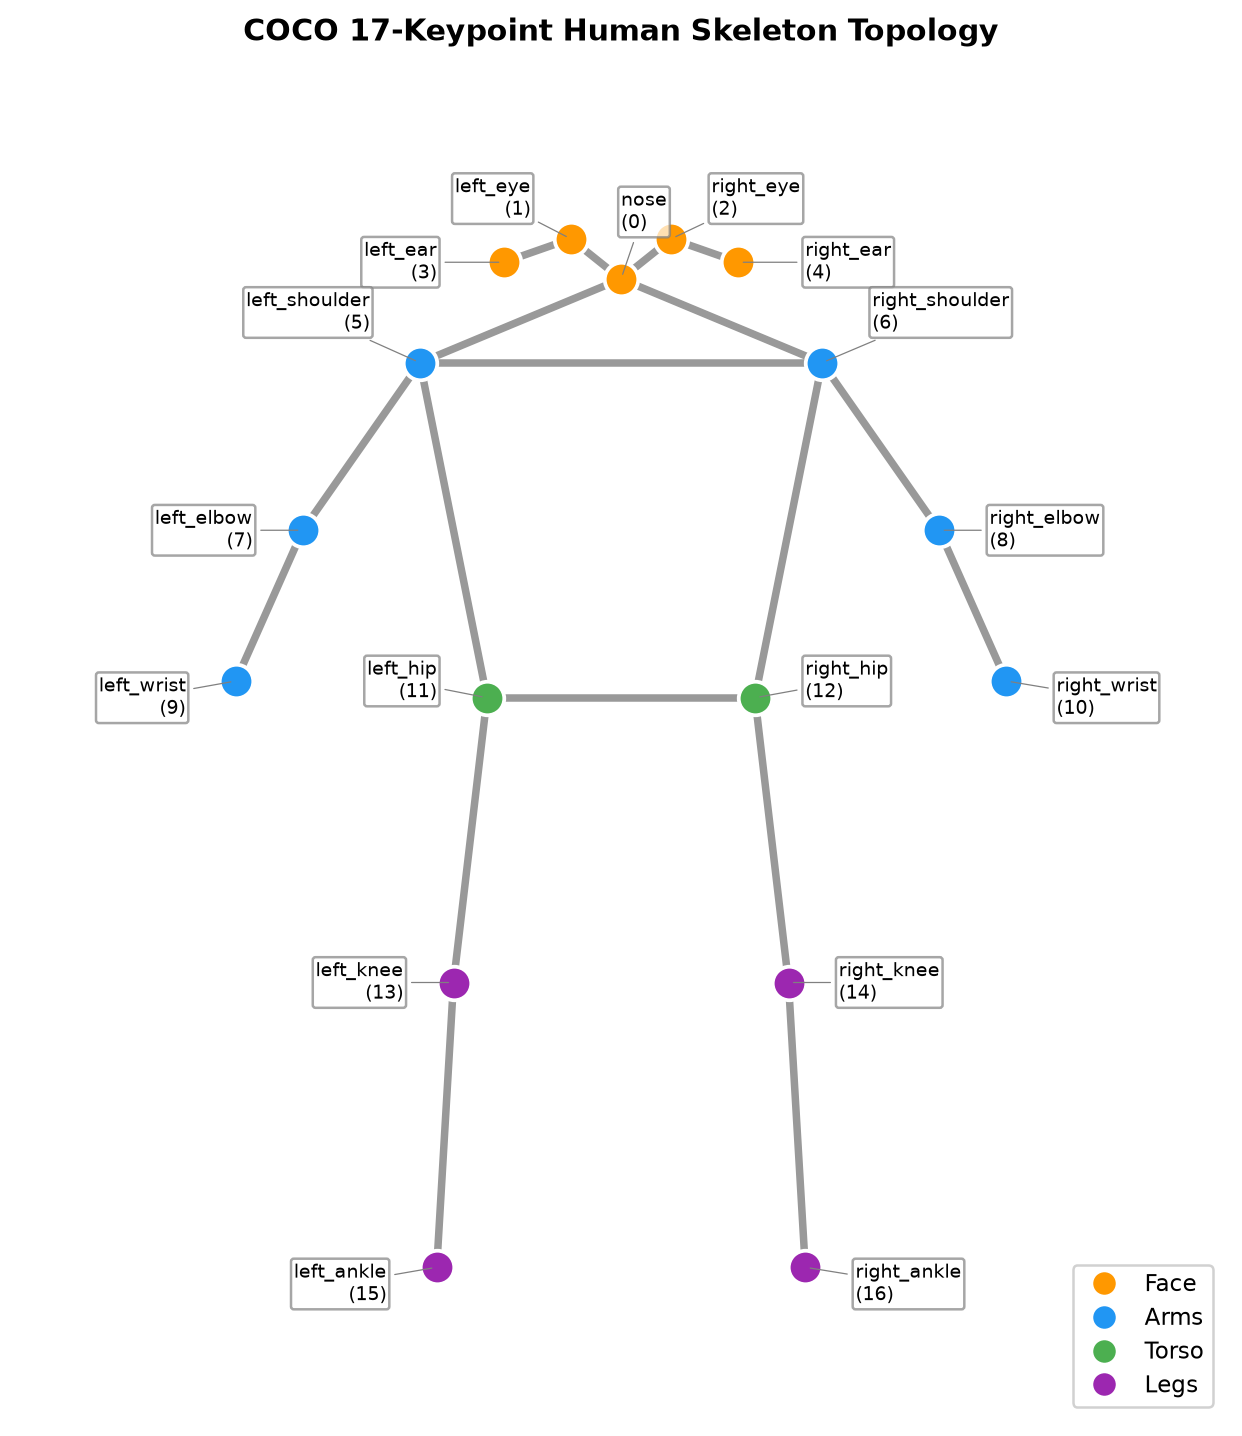
COCO 17 关键点骨架可视化
Section titled “COCO 17 关键点骨架可视化”下图将 COCO 17 个关键点及 19 条骨骼连接以火柴人形式可视化,按身体部位用不同颜色标注,帮助理解人体拓扑结构。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
names = ["nose", "left_eye", "right_eye", "left_ear", "right_ear",         "left_shoulder", "right_shoulder", "left_elbow", "right_elbow",         "left_wrist", "right_wrist", "left_hip", "right_hip",         "left_knee", "right_knee", "left_ankle", "right_ankle"]
kpts = np.array([    [0.0, 0.0], [-0.15, -0.12], [0.15, -0.12], [-0.35, -0.05], [0.35, -0.05],    [-0.6, 0.25], [0.6, 0.25], [-0.95, 0.75], [0.95, 0.75],    [-1.15, 1.2], [1.15, 1.2], [-0.4, 1.25], [0.4, 1.25],    [-0.5, 2.1], [0.5, 2.1], [-0.55, 2.95], [0.55, 2.95],])
skeleton = [(0,1),(0,2),(1,3),(2,4),(5,7),(7,9),(6,8),(8,10),            (5,6),(5,11),(6,12),(11,12),(11,13),(13,15),(12,14),(14,16)]
face = {0,1,2,3,4}; arms = {5,6,7,8,9,10}torso = {11,12}; legs = {13,14,15,16}color_map = {0:"#FF9800", 1:"#2196F3", 2:"#4CAF50", 3:"#9C27B0"}
def part_color(idx):    if idx in face: return "#FF9800"    if idx in arms: return "#2196F3"    if idx in torso: return "#4CAF50"    return "#9C27B0"
fig, ax = plt.subplots(figsize=(7, 9))for i, j in skeleton:    ax.plot([kpts[i,0], kpts[j,0]], [kpts[i,1], kpts[j,1]],            color="#555", linewidth=3, solid_capstyle="round", alpha=0.6)for idx in range(17):    ax.scatter(kpts[idx,0], kpts[idx,1], c=part_color(idx),               s=180, zorder=2, edgecolors="white", linewidths=1.5)    ax.annotate(names[idx], (kpts[idx,0], kpts[idx,1]),                fontsize=7, ha="center",                bbox=dict(boxstyle="round,pad=0.1", facecolor="white",                          edgecolor="gray", alpha=0.7))
ax.set_title("COCO 17-Keypoint Human Skeleton Topology",             fontsize=12, fontweight="bold")ax.set_aspect("equal")ax.set_xlim(-1.8, 1.8)ax.set_ylim(3.4, -0.6)ax.axis("off")plt.tight_layout()plt.savefig("pose-estimation-keypoints.png", dpi=180,            bbox_inches="tight", facecolor="white")
使用 MediaPipe 做姿态估计
Section titled “使用 MediaPipe 做姿态估计”import cv2import mediapipe as mp # pip install mediapipe
mp_pose = mp.solutions.posemp_drawing = mp.solutions.drawing_utils
# BlazePose 配置: 33 个关键点 (比 COCO 17 更丰富,含手部/脚部细节)pose = mp_pose.Pose( static_image_mode=False, # 视频流模式(利用时序平滑) model_complexity=1, # 0=Lite, 1=Full, 2=Heavy enable_segmentation=False, # 是否输出人体分割 min_detection_confidence=0.5, min_tracking_confidence=0.5,)
cap = cv2.VideoCapture("walk.mp4") # 打开视频while cap.isOpened(): ok, frame = cap.read() if not ok: break # MediaPipe 需要 RGB 输入,OpenCV 默认 BGR results = pose.process(cv2.cvtColor(frame, cv2.COLOR_BGR2RGB)) if results.pose_landmarks: # 检测到人体 # 每个关键点: 归一化坐标 (x, y) ∈ [0,1] + 深度 z (相对值) + 可见度 for idx, lm in enumerate(results.pose_landmarks.landmark): print(f"关键点{idx}: ({lm.x:.3f}, {lm.y:.3f}, z={lm.z:.3f}, vis={lm.visibility:.2f})")
# 在画面上绘制骨架 mp_drawing.draw_landmarks( frame, results.pose_landmarks, mp_pose.POSE_CONNECTIONS ) cv2.imshow("Pose", frame) if cv2.waitKey(1) & 0xFF == ord('q'): break使用 mmpose 做单人姿态估计
Section titled “使用 mmpose 做单人姿态估计”from mmpose.apis import init_model, inference_topdown # pip install mmposefrom mmdet.apis import init_detector, inference_detector
det_model = init_detector("yolox_config.py", "yolox.pth", device="cuda:0")pose_model = init_model("hrnet_config.py", "hrnet_w32.pth", device="cuda:0")
bboxes = inference_detector(det_model, "person.jpg") # 先检测人体框results = inference_topdown(pose_model, "person.jpg", bboxes)# results 包含每个检测到的人体 17 个关键点坐标和置信度用 PyTorch 实现热力图回归
Section titled “用 PyTorch 实现热力图回归”import torchimport torch.nn as nnimport torch.nn.functional as F
class HeatmapPoseNet(nn.Module): """简化版热力图回归姿态估计网络。 输入: (B, 3, H, W) 图像 输出: (B, K, H/4, W/4) 热力图, K = 关键点数量 """ def __init__(self, num_keypoints=17, heatmap_stride=4): super().__init__() self.stride = heatmap_stride
# 简化 backbone (实际用 HRNet 或 ResNet) self.backbone = nn.Sequential( # Stage 1: 3→64, stride=2 nn.Conv2d(3, 64, 3, stride=2, padding=1), nn.BatchNorm2d(64), nn.ReLU(), # Stage 2: 64→128, stride=2 nn.Conv2d(64, 128, 3, stride=2, padding=1), nn.BatchNorm2d(128), nn.ReLU(), # Stage 3: 128→256, stride=2 (总 stride=8) nn.Conv2d(128, 256, 3, stride=2, padding=1), nn.BatchNorm2d(256), nn.ReLU(), )
# 热力图预测头: 逐关键点 1×1 卷积 self.heatmap_head = nn.Conv2d(256, num_keypoints, kernel_size=1)
def forward(self, x): feat = self.backbone(x) # (B, 256, H/8, W/8) heatmap = self.heatmap_head(feat) # (B, K, H/8, W/8) return heatmap
@torch.no_grad() def predict_keypoints(self, heatmap): """从热力图提取关键点坐标 (带亚像素 Dark 解码)。""" B, K, H, W = heatmap.shape # argmax 找峰值 heatmap_flat = heatmap.view(B, K, -1) max_idx = heatmap_flat.argmax(dim=-1) # (B, K) max_val = heatmap_flat.max(dim=-1)[0] # (B, K) 置信度
y = (max_idx // W).float() x = (max_idx % W).float()
# Dark 亚像素修正 (简化版) for b in range(B): for k in range(K): px, py = int(x[b, k]), int(y[b, k]) if 0 < px < W-1 and 0 < py < H-1: dx = 0.5 * (heatmap[b,k,py,px-1] - heatmap[b,k,py,px+1]) / \ (heatmap[b,k,py,px-1] - 2*heatmap[b,k,py,px] + heatmap[b,k,py,px+1] + 1e-6) dy = 0.5 * (heatmap[b,k,py-1,px] - heatmap[b,k,py+1,px]) / \ (heatmap[b,k,py-1,px] - 2*heatmap[b,k,py,px] + heatmap[b,k,py+1,px] + 1e-6) x[b, k] += dx.item() y[b, k] += dy.item()
return x * self.stride, y * self.stride, max_val # 缩放回原图坐标生成热力图标注(用于训练)
Section titled “生成热力图标注(用于训练)”def generate_heatmap(keypoints, img_size, sigma=2, stride=4): """从关键点坐标生成高斯热力图标签。 keypoints: (K, 2) 真实关键点坐标(原图尺度) 返回: (K, H/stride, W/stride) 热力图 """ H, W = img_size[0] // stride, img_size[1] // stride K = len(keypoints) heatmap = torch.zeros(K, H, W)
for k in range(K): cx, cy = keypoints[k] # 原图坐标 cx, cy = cx / stride, cy / stride # 缩放到热力图尺度
# 只在以 (cx, cy) 为中心的局部区域生成高斯(避免计算全图) for y in range(max(0, int(cy-3*sigma)), min(H, int(cy+3*sigma))): for x in range(max(0, int(cx-3*sigma)), min(W, int(cx+3*sigma))): d2 = (x - cx)**2 + (y - cy)**2 heatmap[k, y, x] = torch.exp(torch.tensor(-d2 / (2 * sigma**2)))
return heatmap-
自顶向下 vs 自底向上:自顶向下(Top-down,先检测人再逐个估姿态)精度高但速度随人数线性下降;自底向上(Bottom-up,先检测所有关键点再匹配)速度与人数无关但精度略低。OpenPose 是自底向上代表,HRNet+检测器是自顶向下代表。
速度对比 (n = 图中人数):Top-down: O(n) —— 每个人都要单独跑一次姿态网络Bottom-up: O(1) —— 全图跑一次,关键点匹配是后处理选择策略: 少人场景(≤5)用 Top-down 保精度;多人/拥挤场景用 Bottom-up 保速度 -
数据增强:旋转、缩放、水平翻转是标配。对于手部姿态,还需要做遮挡增强(随机遮挡部分手指)来提升鲁棒性。水平翻转时注意左右对称的关键点要交换(左肩↔右肩,左肘↔右肘……),否则标签就错了。
-
热力图后处理:直接取 argmax 会有亚像素精度损失。用 Dark 解码(根据峰值周围像素的分布做二次拟合)可以提升精度。
-
实时性优化:MediaPipe BlazePose 专为手机设计,GPU 上可达 30+ fps。如果用 HRNet,需要做模型剪枝或蒸馏来加速。2023 年的 RTMPose 通过知识蒸馏 + 模型量化,在保持高精度的同时实现了手机端实时。
-
3D 精度挑战:单目 3D 姿态存在深度歧义(前后难以区分)。多视角相机可以消除歧义但部署成本高。
-
训练分辨率与推理分辨率要一致:热力图回归对输入分辨率敏感。训练时用 256×192,推理时也应用同尺寸输入(或等比缩放后做坐标逆变换),否则精度会下降。
- 健身与运动指导:Keep、Nike Training Club 用姿态估计实时纠正深蹲、俯卧撑的动作角度——你的手机就是私人教练。
- 动作捕捉(MoCap):影视和游戏制作中替代昂贵的光学动捕设备,用普通摄像头就能采集人体动作数据。
- 安防行为分析:检测跌倒、打架、异常徘徊等行为——养老院跌倒报警、公共场所安保监控。
- 虚拟主播(VTuber):实时追踪面部和身体动作,驱动虚拟形象——B站、YouTube 虚拟主播的技术基础。
- AR 滤镜与特效:Snapchat、抖音的全身特效(虚拟衣服、骨骼变形)依赖实时姿态估计。
- 手语翻译:识别手部姿态序列,翻译成文字或语音——听障人士的沟通工具。
2025-2026 最新进展
Section titled “2025-2026 最新进展”大模型驱动的姿态估计
Section titled “大模型驱动的姿态估计”2024-2025 年,姿态估计开始与视觉大模型融合:
- SAM-Pose:利用 Segment Anything Model(SAM)的强大分割能力辅助姿态估计——SAM 提供精确的人体轮廓,姿态网络在轮廓内做精确关键点回归,显著提升遮挡场景的表现。
- FoundationPose / UMAP:在大规模无标注视频上自监督预训练的通用人体姿态基础模型,可以 Zero-shot 迁移到新场景(如运动分析、医疗康复),不再需要为每个新场景重新标注数据。
- DWPose / SapiensPose:全身姿态估计(Whole-Body Pose),将身体、手部(21 点×2)、面部(68+ 点)统一到一个模型中输出,总计 133+ 个关键点。Meta 的 Sapiens(2024)展示了在 3 亿张人体图像上预训练的全能人体理解模型。
单目 3D 人体网格恢复的突破
Section titled “单目 3D 人体网格恢复的突破”传统的 3D 人体网格恢复(HMR)依赖 3D 标注数据且精度有限。2024-2025 年的新趋势:
- 4DHumans / HMR 2.0:Google 的 4DHumans 从单目视频恢复 4D(时空连贯)人体网格,利用 ViT backbone + 时序优化,在野外视频上实现了接近 MoCap 精度的结果。
- SMPLer-X / PIXIE:将身体姿态、手部姿态、面部表情统一回归的全身 3D 人体恢复方案——从单张图像恢复完整的人体网格 + 表情 + 手势。
- *-neural- / 生成式人体先验:用生成模型学习人体姿态的先验分布,用于约束 3D 重建的合理性,有效解决遮挡和截断场景。
视频姿态估计的时空优化
Section titled “视频姿态估计的时空优化”从单帧姿态估计走向视频时序优化:
- BiPPose / PoseFormer V2:利用双向 Transformer 对视频序列建模,前后帧信息互相补充——遮挡帧可以从前后帧”借”信息,大幅降低遮挡导致的误差。
- VIBE / MEVA / TCMR:从视频中重建 3D 人体运动序列的代表性方法,结合对抗训练(GAN)和时序平滑约束。
- 运动质量评估(Motion Quality Assessment):2025 年新方向——不仅估计姿态,还评估动作质量(如康复训练动作是否标准、运动技术是否规范),用大模型做细粒度动作理解。
动作识别的视觉-语言融合
Section titled “动作识别的视觉-语言融合”受 CLIP 等多模态模型启发,2025 年的动作识别走向开放词汇(Open-Vocabulary):
- Open-vocabulary Action Recognition:不再局限于预定义的几百个动作类别,而是用自然语言描述要识别的动作(如”正在用右手拿杯子喝水”),模型输出匹配分数。
- Video-LLM 理解动作:结合视频大模型(如 VideoLLaMA、GPT-4o),可以直接用自然语言问答的方式分析视频中的动作——“这个人做了几次深蹲?""他的左膝角度够不够深?”
端侧部署的极致优化
Section titled “端侧部署的极致优化”姿态估计是端侧 AI(手机/IoT)最重要的应用之一:
- RTMPose / RTMO(2023-2024):RealTime Multiple Object Pose,通过蒸馏 + 量化 + 高效架构设计,在手机 NPU 上实现 100+ fps 的多人姿态估计。是当前端侧部署的最优方案。
- Yolo-Pose / YOLOv8-Pose:将姿态估计与目标检测统一到 YOLO 架构中,一次前向传播同时输出人体框和关键点,极简部署。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| MediaPipe | Python/C++ | Google 出品,跨平台实时姿态估计,手机端友好 |
| MMPose | Python | 商汤开源的姿态估计工具箱,算法齐全,学术首选 |
| OpenPose | C++/Python | CMU 开发的多人姿态估计经典框架,PAF 方法原版实现 |
| AlphaPose | Python | 上交开源的多人姿态估计,自顶向下方案 |
| mmpose + mmdetection | Python | 组合使用,先检测人体再做姿态估计 |
| trt-pose | Python/TensorRT | NVIDIA 优化的实时姿态估计,部署在 Jetson 边缘设备 |
| RTMPose | Python | OpenMMLab 的实时高精度方案,支持端侧部署 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 姿态估计 | Pose Estimation | 定位人体关键点(关节)位置的任务 |
| 关键点 | Keypoint / Landmark | 人体上的标注点,如肩膀、肘、膝等关节 |
| 热力图回归 | Heatmap Regression | 为每个关键点输出一张概率热力图,取峰值定位 |
| 直接回归 | Direct Regression | 直接让网络输出关键点的 (x, y) 坐标值 |
| 部件亲和场 | Part Affinity Field (PAF) | OpenPose 提出的骨骼方向场,用于关联关键点到同一个人 |
| HRNet | High-Resolution Network | 并行多分辨率融合网络,2D 姿态估计精度最高 |
| SMPL | Skinned Multi-Person Linear | 参数化人体网格模型,用少量参数控制 3D 人体 |
| OKS | Object Keypoint Similarity | 姿态估计标准评估指标,类似目标检测中的 IoU |
| 自顶向下 | Top-down | 先检测每个人再做单人姿态估计的策略 |
| 自底向上 | Bottom-up | 先检测所有关键点再匹配到个人的策略 |
| 动作识别 | Action Recognition | 从时序姿态或视频序列中识别动作类别 |
| ST-GCN | Spatio-Temporal Graph Convolutional Network | 时空图卷积网络,在骨骼图上做动作识别 |
| COCO 关键点格式 | COCO Keypoint Format | 定义 17 个人体关键点的标准标注规范 |
| 人体网格恢复 | Human Mesh Recovery (HMR) | 从图像/视频恢复 3D 人体网格(含 SMPL 参数) |
- Cao et al.,「OpenPose: Realtime Multi-Person 2D Pose Estimation using Part Affinity Fields」(TPAMI 2019):OpenPose 论文,多人姿态估计的奠基工作,PAF 方法详解。
- Sun et al.,「Deep High-Resolution Representation Learning for Human Pose Estimation」(CVPR 2019):HRNet 论文,提出并行高分辨率网络,2D 姿态估计精度革命性提升。
- Loper et al.,「SMPL: A Skinned Multi-Person Linear Model」(SIGGRAPH Asia 2015):SMPL 人体参数模型论文,3D 人体重建的基础。
- Bazarevsky et al.,「BlazePose: On-device Real-time Body Pose Tracking」(arXiv 2020):Google MediaPipe 姿态方案,手机端实时运行。
- Zheng et al.,「PoseFormer: Spatial-Temporal Transformer for 3D Human Pose Estimation」(ICCV 2021):Transformer 做 3D 姿态时序提升。
- Goel et al.,「Humans in 4D: Reconstructing and Tracking Humans with Transformers」(ICCV 2023):4DHumans,单目视频 4D 人体重建的突破。
- MMPose GitHub:
https://github.com/open-mmlab/mmpose——最全面的姿态估计工具箱,含 30+ 算法实现。