
检索方法对比
检索是 RAG 检索增强生成的入口——用什么方法从知识库里找到相关内容,直接决定了最终答案的质量。本页对比稀疏检索(BM25/TF-IDF)、稠密检索(向量语义)与混合检索三大流派,并梳理 HyDE、Multi-Query Retriever、Parent-Child 分块、上下文压缩等进阶检索策略。前置阅读:嵌入模型、向量数据库,后处理环节见重排序。
把检索想象成在图书馆找书,三种方法的区别就像三种截然不同的找书策略:
- 稀疏检索(BM25/TF-IDF)= 查卡片目录。 你拿着关键词去翻索引卡片,找到标题和摘要里精确包含这些词的书。你不懂书的含义,只认字——“手机”和”移动电话”对你来说完全无关,因为卡片上写的是”手机”。
- 稠密检索(向量)= 问一个博览全书的图书管理员。 你说”我想了解移动通信设备”,管理员虽然没在书名里看到”手机”这个词,但他知道这本书讲的就是你要的东西——他理解语义。
- 混合检索 = 两个人同时帮你找,一个查卡片,一个凭理解推荐,最后合并两人的结果。 既不漏掉精确匹配,也不错过语义相关。
进阶策略的直觉:
- HyDE(假设文档嵌入)= 先自己写一篇假答案,再拿假答案去找真资料。 假答案虽然事实可能有误,但用词和领域往往贴近真资料,所以检索更准。
- Multi-Query Retriever = 换几种说法重新问一遍。 同一个问题从三个角度各检索一次,结果合并去重,减少单次查询的盲区。
- Parent-Child 分块 = 用小片段精准定位,返回时带上上下文。 就像用页码(小)精确找到相关段落,返回时把整章(大)都给你,让你有完整背景。
- 上下文压缩检索 = 找到资料后再做一次”划重点”。 一份 20 页的文档里只有 2 段相关,就只返回那 2 段,省 token、降噪声。
2024-2025 年还涌现了 Graph RAG(知识图谱增强检索)、Corrective RAG(纠错式检索)、Self-RAG(自适应检索)等新范式——它们让检索从”被动匹配”走向”主动决策”。这些将在本页后半部分讲解。
稀疏检索:TF-IDF 与 BM25
Section titled “稀疏检索:TF-IDF 与 BM25”稀疏检索的核心思想是关键词匹配——文档和查询都表示为词袋(Bag of Words,即忽略词序、只统计词频的文本表示方法),通过统计词频来打分。它”稀疏”是因为向量维度等于词表大小(可能几万到几十万),但每个文档只激活其中极少几个维度(绝大多数为 0)。
TF-IDF(词频-逆文档频率) 是最经典的方法,核心思想:一个词在当前文档出现越多、在全语料出现越少,就越重要。
- TF(词频)= 该词在文档中出现的次数 / 文档总词数
- IDF(逆文档频率)= log(语料总文档数 / 包含该词的文档数 + 1)
- TF-IDF = TF IDF
直觉:像”的”、“是”这种到处都有的词,IDF 很低(接近 0),被自动降权;而”苯丙酮尿症”这种罕见词,IDF 很高,一旦匹配权重极大。
BM25 是 TF-IDF 的升级版,也是当今工业界(Elasticsearch、Lucene(Apache 的全文检索引擎库,Elasticsearch 和 Solr 的底层核心)的默认排序算法)最常用的稀疏检索方法。它引入了两个关键改进——饱和函数和文档长度归一化。BM25 打分公式(纯文本表示):
其中:
- 是词 在文档 中的出现频率
- 是文档 的长度(词数), 是语料平均文档长度
- 和 是可调超参数,典型值 、
- ,其中 是总文档数, 是包含词 的文档数
两个改进的直觉:
- 饱和():词频的收益递减。一个词出现 3 次确实比 1 次重要,但出现 30 次不比 3 次重要十倍——TF-IDF 是线性增长,BM25 用饱和函数让它趋于上限。你可以把 理解为”词频增益的天花板”—— 越大,高词频的增益空间越大; 则退化为不考虑词频(只看是否出现)。
- 长度归一化():长文档天然更容易匹配到关键词(篇幅大碰到的词多),但未必更相关。BM25 用 参数惩罚过长的文档,让长短文档有公平竞争的机会。 完全按长度归一化, 不做归一化——0.75 是经验上的最佳平衡。
BM25 的底层实现——倒排索引(Inverted Index):
BM25 之所以能在毫秒级完成检索,依赖的是倒排索引数据结构。正排索引是”文档 → 包含哪些词”,倒排索引反过来——“词 → 出现在哪些文档中”。查询时,只需取查询词对应的倒排链做交集和打分,无需扫描全部文档。这和字典的索引页(“某词在第几页”)是同一个思想。Elasticsearch、Lucene 都是基于倒排索引构建的。
稀疏检索的优点:
- 精确匹配强:查询”iPhone 15 Pro”时能精确命中这个型号名,不会返回”苹果手机”的泛泛内容。
- 可解释:打分基于明确的词项匹配,可以直接看到”哪个词贡献了多少分”,便于调试。
- 无需训练:不依赖任何模型,纯统计方法,部署零成本。
- 高效率:倒排索引 + BM25 在几十亿级文档上仍能毫秒级返回结果。
稀疏检索的缺点:
- 不理解语义:同义词、近义词、不同表述完全无法关联。“汽车”的查询匹配不到只写了”轿车”的文档。
- 词形变化盲区:中文尚好,但英文中 “run” 和 “running” 若不做词干提取(Stemming,将词还原为词根形式的操作,如 “running” → “run”)会被当作不同词。
- 对拼写错误敏感:query 中的任何拼写错误都会导致关键词不匹配,除非使用模糊匹配(Fuzzy Matching)。
2024-2025 进展——学习型稀疏检索(Learned Sparse Retrieval):
SPLADE(Sparse Lexical and Expansion模型)等学习型稀疏检索方法结合了稀疏检索的可解释性和稠密检索的语义理解能力。它们通过训练(通常基于 BERT 等预训练模型),让模型自动对查询和文档进行”语义扩展”——例如查询”汽车”时自动在稀疏向量中激活”轿车""车辆""SUV”等同义维度,但仍然保持稀疏表示和倒排索引的高效检索。SPLADE 在 BEIR 等检索基准上的表现接近甚至超过稠密检索,同时保留了 BM25 的可解释性和高效率。
稠密检索:向量嵌入与余弦相似度
Section titled “稠密检索:向量嵌入与余弦相似度”稠密检索的思路完全不同:先用嵌入模型把每段文本编码成一个固定维度的稠密向量(如 768 维或 1536 维,每维都有非零值,故称”稠密”),再用向量间的距离来衡量语义相似度。查询时,先把查询文本同样编码成向量,然后在向量数据库中找最近的邻居。
余弦相似度 是最常用的度量方式:
即两个向量的点积除以各自模长的乘积。值域为 -1 到 1,越接近 1 表示越相似。实际中嵌入向量通常已归一化(模长为 1),此时余弦相似度就等于点积。
点积相似度(向量归一化后):
即对每一维 求和。
其他常见度量还有欧氏距离(L2) 和内积(Inner Product)。三种度量在向量归一化后其实是等价的,实践中差别不大。
稠密检索的底层实现——近似最近邻搜索(ANN):
稠密检索要在百万级向量中快速找到最相似的 Top-K,暴力逐一比较(brute-force)需要 次计算,在百万规模上需要数秒。实际系统使用近似最近邻搜索(Approximate Nearest Neighbor,ANN)算法,在精度损失极小(通常 < 1% 召回率下降)的前提下将检索时间降至毫秒级。主流算法包括:
- HNSW(Hierarchical Navigable Small World):构建多层导航图,从顶层粗粒度快速定位、逐层细化。当前最主流的 ANN 算法,被 Faiss、Milvus、Qdrant 等广泛采用。
- IVF(Inverted File Index):先用 K-means 聚类将向量空间分为 nlist 个簇,查询时只搜索最近的 nprobe 个簇——类似”先定位到书架,再在书架上翻书”。
- PQ(Product Quantization):将高维向量切分为若干子向量,每段做独立量化压缩(如 768 维 → 96 字节),大幅降低内存占用。适合十亿级超大规模场景。
Bi-Encoder(双塔编码器)训练原理:
稠密检索的核心模型是 Bi-Encoder——query 和文档各自独立编码。训练时采用对比学习(Contrastive Learning)目标:让正样本对(相关 query-文档对)的向量距离拉近,负样本对(不相关 query-文档对)的距离推远。最常用的损失函数是 InfoNCE:
其中 是正样本, 包含正样本和若干负样本, 是温度参数。训练一个好嵌入模型的关键是高质量的正负样本和困难负样本挖掘(Hard Negative Mining,刻意找与 query 语义相近但实际不相关的文档作为难负样本,迫使模型学到更精细的区分能力)。
稠密检索的优点:
- 语义理解:“手机”的查询能匹配到讲”移动通信终端”的文档——嵌入模型在训练时学到了这两个概念在语义上相近。
- 泛化能力强:对同义改写、口语化表达、跨语言查询都有一定鲁棒性。
- 维度紧凑:768 维向量远比几万维的词袋更高效,适合大规模检索。
稠密检索的缺点:
- 可能漏掉精确匹配:查询一个专有名词”GPT-4o”,向量检索可能返回语义相近的”GPT-4”或”大语言模型”文档,但漏掉了精确包含”GPT-4o”的那篇。
- 依赖嵌入模型质量:嵌入模型没见过的领域术语、新词、产品编号,向量表示可能不准。
- 不可解释:两个向量为什么相似是一个黑盒,难以调试。
- 领域偏移问题:在通用语料上训练的嵌入模型用于法律、医疗等专业领域时,效果可能显著下降——需要领域微调(Domain Fine-tuning)。
混合检索:稀疏 + 稠密融合
Section titled “混合检索:稀疏 + 稠密融合”混合检索(Hybrid Retrieval)结合两种方法的长处:同时跑一遍稀疏检索和一遍稠密检索,然后把两份排名列表融合。难点在于两套分数的量纲不同——BM25 分数可能是几十,余弦相似度在 0 到 1 之间,直接加权平均毫无意义。两种主流融合策略:
策略一:加权分数融合(需要归一化)。 先把两种分数各自归一化到同一区间(如 min-max 归一化到 0 到 1),再加权求和:
其中 是稀疏权重,典型值 0.3 到 0.7,根据场景调优。
策略二:RRF(Reciprocal Rank Fusion,倒数排名融合)。 不用分数,只用排名——对每个文档,看它在两种检索结果中分别排第几名,取倒数加权求和。公式:
其中 是文档 在第 个检索系统结果中的排名(第 1 名 rank=1), 是平滑常数(典型值 60,来自 Google 原始论文)。直觉:一个文档在两种检索中都排靠前,RRF 分数就高;只在一种中靠前,贡献被稀释。
RRF 的优点是无需调参( 基本通用)、无需分数归一化、对异构检索系统非常鲁棒,因此成为当今混合检索的事实标准。
为什么混合检索优于单一方法——互补性分析:
BM25 和稠密检索擅长处理的查询类型恰好互补:
| 查询类型 | BM25 | 稠密检索 | 说明 |
|---|---|---|---|
| 精确名称/编号(“GPT-4o”、“ISO 27001”) | ✅ 强 | ❌ 可能漏 | BM25 精确匹配,稠密可能泛化到相似概念 |
| 同义改写(“手机”→“移动通信终端”) | ❌ 弱 | ✅ 强 | BM25 不理解语义,稠密能跨表述匹配 |
| 长尾术语(“苯丙酮尿症”) | ✅ 强 | ⚠️ 不稳定 | BM25 只要有这个词就能匹配;稠密取决于模型是否见过 |
| 概念性查询(“如何优化模型性能”) | ⚠️ 一般 | ✅ 强 | BM25 靠关键词碰运气,稠密理解语义意图 |
| 拼写错误 | ❌ 弱 | ✅ 较强 | BM25 无法容忍拼写变化,稠密的语义空间有一定容错 |
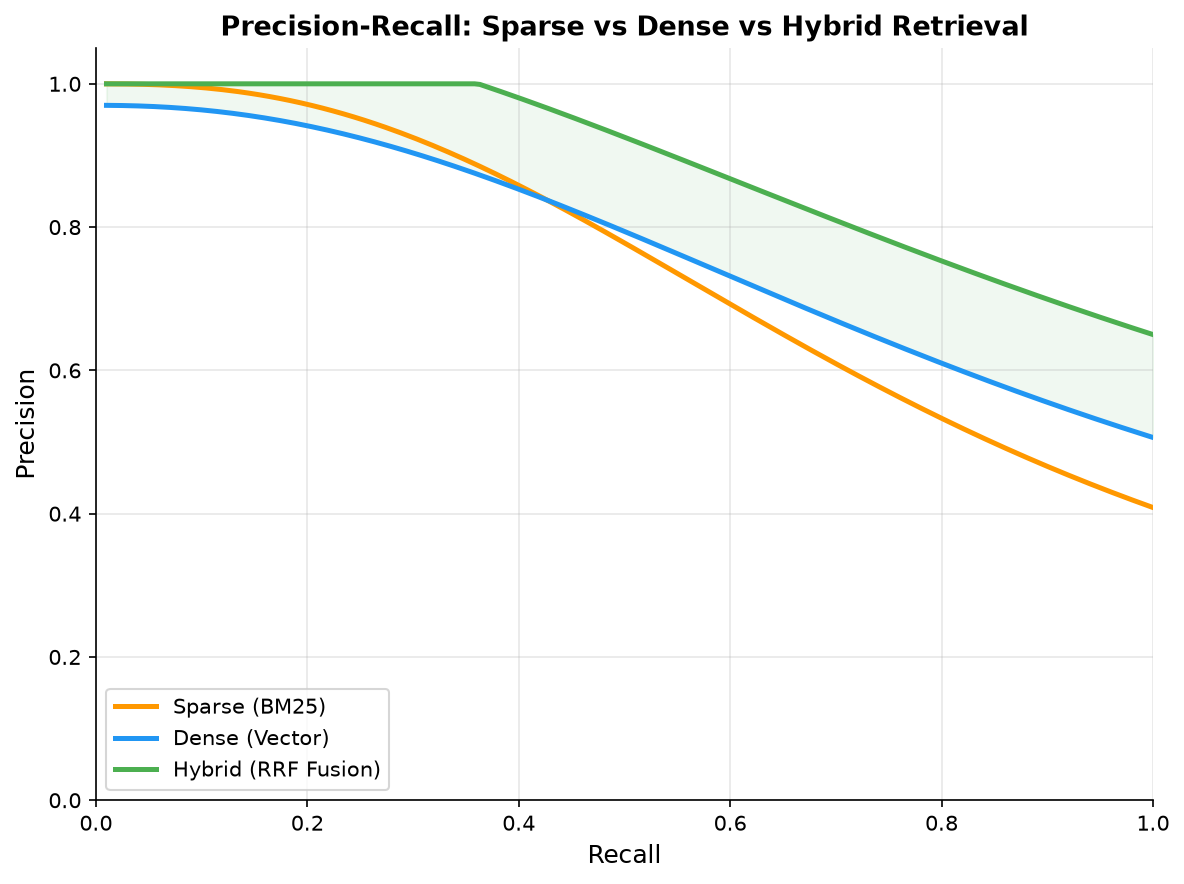
混合检索覆盖了两者的优势区域,这也是为什么几乎所有生产级 RAG 系统都采用混合检索作为默认方案。
HyDE:假设文档嵌入
Section titled “HyDE:假设文档嵌入”HyDE(Hypothetical Document Embeddings)解决一个痛点:用户的查询往往又短又口语化(“怎么解决 NaN loss?”),这种短句的嵌入向量信号弱,稠密检索效果差。HyDE 的思路是先让 LLM 生成一个假设性的答案文档,再拿这个答案文档去检索。
步骤:
- 用户查询 → 送入 LLM,Prompt 大意:“请针对以下问题生成一段假设性的答案文档。”
- LLM 输出一段假设答案(如 100 到 200 字的假设性解答,事实可能不准,但用词和领域贴近真实文档)。
- 用嵌入模型对这段假设答案编码成向量。
- 拿这个向量去稠密检索——因为答案文档的表述比原始查询更接近知识库里文档的表述,检索更精准。
- 用检索到的真实文档喂给 LLM 生成最终答案。
直觉:原始查询是”问题表述”,知识库文档是”答案表述”,两者表述差距大导致检索困难。HyDE 用 LLM 把查询临时翻译成答案表述,缩小了检索的表述鸿沟。代价是多一次 LLM 调用,延迟增加。
HyDE 的适用与不适用场景:
- ✅ 事实性问答:查询”什么是 Docker?“——LLM 生成的假设答案会包含”容器""虚拟化""镜像”等领域术语,比原始短查询更容易匹配到技术文档。
- ✅ 短查询 + 大文档库:查询越短、文档越长,HyDE 的收益越大——因为长文档的嵌入更”丰富”,短查询的嵌入太”稀薄”。
- ❌ 最新信息查询:查询”2025 年最新的 AI 模型有哪些?“——LLM 的假设答案可能基于过时知识(训练数据截止),生成的假答案可能误导检索方向。
- ❌ 延迟敏感场景:每次检索额外调一次 LLM(500ms-2s),不适合实时对话。
Multi-Query Retriever:多查询改写
Section titled “Multi-Query Retriever:多查询改写”Multi-Query Retriever 的思路与 HyDE 互补:与其改写成”答案”,不如改写成多个角度的”问题”。步骤:
- 用户查询 → 送入 LLM,Prompt:“请从不同角度改写以下问题,生成 3 到 5 个不同表述。”
- LLM 输出多个改写版本(如原问题”怎么调学习率”,改写为”如何设置 learning rate”、“学习率超参数最佳实践”、“训练时 lr 怎么选”)。
- 对每个改写版本分别做一次检索(稀疏或稠密均可)。
- 合并所有检索结果,按文档去重(同一文档出现多次代表多个角度都命中,可信度更高)。
- 去重后的结果作为最终检索输出。
优点:覆盖面广,单一查询的表述盲区被其他改写版本补上。代价是多倍检索开销 + 一次 LLM 改写调用。LangChain 的 MultiQueryRetriever 是这一策略的典型实现。
HyDE vs Multi-Query 的对比:
| 特性 | HyDE | Multi-Query |
|---|---|---|
| 改写方向 | 改成”答案”(答案表述) | 改成多个”问题”(不同角度) |
| 适合场景 | 查询短、知识库文档长 | 查询有歧义、单一表述可能遗漏 |
| LLM 调用次数 | 1 次 | 1 次 |
| 检索次数 | 1 次 | N 次(N = 改写数量) |
| 结合使用 | ✅ 可同时使用 | ✅ 可同时使用 |
Parent-Child 分块检索
Section titled “Parent-Child 分块检索”分块(Chunking)是 RAG 的前置步骤——把长文档切成小片段再嵌入。矛盾在于:小块嵌入更精准(一段话聚焦一个主题,向量信号强),但大块提供更完整上下文(答案往往需要前后文才能理解)。Parent-Child 分块检索解决这个矛盾。
策略:
- 索引时双重分块。 把文档先切成较大的父块(Parent,如一整段或一节),再把每个父块切成更小的子块(Child,如一两句话)。
- 嵌入检索子块。 只对小而精的子块做嵌入并索引——子块聚焦,检索精准。
- 返回时替换为父块。 检索命中某个子块时,不返回子块本身,而是返回它所属的父块——父块提供完整上下文,LLM 看到的信息更连贯。
LlamaIndex 的 HierarchicalNodeParser + AutoMergingRetriever、LangChain 的 ParentDocumentRetriever 都是这一思路的实现。
分块策略深入——不只是”按长度切”:
分块的质量直接影响检索效果。除了固定大小分块(如每 512 token 切一块),还有更智能的策略:
- 语义分块(Semantic Chunking):不按固定长度切,而是按语义边界切——用嵌入模型计算相邻句子的相似度,在相似度”断崖”处切分。这样每个块在语义上更连贯。
- 递归分块(Recursive Chunking):先按段落分隔符切,段落太大则按句子切,句子太大则按词切——逐级递进,尽量保持自然边界。LangChain 的
RecursiveCharacterTextSplitter是典型实现。 - 结构感知分块(Structure-Aware Chunking):利用 Markdown 标题、HTML 标签、代码函数边界等文档结构信息进行切分——确保一个块不跨越不相关的章节。
- Late Chunking(2024 新方法):传统做法是”先分块再嵌入”——每个块独立编码,丢失了文档全局上下文。Late Chunking 反过来——先对整个文档做一次前向传播获得 token 级嵌入,再按块边界池化。这样每个块都包含了全文的上下文信息,检索效果更好。这是 2024 年由 Jina AI 提出的重要改进。
上下文压缩检索
Section titled “上下文压缩检索”上下文压缩检索(Contextual Compression Retrieval)解决另一个痛点:检索到的文档太长,真正相关的只是其中一小部分,直接全喂给 LLM 浪费 token 又引入噪声。策略:
- 先用任意检索方法拿到一批候选文档(如 top-20)。
- 对每个候选文档,用一个轻量 LLM 或专门模型做信息提取 / 压缩——只保留与查询相关的片段,或生成一段相关摘要。
- 过滤掉与查询无关度低于阈值的文档。
- 只把压缩后的精简内容喂给最终 LLM。
LangChain 的 ContextualCompressionRetriever 配合 LLMChainExtractor 是典型实现。代价是多一轮 LLM 处理开销,收益是大幅降低下游 LLM 的输入 token 量和噪声干扰。
Token 效率的重要性:在 LLM 应用中,输入 token 数量直接影响三个维度:(1) 成本——按 token 计费的 API 调用,冗余文档浪费真金白银;(2) 延迟——输入越长、LLM 处理越慢;(3) 质量——研究发现 LLM 在超长上下文中存在 “lost in the middle” 现象(中间位置的信息容易被忽略),减少噪声文档反而能提升答案质量。
2024-2025 前沿:新一代检索范式
Section titled “2024-2025 前沿:新一代检索范式”Graph RAG(知识图谱增强检索)
Section titled “Graph RAG(知识图谱增强检索)”传统检索(无论稀疏还是稠密)都是”局部匹配”——找与 query 相似的文本块。但有些问题需要跨文档的全局推理——如”这个项目涉及的所有技术栈之间有什么关联?“需要遍历多份文档并构建关系网络。
Graph RAG 在向量检索之上叠加一层知识图谱(Knowledge Graph,一种以实体为节点、关系为边结构化存储知识的数据结构):
- 索引阶段:用 LLM 从文档中抽取实体和关系(如”张三 —[负责]—> 前端模块”),构建知识图谱。
- 检索阶段:query 到来时,既做向量检索找相关文本块,又在图上做图遍历找关联实体。两者结果合并喂给 LLM。
微软 2024 年开源的 GraphRAG 是这一方向的标志性项目。Graph RAG 特别适合需要多跳推理(multi-hop reasoning,需要跨越多个信息节点逐步推理才能得到答案的场景)的复杂问答。
Corrective RAG (CRAG,纠错式检索)
Section titled “Corrective RAG (CRAG,纠错式检索)”CRAG 在检索结果和生成之间加了一个质量评估器——先用一个小模型评估”检索到的文档到底相不相关?”:
- 如果检索结果质量高 → 直接用(Correct 路径)
- 如果检索结果质量低 → 触发 Web 搜索补充信息(Corrective 路径)
- 如果不确定 → 两路结果都保留,融合后使用
这种”先评估再决定用什么”的策略让 RAG 系统更加鲁棒——不会因为一次差的检索就输出错误答案。
Self-RAG(自适应检索)
Section titled “Self-RAG(自适应检索)”Self-RAG 让 LLM 自己学会何时检索、检索什么。它通过训练让模型输出特殊的”反思 token”:
Retrieve?→ 判断当前问题是否需要检索外部知识Relevant?→ 判断检索到的文档是否相关Supported?→ 判断生成的内容是否有检索文档支持
这让检索从”每次必查”变成”按需检索”——简单问题直接回答(省时间),复杂问题才触发检索。这种自适应策略显著提升了效率,同时降低了不必要的幻觉。
Agentic RAG(智能体式检索)
Section titled “Agentic RAG(智能体式检索)”2024-2025 年最重要的趋势是把 Agent(智能体,能够自主决策和调用工具的 AI 系统)引入检索流程。传统 RAG 是固定流水线——“检索 → 生成”一步走完。Agentic RAG 让 LLM 像研究员一样自主探索:
- 先理解问题、规划检索策略(“这个问题需要查 3 类资料”)
- 依次或并行执行多轮检索,每轮根据上一轮的结果调整下一步
- 评估收集的信息是否足够——不够就继续查,够了就总结回答
- 可以调用不同工具:向量检索、SQL 查询、Web 搜索、API 调用
LangGraph、CrewAI 等框架是构建 Agentic RAG 系统的主流工具。详见智能体。
三种检索流派对比
Section titled “三种检索流派对比”HyDE 流程:用假答案检索真资料
Section titled “HyDE 流程:用假答案检索真资料”完整 RAG 检索流水线
Section titled “完整 RAG 检索流水线”BM25 vs 稠密检索对比
Section titled “BM25 vs 稠密检索对比”from rank_bm25 import BM25Okapifrom sentence_transformers import SentenceTransformer, util
# 语料库:3 篇文档docs = ["苹果发布了新的手机 iPhone 15", "华为推出 Mate 60 移动通信终端", "今天天气很好适合户外运动"]# 用户查询:用"移动电话"这个近义词query = "我想了解移动电话"
# --- 稀疏检索 BM25 ---bm25 = BM25Okapi([d.split() for d in docs]) # 中文需先分词,此处简化scores_bm = bm25.get_scores(query.split()) # BM25 打分
# --- 稠密检索 向量 ---model = SentenceTransformer("paraphrase-multilingual-MiniLM-L12-v2")emb_q = model.encode(query) # 查询向量emb_docs = model.encode(docs) # 文档向量scores_dense = util.cos_sim(emb_q, emb_docs)[0] # 余弦相似度
print("BM25 分数:", [round(x, 2) for x in scores_bm]) # 精确词匹配弱print("稠密分数:", [round(float(x), 4) for x in scores_dense]) # 语义理解强# 稠密检索能识别"移动电话" ≈ "手机",BM25 只看字面则完全无法关联运行后可观察到:BM25 对”移动”和”电话”做精确匹配,由于文档 1(“手机”)和文档 2(“移动通信终端”)字面重叠有限,打分差异不大;稠密检索则能理解”移动电话”与”手机”的语义等价,明显偏好文档 1 和文档 2,文档 3(天气)被自然过滤。
混合检索 + RRF 融合
Section titled “混合检索 + RRF 融合”from rank_bm25 import BM25Okapifrom sentence_transformers import SentenceTransformer, utilimport numpy as np
docs = ["梯度下降是深度学习的核心优化算法", "反向传播算法用于计算神经网络中的梯度", "Python 是一种流行的编程语言", "SGD 随机梯度下降是梯度下降的一个变种", "HTTP 是 Web 通信的基础协议"]
query = "神经网络中如何计算梯度"
# --- 稀疏检索 ---bm25 = BM25Okapi([list(d) for d in docs]) # 中文逐字切分(简化)bm25_scores = bm25.get_scores(list(query))bm25_ranks = np.argsort(-bm25_scores) # 分数降序的文档索引
# --- 稠密检索 ---model = SentenceTransformer("paraphrase-multilingual-MiniLM-L12-v2")emb_q = model.encode(query)emb_docs = model.encode(docs)dense_scores = util.cos_sim(emb_q, emb_docs)[0].numpy()dense_ranks = np.argsort(-dense_scores)
# --- RRF 融合 ---k = 60 # RRF 平滑常数rrf_scores = np.zeros(len(docs))for rank, doc_idx in enumerate(bm25_ranks): rrf_scores[doc_idx] += 1.0 / (k + rank + 1)for rank, doc_idx in enumerate(dense_ranks): rrf_scores[doc_idx] += 1.0 / (k + rank + 1)
# 最终排序final_ranks = np.argsort(-rrf_scores)print("RRF 混合排序:")for i in final_ranks: print(f" [{rrf_scores[i]:.4f}] {docs[i]}")# 反向传播算法、梯度下降相关文档排在最前# 即使 query 用词与文档不完全匹配,RRF 融合了两路检索的信号HyDE:假设文档嵌入检索
Section titled “HyDE:假设文档嵌入检索”from openai import OpenAIfrom sentence_transformers import SentenceTransformer, util
openai_client = OpenAI()embed_model = SentenceTransformer("paraphrase-multilingual-MiniLM-L12-v2")
query = "训练时 loss 变成 NaN 怎么办"
# Step 1: 用 LLM 生成假设答案resp = openai_client.chat.completions.create( model="gpt-4o-mini", messages=[{"role": "user", "content": f"请针对以下问题写一段简短的假设性解答(100-200字)。\n问题:{query}"}], temperature=0.3, # 低温度 → 更稳定的假设答案)hypothetical_doc = resp.choices[0].message.contentprint(f"假设答案: {hypothetical_doc[:100]}...")
# Step 2: 用假设答案(而非原始 query)做嵌入检索hyde_emb = embed_model.encode(hypothetical_doc)
# Step 3: 在知识库中检索(此处用示例文档模拟知识库)kb_docs = [ "梯度爆炸是 loss 变 NaN 的常见原因,可通过梯度裁剪缓解。", "学习率过大可能导致训练发散,loss 趋向无穷或 NaN。", "数据中存在 NaN 或 Inf 值会直接污染训练 loss。", "Python 列表和元组的主要区别在于可变性。",]kb_embs = embed_model.encode(kb_docs)scores = util.cos_sim(hyde_emb, kb_embs)[0]
print("\nHyDE 检索结果:")for idx in scores.argsort(descending=True): print(f" [{float(scores[idx]):.4f}] {kb_docs[idx]}")# 假设答案中包含"梯度""学习率""数值不稳定"等术语# 比原始短 query 更贴近知识库文档的表述,检索更精准- 生产系统默认上混合检索。 纯稀疏漏语义、纯稠密漏精确词,混合检索(尤其 RRF 融合)几乎在所有公开基准上都优于单一方法,且 RRF 无需调参,是低风险高收益的默认选择。
- 中文务必先分词再跑 BM25。 英文天然有空格分隔,BM25 直接按空格切词即可;中文没有词边界,必须先用 jieba、HanLP 等分词工具预处理,否则 BM25 退化成字面字符匹配,效果极差。
- 嵌入模型选型要看领域。 通用嵌入(如 OpenAI text-embedding-3、BGE)在医疗、法律、金融等垂直领域可能不如领域微调的嵌入模型;有标注数据时用对比学习微调嵌入往往比换检索策略更见效。
- HyDE / Multi-Query 适合查准率瓶颈场景,不适合延迟敏感场景。 每次检索都要额外调一两次 LLM,延迟可能翻倍;对实时对话机器人要谨慎,对离线批处理或质量优先的场景则非常划算。
- 分块大小是最该先调的超参数。 块太大检索信号被稀释、块太小上下文断裂——先用 Parent-Child 分块做基准,再根据 bad case 微调块大小和重叠区域,往往比换检索算法提升更明显。
- 检索召回不够时先扩召回(多路检索),再上重排序精筛。 流水线范式:混合检索(广撒网)→ 重排序模型(重排序)→ 上下文压缩(去噪)→ LLM 生成。每一步职责单一,便于独立调优和 A/B 测试。
- 复杂问答考虑 Graph RAG。 如果用户的问题需要跨多个文档做关联推理(“A 项目和 B 项目共用了哪些组件?”),传统向量检索很难命中——Graph RAG 或多跳检索更合适。
- 关注 Self-RAG 的按需检索理念。 不是每个 query 都需要检索——简单事实性问题直接回答更快更省,Self-RAG 的思路可以让系统自适应地决定何时触发检索。
- 用评估指标驱动迭代。 建立一个标注好的评估集(100-500 条 query-相关文档对),持续测量 Recall@K(召回率)、nDCG@10(排序质量)、MRR(首个正确结果的位置),用数据而非直觉指导优化方向。
- Elasticsearch / OpenSearch 混合检索:原生支持 BM25 + kNN(K-Nearest Neighbors,近似最近邻)向量检索 + RRF 融合,是企业搜索的标配方案,支持几十亿级文档的实时混合检索。
- Pinecone / Weaviate / Qdrant:主流向量数据库都已内置稀疏-稠密混合检索(Pinecone 的 sparse-dense hybrid、Weaviate 的 hybrid search、Qdrant 的 sparse vectors),一行 API 即可启用。
- LangChain MultiQueryRetriever / ContextualCompressionRetriever:LangChain 框架原生实现了 Multi-Query 改写、上下文压缩、Parent-Child 分块等高级检索策略,是 Python RAG 应用的首选编排工具。
- LlamaIndex AutoMergingRetriever:LlamaIndex 的层级分块 + 自动合并检索是 Parent-Child 策略的成熟实现,支持从小块检索自动回溯到大块上下文。
- Microsoft GraphRAG:微软 2024 年开源的知识图谱增强 RAG 系统,适合需要跨文档关联推理的复杂知识库问答。
- Cohere Rerank + 混合检索:Cohere 的 Rerank API 常与混合检索搭配,形成”混合检索召回 + 重排序精筛”的两阶段流水线,是企业级 RAG 的典型架构。
- Google Vertex AI Search:Google 的企业搜索服务底层即采用混合检索 + RRF + 重排序的组合,支持文档、网站、数据库等多种数据源。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| rank_bm25 | Python | 轻量纯 Python 实现的 BM25 算法,适合原型验证和小规模语料 |
| Elasticsearch / OpenSearch | Java / REST | 企业搜索引擎,原生 BM25 + kNN 向量 + RRF 混合检索 |
| sentence-transformers | Python | HuggingFace 生态嵌入模型库,提供多语言句向量模型与余弦相似度计算 |
| Faiss | Python / C++ | Meta 开源的高效向量检索库,支持 GPU 加速和十亿级向量近似最近邻搜索 |
| LangChain Retriever | Python | 框架内置 MultiQueryRetriever、ContextualCompressionRetriever、ParentDocumentRetriever 等高级检索策略 |
| LlamaIndex | Python | RAG 框架,提供 HierarchicalNodeParser(层级分块)和 AutoMergingRetriever(自动合并) |
| Milvus / Qdrant / Weaviate | 多语言 | 主流开源向量数据库,均内置稀疏向量与混合检索支持 |
| Microsoft GraphRAG | Python | 知识图谱增强 RAG 系统,支持跨文档关联推理 |
| SPLADE | Python | 学习型稀疏检索,结合语义扩展与倒排索引效率 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 稀疏检索 | Sparse Retrieval | 基于关键词匹配的检索方法(TF-IDF、BM25),向量维度高但大部分为 0 |
| 稠密检索 | Dense Retrieval | 基于嵌入向量语义相似度的检索方法,每维都有非零值 |
| 混合检索 | Hybrid Retrieval | 同时执行稀疏和稠密检索并融合结果的方法 |
| 词频-逆文档频率 | TF-IDF | 经典稀疏打分方法,词频乘以逆文档频率衡量词项重要性 |
| BM25 | Okapi BM25 | TF-IDF 的改进版,引入饱和函数和文档长度归一化,是 Lucene/Elasticsearch 默认算法 |
| 倒数排名融合 | RRF (Reciprocal Rank Fusion) | 只用排名不用分数的检索结果融合方法,公式 , 通常取 60 |
| 余弦相似度 | Cosine Similarity | 两个向量夹角的余弦值,衡量方向相似度,是稠密检索的标准度量 |
| 近似最近邻 | ANN (Approximate Nearest Neighbor) | 在精度微小损失下大幅加速向量检索的算法族(HNSW、IVF 等) |
| 对比学习 | Contrastive Learning | 训练嵌入模型的范式:拉近正样本对、推远负样本对 |
| 困难负样本挖掘 | Hard Negative Mining | 刻意找与 query 相似但不相关的文档作为训练负样本的技术 |
| 假设文档嵌入 | HyDE | 先用 LLM 生成假设答案文档,再用该文档向量去检索的策略 |
| 多查询检索 | Multi-Query Retriever | 让 LLM 对查询生成多个改写版本,分别检索后合并去重的策略 |
| 父子分块 | Parent-Child Chunking | 检索时用小块精准匹配,返回时替换为所属大块以提供完整上下文 |
| 上下文压缩检索 | Contextual Compression Retrieval | 检索后用 LLM 对每篇文档提取相关信息,只保留与查询相关的精简内容 |
| 词袋模型 | Bag of Words | 忽略词序、只统计词频的文本表示方法,是稀疏检索的基础 |
| 倒排索引 | Inverted Index | 词项到包含它的文档列表的映射,是稀疏检索的底层数据结构 |
| 学习型稀疏检索 | Learned Sparse Retrieval | 通过训练让稀疏向量获得语义扩展能力(如 SPLADE) |
| 知识图谱增强检索 | Graph RAG | 叠加知识图谱的 RAG 检索范式,支持跨文档多跳推理 |
| 纠错式检索 | Corrective RAG (CRAG) | 评估检索质量,低质量时触发补充检索的自纠错策略 |
| 自适应检索 | Self-RAG | LLM 自主判断是否需要检索、检索结果是否相关的范式 |
| 多跳推理 | Multi-Hop Reasoning | 需要跨越多个信息节点逐步推理才能得到答案的场景 |
- Robertson & Zaragoza,「The Probabilistic Relevance Framework: BM25 and Beyond」(2009):BM25 系列方法的奠基性综述,系统讲解概率检索框架和参数 k1、b 的意义,理解稀疏检索必读。
- Karpukhin et al.,「Dense Passage Retrieval for Open-Domain Question Answering」(EMNLP 2020):DPR 论文,首次证明纯稠密检索能超越 BM25,开启稠密检索时代,对比学习训练双塔嵌入的经典范式。
- Formal et al.,「SPLADE: Sparse Lexical and Expansion Model」(SIGIR 2021):学习型稀疏检索代表作,结合语义扩展与稀疏表示。
- Gao et al.,「Modularized Retrieval-Augmented Generation」(2023, Microsoft):关于 RAG 模块化设计的综述,系统讨论稀疏、稠密、混合检索的取舍和工业落地经验。
- Gao et al.,「Precise Zero-Shot Dense Retrieval without Relevance Labels」(HyDE, 2023):HyDE 原始论文,提出用 LLM 生成假设文档做零样本稠密检索,无标注数据场景的利器。
- Cormack et al.,「Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods」(SIGIR 2009):RRF 融合方法的原始论文(来自 Google 团队),证明简单的倒数排名融合胜过复杂的学习排序方法,k=60 的出处。
- Edge et al.,「From Local to Global: A Graph RAG Approach to Query-Focused Summarization」(Microsoft, 2024):Graph RAG 原始论文,用知识图谱增强 RAG 的全局推理能力。
- Asai et al.,「Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection」(ICLR 2024):Self-RAG 论文,让 LLM 自主决定何时检索。
- Yan et al.,「Corrective Retrieval Augmented Generation」(2024):CRAG 论文,检索结果质量评估与纠错机制。
- Gunther et al.,「Late Chunking: Contextualizing Document Representations」(Jina AI, 2024):Late Chunking 方法,先编码全文再分块池化,保留全局上下文。
- LangChain 官方文档 Retrievers 章节(python.langchain.com):MultiQueryRetriever、ParentDocumentRetriever、ContextualCompressionRetriever 的使用指南和代码示例,工程落地首选参考。
- 后处理环节见重排序,完整流程见RAG 检索增强生成,智能体式检索见智能体。