
数值优化与数学基础
数值优化是整个机器学习的数学引擎——SVM 求解最大间隔、神经网络训练、逻辑回归拟合……本质上都是在「最小化某个损失函数」。本页是全站最底层的数学基础,后续的梯度下降与优化器、最小二乘法、凸优化与约束优化都从这里的概念出发。
- 数值优化与数学基础:本页,优化与数学基础总览、核心直觉与动手实践
- 梯度下降与优化器:SGD、Momentum、RMSProp、Adam 等一阶优化器的原理与演进
- 最小二乘法:线性回归的数学基础、闭式解与正则化变体
- 凸优化与约束优化:凸集/凸函数、拉格朗日对偶、KKT 条件
- 模型评估与指标:准确率、精确率/召回率、F1、AUC、混淆矩阵
- 损失函数:交叉熵、MSE、Hinge、对比损失等的设计与选择
- 激活函数:ReLU、Sigmoid、Tanh、GELU、SwiGLU 等的性质与对比
- 正则化与防过拟合:L1/L2、Dropout、Early Stopping、BatchNorm
- 数据增强:图像/文本/音频的增强策略与实现
- 分布式训练:数据并行、模型并行、ZeRO、流水线并行
- 混合精度训练:FP16/BF16、损失缩放、显存与速度优化
- 概率论基础:随机变量、常见分布、期望/方差、贝叶斯公式
- 线性代数基础:向量/矩阵运算、特征分解、SVD、投影
- 信息论基础:熵、KL 散度、交叉熵、互信息
- 贝叶斯推断:先验/后验、共轭分布、最大后验估计
- EM算法与变分推断:EM 迭代、ELBO、变分推断与 VE 框架
- 蒙特卡洛方法与MCMC:蒙特卡洛估计、重要性采样、Gibbs/Metropolis-Hastings
- 反向传播详解:链式法则、计算图、自动求导原理
- 参数初始化策略:Xavier、He、正交初始化等的设计动机
- 学习率调度策略:Warmup、Cosine、StepLR、OneCycle 等调度方案
- 数据预处理:归一化、标准化、缺失值与类别特征编码
- 牛顿法与拟牛顿法:二阶优化、海森矩阵近似、L-BFGS 收敛性
- 采样方法:直接采样、拒绝采样、分层/重要性采样
机器学习可以浓缩为一句话:定义一个损失函数(打分标准)+ 用优化算法找最小值(找最低谷)。
- 损失函数 = 打分标准:衡量当前模型”有多烂”。预测越准,损失越低;预测越离谱,损失越高。
- 优化算法 = 蒙眼下山:想象你被蒙住眼站在山上,目标是走到最低的谷底。你看不到全貌,但能摸到脚下哪边是下坡——于是每次往下坡方向走一小步,反复迭代。
这个”蒙眼下山”的比喻,就是几乎所有优化算法的原型:
- 梯度告诉你”脚下哪个方向最陡”——梯度方向是上升最快的方向,所以反方向走就是下降最快的方向。
- 学习率决定”每步走多远”——太大会跨过谷底来回震荡,太小会走到天荒地老。
- 局部最优 vs 全局最优:山脉地形有无数小坑(局部最优),你要的最低点(全局最优)只有一个。非凸问题(如神经网络)没法保证找到全局最优,但实践中”够好的局部最优”往往也够用。
用数学说清楚:为什么”负梯度方向”是下降最快的方向?
Section titled “用数学说清楚:为什么”负梯度方向”是下降最快的方向?”对计算机专业但第一次接触优化的读者,我们来把这个直觉严格化。设目标函数 (一个把 维向量映射成标量”分数”的函数),当前位于点 ,我们想选一个单位方向 ()走一小步,使得 下降得最快。
把 在 处做一阶泰勒展开(Taylor expansion,即用线性函数局部近似):
其中 是步长, 是梯度(gradient,即 对每个分量的偏导数组成的向量)。要让 下降最多,就是要最小化 。由柯西-施瓦茨不等式(Cauchy–Schwarz inequality):
等号在 时成立。也就是说:负梯度方向是局部下降最快的方向,这就是”梯度下降”这个名字的数学来源。
于是,最基本的梯度下降更新规则就是:
其中 是学习率(learning rate,即步长系数)。这个公式的意思朴素极了:“往最陡的下坡方向走一小步”。
损失曲面与梯度下降
Section titled “损失曲面与梯度下降”损失函数的值构成一个”地形”(损失曲面),梯度下降沿着最陡下坡方向一步步逼近最低点:
学习率:太大太小都不行
Section titled “学习率:太大太小都不行”学习率(learning rate)是优化中最重要的超参数之一:
一阶 vs 二阶:要不要”看看曲率”?
Section titled “一阶 vs 二阶:要不要”看看曲率”?”梯度只告诉你坡有多陡,没告诉你坡有多弯。二阶方法(如牛顿法)额外利用海森矩阵(Hessian,即二阶偏导数矩阵,描述曲面弯曲程度)来估计更优的方向,理论上能用更少步数到达谷底。但海森矩阵的尺寸是 ——当 是亿级参数时,存储和求逆都是天价。所以深度学习几乎都用”只算梯度”的一阶方法(SGD/Adam),而传统凸优化(参数少)经常用二阶方法(L-BFGS)。
numpy 手写梯度下降:求二次函数最小值
Section titled “numpy 手写梯度下降:求二次函数最小值”目标函数 ,它的梯度是 。梯度下降会一步步逼近 这个最小值点:
import numpy as np
# 目标函数 f(x) = x²,梯度 f'(x) = 2xdef loss(x): return x ** 2def grad(x): return 2 * x
# 从随机点出发,学习率 0.1,迭代 50 步x = 5.0                     # 初始点:站在 x=5 的山坡上lr = 0.1                    # 学习率:每步走多远for step in range(50):    x = x - lr * grad(x)    # 往梯度的反方向走一步    if step % 10 == 0:        print(f"step {step}: x={x:.4f}, f(x)={loss(x):.4f}")print(f"最终: x={x:.6f}(理论最优 x=0)")# step 0:  x=4.0000, f(x)=16.0000# step 10: x=0.4318, f(x)=0.1864# step 20: x=0.0372, f(x)=0.0014# step 30: x=0.0032, f(x)=0.0000# 最终: x=0.000007(理论最优 x=0)
为什么 必然收敛?——一个迷你收敛性证明
Section titled “为什么 f(x)=x2f(x)=x^2f(x)=x2 必然收敛?——一个迷你收敛性证明”对于 ,更新规则是 。反复代入得:
当 时,,所以 ,即 (全局最优)。这也解释了为什么学习率不能太大:当 时 ,序列会发散到无穷——这正是实践中 loss 变成 NaN 的数学根源。
多维梯度下降:用 autograd(自动微分引擎)拟合一个超平面
Section titled “多维梯度下降:用 autograd(自动微分引擎)拟合一个超平面”真实问题里,参数都是高维向量,手算梯度既繁琐又容易错。下面用 PyTorch 的 autograd(自动微分引擎,即自动计算梯度的系统)来求解一个最简单的线性回归 ,让你直观看到 loss.backward() + optimizer.step() 的完整流程:
import torch
# 1. 造一组带噪声的数据:真实关系 y = 2x + 3torch.manual_seed(42)X = torch.linspace(-3, 3, 100).unsqueeze(1)         # 100 个输入y = 2 * X + 3 + 0.5 * torch.randn_like(X)           # 加高斯噪声
# 2. 定义可训练参数 w, b(requires_grad=True 表示要算梯度)w = torch.zeros(1, 1, requires_grad=True)b = torch.zeros(1, requires_grad=True)
# 3. 用 Adam 优化器(自适应学习率,对学习率更鲁棒)optimizer = torch.optim.Adam([w, b], lr=0.1)
# 4. 训练 300 步:前向 → 算损失 → 反向 → 更新for step in range(300):    pred = X @ w + b                                  # 前向传播:模型预测    loss = ((pred - y) ** 2).mean()                   # MSE 损失(均方误差)
    optimizer.zero_grad()                             # 清空旧梯度    loss.backward()                                   # autograd 自动反向求梯度    optimizer.step()                                  # 沿负梯度方向更新参数
    if step % 50 == 0:        print(f"step {step}: loss={loss.item():.4f}, "              f"w={w.item():.4f}, b={b.item():.4f}")print(f"最终: w={w.item():.4f}(真值 2), b={b.item():.4f}(真值 3)")# step 0:   loss=18.8810, w=0.1000, b=0.1000# step 50:  loss=0.3518,  w=1.9110, b=2.4280# ...# 最终: w≈2.00, b≈3.00(成功拟合)
这段代码的每一行都是深度学习训练的最小骨架——把它换成 CNN/Transformer,流程几乎一样,只是 loss 和 pred 的计算更复杂。
可视化:用等高线看二维优化轨迹
Section titled “可视化:用等高线看二维优化轨迹”理解优化过程最好的方式是”看它怎么走”。下面用 matplotlib 画出 (一个”狭长山谷”形函数)的梯度下降轨迹——它是一个经典的病态(ill-conditioned)例子,梯度的方向并不指向谷底:
import numpy as npimport matplotlib.pyplot as plt
def f(x, y): return x**2 + 10 * y**2          # 狭长山谷:y 方向比 x 方向陡 10 倍def grad(x, y): return np.array([2*x, 20*y])  # 梯度
# 梯度下降轨迹xy = np.array([4.0, 1.0])                     # 起点lr = 0.08trajectory = [xy.copy()]for _ in range(50):    xy = xy - lr * grad(*xy)    trajectory.append(xy.copy())trajectory = np.array(trajectory)
# 画等高线 + 轨迹xx, yy = np.meshgrid(np.linspace(-5, 5, 200), np.linspace(-3, 3, 200))plt.figure(figsize=(7, 4))plt.contour(xx, yy, f(xx, yy), levels=30, cmap='viridis')plt.plot(trajectory[:, 0], trajectory[:, 1], 'r.-', lw=1, ms=4)plt.title("梯度下降在病态曲面上的锯齿形震荡\n"          "(为什么需要 Momentum/Adam 等改进)")plt.xlabel("x"); plt.ylabel("y"); plt.axis('equal')plt.colorbar(label='f(x,y)')plt.tight_layout(); plt.show()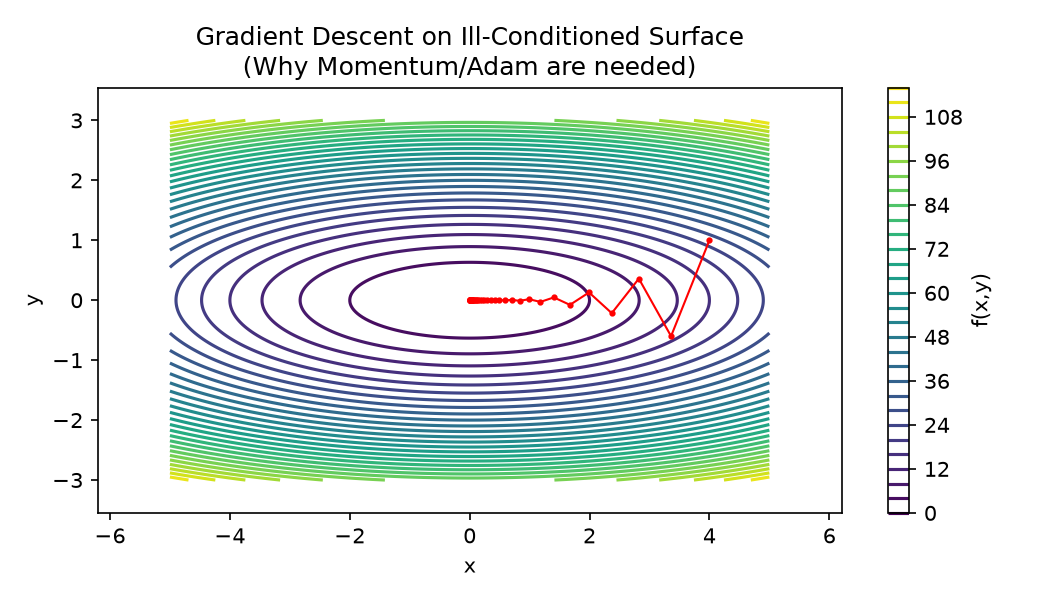
你会看到红点轨迹呈明显的锯齿形来回震荡——梯度在陡峭的 方向反复”撞墙”,而真正需要走的平缓 方向却进展缓慢。这正是 Momentum、Adam(自适应学习率,对每个参数用不同步长)要解决的核心痛点,详见梯度下降与优化器。
- 学习率是第一优先级的超参数:永远先调学习率。太大发散(loss 变 NaN),太小不收敛。经验范围:深度学习 ,传统 ML 可能更大。
- 非凸问题不要纠结全局最优:深度学习的损失曲面高度非凸,理论上 NP-hard,但 SGD + 好的初始化在实践中”意外地好用”——找到的局部最优往往泛化良好。
- 梯度消失/爆炸:深层网络中梯度可能极小(消失)或极大(爆炸),这是 RNN 训练的核心痛点,也是 Transformer 用 LayerNorm、残差连接的原因。
- 鞍点比局部最优更常见:高维空间中,局部最优反而稀少,鞍点(某些方向是最低、某些方向是最高)才是主要障碍。Dauphin 等人 2014 年的实证研究显示,在真实深度网络中绝大多数”卡住”的时刻其实是鞍点而非局部最优。
- 条件数(condition number)决定收敛快慢:损失曲面在各个方向上越”均匀”,收敛越快;越”狭长”,梯度下降越容易震荡。这是 Adam 等自适应方法(给每个方向自适应配步长)优于朴素 SGD 的根本原因。
- 神经网络训练:PyTorch / TensorFlow 的每一次
loss.backward()+optimizer.step(),本质就是梯度下降——这是深度学习的底层引擎。 - SVM 求解最大间隔:SVM 的训练是一个凸二次规划问题,用 SMO 等优化算法求解拉格朗日对偶。深入解析见SVM 支持向量机。
- 逻辑回归拟合:用梯度下降(或 L-BFGS)最小化交叉熵损失——广告 CTR 预估的核心模型。
- 曲线拟合/回归:最小二乘法的本质也是优化——最小化残差平方和。详见最小二乘法。
- 大模型预训练:GPT、BERT 的训练就是在数十亿参数的超高维空间中做随机梯度下降。详见语言模型演进。
优化器演进速览(截至 2025)
Section titled “优化器演进速览(截至 2025)”理解了梯度下降的基本原理后,下面这张表帮你把后续各代优化器的”改进了什么”快速对上号。每一代都是在解决上一代的某个痛点,详细的数学推导见梯度下降与优化器。
| 时代 | 代表方法 | 核心改进 | 直觉类比 |
|---|---|---|---|
| 1951 | SGD | 最朴素的负梯度更新 | 蒙眼下山,只看脚下 |
| 1986 | Momentum | 累加历史梯度,抑制震荡 | 滚雪球:惯性帮你冲过小坑 |
| 2011 | AdaGrad | 每个参数自适应学习率 | 经常走的方向放小步,少走的方向放大步 |
| 2012 | RMSProp | AdaGrad 加指数衰减 | “忘记”太老的历史,适应非凸地形 |
| 2014 | Adam | Momentum + RMSProp 合体 | 下山时既有惯性又自适应步长 |
| 2017 | AdamW | 修正权重衰减的实现 | 修复 Adam 的一个正则化 bug,成 LLM 训练标配 |
| 2023 | Lion | 只用梯度的符号(sign),更省显存 | Google 用符号搜索发现的”极简”优化器 |
| 2024 | Schedule-Free | 去掉学习率调度 | Meta 提出,省去调 warmup/cosine 的麻烦 |
| 2024 | Muon | 对动量做正交化(Newton-Schulz) | 让每层梯度的奇异值更均匀,训练更稳定 |
| 2024 | SOAP / PSGD-Kron | 二阶信息的廉价近似 | 用近似海森矩阵加速收敛,成本接近一阶 |
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
| scipy.optimize | Python | 科学计算的优化全家桶:L-BFGS-B、Nelder-Mead、BFGS、信赖域方法等 |
| PyTorch autograd | Python | 自动求导引擎,loss.backward() 自动算梯度,是深度学习优化的核心 |
| JAX | Python | Google 的可微分数值计算框架,支持 jit 加速和自动向量化 |
| CVXPY | Python | 凸优化建模语言,专注于线性/二次/锥规划(见凸优化) |
| NLopt | C/C++ | 非线性优化库,提供数十种全局/局部优化算法 |
| Optax | Python | JAX 生态的优化器库,提供 JAX 版的 AdamW、Lion、Muon、Schedule-Free 等 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 目标函数 | Objective Function | 要最小化(或最大化)的函数,在 ML 中通常是损失函数 |
| 梯度 | Gradient | 目标函数在各维度的偏导数向量,指向上升最快方向 |
| 海森矩阵 | Hessian Matrix | 二阶偏导数矩阵,描述损失曲面的曲率信息 |
| 全局最优 | Global Optimum | 整个定义域内最低的谷底 |
| 局部最优 | Local Optimum | 某个邻域内最低、但全局未必最低的谷底 |
| 学习率 | Learning Rate | 每次迭代的步长系数,决定收敛速度和稳定性 |
| 收敛 | Convergence | 迭代过程逐步逼近最优解,损失不再显著下降 |
| 鞍点 | Saddle Point | 某些方向是极小值、另一些方向是极大值的临界点 |
| 条件数 | Condition Number | 海森矩阵最大与最小特征值之比,衡量曲面”病态”程度 |
| 泰勒展开 | Taylor Expansion | 用多项式局部近似一个函数,优化中常用一阶/二阶展开 |
- Boyd & Vandenberghe《Convex Optimization》(2004):凸优化领域的圣经,免费 PDF 公开。虽然标题是凸优化,但前几章对优化基础概念(梯度、对偶、KKT)的讲解极为透彻。
- Nocedal & Wright《Numerical Optimization》(2006):数值优化算法的标准教材,覆盖线搜索、信赖域、拟牛顿法(L-BFGS)、共轭梯度等,偏理论和算法实现。
- Goodfellow《Deep Learning》第 4 章:深度学习视角的数值计算基础,讨论了梯度消失/爆炸、病态条件等实践问题。
- Ruder「An overview of gradient descent optimization Algorithms」:在线经典综述,清晰梳理 GD→SGD→Momentum→Adam 的演进脉络。
- Jordan-Zoubin-Ghoshtein《Mathematical Optimization for Machine Learning》(2024):一本较新的教材,把优化与机器学习紧密结合,覆盖一阶/二阶方法、非凸优化与现代大模型训练的优化视角。
- Defazio et al.「The Road Less Scheduled」(2024):Schedule-Free 优化的原论文,论证了为何学习率调度可以被更简单的”平均化”机制替代,适合想了解最新优化器设计思路的读者。
- Károly et al.「Muon: An optimizer for hidden layers in neural networks」(2024):Muon 优化器的技术报告,提出用 Newton-Schulz 迭代对动量做正交化,是 2024-2025 年大模型训练最受关注的新优化器之一。
- Martens & Grosse「Optimizing Neural Networks with Kronecker-factored Approximate Curvature」:K-FAC 论文,奠定了用 Kronecker 分解近似海森矩阵的范式,启发了 2024 年的 PSGD-Kron 等二阶近似方法。