
迁移学习
本页介绍迁移学习(Transfer Learning):用在大数据集上预训练好的模型,迁移到自己的小数据任务上。它是深度学习从”学术研究”走向”工业落地”的关键转折——2012 年之后,绝大多数实际应用都不是从头训练,而是站在预训练巨人的肩膀上微调。CNN 的背景见 卷积神经网络 CNN。
迁移学习的核心信念是:底层特征是通用的,可以复用。具体到视觉领域,一个在 ImageNet(128 万张图、1000 类)上训练好的 ResNet,它的卷积层学到了一套从低级到高级的特征层级:
- 浅层:边缘、颜色斑块、纹理——几乎所有自然图像都有这些元素
- 中层:角点、轮廓、简单部件(眼睛、轮子、叶片)——跨类别共享
- 深层:更抽象的语义概念,越往上越贴合 ImageNet 的 1000 类
迁移学习的做法是:保留底层特征提取器,只重新训练顶层的分类器。这就像一个学过开车的人再去学开卡车——油门、刹车、方向盘的肌肉记忆可以直接复用,只需学卡车特有的操作。
为什么这在数学上合理?因为深度网络的特征空间存在”通用性梯度”——底层特征对几乎所有视觉任务都有用,越往上越任务特化。所以微调时,对不同层施加不同的学习率(浅层小、深层大),甚至直接冻结浅层,是最经济的策略。
2024-2025 年,迁移学习的范式又发生了重大变化:参数高效微调(PEFT, Parameter-Efficient Fine-Tuning) 兴起,尤其是 LoRA(Low-Rank Adaptation)——它只训练极少量的额外参数(通常 < 1% 的原模型参数),就能达到接近全参数微调的效果。这使得在消费级 GPU 上微调数十亿参数的大模型成为可能。
特征迁移的数学基础
Section titled “特征迁移的数学基础”迁移学习之所以有效,有严谨的理论支撑。Yosinski et al. (2014) 的经典实验系统地验证了 “特征可迁移性”:
实验设计:  - 用数据集 A 训练一个 8 层 CNN,得到网络 N_A  - 用数据集 B 训练一个相同架构的网络 N_B  - 取 N_A 的前 k 层(特征提取器),接到 N_B 的后 8-k 层(分类器)  - 在数据集 B 上微调,观察性能
结论: - 第 1~3 层(边缘/纹理特征)几乎完全可迁移,冻结或微调差异不大 - 第 4~6 层(中层特征)部分可迁移,取决于两个任务的相关性 - 第 7~8 层(任务特化层)几乎不可迁移,必须重新训练 - 整体规律:特征的"通用性"随深度递减,"特化性"随深度递增这个”通用性梯度”可以用信息论直觉解释:浅层特征捕捉的是自然图像的统计规律(哪些边经常一起出现、纹理有哪些模式),这些统计规律在几乎所有自然图像中都成立——它们属于数据的内在结构而非某个任务的判别需求。
迁移学习的类型体系
Section titled “迁移学习的类型体系”迁移学习不只有”ImageNet 预训练 → 微调”这一种形式。按知识来源和迁移方式可分类:
| 类型 | 含义 | 典型场景 |
|---|---|---|
| 归纳迁移(Inductive) | 源域和目标域任务不同,但有标注数据 | ImageNet 分类 → 医疗影像分类 |
| 直推迁移(Transductive) | 源域和目标域任务相同,但数据分布不同 | 网络图片 → 卫星图片分类 |
| 无监督迁移 | 目标域无标注数据 | 域自适应(Domain Adaptation) |
| 特征迁移 | 冻结特征提取器,只训练分类头 | 小数据微调 |
| 参数迁移 | 共享模型参数,全部或部分微调 | 标准微调 |
| 实例迁移 | 对源域样本重新加权来匹配目标域分布 | 域自适应中的样本加权 |
| 参数高效迁移(PEFT) | 冻结原参数,只训练极少量额外参数 | LoRA、Adapter、Prompt Tuning |
源域(Source Domain):有充足数据/标注的领域;目标域(Target Domain):你想解决但数据少的领域。迁移学习的目标就是把源域学到的知识”搬”到目标域。
微调策略的数学原理
Section titled “微调策略的数学原理”冻结策略(Freezing)
冻结浅层参数等价于在优化时设置 requires_grad=False,这些层的参数不参与梯度更新。从数学上看,损失函数 L(θ_frozen, θ_trainable) 只对 θ_trainable 做梯度下降:
这在小数据场景下至关重要:如果同时微调所有层,模型容易过拟合——因为它有太多自由度可以在小数据上”记住”训练集。冻结浅层减少了有效参数量,起到了隐式正则化的作用。
差分学习率(Discriminative Learning Rates)
差分学习率的核心原理是:浅层特征已足够好,只需微调;深层需要更多调整来适应新任务。对不同层使用不同的学习率:
第 1~2 层:lr = 1e-5 (几乎不动,只做极小调整)第 3~4 层:lr = 5e-5 (轻微调整)第 5~6 层:lr = 1e-4 (中等调整)第 7~8 层:lr = 1e-3 (大幅调整,学习新任务特征)分类头: lr = 1e-3 (从零开始,正常学习率)在 Transformer 模型中,这被称为 Layer-wise Learning Rate Decay (LLRD)——每层的基准学习率按固定衰减率(如 0.95)从顶层向底层递减。BERT、ViT 微调时广泛使用。
渐进解冻(Gradual Unfreezing)
渐进解冻是一种训练策略,分阶段逐步解冻网络层:
阶段 1(epoch 0-3):冻结全部 backbone,只训练分类头阶段 2(epoch 3-6):解冻最后一个 block,分类头 + 最后 block 一起训练阶段 3(epoch 6-9):再解冻前一个 block...每解冻一层,将整体学习率降低约一个量级直觉理解:先让分类头”适应”预训练特征,再逐步”唤醒”深层,最后才动浅层——避免一上来就大规模调整破坏预训练特征。
参数高效微调(PEFT):2024-2026 的主流
Section titled “参数高效微调(PEFT):2024-2026 的主流”当模型规模达到数十亿到数千亿参数(如 GPT-4、LLaMA 3、DINOv2),全参数微调变得极其昂贵——一个 70B 模型全参数微调需要多张 A100/H100,显存占用超过 300GB。PEFT 的核心思想是:冻结原模型 99% 的参数,只训练极少量额外参数。
LoRA(Low-Rank Adaptation)
LoRA 是目前最流行的 PEFT 方法。它的数学核心是低秩矩阵近似:
其中:
- :冻结的原始权重矩阵(,不训练)
- :可训练的”降维”矩阵, 是秩(rank),通常
- :可训练的”升维”矩阵
- 用随机高斯初始化, 初始化为全零(训练开始时 ,不改变原始输出)
可训练参数量:。例如 时,全参数为 ,而 LoRA 仅为 (原参数的 0.39%)。
为什么低秩有效? Aghajanyan et al. (2020) 的研究表明,预训练模型的权重更新 ΔW 在微调过程中具有低本征秩(low intrinsic rank)——即虽然 ΔW 是一个大矩阵,但它的有效信息可以压缩到低维空间。这意味着不需要更新全部参数,只需要在低维子空间中搜索就能很好地适应新任务。
LoRA 的实践优势:
- 显存占用极低:70B 模型用 LoRA 微调,单张 24GB 消费级 GPU 即可完成。
- 推理无额外延迟:训练完成后可以将 BA 合并到 W 中(W_new = W + BA),推理时和原模型结构完全一致。
- 可插拔切换:不同的 LoRA 适配器(A、B 矩阵)可以热切换——一个基础模型 + 多个小 LoRA 适配器,实现多任务部署。
QLoRA(Quantized LoRA)
QLoRA 在 LoRA 基础上进一步创新——将冻结的原始权重 W 量化为 4-bit 精度(NF4, NormalFloat 4),只训练 LoRA 的 A、B 矩阵(保持 FP16/BF16 精度)。这使得一个 65B 模型可以在单张 48GB GPU 上微调:
QLoRA 显存占用对比(65B 模型): 全参数 FP16 微调:~780GB (需要 10× A100 80GB) LoRA FP16 微调: ~130GB (需要 2× A100 80GB) QLoRA 4-bit: ~48GB (单张 A6000 即可!)QLoRA 引入的关键技术:
- NF4(NormalFloat 4):信息论最优的 4-bit 量化格式,假设权重服从正态分布,量化点不均匀分布在正态分布的分位数上。
- 双重量化(Double Quantization):对量化常数本身再做一次量化,进一步节省显存。
- 分页优化器(Paged Optimizer):利用 NVIDIA 统一内存,在显存溢出时自动将优化器状态转移到 CPU 内存。
Adapter 与 Prefix Tuning
除 LoRA 外,其他 PEFT 方法的原理:
- Adapter:在 Transformer 每层的注意力/FFN 之后插入一个小型瓶颈网络(bottleneck: d → r → d,r d)。只训练 Adapter 参数,原始 Transformer 冻结。与 LoRA 的区别是:Adapter 增加了推理时的额外计算(多了一层),而 LoRA 可以合并。
- Prefix Tuning:在 Transformer 每层的注意力键值对前面拼接 K 个可学习的”虚拟 token”(prefix vectors)。模型看到这些 prefix 就知道当前是什么任务。相当于用”软提示”(soft prompt)来引导模型行为。
- Prompt Tuning:更轻量版——只在输入嵌入层加入可学习的 prompt 向量,不修改内部层。适合 10B+ 参数的大模型。
- DoRA(Weight-Decomposed LoRA, 2024):将权重分解为方向(direction)和幅度(magnitude)两部分,对方向用 LoRA 微调,对幅度用标量微调,效果优于标准 LoRA。
2024-2025 年,LoRA 及其变体(QLoRA、DoRA、LoRA+)已成为 LLM 微调的事实标准。HuggingFace PEFT 库、UNSATh、axolotl 等工具让 LoRA 微调变得”几行代码即可运行”。
ImageNet 预训练 → 下游任务微调
Section titled “ImageNet 预训练 → 下游任务微调”三种常见微调策略
Section titled “三种常见微调策略”LoRA 的低秩分解原理
Section titled “LoRA 的低秩分解原理”什么时候用哪种策略? 数据极少(< 每类 100 张)→ 冻结 backbone 只训分类头;数据中等 → 差分学习率全网络微调;数据很多但与预训练域差异大 → 从头训练或较大学习率微调;大模型(> 1B 参数)→ 用 LoRA / QLoRA,显存和存储都大幅节省。
冻结 vs 微调:特征空间对比
Section titled “冻结 vs 微调:特征空间对比”下面的可视化用模拟的 t-SNE 散点图,直观展示了”冻结 backbone”与”微调”两种策略下特征空间的可分性差异:冻结时各类特征高度重叠,微调后各类聚类清晰分离。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
np.random.seed(42)
N_PER_CLASS = 100CLASS_NAMES = ["Airplane", "Car", "Bird", "Cat", "Dog"]CLASS_COLORS = ["#2196F3", "#F44336", "#4CAF50", "#FF9800", "#9C27B0"]
# Frozen backbone features: cluster centers close together → heavy overlapfrozen_centers = np.array([    [0.6, 0.5], [1.2, 0.8], [0.3, 1.4], [1.5, 0.2], [0.8, 1.2],])frozen_spread = 0.55
frozen_data, frozen_labels = [], []for i, c in enumerate(frozen_centers):    frozen_data.append(np.random.randn(N_PER_CLASS, 2) * frozen_spread + c)    frozen_labels.extend([i] * N_PER_CLASS)frozen_data = np.vstack(frozen_data)frozen_labels = np.array(frozen_labels)
# Fine-tuned features: centers far apart, same spread → clear separationfinetuned_centers = np.array([    [-4.0, 3.0], [4.5, 2.5], [-3.0, -3.5], [4.0, -3.0], [0.0, 5.0],])finetuned_spread = 0.55
finetuned_data, finetuned_labels = [], []for i, c in enumerate(finetuned_centers):    finetuned_data.append(np.random.randn(N_PER_CLASS, 2) * finetuned_spread + c)    finetuned_labels.extend([i] * N_PER_CLASS)finetuned_data = np.vstack(finetuned_data)finetuned_labels = np.array(finetuned_labels)
fig, (ax_f, ax_ft) = plt.subplots(1, 2, figsize=(11, 5.5))fig.patch.set_facecolor("white")
for i in range(len(CLASS_NAMES)):    m = frozen_labels == i    ax_f.scatter(frozen_data[m, 0], frozen_data[m, 1], c=CLASS_COLORS[i],                 s=35, alpha=0.6, edgecolors="white", linewidths=0.4,                 label=CLASS_NAMES[i])    m = finetuned_labels == i    ax_ft.scatter(finetuned_data[m, 0], finetuned_data[m, 1], c=CLASS_COLORS[i],                  s=35, alpha=0.7, edgecolors="white", linewidths=0.4,                  label=CLASS_NAMES[i])
ax_f.set_title("Frozen Backbone Features", fontsize=11, fontweight="bold", color="#D32F2F")ax_f.set_xlabel("t-SNE dim 1", fontsize=10)ax_f.set_ylabel("t-SNE dim 2", fontsize=10)ax_f.set_xticks([]); ax_f.set_yticks([])
ax_ft.set_title("Fine-tuned Features", fontsize=11, fontweight="bold", color="#388E3C")ax_ft.set_xlabel("t-SNE dim 1", fontsize=10)ax_ft.set_ylabel("t-SNE dim 2", fontsize=10)ax_ft.set_xticks([]); ax_ft.set_yticks([])ax_ft.legend(loc="upper right", fontsize=8, framealpha=0.9)
fig.suptitle("Feature Space Comparison: Frozen vs Fine-tuned (Simulated t-SNE)",             fontsize=12, fontweight="bold", y=0.99)plt.tight_layout(rect=[0, 0, 1, 0.95])plt.savefig("transfer-learning-tsne.png", dpi=180, bbox_inches="tight", facecolor="white")plt.close()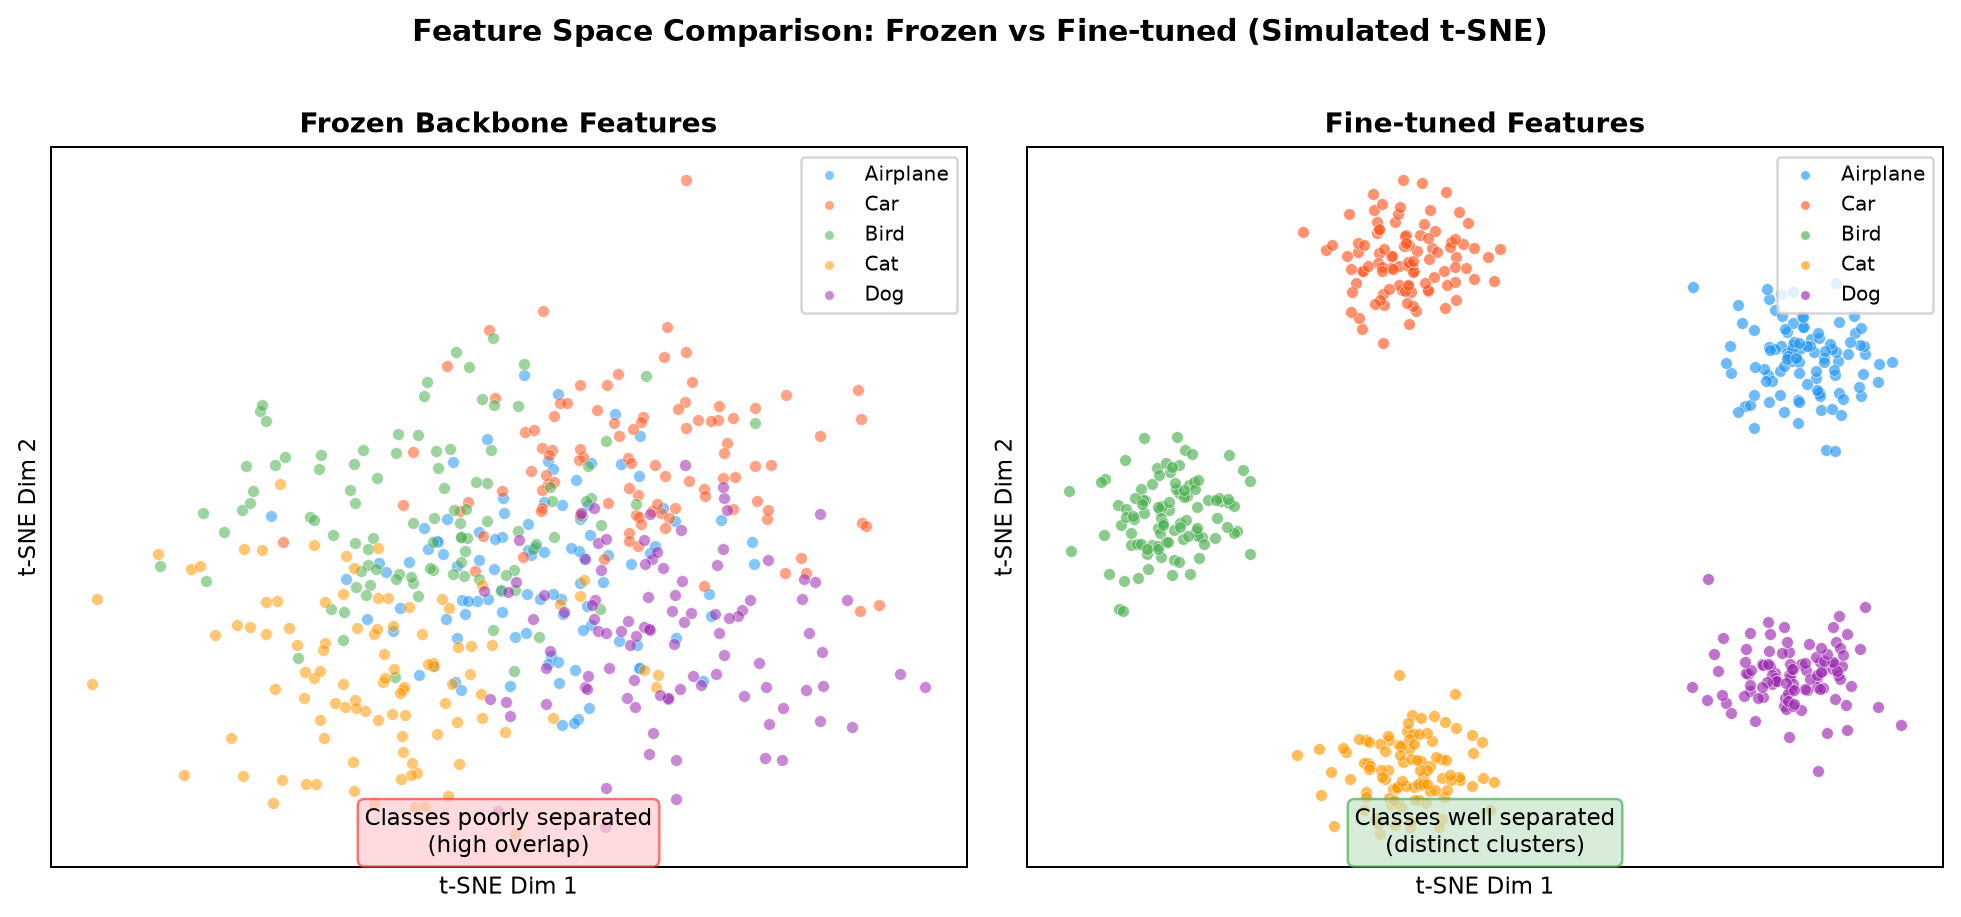
冻结 vs 微调:特征空间对比
Section titled “冻结 vs 微调:特征空间对比”下图用模拟的 t-SNE 投影直观对比两种策略的特征空间分布:冻结 backbone 时各类特征高度重叠(分类困难),微调后各类特征形成清晰可分的簇。
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as np
np.random.seed(42)
n_classes = 5n_per_class = 100class_names = ["Airplane", "Car", "Bird", "Cat", "Dog"]colors = ["#2196F3", "#FF5722", "#4CAF50", "#FF9800", "#9C27B0"]
# 冻结 backbone:聚类中心靠近,方差大 → 高重叠frozen = []for c in range(n_classes):    center = np.random.randn(2) * 1.5    frozen.append(center + np.random.randn(n_per_class, 2) * 1.2)
# 微调后:聚类中心散开,方差小 → 清晰可分angles = np.linspace(0, 2 * np.pi, n_classes, endpoint=False)centers = np.column_stack([np.cos(angles) * 6, np.sin(angles) * 6])finetuned = []for c in range(n_classes):    finetuned.append(centers[c] + np.random.randn(n_per_class, 2) * 0.7)
fig, axes = plt.subplots(1, 2, figsize=(11, 5))for ax, data, title, note, note_color in [    (axes[0], frozen, "Frozen Backbone Features",     "Classes poorly separated", "#FFCDD2"),    (axes[1], finetuned, "Fine-tuned Features",     "Classes well separated", "#C8E6C9"),]:    for c in range(n_classes):        ax.scatter(data[c][:, 0], data[c][:, 1], c=colors[c],                   alpha=0.6, s=22, label=class_names[c])    ax.set_title(title, fontsize=11, fontweight="bold")    ax.set_xticks([])    ax.set_yticks([])    ax.legend(fontsize=8)
fig.suptitle("Feature Space Comparison: Frozen vs Fine-tuned (Simulated t-SNE)",             fontsize=12, fontweight="bold")plt.tight_layout()plt.savefig("transfer-learning-tsne.png", dpi=180,            bbox_inches="tight", facecolor="white")
训练技巧与工程细节
Section titled “训练技巧与工程细节”学习率预热(Warmup)是微调的必备技巧
Section titled “学习率预热(Warmup)是微调的必备技巧”预训练模型的权重已经在一个很好的位置,如果训练第一步就用大学习率更新,可能导致权重被严重扰动(catastrophic forgetting,灾难性遗忘——模型”忘掉”了预训练知识)。学习率预热解决此问题:
Warmup 阶段(前 10% 训练步数):学习率从 0 线性增长到 base_lr。
余弦退火阶段(后 90% 训练步数):学习率按余弦曲线缓慢衰减到 min_lr。
其中:
推荐参数:
- CNN 微调:base_lr = 1e-3(分类头)/ 1e-4(backbone),warmup 5%
- ViT 微调:base_lr = 1e-4,warmup 10%,LLRD 衰减率 0.65~0.75
- LoRA 微调:base_lr = 2e-4
1e-3(比全微调大),warmup 35%
防止灾难性遗忘
Section titled “防止灾难性遗忘”微调时模型可能”忘掉”预训练知识——在小数据上过拟合到新任务,丢失通用特征。缓解策略:
- 小学习率:最直接有效的方法。微调学习率通常是从头训练的 1/10~1/100。
- 冻结浅层:直接锁住通用特征层。
- 混合训练(Mixout / Feature Mixup):在微调时混合部分预训练数据或预训练特征。
- 弹性权重整合(EWC, Elastic Weight Consolidation):对每个参数计算”重要性”(Fisher 信息矩阵),重要参数的更新幅度被惩罚项限制——让模型”不敢忘”重要知识。
其中 是预训练参数, 是第 个参数的 Fisher 信息(衡量重要性), 控制对预训练知识的保留力度。
预处理对齐:最容易被忽略的陷阱
Section titled “预处理对齐:最容易被忽略的陷阱”预训练模型期望的输入有固定的统计分布。如果你的新数据预处理方式与预训练时不同,特征提取器会”认不出”输入,迁移效果大幅退化。最常见的错误:
# ❌ 错误:忘记归一化transform = transforms.Compose([    transforms.Resize((224, 224)),    transforms.ToTensor(),    # 缺少 Normalize!输入值在 [0,1],而预训练模型期望标准化后的分布])
# ✅ 正确:用 ImageNet 的均值和标准差归一化transform = transforms.Compose([    transforms.Resize((224, 224)),    transforms.ToTensor(),    transforms.Normalize(        mean=[0.485, 0.456, 0.406],   # ImageNet RGB 均值        std=[0.229, 0.224, 0.225]      # ImageNet RGB 标准差    )])
为什么用这组特定的均值和标准差?因为 ImageNet 训练数据中 RGB 三个通道的均值约为 (0.485, 0.456, 0.406),标准差约为 (0.229, 0.224, 0.225)。预训练模型的 BatchNorm 层是在这个统计分布上收敛的,输入分布偏移会导致 BatchNorm 的统计量失效。
LoRA 微调的超参数选择
Section titled “LoRA 微调的超参数选择”LoRA 微调的效果高度依赖超参数设置,关键参数:
| 参数 | 推荐值 | 说明 |
|---|---|---|
| 秩 r | 8~64 | r 越大表达能力越强但参数越多;r=8 足以应对大多数任务,r=64 用于复杂任务 |
| 缩放因子 alpha | r 的 2 倍 | LoRA 输出乘以 alpha/r,控制适配强度;常用 alpha = 2r |
| 目标模块 | q_proj, v_proj | LLM 中通常加在注意力的 Q 和 V 矩阵上;全覆盖(所有 Linear)效果更好但参数更多 |
| Dropout | 0.05~0.1 | LoRA 层的正则化,防止过拟合 |
| 学习率 | 2e-4~1e-3 | 比全参数微调大一个量级,因为 LoRA 参数是从零初始化的 |
| Batch size | 32~128 | 越大越稳定,配合梯度累积 |
PyTorch:加载 ResNet 预训练权重 + 替换分类头 + 微调
Section titled “PyTorch:加载 ResNet 预训练权重 + 替换分类头 + 微调”import torchimport torch.nn as nnfrom torchvision import models, datasets, transformsfrom torch.utils.data import DataLoader
# 1. 加载在 ImageNet 上预训练的 ResNet18model = models.resnet18(weights=models.ResNet18_Weights.DEFAULT)
# 2. 冻结 backbone(卷积层参数不更新),只训练分类头for param in model.parameters(): param.requires_grad = False
# 3. 替换最后的全连接层为新的分类头(自动 requires_grad=True)num_classes = 5 # 假设新任务有 5 个类别model.fc = nn.Linear(model.fc.in_features, num_classes)
# 4. 用小学习率微调(冻结的层不会更新)optimizer = torch.optim.Adam(model.fc.parameters(), lr=1e-3)criterion = nn.CrossEntropyLoss()差分学习率全网络微调(进阶)
Section titled “差分学习率全网络微调(进阶)”import torchimport torch.nn as nnfrom torchvision import models
model = models.resnet50(weights=models.ResNet50_Weights.DEFAULT)
# 替换分类头model.fc = nn.Linear(model.fc.in_features, 10)
# 为不同层设置不同学习率optimizer = torch.optim.AdamW([ {'params': model.conv1.parameters(), 'lr': 1e-5}, # 最浅层:极小学习率 {'params': model.layer1.parameters(), 'lr': 1e-5}, {'params': model.layer2.parameters(), 'lr': 5e-5}, {'params': model.layer3.parameters(), 'lr': 1e-4}, # 中间层:中等学习率 {'params': model.layer4.parameters(), 'lr': 5e-4}, {'params': model.fc.parameters(), 'lr': 1e-3}, # 分类头:正常学习率], weight_decay=1e-4)
# 余弦退火 + 预热调度器scheduler = torch.optim.lr_scheduler.CosineAnnealingWarmRestarts( optimizer, T_0=10, T_mult=2, eta_min=1e-6)进阶技巧:渐进解冻(gradual unfreezing)。先只训分类头几个 epoch,再解冻 layer4,再解冻 layer3……每解冻一层把学习率降低一个量级。fastai 库的
fine_tune把这套流程封装成了一行,强烈推荐初学者使用。
LoRA 微调大语言模型(HuggingFace PEFT)
Section titled “LoRA 微调大语言模型(HuggingFace PEFT)”from peft import LoraConfig, get_peft_model, TaskTypefrom transformers import AutoModelForCausalLM, AutoTokenizerimport torch
# 加载预训练大模型(以 LLaMA-3-8B 为例)model = AutoModelForCausalLM.from_pretrained( "meta-llama/Meta-Llama-3-8B", torch_dtype=torch.bfloat16, device_map="auto")
# 配置 LoRAlora_config = LoraConfig( task_type=TaskType.CAUSAL_LM, r=8, # 秩:控制 LoRA 的表达能力 lora_alpha=16, # 缩放因子:通常设为 r 的 2 倍 lora_dropout=0.05, # 正则化 target_modules=[ # 在哪些层插入 LoRA "q_proj", "k_proj", "v_proj", "o_proj", # 注意力的 Q/K/V/O "gate_proj", "up_proj", "down_proj", # FFN 的三个线性层 ],)
# 应用 LoRA:冻结原模型,注入低秩适配矩阵model = get_peft_model(model, lora_config)model.print_trainable_parameters()# 输出示例:# trainable params: 21,088,256 || all params: 8,072,204,288 || trainable%: 0.26%# → 仅训练 0.26% 的参数!LoRA 适配器的保存与加载
Section titled “LoRA 适配器的保存与加载”# 保存:只保存 LoRA 参数(几十 MB),而非整个模型(几十 GB)model.save_pretrained("./lora_adapter/")# ./lora_adapter/ 目录下只有 adapter_model.safetensors(约 80MB)+ adapter_config.json
# 加载:先加载基础模型,再加载 LoRA 适配器from peft import PeftModelbase_model = AutoModelForCausalLM.from_pretrained("meta-llama/Meta-Llama-3-8B", ...)model = PeftModel.from_pretrained(base_model, "./lora_adapter/")
# 合并到基础模型(推理时无额外延迟)model = model.merge_and_unload()model.save_pretrained("./merged_model/")- 数据量决定策略:小数据 + 相似域 → 冻结 + 只训分类头;中等数据 → 差分学习率微调;大数据或跨域 → 较大学习率全网络微调,甚至从头训练。大模型(> 1B)→ 用 LoRA,无论数据量大小。
- 预处理必须对齐:预训练模型的输入有固定的归一化方式(如 ImageNet 的 mean/std),你的新数据必须用同样的方式归一化,否则特征提取器会”认不出”输入。
- 学习率要小:微调的学习率通常是从头训练的 1/10 到 1/100(1e-4 ~ 1e-5),因为预训练权重已经很好,大学习率会破坏学到的特征。但 LoRA 微调例外——LoRA 参数从零初始化,学习率可以更大(2e-4~1e-3)。
- 差分学习率 / LLRD:底层(通用特征)用极小学习率(1e-5),顶层(任务特化)用较大学习率(1e-3)。PyTorch 用参数组分别设置。Transformer 用 LLRD(layer-wise decay rate 0.65~0.95)。
- 预热必不可少:微调的前 5~10% 步骤做学习率预热(从 0 线性增长),防止初始大梯度破坏预训练权重。
- 迁移不限于分类:检测、分割、关键点等任务都可以用 ImageNet 预训练 backbone。检测框架如 YOLO(见 目标检测与 YOLO)、分割模型(见 图像分割)默认都用预训练权重初始化。
- 自监督预训练是替代选项:没有标注数据做预训练?自监督学习(见 自监督学习)可以在无标注数据上获得高质量预训练权重——DINOv2、MAE 等的迁移效果已媲美甚至超越有监督 ImageNet 预训练。
2025-2026 最新进展
Section titled “2025-2026 最新进展”PEFT 成为主流,全参数微调退居其次
Section titled “PEFT 成为主流,全参数微调退居其次”2024-2025 年,参数高效微调 已成为大模型微调的事实标准。原因有三:
- 硬件门槛低:QLoRA 让 70B 模型的微调从”需要 10 张 A100”降到”单张消费级 GPU 即可”。
- 多任务部署成本低:一个基础模型 + 多个小 LoRA 适配器(每个几 MB),可以服务多个任务,无需部署多个大模型。
- 效果接近全参数微调:研究表明,LoRA 在大多数任务上只比全参数微调差 1~2%,在低数据场景甚至更好(因为隐式正则化更强)。
LoRA 的改进变体
Section titled “LoRA 的改进变体”2024-2025 年出现了大量 LoRA 改进方法:
- LoRA+(2024):对 A 和 B 矩阵使用不同学习率(B 的学习率远大于 A),加速收敛并提升最终精度。
- DoRA(2024):权重分解为方向和幅度,分别用 LoRA 和标量微调,效果优于标准 LoRA。
- GaLore(2024):梯度低秩投影,在不需要额外参数的情况下降低全参数微调的显存占用——介于 LoRA 和全微调之间。
- PiSSA(2024):用 SVD 分解原始权重 W 代替随机初始化 A、B,初始化即包含任务相关信息,收敛更快。
视觉迁移学习的新范式
Section titled “视觉迁移学习的新范式”- DINOv2 / DINOv3 零样本迁移:Meta 的 DINOv2 特征质量极高,在许多视觉任务上不需要微调——直接用线性探测或最近邻就能达到接近全监督的效果。这简化了迁移学习流程:从”下载 backbone → 替换分类头 → 微调”简化为”提取 DINOv2 特征 → 训练线性分类器”。
- SAM 2 prompt-based 迁移:Meta 的 SAM 2 可以通过 prompt(点击/框选/文本)直接做分割,无需针对新场景微调——迁移学习被”prompt 工程”取代。
- 视觉语言模型的迁移:CLIP、SigLIP 等模型的零样本分类能力(用文本描述类别即可),在很多场景下免去了视觉迁移学习的需求。
指令微调与 RLHF 中的迁移学习
Section titled “指令微调与 RLHF 中的迁移学习”大语言模型的训练流程本身就是迁移学习的典型应用:
阶段 1:预训练(海量无标注文本,自监督学习)  → 得到基础模型(如 LLaMA-3-8B)
阶段 2:监督微调(SFT,高质量指令-回答对)  → 模型学会"遵循指令"——这是迁移学习的一种形式  → 2025 趋势:用 LoRA 做 SFT,成本极低
阶段 3:人类反馈强化学习(RLHF)  → 模型对齐人类偏好  → 见 [强化学习](../../reinforcement-learning/03-applications/rlhf-and-llm.md)
每个阶段都在前一阶段的模型基础上迁移——预训练 → SFT → RLHF 是 NLP 中最经典的"渐进迁移"流程。- 医疗影像(CheXNet 2017):用 ImageNet 预训练的 ResNet121,在 ChestX-ray14 数据集上微调,诊断 14 种胸片疾病。医疗标注数据稀缺(放射科医生很贵),迁移学习让模型在仅有几千张标注的情况下达到甚至超过放射科医师水平。
- 自动驾驶:交通标志识别、行人检测、车道线检测等任务,用 ImageNet 预训练 backbone + 少量任务数据微调。Tesla、Waymo 的感知模型都受益于预训练。
- 工业质检:工厂产线上的缺陷检测(划痕、裂纹、变形),每个工厂每种产品都要单独训练,但每个场景的缺陷样本很少。用 ImageNet 预训练 backbone + 少量缺陷图微调,能在数百张样本下启动。
- 农业病虫害识别:手机 App 拍照识别作物病害,每种作物的病害图很难大规模采集,迁移学习让小团队也能做出可用的识别系统。
- 遥感图像:用自然图像预训练的模型迁移到卫星图,虽然域差异较大,但底层纹理特征仍部分可复用。DINOv2 等自监督预训练模型在遥感迁移上效果更好。
- LLM 领域适配:用 LoRA 在通用大模型(如 LLaMA-3)上微调特定领域数据(医疗问答、法律文书、代码生成),每个适配器仅需数十 MB 存储——一家公司可以在一个基础模型上叠加几十个领域适配器。
典型类库与工具
Section titled “典型类库与工具”| 类库 | 语言 | 说明 |
|---|---|---|
torchvision.models | Python | 内置 ImageNet 预训练的 ResNet、VGG、EfficientNet 等主流架构 |
timm (PyTorch Image Models) | Python | 收录数百种预训练模型(含 DINOv2、SAM 等),SOTA 架构最全,迁移学习首选 |
transformers (HuggingFace) | Python | NLP 预训练模型库,BERT/GPT/T5/LLaMA 等开箱即用微调 |
peft (HuggingFace) | Python | 参数高效微调工具库,集成 LoRA/QLoRA/Adapter/Prefix Tuning 等 |
axolotl / unsloth | Python | LoRA 微调的高层封装工具,进一步降低使用门槛,2024-2025 社区流行 |
| fastai | Python | 高层 API,fine_tune 一行完成渐进解冻 + 差分学习率 |
keras.applications | Python | Keras 内置预训练模型,几行代码即可加载与微调 |
| bitsandbytes | Python | 实现 QLoRA 的 4/8-bit 量化库,是低显存微调的核心依赖 |
| 术语 | 英文 | 解释 |
|---|---|---|
| 迁移学习 | Transfer Learning | 将源任务上学到的知识迁移到目标任务的方法总称 |
| 预训练 | Pre-training | 在大规模数据上从头训练模型的过程 |
| 微调 | Fine-tuning | 在预训练模型基础上,用目标任务数据继续训练 |
| 冻结 | Freezing | 固定某些层的参数不更新,只训练其余层 |
| 差分学习率 | Discriminative Learning Rates | 不同层使用不同学习率,浅层小、深层大 |
| 层级学习率衰减 | Layer-wise LR Decay (LLRD) | Transformer 微调时,学习率按层指数衰减的策略 |
| 渐进解冻 | Gradual Unfreezing | 从顶层开始逐层解冻并训练的策略 |
| 领域自适应 | Domain Adaptation | 源域和目标域数据分布不同时的迁移学习方法 |
| 特征提取器 | Feature Extractor | 网络的卷积部分,负责从输入提取通用特征 |
| 灾难性遗忘 | Catastrophic Forgetting | 微调时模型”忘记”预训练知识的现象 |
| 参数高效微调 | Parameter-Efficient Fine-Tuning (PEFT) | 冻结大部分参数,只训练极少额外参数的微调方法总称 |
| LoRA | Low-Rank Adaptation | 用低秩矩阵分解近似权重更新,最流行的 PEFT 方法 |
| QLoRA | Quantized LoRA | 在 LoRA 基础上将冻结权重量化为 4-bit,大幅降低显存 |
| 秩 | Rank (r) | LoRA 中低秩矩阵的维度,控制可训练参数量和表达能力 |
| Adapter | Adapter Module | 在 Transformer 层中插入的瓶颈型可训练模块 |
| 前缀微调 | Prefix Tuning | 在注意力键值前拼接可学习虚拟 token 的 PEFT 方法 |
| 弹性权重整合 | Elastic Weight Consolidation (EWC) | 通过惩罚重要参数的更新来防止灾难性遗忘的方法 |
| Fisher 信息 | Fisher Information | 衡量参数对任务重要性的指标,用于 EWC 中的权重惩罚 |
- 微调的奠基实验:Yosinski et al. (2014) “How transferable are features in deep neural networks?”——系统验证了底层特征的可迁移性,是理解迁移学习为何有效的经典论文。
- CheXNet:Rajpurkar et al. (2017),迁移学习在医疗影像的标志性应用,展示了预训练模型在小数据专业领域的威力。
- LoRA:Hu et al. (2021) “LoRA: Low-Rank Adaptation of Large Language Models”——低秩适配的开山之作,PEFT 的事实标准。
- QLoRA:Dettmers et al. (2023) “QLoRA: Efficient Finetuning of Quantized LLMs”——4-bit 量化 + LoRA,让 65B 模型单卡微调成为可能。
- DoRA:Liu et al. (2024) “DoRA: Weight-Decomposed Low-Rank Adaptation”——LoRA 的改进,分解方向和幅度,效果更优。
- Aghajanyan et al. (2020) “Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning”——从理论解释了为什么低秩微调有效。
- NLP 的迁移学习:BERT/GPT 等预训练语言模型把迁移学习范式带到了 NLP,详见 语言模型演进。
- CNN 架构背景见 卷积神经网络 CNN;自监督预训练(另一种获取预训练权重的方式)见 自监督学习。